lean-memory について
lean-memory は、エージェント向けの埋め込み型でローカルファーストなメモリライブラリです。ネームスペースごとに SQLite ファイルを使用し、サーバーやクラウドキーは不要です。永続的なメモリを必要とする Python アプリケーションや MCP エージェントを対象としており、古い事実は削除せず置き換えて管理します。
主な機能
- 01自然言語から事実を抽出して保存
- 02矛盾する古い事実の自動置き換え
- 03密ベクトルと疎ベクトルのハイブリッド検索とリランキング
- 04過去時点の事実を参照する as_of 検索
- 05人の確認を挟むオフラインのメンテナンス
活用シーン
- 01Claude Code や Claude Desktop へのローカル永続メモリの追加
- 02Python アプリでのユーザーごとの独立したメモリ管理
- 03エージェントのメモリにある重複内容のレビューと整理
MCP 対応
memory_add、memory_search、memory_clear などのツールを公開する MCP サーバーを提供します。コアサーバーではメンテナンスとレビューのツールも利用できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細
lean-memory


組み込み型のローカル優先エージェントメモリです。サーバーもデーモンも不要で、クラウドキーも必須ではありません。
ステータス(2026-07): 最初の一般公開リリース(0.2.1)がPyPIと MCP Registryで公開されています(MCPを最優先したローンチ)。Claude Codeプラグインは このリポジトリに含まれています(マーケットプレイスへの掲載は保留中)。 ロードマップと背景:
docs/superpowers/specs/2026-07-08-strategic-direction-design.md。 公開ベンチマークの実行(LongMemEval/LoCoMo)は、ローンチ後まで意図的に延期しています。 ハーネスは完成しており(bench/phase2_*.py)、そこで明らかになったエンジンの問題は修正済みです。詳しくはdocs/phase2-learnings.mdをご覧ください。
from lean_memory import Memory

mem = Memory(root="./data")

mem.add("user-42", "I work at Acme Corp.")
mem.add("user-42", "I now work at Globex.")          # supersedes Acme automatically

mem.search("user-42", "where does the user work?")   # → "I now work at Globex."
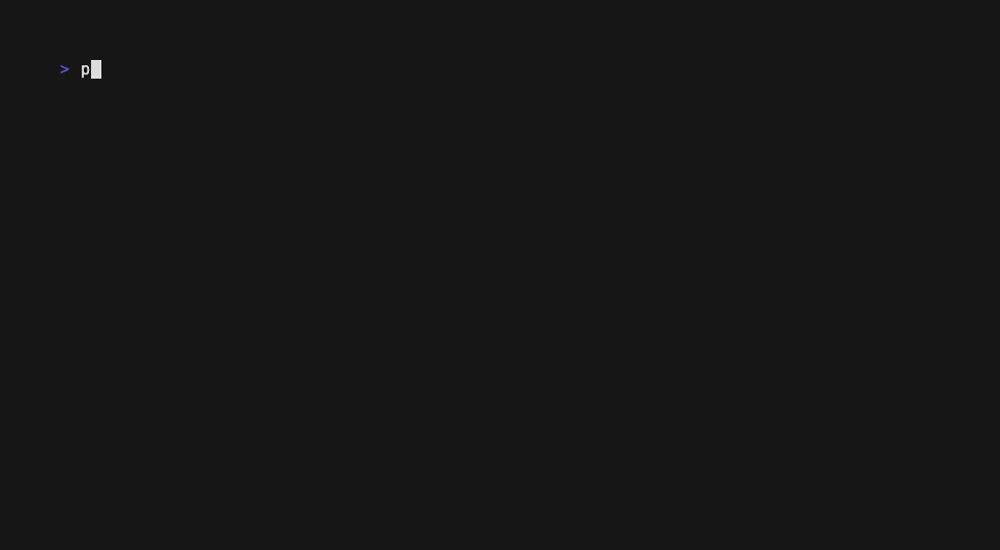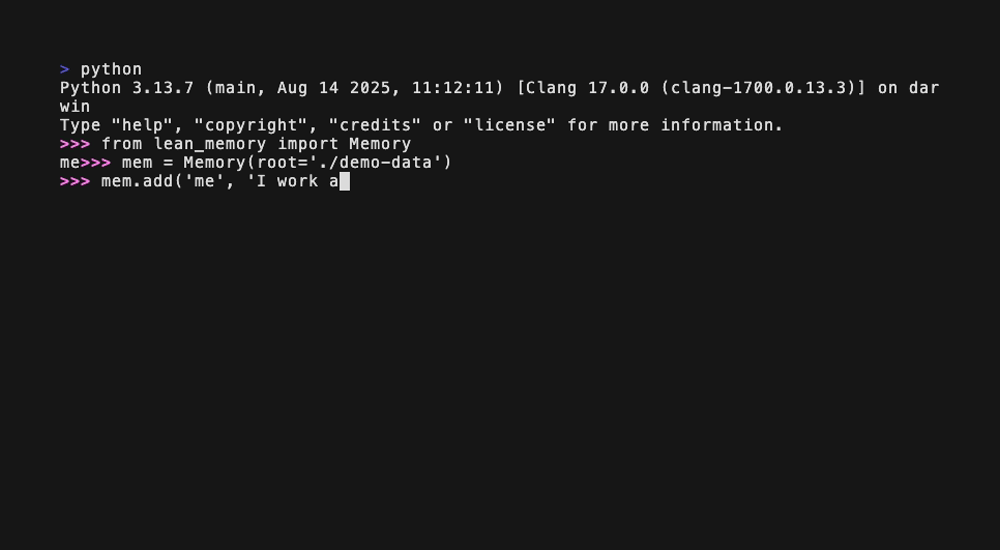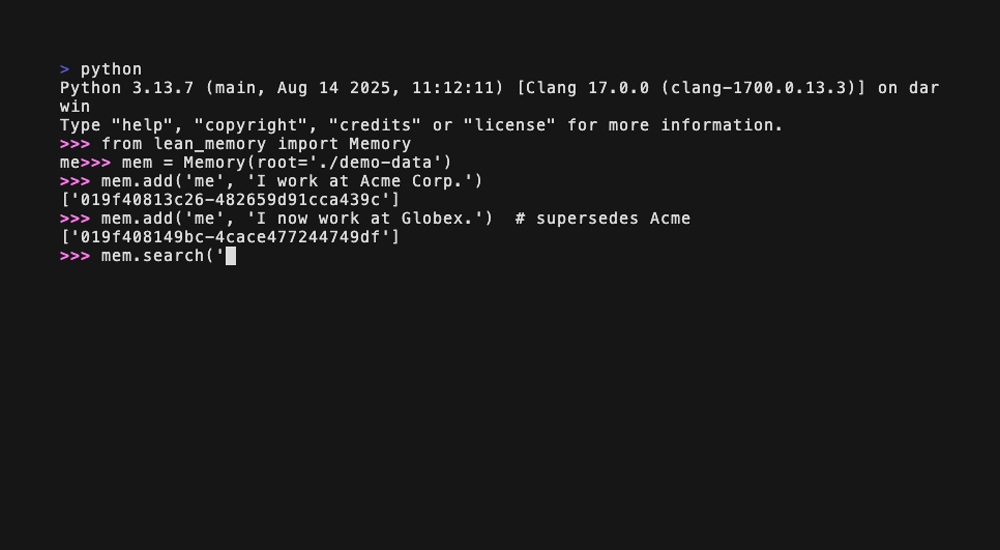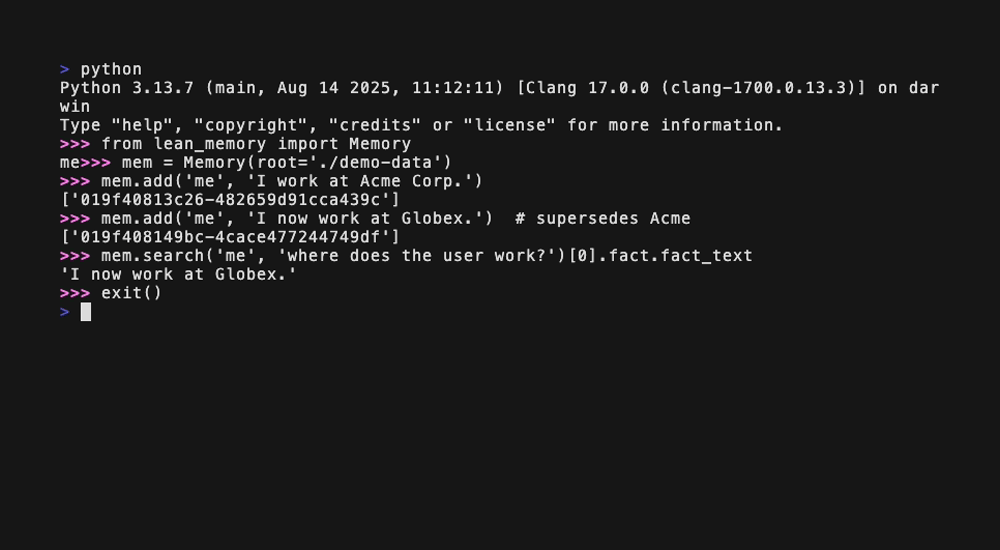
自然言語から事実を抽出し、名前空間ごとのSQLiteファイルに保存して、密ベクトル検索と疎検索を組み合わせて取得します。古い事実は削除されず、より新しい事実によって置き換えられ、過去の任意の時点を指定して検索できます。
インストール
pip install lean-memory
インストール直後から完全にオフラインで動作します。オプションの追加機能を導入すると、実際のモデル品質を利用できます。
| 追加機能 | 内容 |
|---|---|
lean-memory[models] | 実用的な埋め込みモデルと再ランキングモデル(Qwen3-0.6B + Ettin-32M) |
lean-memory[extract] | より豊かな抽出のためのGLiNER2候補生成 |
lean-memory[llm] | OllamaベースのLLM型付け処理 |
lean-memory[mcp] | Claude Desktop / Claude Code用MCPサーバーブリッジ |
lean-memory[examples] | ターミナルデモエージェント(anthropic SDKが必要) |
クイックスタート
from lean_memory import Memory

mem = Memory(root="./data")   # one SQLite file per namespace, stored under ./data/

# Store facts in natural language
mem.add("alice", "I work at Stripe.")
mem.add("alice", "I now work at Vercel.")   # supersedes Stripe automatically

# Retrieve — the superseded Stripe fact drops out; only the current one is returned
results = mem.search("alice", "what does Alice do for work?", k=3)
for hit in results:
    print(hit.fact.fact_text, hit.final_score)
# → I now work at Vercel. 0.89

# Point-in-time query — what was true at a specific moment?
mem.search("alice", "employer", as_of=1_700_000_000_000, is_latest_only=False)  # epoch ms

# Always close when done (flushes WAL)
mem.close()
デモエージェント
メモリの一連の流れ(追加、取得、置き換え、再起動)を確認できるターミナルチャットボットです。 デモスクリプトはリポジトリにあります(パッケージにはインストールされません)。
git clone https://github.com/Wuesteon/lean-memory && cd lean-memory
pip install -e '.[examples]'
export ANTHROPIC_API_KEY=sk-ant-...
python examples/chat.py                  # uses offline stubs by default
python examples/chat.py --namespace bob  # separate memory tenant, persists across restarts
APIキーがなくてもデモは動作します。Claudeを呼び出す代わりに取得したメモリのコンテキストを表示するため、オフラインでエンジンの動作を確認できます。
MCP サーバー — Claude Code / Claude Desktop 向けのメモリ
あらゆる MCP エージェントに永続的なローカルメモリを提供します。ツールは 3 つ(memory_add、
memory_search、memory_clear)、名前空間ごとに SQLite ファイルを 1 つ使用し、データがマシンの外に出ることはありません。
pip install 'lean-memory[mcp,models,extract]'
初回実行時に、3 つのオープンモデル(合計約 2.0 GB:検索用の Qwen3-Embedding-0.6B と Ettin-32M reranker、および実際の抽出用の GLiNER2-base(約 0.8 GB))がダウンロードされます。すべてアクセス制限はありません。MCP クライアントがダウンロードを待たずに済むよう、一度だけ事前にウォームアップしてください。
python -c "from lean_memory.embed.sentence_transformer import SentenceTransformerEmbedder; \
from lean_memory.retrieve.rerank import CrossEncoderReranker; \
SentenceTransformerEmbedder().embed_one('warm'); CrossEncoderReranker().score('warm', ['up']); \
from lean_memory.extract.gliner_extractor import Gliner2Generator; from lean_memory.types import Episode; \
Gliner2Generator().generate(Episode(namespace='w', raw='I work at Acme.', t_ref=0, source='user'))"
Claude Code:
claude mcp add lean-memory -- lean-memory-mcp
Claude Desktop — mcpServers に追加するか(または examples/mcp_config.json をコピーしてください):
{ "lean-memory": { "command": "lean-memory-mcp", "env": { "LM_DATA_ROOT": "~/.lean_memory" } } }
データのルートディレクトリ:LM_DATA_ROOT(既定値は ~/.lean_memory)。オフラインのみでも動作します —
サーバーは、追加機能がインストールされているバックエンドを機会に応じてアップグレードし([models] → 実際の埋め込みモデルとリランカー、[extract] → GLiNER2 による抽出)、それ以外の場合は決定論的なスタブバックエンドにフォールバックします(CI には適していますが、実際の用途では意味的に無意味です — [mcp,models,extract] をインストールしてください)。
オプションの
[llm]エクストラで得られるもの。 標準の[mcp,models,extract]インストールには LLM による型付けパスがないため、エスカレーションされる候補の約 15% — そのほとんどは推論による(derives)事実です — は、モデルではなく決定論的なスタブによって型付けされます。断定的な事実には影響しませんが、デフォルトの経路では推論型の事実は実質的に二級扱いとなります。[llm](ローカルの Ollama モデル)を追加すると、エスカレーションされた層が実際の制約付き型付けにアップグレードされます。ARCHITECTURE.md → 既知の制限事項を参照してください。
スリープ中のメンテナンスとレビュー
メモリには不要な情報がたまっていきます。同じ事実が何通りにも書き直されたり、使われることのない古い記録が残っていたり、要約すべき情報のまとまりができたりします。lean-memory は、睡眠中に記憶を整理するのと同じように、時間外に実行するオフラインジョブでこれらを整理します。重複を統合し、要約し、価値の低い記録の優先度を下げたうえで、判断が必要な項目を翌朝に確認できるようにします。確認はウェブコンソールでも、Claude Code との会話でも行えます。
CLI(lean-memory-maintain)が主な実行方法です。デフォルトではドライランで、実行する内容を報告するだけで、何も書き込みません。
lean-memory-maintain --root ~/.lean_memory              # dry-run: report only, zero writes
lean-memory-maintain --root ~/.lean_memory --apply      # auto-apply safe transforms + stage the rest
lean-memory-maintain --root ~/.lean_memory --auto-only   # with --apply: ONLY the provably-safe band, stage nothing
lean-memory-maintain --root ~/.lean_memory --json        # one machine-readable object, stable keys
--root のデフォルトは $LM_DATA_ROOT です。--namespace NS を追加すると、ルート配下のすべての *.db ではなく、単一の名前空間に対して実行します。夜間にスケジュール実行するには、次の crontab の1行で、毎晩午前3時に安全な範囲の処理を実行し、それ以外の処理をすべて確認待ちとして登録できます。
0 3 * * * lean-memory-maintain --root ~/.lean_memory --apply >> ~/.lean_memory/maintain.log 2>&1
翌朝、Claude Code でレビューします。 判断が必要な項目(類似レコードのマージ、要約、削除対象の選定)は提案として登録され、承認するまで保存済みのメモリは変更されません。/review-memory プラグインコマンドを実行するか、コンソールサーバーで review-memory-maintenance MCP プロンプトを呼び出すと、Claude がエンティティごとにまとめたキューを、変更前後の根拠とともに順に確認していきます。記録されるのは、あなたが下した判定だけです。これを支える MCP ツールは4つあり、memory_maintenance_run(CLI と同様、デフォルトではドライラン)、memory_maintenance_status、memory_review_queue、memory_review_decide が、コアの lean-memory-mcp サーバーと両方のコンソール MCP 接続で利用できます。LM_MAINT_AUTO=1 を設定すると、古くなった名前空間で最初のツール呼び出しがあった際に、安全な範囲の処理だけをバックグラウンドで自動実行するよう設定できます。デフォルトでは無効です。
または、コンソールで確認できます。 メモリコンソールには Review ページがあり、同じキューをエンティティごとにまとめて表示します。提案ごとに変更前後の根拠(類似レコードの場合は両方のテキストとコサイン類似度、要約の場合はソースと提案テキスト、削除の場合はスコアの根拠)を確認でき、Approve/Keep/Edit-then-approve/Promote の操作、エンティティ単位の一括承認、メンテナンス実行ボタン(デフォルトではドライラン。適用には確認が必要)を利用できます。どちらのフロントエンドも、比較してから更新する同一の提案ストアを操作します。そのため、片方で判定すると、もう片方では二重適用されず「すでに判定済み」と表示されます。
安全性について。 情報が削除されることはありません。メンテナンスでは、追記、退役(通常の置き換えと同じ superseded_by の切り替え)、または低温ティアへの降格のみを行います。そのため、過去のどの時点の完全な履歴もクエリ可能であり、ストアの述語レベルでビット単位に同一であることが実行可能なテストで保証されています。自動適用される変換は、完全一致する重複の退役と、厳格な基準に基づく削除の2つだけです。判断を要するものはすべて人による確認待ちとして登録され、未レビューの提案は自動適用されるのではなく、30日後に期限切れになります。無回答が同意とみなされることはありません。低温ティアに降格された事実も、as_of クエリと search(..., include_cold=True) で参照できます。また、高温ティアへの昇格は明示的な操作のみで行われるため、読み取りによってエージェントから見える情報が永続的に変わることはありません。
実際のモデル品質
デフォルトのバックエンドはオフラインのスタブです。決定論的で依存関係もありませんが、意味的な処理は行いません。本番環境に適した検索品質を得るには、実際のモデルに切り替えてください。
pip install 'lean-memory[models]'
Qwen3-Embedding-0.6B と Ettin-32M リランカーを使用すると、コードを一切変更せずに、内部ベンチマークで検索精度が 1/5 から 4/5 に向上します。
ベンチマーク結果、アーキテクチャの決定事項、実装状況については、ARCHITECTURE.md をご覧ください。
動作の仕組み
mem.add() を呼び出すたびに、4 段階のハイブリッド抽出パイプラインが実行されます。
- ルール — 一般的な述語(
works_at、lives_in、…)に対する正規表現と dateparser - GLiNER2 — オープン語彙の NER 候補生成(デフォルトではオフラインスタブ)
- ルーター — 再現率を重視したエスカレーション:信頼度が低い事実、照応、推論による事実(
derives)を LLM パスにエスカレーションします - LLM による型付け — ローカルの Ollama モデルを使った制約付き関係型付け(デフォルトではスタブ)
矛盾検出は、低コストの方法から順に実行されます(スロット照合 → コサイン類似度 → トークンの包含関係 → LLM)。競合する事実は削除せずに置き換えます。古い事実は is_latest=False と superseded_by ポインターを保持したまま残ります。
エンティティの同一性は、正規化された名前キー(NFC + Unicode のケースフォールド + 空白の正規化)で解決されます。そのため、Acme、ACME、acme は同じサブジェクトとして扱われ、重複排除や置き換えが適切に適用されます。SQLite の ASCII のみに対応した NOCASE ではなく、Unicode 全体のケースフォールドを使用するため、Café/CAFÉ や ЖУК/жук も同じものとして照合されます。句読点と発音区別符号は意図的に正規化しません(Yahoo! ≠ Yahoo、Café ≠ Cafe)。表示名には、最初に使用した表記が保持されます。この方式にはトレードオフがあります。大文字と小文字だけが異なる、本来は別個のサブジェクト(惑星の Mercury と金属の mercury など)は同じものとして照合されます。ただし、何も削除されず、退役した事実は search(as_of=…, is_latest_only=False) から引き続き参照できます。
検索では、2 段階の Matryoshka 高密度検索(256 次元の粗い KNN → 全次元(デフォルトの埋め込み器では 1024 次元)で再スコアリング)と BM25 疎検索を融合し、RRF 融合を適用してクロスエンコーダーで再ランキングし、重要度減衰を用いてスコアを算出します(0.6·関連度 + 0.2·新しさ + 0.2·重要度)。
開発
git clone https://github.com/Wuesteon/lean-memory
cd lean-memory
python -m venv .venv && source .venv/bin/activate
pip install -e '.[dev]'
pytest -q    # full offline suite, no downloads
プロジェクト構成
src/lean_memory/
  memory.py                   Memory facade — the public API
  types.py                    Episode / Fact / RetrievedFact types
  store/                      Store interface + SqliteStore (vec0 + FTS5)
  embed/                      Embedder interface, FakeEmbedder, SentenceTransformer
  extract/                    4-pass extraction pipeline
  retrieve/                   Reranker interface, retrieval pipeline
examples/
  chat.py                     Terminal demo agent
  mcp_config.json             Drop-in MCP client config
tests/                        offline test suite
bench/                        Retrieval quality + BET-2 ablation harnesses
ライセンス
Apache-2.0
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。