agent-memory-os について
AgentMemoryOS は、AI エージェントチーム向けのローカルファーストなメモリーシステムで、範囲別のアクセス制御とノード間同期に対応します。SQLite ベースのコアは追加依存なしで動作し、オプションで MCP サーバー、Web UI、セマンティック検索を利用できます。
主な機能
- 01SQLite メモリーストアと全文検索
- 02エージェント・チーム・プロジェクト単位の強制 ACL
- 03アクセス取り消しに対応したフェデレーション同期
- 04予算内のコンテキスト選択と連想想起
- 05メモリーの減衰・固定・統合
- 06オプションのセマンティック検索、MCP サーバー、Web UI
活用シーン
- 01エージェントチームでプロジェクト知識を共有
- 02個人の記憶と共有コンテキストを分離
- 03範囲を限定した記憶をノード間で同期
- 04プロンプトのトークン予算内で関連記憶を提供
MCP 対応
オプションの MCP サーバーが AgentMemoryOS のメモリー機能を MCP クライアントに公開します。[mcp] extra で導入でき、Docker イメージの stdio モードでも実行できます。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
uvx agent-memory-osAGENT_MEMORY_AGENT_IDThis agent's identity; memories default to this owner and recall carries its ACL.AGENT_MEMORY_HOMEData home directory (default ~/.agent-memory).ローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
ローカルサーバーのツールはマシン上で起動して初めて取得できます。メンテナーはまだツール一覧を提供していません。
詳細




English · 繁體中文
AI エージェントチーム向けのローカルファーストなメモリシステムです。単一のエージェントにメモリを与えるだけでなく、連携して働くエージェントのフリートで共有するメモリ基盤を提供します。厳格な ACL のもとで、プライベート、チーム、プロジェクト単位のメモリ、連想検索、ノード群(およびその組織構造)の整合性を保つフェデレーション同期を実現します。SQLite ファイル 1 つで動作し、必須の依存関係はなく、Apache-2.0 です。
理由 · 比較 · インストール · クイックスタート · 機能 · フェデレーション · Web UI · ユーザー ガイド
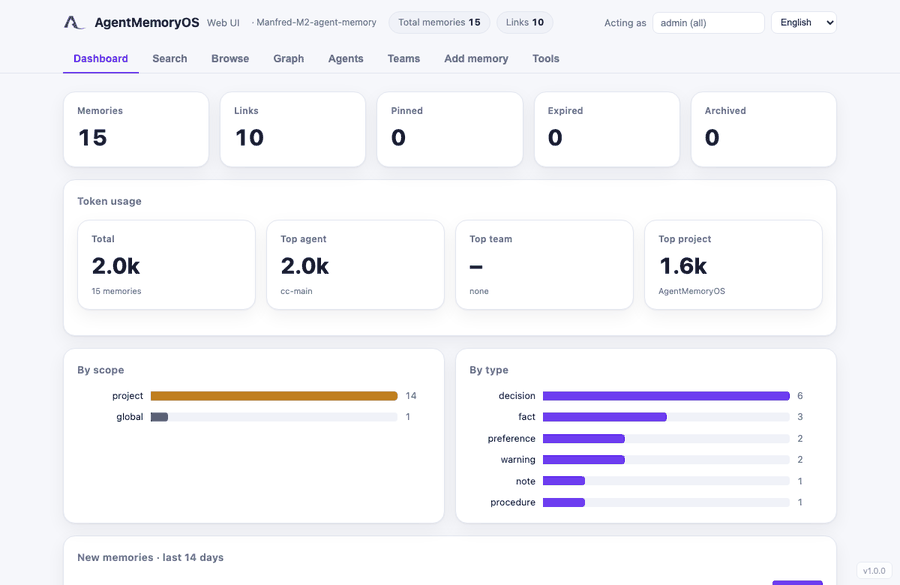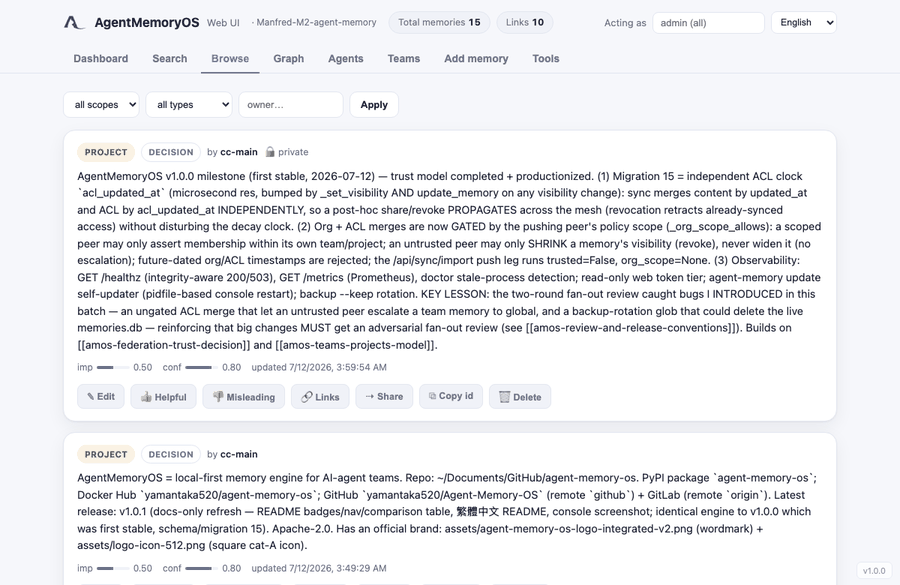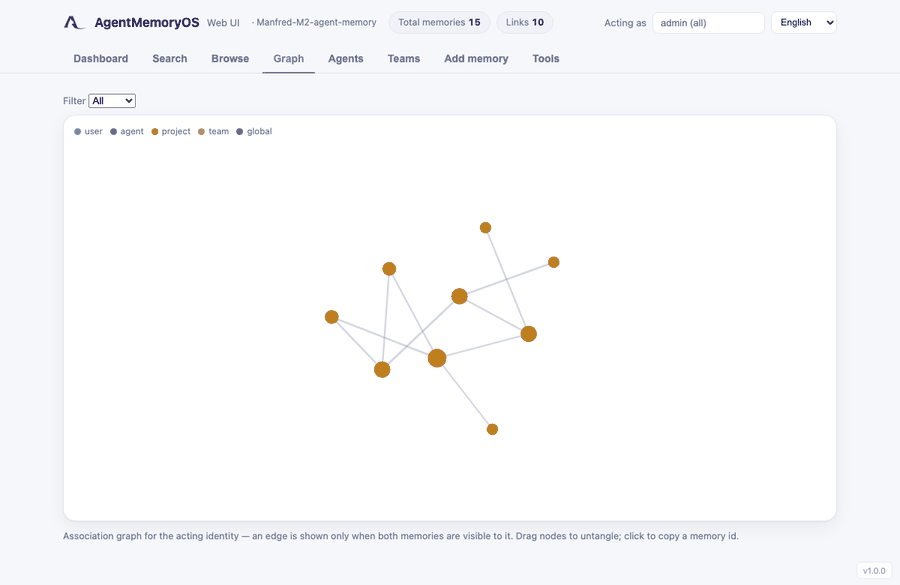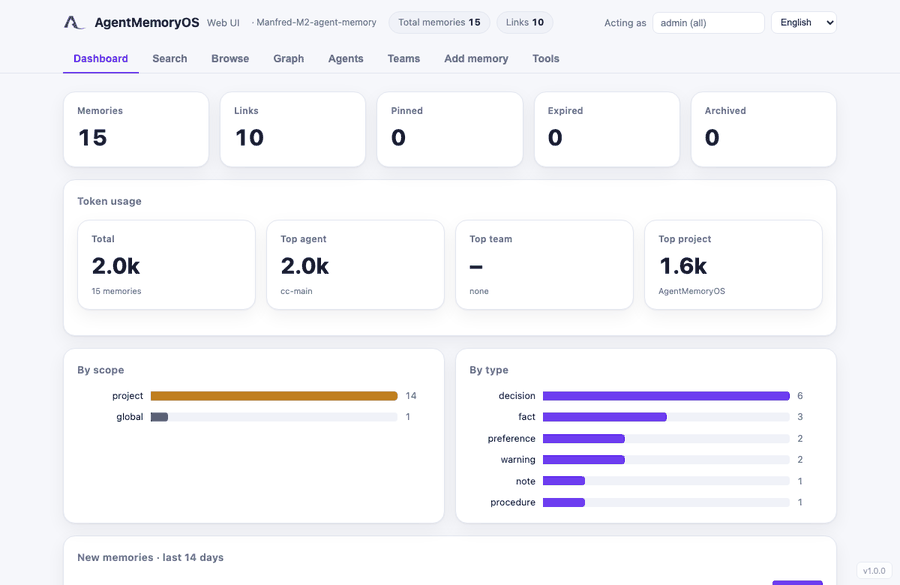
組み込みの Web コンソール:エージェント/チーム/プロジェクト別のトークン使用量、メモリ閲覧、ACL で保護された関連グラフ。
理由
実際の作業はエージェントのチームで行われます。1 つのプロジェクトで Claude Code、Codex、OpenClaw、複数の Hermes プロファイルを組み合わせ、1 台または複数のマシン上で、複数のチームやプロジェクトにまたがって作業することもあります。適切な知識を適切なチームメイトと共有し、プライベートにすべき情報はプライベートに保つ必要があります。
- エージェントごとのメモリは最低限であり、目標ではありません。セッションをまたいで残る、永続的な事実、好み、手順、教訓を保持します。
- チームおよびプロジェクトのメモリが要点です。チームは
team:<id>のメモリを参照し、チームの一部であるプロジェクトはproject:<id>のメモリを参照します。境界を越えて情報が漏れることはありません。メンバーシップは第一級の機能として管理でき、ACL に反映されます。 - フェデレーションにより、ノード群の整合性を維持します。メモリだけでなく、組織構造(チーム/プロジェクト/メンバーシップ)もノード間で同期されるため、
project:<id>はどこでも同じ意味になります。 - ローカルファーストにより、クラウドメモリプラットフォームの遅延、コスト、プライバシーに関するトレードオフを回避できます。メモリはローカルの SQLite ファイルに保存され、各プロンプトには関連する内容だけが予算内で渡されます。
特徴
- ローカルファーストで、コアに依存関係なし — SQLite ファイル 1 つ(FTS5)で動作し、サーバーは不要です。
pip installしてすぐに使えます。 - チームとプロジェクトを標準機能としてサポート — チームはノードメンバーの集合で、プロジェクトのメンバーはそのチームのサブセットです。
team:<id>のメモリはチーム全体に届き、project:<id>のメモリはそのプロジェクトだけに届きます。これはコンソール/CLI/API で管理される厳格な ACL です。メンバーを削除すると、想起のスコープが即座に変更され、スコープを削除すると、そのメモリへのアクセスが取り消されます。 - 実効性のある信頼モデルによるノード間の連携 — ポータブルバンドルとピア同期により、メモリ、リンク、プロフィール、組織構造(チーム/プロジェクト/メンバーシップ)が、最終更新者優先とトゥームストーンによって収束します。ピアごとのポリシー(
shared/full/team:/project:)は強制適用される認可スコープです。ピアが主張できるメンバーシップは自身のスコープ内に限られ、メモリの可視性を縮小することだけが許可されます。拡大はできないため、バンドルによるスコープ越えの権限昇格はありません。 - 伝播するアクセス取り消し — 独立した ACL クロックが、事後の共有/取り消しをメッシュ全体に伝播するため、アクセスを取り消すと、すでにメモリを同期したピアからも実際にアクセスが取り消されます。減衰クロックには影響しません。
- リクエスターを考慮した ACL — すべてのエージェントが、プライベート、エージェント、チーム、プロジェクト、グローバルの各メモリを持ちます。可視性はランキング前に適用される厳格なゲートであり、単なるスコアではありません。候補インデックスが返すのは ID のみで、コンテンツはゲートを通して再読み込みされます。
- 動的なコンテキストパック — プロンプトごとにトークン予算に基づいてメモリを選択し、監査できます(
context_pack_report()で、含める/除外するすべての判断を確認できます)。 - 真偽の調停 — 重複の抑制、矛盾の検出(
CONFLICTマーカー)、コアメモリ用の予算確保を行います。 - 連想想起(共鳴) — 信頼できる
memory_linksグラフにより、クエリ用語が共通していない関連メモリも表面化します。探索は ACL に準拠し、不可視ノードはたどれません。 - ヘッブ則による強化 — 一緒に想起されたメモリ間のリンクを強化します(
record_recall、またはコンテキストパックでのauto_reinforce=True)。役に立たなかった想起では、リンクと信頼度が弱まります(helpful=False)。 - エージェントごとの想起プロフィール — エージェントのペルソナに応じて、メモリ種別の重み付けを変えられます(エンジニアは
procedureを重視し、コンパニオンはpreferenceを重視します)。プロフィールはデータベースに保存され、ランキングの重み付けだけを変更します。ACL を回避することはありません。 - メモリのライフサイクル — 指数/線形減衰、固定、ハード期限、さらに書き込み側の
consolidate()による重複の統合と、頻繁に一緒に想起されるクラスタからの概念メモリの合成を行います。 - オプションのサイドカー — セマンティックなベクトル候補(turbovec)、MCP サーバー、FastAPI Web UI を追加機能として提供します。すべての候補は SQLite に戻り、使用前に厳格なゲートを通過します。
他のシステムとの比較
ほとんどのエージェントメモリーシステムは、ホスト型の大規模運用での LLM 主導の抽出を最適化しています。 AgentMemoryOS が最適化しているのは、異なる領域です。ローカルファースト、チーム単位、フェデレーション対応 — 自分で実行し、厳格な ACL のもとで複数のエージェントに共有するメモリーです。 これは 位置付け の比較であり(ベンチマークではなく、アーキテクチャの比較です)、各行の内容は各プロジェクトの最新ドキュメントで確認してください。
| AgentMemoryOS | Mem0 | Zep / Graphiti | |
|---|---|---|---|
| 実行方法 | 1 つの SQLite ファイル、pip install | セルフホスト(LLM とベクターデータベースを設定)またはホスト型 | Zep Cloud、または Neo4j/FalkorDB 上で Graphiti をセルフホスト |
| コアに LLM が必要か | いいえ(FTS5 + オプションのローカルベクトル) | はい(LLM による抽出。例:gpt-5-mini) | はい(LLM が時間軸グラフを構築) |
| 外部サービス | 不要 | LLM API + ベクトルストア | グラフデータベース + LLM + 埋め込み(セルフホストするには 3 つ以上のシステムが必要) |
| スコープ / ACL モデル | プライベート / エージェント / チーム / プロジェクト / グローバル — ランキング前に厳格に制限 | ユーザー / エージェント / セッション ID 単位 | ユーザー / セッショングラフ単位 |
| ノード間フェデレーション | はい — メモリー と 組織構造が同期され、失効が伝播 | 集中型ストア | 集中型(Cloud またはユーザーのグラフデータベース) |
| 組み込み MCP サーバー | はい | SDK 経由 | SDK 経由 |
| ライセンス / セルフホスト | Apache-2.0、完全なオープンソース | オープンソースのコア。グラフ機能と上位プランは有料 | Community Edition は非推奨。セルフホストには Graphiti をそのまま使用 |
Mem0 と Zep は、LLM ベースの抽出とマネージド規模での検索に優れています。これらは AgentMemoryOS が意図的に扱わない領域です。自分で管理できる、依存関係の少ないメモリーを求めていて、チーム 内のエージェント間で適切に共有し、オフラインでも動作し続け、独自の方針で同期したい場合は、AgentMemoryOS をお選びください。
インストール
pip install 'agent-memory-os[full]' # recommended: everything (Web UI, MCP, turbovec)
機能を選んでインストールすることもできます。agent-memory-os(コア、依存関係なし)、[api](Web UI)、[mcp](MCP サーバー)、[semantic](turbovec によるベクトル検索)があります。
Docker: 事前ビルド済みのマルチアーキテクチャイメージには、AgentMemoryOS の全機能(Web コンソール + MCP サーバー + CLI)が含まれています。最初の引数でモードを選択します。
docker run -p 8000:8000 -v amos-data:/data yamantaka520/agent-memory-os        # web console (default)
docker run -i --rm yamantaka520/agent-memory-os mcp                            # stdio MCP server
docker run --rm -v amos-data:/data yamantaka520/agent-memory-os check          # any CLI command
または docker compose up -d を実行してください。コンソールは http://localhost:8000 にあり、メモリーはボリュームに保存されます。Docker ガイド(Docker Hub イメージ + 2 ノードの同期メッシュ)を参照してください。
標準の CPython ビルドに含まれる SQLite FTS5 を備えた Python 3.11 以降が必要です。
インストール後、2 つのコマンドを実行します。
agent-memory doctor          # verifies FTS5, turbovec, and the other extras
                             # (add --install to auto-install anything missing)
agent-memory token create    # protects the Web UI API with a bearer token
トークンは <home>/web_token に保存され(モード 600)、agent-memory-web が自動的に読み込みます。コンソールの初回使用時にはトークンの入力が求められます。後から agent-memory token show|rotate|disable で管理できます。
権限を絞った 2 種類のトークンもあります。--readonly(GET のみ)と --sync(フェデレーション用ルートのみ)です。管理者トークンの代わりに、こちらをピアに渡してください。
クイックスタート
実行できるスクリプトをお探しですか?
examples/team_memory.pyでは、3 つのエージェントが厳格な ACL のもとで 1 つのストアを共有する方法を、約 40 行で示しています —python examples/team_memory.py。
from agent_memory_os import MemoryClient, RecallProfile

client = MemoryClient(home="~/.agent-memory")

# Write memories with ownership and visibility
client.add("User prefers dark mode.", owner="mizuki", type="preference",
           visibility=[])                      # private to owner
client.add("Deploy target is port 8000.", owner="neo", type="environment",
           visibility=["global"])              # visible to every agent

# Requester-aware search: each agent sees only what it may see
hits = client.search("deploy port", requester_agent_id="neo")

# Token-budgeted context pack for the prompt, with reinforcement loop closed
pack = client.context_pack("deploy port", requester_agent_id="neo",
                           max_tokens=1200, auto_reinforce=True)

# Associate memories; linked memories resonate into future recalls
a = client.add("Staging deploy failed with database lock.", visibility=["global"])
b = client.add("Always snapshot before schema changes.", visibility=["global"])
client.link(a.id, b.id, relation="caused_by", weight=0.8)

# Persist an agent persona: soft ranking bias per memory type
client.save_profile(RecallProfile(agent_id="neo",
                                  type_weights={"procedure": 1.5, "note": 0.7}))

# Periodic hygiene: merge duplicates, synthesize concept memories
client.consolidate()
アーキテクチャ
query
  -> candidate providers (FTS5 | vector sidecar | resonance graph | fallback)
  -> merge/dedupe by stable memory_id
  -> rejoin authoritative rows from SQLite
  -> ACL hard gate -> expires_at hard gate
  -> scoring (relevance x importance x confidence x freshness x reinforcement)
  -> per-agent profile re-weighting (soft)
  -> truth arbitration + context budget allocation
設計上の不変条件:
- SQLite の
memoriesテーブルが唯一の信頼できる情報源です。FTS / ベクトルインデックスは破棄して再構築できます(rebuild_indexes())。 - 候補プロバイダーが返すのは ID とスコアのみです。コンテンツは常に、ACL と有効期限の厳格なゲートを経由して SQLite から再読み込みされます。
- 関連付けエッジ(
memory_links)は信頼できるデータであり、インデックスの再構築後も保持され、使われないと減衰します。また、非表示のメモリーが可視の 2 つのメモリーを橋渡しすることはありません。
仕様全体については、SPEC.md を参照してください。
ストレージエンジン:SQLite + turbovec
AgentMemoryOS は、権限が明確に分かれた 2 つのストレージ層を使用します。
- SQLite(常時有効)は唯一の信頼できる情報源です。メモリ、リンク、
プロファイル、FTS5 の字句インデックスはすべて、1 つの
memories.dbファイルに保存されます。 - turbovec(
[full]/[semantic]とともにインストール)は、意味ベースのベクトル エンジンです。キーワードではなく意味によってメモリを呼び出す、インメモリの量子化インデックスです。 意図的に 破棄可能な設計となっており、候補となるmemory_idとスコアだけを返します。すべての候補は SQLite に戻され、内容の使用前に ACL/有効期限の厳格なチェックを通過します。また、真実の保存先に触れることなく、 インデックスはいつでも削除して再構築できます。
セマンティック検索は、すぐに利用できます。
client = MemoryClient(home="~/.agent-memory", semantic="auto")
semantic="auto" を指定すると、組み込みの決定論的ハッシュ埋め込み器を使った、自己同期型の turbovec インデックスが設定されます(モデルのダウンロードは不要です。誤字や形態の違いに耐性のある字句ベクトルを使用します)。メモリテーブルが変更されるたびにインデックスが自動で再構築され、バックエンドがインストールされていない場合は、字句検索と共鳴検索に静かにフォールバックします。より深い意味検索を行うには、任意の埋め込みモデルを TurbovecSemanticCandidateProvider.from_vectors(...) に渡し、独自の embed_query を指定してください。agent-memory doctor でバックエンドがインポート可能か確認できます。
メモリのライフサイクルと保持
agent-memory retention               # archive expired + memories idle 4+ half-lives
agent-memory retention --half-lives 0   # expired only
agent-memory check                   # SQLite + FTS + link-graph integrity
アーカイブされたメモリは検索対象から完全に除外されますが、復元可能な状態で保持されます(Web UI → Tools →
Retention & archive、または POST /api/archive/{id}/restore)。ピン留めされたメモリと権限トラックのメモリは、減衰によってアーカイブされることはありません。データベースは、バージョン管理された一方向の移行テーブルを使って自動移行されます(スキーマバージョンは agent-memory check
で確認できます)。
バックアップと復元
agent-memory backup ~/backups/memories-$(date +%F).db --keep 14   # rotate, keep 14
agent-memory restore ~/backups/memories-2026-07-11.db --force
バックアップには SQLite のオンラインバックアップ API を使用するため、エージェントによる書き込み中でも一貫性が保たれます。--keep N は同じ名前のシリーズにある古いバックアップを順次削除します(稼働中のデータベースが削除されることはありません)。破棄可能なインデックスは、復元後に自動で再構築されます。
アップグレードとヘルスチェック。 agent-memory update は PyPI を確認してアップグレードし、実行中のコンソールを再起動します。--check を指定すると確認のみを行います。ヘルスチェックには GET /healthz
(200/503)を、Prometheus スクレーパーには GET /metrics を指定してください。
マルチエージェントプロジェクト
1 つのプロジェクトで、Claude Code、Codex、OpenClaw、複数の Hermes
プロファイルを単一のストアに接続して利用できます。コンソールの Agents タブまたは API から各エージェントをチームに登録すると、チームのメンバーは追加設定なしで team:<project> のメモリを自動的に参照できます。
curl -X POST localhost:8000/api/agents -H 'content-type: application/json' \
  -d '{"id": "cc-main", "kind": "claude-code", "teams": ["apollo"]}'
または、フリート全体をコードで宣言できます。<home>/agents.toml はストアを開くたびに再適用されます(ファイルに記載されたエージェントはファイルが権威となり、手動で登録したエージェントには影響しません)。
[agents.cc-main]
kind = "claude-code"
teams = ["apollo", "shared-infra"]   # multiple teams = multiple projects

[agents.hermes-neo]
kind = "hermes"
teams = ["apollo", "ops"]
各 MCP サーバーは AGENT_MEMORY_AGENT_ID で自身の ID を宣言します。これにより、メモリの所有者はデフォルトでそのエージェントとなり、すべての検索にチームの ACL が適用されます。agent-memory sync export apollo.jsonl --team apollo を使えば、あるホストから別のホストへ、プロジェクトの共有メモリを移行できます。
フェデレーション(マルチホスト同期)
# on the host being joined: mint a sync-scoped token for the peer
agent-memory token create --sync           # prints amos_sync_… (federation routes only)

# one-time, on the joining host
# easiest: pairing (one command on each side — tokens/mesh key exchanged for you)
#   on the existing node:  agent-memory team invite apollo
#   on the joining node:   agent-memory join <code> --url http://that-node:8000
# or wire a peer by hand:
agent-memory peers add https://other-host:8000 --peer-token <their sync token>

# converge with every registered peer (pull + push, deterministic merges)
agent-memory sync auto
ピアはホームごとに保存されます。sync auto(またはコンソールの「Sync mesh now」)を実行すると、各ピアと双方向に同期され、内容が収束します。メモリとプロファイルには最終書き込み優先、リンクには最も強いものを優先する方式が適用され、到達できないピアはそれぞれ個別に失敗しますが、全体に致命的な影響はありません。ファイルバンドル(sync export/import)を使うと、エアギャップ環境間で移行できます。継続的なメッシュ同期には、agent-memory service install と cron/タイマーの設定を組み合わせてください。
通信を暗号化する。 すべてのノードに同じメッシュキーを設定すると、同期バンドルはアプリケーション層(Fernet)で暗号化されます。そのため、平文 HTTP やプロキシ経由でもメモリの内容は機密に保たれます。キーは独立したシークレットであり、通信経路を通じて送信されることはありません。
agent-memory sync genkey                   # prints amos_sk_… ; needs the [secure-sync] extra
export AGENT_MEMORY_SYNC_KEY=amos_sk_…      # set the SAME value on every node
同期専用トークンは引き続き Authorization ヘッダーで送信されるため、ローカルホスト以外のピアでは、トークンも保護できるよう証明書が検証される https:// のピア URL を使用してください。保証内容の詳細については、SECURITY.md を参照してください。
エージェント連携
一般的なエージェントに AgentMemoryOS を接続する手順ガイドです。タイルをクリックしてください。


Hermes Agent には ネイティブのメモリプロバイダープラグインが用意されています(MCP だけではありません)。
pip install agent-memory-os && agent-memory hermes install を実行し、hermes memory setup で
agent-memory-os を選択してください。各ターンでリコールが注入され、
amos_* ツールにはチーム/プロジェクト ACL が適用されます。API キーも LLM も必要ありません。
Hermes ガイドをご覧ください。
MCP 対応のエージェントであれば、同じ方法を利用できます。
共有 AGENT_MEMORY_HOME を参照する stdio MCP サーバーとして
python -m agent_memory_os.mcp_server を実行してください。
MCP サーバー

pip install 'agent-memory-os[mcp]'
python -m agent_memory_os.mcp_server
エージェントの ID を設定してメモリが正しい所有者に割り当てられるようにし、1 行で Claude Code に接続します。
claude mcp add agent-memory --env AGENT_MEMORY_AGENT_ID=cc-main -- python -m agent_memory_os.mcp_server
ツール(12 個):memory_add(チーム/プロジェクト/グローバル用の share 引数付き)、memory_search、memory_context_pack、memory_orchestrate_context、memory_link、memory_update、memory_share、memory_recall_feedback、memory_consolidate、memory_offload_context、memory_reload_context、memory_snapshot_diff。AGENT_MEMORY_AGENT_ID を設定すると、各エージェントが独自の ID で動作します。同じホームを参照する 2 つのエージェントは、team:/project: のメモリをすぐに共有できます。
Web UI
pip install 'agent-memory-os[api]'
agent-memory-web --host 127.0.0.1 --port 8000 --home ~/.agent-memory-web
コンソールは 英語、繁体字中国語、簡体字中国語、日本語、韓国語に対応しており、ブラウザーの設定から自動検出されます。ヘッダーで切り替えることもできます。統計ダッシュボード(スコープ/タイプ/関係の内訳、過去 14 日間のアクティビティ、リコール回数の多いメモリ)、検索と新しい順での閲覧(インライン編集、フィードバック、リンク、削除操作に対応するメモリカード)、インタラクティブな関連グラフ表示、メモリごとの判断を確認できるコンテキストパックのプレビュー、追加/リンク/統合ツールを備えています。これらはすべて、グローバルな「操作対象」ID によって動作します。
エンドポイント:health/stats/dashboard/integrity · memories CRUD + 閲覧 · search / context-pack / orchestrate · links + graph · recall feedback · share / revoke / audit · consolidate / retention / archive+restore · agents registry · peers + mesh sync · bundle export/import · owner list / reassign / purge · fleet status/trigger(Ed25519 署名付きのノード間操作)。完全な一覧はユーザーガイドをご覧ください。
検索、閲覧、グラフ、リコールフィードバック、コンテキストパックでは requester_agent_id を受け付け、SDK と同じ ACL の厳格なゲートを適用します。リクエストに requester が含まれない場合は、制限のない管理者ビューで実行されます。localhost のみにバインドするか、--token <secret>(または AGENT_MEMORY_WEB_TOKEN)を指定して、すべての API ルートでベアラートークンを必須にしてください。
注:--home データベースはローカルディスクに置いてください。ネットワークファイルシステム(NFS/SMB)では、SQLite FTS5 のスキーマ作成時に database is locked エラーが発生することがあります。
ログインサービスとして実行(macOS / Linux / Windows)
agent-memory service install [--host 127.0.0.1] [--port 8000]
agent-memory service status | start | stop | restart | uninstall
install はコンソールをネイティブのサービスマネージャーに登録し、ログイン時に自動起動し、障害時に再起動するようにします。macOS では launchd LaunchAgent、Linux では systemd ユーザーユニット、Windows ではタスクスケジューラーログオンタスクが使われます。管理者権限は不要です。サービスはインストール元と同じ Python 環境で実行され、<home>/logs/web.log にログを記録します。Linux でログインせずに起動時に実行する必要がある場合は、loginctl enable-linger $USER を実行してください。動作を事前確認するには --dry-run を追加します。CI では Ubuntu、macOS、Windows で Python 3.11~3.13 を対象にテストスイート全体を実行します。
開発
pip install -e '.[dev]'
pytest
ステータス
安定版 — 1.x。 上記の仕様は実装済みで、テストスイート(3 OS の CI マトリックスで 300 件以上のテストに加え、移行アップグレードパスのジョブ)でカバーされており、ファンアウトコードとセキュリティのレビューを繰り返し実施して監査されています(レポートは docs/reviews/ にあります)。パフォーマンスは 10k 件のメモリで検証済みです(追加 0.17 ms、検索 <1 ms、コンテキストパック 7.8 ms)。データベースは自動的に前方移行されます。各リリースで追加された内容については、CHANGELOG をご覧ください。
ドキュメント
- ユーザーガイド — 概念、CLI / HTTP API / MCP の完全なリファレンス、マルチエージェントとフェデレーションの手順、運用チェックリスト
- Docker ガイド —
docker/docker composeの起動、環境変数による設定、2 ノード同期メッシュ - SPEC — マイルストーンごとの仕様と不変条件
- セキュリティ & 脅威モデル — 脆弱性開示ポリシー、信頼境界、既知の制限事項
- 埋め込みとスケーリング — 実際の埋め込みモデルの組み込み、1 万~100 万件のメモリでの動作
- インポーター — Mem0 / Zep / ChatGPT からの移行 · 互換性 — 1.x のセマンティックバージョニングに関する保証
- レビューとレポート — ファンアウトコードとセキュリティのレビュー(1.x 系全体)、パフォーマンス/セキュリティレポート、検証ハーネス(
scripts/validation_run.py) - CHANGELOG · ロードマップ · 統合ガイド
ライセンス
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。