
tableski について
tableskiは、Excel、CSV、Parquet、JSONをSQLで検索できるテーブルとしてAIエージェントに提供するMCPサーバーです。異なる形式をまたぐ分析に対応し、クエリ結果をCSVまたはXLSXに出力できます。
主な機能
- 01形式をまたぐSQLクエリ
- 02Excel、CSV、Parquet、JSONの取り込み
- 03スキーマと列統計の取得
- 04CSV・XLSXへの結果出力
- 05信頼できないSQL向けの読み取り専用モード
活用シーン
- 01ブックのシートとファイル間のデータ結合
- 02エージェントによるデータ集計や絞り込み
- 03クエリ結果の表計算ソフト向け出力
MCP 対応
ステートレスなStreamable HTTPを通じて、テーブル一覧、SQLクエリ、スキーマ、統計、エクスポートのツールをMCPクライアントに提供します。
設定
リモートサーバーはインストール不要です。クライアントを選んで設定をコピーするか、ワンクリックで導入できます。
https://mcp.tableski.io/claude mcp add --transport http yarenty-tableski https://mcp.tableski.io/{"mcpServers":{"yarenty-tableski":{"type":"http","url":"https://mcp.tableski.io/"}}}Cursor で開く{"servers":{"yarenty-tableski":{"type":"http","url":"https://mcp.tableski.io/"}}}VS Code で開く{"mcpServers":{"yarenty-tableski":{"type":"http","url":"https://mcp.tableski.io/"}}}{"mcpServers":{"yarenty-tableski":{"serverUrl":"https://mcp.tableski.io/"}}}コマンドはターミナルで実行し、JSON は各クライアントの MCP 設定に貼り付けて再起動します。認可が必要なサーバーは初回接続時にログインを求めます。
ツール
詳細
tableski



すべてのスプレッドシートはテーブルです。tableski は SQL でエージェントにデータを提供します。
Excel、CSV、Parquet、JSON を扱うペンギン一族の単一バイナリで、データファイルをクエリ可能なテーブルに変換し、 Model Context Protocol を介して AI エージェントに提供します。
- 単一バイナリで、ステートレスな Streamable HTTP に対応。emperor-mcp フレームワークを基盤としています(Emperor Profile P1 準拠:フレーム化された出力、認証情報の転送、セッションアフィニティなし)。
- SQL エンジンには Apache DataFusion を採用しています。
- kowalski のルークリーで孵化しました。
-skiは一族の名字です。
インストール
ビルド済みバイナリ(macOS arm64/x86_64、Linux x86_64、Windows x86_64)は GitHub のリリースから入手できます。
curl -fsSL https://raw.githubusercontent.com/yarenty/tableski/main/install.sh | sh
Windows の場合は、リリースページから .zip をダウンロードしてください。または cargo 経由でインストールできます。
cargo install tableski
MCP クライアントを接続する
tableski はステートレスな Streamable HTTP を使用する標準的な MCP サーバーです。任意のクライアントからサーバー URL を指定してください。
# Claude Code
claude mcp add --transport http tableski http://127.0.0.1:8080/
// Claude Desktop (claude_desktop_config.json) via mcp-remote
{ "mcpServers": { "tableski": { "command": "npx",
    "args": ["mcp-remote", "http://127.0.0.1:8080/"] } } }
または、raw HTTP を使用する場合は、Accept: application/json を指定して / に JSON-RPC を POST してください(下記を参照)。
実行する
# One model for every format: --file registers by extension, table name = file stem
# (.csv .parquet .json/.ndjson/.jsonl; workbooks .xlsx/.xls/.ods = one table per sheet)
cargo run -- --file fixtures/sample.xlsx --file fixtures/sample.parquet \
             --file fixtures/sample.ndjson --export-dir ./exports
# (--csv/--xlsx flags still work; name collisions get _2/_3 suffixes)
何か質問してみてください(ツール:list_tables、query_sql、get_schema、column_statistics、
export_result。出力はすべて Emperor Profile E8 に従いデータとしてフレーム化されます)。SQL の結合は形式をまたいで機能します。xlsx シートと Parquet ファイル、NDJSON ログを結合できます。export_result はクエリ結果の行を .csv/.xlsx に書き出します。書き出し先は --export-dir のサンドボックス内に限られます(相対名のみ、.. は不可。このフラグをオペレーターが指定しない限り、ツールは無効です)。
curl -s -X POST http://127.0.0.1:8080/ \
  -H 'Content-Type: application/json' -H 'Accept: application/json' \
  -d '{"jsonrpc":"2.0","id":1,"method":"tools/call","params":{"name":"query_sql",
       "arguments":{"sql":"SELECT p.name, SUM(o.amount) AS total FROM people p JOIN orders o ON p.name = o.name GROUP BY p.name ORDER BY total DESC"}}}'
# => ada 150.5, linus 99.99 — a SQL join across two sheets of one workbook
シート名はスラッグ化され、テーブル名になります(People → people、2024 Orders →
t_2024_orders)。ヘッダーらしい先頭行は列名として扱われます(--headers auto|first-row|none で変更可能)。列の型は推論されます。整数、浮動小数点数、ブール値、日付(タイムスタンプとして)、テキストに対応します。
実際のワークブックは扱いが難しいものですが、tableski はその複雑さに対応します。Excel の両方の日付システム(1900 と 1904)、数式セル(キャッシュ済みの値を取り込み、#DIV/0! のようなエラーは NULL に変換)、結合セル(左上の値を使用し、続くセルは NULL)、表示形式(常に生の値を使用)、行ごとの列数の不揃い、書式のみの余白(トリミング)、Unicode のシート名に対応します。また、上限を超えた場合に黙って切り捨てず、明示的にエラーにする --max-rows 上限もあります。厄介なワークブックのコーパスは
fixtures/corpus/ にあります。各特性に対応するフィクスチャとテストが用意されています。
初めての方へ。5 分間のデモでは、2 シートのワークブックを tableski.io またはローカルの tableski にアップロードし、最初の質問をして、kowalski、Claude、Cursor を使って自然な言葉で次の質問をする方法を紹介します。ローカルでの一連の流れをまとめて試すには、./scripts/demo.sh を実行してください(スプレッドシート → 質問 → SQL の回答 →
エクスポートされたワークブック)。demo.tape は vhs で GIF に変換できます。
kowalski を使うと、自然な言葉で質問でき、回答はワークブックとして返ってきます。その Spreadsheet analyst が tableski を通してテーブルを分析し、モデルが質問ごとに 1 つの SQL クエリを作成します。すべての数値はクエリエンジンから得られます。
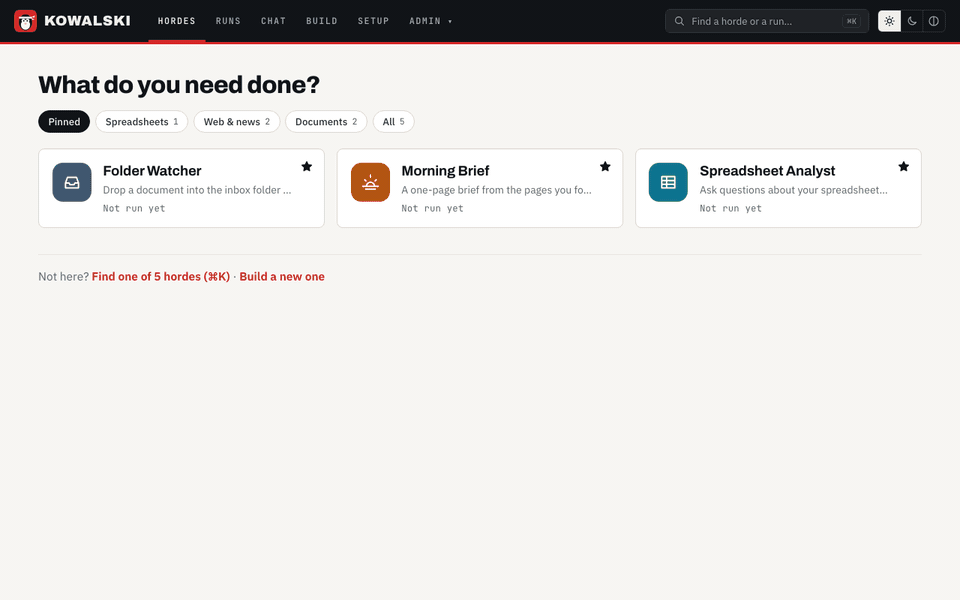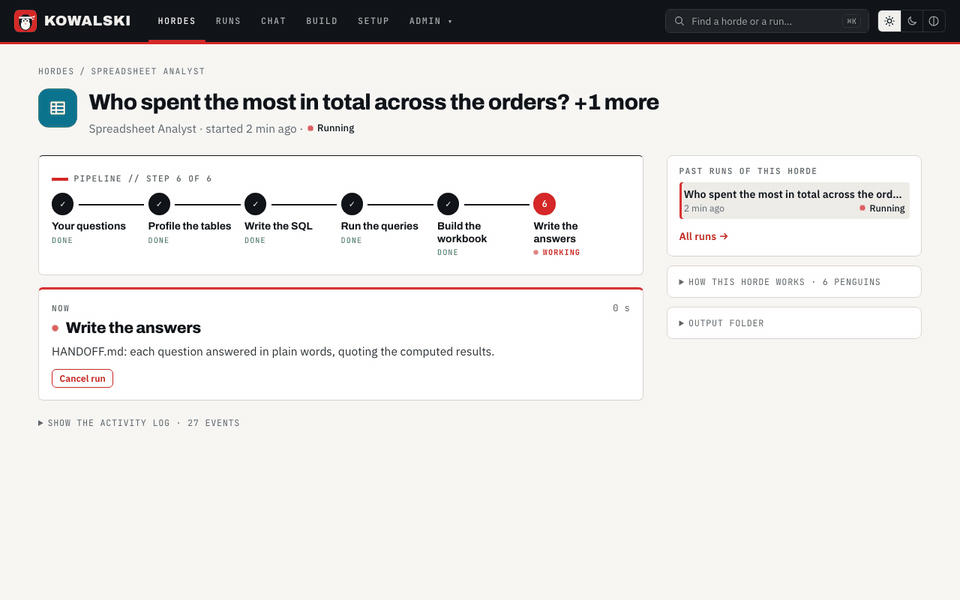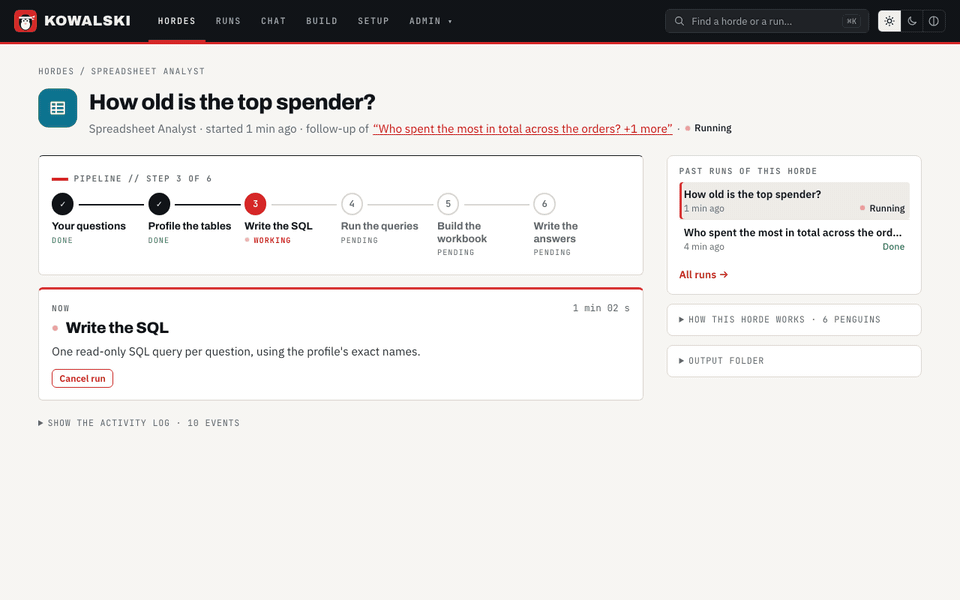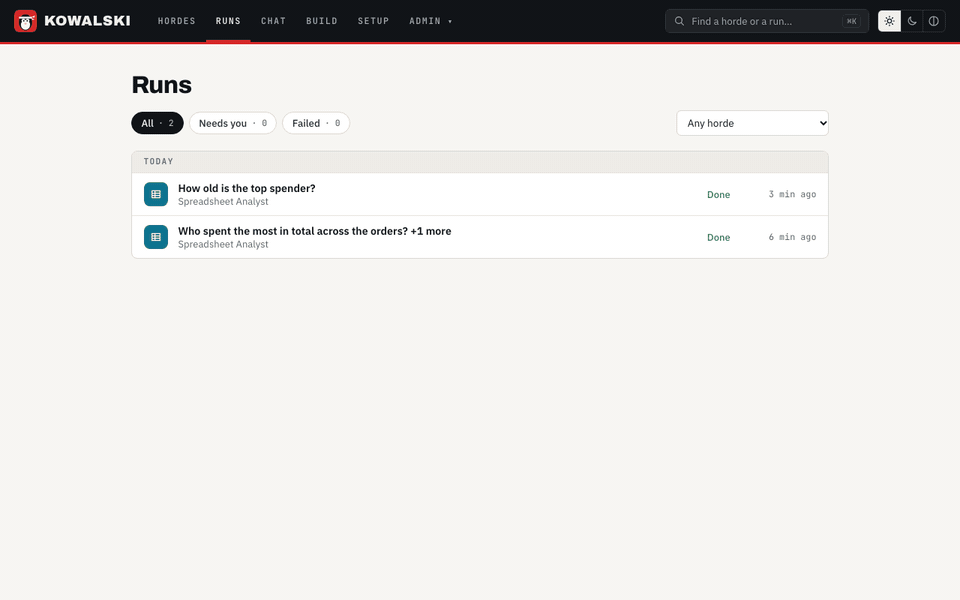
ステータス:CSV、Excel(xlsx/xls/ods。実際のワークブックに対応するよう強化済み)、Parquet、NDJSON はすべて現在利用できます。結果は csv/xlsx にエクスポートでき、バイナリはリリースごとに提供されます。サービスの公開は次の段階です。
信頼できないクライアントへの提供
デフォルトでは、tableski は DataFusion が受け付ける任意の SQL を実行します。これはローカルのシングルユーザー環境には適しています。管理下にないエージェントやユーザーからサーバーにアクセスできる場合は、--untrusted-sql を追加してください。
tableski --file sales.xlsx --untrusted-sql
これにより、実行されるのは読み取り専用のクエリのみになります。登録済みのテーブルに対する SELECT、WITH、VALUES、EXPLAIN に限られ、リクエストごとに1つのステートメントだけが実行されます。CREATE、INSERT、UPDATE、DELETE、DROP、COPY、SET、CREATE EXTERNAL TABLE、テーブル関数(read_csv(...)、range(...))、未登録のテーブルやファイルパスへの参照は、解析済みステートメント上で実行前に拒否され、その理由を示すエラーが返されます。二重の防壁として、DataFusion 独自の DDL/DML/ステートメント切り替えも無効になります。
制限
1つのクエリでマシンが停止することはありません。デフォルト値では、それぞれ 0 は無制限を意味します。
| フラグ | デフォルト | 制限する内容 |
|---|---|---|
--max-memory-mb | 2048 | セッションの DataFusion メモリープールです。これを超えるメモリーを必要とするクエリは、プロセスのメモリー使用量が増え続けるのではなく、Resources exhausted で失敗します。上限を設定するとディスクへのスピルは無効になるため、ディスクをいっぱいにするのではなく、速やかに失敗します。 |
--query-timeout-secs | 60 | プランニングを含む、クエリごとの実時間です。クエリは専用のスレッドプールで実行され、DataFusion の次のイールドポイントでキャンセルされます。その間もサーバーは応答を続けます。 |
--max-result-rows | 10000 | query_sql の結果として返される行数です。上限を超えると結果は切り詰められ、末尾に -- result truncated ... という行が付加されます。export_result は部分ファイルを書き出すのではなく、エラーになります。 |
--max-result-mb | 16 | Arrow のインメモリーサイズにも同じ制限が適用されます。 |
直積(CROSS JOIN、または = 条件のない結合)は、実行開始後にタイムアウトで停止できない唯一の形式です。そのため、--untrusted-sql は実行前のプラン上でこれを拒否します。
タイムアウトは実行だけでなくプランニングにも適用されるため、最適化だけでもコストのかかるステートメントは打ち切られます。このプールで計測されないものには、スカラー関数(repeat、lpad、…)が割り当てるメモリーがあります。信頼できないクライアント向けのサーバーは、tableski.io のデプロイと同様に、コンテナーのメモリー制限下で実行してください。すべての対策は tests/hostile_sql.rs(DDL/DML、ファイルシステムへのアクセス、識別子の細工、過負荷、パーサーへの負荷、エクスポート時のパストラバーサル)でテストされています。新しい問題のある形式を見つけたら、ここに行を追加してください。
ライブラリとして使用する
エンジンは独立したクレート tableski-core です。ファイルを DataFusion の SessionContext に登録し、call_tool でツールを実行するか、任意の emperor-mcp トランスポートを介して AppState を提供します。HTTP も CLI も必要ありません。
[dependencies]
tableski-core = "0.1"
let sources: Vec<Box<dyn TableSource>> = vec![Box::new(FileSource::new().path("orders.xlsx"))];
let tables = register_sources(&ctx, &sources, &IngestOptions::default()).await?;
let state = AppState::new(Arc::new(ctx), tables);
let grid = call_tool(&state, "query_sql", json!({ "sql": "SELECT count(*) FROM orders" })).await?;
テーブルは TableSource の実装から作成されます。FileSource はディスク上のファイルを扱います。ストリーミングや更新を行うソース(価格フィードや、内容が書き換えられるファイルなど)は同じトレイトを実装し、その状態を独自の DataFusion TableProvider 内に保持します。これにより、各クエリはプランニング時点で存在する行を参照できます。tableski_core::source のモジュールドキュメントには契約の詳細が記載されており、crates/tableski-core/tests/table_source.rs には追記型ソースの実装例があります。
テナントを持つサーバーでは、Quota と UsageMeter(1日あたりのクエリ数、保存バイト数、ファイル数、ファイルあたりの行数)を with_quota で同じ状態に組み込めます。メーターはメモリー上に保持されるため、使用量の永続化はホスト側で行います。
比較
率直な位置づけです。ツールによって解決する課題は異なります。
| tableski | openpyxl ベースの Excel MCP サーバー | Google-Sheets MCP | |
|---|---|---|---|
| データに関する質問 | SQL エンジン(DataFusion):シート間およびファイル形式をまたいだ結合、集計、フィルター | セル/範囲の読み取り。分析ロジックはモデルのコンテキストに委ねられます | ライブの Sheets に対する API 呼び出し |
| 形式 | xlsx/xls/ods + CSV + Parquet + NDJSON を、1 つのテーブルモデルで扱います | xlsx(多くの場合、読み取りと書き込みの両方に対応し、書式設定やグラフも含みます。tableski ではワークブックを編集できません) | Google Sheets のみ |
| デプロイ | 単一の静的バイナリ、ステートレスな Streamable HTTP(Emperor Profile P1) | Python ランタイムと依存関係 | ホスト型 API + OAuth |
| 出力の安全性 | すべてのツール結果をデータとして扱う形式で囲みます(プロンプトインジェクション対策) | 通常は生データ | 通常は生データ |
ワークブックの編集(スタイル、グラフ、セルへの書き込み)が必要な場合は、tableski と書き込みに特化したサーバーを組み合わせてください。tableski は分析とエクスポートのエンジンです。
貢献
CONTRIBUTING.md を参照してください。チェックを実行し、ドキュメントを最新に保ち、コミットに署名してください(DCO、git commit -s)。
ライセンス
以下のいずれかのライセンスが適用されます。
- Apache License, Version 2.0(LICENSE-APACHE または https://www.apache.org/licenses/LICENSE-2.0)
- MIT license(LICENSE-MIT または https://opensource.org/licenses/MIT)
ライセンスは任意で選択できます。
明示的に別途記載しない限り、tableski に含める目的であなたが意図的に提出したすべての貢献は、追加の条件を付けず、上記のライセンスのデュアルライセンスで提供されます。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。