BioMCP-TS について
BioMCP-TS は生物医学研究向けの MCP サーバーで、LLM に遺伝子、変異、薬剤、疾患、文献、臨床試験、生物学データのツールを提供します。任意でローカルデータの整備や解析を行うツールボックスも利用できます。
主な機能
- 01遺伝子と変異データの検索・取得
- 02薬剤、疾患、臨床試験の調査
- 03生物医学文献の横断検索
- 04ゲノム・構造生物学データの照会
- 05特許検索とジャーナル指標の確認
- 06任意のローカルデータ整備・解析ツールボックス
活用シーン
- 01遺伝子と疾患・薬剤の関連性の調査
- 02研究テーマに関する文献や試験の検索
- 03変異アノテーションとゲノム記録の確認
- 04生物医学研究に関連する特許の検索
MCP 対応
stdio MCP サーバーとして動作し、上流データベースや API を横断して生物医学研究ツールを MCP クライアントに公開します。
設定
ローカルサーバーの設定はどのクライアントでも共通です。コピーしてクライアントの MCP 設定ファイルに貼り付けてください。
npx -y biomcpANALYSIS_BIOWASMSet to 1 to enable the samtools/bedtools/bcftools biowasm analysis toolsANALYSIS_RSet to 1 to enable the R/Bioconductor analysis tools (requires the webr peer dependency; use the pinned one-shot client command)DB_TYPESet to mysql or sqlite to enable the read-only SQL database toolsNCBI_API_KEYシークレットHigher NCBI E-utilities rate limits (3 -> 10 req/s)S2_API_KEYシークレットHigher Semantic Scholar rate limitsOPENFDA_API_KEYシークレットHigher OpenFDA rate limitsONCOKB_TOKENシークレットRequired by the variant_oncokb tool (OncoKB annotations)DISGENET_API_KEYシークレットRequired for DisGeNET disease-gene associationsローカルサーバーにはマシン上の実行環境(Node.js 18 以上など)が必要です。設定ファイルの場所はクライアントごとに異なります。
ツール
41掲載時のツール一覧 · 2 週間前に更新
| パラメーター | 型 | 必須 | 説明 |
|---|---|---|---|
| query | string | はい | 検索する遺伝子のシンボル、名前、キーワード |
| chromosome | string | いいえ | 染色体で絞り込みます(例:“7”、“X”) |
| limit | integer | いいえ | 最大結果数 |
| offset | integer | いいえ | 結果オフセット |
詳細
BioMCP


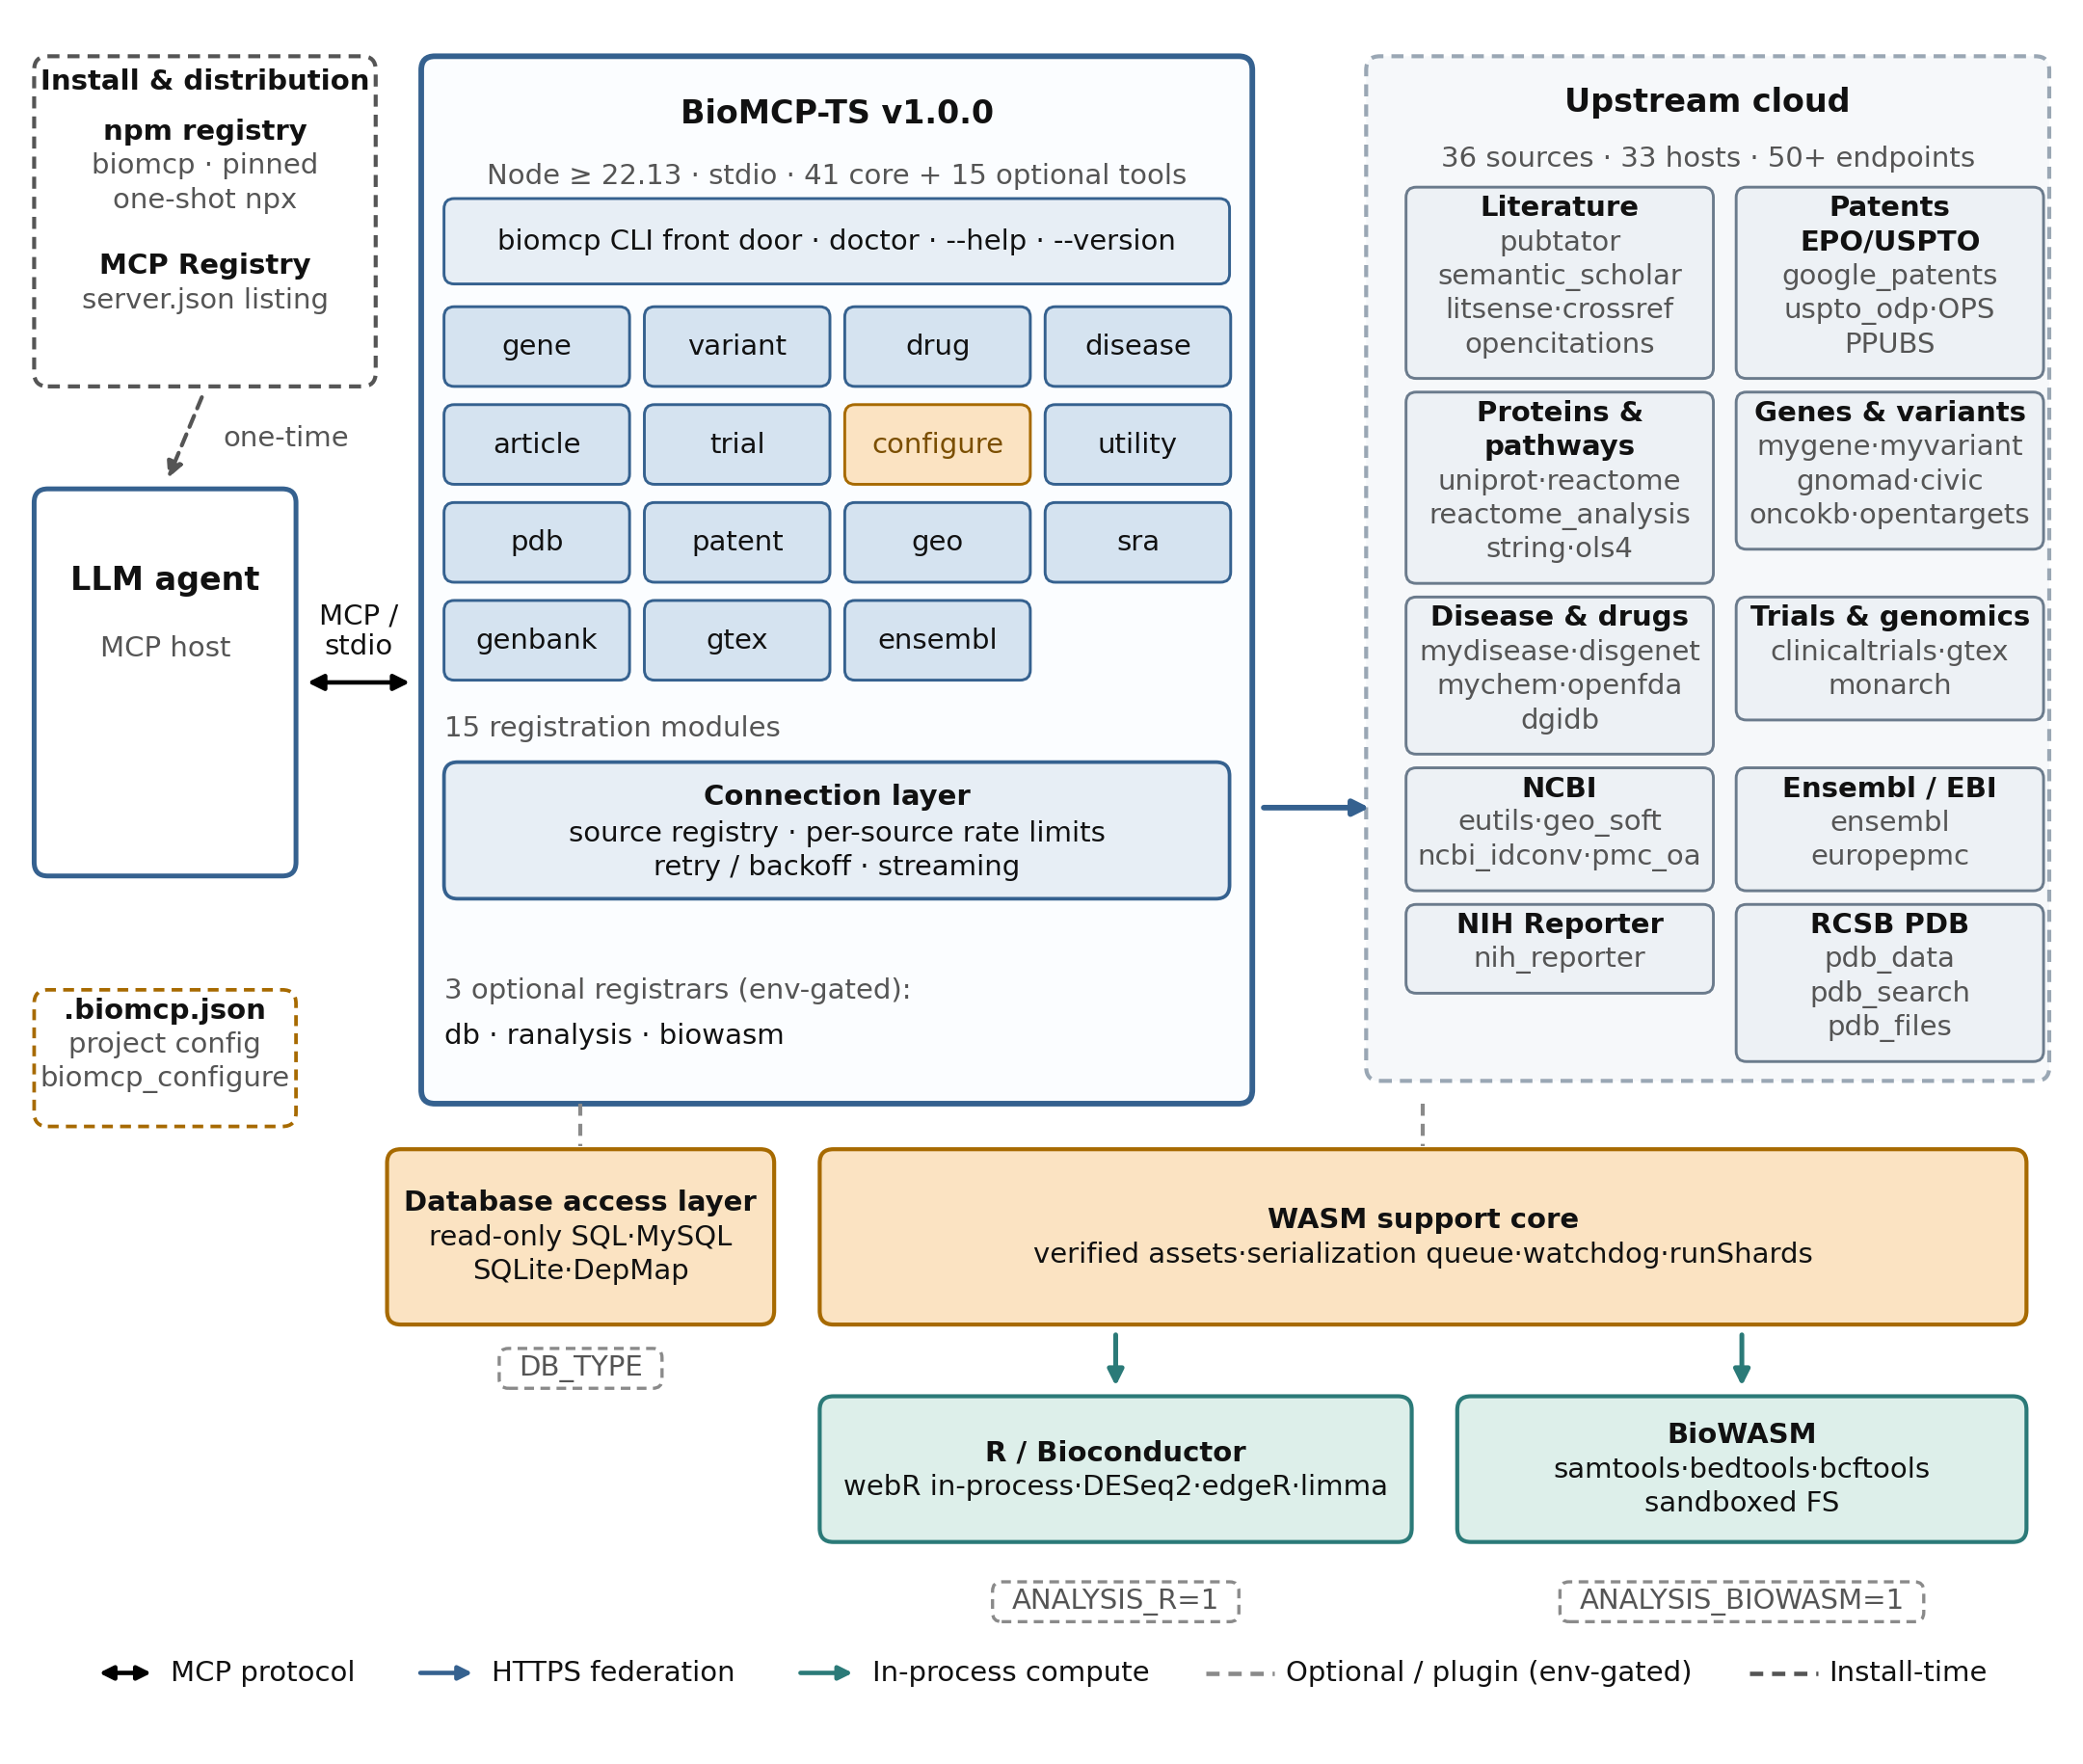
特長
バイオインフォマティクスおよびバイオ医薬品のデータベースや解析へのエージェントによるアクセスを、誰もが利用できるようにします。
- セクションベースのフェデレーションアクセスにより、50 以上のバイオインフォマティクス、製薬、特許データベースを利用できます
- ローカルデータベースのキュレーションや、Bioconductor および SAM/BED/BCFtools による依存関係不要の解析に使えるオプションのツールボックス(R のインストール、C ツールチェーン、コンテナは不要です)
- 完全にオープンな形で開発された、具体的な例を示すビネット
インストール
npx -y biomcp doctor   # diagnose a machine: Node gate, config health, feature gates, peer deps
npx biomcp             # zero-config stdio MCP server (this is what MCP clients run); Node >= 22.13
セットアップはdocs/AGENT-INSTALL.mdでガイドされています — 1 分で始められ、Claude Desktop、Claude Code、Codex、OpenCode 用の設定項目をコピー&ペーストできます(すべての機能を網羅する、固定された単一の標準コマンドを使用)。トラブルシューティングの窓口は biomcp doctor に一本化されており、API キーやオプション機能の利用に適したエージェント向けの手順も用意されています。
1 台のマシンで複数のエージェントを実行する場合: biomcp は、プロセスごとに arXiv の利用規約によるレート制限(3 秒あたり 1 リクエスト)を適用します。1 台のマシンで複数の biomcp MCP インスタンスを実行する場合(たとえば、エージェントごとに stdio インスタンスを 1 つ実行する場合)、プロセス間でレート制限は調整されず、arXiv の利用規約は利用するすべてのマシンを合算したリクエスト数に適用されます。1 台のマシンで複数エージェントを運用する場合は、単一の共有 biomcp serve デーモンを実行してください(docs/SELF-HOSTING.mdを参照)。すべてのエージェントが 1 つのプロセスとグローバルなレートリミッターを共有できます。
利用可能なツール
ツールの完全なスキーマ(パラメーター、列挙値、デフォルト値)は src/server/README.md にあります。
Gene(7)
| ツール | 説明 |
|---|---|
gene_search | 染色体フィルターを使って、シンボル、名前、キーワードから遺伝子を検索します |
gene_get | HGNC シンボルから遺伝子の詳細情報を取得します。セクション(core、pathways、protein、ontology、go、interactions、expression、protein_atlas、constraint、druggability、dosage_sensitivity、clinical_evidence、disease_associations、diseases、funding)を指定できます。smart=true を設定すると、遺伝子の別名を自動解決します(例:「HER2」→「ERBB2」) |
gene_diseases | 遺伝子に関連する疾患を取得します(DisGeNET / OpenTargets) |
gene_drugs | 遺伝子を標的とする薬剤を検索します(OpenTargets。エンベロープ { results, warnings?, errors? } を返します。OpenTargets の失敗や解決できない遺伝子は errors[] に格納され、インラインの行として返されることはありません) |
gene_trials | 遺伝子に関する臨床試験を検索します |
gene_articles | 遺伝子に関する論文を検索します(PubMed、EuropePMC、Semantic Scholar、arXiv、PubTator、LitSense にまたがるフェデレーション検索。エンベロープ { results, warnings?, errors? } を返し、バックエンドごとの失敗は errors に格納されます) |
gene_enrich | 遺伝子リストのパスウェイ濃縮解析を行います(Reactome) |
バリアント(4)
| ツール | 説明 |
|---|---|
variant_search | rsid、HGVS、遺伝子、ClinVar の臨床的意義、頻度、CADD でバリアントを検索します |
variant_get | セクション(頻度、予測、臨床情報。alphagenome_scores は再実装待ちのため、現在は利用不可エラーを返します)を任意で指定して、バリアントの詳細情報を取得します |
variant_oncokb | OncoKB のがんバリアント注釈を取得します(ONCOKB_TOKEN が必要です) |
variant_trials | バリアントの臨床試験を検索します |
医薬品(3)
| ツール | 説明 |
|---|---|
drug_search | 名前、作用機序、またはキーワードで医薬品を検索します(エンベロープ { results, hint? } — 一致するものがない場合、hint は作用機序や標的の検索を gene_drugs に案内します) |
drug_get | セクション(米国規制情報、WHO 規制情報、安全性、標的、適応症、有害事象 — FDA FAERS の副作用は報告件数順。WHO PQ 掲載情報の照会では、世界保健上の優先製品約 650 件を対象)を任意で指定して、医薬品の詳細情報を取得します |
drug_trials | 医薬品の臨床試験を検索します |
疾患(4)
| ツール | 説明 |
|---|---|
disease_search | 名前、表現型、またはキーワードで疾患を検索します(エンベロープ { results, warnings?, errors? }) |
disease_get | ID(DOID、MONDO、OMIM など)で疾患の詳細情報を取得します。セクション(遺伝子関連、表現型、経路)を任意で指定できます |
disease_drugs | 疾患に対応する医薬品を取得します(OpenTargets、エンベロープ { results, warnings?, errors? } — OpenTargets の失敗や解決できない疾患は errors[] に含まれ、インライン行として表示されることはありません) |
disease_trials | 疾患の臨床試験を取得します(ClinicalTrials.gov、エンベロープ { results, warnings?, errors? }) |
論文(4)
| ツール | 説明 |
|---|---|
article_search | PubMed、EuropePMC、Semantic Scholar、arXiv、PubTator、LitSenseを横断する文献検索です。任意の日付範囲で絞り込めます。source: "preprint_only"に切り替えると、bioRxivとmedRxivのプレプリントのみを対象に検索します(抄録、引用数、日付による絞り込み)。検索結果にはjournal_issnが含まれます |
article_get | 識別子(PMID、PMCID、DOI、bioRxiv/medRxivプレプリントDOI)を指定して論文の詳細情報を取得します。任意のセクションを指定できます。fulltext(PMC/Europe PMCで無料で閲覧できる論文の全文。オープンアクセスかつ無料で読める論文が対象です。デフォルト(fulltext_output="file")ではサーバー側のMarkdownファイルに書き込まれ、応答にはfile_pathと、選択的なRead/Grepに使える行番号および文字数付きの見出し一覧が含まれます。本文はエージェントのコンテキストに含まれません。fulltext_output="inline"では、fulltext_max_charsで上限を指定したテキストセクションを返します。デフォルトは40000です)、oa(オープンアクセス/ライセンスのメタデータとリンク。ステータスはopen_access/free_to_read/paywalled/not_in_pmc/unknown、ライセンス、PMC/PDF/DOIリンク)、annotations、graph(引用グラフ)、citation(高速または完全な引用データ。プレプリントの引用データはEurope PMCから取得)。allには全文が含まれません。プレプリントのレコードには、すべてのバージョン、ライセンス、カテゴリ、資金提供者、JATS全文URL(リンクのみ。本文の取得にはpreprint_fulltextを使用)、公開済みバージョンとの対応情報が含まれます。レコードにはjournal_issnが含まれます |
preprint_fulltext | bioRxiv/medRxivプレプリントの全文をオンデマンドで取得します(JATS XMLをセクションに解析)。プレプリントDOIで指定し、バージョンも任意で指定できます(デフォルトは最新)。厳密なオンデマンド取得のため、検索中に実行されることはありません。ダウンロードは間隔を空けて行われ(3秒以上)、(DOI、バージョン)ごとにキャッシュされます(JATSはバージョンごとに不変です)。ライセンスも考慮され、cc_byの場合はすべての応答にcc byとCC URLが含まれます(再利用の可否は論文ごとのライセンスに従います)。www.biorxiv.orgでは頻繁にレート制限が行われます。429/Cloudflare判定が発生すると、すべてのダウンロードを60秒以上停止し(Retry-Afterを遵守)、クールダウン中の呼び出しにはretry_after_secを含む正確なrate_limitedエンベロープを返します。キャッシュ済みのコピーは即座に引き続き提供されます。output="file"(デフォルト)ではサーバー側のMarkdownファイル(file_pathと見出し一覧)に書き込み、output="inline"では上限付きのセクション(fulltext_max_chars)を返します。コーパス規模の利用には、bioRxiv/medRxivの月次S3バケットを使用してください(https://www.biorxiv.org/tdm) |
journal_metrics | OpenAlexによる学術誌の品質指標(2年間の平均被引用度 — オープンアクセスのインパクトファクター代替指標)、h-index、品質リストを、誌名、NLM略称、ISSNで取得します |
臨床試験(2)
| ツール | 説明 |
|---|---|
trial_search | 疾患、介入、ステータス、フェーズで臨床試験を検索します。page_tokenを使ったカーソルベースのページネーションに対応しています |
trial_get | NCT IDを指定して臨床試験の詳細情報を取得します。適格基準、実施場所、結果などのセクションを任意で指定できます |
ユーティリティ(2)
| ツール | 説明 |
|---|---|
discover | すべてのエンティティタイプを対象に、フリーテキストから概念を特定します |
batch_get | 複数のエンティティを並列で取得します |
構造生物学(1)
| ツール | 説明 |
|---|---|
pdb | PDB構造を検索し、任意のセクション(ポリマーエンティティ、リガンド、アセンブリ、実験、引用情報)を含むエントリのメタデータを取得し、構造ファイル(mmCIF/PDB)をダウンロードします |
特許(2)
| ツール | 説明 |
|---|---|
patent_search | 世界各国の特許(US、EP、WO、JP、100 以上の管轄機関)を、譲受人/発明者/CPC/ステータス/日付によるフィルターと関連度順ランキング(sort_by)を使って検索します。複数語の概念を完全一致で検索するには引用符で囲みます(例:「flow cytometry」)。基礎となる先行技術は、共引用マイニングによって自動検出されます(seminal_prior_art。seminal: false で無効化)。デフォルトのバックエンドは、USPTO Public Search の全文検索(US、キー不要、関連度順)と EPO OPS(世界各国、キーが必要)です。source で指定できるバックエンドとして、uspto_odp(US の書誌メタデータ)と google_patents(ベストエフォート)も利用できます |
patent_get | 公開番号を指定して特許の詳細を取得します。セクションは、要約、請求項(USPTO Public Search 経由の US 全文テキスト。EP/WO は設定済みの場合は EPO OPS、そうでない場合は Google Patents のページ)、引用(前方+後方)、ファミリー、分類です |
GEO(2)
| ツール | 説明 |
|---|---|
geo_search | NCBI GEO で、エントリータイプ(GSE/GSM/GPL/GDS)と生物種を指定して、機能ゲノミクス研究(発現マイクロアレイ、RNA-seq、単一細胞シリーズ)を検索します。結果には、連携に使える相互リンク(bioproject、pubmed_ids、NCBI が SRA 研究にリンクしている場合は sra_project。リンクしていない場合は geo_get の sra フィールド)が含まれます |
geo_get | GEO のシリーズ/サンプル/プラットフォームの SOFT レコード全体を取得します。概要、生物種、サンプルのプレビュー(≤20)、補足ファイルの URL、相互参照が含まれ、オプションで最初の補足ファイルをダウンロードできます。キュレーション済み DataSet である GDS の場合は、レコードの代わりに、元の GSE/GSM を示す構造化されたガイダンス({ accession, guidance, see_also: { series, sample } })を返します |
SRA(2)
| ツール | 説明 |
|---|---|
sra_search | NCBI の Sequence Read Archive で、フリーテキスト、アクセッション、またはフィールド構文を使ってシーケンシング実験とランを検索します。ライブラリ戦略とラン数を含む、実験/研究/サンプルのアクセッションを返します |
sra_get | SRA アクセッションの詳細を取得します。ラン(SRR/ERR/DRR:機器、スポット、塩基、サイズ)、実験(SRX/ERX/DRX:ライブラリ設計)、研究(SRP/ERP/DRP:実験リスト)、またはサンプル(SRS/ERS/DRS)に対応します。NCBI SRA では、NCBI、ENA、DDBJ のアクセッションを同様にインデックス化しています |
GenBank(3)
| ツール | 説明 |
|---|---|
genbank_search | NCBI のヌクレオチドレコード(GenBank/RefSeq/INSDC)を、通常の検索語、アクセッション、またはフィールド構文で検索します。結果には accession.version、定義、長さ、生物種、トポロジーが含まれます |
genbank_get | GenBank/RefSeq レコードを GenBank フラットファイルまたは FASTA として取得します。レコード全体の上限は 2 Mb です。これを超えるレコードには seq_start/seq_stop で領域を指定する必要があります(最大 10 Mb。strand=2 で逆鎖を指定) |
genbank_genes | GenBank/RefSeq アクセッションを NCBI Gene ID に対応付け(elink nuccore→gene)、遺伝子ツールとの連携に使います |
GTEx(2)
| ツール | 説明 |
|---|---|
gtex_expression | GTEx の組織全体にわたる遺伝子発現の中央値を取得します(Analysis v10、54 の組織部位、TPM、高い順)。HGNC シンボルまたは Ensembl 遺伝子 ID を指定でき、単一組織によるフィルターも任意で指定できます |
gtex_eqtl | GTEx の特定組織(v10)における、遺伝子の有意な cis-eQTL 関連を取得します。variant_id、p_value、NES、slope を含み、p 値の昇順で並べます |
Ensembl(4)
| ツール | 説明 |
|---|---|
ensembl_lookup | 約356種のいずれかについて、Ensembl 用語で遺伝子を特定します。安定 ID(+バージョン)、シンボル、現在のアセンブリ上の座標、代表的な転写産物を返します。expand=true を指定すると、翻訳 ID/タンパク質 ID を含む転写産物が追加されます |
ensembl_homology | Ensembl Compara を介して種間のオルソログ/パラログを検索します。対象の安定 ID、分類階級、配列一致率を返し、一致率順に並べます。target_species/target_taxon で絞り込みます |
ensembl_consequence | NOVEL 変異およびヒト以外の種について、Ensembl VEP を介して変異の影響をオンデマンドで計算します。最も重大な影響、転写産物ごとの影響(SIFT/PolyPhen)、同じ位置にある ClinVar/COSMIC/gnomAD のデータを返します。既知のヒト変異については、variant_get でより詳細な事前計算スコアを取得できます。精度を高めるため、rsID より HGVS 入力を推奨します |
ensembl_region | 現在のアセンブリ上のゲノム領域(chr:start-end)にある遺伝子/転写産物/既知の変異を検索します(遺伝子座のトリアージ) |
R 解析(4、オプション — ANALYSIS_R=1)
| ツール | 説明 |
|---|---|
analysis_r_deseq2 | サンドボックス化された WebAssembly R で、Bioconductor DESeq2 を使用して RNA-seq カウントの差次的発現解析を行います(負の二項分布、独立フィルタリング、オプションの LFC 縮小)。入力:整数カウント行列+サンプルメタデータ+デザイン式。出力:調整済み p 値の上位遺伝子をまとめた Markdown テーブル(全件を含む base64(gzip(TSV)) テーブルを取得するには、format="json"、include_full=true を指定) |
analysis_r_edger | edgeR で差次的発現解析を行います。TMM 正規化、経験ベイズ分散推定、準尤度 F 検定(test="qlm")または2群の正確検定を使用します。入出力の仕様は同じです |
analysis_r_limma | limma-voom で差次的発現解析を行います。精度重み付き線形モデルと経験ベイズによるモデレーションを使用します。入出力の仕様は同じです |
analysis_r_session_info | R ランタイムのレポートです。R/webR のバージョン、インストール済みパッケージのバージョン、メモリ、ミラーのエンドポイントを表示し、解析の問題の診断に役立ちます |
初回の使用時に、約1 GB の WebAssembly R ワーカーが起動し、wasm パッケージバンドル(約62 MB)が GitHub リリースからダウンロードされます(キャッシュされます)。biomcp の隣に webr がインストールされている必要があります。ガイド:docs/R-ANALYSIS.md。
Biowasm 分析(8 件、オプション — ANALYSIS_BIOWASM=1)
| ツール | 説明 |
|---|---|
analysis_bam_summary | アラインメント(SAM/BAM/CRAM)を調査します。ヘッダーの contig、サンプル/リードグループ、flagstat によるマッピング指標、インデックスがある場合は idxstats による contig ごとのカウントを確認できます。領域を処理する前に「この BAM には何が含まれているか」を把握できます |
analysis_bam_view_region | ゲノム領域内のリード、深度、pileup、またはリード抽出に対応します(samtools view/depth/mpileup)。インデックス付きのソースは高速な位置検索を使用し、インデックスのないソースは BED フィルターをストリーミングします(深度の計算には座標順にソートされた入力が必要で、順序違反を検出します)。カウント、カバレッジ表、SAM 行、または BAM アーティファクトを返します |
analysis_bcf_summary | VCF/BCF を調査します。contig、サンプル数と名前、ヘッダー内の INFO/FORMAT フィールド一覧を確認できます |
analysis_bcf_view_region | 領域内のバリアントを、対象フィールドに絞って取得します(bcftools query)。選択する列、サンプルのサブセット、式フィルター、バリアント型を指定できます。または、切り出した VCF.gz アーティファクトを取得できます |
analysis_bed_op | BED トラックに対する区間演算(bedtools intersect/merge/subtract/coverage/jaccard/sort)に対応します。ソート済みの入力には、ストリーミング方式の -sorted アルゴリズムを使用します |
analysis_biowasm_convert | フォーマット変換を行います。samtools view による SAM/BAM/CRAM の変換、bcftools view による VCF/BCF の変換、bcftools query による VCF/BCF → TSV の変換に対応します。結果は artifact_id として再利用できるアーティファクトハンドルです |
analysis_biowasm_session_info | Biowasm ランタイムのレポートを表示します。固定されたツールのバージョン、アセットキャッシュの状態、エンジンのステータス、保持されているアーティファクト、メモリを確認できます |
analysis_biowasm_cli | 制約付きの代替手段です。許可リストに登録された samtools/bedtools/bcftools のサブコマンドを、スキーマ検証済みの引数で実行します(シェルは使用せず、パスは /shared 配下に限定) |
初回の使用時に、チェックサム検証済みの wasm アセット(約 4.5 MB)がダウンロードされ、キャッシュされます。追加の npm パッケージは不要です。インデックス付きのソースでは、領域クエリに高速な位置検索を使用し(ファイルの約 0.2 % を読み込みます)、インデックスのないソースでは BED フィルターをストリーミングします。ガイド:docs/BIOWASM-ANALYSIS.md。
引用モジュール
引用は、5 つのプロバイダーから情報を集約し、高速モード(約 4 秒)または完全モード(約 15~30 秒)で取得できます。被引用文献の一覧は Europe PMC、OpenCitations、Semantic Scholar から取得し、Crossref は件数と後方参照を提供します。プロバイダーの対応表とスキーマの詳細:src/server/README.md。
オプション機能
パッケージに含まれていますが、有効にするまで無効な機能です。それぞれのガイドをご覧ください。
| 機能 | 有効化 | ガイド |
|---|---|---|
データベースアクセス — MySQL とローカルファイルの SQLite 用の読み取り専用 SQL ツール(db_query、db_list_tables、db_describe_table) | DB_TYPE(および接続用環境変数)を設定します。MySQL では mysql2 のピア依存パッケージが必要です。固定バージョンを指定したワンショットのクライアントコマンドを使用してください(docs/DATABASE.md を参照)。 | docs/DATABASE.md |
R 解析 — サンドボックス化された WebAssembly R で DESeq2/edgeR/limma を実行する、Bioconductor による差次的発現解析(analysis_r_deseq2、analysis_r_edger、analysis_r_limma、analysis_r_session_info)。wasm パッケージは初回使用時に GitHub リリースからダウンロードされます(約 62 MB、キャッシュされます。接続が遅い場合は asset_timeout_ms または独自に取得した mirror_url を使用してください)。 | ANALYSIS_R=1 を設定します。webr のピア依存パッケージが必要です。固定バージョンを指定したワンショットのクライアントコマンド ["npx","-y","-p","[email protected]","-p","[email protected]","biomcp"] を使用してください(全機能版では -p mysql2@3 を追加します)。RSS は約 1 GB を想定してください。 | docs/R-ANALYSIS.md |
| Biowasm 解析 — サンドボックス化された WebAssembly で samtools/bedtools/bcftools(BAM/BED/VCF)を実行します。実際のヒト規模データセットをストリーミング/インデックス化します(BAM のスキャンは約 300 MB、領域クエリが読み取るのはファイルの約 0.2%です)。アセットは初回使用時にキャッシュされ、約 4.5 MB です。追加の npm パッケージは不要です。 | ANALYSIS_BIOWASM=1 を設定します。 | docs/BIOWASM-ANALYSIS.md |
環境変数の設定ブロックを手作業で編集する代わりに、エージェント(およびユーザー)は常に利用可能な biomcp_configure ツールを使って自分で設定できます。このツールは、すべてのパラメーターの状態と値の出所を報告し、上記のオプション機能用のプロジェクト設定ファイル .biomcp.json を書き込みます(環境変数が優先されます。環境変数のみで設定するパラメーターは照会専用で、値はマスクされます)。また、変更の検証、競合の検出、ピア依存パッケージの前提条件の確認を行い、再起動と検証の手順を明示します。詳細:docs/ENV-VARS.md → プロジェクト設定ファイル。
ドキュメント
| ドキュメント | 内容 |
|---|---|
| docs/AGENT-INSTALL.md | インストールとクライアント設定のガイド(Claude Desktop、Claude Code、Codex、OpenCode) |
| docs/ENV-VARS.md | すべての環境変数をまとめた唯一の参照元 |
| docs/DATABASE.md | データベースアクセス機能ガイド |
| docs/R-ANALYSIS.md | R 解析機能ガイド(WebAssembly 上の Bioconductor) |
| docs/BIOWASM-ANALYSIS.md | Biowasm 解析機能ガイド(WebAssembly 上の samtools/bedtools/bcftools) |
| docs/DEVELOPMENT.md | ビルド、テスト、公開のワークフロー |
| docs/development/CI.md | CI パイプライン、Dependabot による自動化、自動マージの安全モデル |
| src/server/README.md | ツールスキーマの全容(パラメーター、列挙値、デフォルト値) |
| agent-test/README.md | 解析ツールのユーザーエージェント向け E2E テスト |
ライセンス
Apache License, Version 2.0 の下でライセンスされています。著作権表示については NOTICE をご覧ください。
BioMCP-TS は、エージェントを第一に考えた開発アプローチと機能強化を加え、上流の BioMCP Rust プロジェクト(MIT)を基にしています。オリジナルの作者に感謝します。
コメント
AI アプリケーションが外部のツールやデータソースに統一的な方法で接続するためのオープンなプロトコルです。クライアントはモデルとの対話を担い、MCP サーバーはツール・リソース・プロンプトテンプレートを提供します。標準メッセージでやり取りするため、1 つのサーバーを複数のクライアントで再利用できます。