关于 defluff
defluff 是用于检查 LLM 文本中填充语、套话、模糊措辞和行话的确定性文本检查器,适合写作者、Agent 和 CI 流程。它无需模型或 API 密钥,可配置词库并返回可复现的评分与命中位置。
主要功能
- 01检测填充语及常见套话
- 02输出归一化密度评分和命中位置
- 03支持自定义词库及项目覆盖
- 04提供领域词组包和类别过滤
- 05支持 CLI、Python API 与 CI
- 06提供 MCP 文本检查工具
适用场景
- 01在 Agent 返回草稿前检查措辞
- 02阻止 CI 发布包含过多填充语的文档
- 03为编辑标出可删减的具体短语
- 04比较不同草稿的填充语密度
MCP 相关
MCP 服务提供 slop_detect、slop_add 和 slop_ignore 工具,使 MCP Agent 能检查文本并调整个人或项目词库。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
defluff
用于检测 AI 生成文本中冗余套话的确定性检查工具。将它用于变更日志、文档或 Agent 自己的输出,即可找出应删掉的填充语——还能获得 CI 退出码和可固定的评分,每次运行的结果都完全一致。无需模型,无需 API 密钥。


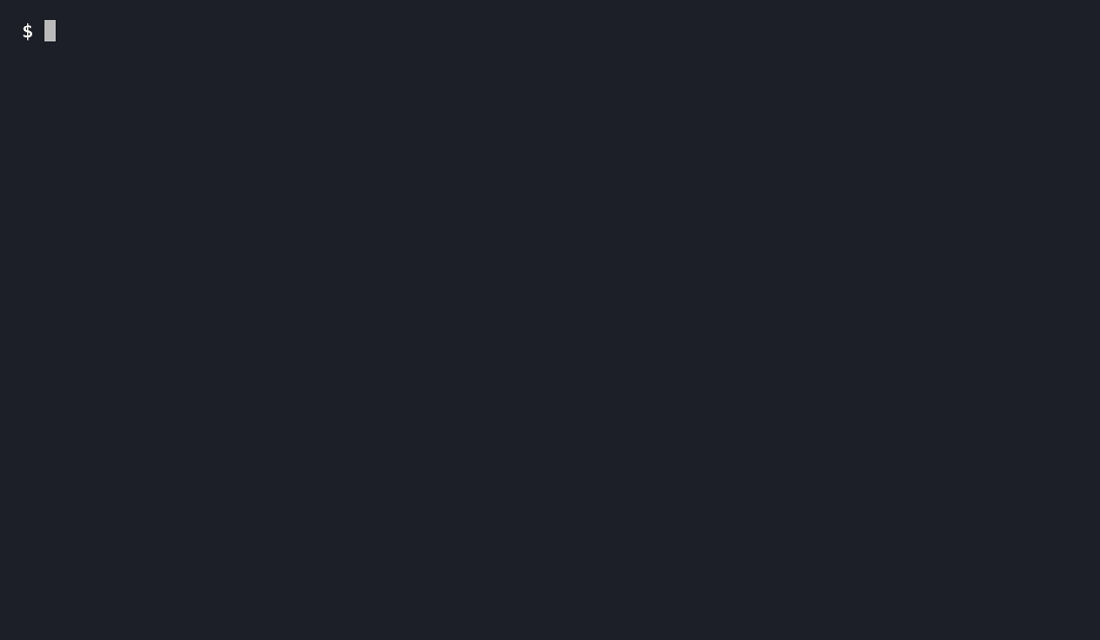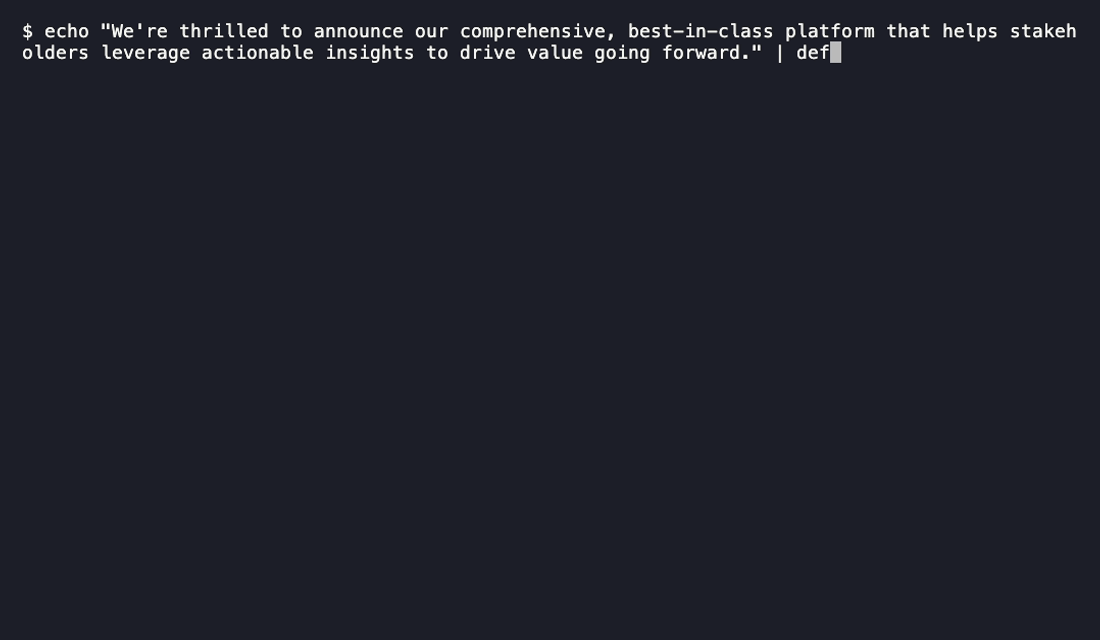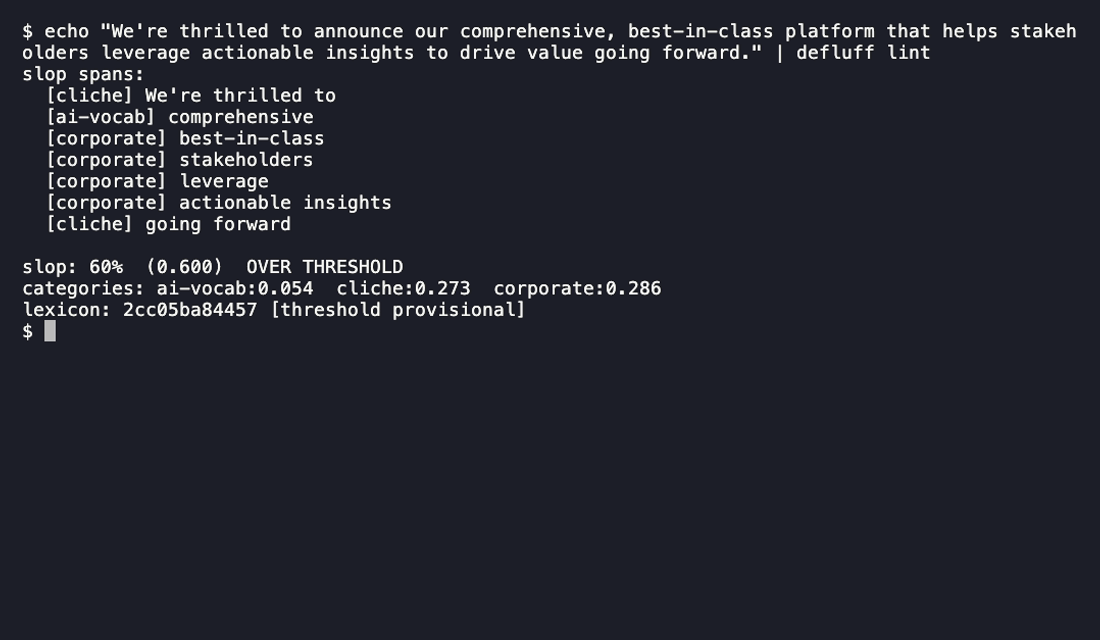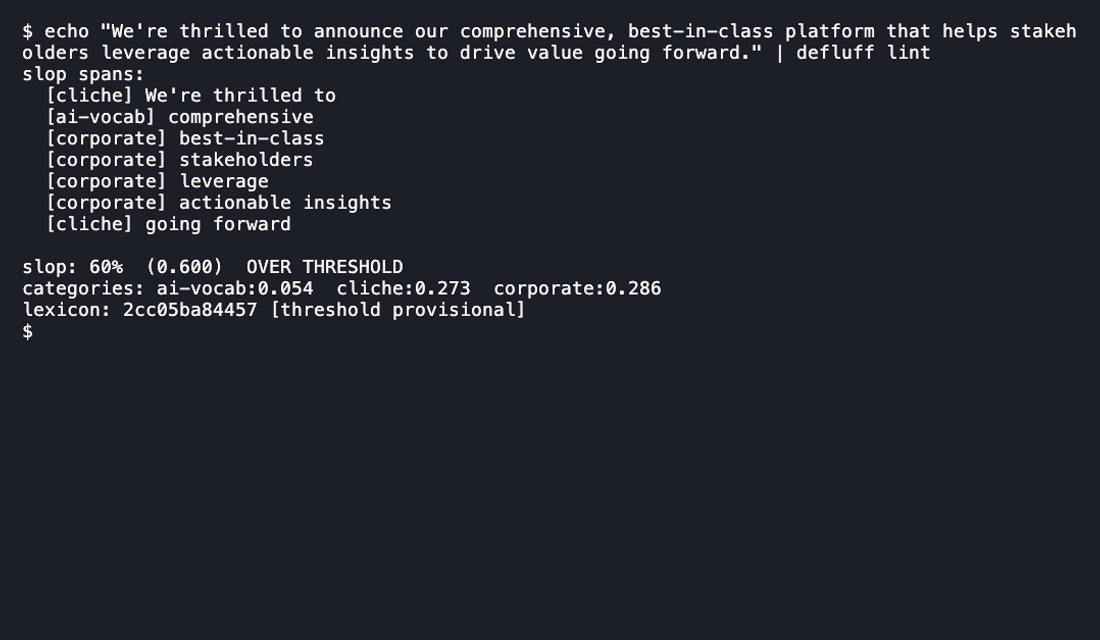
每个被标记的片段都不包含任何信息,因此删掉它们不会损失任何内容。干净的文本也使用同一工具,检查后直接通过:
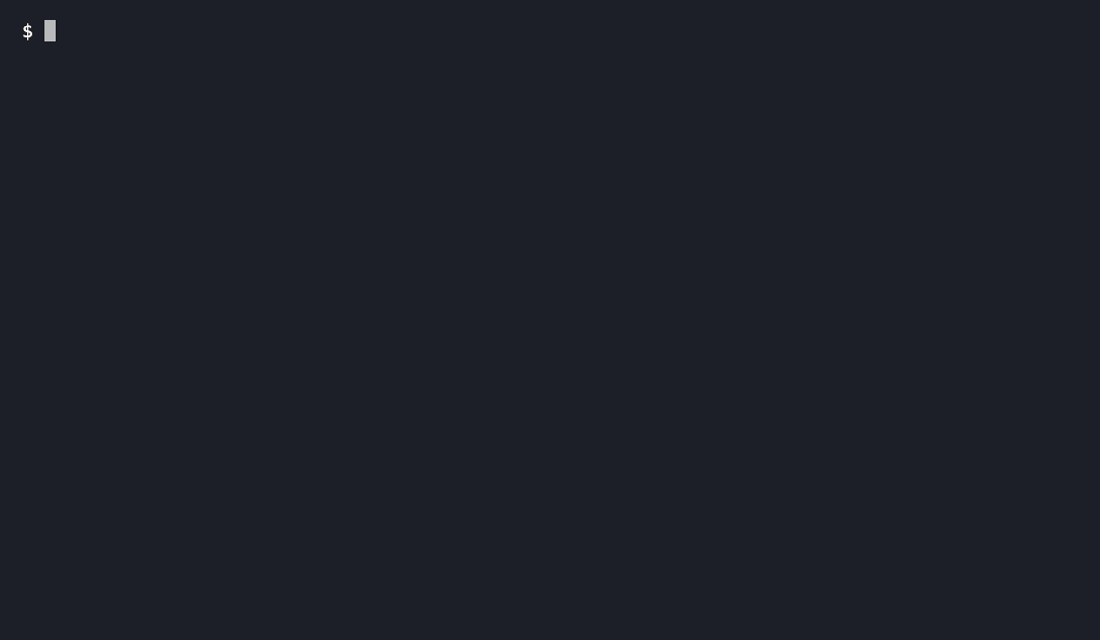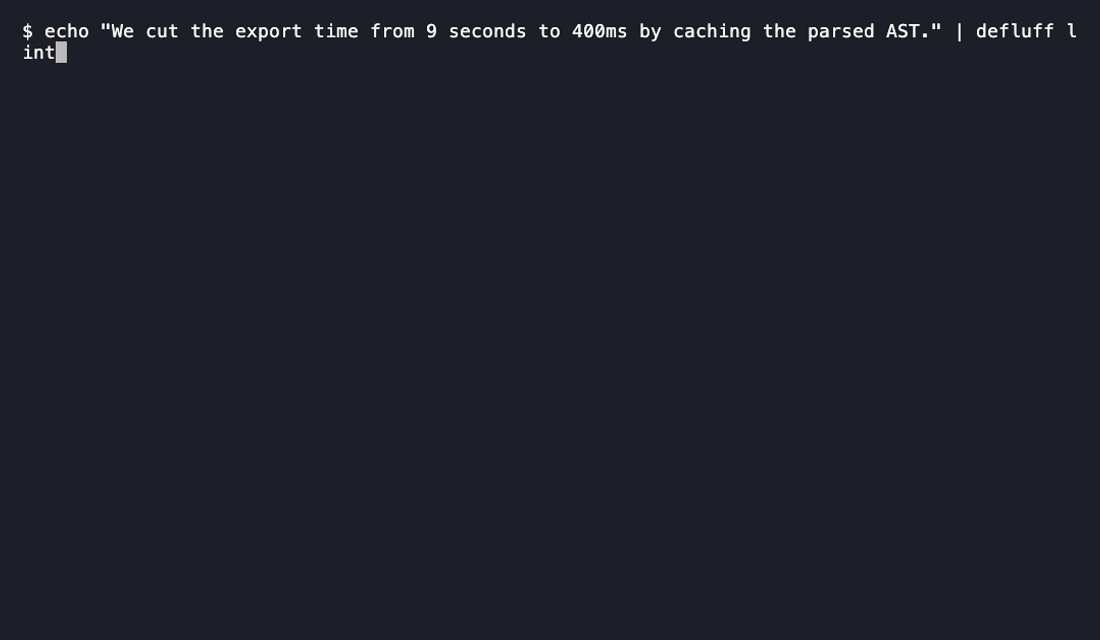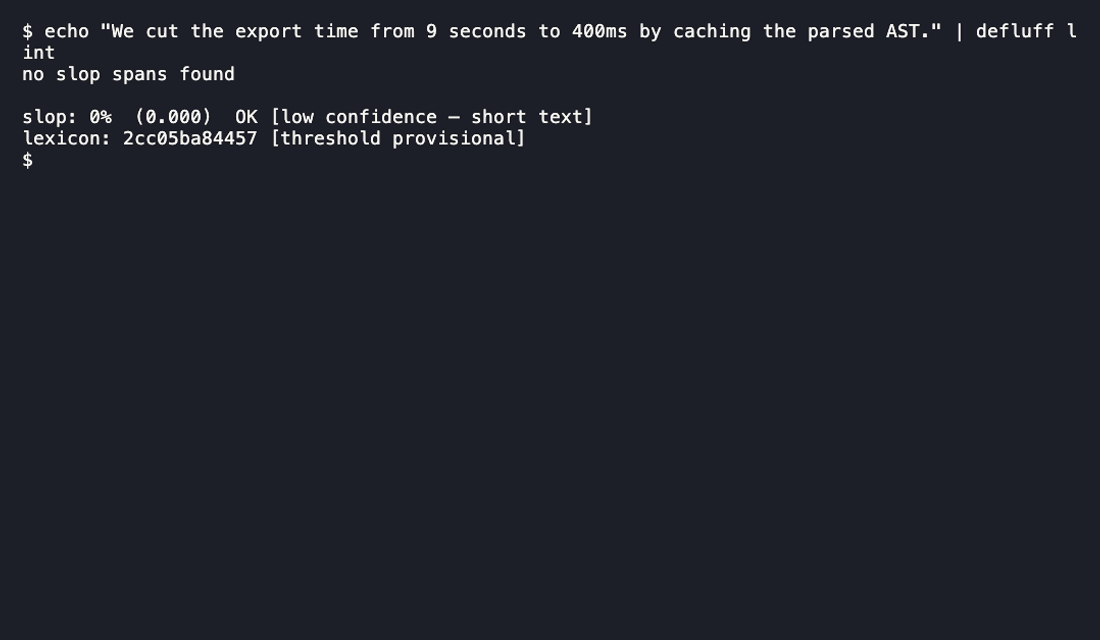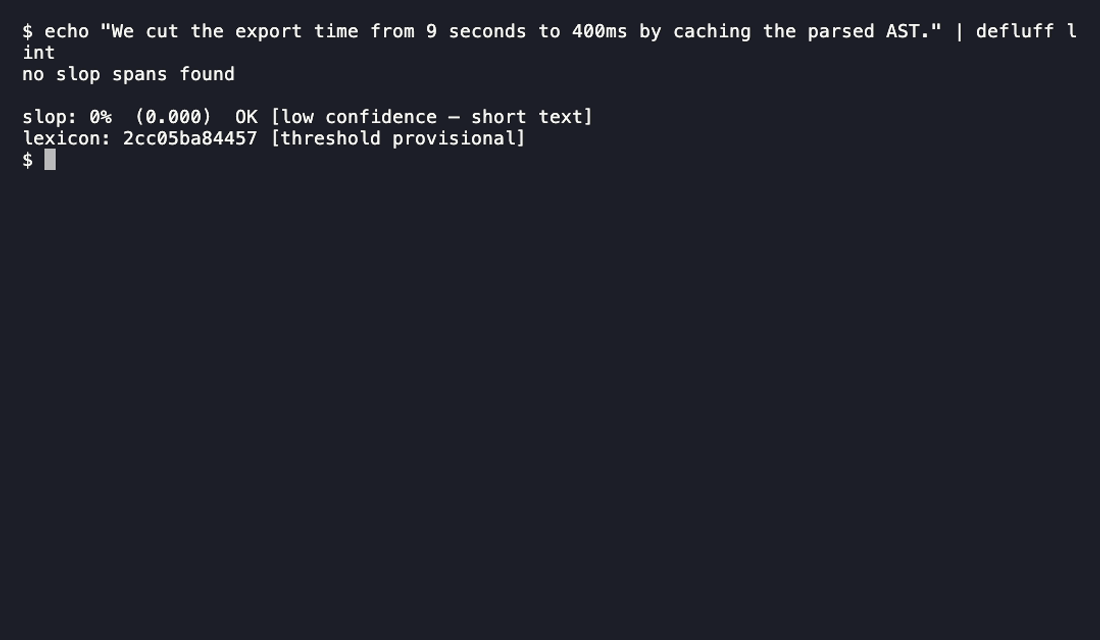
与一次性使用 grep 相比,defluff 值得安装的原因在于词表之外的引擎:你可以添加自己的短语、设置项目专属叠加词表,还能使用 MCP 服务,让 Agent 无需额外配置即可发现并使用它。
安装
pip install defluff
或者在 macOS/Linux 上通过 Homebrew 安装:
brew install ahmedak/defluff/defluff
就是这样。无需下载模型,无需 API 密钥。只要能运行 Python,就能运行它。
快速开始
# Lint a file — exit 1 on slop, 0 when clean
defluff lint essay.md

# Pipe text
cat draft.md | defluff lint

# Get a bare score for scripts (0.0 – 1.0)
defluff score essay.md

# Machine-readable JSON for downstream tooling
defluff lint essay.md --json
MCP 服务
它提供三个工具,任何支持 MCP 的 Agent 都可以调用它们检查文本,无需专门配置——包括在返回草稿前检查自己的草稿。
通过 uvx 零安装运行(推荐)——首次运行时会拉取软件包和 mcp 附加组件:
{
  "mcpServers": {
    "defluff": {
      "command": "uvx",
      "args": ["--from", "defluff[mcp]", "defluff-mcp"]
    }
  }
}
也可以安装后直接运行入口程序:
pip install "defluff[mcp]"
defluff-mcp
{
  "mcpServers": {
    "defluff": { "command": "defluff-mcp" }
  }
}
已作为 io.github.ahmedak/defluff 发布到 MCP Registry(参见 server.json)。
mcp-name: io.github.ahmedak/defluff
| 工具 | 参数 | 返回值 |
|---|---|---|
slop_detect | text: str | slop_score、spans(文本、类别、权重、偏移量)、categories、lexicon_version |
slop_add | pattern: str, category: str, scope: "user"|"project" | 将短语添加到词表叠加层 |
slop_ignore | pattern: str, scope: "user"|"project" | 忽略某个短语(例如领域行话) |
常见用例
- Agent 自我纠正 — 对草稿调用
slop_detect,并在返回前修改被标记的短语。无需配置,同一会话即可完成,无需让第二个模型参与。 - 为生成内容设置 CI 门禁 — 如果 AI 起草的变更日志或文档中充斥着“furthermore”和“robust”等词,就让构建失败。确定性检查 + 退出码 + 可固定的词表,是 LLM 评审门禁无法提供的组合。
- 写作助手反馈 — 突出编辑会删掉的具体短语,而不是含糊地说“这听起来像 AI 写的”。
- 微调的奖励组成部分 — 注意事项见奖励循环;单独使用时容易被钻空子。
为什么选择 defluff?
每个“AI 检测器”都试图判断文本是否由 AI 生成——这是个困难且不可靠的问题。defluff 提出了另一个问题:这段文本中是否包含可以删去的填充内容? 这个问题可以确定性地回答,而且无论是人还是大模型写下“归根结底”,答案都一样。
proselint 是最接近的先例——确定性工具,不依赖模型——但它只会发出是/否警告,而不会给出可调节的密度分数;它也并非围绕一个可替换、叠加或固定的列表构建。
用 grep 搜索词语列表只能得到原始匹配结果。defluff 则提供了你原本需要围绕该列表自行构建的功能:
- MCP 服务——Agent 无需任何接线配置即可自行检查。
- 识别 Markdown 和代码——先剥离代码围栏、行内代码和 URL。
- 整词匹配——
"foster"不会在"fostering"中触发匹配。 - 归一化分数,而非匹配次数——填充内容密度,因此同一个阈值既适用于推文,也适用于 5,000 字的文档。
- 重叠处理——“at the end of the day”与“end of the day”重叠时,每个词只计一次(优先匹配最长项)。
- 退出码、JSON 和字符偏移范围——可集成到 CI、提交前检查和编辑器工具中。
- 可固定的词库哈希值——证明不同运行之间的评判标准没有变化。
使用你自己的填充词
defluff lint draft.md --lexicon team-slop.md
# team-slop.md
- circle back
- low-hanging fruit
- boil the ocean
paradigm shift
每行一个短语(会忽略 # 注释和 -/* 标记)。这些短语会叠加在内置默认项之上,并归入中性的 custom 类别。如需真实类别和逐短语权重,请使用 .json 列表(参见词库叠加与版本管理)。
现成的领域包
defluff lint post.md --pack marketing-growth
defluff lint post.md --pack marketing-growth,ai-llm   # stack several
| Pack | 识别内容 | Pack | 识别内容 |
|---|---|---|---|
corporate-linkedin | 职场行话 | crypto-web3 | 加密货币炒作话术 |
startup-vc | 路演幻灯片话术 | pr-press-release | 新闻稿套话 |
marketing-growth | 炒作文案 | academic | 研究领域中的模棱两可表达 |
ai-llm | 大模型特征用语 | wellness-selfhelp | 网红式表达 |
social-media | X/Twitter 互动诱饵 |
使用 defluff packs 列出这些包。误报率较高的词语(例如 pivot、detox)默认以注释形式提供,因此在你主动启用之前不会生效。参见词包 README。
开箱即用的默认项
约 130 条精选模式,分为五个加权类别,不区分大小写并按整词匹配:
| Category | 识别内容 | 示例 |
|---|---|---|
ai-vocab | 被大模型过度使用的词语 | delve, tapestry, nuanced, pivotal, robust, showcase |
cliche | 不增加信息的空洞成语 | at the end of the day, move the needle, circle back, game changer |
hedge | 空洞的限定语 | it should be noted that, needless to say, basically, essentially |
corporate | 被夸大的流行术语 | leverage, synergy, actionable insights, cutting-edge, scalable |
transition | 大模型默认倾向使用的填充性连接词 | furthermore, moreover, in conclusion, first and foremost |
修辞模式(超出词表范围)
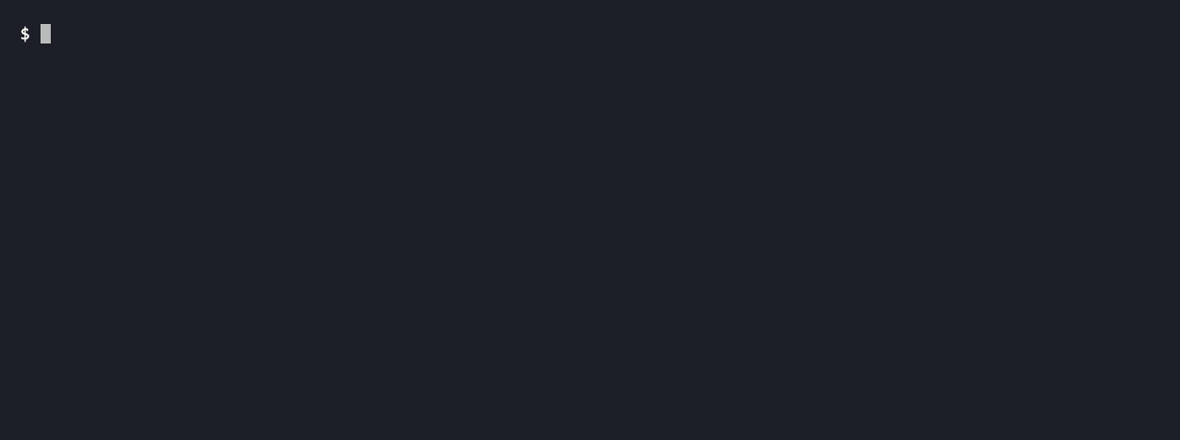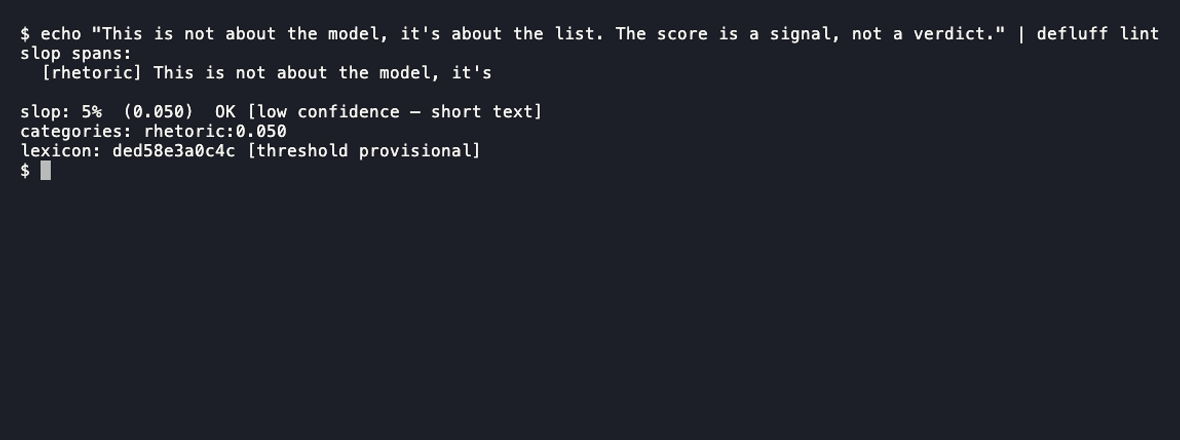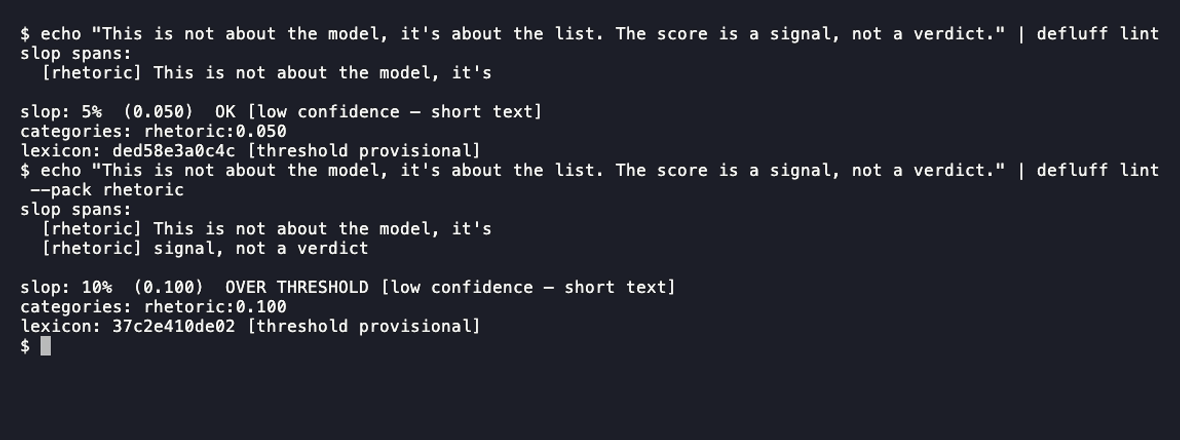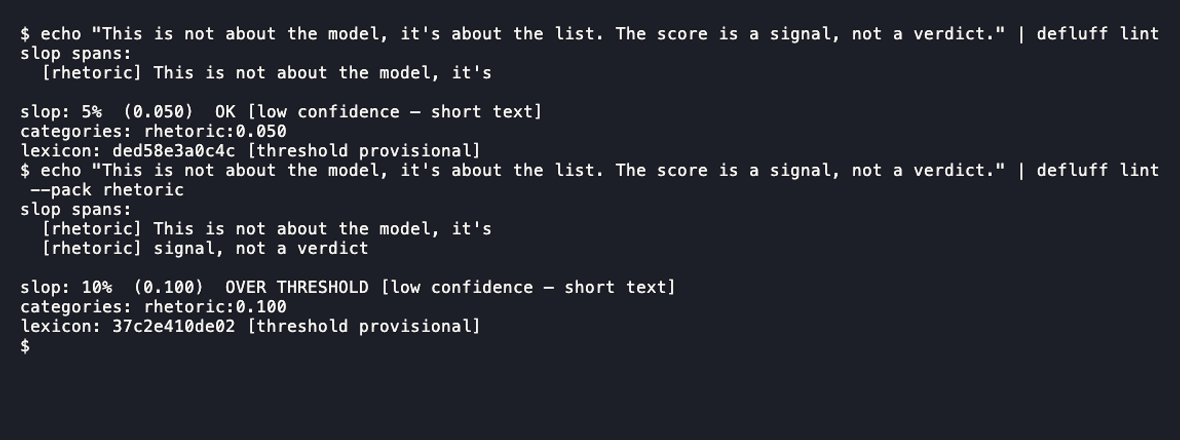
一些 AI 痕迹体现在句式形状上,而不是固定短语——即对偶:it's not X, it's Y、not just a list but a runtime。正则表达式模式层会将这些归入 rhetoric 类别:
| 模式 | 检测内容 | 默认状态 | 原因 |
|---|---|---|---|
| Compound (置信度高) | 完整句式:it's not X, it's Y · not just X but Y | 开启 | 第二个分句证明了这种修辞手法——极少误报 |
| Fragment (推测性) | 简短的 X, not Y——例如:a signal, not a verdict | 关闭,使用 --pack rhetoric | 也会匹配普通更正(shipped Tuesday, not Wednesday) |
无论长度如何,每个匹配项都计为一个单位并计入分数。开启 Fragment 模式会更改词库哈希值。
defluff lint draft.md                  # compound antithesis caught by default
defluff lint draft.md --pack rhetoric  # also catch the punchy "X, not Y" fragment
defluff lint draft.md --category rhetoric   # gate CI on antithesis alone
Python API
import defluff

report = defluff.detect("It is worth noting that we should leverage synergies.")
print(report.slop_score)   # 0.0 – 1.0
print(report.spans)        # flagged phrase locations + categories

score = defluff.score(text)       # bare float
clean = defluff.is_slop(text)     # bool at default threshold

lex = defluff.load_lexicon()                # pin for reproducible runs
score = defluff.score(text, lexicon=lex)
SlopReport 字段:
| 字段 | 类型 | 说明 |
|---|---|---|
slop_score | float | 限定在 [0, 1] 范围内——用于设置阈值 |
slop_density | float | 未限定范围的原始值——更适合奖励循环使用的梯度 |
spans | list[Span] | 每个命中项包含:text、类别、权重、字符偏移量(相对于清理后的文本;参见局限性) |
categories | dict[str, float] | 各类别的密度 |
n_words | int | 词元数量 |
low_confidence | bool | 当 n_words < 20 时为 True |
lexicon_version | str | 已解析词条集的 SHA 前缀 |
词库叠加与版本管理
随包附带的词库是基线;无需编辑软件包即可在其基础上叠加:
# "synergy" is slop on this machine
defluff lexicon add "synergy" --category corporate --scope user

# "leverage" is fine in this repo (finance context) — commit this with the repo
defluff lexicon rm "leverage" --scope project
git add .defluff/ignore.json && git commit -m "allow 'leverage' in finance context"
- 用户叠加层(
~/.config/defluff/)——整台机器范围,不纳入版本控制 - 项目叠加层(Git 根目录下的
.defluff/)——适用于单个仓库;提交后可供整个团队使用
写入操作是原子的,并采用跨进程锁定;如果叠加层损坏,会发出警告并跳过——detect() 永远不会崩溃。
每个已解析词库(随包附带的词库 + 叠加层 + 词包)都带有简短的内容哈希,每次运行时都会打印(lexicon: 2cc05ba84457),并通过 SlopReport.lexicon_version 提供。只需传入一次 lexicon=defluff.load_lexicon(),之后每次调用都会使用同一把尺子评分——可固定用于 CI 基线和 RL 奖励;此外也可审计,因为只有已解析词条集发生变化时,哈希才会改变。每个版本都会附带注明日期的词库和更新日志(CHANGELOG.md);ai-vocab 预计会随版本迭代而更新,而 cliche/hedge/corporate/transition 则基本稳定。
解读输出并设置阈值
- 命中片段——具体的填充短语及其类别。确定且可靠,应据此采取行动。
- 分数——
slop_score= 标记词数 ÷ 总词数,并按类别加权(ai-vocab权重略高,transition略低)。0.20≈“这段文本有五分之一是词表中列出的填充内容。”通常在0.0–1.0范围内;如果文本几乎全是填充内容,分数可能略高于1.0。它不是质量量化指标,只是用于触发 CI 退出代码的警报线。
根据允许的填充内容密度来选择阈值:
--threshold | 含义 | 适用场景 |
|---|---|---|
0.05 | 填充内容约占 5%——严格 | 营销文案、落地页、面向客户的文本 |
0.08 (默认值) | 填充内容约占 8%——用于分流的警报线 | 一般散文、博客草稿 |
0.12–0.20 | 仅标记严重冗余内容 | 合理使用 robust、scalable、in order to 的技术文档 |
默认值 0.08 是暂定值——由人工选定,尚未基于标注语料进行校准(因此带有 [threshold provisional] 标签)。如需设置严格的 CI 门禁,请自行设定阈值,并先排除所在领域的词汇(见下文)。
在 CI 中使用
技术写作——API 文档、ADR、RFC——确实会使用
robust、scalable、in order to这类词。请先屏蔽项目的领域词汇:defluff lexicon rm "scalable" --scope project defluff lexicon rm "in order to" --scope project git add .defluff/ignore.json && git commit -m "defluff: allow domain vocabulary"然后只针对你信任的类别设置门禁,而不是全部五类:
- name: Check AI-generated content for slop
  # --category ai-vocab,hedge gates only on the highest-precision categories
  run: cat generated_output.md | defluff lint --category ai-vocab,hedge --threshold 0.1
退出代码为 1 时步骤失败,为 0 时通过。
与 pre-commit 一起使用
# .pre-commit-config.yaml
repos:
  - repo: local
    hooks:
      - id: defluff
        name: defluff slop check
        entry: defluff lint
        language: system
        types: [markdown]
在奖励循环中使用(实验性)
确定性的、不可微的填充词密度标量可以作为奖励组合中的一个小型组成部分,但单独使用很容易被钻空子:如果模型只针对固定短语列表进行优化,就会学会改写填充词,而不是将其删除。请搭配真实的质量信号(人工或 LLM 评审);目前还没有已发表的训练运行结果表明这种做法有效。
lex = defluff.load_lexicon()  # pin once
reward = lambda text: -defluff.detect(text, lexicon=lex).slop_density  # unclamped, better gradient

delta = defluff.compare(draft_v1, draft_v2, lexicon=lex)
# {"score_a": 0.31, "score_b": 0.18, "delta": -0.13,
#  "improved": [...], "regressed": [...]}  # set diff of flagged phrases, not a semantic diff
CLI 参考
defluff lint [FILE] [--json] [--threshold FLOAT] [--category CATS] [--lexicon PATH] [--pack NAMES] [--no-project-overlay]
defluff score [FILE] [--pack NAMES] [--no-project-overlay]
defluff packs          # list bundled domain packs

defluff lexicon list   [--category CATEGORY] [--scope SCOPE] [--json]
defluff lexicon add    PATTERN --category CATEGORY [--scope SCOPE] [--weight FLOAT]
defluff lexicon rm     PATTERN [--scope SCOPE]
--category— 以逗号分隔;只有这些类别中的片段会计入退出代码判定(但仍会报告所有命中项)。有效值:ai-vocab、cliche、hedge、corporate、transition、custom、rhetoric。--lexicon PATH— 在默认词汇表基础上叠加你的短语。.txt/.md文件每行一个短语(归入custom);.json文件则包含明确的类别和权重。--pack NAMES— 以逗号分隔的领域包。rhetoric专用于模式包,可启用可选的X, not Y对照句片段。
defluff lint 的退出代码:0 = 无问题 · 1 = 冗余文本 · 2 = 输入错误。
准确性
defluff 是确定性匹配器,而非训练好的分类器,因此关键指标是精确率——它标记某内容时,该内容是否确实是可以删除的填充词?在默认阈值下,对 50 个人工标注的样例(eval/validation.jsonl)进行测试,样例涵盖明显的冗余文本、通顺的 prose,以及术语本身就是内容的陷阱(例如“the robust standard errors”、“pivotal trials”):
| 指标 | 分数 | 说明 |
|---|---|---|
| 精确率 | 1.00 | 0 个误报——通顺的 prose 和合理的术语均未被标记 |
| 召回率 | 0.65 | 受词汇表覆盖范围限制 |
复现方法:python eval/score.py eval/validation.jsonl
漏检的是词汇表中尚未收录的新潮词(例如“operationalize the ideation funnel”)——这是基于列表的匹配器已知的局限,并非噪声。对于列表中已有的填充词,召回率为 1.00;随着词汇表扩充,该数值会提高,但如果没有语义层,面对开放式的新术语时,召回率不会达到 1.00。
注意事项:样例集规模较小,且由作者标注——它是对精确率的合理性检查,并非经独立评审的基准。
局限性
- 它按设计匹配已知列表,不会理解文本。 新潮词可能漏检;这是换取确定性、本地运行和可复现性的代价(无需模型、无需 API 密钥、可固定哈希)。若需通过语义检测发现新出现的填充词,请搭配 LLM 评审。
- 领域术语的含义取决于上下文。 在金融文档中,
"leverage"是实际内容。请检查标记的片段;可使用defluff lexicon rm抑制误报(将其加入忽略列表,而非从内置词汇表中删除)。 - 片段偏移量对应清理后的文本。 defluff 会在匹配前去除代码围栏、行内代码、URL 和 Markdown 标记,因此偏移量与原始文档不一致——请根据
span.text,而非原始偏移量,在带标记的源文本中匹配。 custom只能通过文件读取。--lexicon文件中的短语会归入custom,但defluff lexicon add --category custom会被拒绝——add仅接受五个精选类别。- v0 仅支持英语。
- 短文本(< 20 个词)会标记为
low_confidence: true——分母下限为 20,因此两个句子的输入中不会因一个短语就被判定为 100% 冗余文本。
贡献
最简单的贡献方式是添加遗漏的填充短语:
- 将其按正确的类别添加到
src/defluff/data/lexicon-v1.json - 运行
pytest— 冒烟测试会检查边界错误 - 提交 PR,并附上该短语在实际使用中的一两个示例
代码配置和指南请参阅 CONTRIBUTING.md。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。