
关于 Code Context Engine
Code Context Engine(CCE)为代码库建立本地索引,让 AI 编码工具通过检索获取相关代码,而不是反复读取整个文件。适合希望降低 Claude Code 等工具 token 消耗的开发者,并支持跨会话记忆。
主要功能
- 01基于 tree-sitter 的代码语义分块
- 02向量与 BM25 混合检索
- 03记录并召回跨会话的决策
- 04本地存储,不进行云端索引
- 05显示 token 节省的估算金额
适用场景
- 01降低 Claude Code 的输入 token 消耗
- 02在多个编辑器之间共享同一份索引
- 03保存架构决策并在后续会话中召回
MCP 相关
CCE 是一个 MCP 服务,向 MCP 客户端暴露 context_search、session_recall、record_decision 等 11 个工具。cce init 会为多种编辑器写入对应的 MCP 配置。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Code Context Engine
为代码库建立索引。AI 通过搜索获取信息,无需反复读取文件。
经可复现的基准测试,节省 94% 的令牌。
网站 · 文档 · 为什么选择 CCE? · 基准测试 · GitHub




Python 3.11+ · macOS · Linux · Windows





一条命令。自动检测编辑器。无需云服务,无需配置。
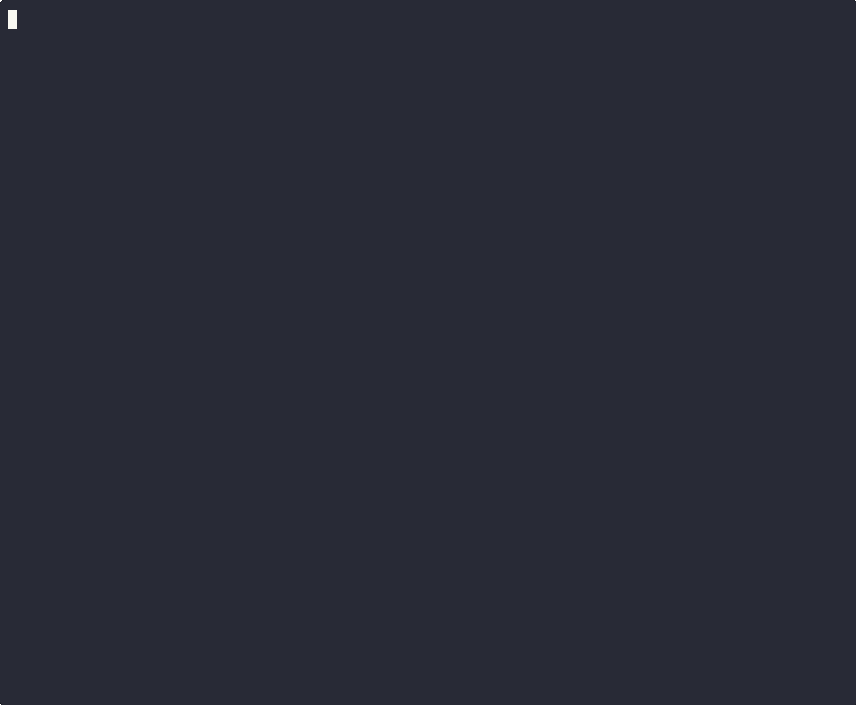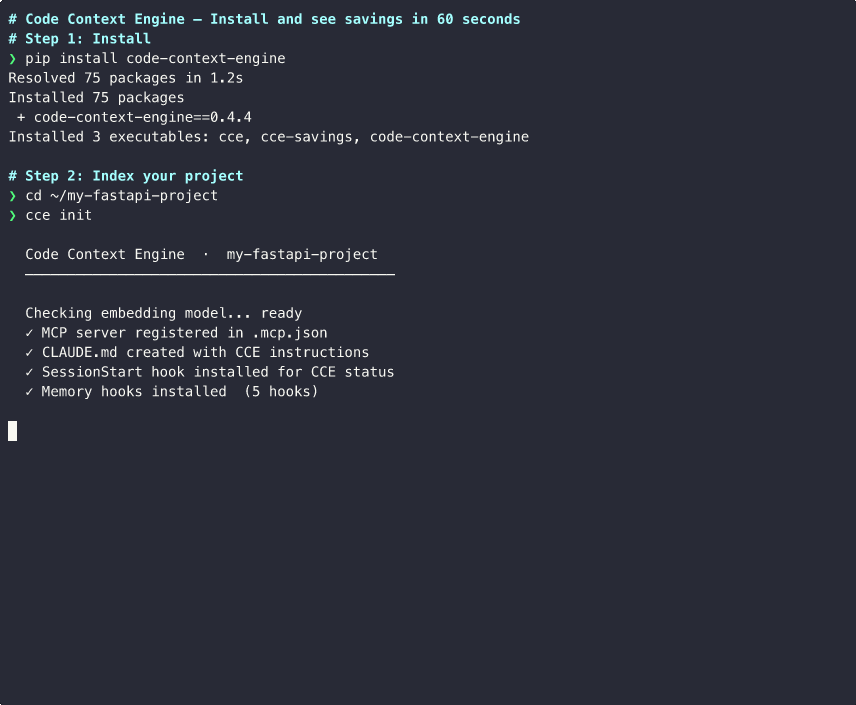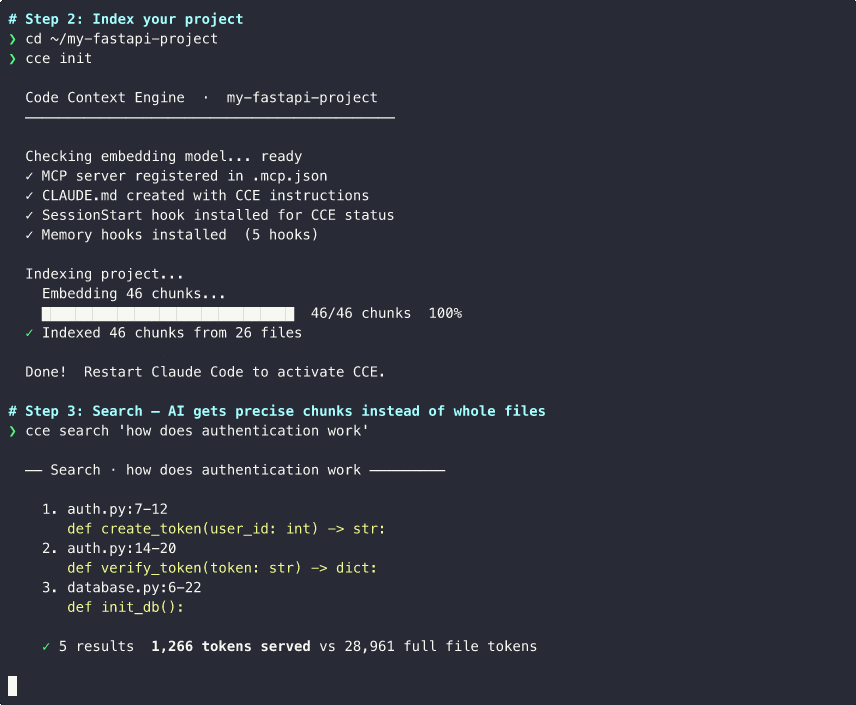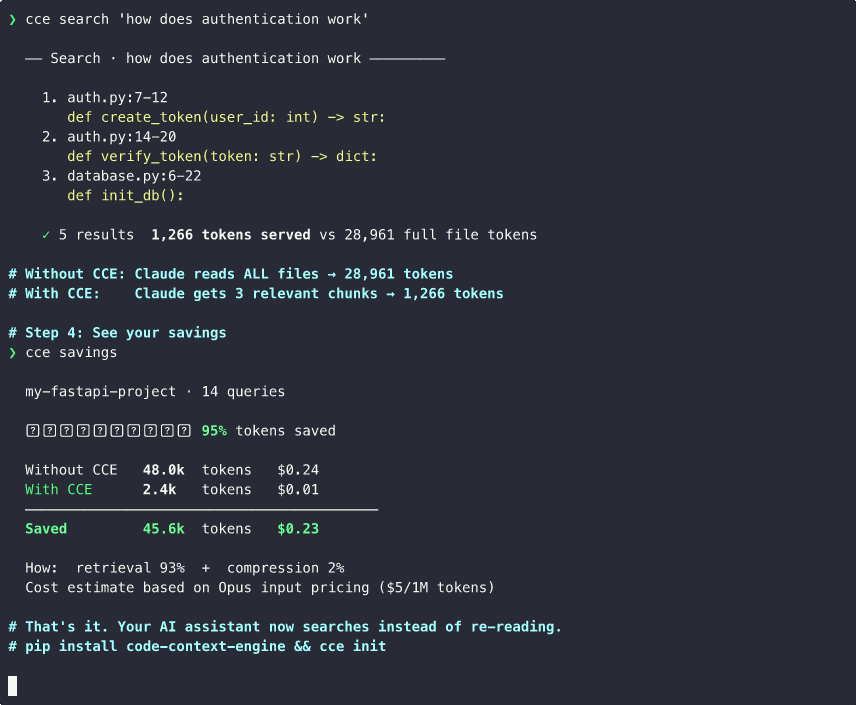
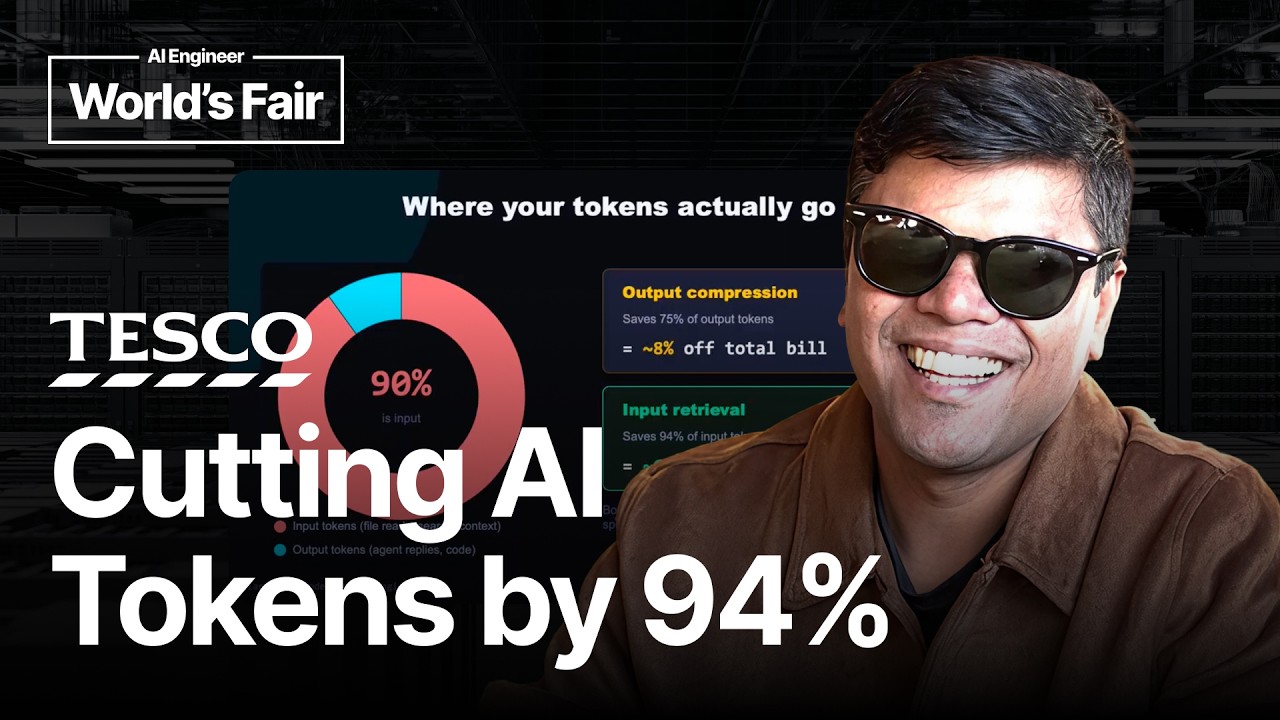
演讲:我们将 AI 编码 Token 减少了 94% — AI Engineer World's Fair 2026
使用场景
| 使用场景 | CCE 的作用 | |
|---|---|---|
| 💰 | 降低 Claude Code 成本 | 每个会话的输入 Token 减少 94% |
| 🔒 | 保护代码隐私 | 所有数据都在本地,不进行云端索引 |
| 🔄 | 多编辑器团队 | Claude Code、Cursor、VS Code、Gemini CLI 共用一个索引 |
| 🧠 | 跨会话记忆 | 决策和上下文在重启后依然保留 |
| ⚡ | 更快响应 | 上下文更少,Claude 回复更快 |
| 📊 | 追踪实际节省金额 | 显示实际金额,而非估算值 |
快速开始
只需一条命令,30 秒即可完成。
uvx --from "code-context-engine[local]" cce init # install + index + configure, one shot
如果你更喜欢持久安装:
uv tool install "code-context-engine[local]"    # or: pipx install "code-context-engine[local]"
cd /path/to/your/project
cce init
重启编辑器即可。每个问题现在都会查询索引,而不是重新读取文件。
**支持 Agent Plugin:**运行
cce init --plugin以生成可移植的 Agent Plugin 目录,适用于 VS Code、Cursor、Copilot、Codex、ChatGPT 和 Kiro。该插件使用uvx按需启动 CCE,因此用户无需预先安装 Python 软件包。请参阅下方的 Agent Plugin。
已经安装 Ollama? 跳过
[local],改用uv tool install code-context-engine。CCE 会自动检测 localhost:11434 上的 Ollama,并使用nomic-embed-text。
系统要求
Python 3.11+ 和 C 编译器(用于 tree-sitter 语法解析器)。
| 平台 | 安装方式 |
|---|---|
| macOS | xcode-select --install |
| Ubuntu/Debian | sudo apt install build-essential cmake |
| Fedora/RHEL | sudo dnf install gcc gcc-c++ cmake |
| Windows | Visual Studio Build Tools(C++ 工作负载)+ CMake |
已在 macOS、Linux 和 Windows 上通过 Python 3.11/3.12/3.13 测试。
cce init 会自动检测你的编辑器,并写入相应配置。要指定某个
Agent,请使用 --agent claude、--agent codex、--agent copilot、--agent pi 或
--agent all。
| 编辑器 | 写入的配置 | 指令文件 |
|---|---|---|
| Claude Code | .mcp.json | CLAUDE.md |
| VS Code / Copilot | .vscode/mcp.json | .github/copilot-instructions.md |
| Cursor | .cursor/mcp.json | .cursorrules |
| Gemini CLI | .gemini/settings.json | GEMINI.md |
| OpenAI Codex | ~/.codex/config.toml(用户全局配置,按项目分节) | AGENTS.md |
| OpenCode | opencode.json | |
| Tabnine | .tabnine/agent/settings.json | TABNINE.md |
| Pi | .mcp.json | AGENTS.md |
同一个项目中使用多个编辑器?一条命令即可为它们全部完成配置。
**Codex 说明:**Codex CLI 只会从 ~/.codex/config.toml 读取 MCP 服务 —
它不支持项目级配置。cce init 会为每个项目添加一个 [mcp_servers.cce-<project>-<hash>]
分节,让多个项目共存;cce uninstall 只会移除当前项目对应的分节。
**Pi 说明:**Pi 不原生支持 MCP。要在 Pi 中使用 CCE,你需要安装
Pi MCP 适配器扩展(例如 pi-mcp-adapter),
以读取 .mcp.json 配置并将 CCE 的工具提供给 Pi Agent。
cce init 会同时设置 .mcp.json 和 AGENTS.md(Pi 会在启动时自动
加载后者作为启动指令)。
  my-project · 38 queries · last query 5m ago

  ⛁ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶ ⛶  88% tokens saved

  Input savings   1.9M  tokens   $27.78
  Output savings  4.8k  tokens   $0.36
  ──────────────────────────────────────────
  Total saved   1.9M  tokens   $28.15

  Breakdown:
    retrieval              84%  ▰▰▰▰▰▰▰▰▰▰    1.8M   $26.76 · 12 calls
    chunk compression       3%  ▰▱▱▱▱▱▱▱▱▱   68.5k    $1.03 · 12 calls
    output compression*    <1%  ▰▱▱▱▱▱▱▱▱▱    4.8k    $0.36 · 12 calls

  Cost estimate based on Opus pricing (input $15.0/1M, output $75.0/1M)
支持 Anthropic、OpenAI 和 Google 的模型定价。通过 ~/.cce/config.yaml 中的 pricing.model 进行配置。
为什么这很重要
输入令牌占 Claude Code 账单的 85-95%。CCE 可将其减少 94%(在 FastAPI 上进行基准测试)。
Without CCE:    Claude reads payments.py + shipping.py   = 45,000 tokens
With CCE:       context_search "payment flow"            =    800 tokens
| 不使用 CCE | 使用 CCE | |
|---|---|---|
| 会话启动 | 每次都重新读取文件 | 查询索引 |
| 查找函数 | 读取整个 800 行文件 | 获取 40 行的函数 |
| 跨会话记忆 | 无 | 保存决策和代码区域 |
| 令牌成本(Sonnet,中型项目) | 约 $0.14/会话 | 约 $0.04/会话 |
基准测试:FastAPI(可复现)
我们使用 20 个真实编码问题,将 CCE 与 FastAPI(53 个源文件,180K 个令牌)进行基准测试。没有挑选有利结果,也没有合成查询。
方法: 对于每个查询,“不使用 CCE”表示读取查询涉及的每个文件的完整内容。“使用 CCE”表示压缩后的相关代码块。
重要的基线说明: 94% 这一数字是以读取完整文件为基准测得的,并非以 Claude Code 实际执行的操作为基准。实际上,Claude Code 已经会使用 grep、部分文件读取和定向工具,因此与 Claude Code 常规行为相比,实际节省会低于 94%。我们使用完整文件作为基线,是因为这种方式可复现且结果确定(不受 Agent 行为差异影响)。此基准测试衡量的是 CCE 的检索效率,并非与 Claude Code 内置探索功能进行直接比较。
| 指标 | 结果 |
|---|---|
| 检索节省 | 94%(每个查询 83,681 → 4,927 个令牌) |
| 压缩(对检索到的代码块进行额外压缩) | 89%(每个查询 4,927 → 523 个令牌) |
| Recall@10(找到正确文件的比例) | 0.90 |
| 延迟 p50 | 0.4ms |
| 测试查询数 | 20 |
各层节省(分别独立测量)
| 层 | 功能 | 节省 | 方法 |
|---|---|---|---|
| 检索 | 完整文件 → 相关代码块 | 94% | 实测 |
| 代码块压缩 | 原始代码块 → 签名 + 文档字符串 | 89% | 实测 |
| 语法 | 从记忆文本中去掉冠词和填充词 | 13% | 实测 |
输出压缩(缩短 Claude 的回复)还能进一步节省(估算约 65%),但未计入上方的主要数字。
多语言基准测试
| 仓库 | 语言 | 文件数 | 检索节省 | Recall@10 |
|---|---|---|---|---|
| FastAPI | Python | 53 | 94% | 0.90 |
| Django | Python(大型) | 2,347 | 93% | 0.95 |
| Express | JavaScript | 6 | 94% | 1.00 |
| chi | Go | 94 | 76% | 0.67 |
| fiber | Go(单体仓库) | 396 | 93% | 0.07 |
Django(2,347 个文件,5.4M 个令牌)的结果表明,CCE 可扩展到大型代码库,同时保持 0.95 的召回率。Go 文件较短,因此检索提升空间较小(基线更低)。在 top-10 中,单体仓库会拉低召回率(fiber)。每个文件包含一个特性的中间件查询则始终达到 R=1.00。
亲自复现:
pip install code-context-engine
python benchmarks/run_benchmark.py --repo https://github.com/fastapi/fastapi.git --source-dir fastapi
python benchmarks/run_benchmark.py --repo https://github.com/go-chi/chi.git --source-dir .
完整结果见 benchmarks/results/。查询和方法见 benchmarks/。
你将获得
11 个 MCP 工具,Claude 会自动使用:
| 工具 | 功能 |
|---|---|
context_search | 结合向量与 BM25 的混合搜索,并进行图扩展 |
expand_chunk | 查看压缩结果的完整源代码 |
related_context | 通过图边(调用、导入)查找代码 |
session_recall | 回忆过去会话中的决策 |
session_timeline | 浏览会话的轮次摘要(深入查看回忆结果) |
session_event | 检查特定事件的原始工具输入/输出 |
record_decision | 保存决策,供未来会话使用 |
record_code_area | 记录已处理的文件 |
index_status | 检查索引是否为最新 |
reindex | 重新索引文件或整个项目 |
set_output_compression | 调整响应详细程度(off / lite / standard / max) |
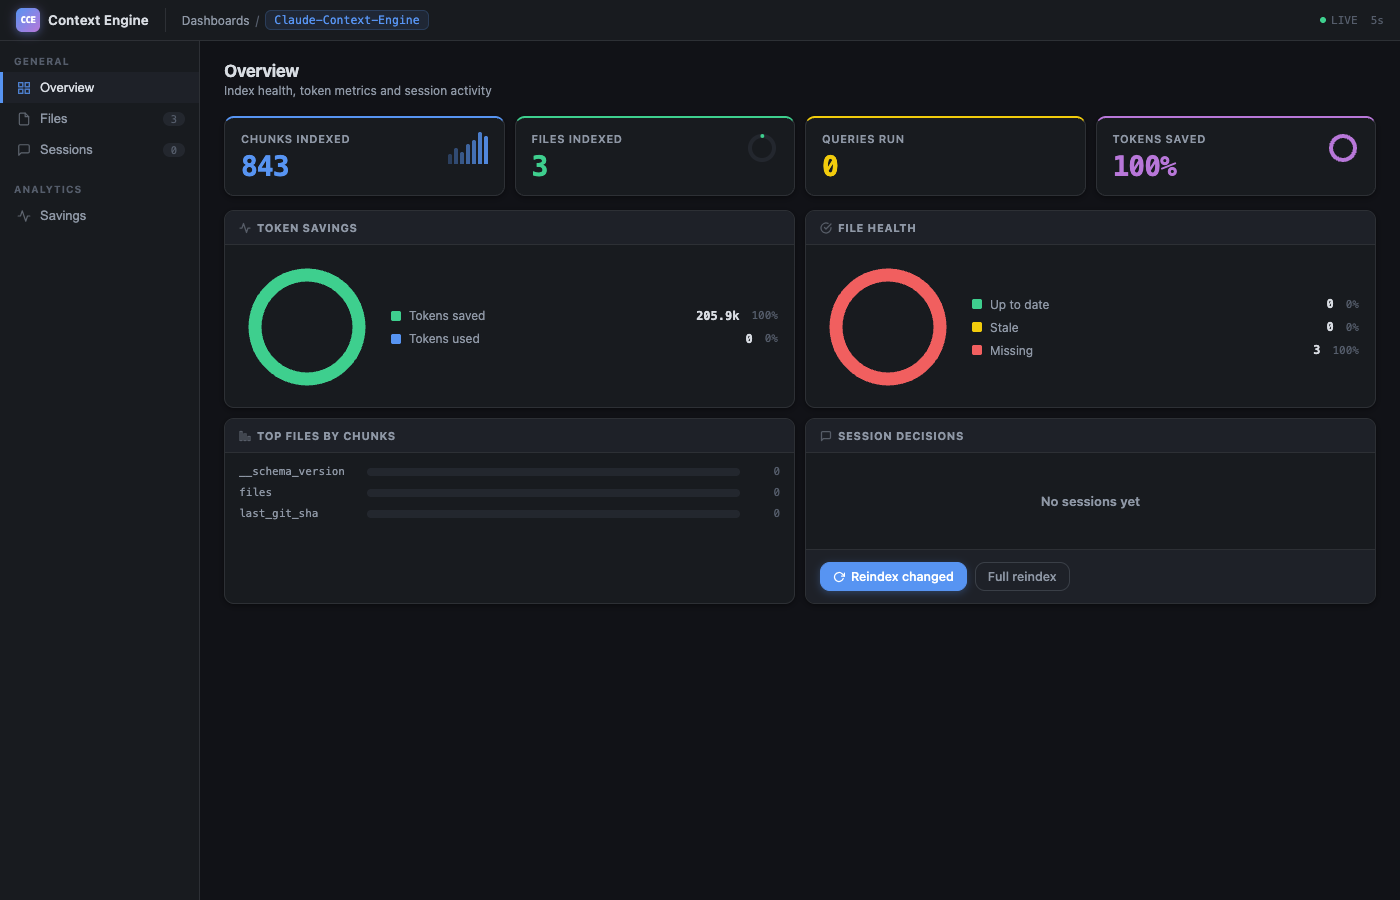
实时仪表板,包含环形图、文件健康状态和会话历史:
cce dashboard
多服务商定价的美元费用估算(Anthropic、OpenAI、Google):
cce savings --all # see savings across all projects
工作原理
- 索引: Tree-sitter 将代码解析为语义块(函数、类、模块)。并在本地存储为向量嵌入。
- 搜索: Claude 调用
context_search。混合向量与 BM25 检索可找到合适的代码块。代码图会自动补充相关文件。 - 压缩: 代码块会被截断为签名和文档字符串(如果 Ollama 正在运行,则会由大模型生成摘要)。
- 记忆: 决策和代码区域会通过
session_recall跨会话保留。 - 跟踪: 每次查询都会被记录。
cce savings会准确显示节省了多少。
编辑后重新索引用时不到 1 秒(嵌入缓存命中率为 96%)。Git 钩子会自动保持索引最新。
CCE 的不同之处
在最能省钱的地方为你省钱
输出压缩工具(如 Caveman)可节省 20-75% 的输出令牌。输出占账单的 5-15%。净节省约为 11%。
CCE 可节省输入令牌(在 FastAPI 上检索节省 94%,可复现的基准测试)。输入占账单的 85-95%。
真正理解你的代码
这不是文本搜索。Tree-sitter AST 解析会创建语义代码块。混合检索通过 Reciprocal Rank Fusion 合并向量相似度与 BM25 关键词匹配。置信度评分器会综合相似度(50%)、关键词匹配(30%)和时效性(20%)。图扩展会遍历 CALLS/IMPORTS 边,以提取相关代码。
记住信息
record_decision("use JWT for auth", reason="session tokens flagged by legal") 会存储在 SQLite 中,并在下一个会话中通过 session_recall 显示。无需反复解释你的架构。
跟踪实际节省
并非估算值,而是与完整文件基准相比实际提供的令牌数,并按类别(检索、压缩、输出、记忆、语法)细分。美元费用从 Anthropic 的定价页面获取。每次会话开始时都会显示节省汇总。
默认安全
机密文件(.env、*.pem、credentials.json)绝不会被索引。内容会扫描 AWS 密钥、GitHub 令牌、Slack 令牌、Stripe 密钥、JWT 和通用凭证。写入记忆前会清除 PII(电子邮件、IP、SSN、信用卡)。所有 MCP 文件路径都会经过路径遍历验证。
深入原理
基于内容哈希的嵌入缓存
为每个代码块生成 SHA-256 指纹,并使用模型名称加盐。重新索引时跳过未更改的代码。采用二进制 float32 存储(比 JSON 小 10 倍)。典型的重新索引缓存命中率为 96%,耗时不到 1 秒。
sqlite-vec:2 MB,而非 217 MB
用 sqlite-vec 替换了 LanceDB。余弦距离质量相同,安装体积缩小 99%。WAL 模式 + PRAGMA NORMAL 可将写入速度提升 80%。向量、FTS5、代码图和压缩缓存全部存储在 3 个 SQLite 文件中。
确定性语法压缩
无需调用大模型即可压缩记忆条目。删除冠词、填充词和代词。提供 3 个级别(lite/full/ultra,节省 20-60%)。代码、路径和 URL 按字节原样保留。相同输入始终产生相同输出。
故障时关闭的钩子设计
5 个 Claude Code 生命周期钩子用于捕获会话上下文。每个钩子都会运行 curl ... || true,因此服务崩溃也不会阻止用户操作。SessionStart 注入引导上下文;其他钩子则静默捕获信息。
多提供商定价
cce savings 中的美元估算支持 Anthropic、OpenAI 和 Google 的 15+ 个模型。CCE 内置静态定价;Anthropic 的实时定价会获取并缓存 7 天。可配置 pricing.model(例如 gpt-4o、gemini-2.5-pro、sonnet),也可通过 pricing.input / pricing.output 覆盖为自定义费率。
资源管理器(多实例安全)
运行数十个 cce serve 进程(每个 AI 会话中的每个项目各运行一个)可能耗尽系统内存。资源管理器会限制每个进程的 ONNX Runtime 线程数,使用建议式文件锁确保同一时间只有一个进程为指定项目编制索引,在 Linux 内存压力(PSI)下自动退避,并在空闲 30 分钟后自动关闭服务。通过 serve.idle_timeout_minutes 和 serve.max_ort_threads 配置。
记忆提醒
CCE 的跨会话记忆依赖 Agent 调用 record_decision 和 record_code_area。记忆提醒让记录成为自然环节:连续搜索 N 次但未记录后,context_search 结果中会包含简短提醒。会话结束时,Stop 钩子会总结未记录的活动。首次记录后,提醒会重新启用,让它们保持实用而不造成干扰。
HTTP 搜索端点
cce serve --http 会提供 POST /search 端点,供通过 HTTP 而非 MCP stdio 通信的自定义 Agent 集成使用。采用相同的混合检索流程,并以结构化 JSON 响应返回置信度分数。输入验证会限制 top_k(1..100)和 confidence_threshold(0.0..1.0)。
仅追加的节省记录账本
7 个类别会跟踪每一处 Token 节省:检索、代码块压缩、输出压缩、记忆召回、语法、轮次总结和渐进式披露。重启后数据仍会保留,为命令行和仪表盘分析提供支持。
Agent 插件
Agent 插件 是一项开放标准(v1.0.0),由 Amazon、Cursor、Microsoft、OpenAI 和 Vercel 支持,用于将 AI 技能和 MCP 服务打包为可移植、零安装的捆绑包。CCE 可以生成插件目录,兼容的编辑器能够自动发现并加载该目录。
cce init --plugin                          # Generate at .cce/plugin/
cce init --plugin --plugin-dir ~/plugins/cce  # Custom location
cce init --agent claude --plugin           # Both: agent config + plugin
生成的内容
.cce/plugin/
├── plugin.json                       # Agent Plugins v1.0.0 manifest
├── mcp.json                          # MCP server config (uvx + stdio)
├── skills/
│   └── code-context/
│       ├── SKILL.md                  # Agent instructions (frontmatter + body)
│       └── references/
│           └── tools.md              # Per-tool parameter docs (loaded on demand)
└── LICENSE
兼容的编辑器
VS Code、GitHub Copilot、ChatGPT、Codex、Cursor 和 Kiro。该插件使用 uvx 按需启动 CCE,因此用户无需预先安装 Python 包。MCP 服务会从其工作目录向上遍历,查找 .context-engine.yaml 或 .git/,从而自动发现项目根目录。
何时使用 --plugin,何时使用 --agent
--agent(默认) | --plugin | |
|---|---|---|
| 安装方式 | 写入特定编辑器的配置文件 | 生成可移植的插件目录 |
| 零安装 | 否,CCE 必须位于 PATH 中 | 是,uvx 会按需获取 CCE |
| 指令更新 | 需重新运行 cce init 才会更新 | 需重新运行 cce init --plugin 才会更新 |
| 最适合 | 在自己的机器上使用 | 与团队共享或分发 |
两者可以同时使用。--agent 负责处理各编辑器的 MCP 配置,--plugin 则提供可移植的替代方案。
CLI 一览
cce init                    # Index + install hooks + register MCP
cce init --plugin           # Generate Agent Plugin for VS Code, Cursor, etc.
cce                         # Status banner
cce savings                 # Token savings with dollar estimates
cce savings --all           # All projects
cce dashboard               # Web dashboard with live charts
cce search "auth flow"      # Test a query
cce status                  # Index health + config
cce services                # Ollama + dashboard + MCP status
cce commands add-rule '...' # Project rules for Claude
cce uninstall               # Clean removal of all CCE artifacts
运行 cce list 查看完整的命令参考。
配置
默认无需配置。可在 ~/.cce/config.yaml 或 .context-engine.yaml 中覆盖所需配置:
compression:
  level: standard          # minimal | standard | full
  output: standard         # off | lite | standard | max
  ollama_url: http://localhost:11434   # point at a remote Ollama if desired

retrieval:
  top_k: 20
  confidence_threshold: 0.5

pricing:
  model: opus              # opus | sonnet | haiku | gpt-4o | gemini-2.5-pro | ...
  # input: 15.0            # override $/1M input tokens
  # output: 75.0           # override $/1M output tokens
远程 Ollama: 如果你在网络中的另一台机器上运行 Ollama,请设置 compression.ollama_url(例如 http://nas.local:11434),或导出 CCE_OLLAMA_URL(环境变量优先)。CCE 会探测该端点;如果无法访问,则回退到仅截断压缩,因此不稳定的连接不会导致索引失败。
输出压缩
CCE 也会压缩 Claude 的响应(与 Caveman 的概念相同):
| 级别 | 风格 | 节省量 |
|---|---|---|
off | 完整输出 | 0% |
lite | 去掉填充语和模棱两可的措辞 | ~30% |
standard | 使用片段,去掉冠词 | ~65% |
max | 电报式 | ~75% |
告诉 Claude:“切换到最高级别压缩”或“关闭压缩”。代码块和命令永远不会被压缩。
磁盘占用
| 组件 | 大小 |
|---|---|
| 核心安装(Ollama 后端) | ~17 MB |
使用 [local] 扩展(fastembed + ONNX) | ~189 MB |
| 嵌入模型(一次性下载) | ~60 MB(fastembed),或由 Ollama 管理 |
| 每个项目的索引(小型/中型/大型) | 5-60 MB |
无需 GPU。使用 Ollama 时,嵌入由 Ollama 服务处理。使用 [local] 扩展时,嵌入模型通过 ONNX Runtime 在 CPU 上运行。
支持的语言
AST 感知分块(由 tree-sitter 解析,11 种扩展名):
| 语言 | 扩展名 |
|---|---|
| Python | .py |
| JavaScript | .js、.jsx |
| TypeScript | .ts、.tsx |
| PHP | .php |
| Go | .go |
| Rust | .rs |
| Java | .java |
| C# | .cs |
语言感知回退分块(40 多种扩展名):
| 类别 | 语言 |
|---|---|
| Web | HTML、CSS、SCSS、LESS、Vue、Svelte |
| 系统 | C、C++、Zig、Nim |
| 移动端 | Swift、Kotlin、Dart |
| 函数式 | Haskell、Scala、Clojure、Elixir、Erlang、F# |
| 脚本 | Ruby、Perl、Lua、R、Bash/Zsh |
| 数据/配置 | JSON、YAML、TOML、XML、SQL、GraphQL、Protobuf |
| DevOps | Terraform、HCL、Dockerfile |
| 文档 | Markdown |
其他所有文本文件均按行范围分块。二进制文件会被跳过。
文档
| 页面 | 内容 |
|---|---|
| 使用 AI 编码令牌要花多少钱? | 输入令牌与输出令牌的计算 |
| 什么是 CCE?(完整指南) | 设置、工具、工作原理、常见问题 |
| 如何节省 Claude Code 令牌 | 成本明细与节省指南 |
| 基准测试深入解析 | 完整的 FastAPI 基准测试方法 |
| 与其他方案的比较 | CCE 与 Cursor、Aider、Continue、Greptile 的比较 |
| 示例 | 与 Claude 的真实对话 |
| 工作原理 | 完整的 9 阶段流水线 |
| CLI 参考 | 每条命令及其输出 |
| 配置 | 所有配置选项 |
常见问题
CCE 会影响回复质量吗?
不会。质量保持不变或略有提升。
CCE 会将“倾倒整个文件”替换为“搜索相关函数”。模型仍能获取所需代码(基准测试中的 Recall@10 为 0.90)。减少无关上下文意味着减少干扰注意力的噪声,从而让模型更专注于你的实际问题。
输出令牌节省是如何实现的?
CCE 会在 cce init 期间,将输出压缩规则直接写入 Agent 的指令文件(CLAUDE.md、AGENTS.md、.cursorrules 等)。这些规则适用于整个会话,而不只是 CCE 工具的回复,因此 Agent 的每条回复都会遵循这些规则。
在 ~/.cce/config.yaml 或 .context-engine.yaml 中设置级别:
compression:
  output: max       # off | lite | standard | max
然后重新运行 cce init 以更新指令文件。也可以在运行时更改:
set_output_level output_level=max
| 级别 | 节省比例 | 功能 |
|---|---|---|
off | 0% | 不压缩 |
lite | ~25% | 删除填充词、模糊措辞和客套话 + 代码变更仅输出差异 |
standard | ~70% | 删除冠词、残句和简短同义词 + 代码仅输出差异 |
max | ~80% | 电报式表达 + 代码仅输出差异 |
默认级别为 standard。所有级别都包含代码输出规则,要求模型只显示更改的行(而不是重写整个文件),因为编码会话中的大部分输出令牌都消耗在这里。max 级别生成的文本非常简短(类似“原始人模式”)。无论级别如何,代码块、路径和命令都不会被压缩。
节省的令牌来自哪里?
大部分节省来自输入令牌(输入模型的内容):
| 层 | 类型 | 典型节省比例 |
|---|---|---|
| 检索 | 输入 | 94%(完整文件 → 相关片段) |
| 片段压缩 | 输入 | 89%(片段 → 签名) |
| 语法压缩 | 输入 | 13%(删除冠词和填充词) |
| 轮次摘要 | 输入 | 因情况而异(会话历史) |
| 渐进式披露 | 输入 | 因情况而异(工具负载) |
| 输出压缩 | 输出 | 25-80%(取决于级别) |
每个输出令牌的成本是输入令牌的 5 倍(例如,Opus:每 1M 输入令牌 $15,对比每 1M 输出令牌 $75),因此即使只是略微减少输出,也能大幅降低成本。
路线图
- 多仓库基准测试(FastAPI、chi、fiber)
- 更多基准测试(Django、Express)
- 为 C、C++、Ruby、Swift、Kotlin 提供 Tree-sitter 支持
- 为远程模式提供 Docker 支持
- 迁移至 mcp 2.x API
已发布的功能请参阅 CHANGELOG.md。
贡献
欢迎贡献。有关设置说明,请参阅 https://github.com/elara-labs/code-context-engine/blob/main/CONTRIBUTING.md。
许可证
MIT。请参阅 LICENSE。
作者
致谢
Claude Code · MCP · sqlite-vec · Tree-sitter · fastembed · Ollama
如果 CCE 帮你节省了令牌,请给它点个星。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。