关于 context-firewall
Context Firewall 是供使用多个 MCP 服务的 AI Agent 使用的本地 MCP 代理。它将工具收拢为四个元工具,在结果进入模型前压缩大型输出,并支持通过 read_more 取回完整结果。
主要功能
- 01将下游工具收拢为四个元工具
- 02按需搜索工具并加载架构
- 03压缩 HTML、base64 和 JSON 输出
- 04通过 read_more 取回完整结果
- 05按服务及工具设置访问策略
- 06生成会话节省报告
适用场景
- 01减少 Agent 可见的工具定义
- 02让大型服务响应适配上下文预算
- 03取回压缩结果中的指定部分
- 04限制可调用的下游工具
MCP 相关
它作为 MCP 客户端与已配置下游服务之间的代理,支持 stdio 或 Streamable HTTP。客户端通过四个元工具发现并调用下游工具,结果经压缩后可通过 read_more 取回。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Context Firewall


在大型 MCP 工具输出进入模型的上下文窗口之前,将其缩减 60–95%;并将 50 多个工具定义合并为 4 个。 基于真实 HTML/JSON 测量得出,详见基准测试。适用于任何 MCP 客户端和任何模型。压缩后仍超出所配置令牌预算的内容会被硬截断至该预算,但始终可以通过 read_more 获取完整原文。
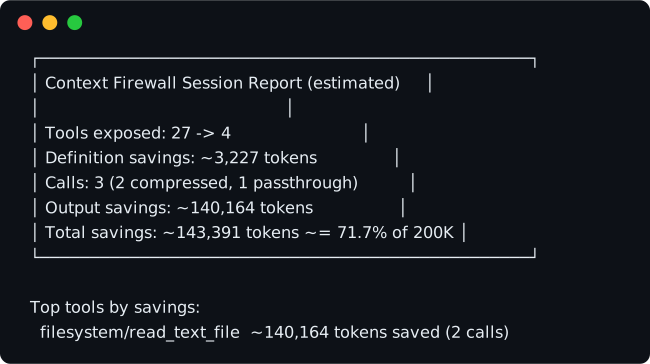
会话关闭时打印的报告——本例来自一个包含 3 次调用的真实会话(两次大型文件读取、一次回显)。所有数字均为实测,未经模拟。
Context Firewall 是一个本地 MCP 代理,位于你的 AI Agent(Claude Code、Claude Desktop、Cursor、Cline 等)与所配置的所有下游 MCP 服务之间。大型工具输出(原始 HTML、base64 数据块、超大 JSON)会在到达模型的上下文窗口之前进行压缩;无论下游服务实际上提供多少个工具,客户端看到的都只有 4 个工具。
实测结果
| 指标 | 结果 |
|---|---|
| 输出压缩 | 真实 HTML 页面可压缩 70–94%,大型结构化 JSON 可压缩 约 97%(仅经过智能处理阶段,尚未进行预算截断)——例如,通过 fetch 工具获取的实时 Wikipedia 页面:232,391 → 6,907 个字符(97.0%,实测);通过 jsonSummary 阶段处理的 GitHub issues JSON 负载:186,810 → 3,480 个字符(98.1%,实测) |
| 工具合并 | 对外提供 122 → 4 个元工具(5 个真实下游服务,包括官方 GitHub github-mcp-server,共 85 个工具) |
| 工具定义节省 | 约 28,600 个令牌 (估算值,字符数 ÷ 3.5)——原始定义 102,158 个字符,对外提供 2,146 个字符 |
所有数据均基于真实下游 MCP 服务测量,并非合成数据——完整方法和表格请见 docs/BENCHMARKS.md。
功能
- 渐进式工具披露——客户端启动时无需加载每个下游工具的完整架构,只会看到 4 个元工具(
list_tool_categories、search_tools、invoke_tool、read_more);只有实际搜索某个工具时,才会承担加载其完整架构的令牌成本。 - 输出压缩流水线——大型工具结果会依次经过以下处理,然后再返回:移除 base64 内容、提取主要内容并将 HTML 转换为 Markdown(如果页面有可识别的内容区域,则会移除页面外围元素——导航栏、网站页眉/页脚——让令牌预算用于实际内容,而非导航链接)、依据 JSON 结构进行智能摘要,最后按字符预算截断。
- 通过
read_more获取完整输出——不会静默丢弃任何内容。每个压缩后的输出都会以完整形式存储(在内存中,使用不透明句柄),并可通过read_more(handle, offset, length)分页读取。 - 会话节省情况报告——关闭时会打印可分享的终端报告卡(并可选生成 Markdown 文件),展示该会话在工具定义和输出令牌方面的节省情况,并列出节省最多的工具。
快速入门
npx context-firewall --config context-firewall.json
最简 context-firewall.json(downstreams 块与您熟悉的 mcpServers 格式一致):
{
  "downstreams": {
    "filesystem": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-filesystem", "/path/to/project"]
    },
    "github": {
      "command": "npx",
      "args": ["-y", "@modelcontextprotocol/server-github"],
      "env": { "GITHUB_PERSONAL_ACCESS_TOKEN": "${GITHUB_TOKEN}" }
    }
  }
}
(上面的 ${GITHUB_TOKEN} 只是此示例中的环境变量名称——您可以选择 shell 中已设置的任何变量;它会被展开为 GITHUB_PERSONAL_ACCESS_TOKEN,也就是下游服务实际读取的环境变量名称。)
选择哪个 GitHub 服务? 有两个选项,工具数量不同:
-
@modelcontextprotocol/server-github(上文使用的)——原始 npm 包,包含 26 个工具,只需一行npx -y,无需额外设置。上游已归档/不再维护,但仍可正常使用。 -
github/github-mcp-server——积极维护的官方服务,默认工具集包含 44 个工具,设置GITHUB_TOOLSETS=all时包含 85 个工具。它以 Go 二进制文件或 Docker 镜像的形式提供,而非 npm 包:"github": { "command": "docker", "args": ["run", "-i", "--rm", "-e", "GITHUB_PERSONAL_ACCESS_TOKEN", "ghcr.io/github/github-mcp-server"], "env": { "GITHUB_PERSONAL_ACCESS_TOKEN": "${GITHUB_TOKEN}" } }或直接运行本地构建/下载的二进制文件:
"command": "/path/to/github-mcp-server", "args": ["stdio"](使用相同的env块;添加GITHUB_TOOLSETS以指定要公开的 85 个工具)。
按工具设置允许/拒绝策略。 在任意下游条目中添加 allowTools/denyTools(精确名称或 * 通配符数组),以限制可调用的工具:
"github": {
  "command": "npx",
  "args": ["-y", "@modelcontextprotocol/server-github"],
  "denyTools": ["delete_*"]
}
拒绝规则始终优先于允许规则。设置 allowTools 后,只允许匹配的工具;该服务上的其他工具都会被阻止。空的 allowTools: [] 与省略此项的处理方式相同(允许所有工具),而不是“拒绝所有工具”。被阻止的工具不会显示在 search_tools 结果中,且 invoke_tool 会在向下游服务分发前拒绝调用。list_tool_categories 中的工具数量以及元工具描述中的数量均为未经筛选的总数——策略仅在调用 search_tools/invoke_tool 时执行。
客户端设置
将 Context Firewall 设为唯一的 MCP 服务——把您目前直接配置的所有下游服务(filesystem、github、everything 等)移至 context-firewall.json 的 downstreams 块中。这样,您的 Agent 看到的是 4 个工具,而不是所有下游服务工具数量的总和;将客户端指向 Context Firewall 并保留现有服务,并不能获得工具精简或压缩方面的好处。
以下客户端使用相同的服务条目:
{
  "mcpServers": {
    "context-firewall": {
      "command": "npx",
      "args": ["-y", "context-firewall", "--config", "/absolute/path/to/context-firewall.json"]
    }
  }
}
Claude Code
在仓库根目录中使用项目级 .mcp.json(如上所示),或通过 CLI 配置:
claude mcp add --transport stdio context-firewall -- npx -y context-firewall --config /absolute/path/to/context-firewall.json
Claude Desktop
claude_desktop_config.json(macOS:~/Library/Application Support/Claude/claude_desktop_config.json;Windows:%APPDATA%\Claude\claude_desktop_config.json)——使用与上文相同的 mcpServers 块。
Cursor
.cursor/mcp.json(项目级)或 ~/.cursor/mcp.json(全局)——使用与上文相同的 mcpServers 块。
Cline
cline_mcp_settings.json(VS Code 扩展存储目录;macOS:~/Library/Application Support/Code/User/globalStorage/saoudrizwan.claude-dev/settings/cline_mcp_settings.json)——使用与上文相同的 mcpServers 块。
兼容性状态
| 客户端 | 状态 |
|---|---|
| Claude Code | 已在真实 Agent 会话中测试——已端到端验证自主执行的 list → search → invoke → read_more 工作流 |
| Claude Desktop | 已通过协议验证* |
| Cursor | 已记录配置格式,欢迎社区测试 |
| Cline | 已记录配置格式,欢迎社区测试 |
* 已通过 MCP 协议集成测试验证(236 项自动化测试,包括针对真实下游服务的完整 stdio 协议往返测试,每次推送都会在 CI 中运行)。欢迎提供真实客户端的测试报告。
配置
downstreams
每个条目可以是 stdio 服务(格式与 mcpServers 相同),也可以是 Streamable HTTP 服务:
{
  "downstreams": {
    "local-tool": { "command": "npx", "args": ["-y", "some-mcp-server"], "env": { "TOKEN": "${TOKEN}" } },
    "remote-tool": { "url": "https://mcp.example.com/mcp", "transport": "streamable-http" }
  }
}
任何字符串值中的 ${VAR_NAME} 都会从环境变量中展开;如果变量不存在,配置加载会失败并显示易于理解的错误信息。
compression
策略解析顺序为 default < perServer < perTool(后者逐字段覆盖前者):
{
  "compression": {
    "default": {
      "maxOutputTokens": 2000,
      "htmlToMarkdown": true,
      "stripBase64": true,
      "jsonSummary": true,
      "llmSummary": false,
      "bypass": false
    },
    "perServer": { "github": { "maxOutputTokens": 4000 } },
    "perTool": { "filesystem/read_file": { "maxOutputTokens": 8000 } }
  }
}
| 字段 | 类型 | 默认值 | 含义 |
|---|---|---|---|
maxOutputTokens | number | 2000 | 压缩输出在最后兜底时截断至的软预算(字符数 ≈ 令牌数 × 3.5)。 |
htmlToMarkdown | boolean | true | 将检测到的 HTML 转换为 Markdown;如果能识别出主要内容区域,则提取该区域(剥除导航栏、页眉和页脚等界面元素)。 |
stripBase64 | boolean | true | 将 base64 数据块(数据 URI 和独立数据块)替换为 read_more 句柄。 |
jsonSummary | boolean | true | 合并同质 JSON 数组并缩短较长的字符串字段,同时保持 JSON 有效。 |
llmSummary | boolean | false | 使用你选择的大模型对超出预算的输出进行语义摘要。需要顶层 llm 块——请参阅 大模型摘要(可选启用)。 |
bypass | boolean | false | 跳过此服务/工具的整个处理流程——输出原样传递。 |
report
{
  "report": {
    "enabled": true,
    "markdownPath": "./context-firewall-report.md"
  }
}
| 字段 | 类型 | 默认值 | 含义 |
|---|---|---|---|
enabled | boolean | true | 关闭时将会话报告打印到 stderr。 |
markdownPath | string | (无) | 如果设置,还会将报告写入此路径下的 Markdown 文件。 |
callToolTimeoutMs
顶层配置(不嵌套在 compression 下)。传递给下游 MCP SDK 客户端的每次 invoke_tool 超时时间,单位为毫秒;如果下游挂起且不响应,超时后 invoke_tool 会返回 isError 结果,而不是一直阻塞。未设置时,默认使用 SDK 自身的默认值(60,000ms)。
{ "callToolTimeoutMs": 30000 }
工作原理
客户端调用 list_tool_categories() 查看已连接的服务及其大致功能,调用 search_tools(query) 获取候选工具的完整输入架构,调用 invoke_tool(server, tool, args) 实际运行工具(返回结果会经过压缩),并调用 read_more(handle, offset, length) 分页读取被压缩的内容。压缩运行时始终按相同顺序执行:剥除 base64 → 提取主要内容并将 HTML 转换为 Markdown → 摘要 JSON 结构 → 按预算截断(如果启用了下文介绍的可选大模型摘要阶段,则会在截断前运行)。内容提取的设计较为保守:只有在能识别语义内容区域(<article>/<main>),或能明确判断已移除内容并非页面实际内容时,才会剥除界面元素;否则会回退到转换整个页面——无论哪种情况,都始终可以通过 read_more 获取完整原文。与安全相关的输出(错误、权限/警告/确认消息)绝不会被静默压缩——它们会直接传递,唯一的限制是硬性截断至 50,000 个字符,以防单个失控的错误转储占满调用方的上下文。
LLM 摘要(选择启用)
确定性管道可以剥除标记、合并重复结构并截断内容,但无法对长篇自然语言输出(日志文件、文章、报告)进行语义压缩:确定性阶段完成后,任何仍超出预算的内容都会被直接截断。这个可选阶段弥补了这一不足:它会将超出预算的文本发送给你选择的模型,生成事实性摘要(保留 ID、路径、URL、数字和错误消息),并附加一个指向未改动完整原文的 read_more 指针,同时保留截断作为最后一道保护。此功能默认关闭,需要在两个独立层显式选择启用:顶层的 llm 块,以及压缩策略中的 llmSummary: true。任何兼容 OpenAI 的 /chat/completions 端点都可使用——选择一个提供商预设,或将 baseUrl 指向其他端点。
{
  "llm": {
    "provider": "openrouter",
    "model": "your-model-name"
  },
  "compression": {
    "default": { "llmSummary": true }
  }
}
provider 是预设基础 URL 和常规 API 密钥环境变量的简写:
| 提供商 | 基础 URL | 密钥环境变量 |
|---|---|---|
openai | https://api.openai.com/v1 | OPENAI_API_KEY |
openrouter | https://openrouter.ai/api/v1 | OPENROUTER_API_KEY |
orcarouter | https://api.orcarouter.ai/v1 | ORCAROUTER_API_KEY |
deepseek | https://api.deepseek.com/v1 | DEEPSEEK_API_KEY |
也可以通过 baseUrl 使用任何其他兼容 OpenAI 的端点(此时必须提供 apiKey):
{
  "llm": {
    "baseUrl": "https://api.your-provider.example/v1",
    "apiKey": "${LLM_API_KEY}",
    "model": "your-model-name"
  },
  "compression": {
    "default": { "llmSummary": true }
  }
}
| 字段 | 类型 | 默认值 | 含义 |
|---|---|---|---|
provider | string | (无) | 上述预设名称之一。必须提供 provider 或 baseUrl;如果两者都设置,则以显式指定的 baseUrl 为准(并发出警告)。 |
baseUrl | string | (来自预设) | 任何兼容 OpenAI 的端点的基础 URL;此阶段会向 <baseUrl>/chat/completions 发送 POST 请求。未设置 provider 时必须提供。 |
apiKey | string | (来自预设环境变量) | 作为 Authorization: Bearer ... 发送。使用 provider 时,默认为预设的密钥环境变量;显式指定的值(使用 ${ENV_VAR} 扩展——切勿填写明文密钥)会覆盖默认值。使用单独的 baseUrl 时必须提供。 |
model | string | (必填) | 原样传递给端点的模型名称。 |
timeoutMs | number | 20000 | 超过此时长后中止请求;超时后此阶段不执行任何操作。 |
maxInputChars | number | 120000 | 将发送到 API 的文本从开头截断至此字符数(硬性上限为 400,000,与配置无关——用于控制成本)。 |
使用 OrcaRouter 的示例——适用于免费模型(orcarouter/free 是其按难度路由的免费层级;API 密钥从 ORCAROUTER_API_KEY 读取):
{
  "llm": {
    "provider": "orcarouter",
    "model": "orcarouter/free"
  },
  "compression": {
    "default": { "llmSummary": true }
  }
}
可运行的完整示例:examples/config.llm-orcarouter.json 和 examples/config.llm-generic.json。
故障处理:如果端点宕机、无法访问、超时或返回格式错误的内容,此阶段会静默地不执行任何操作,输出将回退到确定性截断——端点不可用绝不会导致你的工具出错。
隐私:启用后,超出预算且不涉及安全敏感内容的工具输出会发送到你配置的端点——除此之外不会发送任何内容,也不会发送到其他位置。安全敏感输出(错误、权限拒绝、警告、确认)会在此阶段运行之前绕过压缩管道,因此绝不会被发送。如果你不接受将工具输出内容发送到该端点,请勿启用此功能。
披露说明
Context Firewall 参与了 OrcaRouter 开源计划:如果你选择 OrcaRouter 作为端点,本项目将获得由此产生的使用收入的 5%。这不会改变你的定价,完全由你自愿选择,并且任何兼容 OpenAI 的提供商都能以相同方式工作。
定位
Context Firewall 是对 Anthropic's Tool Search Tool 的补充,而非与之竞争。Tool Search 解决的是启动时工具定义膨胀的问题(即在调用任何工具之前加载到上下文中的架构),且仅适用于 Claude。Context Firewall 则在调用时压缩工具输出——这是 Tool Search 未涉及的另一半问题——并且适用于任何 MCP 客户端和任何模型,而不只是 Claude。
关于 token 数量的说明
本项目中的所有 token 数量(截断预算、会话报告)都通过 chars / 3.5 估算,绝不是针对特定模型的精确计数。默认情况下,不存在将工具输出内容发送到外部 API 的代码路径——无论是为了计算 token 数量,还是其他任何目的。如果你明确启用可选的 LLM 摘要阶段,超出预算的输出会发送到由你配置的端点——仅此而已,不会发送到其他任何地方;无论哪种情况,token 计数都在本地完成。出于这个原因,会话报告始终标注为“(估算)”。
安全
- 工具参数和输出内容绝不会写入日志或会话报告——其中只包含服务器/工具名称以及字符/token 数量。
- 与安全相关的输出(错误、权限拒绝、警告、确认)绝不会在不提示的情况下被压缩。
- 默认情况下,工具输出内容绝不会离开你的机器(你配置的下游服务器除外)。可选择启用的 LLM 摘要阶段是唯一可能将其发送到其他地方的代码路径,且默认关闭;安全敏感的输出也绝不会进入该阶段。
- 下游工具描述被视为不可信输入,只会显示,绝不会执行。
- 下游工具描述会原样传递,不做清理——
search_tools不会剥离或过滤恶意下游可能放入其中的提示词注入文本。信任边界在于你选择配置哪些下游服务器,而不在于此网关。 - 渐进式披露存在实际的权衡:工具描述会按需在会话中途送达,正是在调用模型通过
search_tools主动请求它们的时候——与会话开始时一次性展示所有工具相比,此时模型最不可能仔细审查其中嵌入的指令。截至 v0.3.0,此问题通过两种方式缓解:search_tools结果会包裹在<untrusted-tool-descriptions nonce="...">...</untrusted-tool-descriptions nonce="...">分隔符中,其中包含每个进程启动时生成一次的随机 nonce(crypto.randomBytes(8).toString('hex'),在进程的整个生命周期内固定),并附有说明,告知模型只有带有匹配 nonce 的结束标签才能结束该区块;CLI 还会在启动时将易读的摘要输出到 stderr(服务器名称、工具数量、主要类别),以便操作人员一眼看出实际连接了哪些内容。该 nonce 专门用于防止一种直接的绕过方式:下游在描述中嵌入自己的</untrusted-tool-descriptions>字符串,后接伪造的“可信系统”指令——它无法预测 nonce,因此无法伪造匹配的结束标签。残余风险:这仍然只是文本层面的约定,并非沙箱——它依赖调用模型实际阅读说明并遵守 nonce 匹配规则;没有任何机制能阻止模型完全忽略这些框定标记。上述两种缓解措施都不会清理描述内容本身——请参阅上文。分隔符框定现在使每次search_tools调用约增加 80-85 个 token(约 289 个字符,按本项目的 chars/3.5 估算)。 list_tool_categories显示的类别也来自下游提供的数据(工具名称,通过registry.ts中粗略的动词前缀启发式判断)——但与自由文本描述相比,工具名称是带宽低得多的指令夹带渠道,而且此输出没有用上述分隔符包裹。应将其视为比search_tools输出风险更低,而非毫无风险。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。