关于 Aether Cache
Mnemolith(原名 Aether Cache)为 AI 编码工具提供本地共享记忆。记忆关联 Git 文件,代码变化时可标记过期,并通过 MCP 服务提供记忆操作。
主要功能
- 01在 AI 工具间共享项目记忆
- 02关联文件并检查记忆是否过期
- 03语义搜索与完整历史
- 04审查冲突并合并重复项
- 05同步到 AGENTS.md 和 CLAUDE.md
- 06兼容 Redis 的 Java 引擎
适用场景
- 01在不同编码会话间保留项目事实
- 02查找代码修改影响的记忆
- 03审查并解决相互冲突的记忆
MCP 相关
MCP 服务让 Claude Code、Cursor 等 MCP 客户端共享项目记忆,并提供保存、检索、确认和替换事实的工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
10收录的工具列表 · 更新于 1 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| fact | string | 是 | |
| files | any | 否 |
详细介绍
Mnemolith
为 AI 编码工具提供共享记忆,并始终与代码保持一致。

Mnemolith(NEE-mo-lith):“记忆之石”。AI 学到的内容,铭刻在每个工具都能读取的地方。(名称由来)
原名 Aether Cache。 如果你安装了
aether-cache,请参阅从 Aether Cache 迁移:你的记忆会一并迁移。
Claude Code、Cursor 和其他 AI 工具每次会话之间都会忘记你的项目;即使它们记住了某些内容,也没有机制检查这些记忆是否仍然正确。Mnemolith 为所有工具提供一份共享的本地记忆,并确保它始终准确:
- 代码变更后,记忆会过时。 每条记忆都会关联到相关文件,并记录文件 Git 内容哈希的快照。当
docker-compose.yml发生变更时,关于它的记忆会自动失效,而不会永远提供给 AI。 - 矛盾内容会被替换,而不是堆积。 “我们已迁移到 MySQL”会使“我们使用 Postgres”失效,而不是让两条记忆并存、混淆模型。近似重复的内容会合并。
- 每条记忆都能说明自身来历。 哪个工具和会话保存了它、它所依据的文件版本,以及它经历的每次变更:创建、再次查看、过时、确认、替换。
- 它能配合你现有的文件使用。 当前记忆会同步到
AGENTS.md和CLAUDE.md中由它管理的区域,因此这些记忆会提交到版本库、在 PR 中接受审查,也会展示给未运行 Mnemolith 的队友。
它完全在你的机器上运行,底层使用的是我从零编写的数据库引擎。
不只是 Redis 克隆
Mnemolith 最初是用 Java 从零重建 Redis 的项目,后来不断发展。这里的每一层都从零编写,而且每一层都能实现其下层无法实现的功能:
| 层 | 提供的功能 |
|---|---|
| MCP 服务 | Claude Code、Cursor 和任何 MCP 工具共享同一份记忆 |
| Git 感知 | 记忆所描述的代码变更后,记忆会自动失效 |
| 记忆层 | 在引擎内部实现状态、来源记录、完整历史、重复内容合并和冲突审查 |
| HNSW 向量索引 | 语义搜索:在 100K 个向量上召回率为 99.4%,耗时 0.84 ms,比精确搜索快 22 倍 |
| 兼容 Redis 的引擎 | RESP 协议、50 多条命令、复制、事务和崩溃安全持久化(在 1,039,890 次写入和 8 次 kill -9 崩溃中,未丢失任何已确认写入),吞吐量达到原版 Redis 的 88–93% |
仅底层这一层就是一套可用的 Redis:redis-cli、redis-benchmark 和 redis-py 无需修改即可与之通信。记忆层、Git 感知和 MCP 服务则是 Redis 完全不具备的功能。
Claude Code ─┐                       ┌─────────────────────────────────────────────┐
Cursor ──────┼─ MCP ─► mnemolith ─┼─ RESP ─► Java engine (Main.java)            │
other tools ─┘   (Python: embeddings,│          memories, HNSW vector index,       │
                  git hashing, sync) │          history, append-only file on disk  │
                                     └─────────────────────────────────────────────┘
效果展示
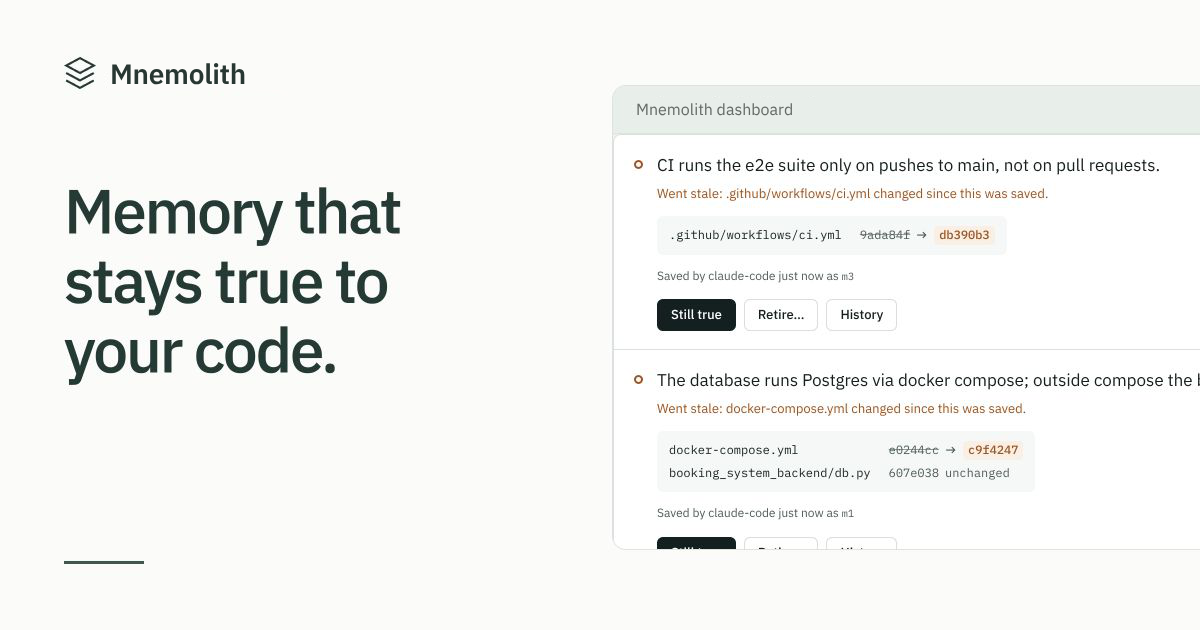
仪表板(mnemolith ui):关联文件已变更的记忆会等待处理决定,文件版本并排显示。

从 AI 工具端来看,一条记忆关联到某个文件,文件发生变更,下一次查询便会发现这一点:
> remember("The database runs Postgres via docker compose", files=["docker-compose.yml"])
Saved as m1.

        ... someone edits docker-compose.yml ...

> recall("database setup")
These memories were just retired because files they depend on changed. If one is still true,
call confirm_memory; if it's wrong, save the corrected fact with remember:
[m1] "The database runs Postgres via docker compose" is now marked outdated: docker-compose.yml changed.

> confirm_memory("m1")        # still true, so re-link it to the new version of the file
Confirmed m1; it's active again and linked to the current file versions.

> explain_memory("m1")
m1: "The database runs Postgres via docker compose"
status: active, project: demo
saved by: claude-code (session eea54b5c)
linked files: docker-compose.yml@02ea346...
history:
  19:16  created: by claude-code (session eea54b5c), linked to docker-compose.yml@87da641...
  19:16  active -> stale: docker-compose.yml changed since this was saved
  19:16  re-linked: to docker-compose.yml@02ea346... (confirmed still true)
  19:16  stale -> active: confirmed still true
较新的事实替换较旧的事实:
> remember("The API timeout was raised to 60 seconds")
Saved as m3.
Related existing memories:
[m1] (similarity 0.58) The API timeout is 30 seconds
If m3 makes any of these no longer true, call replace_memory(old_id, "m3"). Otherwise do nothing.

> replace_memory("m1", "m3")
m1 retired; m3 replaces it.
快速开始
一行命令即可安装所有内容并运行设置。在 macOS 或 Linux 上:
curl -fsSL https://mnemolith.dev/install.sh | sh
在 Windows(PowerShell)上:
powershell -ExecutionPolicy ByPass -c "irm https://mnemolith.dev/install.ps1 | iex"
安装程序(install.sh、[install.ps1](docs/install.ps1))会在你尚未安装 uv 时为你安装(uv 会一并安装 Python),安装 Mnemolith,并运行 mnemolith setup。想用自己的工具?以下任一方式都可以,之后再运行 mnemolith setup:
uv tool install mnemolith
pipx install mnemolith
pip install mnemolith        # Python 3.10+
setup 会在后台启动引擎、下载一次嵌入模型(约 90 MB),并连接它在你的计算机上找到的所有受支持 AI 工具:Claude Code、Cursor 和 Codex。就这么简单。在任意 git 仓库中打开 AI 工具并尝试:
记住,我们的测试需要设置 DOCKER_HOST。它取决于 docker-compose.yml。
然后启动新会话,并询问如何运行测试。
引擎可在 Java 11+ 上运行。如果你已安装 Java,就会使用它。如果没有,Mnemolith 会下载一份私有副本(约 50 MB)到 ~/.mnemolith/java,并根据其发布的校验和进行验证;这份副本仅供 Mnemolith 使用,不会安装到系统范围,运行 mnemolith uninstall 即可将其移除。
已经在 CLAUDE.md、AGENTS.md 或 Cursor 规则中为 AI 保存了笔记?在仓库中运行 mnemolith import(或在仪表板中使用导入笔记),即可将它们转换为记忆,并关联到笔记中提及的文件。
记忆按项目保存(以 git 仓库的文件夹名称区分),因此不同项目不会混在一起。所有内容都保留在你的计算机上:引擎只接受来自本机的连接,记忆保存在 ~/.mnemolith 中。
| 命令 | 功能 |
|---|---|
mnemolith setup | 一次性设置:引擎、模型和 AI 工具 |
mnemolith add | 添加当前所在的仓库(或指定路径),以便仪表板检查其中的文件;仪表板也可以为你查找并添加仓库 |
mnemolith ui | 打开仪表板:查看 AI 记住的内容,并确认或归档文件已更改的记忆 |
mnemolith import | 将 CLAUDE.md、AGENTS.md 和 Cursor 规则中的笔记转换为记忆;会先显示内容并征求确认 |
mnemolith remove | 移除一个项目(默认:当前所在的项目),相当于在仪表板中选择移除项目:其记忆会被归档,而非删除 |
mnemolith export | 将记忆及其关联文件和历史记录保存到 JSON 文件(使用 -p 指定一个项目) |
mnemolith status | 查看引擎是否正在运行,以及当前项目的记忆内容 |
mnemolith doctor | 检查所有内容,并说明如何修复问题 |
mnemolith list / recall "query" / explain m1 | 在终端查看记忆 |
mnemolith sync | 将当前记忆写入 AGENTS.md / CLAUDE.md |
mnemolith connect cursor | 连接一个工具(--print 会显示其他任意 MCP 工具的配置) |
mnemolith start / stop | 启动或停止引擎(工具需要时也会自动启动) |
mnemolith uninstall | 断开 AI 工具连接、停止引擎,并在删除记忆前征求确认 |
如果安装后找不到 mnemolith,请运行 uv tool update-shell,然后打开新的终端。端口 7380 被占用了?设置 MNEMOLITH_PORT 并再次运行 setup。要卸载:运行 mnemolith uninstall,然后运行 uv tool uninstall mnemolith。
从 Aether Cache 迁移
Mnemolith 以前名为 Aether Cache。如果你安装过 aether-cache,请运行上面的安装程序。它会安装 Mnemolith、移除 aether-cache、将记忆从 ~/.aether-cache 移至 ~/.mnemolith,并重新连接 AI 工具。不会丢失任何内容,已同步到 CLAUDE.md / AGENTS.md 的记忆也会在原处继续使用。
如果通过其他方式安装?用相同方式安装 mnemolith,运行 mnemolith setup,然后移除 aether-cache(运行 uv tool uninstall aether-cache、pipx uninstall aether-cache 或 pip uninstall aether-cache)。
AI 可以调用的工具
| 工具 | 功能 |
|---|---|
remember(fact, files?) | 保存持久事实,可选择关联文件。合并近乎相同的重复内容,并显示相关记忆,供 AI 判断新事实是否取代其中一条。 |
recall(query, limit?) | 按含义搜索项目记忆。优先检查关联文件,因此绝不会返回代码已发生变化的记忆。 |
explain_memory(id) | 说明记忆的来源及其完整历史。 |
replace_memory(old, new) | 将被新记忆证伪的旧记忆标记为失效。 |
mark_outdated(id, reason) | 将后来证实有误的记忆标记为失效。 |
confirm_memory(id) | 文件发生变化后,恢复仍然正确的记忆,并将其重新关联到当前版本。 |
check_stale() | 按需运行文件检查。 |
list_conflicts() / resolve_conflict(...) | 检查可能相互矛盾的高度相似记忆。 |
sync_to_files() | 将当前记忆写入 AGENTS.md / CLAUDE.md(也可使用:mnemolith sync)。 |
设计决策与测量结果
相似度无法检测矛盾,因此由 AI 判断
第一个版本会在新记忆与现有记忆相似时,将其标记为可能存在矛盾。通过真实的 all-MiniLM-L6-v2 嵌入模型进行校准后发现,这种方法行不通:
| 对比 | 类型 | 相似度 |
|---|---|---|
| "we use Postgres" / "the database is Postgres" | 重复 | 0.73 |
| "tests need DOCKER_HOST set" / "you have to set DOCKER_HOST before running tests" | 重复 | 0.92 |
| "we use Postgres" / "we migrated to MySQL" | 矛盾 | 0.30 |
| "API timeout is 30 seconds" / "API timeout is 60 seconds" | 矛盾 | 0.94 |
| "tests need DOCKER_HOST set" / "integration tests need a running Redis" | 相关,且两者都正确 | 0.34 |
重复内容的得分为 0.73 到 0.92,矛盾内容的得分为 0.30 到 0.94,因此没有任何阈值能将两者区分开来。若阈值低到足以合并真正的重复内容,就会悄无声息地把“超时为 30 秒”和“超时为 60 秒”合并,这将是本产品可能出现的最严重错误。因此,引擎只会自动合并几乎完全相同的文本(相似度 ≥ 0.97)。对于其他情况,嵌入模型会找出相关记忆,再由已能理解句子的 AI 判断哪条记忆取代了另一条。
过时检测比较的是文件内容,而非提交
每个关联文件都以 path@<git blob hash> 的形式存储,哈希通过 git hash-object 计算。比较文件内容而非提交 ID,可以检测未提交的编辑,忽略未改动该文件的提交,而且不需要 Git 钩子:每次搜索前,recall 都会重新计算少量关联文件的哈希。
记忆永远不会悄无声息地变化
每次变更都会记录为事件,并附带时间戳和原因。引擎会将每条记忆连同分配给它的 ID 和时间戳一起记录,因此重启后重放日志时,可以精确重建完全相同的记忆及其历史,精确到毫秒,而不会生成新的记录。
底层引擎
一个用 Java 从头编写、兼容 Redis 的服务。它支持 RESP,因此 redis-cli、redis-benchmark 和 redis-py 无需任何改动即可使用。核心部分是通过完成 CodeCrafters "Build Your Own Redis" 挑战的所有阶段和扩展构建的;向量索引、持久化强化和记忆层则是我自行添加的内容。
吞吐量与官方 Redis 的对比
redis-benchmark -t set,get,100K 个请求、50 个并行客户端、3 字节值,在同一台机器上:
| Mnemolith | Redis 8.10.2 | Mnemolith 占 Redis 的比例 | |
|---|---|---|---|
| SET | 205.8K ops/sec | 233.6K ops/sec | 88% |
| GET | 225.7K ops/sec | 242.7K ops/sec | 93% |
| p50 延迟 | 0.119 ms | 0.111 ms | |
| p99 延迟(SET / GET) | 0.375 / 0.231 ms | 0.359 / 0.159 ms | |
| 最大延迟(SET) | 19.7 ms | 1.3 ms | JVM GC / JIT 暂停 |
典型延迟与 Redis 相当。差距主要体现在最坏情况下的延迟,这是由 JVM 垃圾回收和 JIT 预热导致的,而用 C 编写的 Redis 不存在这些问题。
HNSW 向量搜索与精确搜索的对比
使用 all-MiniLM-L6-v2 为 100,000 条 AG News 标题生成嵌入(384 维,余弦相似度),并使用 500 个留出查询,k = 10。召回率以相同数据上的精确暴力搜索结果为基准进行测量。
| 模式 | Recall@10 | p50 延迟 | p99 延迟 |
|---|---|---|---|
| 精确(暴力搜索) | 1.000 | 18.58 ms | 20.52 ms |
| HNSW,ef=10 | 0.905 | 0.49 ms | 1.38 ms |
| HNSW,ef=20 | 0.951 | 0.52 ms | 0.73 ms |
| HNSW,ef=50 | 0.985 | 0.66 ms | 0.89 ms |
| HNSW,ef=100 | 0.994 | 0.84 ms | 1.41 ms |
| HNSW,ef=200 | 0.998 | 1.24 ms | 2.19 ms |
ef=100 时,HNSW 返回的真实前 10 个结果占 99.4%,速度约比精确搜索快 22×。为 100K 个向量构建索引耗时 136 秒(M=16,M0=32,efConstruction=200)。延迟从 Python 客户端测量,因此包含网络和客户端开销。完整设置和原始数据见:results.json。
**工作原理:**每个向量都会在分层图中连接到其最近邻。搜索从包含长距离链接的稀疏顶层开始,贪心地向查询点跳转,每次下降一层,最后在底层执行最佳优先搜索,并保留 ef 个最佳候选项。邻居选择采用 HNSW 论文中的多样性启发式方法(优先选择方向各异而非近似重复的邻居),这正是保持高召回率的关键。
**带过滤的搜索:**HNSW 不知道内存状态,因此搜索会过量获取候选项,剔除不匹配的结果(过期或已被取代),在剩余结果太少时扩大搜索范围,并在需要时回退到精确扫描。在一项测试中,2,000 条记忆里只有 2% 处于活动状态,带过滤的搜索在 30/30 个查询中都准确返回了正确的前 10 个结果。问题在于:在这种选择性下,大多数情况下都会执行精确回退;这是图索引后置过滤已知的弱点。
崩溃安全性
每次写入都会写入一个仅追加文件(AOF),并在启动时重放。
kill -9 崩溃测试(crash_test.py):客户端尽可能快速地写入,服务器在随机时刻被终止并重启,然后检查服务器确认过的每次写入。
| fsync 策略 | 崩溃次数 | 已确认写入数 | 丢失数 |
|---|---|---|---|
everysec | 5 | 757,295 | 0 |
always | 3 | 282,595 | 0 |
每次重启的恢复耗时 0.6 秒,最多重放约 185K 次写入。
**写入撕裂:**机器崩溃可能导致最后一次写入只完成一半。第一个版本遇到此类文件时会拒绝启动;现在,重放会在最后一条完整命令处停止、截去不完整命令,然后正常启动,且此前的所有数据都会完好保留。
各 fsync 策略的开销(SET 吞吐量,50 个客户端):
| 策略 | 吞吐量 | p50 延迟 |
|---|---|---|
always(每次写入都同步) | 42.9K/sec | 1.159 ms |
everysec(每秒同步一次) | 113.9K/sec | 0.103 ms |
no(由操作系统决定) | 118.8K/sec | 0.103 ms |
everysec 比 always 快 2.7×,且与 no 相差不到 4%,因此它是合理的默认选项。在 macOS 上,fsync 不会强制刷新 SSD 自带的缓存,因此此处的 always 开销比在 Linux 服务器上更低。
完整命令列表
- 记忆:
MEM.ADD、MEM.GET、MEM.SEARCH(带STATUS筛选)、MEM.STATUS、MEM.WHY、MEM.LISTMEM.FILES、MEM.SEEN、MEM.CONFLICTS、MEM.RESOLVE
- 向量:
VADD、VSEARCH(HNSW,可调节EF,支持EXACT模式) - 字符串:
GET、SET(EX/PX)、INCR、STRLEN、TYPE、KEYS * - 列表:
RPUSH、LPUSH、LRANGE、LLEN、LPOP、阻塞式BLPOP - 流:
XADD(显式、部分和自动 ID)、XRANGE、XREAD(带BLOCK和$) - 有序集合:
ZADD、ZRANK、ZRANGE、ZCARD、ZSCORE、ZREM - 位图:
SETBIT、GETBIT、BITCOUNT、BITOP AND/OR(二进制安全字符串) - 地理空间:
GEOADD、GEOPOS、GEODIST、GEOSEARCH ... FROMLONLAT ... BYRADIUS - 事务:
MULTI、EXEC、DISCARD、WATCH、UNWATCH(通过每个键的写入版本实现乐观锁) - 发布/订阅:
SUBSCRIBE、UNSUBSCRIBE、PUBLISH - 复制:
- 主从握手(
PING、REPLCONF、PSYNC)和命令传播 REPLCONF GETACK偏移量跟踪和WAIT
- 主从握手(
- 持久化: RDB 加载;带清单的 AOF、
appendfsync always/everysec/no,以及写入中断恢复 - 身份验证:
AUTH、ACL WHOAMI/GETUSER/SETUSER(SHA-256 密码哈希)
单独运行引擎
java src/main/java/Main.java                                   # port 6379
java src/main/java/Main.java --bind 127.0.0.1                  # accept connections from this machine only
java src/main/java/Main.java --port 6380 --replicaof "localhost 6379"
java src/main/java/Main.java --dir /tmp/data --appendonly yes --appendfsync everysec
重现基准测试
每项基准测试都针对已启动的引擎运行:
redis-benchmark -p 6379 -t set,get                 # throughput; also run against redis-server to compare
python vector_bench.py                             # HNSW recall and latency (start the engine with -Xmx4g)
python crash_test.py everysec 5                    # kill -9 crash test
python memory_mcp/calibrate.py                     # embedding similarity calibration
相关项目
Mnemolith 是一个早期的开源项目。以下是在同一领域中用于生产环境的系统:
- Redis 风格存储中的向量搜索:
- Redis 8 vector sets 和 valkey-search 为 Redis 和 Valkey 添加了 HNSW 向量搜索功能。
- hnswlib 是 HNSW 的参考实现。
- Malkov & Yashunin (2016) 是此索引所依据的论文。
- AI Agent 的记忆: Mem0、Zep, Letta,以及 MCP reference memory server。
- 指令文件: AGENTS.md 和
CLAUDE.md。Mnemolith 会同步到这些文件中,而不是 替换它们。
状态与限制
Mnemolith 处于 v1 早期阶段。它已通过自动化测试实现端到端运行,目前正在真实的 Claude Code 会话中试用。
尚未完成:
- 在真实编码任务中评估有记忆与无记忆的表现,以衡量它是否确实能减少重复解释。
- **AOF 压缩:**日志只会不断增长,每次状态变更都会增加一行。
引擎限制:
- **线程:**每个连接使用一个 OS 线程,而不是事件循环。这对本地工具来说没有问题,但无法像 Redis 那样扩展到 数千个客户端。
- 事务:
EXEC不具备隔离性,因此其他客户端的命令可能会插入事务中的命令之间。 - **向量索引:**重新添加向量会更新该向量,但不会重新连线其图链接,而且不支持删除。已停用的记忆会被筛除,而不会被移除。
- **复制:**仅支持完整重新同步,且新副本默认主服务器的数据集为空。
- 其他小缺口:
KEYS *只列出字符串键。GEOSEARCH会扫描所有成员。- ACL 仅支持
default用户。 - 不支持
HELLO(RESP3),因此客户端必须使用 RESP2。
项目布局
src/main/java/Main.java      the engine (single file, from the CodeCrafters setup)
mnemolith/                   the Python package behind the `mnemolith` command
  server.py                  MCP server: embeddings, git staleness, AGENTS.md/CLAUDE.md sync
  engine.py                  finds Java, starts and stops the engine in the background
  javart.py                  downloads a private copy of Java when the computer has none
  connect.py                 registers Mnemolith with Claude Code, Cursor, and Codex
  cli.py                     the `mnemolith` command
  ui.py, ui/index.html       the dashboard (`mnemolith ui`): a local server, its API, and the page
  portability.py             import from notes files, export to JSON
  engine/mnemolith-engine.jar the prebuilt engine (rebuild with `python scripts/build_engine.py`)
memory_mcp/calibrate.py      similarity calibration for duplicate/contradiction thresholds
vector_bench.py              HNSW benchmark (writes results.json)
crash_test.py                kill -9 crash-safety test
发布
在 pyproject.toml、mnemolith/__init__.py 和 server.json 中更新版本号,提交,然后运行:
git tag v0.2.2 && git push --tags
发布工作流会检查版本号是否一致,构建并对软件包进行冒烟测试,将其发布到 PyPI 和 MCP Registry,并创建 GitHub Release。
许可证
MIT。请参阅 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。