关于 pasr
pasr 是面向编码 Agent 的本地 MCP 服务,可按 token 预算选择源码上下文并记录文件与行号来源。它在原生搜索和文件读取之外提供排序检索与选择回执。
主要功能
- 01按 token 预算选择上下文
- 02记录文件与行号来源
- 03回执说明选择及原因
- 04基于词项和符号排序搜索
- 05无需守护进程即可本地运行
适用场景
- 01为编码问题选择源码
- 02检查代码片段保留或舍弃的原因
- 03将选取的上下文追溯到仓库行号
MCP 相关
该 MCP 服务提供搜索和选择仓库上下文的工具。客户端可将这些工具与原生搜索及文件读取工具配合使用。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
5收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| query | string | 否 | |
| top_k | integer | 否 | |
| include | array | 否 |
详细介绍

感知来源的片段召回 — 为编码 Agent 提供本地化、按令牌预算控制、 可追溯来源的上下文。



问题
Agent 需要足够的源代码才能正确作答,而每条检索到的观察结果都可能被带入后续模型请求。原生 grep 和有界文件读取已经能提供有用的源代码及来源信息。PASR 必须证明其额外的检索、选择和工具目录复杂度相对于这一基线是合理的,而不是相对于转储整个代码库。
PASR 的功能
按预算控制
实时 select_context 会为返回的上下文设定预算,包括标签、标题、分隔符和脱敏内容;不包括 MCP JSON 信封或累计对话内容。只有当最终呈现形式符合预算时,才会纳入完整的计算片段;这些片段不一定是完整函数。无损选择使用精确的渲染成本,可选的标头不会挤掉本来就能容纳的源代码。

可追溯
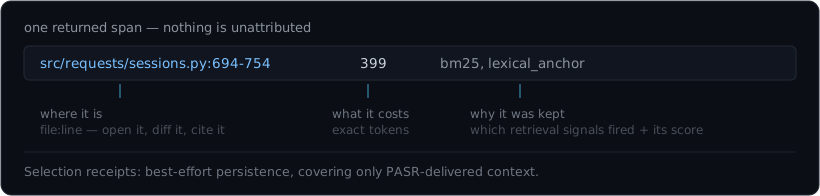
选择回执会记录每个片段的 file:line、令牌数、检索信号,以及保留或丢弃该片段的原因。回执保存在 .pasr/receipts 下;持久化尽力而为,响应会报告是否写入了回执。这些回执仅涵盖 PASR 提供的上下文,不涵盖 Agent 读取或执行的所有内容。
诚实
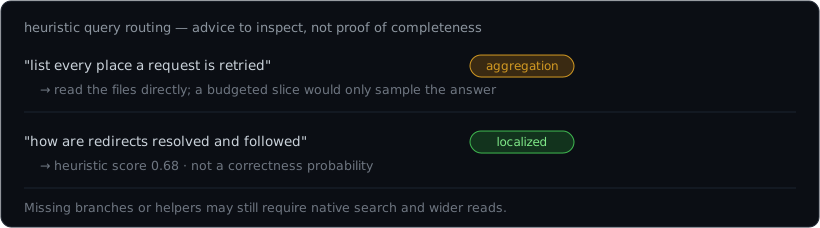
回执会公开启发式查询分类、关键词覆盖情况和路由建议。这些内容不是经过校准的正确概率,也不能证明已检索到所有必要证据。建议不能取代对源代码的检查。
默认本地运行
无需守护进程、向量数据库或手动设置索引。离线选择需要已安装的依赖项和缓存的分词器数据;可选的模型权重需另行准备。客户端仍可能将返回的源代码转发给云端模型。默认的脱敏操作不执行任何处理,并非自动检测机密信息。
安装
从 PyPI 安装 0.4.0 版本。
安装 uv,并确保 uvx 可在 PATH 中使用;
使用 Python 3.10+,或允许 uv 为其提供运行环境。无需检出 PASR。
将 /absolute/path/to/project 替换为要检查的仓库,然后为你的客户端选择
相应的命令:
claude mcp add pasr -- uvx --from pasr-mcp==0.4.0 pasr-mcp --workspace /absolute/path/to/project
codex mcp add pasr -- uvx --from pasr-mcp==0.4.0 pasr-mcp --workspace /absolute/path/to/project
或者,将此 MCP 配置合并到客户端的配置中。如已有 pasr 条目,请更新该条目,
而不是重复注册同一服务:
{ "mcpServers": { "pasr": { "command": "uvx", "args": ["--from", "pasr-mcp==0.4.0", "pasr-mcp", "--workspace", "/absolute/path/to/project"] } } }
如需使用单独的 v0.4.0 GitHub 发布版 wheel,请使用:
python -m pip install https://github.com/Apheironn/pasr/releases/download/v0.4.0/pasr_mcp-0.4.0-py3-none-any.whl
安装该 wheel 后,将客户端配置为运行已安装的 pasr-mcp
可执行文件,并使用 --workspace /absolute/path/to/project,而不是通过 uvx 启动。
仅限开发者 — 源码检出: 在现有注册配置中,将 --from 后的
pasr-mcp==0.4.0 替换为 /absolute/path/to/pasr。例如:
uvx --from /absolute/path/to/pasr pasr-mcp --workspace /absolute/path/to/project
请使用此配置替代已发布软件包的启动方式,不要另行注册第二个 pasr。
它会运行该检出版本,该版本可能与发布版不同;编辑它不会更新
已有的全局安装。
安装后,PASR 的工具会与 Agent 的原生工具一同提供。模型会决定何时搜索、选择上下文 或直接读取文件。仅凭所选上下文更少,并不能证明答案成本更低或更准确。
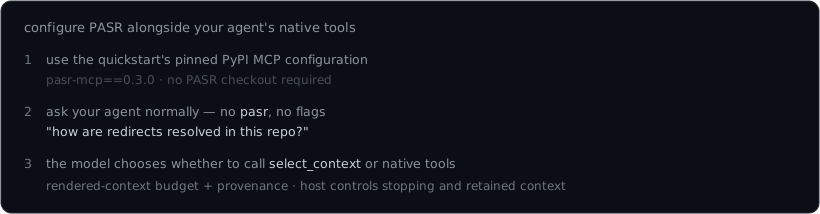
各客户端的设置说明:Claude Code · Cursor · Windsurf。
不使用 Agent 时: 在要检查的项目中运行 uvx --from pasr-mcp==0.4.0 pasr explain "<question>"
以打印选择回执。
examples/ 中有五个使用固定公共仓库的历史 CLI 示例。
0.4.0 诊断
0.4.0 版本包含 pasr doctor。要诊断此软件包安装,请使用与已注册服务
相同的版本:
uvx --from pasr-mcp==0.4.0 pasr --workspace /absolute/path/to/project doctor --json --timeout 30
省略 --json 可生成易读的报告。退出代码分别为:成功时 0,诊断失败时 1,
选项无效时 2。协议截止时间必须是有限的正数;子进程关闭可能还需要几秒钟。
该命令会检查工作区是否为目录,然后在一次性测试环境中启动真实的 MCP
服务,以检查其目录并选择已知源码。
它不会扫描或写入项目或其 .pasr/ 状态。报告包含运行时版本和检查结果,不包含源码、
绝对路径、环境值或原始异常消息。它不会调用付费模型,也不会自动上传报告;
初始设置或分词器编码下载可能需要网络连接。
检查通过并不能验证客户端的注册、审批设置或回答。
可选的公开报告:安装问题 或实际任务反馈。 发布前请先检查;不要包含机密、私有源码或原始对话记录。 Doctor 为可选工具;你可以不运行它而直接提交报告。
已验证的 Codex 上手流程及明确限制
2026-10-04,Codex CLI 0.160.0 + GPT-6 Luna 使用已安装的 0.3.0 wheel, 在一个仅包含单个未经修改的 PASR 源文件的隔离工作区中,回答了一个阅读源代码的问题。最终方案使用了 3 次由模型选择的 PASR 调用、364 个选定上下文令牌,以及经源代码核对的相对行号引用。 这是一次受控的集成冒烟测试,不代表独立用户采用情况,也不能证明模型总成本更低。设置失败和模型较早的回合均保留在集成记录中。
交互使用时,请在客户端提示时批准已知的 PASR 服务。在无人值守的 Codex 运行中,approval_policy = "never" 并不会授予 MCP 工具权限:首次模型调用被阻止。只有在经过审查且可信的服务/工作区中,才应在现有的 [mcp_servers.pasr] 表中设置 default_tools_approval_mode = "approve"。这是对该服务的明确预先批准,并非禁用全局安全措施的理由。PASR 可能会在其工作区中写入回执/缓存;主机的只读 Shell 沙箱并不会隔离 MCP 进程。
请要求提供从 PASR 输出中复制的相对于工作区的 file:line 范围,并以纯文本形式呈现,而不是编造绝对链接。先前的回答添加了不存在的 /workspace 前缀;修订后的引用指令生成了匹配的引用。使用脚本运行 codex exec 时,请关闭未使用的标准输入;否则它可能会等待更多提示输入。这些观察结果都不能证明其他客户端/模型会有相同表现。
如需重复此受控任务,请构建 wheel,并从检出目录的根目录运行已纳入版本控制的驱动程序。请先安装 Codex,并通过常规密钥管理机制提供 OPENAI_API_KEY;这会产生付费 API 请求。
python -m build --outdir dist/demo
python scripts/demo_client.py --codex /absolute/path/to/codex --wheel dist/demo/pasr_mcp-0.4.0-py3-none-any.whl --output eval/agent_bench/results/client-demo
在 Windows 上,请传入实际的 codex.exe,而不是它的 Shell 包装程序。输出目录必须是新建的。驱动程序会将 wheel 安装到临时环境中,仅复制 src/pasr/source_text.py,隔离 Codex 配置,并在清理前保留答案、工具调用、用量、警告和失败信息。它不会评定答案的正确性,而且只会对完全匹配的 API 密钥进行脱敏:分享前请检查证据。维护中的驱动程序也已使用真实模型进行测试;请参阅其重复测试记录。
一次调用
针对 psf/requests 提出一个限定范围的问题——“重定向如何解析并跟随”(逐字记录):
| 历史 CLI 选择结果 | 观察结果 |
|---|---|
| 源上下文令牌 | 从 42,768 个提供的令牌中选出 2,718 个 |
| 来源信息 | 10 个片段均包含 file:line 和选择原因 |
| 启发式诊断 | localized,置信度为 0.68;这不是正确性概率 |
| 观察到的选择耗时 | 在该代码库上离线运行约 0.3 秒 |
这只是源代码选择示例,并非原生 grep/read 基线、答案质量评测结果,也不代表当前 MCP 默认的 1,500 个上下文令牌上限。
证据与替代方案
原生 grep 和有界读取是实用的默认选项。PASR 增加了明确的上下文预算和选择回执;但这并不能证明答案更好或模型总费用更低。Aider RepoMap 提供结构化导航,Repomix 则会将源代码打包供模型使用。这些工作流存在重叠,但并非可互换的产品。
最新工作流研究(2026-10-05):不升级流水线。 在 420 次本地调用中测量了全部 10 种 PASR 方法。回答研究保留了 664 条轨迹,其中包括一项进行了 400 次尝试、涵盖 40 个问题的比较,使用了实际的 Repomix 和 Serena 组件;开发期间也运行了实际的 Aider RepoMap。
在 Luna 上,所选提示词策略的累计提供方 token 用量比未更改的 split-4 多 18.26%(配对 95% 比率区间 1.04594–1.35231)。完全符合评分标准且有来源支持的答案从 3/40 增至 4/40,存在重大错误的答案则从 5 个降至 3 个,但成本目标未达成。这些严格的完整性评分并非通常意义上的答案准确率。有两次提供方故障导致用量未知;经用户批准后,剩余计划得以完成,没有重试,但这不能算作未加限定的确认。生产环境的检索默认设置保持不变。
请参阅逐方法及竞品报告、机器可读摘要和许可证据包。回答 API 的保守成本上限为 $0.644405;编写、编码和审查期间的助手会话 token 不计入,且未经测量。
较早的来源审查研究(2026-10-03):质量与成本的综合门槛也未通过。 这些研究中的实验性拆分读取器使用 search_code / read_code,并由主机强制限制为最多调用四次,同时采用保守的停止指示。该工作流并非默认安装的产品:
| 研究 | 获支持的答案(原生 / 拆分) | 重大错误(原生 / 拆分) | Token 发现与结论 |
|---|---|---|---|
| 此前未参与过的 40 题确认研究 | 28/40 / 28/40 | 3 / 7 | 拆分方案的累计提供方 token 用量减少了 25.3%;主要门槛未通过 |
| 探索性复用同一组 40 题,GPT-6 Luna | 26/40 / 32/40 | 2 / 2 | 平均 token 用量:原生 12,430.875(已知小计),拆分 10,698.075;综合门槛未通过 |
探索性原生运行中有一个请求中断,用量未知;已知小计并非完整的 token 总量。同一研究还在共享的回答测试框架下,使用了实际的上游 Aider RepoMap 和 Repomix 上下文生成,而非完整的 Aider 编码 Agent。结果因模型而异,现有不确定性不足以证明与原生工具或竞品准确率相当,也不足以证明其普遍更优。
请参阅确认记录、探索性矩阵、竞品方法与注意事项,以及流水线审计,第 23–24 节。较早的选择器评估和离线本地化代理采用不同协议;它们不代表当前端到端产品取得了成功。
工作原理
query + files / line ranges / globs
  → discover safe files, read requested sections, tokenize, line-aligned chunks
  → lossless-under-budget check: does the whole thing already fit? return it
  → range-only body read: ordered whole-line prefix + explicit remaining ranges
  → otherwise, ranked selection:
  → candidates: BM25 + lexical coverage + Python AST / JS/TS/Rust tree-sitter symbols
                + optional hashing / MiniLM scorer
  → fuse unique span ranks per signal         score(s) = Σ_r 1 / (k + rank_r(s)), k = 60
  → optional single-source prefix/tail reserve (off in default MCP selection)
  → greedy source-span packing with exact final-context cost ≤ budget
  → classify the query, score confidence, write the receipt
  → return spans + provenance + token accounting + advice
RRF 合并的是排名顺序,而不是校准原始分数。打包采用贪心算法(覆盖感知或仅依据分数),并非精确的背包优化器。在检查渲染后的成本之前,会先按依赖顺序排列选中的片段。
在融合候选项截断之前,覆盖感知选择会优先保留字面请求的区分大小写定义,并依据实际渲染预算计算完整正文的成本。兼容的重叠源片段会合并为一个片段,而不是丢弃未覆盖部分。其余选择优先考虑每个词元带来的边际关键词覆盖率,然后考虑来源多样性和排名。
BM25 和词法选择会保留精确标识符,同时也会匹配点号、连字符和蛇形命名法分隔的组成部分。因此,在原始片段中,needle 可以匹配 needle_worker,但不会将其视为字面定义名称请求。组成部分匹配不代表能够理解同义词或覆盖完整机制。
MCP 工具
定位器会返回工作区路径,并在可用时提供行位置或 read_lines 提示。select_context 接受路径和 path:start-end 范围。位置提示并不能证明狭窄范围内包含回答所需的所有机制。
嵌入方可以通过 create_server(root, expose=("find_symbols", "find_evidence")) 仅发布两个定位器,并搭配宿主原生源代码读取器使用。它们提供的导航建议不会调用未公开的 PASR 工具。这是实验性配置,并未证明能提升准确率或节省词元;默认的五工具目录保持不变。
等效的 stdio 配置为
uvx --from pasr-mcp==0.4.0 pasr-mcp --workspace /absolute/path/to/project --tools find_symbols,find_evidence。
请确保宿主的原生 grep 和源代码读取器仍可用;此目录不包含源代码读取工具。
include 路径和 glob 模式均相对于工作区根目录。*.py 只搜索根目录下的文件;**/*.py 则包含嵌套的 Python 文件。如果不确定目录结构,请省略 include。定位器描述会说明这一区别;即使匹配到的范围过窄,也不会自动扩大范围。
默认公开前五个工具;其他工具需选择启用。
| 工具 | 用途 |
|---|---|
find_evidence | 在整个仓库中搜索内容:优先查找明确限定的定义,然后按混合稀有度、子词相似度和引用排名排序;排名靠前的结果附带有界的 read_lines 片段 |
find_files | 按路径/文件名匹配度排列文件 |
find_symbols | 查找符号的定义位置,以 file:line 形式返回(Python、JS/TS、Rust) |
find_usages | 查找符号的使用位置:匹配行、包含这些行的定义,以及排名靠前结果中有界的 read_lines 片段 |
select_context | 在预算内选择并追踪来源的代码片段——outline=true 用于定义;files=["path.rs:42-56"] 用于包含端点的范围;映射/追踪选项位于 advanced 下 |
search_code(选择启用) | 仅使用 query,从排名前三的匹配文件中发现并选择内容;上下文上限为 1,500 个词元 |
read_code(选择启用) | 从必需且非空的已知 files 中选择内容;显式范围会在相同上限下按顺序继续读取 |
trace_dependencies(选择启用) | 对名称引用进行有界的静态近似分析;direction="callers" 会反向追踪,但不会完整解析绑定 |
explain_selection(选择启用) | 如果先前的回执已持久化且仍可用,则返回该回执 |
expand_context(选择启用) | 增加先前选择的预算,但不扩大其源范围,也不更改大纲模式 |
| 字面符号名称和单个文件名/路径查询会保留停用词部分: | |
Where 和 where.py 仍可搜索,不会像普通文本词语那样被过滤掉。 | |
| 精确的字面符号名称会抑制部分匹配的同名项;只有在没有精确匹配的定义时, | |
| 其下划线分隔的部分才会用于回退匹配。 | |
只有空白或仅包含空格的 find_files 查询才会请求未排序的列表。 | |
| 符号类型别名会同时应用于请求的筛选条件和发现的类型, | |
因此使用 kinds=["class"] 时仍能找到原生 Python class。 |
在发现过程中,像 hooks.enforce 或
Controller.dispatch 这样的显式限定名称会优先匹配定义所在的文件,而非仅有提及的文件。
限定符必须匹配模块路径或实际的外围定义;
这不会解析导入别名。宽泛查询的评分、显式范围和上下文预算均保持不变。选择文件前,
选择加入的 search_code 会使用相同的发现排序,从三个文件中进行选择。
将命中项 provenance 中的路径与 read_lines 组合起来,并将其传递给
select_context(query=..., files=["path.rs:42-56"]),而不是读取整个文件。如果建议范围
不超过 40 行,则会包含外围函数;否则会包含命中位置前后各最多八行。较大的函数可能需要
更宽的显式范围,或使用 find_symbols 定位完整定义。现有代码片段、排序、计数和警告均会保留。
对于未知位置,调用 search_code(query="cert_verify") 以发现实际的工作区相对路径。发现功能不接受
files、include 或其他范围参数;不要根据包名猜测路径。
对于已知位置,调用单独的选择加入读取工具:
read_code(query="validation exit state", files=["src/attr/validators.py:73-88"])。
它要求 files 参数存在且非空,并使用与 select_context 相同的路径/范围语法。
范围为空、缺失、为目录、部分缺失或越界时都会失败,而不会扩大搜索范围。两个工具都会拒绝未知参数。
迁移: 将 search_code(query=..., files=...) 替换为 read_code(...);
旧的带范围发现调用会被拒绝,不会被静默视为发现调用。
仅范围回复会包含 continuation 和同一次读取的 source_fingerprint 值。将剩余范围传递给 read_code,
直到 continuation.files 为空;不要提交空列表。如果 blocked 为 true,则停止。仍然必须提供非空的 query;
显式范围决定读取哪些行。普通文件范围或混合范围仍按查询排序,不会按顺序读取整个文件。
范围错误不会触发自动发现、路径修正或重试。
每次调用相互独立;拼接分页内容前,请比较共享文件的指纹。
使用以下命令发布精简工具组合:
uvx --from pasr-mcp==0.4.0 pasr-mcp --workspace /absolute/path/to/project --tools search_code,read_code。
默认的五工具目录和 select_context 行为保持不变。
此标志不会强制实施实验中的四次调用上限或停止策略。
与 select_context 不同,这组精简工具不会持久化选择回执,也不会追加使用记录账本条目。它会返回原始源文本,
可选附带一行 JSON 元数据标头,并在 MCP structuredContent 中返回完整对象。
发现功能会将 JSON 字符串引号和转义字符计入上下文上限;结构化通道中返回的源文本仍为未转义文本。读取工具
保留之前的显式后续调用计费方式和续传语义。建议、元数据、
工具目录和重复的对话历史仍会产生额外开销。此接口分离并未证明能提高答案准确度或减少提供商累计令牌用量。
同一文件中的多个范围会合并:重叠的行只返回一次,间隔部分仍会排除。显式列出的整个文件优先于该文件的范围。添加 include 模式不会扩大显式指定范围的文件。范围也会限制符号候选项、大纲、映射和嵌入式依赖跟踪。
完整读取范围意味着请求的部分已包含在内,并不表示调用方或依赖项的行为也已涵盖。如果问题需要,请沿着这些关系继续追踪。expand_context 会增加同一范围内的预算;要读取周边代码,请明确请求更宽的范围。
仅指定范围的正文读取按顺序进行,不按查询排序。 当所有解析后的文件都指定了范围且 outline=false 时,PASR 会按文件请求顺序返回前缀,并按行号升序排列合并后的范围。它绝不会跳过超出预算的行来选择后续匹配项。整文件请求或整文件与范围混合的请求仍会采用排序选择。
排序/窗口设置不会改变仅指定范围的正文顺序;可选的映射/跟踪标题仍会占用预算,而且可能会在正文之外重复显示源内容。
响应包含 continuation,例如:
{"files": ["path.rs:57-120"], "blocked": false}
要继续读取,请将 continuation.files 作为下一次调用的 files 参数传入,不要使用 include。空列表表示现有请求范围已读取完毕,并不表示答案完整。范围会截断到当前文件末尾。blocked=true 表示没有正文行可推进:尽可能增加预算,或使用直接读取器。MCP 选择上限仍为 1,500 个令牌;重复被阻止的请求无济于事。响应包含 source_fingerprint;合并页面前,请比较各页面共有文件的标识。源文件有改动时,必须重新读取,不要依赖旧行号。
回执和已保存的包会保留续读元数据,但不会冻结后续读取。
每次选择都是独立的。重复请求会再次返回所请求的源内容;PASR 不会假设先前的响应仍保留在模型上下文中。服务生命周期内没有调用次数上限、拒绝重复内容的机制,也不会自动继续读取尚未读取的行。宿主会明确决定是否继续读取返回的剩余范围;这样做不属于新的排序过程。 宿主负责管理问题边界、停止策略和保留上下文的跟踪。
源文件读取接受 UTF-8,可带可选 BOM,并会将 CRLF/CR 规范化为 LF。只有物理换行符才定义源坐标:源文件中的 Unicode 分隔符和换页符不会产生额外行号。显式读取会拒绝无法解码或含 NUL 字符的输入;内容搜索会跳过此类输入并提供诊断信息。路径发现仅处理元数据。根目录及嵌套的 .gitignore 规则均适用,包括被忽略的父目录屏障;不会遍历外部目录联接点。
快照与 API 迁移
包和回执现在使用格式 2。请重建旧包并重新选择源,以创建新回执;格式 1 的记录会被拒绝,不会在未提示的情况下根据当前文件为其认证。回执 ID 用于标识请求、源指纹和渲染后的证据。展开时会重新读取当前源,并报告 expansion_changed_sources。这些是逐文件快照,不是原子化的工作树快照,也不是完整源代码档案。
暂存审查使用固定的索引树;--range A..B 和 A...B 使用 B 固定版本的源文件,包括调用方。外部 --diff 使用工作树中的源文件,且不能与这些 Git 模式组合使用。JSON source_revision 用于标识所选源。
未使用的控制器/上下文顺序模块和旧版 Python 候选项 API 已移除。请使用受支持的选择/提供方 API;不再保留兼容性垫片。
未使用的 tree-sitter-python 依赖项和多余的基准测试 sweep.py 启动器也已移除。默认 MCP 工具仍为原来的五个。
CLI
pasr explain "how is the request rate limited"        # run a selection, print the receipt
pasr trace enforce_per_user_request_quota src/        # a symbol's dependency closure
pasr trace HTTPAdapter src/ --callers                 # who calls it — impact analysis
pasr pack auth "session + login + token" src/auth/    # save a committable Context Pack
pasr review --staged src/                             # touched defs + the callers they affect
pasr context --issue "$(cat issue.txt)" src/ \        # headless slice for CI / agents
  --format text --metrics-file metrics.json
pasr report --price-per-mtok 3                        # source-context estimates, not API bills
上面的源码读取命令支持可选路径——如果不指定路径,则扫描整个工作区(遵循 .gitignore)。传入目录或 glob(src/、lib/ "**/*.py")可限定范围。doctor 则仅使用其一次性测试夹具。
收据会尽力持久化到 .pasr/receipts/<id>.{json,md}(已加入 git 忽略)。这些记录描述的是 PASR 的选择,并非完整的全局 Agent 审计。.pasr/ledger.jsonl 中的使用情况账本支持估算源上下文,并非实际测得的 API 节省量或已证实避免的往返次数。上下文包会存放在 .pasr/packs/(可提交);分享前请检查其中是否包含敏感源码。使用 select_context(query="", advanced={"pack": "auth"}) 加载指定名称的上下文包。有关 CI,请参阅 docs/ci.md。
0.4.0 报告兼容性
0.4.0 版本的 report 会将 tokens_saved 重新计算为带符号的 tokens_in - tokens_out,包括现有账本行。负值表示上下文扩增;正值不再掩盖其他调用中更大的输出量。
账本本身不会被重写。
JSON 报告包含 unmeasured_calls:至少一个 token 计数器不是有效的非负整数的行。受影响的总计或每日差值为 null,显示为 unknown;测量不完整时,不会提供缩减百分比或美元估算值。输入总量为零时,也无法定义缩减百分比。完全已知的计数器和日期仍可报告。
消费者必须接受可空的计数器、差值、比率和成本估算值,以及带符号的差值。不要将 null 替换为零,也不要将负值截为零;解读总计前请检查 unmeasured_calls。无需迁移账本。
--price-per-mtok 必须是有限的非负值;设为零时会停用美元估算。JSON 成本估算保留小数点后不足一美分的精度,文本则显示 8 位小数。这些是假设的源上下文差值,并非服务提供商费用或实测节省量。覆盖范围描述所选日期范围内记录的行,不代表缺失的写入或完整的 Agent 会话。
如果账本已损坏,读取器会拒绝生成报告:JSON 格式错误或未完成、记录不是对象、UTF-8 无效或读取失败,都会导致 CLI 退出代码为 2,并在 stderr 上输出诊断信息,stdout 上不输出文本或 JSON 总计。JSON/记录错误会指出物理行号,但不会回显其内容。--since 筛选之前会先检查整个文件,因此日期筛选无法掩盖损坏。空行会被忽略;有效查询字符串中的 Unicode 分隔符仍属于该记录。账本确实不存在时,仍表示没有已记录的行。读取操作不会截断或修复文件。如果写入程序仍在追加,请等其完成后再重试;否则,请检查备份或恢复已知有效的账本。与 0.3.0 相比,这些修正改变了报告语义。
能力边界
使用 PASR 查找源码,并在渲染后的预算范围内选择可检查的上下文。计算出的代码片段和有界静态依赖追踪未必包含完整机制。全局聚合、词法不匹配、动态绑定和跨文件状态转换可能需要额外的原生搜索或读取。启发式路由无法保证检测到这些缺口。其他数据集上的研究结果并不能证明本产品的回答质量与之相当。
文档
examples/— 针对固定版本仓库的 5 份原样 CLI 会话记录eval/RESULTS.md— 预先注册的 50 项任务评估(pip install ./eval→pasr-bench)docs/competitors-benchmark.md— 最新的真实组件对比、未通过的门槛和历史代理结果docs/architecture.md— 组件和数据流docs/roadmap.md— 已发布内容和后续计划CHANGELOG.md·CONTRIBUTING.md
本项目将冻结的 researchv2 研究(模型外部上下文优化)产品化;比较性文章正在准备中。
开发
python -m venv .venv && . .venv/bin/activate   # or .venv\Scripts\Activate.ps1
pip install -e ".[dev]"
pytest -q
纯逻辑核心不会导入 torch / transformers(也不会导入 mcp SDK——仅在 pasr.mcp 下加载):
python -c "import pasr.pipeline, sys; assert not {'torch','transformers'} & set(sys.modules)"
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。