关于 memory-boost
memory-boost 为编码 Agent 提供可编辑的 Markdown 记忆,并检查记忆是否过时、遗漏或未完成。它还汇总 Claude Code 会话中的工具使用情况,并支持跨项目复用经验。
主要功能
- 01以 Markdown wiki 保存记忆
- 02报告过期、沉寂和未记录内容
- 03保存并恢复会话检查点
- 04汇总 Claude Code 工具使用情况
- 05按标签向项目提供经验
适用场景
- 01检查项目决策是否需要复审
- 02在上下文压缩后恢复会话
- 03发现重复读取和失败命令
- 04将一个项目的经验用于其他项目
MCP 相关
它通过 MCP 提供九种记忆工具,包括检索、保存、会话检查点、漂移报告和经验查询;可通过 stdio 或本地 HTTP 服务连接 Agent。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
8收录的工具列表 · 更新于 1 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| budget | integer | 否 | |
| project | any | 否 |
详细介绍
memory-boost
会自我审查的编码 Agent 记忆。


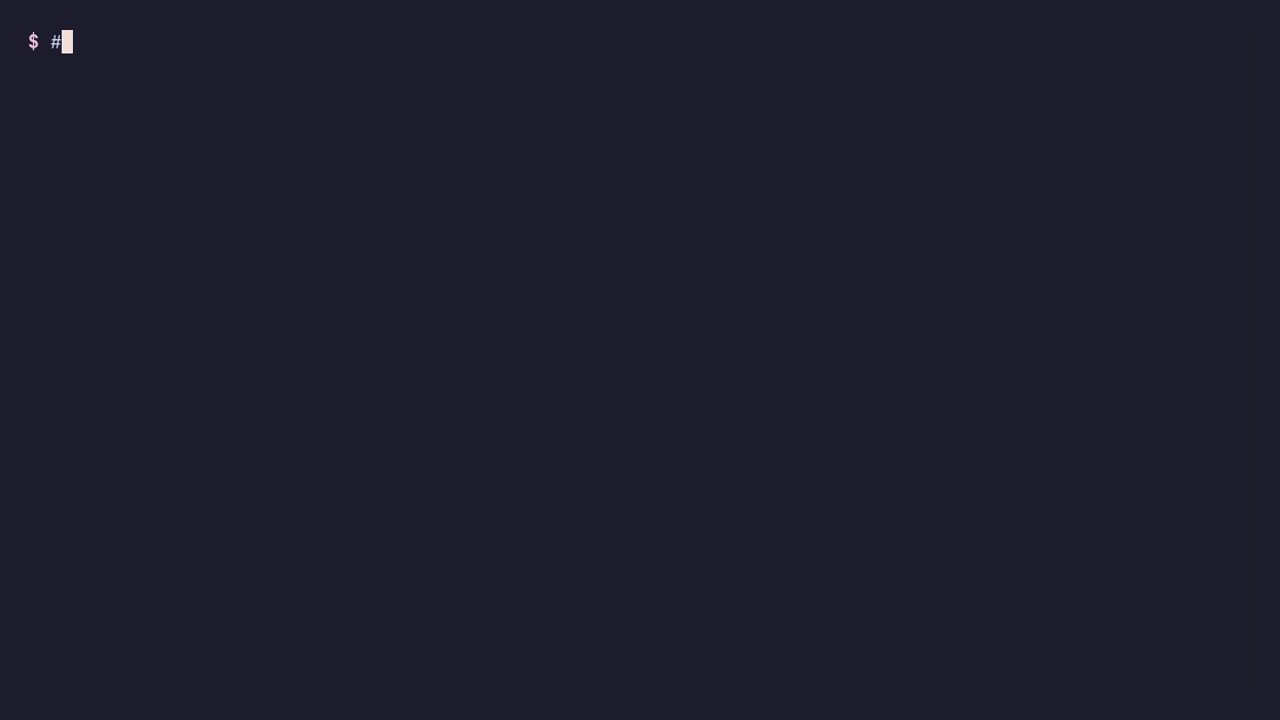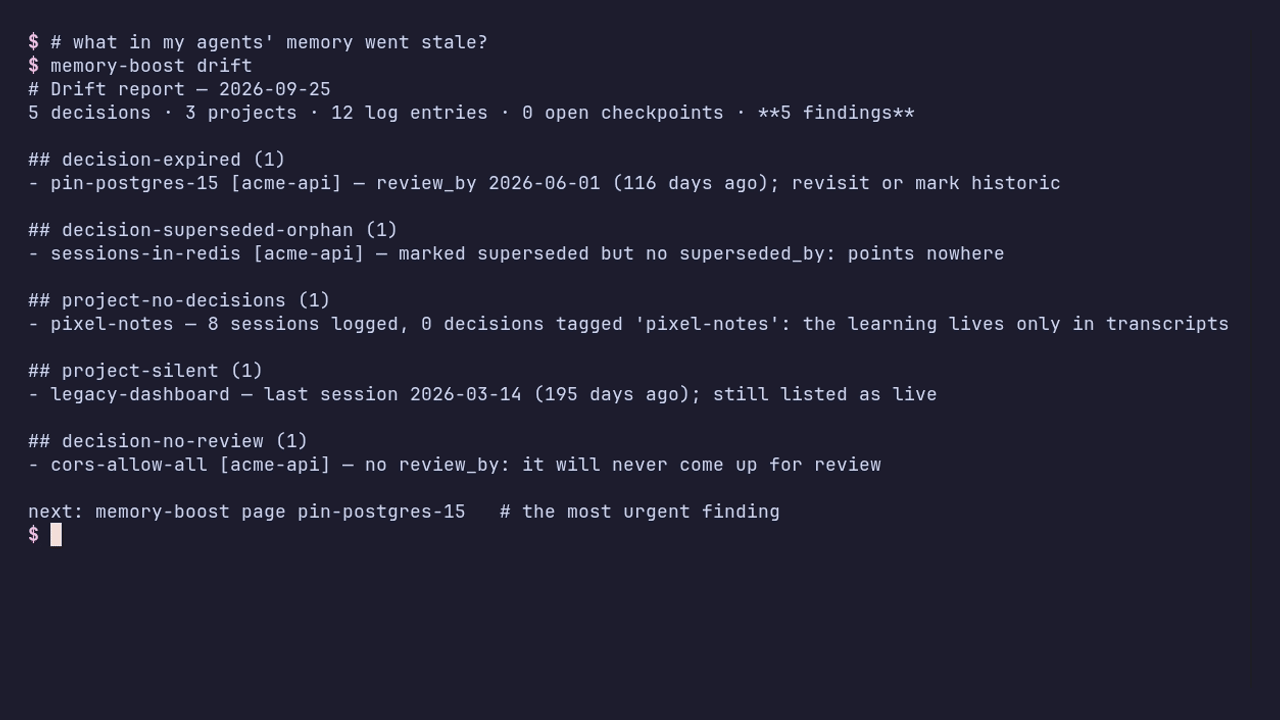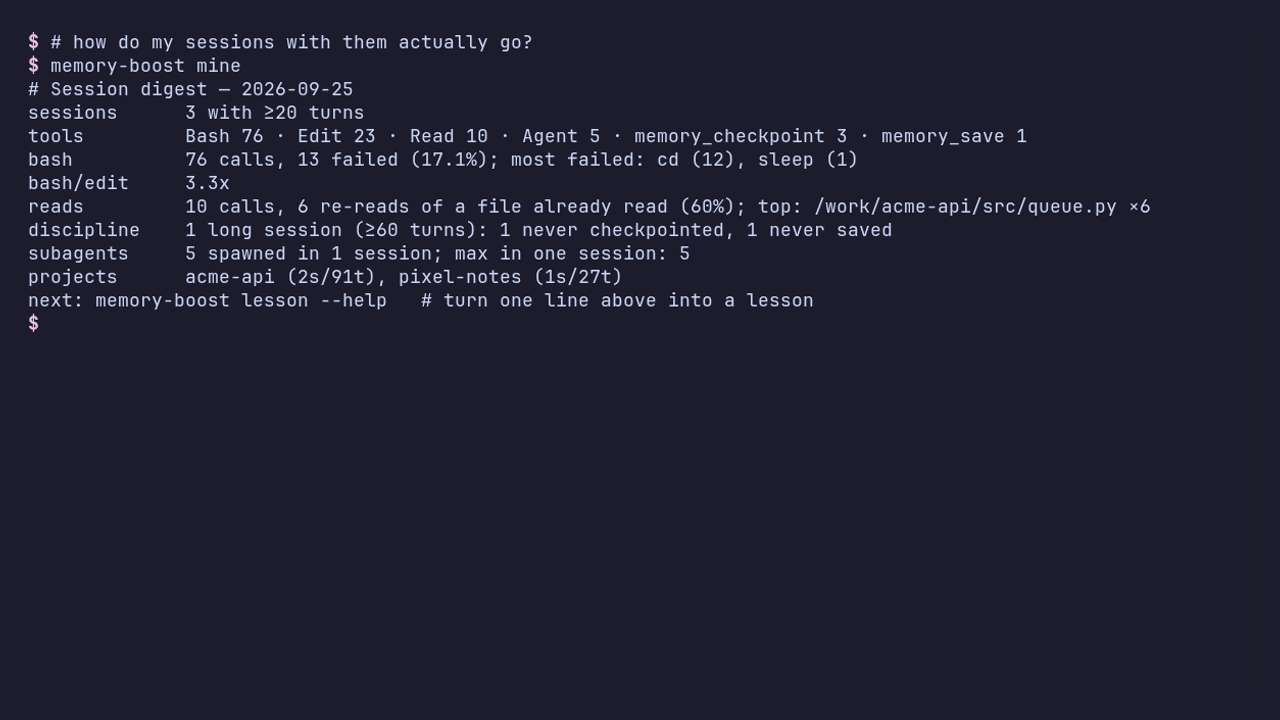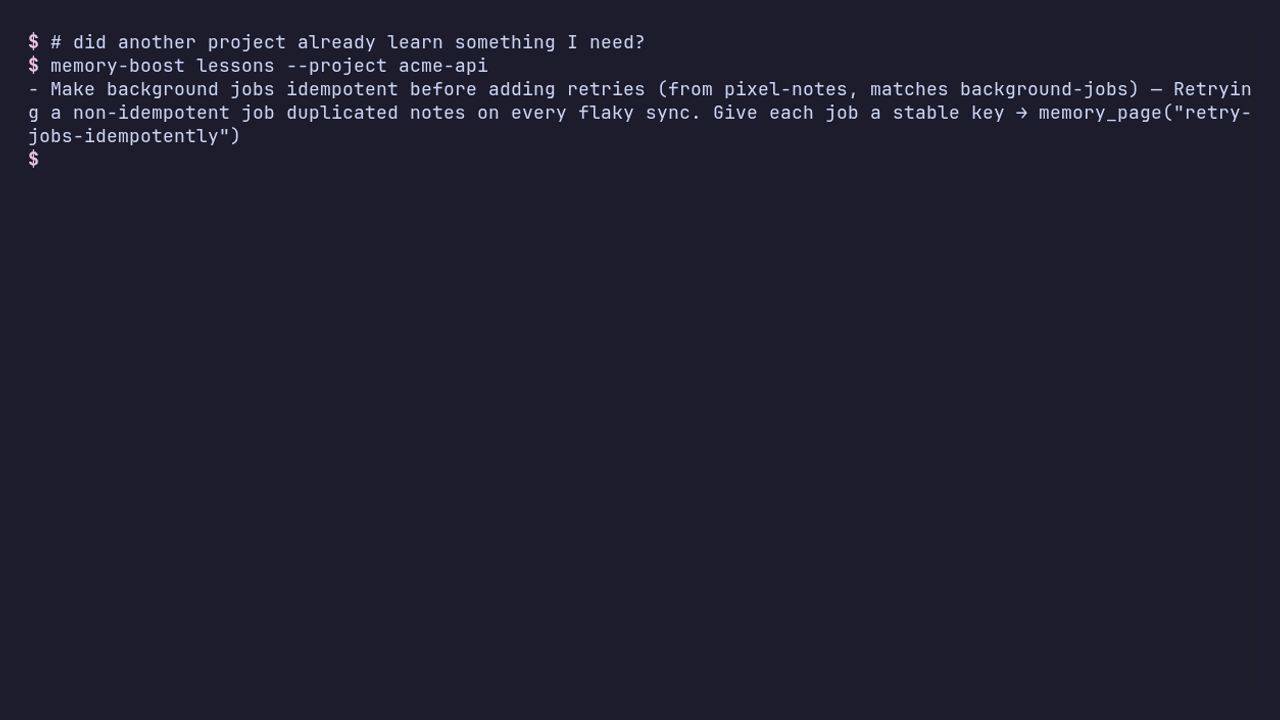
在内置示例数据上运行 drift、mine 和 lessons · 所有操作都在本地进行
立即试用 · 它能解答什么 · 连接你的 Agent · 工作原理 · 与其他方案对比
你的 Agent 什么都记下来,却没人回头看。
每种面向编码 Agent 的记忆工具都在帮它们记住更多。但没有一种会提到,它们记住的内容有一半在 7 月就过期了。memory-boost 会维护一份纯 Markdown 格式的记忆,供你的 Agent 通过 MCP 读取和写入,然后做起不起眼却重要的事:审计这份记忆和你自己的会话,并告诉你哪些内容已经过时。还会礼貌地附上数据。
可以把它看作是对 Agent 记忆的代码审查,也是追踪你如何与它们协作的健身手环。主要还是健身手环:mine 告诉我,我失败次数最多的命令是 cd。一共 69 次。
它能解答什么
| 你可能会想…… | memory-boost 会这样回答 |
|---|---|
| 哪些决策在我们忙着交付时悄悄过期了? | drift:review_by 2026-07-08,已过期 78 天 |
| 哪些“活跃”项目其实几个月前就已经搁置了? | drift:上次会话在 161 天前;仍被列为进行中 |
| 我们在另一个仓库修过这个 bug。是怎么修的? | lessons:相同技术栈的每个项目都会沿用这条修复经验 |
| 为什么我的 Agent 总在重复读取同一个文件? | mine:一个文件,被读取了 18 次 |
| 我的 Agent 有没有在背后启动 20 个子 Agent? | mine:有,还会告诉你是在哪个会话中 |
/compact 吃掉上下文之前,我在做什么? | 会话启动钩子会恢复你的检查点 |
30 秒内试用
无需安装;知识库会放在 ~/.local/share/memory-boost:
uvx memory-boost==0.2.0 init --example   # sample wiki with five kinds of rot + four synthetic transcripts
uvx memory-boost==0.2.0 drift            # what in that memory is stale, orphaned or never written down
uvx memory-boost==0.2.0 mine             # now on your real ~/.claude/projects: aggregates only
要在 Claude Code 中持续使用,请安装插件。它一步就能配置好 MCP 服务、会话启动简报和技能;只需确保 PATH 中有 uv。
/plugin marketplace add arnaugonzalez/memory-boost
/plugin install memory-boost@memory-boost
其他 Agent,或单独使用 CLI:uv tool install memory-boost==0.2.0(或
pipx install memory-boost==0.2.0)。也可以让 Agent 帮你安装:参见让 Agent 为你安装。
让 Agent 为你安装
将以下内容粘贴到 Claude Code、Codex、Cline 或 Cursor 中:
按照 https://github.com/arnaugonzalez/memory-boost/blob/main/llms-install.md 安装 memory-boost 0.2.0:使用
uv tool install memory-boost==0.2.0安装 CLI,运行memory-boost init,将memory-boost serve注册为名为memory的 stdio MCP 服务,确认它能响应九个memory_*工具,然后运行memory-boost drift并向我展示输出。在写入记忆目录(~/.local/share/memory-boost)之外的位置 或编辑任何全局 Agent 配置前,先征求我的同意。
面向 Agent 的安装步骤(按各类运行环境配置 stdio 和 serve --http,并附带检查)见
llms-install.md。
在真实机器上
作者连续 5 周每天使用的记录:29 项决策、24 个项目、657 份 Claude Code 会话记录。 按生成内容原样输出;仅替换了项目和文件名。
$ memory-boost drift
# Drift report — 2026-09-24
29 decisions · 24 projects · 204 log entries · 33 open checkpoints · **20 findings**

## decision-expired (9)
- deploy-via-bastion — review_by 2026-07-08 (78 days ago); revisit or mark historic
- bot-guardrails — review_by 2026-07-08 (78 days ago); revisit or mark historic
  …
## project-no-decisions (2)
- thesis-solver — 20 sessions logged, 0 decisions tagged 'thesis-solver': the learning lives only in transcripts
## project-silent (5)
- mood-api — last session 2026-04-16 (161 days ago); still listed as live
  …

$ memory-boost mine
# Session digest — 2026-09-24
sessions      80 with ≥20 turns
tools         Bash 5956 · Edit 860 · Read 692 · Write 493 · Agent 203 · ToolSearch 138
bash          5956 calls, 159 failed (2.7%); most failed: cd (69), sleep (12), ssh (9), pkill (8), ls (7)
bash/edit     4.4x; extreme: crm-wt-f11 107.5x, sandbox 70.0x, sandbox 54.0x
reads         692 calls, 131 re-reads of a file already read (19%); top: …/apply_email.py ×18
discipline    62 long sessions (≥60 turns): 47 never checkpointed, 29 never saved
subagents     203 spawned in 44 sessions; max in one session: 20
每一行都是一个需要改变的习惯、一项值得重新审视的决策,或一条值得记下的规则。这些都 不需要新工具:数据早已在磁盘上,只需要一个读取器。
它是什么
- 属于你自己的 wiki。
projects/*.md、decisions/*.md、concepts/*.md、log.md。纯 Markdown;手动编辑,并保存在 Git 中。SQLite FTS5 索引只是可随时丢弃的缓存。为任意 harness 提供九个 MCP 工具:memory_brief、memory_recall、memory_page、memory_save、memory_checkpoint、memory_resume、memory_drift、memory_lesson、memory_shelf。memory_shelf(CLI:memory-boost shelf "idea")会将一条带日期的单行想法追加到concepts/idea-shelf.md,而无需 Agent 读回该页面。 - 将新鲜度作为数据。 决策包含
status:和review_by:。搜索结果会标记为current / unclassified / review / historic / superseded,并优先显示 current。 - 会话检查点可在
/compact后保留,其中每个其他正在同一项目上工作的会话占一行, 避免并行 Agent 发生冲突。 drift会读取 wiki,并报告哪些内容已过期、哪些内容已无人关注、哪些内容从未记录, 以及哪些工作只完成了一半。当前项目的主要发现会写入每份会话摘要。mine会读取你本地的 Claude Code 会话记录,并报告工具使用情况、失败的命令、 重复读取、子 Agent 扇出情况和检查点使用规范。只聚合数据:不会存储或打印提示词、 命令或文件内容,因此摘要可安全地粘贴到任何地方。lessons:concepts/中带有applies_when: [tags]的页面。项目页面列出匹配的tags:后,这些经验就会出现在项目摘要中,让一个代码库中验证有效的方法惠及下一个。/retro技能会在会话结束时写入这些经验。
连接你的 harness
MCP 服务(适用于所有 harness):命令 memory-boost,参数 ["serve"]。
如需在多个会话间共享一个服务,请通过可流式传输的 HTTP 运行它(无状态,返回 JSON
响应),并将各个 harness 指向 http://127.0.0.1:8765/mcp:
memory-boost serve --http                      # --host 127.0.0.1 --port 8765 are the defaults
claude mcp add --transport http memory -s user http://127.0.0.1:8765/mcp
默认绑定到回环地址,且没有身份验证:请保持这一设置。
| Harness | MCP 注册方式 | 会话开始时的上下文 |
|---|---|---|
| Claude Code(插件) | /plugin install memory-boost@memory-boost | 已包含:钩子、MCP 服务、技能 |
| Claude Code(手动) | claude mcp add memory -s user -- memory-boost serve | 使用下方的钩子(启动、恢复、压缩);mine 会读取其会话记录 |
| Codex CLI | codex mcp add memory -- memory-boost serve | AGENTS.md:「先调用 memory_brief」 |
| Cursor / VS Code / Gemini CLI | 在其 mcp.json / settings.json 中添加 stdio 条目 | 在规则中添加相同内容(钩子适配器:路线图) |
手动配置 Claude Code 钩子(~/.claude/settings.json),使用插件时无需配置:
{ "hooks": { "SessionStart": [ { "hooks": [ { "type": "command", "command": "memory-boost hook session-start" } ] } ] } }
在 startup/resume 时,它会注入约 1k 个令牌:目录、项目上下文和最近的会话、
项目的 drift、来自其他项目的经验,以及你尚未关闭的检查点。在 compact 时只注入当前
会话的检查点。它绝不会阻止会话启动:发生任何错误时都不输出内容。
技能:/memory-boost(路由器:何时运行什么)、/save-session、/restore-session、
/retro。插件会将它们安装为 /memory-boost:retro 等名称;不使用插件时,将
skills/* 复制到 ~/.claude/skills/。安装插件后的首次会话会多花几秒,因为 uv 会从
PyPI 获取 memory-boost==0.2.0 及其依赖项(这是插件唯一的网络访问);后续会话约需
0.2 秒即可启动。
面向 Agent 的 CLI 约定:数据输出到 stdout,错误输出到 stderr 并附带一行 fix:;每个
读取命令都支持 --json(包含 version 字段);退出码 0 = 可信任 stdout,1 = 未找到,
2 = 输入有误。报告末尾会附带一行 next:,注明要运行的确切命令。
工作原理
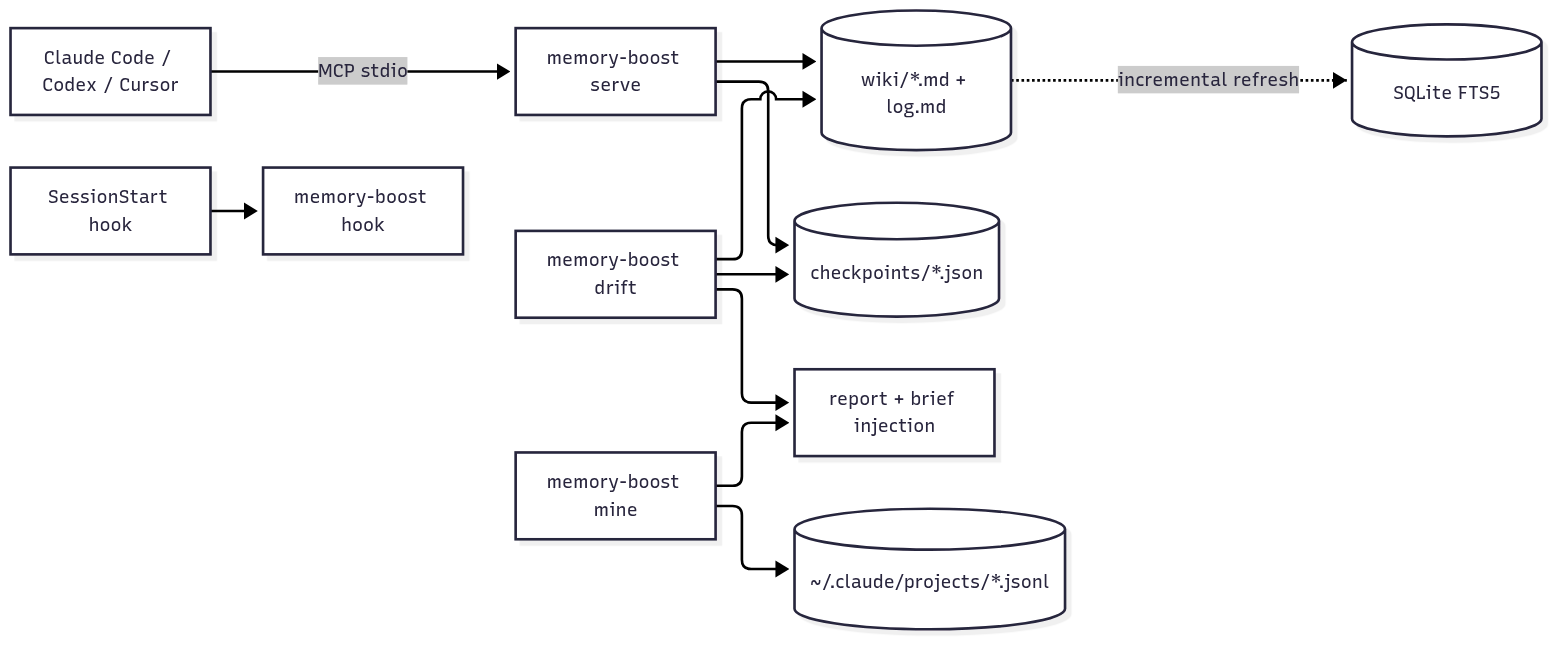
项目根据工作目录名称解析(~/work/acme-api → projects/acme-api.md);
其他名称可在 aliases.json 中映射。Python 代码不到 1,900 行,只有一个依赖(mcp),
除非选择启用语义召回,否则不使用嵌入;除非运行 serve --http,否则不启动守护进程。
语义召回(可选)
默认关闭:memory_recall 仅支持全文搜索,基础安装也只需一个依赖。
如需匹配释义和其他语言,请运行本地嵌入模型:
pip install "memory-boost[semantic]==0.2.0"   # adds sqlite-vec
ollama pull embeddinggemma
export MEMORY_BOOST_SEMANTIC=1
memory-boost index                       # embeds the wiki once; later runs embed only changes
大型知识库首次在 CPU 上建立索引可能需要几分钟:粗略估计,在没有 GPU 的笔记本电脑上,
约 850 份文档可能需要 15 分钟(单次测量,并非基准测试)。运行期间,memory-boost index 和
recall 会在 stderr 上显示 embedding N/M chunks…;之后只会为发生变化的内容重新生成嵌入。
启用后的默认模式为 hybrid(通过加权倒数排名融合全文搜索和向量);可通过
MEMORY_BOOST_RECALL_MODE=fts|semantic|hybrid 或 memory-boost recall --mode 覆盖。如果 Ollama 未运行,
召回会回退到全文搜索并记录警告。在一组私有的 64 条查询(39 条字面查询、25 条释义查询)上,
使用 CPU 和已预热的索引:释义查询的 nDCG@10 从 0.46 提升至 0.76,字面查询从 0.80 提升至 0.85,
每条查询的 p50 约为 110 ms。该查询集未公开。
配置
| 变量 | 默认值 | 用途 |
|---|---|---|
MEMORY_BOOST_HOME | $XDG_DATA_HOME/memory-boost | 知识库、事件、检查点、aliases.json |
MEMORY_BOOST_WIKI | $MEMORY_BOOST_HOME/wiki | 指向现有知识库(例如 Git 仓库) |
MEMORY_BOOST_INDEX | $XDG_CACHE_HOME/memory-boost/index-<hash>.db | 搜索索引 |
MEMORY_BOOST_CHECKPOINTS | $MEMORY_BOOST_HOME/checkpoints | 检查点目录 |
MEMORY_BOOST_TRANSCRIPTS | ~/.claude/projects | mine 查找会话记录的位置(多个目录:a:b) |
MEMORY_BOOST_TODAY | today (UTC) | 固定日期,以生成可复现的报告 |
与其他方案的比较
| memory-boost | basic-memory | claude-mem | agent-retro | |
|---|---|---|---|---|
| 存储 | 可编辑的 Markdown 知识库 | Markdown | 捕获的观察记录 | 无(提示词技能) |
| 搜索 | FTS5(+ 可选本地向量) | FTS + 向量 | FTS + 向量 | — |
| 时效性 / 复核日期 | 有 | 无 | 无 | — |
| 记忆偏移报告 | 有 | 无 | 无 | 无 |
| 会话分析 | 有(本地汇总) | 无 | 无 | 大模型读取对话 |
| 并行会话感知 | 有 | 无 | 无 | — |
| 许可证 | MIT | AGPL-3.0 | Apache-2.0 | ? |
想要更好的搜索、更多集成和社区支持?请使用 basic-memory。想要自动捕获所有内容? 请使用 claude-mem。如果你希望从 Agent 已经记录的内容中学习,请使用 memory-boost。
局限 / 非目标
- 默认使用全文搜索;只有安装可选的
[semantic]扩展并运行本地 Ollama 时才使用嵌入。 mine目前支持解析 Claude Code 会话记录。Codex 已列入路线图。- 报告质量取决于知识库:空知识库会生成空的
drift。 - 单用户、本地文件。支持 Linux 和 macOS;未经 Windows 测试。
- 你的 Agent 会将知识库作为指令读取。只使用你信任的知识库;请参阅 SECURITY.md。
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。