关于 schemagate
schemagate 是用于 text-to-SQL 的访问控制与模式选择工具,会先按调用者身份和授权筛选数据库对象,再将可读表提供给模型。它面向构建 SQL Agent 的开发者,支持多种数据库,并可通过 LangChain、LlamaIndex、MCP 或其他 SQL Agent 使用。
主要功能
- 01按身份和角色筛选数据库对象
- 02在模型提示词中排除无权读取的表
- 03按问题选择相关表并生成提示词
- 04提供命令行与本地 Studio 页面
- 05支持多种数据库与 SQL Agent 集成
适用场景
- 01限制 text-to-SQL Agent 可见的表
- 02为不同角色生成对应的模式上下文
- 03减少每次请求发送的模式信息
- 04通过 Studio 检查问题对应的表选择
MCP 相关
schemagate 可用于 MCP 或其他 SQL Agent 工作流。它筛选调用者获准读取的数据库对象,并将所选模式提供给 text-to-SQL 模型。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx schemagateSCHEMAGATE_DATABASE_URL密钥SQLAlchemy URL of the database to reflect, or 'demo' for the bundled schemaSCHEMAGATE_CATALOG_CONFIGOptional path to a JSON file with roles, hints and shadow-name overrides本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
schemagate — 在选择架构时实施文本转 SQL 访问控制





你的文本转 SQL Agent 会先决定向模型展示哪些表,而后才有人检查调用者获准读取哪些表。schemagate 会先进行检查:根据调用者的授权筛选架构,让受限表不会出现在提示词中,而不是仅仅降低其排名。它可与 LangChain、LlamaIndex、MCP 或任何 SQL Agent 配合使用,支持 Postgres、Oracle、MySQL、SQL Server 和 SQLite。
如果它能将本不该进入提示词的表排除在外,请点个 ⭐,帮助其他构建 SQL Agent 的人发现它。
仅依靠行级安全时,故障会悄然发生:模型针对调用者无权读取的表编写有效 SQL,RLS 会剔除所有行,用户看到的却是“未找到记录”——这与“此数据不存在”无法区分。
演示 · 安装 · 基准测试 · 本地模型 · 费用 · 从 Vanna 迁移
同一个问题,两个调用者,无需数据库,也无需密钥:
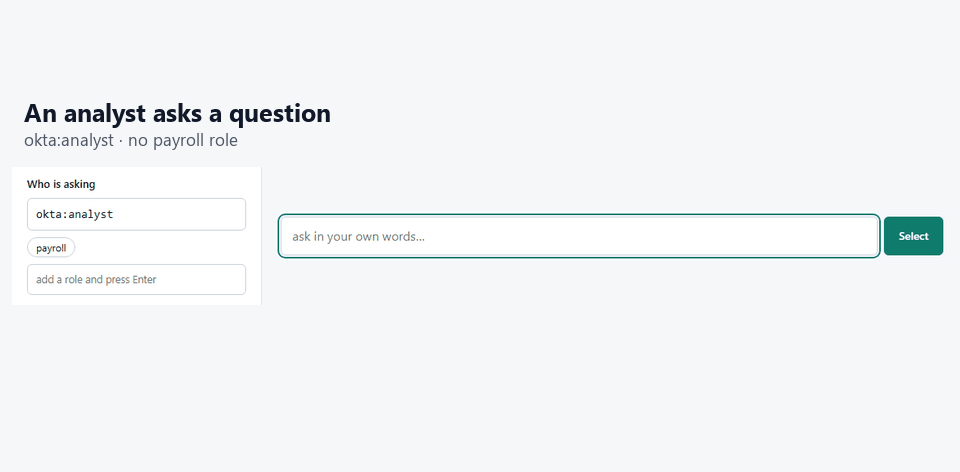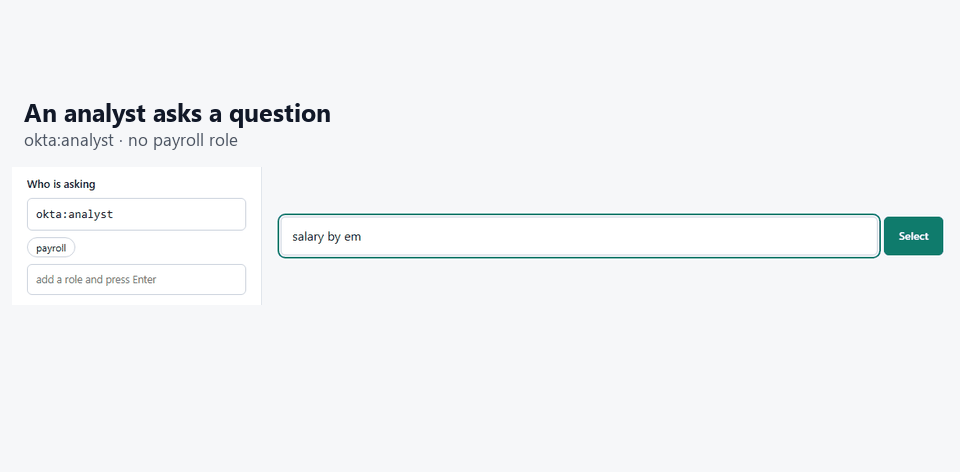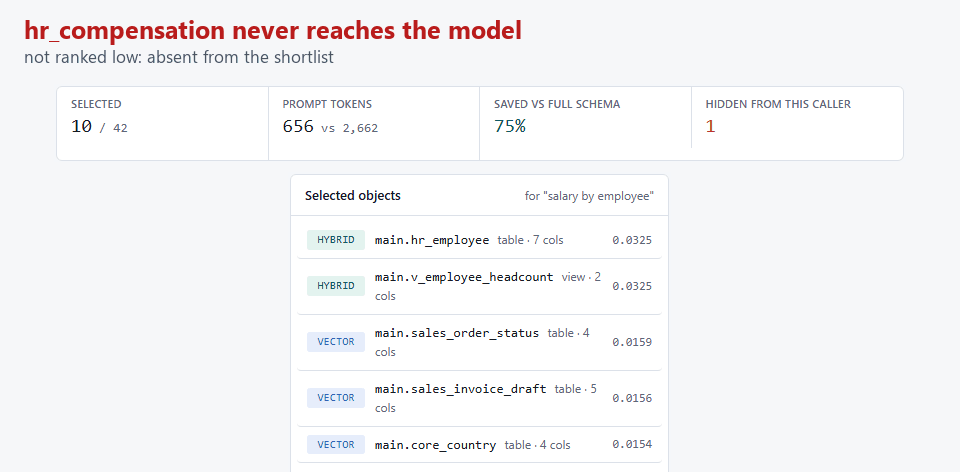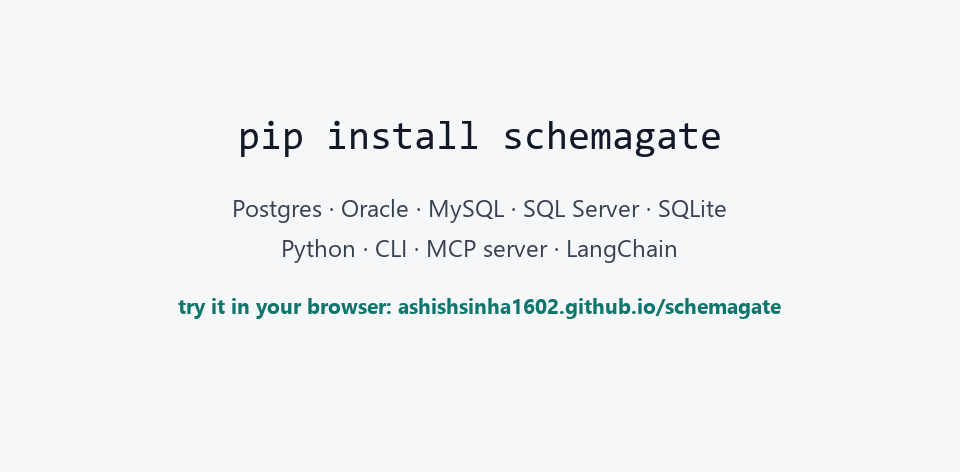
schemagate demo "salary by employee"                                     # hr_compensation absent
schemagate demo "salary by employee" --principal okta:hr --role payroll  # now it is first
不在其中,而非排名较低。调用者无权读取的表永远不会进入 提示词,因此无论如何改写问题都无法访问它,之后也无需 从答案中剔除任何内容。
在浏览器中试用 — 无需 安装、数据库或模型调用。
它的回答
所选内容是一条提示词,接下来就顺理成章了:
pip install schemagate
schemagate demo "which customers owe us money" --answer --provider <provider> --model <model-id>
main.crm_customer   main.crm_contact   main.v_customer_balance   (+5)
8 of 42 objects  ·  ~383 prompt tokens instead of ~2,036

-- SQL written by <provider> / <model-id>, from 8 tables
SELECT c.id, p.display_name, v.account_number, v.invoiced, v.paid,
       (v.invoiced - v.paid) AS balance_due
FROM v_customer_balance v
JOIN crm_customer c ON c.id = v.id_customer
JOIN core_party  p ON p.id = c.id_party
WHERE v.invoiced > v.paid

id  display_name       account_number  invoiced  paid     balance_due
--  -----------------  --------------  --------  -------  -----------
1   Northwind Trading  ACC-1001        33960.0   22080.0  11880.0
2   Kellner GmbH       ACC-1002        8760.0    3000.0   5760.0
根据问题返回行,无需设置数据库——查询针对的是内置的 42 个对象的架构。<provider> 是你选择的模型服务:
openai、anthropic、gemini、oci、local(完全不需要密钥),或 auto
(使用已设置的任一密钥)。使用 --url 指定你自己的数据库:
schemagate select "which customers owe us money" \
  --url "postgresql+psycopg://user:pw@host/db" --answer --provider <provider> --model <model-id>
没有密钥?省略 --provider,它会输出一条提示词,供你粘贴到任意聊天窗口;然后使用 --sql "SELECT ..." 运行它返回的 SQL。
更多内置架构示例,以及人们实际会输入的问题:
schemagate demo "which customers owe us money"
schemagate demo "late shipments by carrier" --prompt   # the DDL the model gets
对于你自己的数据库,用法也一样:
schemagate select "revenue by month" --url postgresql://localhost/app --principal okta:jdoe --role finance
schemagate studio --url postgresql://localhost/app        # the same thing, as a page
schemagate studio 会打开一个本地页面,你可以在其中输入问题、切换调用方角色、编辑提示信息,并查看哪些内容会进入提示词,哪些不会。同一页面也公开运行于 **https://ashishsinha1602.github.io/schemagate/**,包含六种内置架构,可在浏览器中使用,无需后端服务。该页面上的选择器是此库的 JavaScript 移植版本,测试会针对 1,789 个用例同时运行两者,并要求排名完全一致。
如果你从 Vanna(于 2026 年 3 月归档)迁移而来,docs/migrating-from-vanna.md
介绍了简要说明:Vanna 在 SQL 运行时应用身份;schemagate 则在模型看到架构之前应用身份。只需一行,就能将你的 User 映射为 Principal。
它节省了什么
每次文本转 SQL 调用都要为提示词中的架构付费。倾倒整个架构,每个问题都要为所有表付费;手动给模型六张表,每个问题就要为六张表付费。以下是在测试架构上的测量结果,取各架构黄金问题的平均值,使用与 tests/bench.py 相同的内置估算器:
| 架构 | 对象数 | 每次调用的完整架构 | schemagate 平均值 | 减少比例 |
|---|---|---|---|---|
| Commerce | 42 | 2,483 个 token | 604 | 76% |
| Clinical claims | 27 | 1,568 | 543 | 65% |
| Claims warehouse (star) | 51 | 3,312 | 880 | 73% |
| Bank ledger and trading | 39 | 2,255 | 637 | 72% |
| IoT telemetry | 40 | 2,125 | 448 | 79% |
| Hostile(4 个架构,包含所有内容的副本) | 260 | 16,095 | 444 | 97% |
最后一行才是关键:无论架构有多大,选择结果都维持在约六张表,因此架构越大,节省越多。真实数据库更接近最后一行,而不是第一行。
在这里无人编写的公开架构上进行相同的计数(未调用模型; BENCHMARKS.md 中有脚本)。在 Spider 2.0 的真实 BigQuery 和 Snowflake 数据仓库中,包含 50 张或更多表的数据库,其完整架构缩减后的中位数为 92.9%(共 33 个数据库)。在数据库表数中位数为七的 BIRD 上,中位节省比例为 8.8%:可删减的内容不多。删减的代价是可能会漏掉所需的表。在这些数据仓库中,有 79.6% 的问题所对应的选择结果包含黄金查询读取的每一张表。下面是一个具体示例,价格是假设值,你应替换为自己的价格:一个包含 260 个对象的架构,每天 5,000 个问题,输入价格为每百万 token $3。完整架构:16,095 × 5,000 × 30 = 每月 24 亿个 token,约 $7,200。使用 schemagate:444 × 5,000 × 30 = 6,700 万个 token,约 $200。浏览器演示 中,统计数据下方有这两个可编辑字段,你可以填入自己的用量和价格,并查看它们如何根据你提出的问题重新计算。
还有两项在这里不花钱、在其他地方却要花钱的功能:选择器本身从不调用模型(BM25 加哈希嵌入器,可离线运行,耗时仅毫秒);可选的描述可以交给你已付费使用的任意聊天窗口编写,而无需 API 密钥——参见 无需 API 密钥。
这个项目解决的问题
将大模型连接到数据库架构时,会出现两个问题。
第一个是成本。大多数系统会在每个问题中都把整个架构粘贴到提示词里。对于 20 张表来说没问题,但对于 2,000 张表来说,成本高得难以承受。
第二个问题更严重,也是我编写这个项目的原因。架构选择发生在查询运行之前,因此也发生在行级安全策略(RLS)发挥作用之前。如果你的选择步骤没有考虑身份信息,模型就会拿到调用者无权读取的表。它会写出完全正确的 SQL。RLS 或 VPD 会过滤掉所有行。用户看到“未找到记录”,并相信了这个结果。
这不是拒绝访问的消息,而是一个语气笃定的错误答案,用户无从分辨。先按身份信息过滤目录,是我所知道的唯一避免这种情况的方法。
from schemagate import Catalog, Principal

cat = Catalog().bootstrap("postgresql://localhost/app")   # or: from schemagate.demo_schema import demo_catalog; cat = demo_catalog()
cat.hint("invoice_draft", "pre-issue drafts only, not real revenue")
cat.restrict("hr_compensation", ["payroll"])

sel = cat.select("revenue by month", top_k=6,
                 principal=Principal("okta:jdoe", roles={"finance"}))

sel.prompt_fragment()   # compact DDL, ready for the system prompt
sel.object_list         # [{'owner': ..., 'name': ...}]
sel.explain()           # why each object was picked
hr_compensation 不在结果中,它的名称也不会出现在提示词文本中的任何地方。
安装
pip install schemagate
就这么简单。只有一个依赖项(SQLAlchemy),无需 API 密钥,也无需下载模型。默认的嵌入器是一个哈希 n-gram 向量化器,可离线运行,并且在每台机器上都会产生完全相同的结果。
可选附加项:
pip install 'schemagate[postgres]'     'schemagate[oracle]'
pip install 'schemagate[mssql]'        'schemagate[mysql]'
pip install 'schemagate[anthropic]'    'schemagate[openai]'      'schemagate[gemini]'
pip install 'schemagate[huggingface]'
huggingface 是无需密钥、数据不会离开本机的方案,也是唯一比较庞大的附加项:首次使用时需要下载约 2 GB 的 wheel 包和一个 3.1 GB 的模型。它刻意不包含在 schemagate[all] 中。docs/local-models.md 详细介绍了这一切——下载内容、首次加载所需的等待时间、它的优势,以及它不如托管模型的地方。
每个版本都经过签名。 wheel 包附带 PEP 740 证明——由 GitHub 提供的签名,注明构建该文件的工作流、仓库和提交。所有文件都不是手动上传的,也没有可被盗用的 API 令牌。你可以使用 gh attestation verify <wheel> --repo ashishsinha1602/schemagate 自行验证。
快速开始
pip install schemagate            # add an extra for your driver, below
schemagate                        # opens http://127.0.0.1:8770 on the 42-object demo
PyPI 上的每个 wheel 包都附带已签名的来源证明,其中注明了构建该包的提交:
gh attestation verify <wheel> --repo ashishsinha1602/schemagate。
或者,无需安装任何内容,镜像中已包含所有驱动:
docker run -p 8770:8770 -e SCHEMAGATE_DATABASE_URL=postgresql://… ghcr.io/ashishsinha1602/schemagate
不填写 URL 时,它会加载一个包含数据的 42 个对象的示例架构,因此在连接到你自己的数据库之前,就有内容可以提问。
然后,在页面中:
- 连接。 粘贴 URL——
postgres://…、postgresql://…、mysql://…、oracle://…和 JDBC 字符串都可用,Autonomous Database 的钱包形式也可用。勾选 保存此连接 并为其命名,下次启动时就会自动重新连接。 - 编目。 设置 → 模型 → 选择提供商,粘贴密钥,然后点击 保存模型(模型会被保存,重启后无需再次输入)。然后点击侧栏中的 为此数据库编目。每个对象生成一句描述并缓存到磁盘,第二次运行时无需任何开销。
- 提问。 用自己的话输入问题。你会看到相关对象、模型将收到的 DDL、SQL 和行数据。
驱动作为附加项提供——schemagate[postgres]、[oracle]、[mysql]、[mssql];也可以使用 schemagate[all] 安装全部驱动:
pip install 'schemagate[postgres]'
问题选错表时
有两个调整项,都按数据库分别设置,并且每次重新连接时都会应用:
- 提示(侧栏 → 提示):用你自己的话描述一个对象。例如 “MyConvo campaigns:personal-inbox 表示从用户自己的邮箱发送。”
- 术语表(
POST /api/glossary):一个术语,对所有内容生效。此处的术语会传入编目提示词,因此每条描述都会使用你的词汇;提问中提及该术语时,它也会被扩展处理。
提示在所有地方都会优先于自动生成的描述,并且两者都不需要重新编目。
命令
所有子命令及其用途。运行 schemagate <command> --help 可查看相同内容。
schemagate demo      [question]          run against the bundled 42-object schema
schemagate select    --url URL [question]  select against your own database
schemagate studio    [--url URL]         the Studio page, served locally
schemagate describe  --url URL           write AI descriptions for your objects
schemagate certify   URL                 end-to-end check on a real engine
demo 和 select
select 是指向真实数据库的 demo;两者接受相同的标志。
schemagate demo "who reports to whom"
schemagate select --url postgresql+psycopg://user:pw@host/db "unpaid invoices"
schemagate select --schema APP --url "oracle+oracledb://ADMIN:pw@/?dsn=(description=(address=(protocol=tcps)(port=1522)(host=adb.us-phoenix-1.oraclecloud.com))(connect_data=(service_name=abc123_mydb_low.adb.oraclecloud.com)))" "unpaid invoices"   # Autonomous Database
| 标志 | 作用 |
|---|---|
--top-k N | 要选择多少个对象(默认值为 6) |
--principal SOURCE:ID | 请求者的身份,例如 okta:jdoe、db:APPUSER。必须带命名空间 |
--memory PATH|1 | 记住已执行的“问题 → SQL”配对,并在下次使用(固定项 + 成功示例)。1 表示 ~/.schemagate/memory/。默认关闭 |
--role ROLE | 调用者持有的角色;可重复指定 |
--prompt | 打印提示词,而不是选择结果 |
--explain | 显示选择每个对象的原因,以及哪些对象被隐藏 |
--answer | 编写 SQL 并执行(需要提供方) |
--provider NAME / --model ID | 要使用的模型 |
--limit N | --answer 的行数上限 |
--restrict-from-grants | 根据数据库自身的 GRANT 确定可见性 |
--rerank | 让模型重新排列数学计算得出的候选列表(合并后的 Spider 中,所有金标准表都位于前 5 名的问题占比从 80.3% 提升至 96.5%;BIRD 中从 88.6% 提升至 96.7%;参见 BENCHMARKS.md) |
--values | 抽样简短的非个人列值 |
--include / --exclude PATTERN | 缩小反射范围(仅限 select) |
--schema NAME、--no-fk、--config JSON、--sql SELECT | 仅限 select |
studio
schemagate                              # the demo, or your remembered connection
schemagate studio                       # empty, connect from the page
schemagate studio --demo                # the bundled sample schema
schemagate studio --url postgresql://localhost/app
schemagate studio --remember            # save the connection, reconnect next time
schemagate studio --forget              # delete the saved connection and exit
| 标志 | 作用 |
|---|---|
--url URL | 启动时连接,而不是从页面连接 |
--host / --port | 默认值为 127.0.0.1:8770 |
--no-browser | 不打开浏览器 |
--demo | 使用捆绑的示例架构打开 |
--remember | 将此连接保存到 ~/.schemagate/connection.json(0600),并在下次启动时重新使用。包含数据库和 wallet 密码,因此除非明确请求,否则默认关闭 |
--forget | 删除该文件并退出 |
--allow-connect / --no-connect | 页面是否可以自行打开数据库。默认情况下,绑定到 loopback 时开启,绑定到其他地址时关闭 |
--restrict-from-grants | 启动时根据 GRANT 确定可见性 |
--values | 反射时抽样列值 |
--include / --exclude / --config | 与 select 相同 |
在页面中:Catalogue this database 用于描述尚无说明的内容,Re-catalogue all 会重写所有说明,而 Resync schema 会重新反射数据库,同时保留现有说明。
describe
# with a key
schemagate describe --url postgresql://localhost/app --provider anthropic --model claude-sonnet-5

# without one: write the prompt out, paste it into any chat, apply the reply
schemagate describe --url postgresql://localhost/app --out prompt.txt
schemagate describe --url postgresql://localhost/app --apply reply.json
| 标志 | 作用 |
|---|---|
--out FILE | 写入提示词,而不是调用模型 |
--apply REPLY.json | 应用以此方式生成的回复 |
--all | 重新描述所有内容,而不仅是缺少说明的内容 |
--cache FILE | 生成的说明的保存位置;之后重新运行无需付费 |
--provider / --model | 要使用的模型 |
--include / --exclude / --schema / --config | 与 select 相同 |
certify
schemagate certify "postgresql+psycopg://user:pw@host/db"
反射数据库、进行选择,并报告真实引擎实际执行的操作——在信任新数据库或驱动程序之前应运行此检查。
环境
| 变量 | 作用 |
|---|---|
SCHEMAGATE_CONNECT_ARGS | 传递给 create_engine(connect_args=...) 的 JSON,用于 URL 无法表达的连接参数(如 Autonomous Database 钱包) |
SCHEMAGATE_REMEMBER=1 | 无需传递 --remember 即可保存连接 |
SCHEMAGATE_HOME | connection.json 所在位置(默认为 ~/.schemagate) |
ANTHROPIC_API_KEY、OPENAI_API_KEY、GEMINI_API_KEY / GOOGLE_API_KEY、OCI_COMPARTMENT_ID | 由 --provider 自动读取 |
SCHEMAGATE_STUDIO_LOG=1 | 记录 Studio 请求 |
SCHEMAGATE_VALUES=1 | MCP 服务:启动时读取列值,效果类似 --values(SCHEMAGATE_VALUES_BUDGET = 秒数,默认为 30) |
SCHEMAGATE_RESTRICT_FROM_GRANTS=1 | MCP 服务:从数据库的 GRANT 中获取可见性,效果类似 --restrict-from-grants(PostgreSQL、MySQL、Oracle) |
SCHEMAGATE_CATALOG_MAX_AGE | MCP 服务:目录在重新读取前可使用的秒数;如果重新读取失败,范围限定工具会拒绝请求,直到重新读取成功(见下文) |
SCHEMAGATE_REREAD_TIMEOUT | MCP 服务:调用等待重新读取的秒数,超时后会因数据过期而拒绝请求(默认为 30);重新读取仍会继续运行,若返回结果则会提供 |
SCHEMAGATE_MCP_RERANK=1 | MCP 服务:select_schema 会让服务的模型(SCHEMAGATE_MCP_PROVIDER + SCHEMAGATE_MCP_MODEL)重新排列前 20 个结果,效果类似 --rerank;每个问题调用一次模型;未设置模型时,服务不会启动 |
它如何选择
- 通过 SQLAlchemy 反射架构。完全不使用厂商专属 SQL。
- 为名称、列、注释、提示和视图定义建立索引。最后一点比听起来更重要:视图只公开其输出列,因此
v_stock_shortfall看起来像是关于“shortfall”的,而你要搜索的内容reorder_point却藏在它的 SELECT 中。 - 使用 BM25 和向量相似度的倒数排名融合进行检索。单独使用任何一种都不够好。向量会漏掉精确标识符;BM25 会漏掉“欠我们钱” →
balance。 - 沿外键查找问题中未提及的联接表。根据我的经验,这是生成的 SQL 能通过解析却无法运行的最大原因。
- 在以上每个步骤中应用调用方的身份。
数据
访问控制表现,由他人的基准测试评分。 RBAC Text-to-SQL 基准测试(SIGMOD'27)为每个问题指定一个角色和列级策略,并使用作者自己的评估器对回答与拒绝进行评分。使用 claude-sonnet-4-5,进行五次试验:
| AC-F1 | 违规率 | 读取了禁止数据的 SQL | |
|---|---|---|---|
| BIRD,schemagate | 90.1 | 5.4% | 0 |
| BIRD,论文中的最佳结果(相同模型,提示词中包含策略) | 88.1 | 7.4% | 未报告 |
| Spider,schemagate | 93.0 | 5.1% | 0 |
| Spider,论文中使用相同模型的结果 | 93.0 | 4.6% | 未报告 |
| Spider,论文中的最佳结果(DeepSeek V3.2-Reasoning) | 95.9 | 2.0% | 未报告 |
模型看不到架构中受限的部分。注意事项和所有列详见 BENCHMARKS.md。
另一项基准测试的表现。 Spider-ACL(EACL 2026)为 19,624 组问题与角色标注 PostgreSQL 本身允许执行的操作。使用 claude-sonnet-5-5,覆盖全部 19,624 组:
| 拒绝 F1 | 错误许可率 | 读取了角色未获授权数据的查询 | |
|---|---|---|---|
| schemagate | 0.984 | 1.8% | 8,128 个已回答查询中为 0 |
| 论文中的最佳结果(经 LoRA 微调的 Mistral-7B) | 0.933 | -- | 未报告 |
论文中的系统使用的是 2024-25 年的模型;详情和限制见 BENCHMARKS.md,两项结果汇总于一份 技术报告(PDF)、DOI 10.5281/zenodo.23446210。
执行准确率表现,由基准测试各自的评估器评分。 每个问题调用一次模型,提示词约 2,100 个 token,不生成候选结果、不投票、不进行 Agent 循环:
| 模型 | EX | 截至 2026-10-19 的最佳已发布成绩 | |
|---|---|---|---|
| BIRD dev,全部 1,534 道题 | Claude Opus 5.5 | 77.12 | 测试集提交已于 2026-10-22 发送 |
| BIRD Mini-Dev,SQLite / PostgreSQL / MySQL | Claude Opus 5.5 | 81.0 / 72.6 / 72.4 | 75.6 / 65.8 / 49.2 |
| UniQL,Oracle 方言,首次尝试 | Gemini 2.5 Flash | 64.47 | 49.61(Claude Sonnet 4.5) |
| Spider 2.0-lite,仅 135 道 SQLite 题 | Claude Sonnet 5.5 | 71.9 | 57.78 Pass@1(FlexSQL agent,gpt-oss-120b) |
| Spider 2.0-lite,205 道 BigQuery 题 | Claude Sonnet 5.5 | 45.9 | 尚未发布仅针对 BigQuery 的数据 |
Opus 的成绩每次运行大约波动 ±1;Mini-Dev 的数据为自报成绩,等待 BIRD 合并
PR #251。文件和命令:
benchmarks/results/;背景信息见
BENCHMARKS.md。
公开基准测试成绩,你可以自行核验,不必相信我:
BENCHMARKS.md 包含 schemagate 在 Spider 和 BIRD 上的测试结果,测试
脚本位于 benchmarks/,数据从原始来源下载。重点是合并设置——将
Spider 的每个数据库合并到一个包含 876 张表的目录中,不提供任何关于应该查找哪个数据库的提示:
| Spider dev,合并后的 876 张表 | pip install schemagate | [huggingface] | [huggingface] + --rerank |
|---|---|---|---|
| top_k=5 | 76.7% | 80.3% | 96.5% |
| top_k=10 | 86.1% | 90.7% | |
| top_k=20 | 94.2% | 97.0% |
BIRD dev,1,534 道题:每个数据库在 top_k=5 时为 96.7%,合并后在 top_k=10 时为
91.3%;合并后在 top_k=5 时,哈希方式为 83.8%,使用 [huggingface] 为 88.6%,使用 --rerank 为 96.7%。
在 1.5.2 上重新测量;使用 claude-haiku-5-5 重新排序,每道题调用一次。
还有 Spider 2.0-lite,这是为真实数据仓库构建的基准测试——162 个数据库、8,255 张表, 每个数据库的表数量中位数为 16,最多为 785:全部 247 道可用题的 top_k=10 时为 79.8%, 没有排除任何题(在 gold 表可解析的 233 道题上为 84.5%)。数据库本身已经很大,因此无需合并。 本页早期版本写的是 82.9%;该数字是在 Windows 悄悄导致数千个架构文件无法读取时测得的,而且 在发现加载器将基准测试的列级描述读成一条表级描述后,还需要再次重跑。两次重跑均已完成, BENCHMARKS.md 保留了修正记录,而不是将其删除。
端到端表现,按这些排行榜实际评分的指标衡量: schemagate 加上 claude-opus-5 在 BIRD dev 上的执行准确率为 68.0%(102/150,采用固定随机种子的 抽样),其中 97.3% 的问题生成了可运行的 SQL。已发布的 BIRD dev GPT-4 基线约为 46%。
这些成绩都不代表排行榜名次——要获得名次,需要提交保留测试集;这里的结果均未提交。
以下所有数据均在我自行设计的架构上测得,参考价值较低,因此先展示公开数据。
库中附带六个测试架构。运行 python tests/bench.py 即可打印出所有这些结果。
TESTING.md 完整记录了测试内容、出现的问题,以及发现哪些问题其实来自数据库而非 schemagate。
以下每个数字都由该次运行打印;只要有任何数字不再匹配,运行就会失败——bench.py 会读取此表并进行比较。
这里的 recall@6 指在前六个结果中检索到的 gold 表占比,按问题进行微平均。 literal 列的问题会复用架构本身的词汇;business words 列的问题则用普通人的表达方式询问相同内容, 不与架构词汇重叠。两者都很重要,而且结果并不一致,这正是同时展示两者的原因。
| 架构 | 对象数 | recall@6,字面匹配 | recall@6,业务词 |
|---|---|---|---|
| 商务 | 42 | 100% | 50.0% |
| 临床理赔 | 27 | 100% | 46.7% |
| 理赔数据仓库(星型) | 51 | 100% | 50.0% |
| 银行分类账与交易 | 39 | 100% | 64.3% |
| IoT 遥测 | 40 | 100% | 60.0% |
| 对抗性(4 个架构,包含所有内容的副本) | 260 | 100% | 85.7% |
| 在各架构中,真实表优于其备份/暂存副本,共 19 个案例 | 19/19 |
| 不扩展外键时的召回率 | 93.8% |
| 提示词令牌数,每次调用传入完整架构 | 2,812 |
| 提示词令牌数,schemagate 平均值 | 764(−72.8%) |
测量使用的是哈希嵌入器——也就是 pip install schemagate 提供的版本,无需额外安装。schemagate[huggingface] 会改用 sentence-transformers,业务词指标会大幅提升:在留出的释义测试集上,tests/run_paraphrase_eval.py 报告的整体结果是哈希嵌入器 58.6%,MiniLM 为 82.8%。该测试工具只要检索到任意一个标准答案表,就将问题计为命中;这比本表采用的判定条件宽松,因此两者的数字不可比较——也正因如此,它会注明所用的嵌入器。
令牌数来自基准测试内置的估算器,因此无需联网或额外安装即可复现。如果运行 pip install tiktoken,同一脚本就会切换为精确的 cl100k_base 计数。两种方式下的比例都成立。
之所以使用六个架构,而不是一个,是因为如果问题恰好与本架构的表名共享词汇,任何检索器的表现都会显得更好。第二个架构属于完全不同的领域。第三个架构包含 260 个经过刻意设计的干扰对象:每张表都有 _archive 和 _stg 副本,三个架构中存在同名表,包含一条 8 层深的外键链、一个引用循环、复合键、一张 320 列的表、100 字符长的标识符,以及西班牙语和日语名称。第四个架构是理赔数据仓库星型架构,其设计让每个问题都能对应多张看似合理的表,但只有一张才是正确答案:同一事实有四种粒度,带历史表的缓慢变化成员维度,一张以五种不同方式连接的日期维度,桥接表,以及十五个重要表的 _bkp、_old、_v2、_tmp 和 stg_ 副本。第五个是银行架构:有三种粒度的分类账、交易与头寸和结算的区分、既有每日表又有时点视图的外汇数据、贷款业务,以及大多数调用者绝不能看到的 KYC 和 AML 表。第六个是 IoT 车队:读数分为原始、每分钟和每小时粒度,包含六张按月分区的表,以及分布在三张表中的警报生命周期。这六个架构都是虚构的。本仓库中没有来自任何地方的真实架构。
50% 这一行才是诚实的数据。在采用之前,请先读这一行。
50% 这一行,以及该如何应对
默认嵌入器匹配的是子词,而不是含义。问它“我们快用完的东西”,它找不到 v_stock_shortfall,因为这两段字符串没有任何共同点。问它 stock_shortfall,它的表现就很出色。
如果用户输入的问题看起来像标识符,那就已经够用了,而且你永远不需要 API 密钥。如果他们像日常交流那样提问,就为目录补充描述。可以通过两种方式实现,且都不是必需的。
只要环境中有 API 密钥,就会自动生成描述。 所有回答问题的路径——schemagate select、--answer、MCP 服务和 Studio 的 connect——都会先描述目录,将结果按连接缓存到 ~/.schemagate/descriptions/,并且只在对象结构发生变化时重新描述对象。你编写的提示,或数据库中有实际含义的注释,都不会被覆盖;如果注释只是用架构自身的模板化内容重复对象名称,则会被替换,因为它会稀释其中每个词的作用。在一个包含 1,200 个对象的架构上,这使得复杂问题中生成可运行 SQL 的数量从 8 个中的 6 个提升到 8 个中的 8 个。设置 SCHEMAGATE_AUTO_DESCRIBE=0 可关闭此功能;未设置密钥时,不会调用任何服务,也不会发生任何变化。
无需 API 密钥
你已有的任何聊天窗口——ChatGPT、Gemini、Copilot、本地模型——都能撰写描述。schemagate 会提供提示词并接收回复:
schemagate describe --url postgresql://localhost/app --out prompt.txt
# paste prompt.txt into a chat; save its JSON reply as reply.json
schemagate describe --url postgresql://localhost/app --apply reply.json --config catalog.json
schemagate select   --url postgresql://localhost/app "things we're running out of" --config catalog.json
提示词只包含元数据——名称、类型、注释、外键,绝不包含数据行——一次粘贴即可涵盖所有尚无描述的对象。回复会写入 catalog.json 的 describe 块中,与 restrict 和 hint 块并列;select、studio 和 MCP 服务(SCHEMAGATE_CATALOG_CONFIG)都会读取它。在 Python 中也是同样的做法:cat.describe_prompt() 和 cat.describe({"v_stock_shortfall": "Items below their reorder level."})。
使用本地模型,完全无需密钥
pip install 'schemagate[huggingface]'
schemagate describe --url postgresql://localhost/app                     --provider local --model Qwen/Qwen2.5-1.5B-Instruct                     --cache .schemagate-cache.json
或者,在 Studio 中选择 Settings → Model → Local (transformers)。不会出现密钥字段,因为根本不需要密钥。
from schemagate.ai import SchemaDescriber, LocalProvider
cat.describe(SchemaDescriber(LocalProvider(), cache_path=".schemagate-cache.json"))
为每张表写一句话,工作量很小,1.5B 模型也能胜任。但用它编写涉及多张表的 SQL 则不行,而 Studio 两者使用的是同一个提供方——因此,如果你有密钥,可以在本地生成目录描述,但用密钥来回答。启用前请阅读 docs/local-models.md:其中介绍了两项下载、只需等待一次的加载过程、大约 3 GB 的 RAM、让第二次运行无需额外成本的缓存,以及为什么现在弱模型生成的糟糕描述再也无法埋没它所描述的对象。
使用你自己的密钥
from schemagate.ai import SchemaDescriber, AnthropicProvider

cat.describe(SchemaDescriber(AnthropicProvider(model="claude-sonnet-4-5"),
                             cache_path=".schemagate-cache.json"))
模型为每张表撰写一句话,并像其他架构文本一样进行索引。在附带的架构上,这会将业务用语问题的正确率从 50% 提升到 100%,而标识符风格的问题不受影响。
支持 Anthropic、OpenAI 和 Gemini。其他任何提供方都可以通过 CallableProvider 接入;如果供应商更改了 SDK,而你又不想等我发布新版本,这也能作为备用方案。
from schemagate.ai import (AnthropicProvider, OpenAIProvider, GeminiProvider,
                      CallableProvider, auto_provider, available_providers)

AnthropicProvider(model="claude-sonnet-4-5")                    # ANTHROPIC_API_KEY
OpenAIProvider(model="gpt-4.1-mini")                            # OPENAI_API_KEY
GeminiProvider(model="gemini-2.5-flash")                        # GEMINI_API_KEY
OpenAIProvider(model="…", base_url="http://localhost:11434/v1") # anything local
CallableProvider(lambda system, prompt: my_llm(system, prompt))

available_providers()      # ['AnthropicProvider'] — names, never key values
auto_provider(model="…")   # picks whichever key is set
必须指定 model。我不会提供默认模型 ID,因为模型 ID 每隔几个月就会更改,而硬编码的 ID 最终会对所有在修复前安装了该版本的用户返回 404。
启用前,有三点值得了解:
哪些内容会离开你的网络。 表名、列名、类型、是否可为空、现有注释、外键。不会包含任何数据行——ObjectDoc 没有可用于存放数据行的字段,而且测试也验证了这两点。除非你调用 describe(),否则不会发送任何内容。
费用是多少。 每个尚无描述的对象只需调用一次简短请求。默认跳过已有数据库注释或提示的对象。结果按内容缓存,因此重复运行无需额外成本,只有更改过的表才会重新生成描述。付费前先询价:
describer.estimate_calls(docs)   # calls describe() would actually bill for
describer.preview(doc)           # the exact text that would be sent
失败时会怎样。 跳过该对象,继续编制目录;describer.failures 会列出遗漏的内容。如果你希望失败时抛出异常,请传入 strict=True。你手动编写的 hint() 始终优先于生成的描述,因此修正错误描述不需要任何成本。
嵌入器会自动选择
pip install schemagate 使用哈希 n-gram 向量化器:离线、即时,而且在每台机器上生成的字节完全相同。安装 schemagate[huggingface] 后会自动改用句子模型——无需设置标志、无需基准测试,也无需你做出选择。在附带的六个架构、98 个问题且不含描述的情况下,测得的结果如下:
| recall@6 | |
|---|---|
| 哈希 n-gram(基础安装) | 90/98 |
all-MiniLM-L6-v2([huggingface]) | 93/98 |
提升恰好集中在文档所述哈希嵌入器较弱的场景——问题采用人们日常说话的方式表述。在包含这类问题的 commerce 架构上,正确率从 15/18 提升到 18/18。
它不会作为基础默认选项,因为那会以引入 torch 为代价,还会失去同一文本在任何地方都能生成相同向量的保证。如果需要复现旧索引,SCHEMAGATE_AUTO_EMBEDDER=0 可保留哈希嵌入器。
你也可以换用托管嵌入器,不过对于以标识符为主的架构文本,离线嵌入器往往同样出色,而且每次查询都无需付费。
from schemagate.ai import APIEmbedder, OpenAIProvider

provider = OpenAIProvider(model="gpt-4.1-mini",
                          embed_model="text-embedding-3-small")
cat = Catalog(embedder=APIEmbedder(provider, dim=1536))
你们组织使用的词语:术语表
有些问题与任何标识符都毫无关联,也没有任何描述或模型能可靠地建立联系:“我们退还给购物者的钱”对应 billing_credit_note。
在包含访问规则的同一个 catalog.json 中声明一次即可:
{"terms": {"gave back": "billing_credit_note",
           "revenue": ["billing_invoice", "v_monthly_revenue"]}}
也可以在 Python 中使用 cat.term("gave back", "billing_credit_note")。术语会按短语匹配,并将复数形式归一化;只有最具体的术语会生效(“take things offline”优先于“offline”)。术语会在提出问题时应用,因此无需重新建立索引,而且不会扩大访问权限:如果调用者无权读取某个表,那么为该表定义术语对该调用者不起作用。若术语指向的对象不存在,则会报错,而不是静默地不执行任何操作。
它的用途可通过六个捆绑架构中的 58 个业务用语问题来衡量(tests/run_terms_repair.py):每个未命中的问题,只需添加从问题中提取的一个简短术语即可修复,且不会导致其他问题出错——基础嵌入模型为 23 题全对,MiniLM 为 11 题全对。它并不适合用来预先仅根据表名编写术语表;这种做法对留出问题几乎没有改善(基础嵌入模型从 26 题中的 18 题提高到 19 题,MiniLM 则仍为 21/26;tests/run_terms_eval.py),因为人们使用的词语很难猜到。请为你看到的未命中问题添加术语。
完整本体:概念、规则、层级
术语表条目是最简单的概念。完整形式会精确说明一个词的含义,让模型写出正确的 SQL,而不是看似合理的 SQL:
{"ontology": {"concepts": {
  "revenue":  {"synonyms": ["turnover", "sales"],
               "maps": ["billing_invoice.total_net"],
               "filter": "billing_invoice.status = 'issued'",
               "definition": "Issued invoices only; drafts and void excluded.",
               "broader": ["money in"]},
  "money in": {"maps": ["v_monthly_revenue"]}}}}
问题中使用某个概念的名称或同义词时,会引入该概念的对象,其含义会写在 DDL 上方:
-- What the business terms in this question mean:
-- revenue (also: turnover, sales): main.billing_invoice.total_net; only where billing_invoice.status = 'issued'. ...
相隔一步的概念(broader 或更窄的概念)会提供较弱的信号。对于可能无法查看其提及内容的调用方,会省略含义说明行——包括映射的表和列,以及其规则或定义中提及的任何表或列——这样概念就不会把被隐藏的名称重新放进提示词中。
词汇表的来源:
schemagate ontology import semantic_manifest.json --from dbt       --url ... --config catalog.json --save
schemagate ontology import model.yaml            --from snowflake --url ... --config catalog.json --save
schemagate ontology import glossary.csv          --from csv       --url ... --config catalog.json --save
schemagate ontology suggest history.jsonl        --url ... --config catalog.json         # review, then --save
schemagate ontology check                        --url ... --config catalog.json
suggest 会从人们提出的问题及其对应的 SQL 中学习概念(--memory 会读取 schemagate 自身的查询记忆)。Collibra 和 Microsoft Purview 导出的 CSV 标头可以直接使用。
准确率表现:实测数据。
| 设置 | 不使用 | 使用 | |
|---|---|---|---|
从历史记录中学习概念(benchmarks/learn_concepts.py) | Spider dev,汇集 166 个数据库(876 张表),从每个数据库一半的问题中学习,并在另一半上评分:前 5 个结果中包含所有 gold 表 | 73.3% | 82.8%(+49 / −0,p<0.0001;MiniLM 79.1% → 85.9%) |
完整词汇表(benchmarks/bird_ontology.py,D 组) | BIRD dev,201 个留出的问题,不提供其证据,执行准确率,Claude Sonnet 5 | 44.8% | 54.7%(+28 / −8,p=0.001) |
预置定义(benchmarks/planted_definitions.py) | 一个预置的 SQLite,包含 8 个按直觉理解会出错的业务术语(扣除折扣、退款和内部 SKU 后的收入;根据近期订单而非过时标记判断“活跃”;有 30 天宽限期的流失),21 个答案根据定义计算得出的问题,执行准确率,Claude Sonnet 5 | 4.8% | 71.4%(+14 / −0,p=0.0001);定义引入其引用的术语后为 100%(21/21,+6 / −0) |
以 BIRD 为例:将每个问题自身的证据粘贴进去(BIRD 的常规设置),得分为 61.2%;因此,无需逐题输入证据,本体就能带来约 60% 的提升;两次不使用本体的相同运行结果相差 18 个答案。有一项结果未能成立:从其他问题的证据构建的概念得分为 46.8%,而非 44.8%——差异在噪声范围内——因为 BIRD 的证据大多是很少重复的一次性公式。本体只有在包含相关定义时才有帮助。
预置定义测试(审查时建议加入)先写出定义,再根据定义计算所有预期答案,因此衡量的是 SQL 是否正确,而非表是否正确。再次运行时,不使用词汇表的答案没有变化。词汇表最初漏掉的 6 个问题属于同一种模式:一个通过另一术语定义的术语(“合作伙伴销售额是合作伙伴订单的收入”)检索到了自身,却没有检索到它所依赖的术语,于是模型只能猜测收入的含义——而在没有词汇表时,有 4 个问题它本来都选择不回答,却自信地给出了答案。现在,匹配到的概念会引入其定义或筛选条件引用的概念(Ontology.with_cited,沿引用关系跟踪三步,并对每个概念应用可见性规则),相同运行现在得分为 21/21。将收入编译为相关术语所指向的视图,同时仍允许查询毛收入列,得分为 19/21;其中两道错题都与收入无关:问题出在检索,而非模型重新推导已提供给它的定义。
已测量但未实现通过架构图补全连接路径:在 Spider 中,top_k=5 时 266 个错误里只有 2 个是缺少桥接表,因为外键扩展已能引入桥接表(benchmarks/join_paths.py)。
连接到你实际拥有的内容
大多数人没有 SQLAlchemy URL。他们有一个钱包 zip 文件、一段从配置文件中复制出来的 JDBC 字符串,或者一个主机和端口。schemagate.connect
会将这些内容转换为 SQLAlchemy 所需的两项内容:
from sqlalchemy import create_engine
from schemagate import Catalog
from schemagate.connect import resolve

url, connect_args = resolve("jdbc:oracle:thin:@//host:1521/ORCLPDB1")
cat = Catalog().bootstrap(create_engine(url, connect_args=connect_args))
connect_args 并非可有可无。Autonomous Database 没有名副其实的 URL——钱包目录、钱包密码和 TNS 别名都无处存放——因此 URL 退化为 oracle+oracledb://@,连接参数则与它一同传递:
url, connect_args = resolve({
    "kind": "wallet",
    "wallet": "~/Downloads/Wallet_mydb.zip",   # the zip as downloaded
    "alias": "mydb_high",
    "user": "ADMIN", "password": "...",
})
zip 文件会解压到自身所在目录,因为驱动每次重新连接时都会重新读取它——临时目录只能让连接成功一次。
在 Studio 中也可以完成同样的操作,只需从下拉菜单中选择,而不是填写字典:
pip install "schemagate[all]"          # every driver, the model SDKs, MCP
schemagate
在 Oracle Cloud 上,添加 OCI SDK,这样目录编制就可以通过 OCI Generative AI 完成,完全不需要 API 密钥:
pip install "schemagate[all,oci]"
它被单独列出,是因为它的体积也独占一档:OCI SDK 有 488 MB,包含 17,505 个模块,而其他所有内容加起来只有 217 MB。
| 你拥有的内容 | 选择 |
|---|---|
postgresql+psycopg://... | SQLAlchemy URL |
jdbc:oracle:thin:@//host:1521/SVC | JDBC URL |
Wallet_mydb.zip + mydb_high | Oracle 钱包 |
| 一个主机、一个端口和一个数据库 | 按名称选择引擎 |
连接成功后,Studio 会显示可重现该连接的命令——schemagate select ... --url ... 这一行,以及对应的 Python 写法;密码会显示为 $DB_PASSWORD,而不是实际密码。可以先在页面中试用,再复制命令。
在 localhost 上无需额外配置即可连接,因为只有已经坐在这台机器的 shell 前的人才能访问该页面。如果在其他地址上提供 Studio 服务,就需要使用 --allow-connect,因为这样一来,网络上的任何人都能把它当作 URL 输入框,让你的服务连接到只有它能访问的主机。--no-connect 则可在任何地方关闭连接功能。连接失败时只会报告异常类型,不会报告其他内容,因为驱动错误会引用传入的 URL,而 URL 中包含密码。
限制单个列,并读取你已有的 ACL
对象级规则无法表达常见情况:表是正确的,但其中某一列不该显示。
from schemagate import Catalog, Principal

cat = Catalog().bootstrap("postgresql+psycopg://user:pw@host/db")
cat.restrict_column("employee", "salary", ["payroll"])
cat.index()

analyst = Principal("okta:jdoe")
print(cat.select("who reports to whom", principal=analyst).prompt_fragment())
salary 在这个片段中不会出现——既不会显示为 REDACTED,也不会改名。列名本身就是一种披露:知道该列存在的模型可以询问它、将它用于联接,或在解释中提及它。任何提到被隐藏列的 -- FK 行也会被删除,因为它们会直接暴露该标识符。
显示了什么,以及显示给了谁
sel = cat.select("who reports to whom", principal=analyst)
sel.to_dict()
# {'question': 'who reports to whom',
#  'principal': 'okta:jdoe', 'roles': [], 'total_objects': 219,
#  'hits': [{'object': 'hr.employee', 'kind': 'TABLE', 'score': 0.031,
#            'reason': 'hybrid', 'columns_shown': 3, 'columns_withheld': 1}]}
这是审计人员事后需要的记录,也是唯一无法事后重建的内容——目录会变,角色会变,而问题也已不复存在。记录中包含被隐藏列的数量,但绝不包含列名:列出隐藏内容的日志,会将这些内容披露给所有能读取日志的人。
根据 GRANT 推导可见性
有 40 张表时,手写 restrict 映射还算可行。有 400 张时,它就成了数据库中现有 ACL 的第二份副本,而两份副本会逐渐偏离。
schemagate select "what do we pay our doctors" \
  --url "postgresql+psycopg://user:pw@host/db" --restrict-from-grants
from schemagate.grants import restrict_from_grants
report = restrict_from_grants(cat, engine, report=True)
# then the half grants cannot see: objects under a row-level policy are
# flagged in the prompt, probed per role on PostgreSQL, and the views that
# bypass the policy are named -- docs/row-level-security.md
from schemagate.rls import restrict_from_policies
print(restrict_from_policies(cat, engine, report=True))
print(report)
# postgresql: 629 object(s) seen, 218 restricted, 1 public, 0 unmatched, 1 role(s) expanded
适用于 PostgreSQL 和 Oracle。嵌套角色会被传递性地展平,因此,如果用户所属的组映射到一个继承了已授予角色的角色,该用户仍可访问相应对象。没有授权行的对象保持不变,并会列在 report.objects_unmatched 中——无提示不代表拒绝访问;如果因为连接无法查看所有内容就限制访问,会在第一次发生时破坏正常工作的目录。
它读取授权,因此看不到行级策略。 在 Oracle 26ai 上测得:即使调用者的 Virtual Private Database 策略不允许返回任何行,ALL_TAB_PRIVS 中仍会显示其持有 SELECT 权限,ALL_TABLES 中仍会列出该表,并且模型仍会看到该表的所有列。不会泄漏任何内容——数据库会强制执行策略——但提示词中会出现调用者无法读取任何行的表。docs/row-level-security.md 介绍了测量结果、当前的应对方法和修复方案。
调用者的角色从何而来
授权决定哪些角色可以查看某个对象。另一半——该调用者持有哪些角色——过去取决于调用者自述;对于连接到其自有数据库的桌面客户端,这样做没问题,但对于托管服务端,则完全没有验证。目录配置中的 groups 块会从角色已存储的位置读取角色,而客户端发送的角色会被忽略:
{"groups": {"sources": [
   {"type": "entra", "tenant": "contoso.onmicrosoft.com",
    "client_id": "…", "client_secret": "${ENTRA_CLIENT_SECRET}"},
   {"type": "native"}],
  "map": {"Payroll Team": "payroll"}}}
五种来源:entra(通过 Graph 使用 Microsoft Entra ID,同时支持传递性组成员关系、ID 和显示名称)、native(数据库自身的角色图——与 restrict_from_grants 读取的视图相同,从用户开始向上遍历,因此可以解析两级 GRANT 链)、sql(成员关系表,绑定一个 :subject)、http(任何以 JSON 返回组的端点)、static(文件中的映射)。每种来源只为其支持的主体命名空间提供结果;结果会合并;map 会将组 ID 转换为角色名。答案会缓存 ttl 秒。
某个来源无法提供答案,对该调用者来说就是错误,而不是匿名选择:“没有组”和“无法查询”是不同的答案,只有其中一种可以安全地用于操作。已在 PostgreSQL 16、MySQL 8.4 和 Oracle Autonomous Database 26ai 上验证:解析器和限制了授权的目录与 has_table_privilege 及实际的 SELECT 结果一致。docs/groups.md 介绍了配置块、每种来源以及测试内容。
数据库
反射仅使用与方言无关的 SQLAlchemy Inspector。schemagate.introspect 中没有手写 SQL,并且有一项测试会在发现任何手写 SQL 时导致构建失败,因此原则上 SQLAlchemy 支持的任何方言都能使用。
原则上可行不等于有证据,因此这里提供了一个脚本:
python scripts/certify_dialect.py 'postgresql+psycopg://user:pw@host/db'
python scripts/certify_dialect.py 'oracle+oracledb://user:pw@host:1521/?service_name=FREEPDB1'
python scripts/certify_dialect.py 'mssql+pyodbc://user:pw@host/db?driver=ODBC+Driver+18+for+SQL+Server'
python scripts/certify_dialect.py 'mysql+pymysql://user:pw@host/db'
该脚本会创建三个 schemagate_cert_ 表,反射它们,端到端运行选择和身份范围限定,然后再次删除这些表;如果任何环节失败,脚本会以非零状态码退出。请将它指向一个临时架构。
| SQLite | 已认证,10/10,在 CI 中运行 |
| PostgreSQL | 已认证,在 PostgreSQL 16 上 10/10,另通过完整的 260 对象测试套件 |
| Oracle | 已在 Oracle AI Database 26ai(Autonomous Database)上进行实时认证,2026 年 9 月:认证脚本 10/10、原生 VECTOR(512, FLOAT32) 存储一致性测试套件,以及方言测试套件。还针对包含 3 个域、127 个对象和约 700 万行的架构进行了压力测试 |
| SQL Server | 已在 SQL Server 2022 (16.0.4295.3) 上进行实时认证,10/10,每次推送时都在 CI 中通过服务容器测试;另有 13 项实时方言测试,涵盖别名类型、hierarchyid/sql_variant,以及以字节为单位的 max_length |
| MySQL / MariaDB | 已在 MySQL 8.4.11 上进行实时认证,10/10,每次推送时都在 CI 中通过服务容器测试;另有 GRANT 读取器测试套件:涵盖全部三个权限级别、角色图,以及 MySQL 无法报告的仅角色盲点。尚未运行 MariaDB |
上表中的每一项都通过真实数据库进行了测试。还有一点值得明确说明:MariaDB 的表现是根据 MySQL 推断得出的,并未实际运行。欢迎将脚本指向 MariaDB 并告知结果。
设置 URL 环境变量后,也可以在 pytest 下运行相同的检查;CI 正是通过这种方式正式认证方言:
export SCHEMAGATE_POSTGRES_URL='postgresql+psycopg://…'
export SCHEMAGATE_ORACLE_URL='oracle+oracledb://…'
export SCHEMAGATE_MSSQL_URL='mssql+pyodbc://…'
export SCHEMAGATE_MYSQL_URL='mysql+pymysql://…'
pytest tests/test_dialects.py -v
在 Agent 中使用
MCP 服务信任传入的身份。
principal和roles来自客户端,未经身份验证——没有令牌,也没有会话。任何能够访问传输层的人都可以声明一个角色,并读取该角色有权读取的内容;而且由于run_query会返回行数据,这涉及的是数据,而不只是架构。请通过 stdio 运行(调用方是你自己的桌面客户端),或通过 HTTP 在能够验证用户身份并为其设置principal的服务后运行。这是一种范围限定机制,不是一道锁。如果在SCHEMAGATE_CATALOG_CONFIG中配置groups块,客户端便无法自行声明 角色——这些角色来自目录或数据库,请求中提供的角色会被忽略(docs/groups.md);但主体仍由传输层传入。或者启用 OAuth,这样它就是一道锁。 设置
SCHEMAGATE_MCP_OAUTH_ISSUER和SCHEMAGATE_MCP_OAUTH_AUDIENCE后,通过 HTTP 发送的每个请求都必须携带由你的身份提供商(Entra ID、Okta、Auth0、Keycloak)签署的令牌。请求者身份及其持有的角色都来自该令牌,而不是客户端。无需网关(docs/oauth.md)。
如果你已经有能编写 SQL 的 Agent,最快的接入方式是让它把 schemagate 当作工具调用,而不是将该库接入你的代码。
MCP。 Cursor、Windsurf、Zed,以及任何支持 Model Context Protocol 的其他工具:
只需一行,事先无需安装任何内容(需要 uv);demo 是随附的示例架构,因此在连接任何目标之前就可以使用:
uvx --from "schemagate[mcp]" schemagate-mcp --url demo
Claude Code:
claude mcp add schemagate -- uvx --from "schemagate[mcp]" schemagate-mcp --url demo
其他任何客户端(Claude Desktop、Cursor、Windsurf、Zed)搭配你的数据库使用时,请在 mcp 旁添加数据库驱动扩展:postgres、mysql、mssql 或 oracle(SQLite 无需安装):
{"mcpServers": {"schemagate": {
  "command": "uvx", "args": ["--from", "schemagate[mcp,postgres]", "schemagate-mcp"],
  "env": {"SCHEMAGATE_DATABASE_URL": "postgresql+psycopg://user:password@localhost/app"}}}}
请像上面那样将含密码的 URL 放在 env 中,而不要放在 --url 中:命令参数对机器上的所有进程都可见。不使用 uv:运行 pip install 'schemagate[mcp,postgres]',然后运行 schemagate-mcp(或 python -m schemagate.mcp_server,仍然有效)。
七种工具,全部为只读:select_schema(针对某个问题、限定于调用者可见范围的 DDL)、list_objects(调用者可见的内容)、describe_object(单个对象的完整 DDL)、run_query(执行单条读取查询;如果查询涉及调用者无权查看的内容,则拒绝执行)、answer、refresh_catalog 和 health。它们接收 principal 和 roles。如果客户端未提供这些参数,调用者将被视为匿名用户,只能看到不受限制的对象。受限对象和不存在的对象会返回相同错误,因此不会泄露对象是否存在。
每项决策都有记录。 每次调用这些工具,以及调用 run_query 和 answer,都会写入一行记录:时间、调用者的主体及角色、调用者提出的问题、向其展示的内容、被扣留的对象和列的数量、执行的 SQL 和返回的行数,以及调用是否被拒绝及拒绝原因。绝不记录行数据、被扣留内容的名称或数据库 URL。记录保存在内存中(最近 500 条,可在 health 中查看);除非设置 SCHEMAGATE_AUDIT_LOG=<path>,或设置为 =1 以写入 ~/.schemagate/audit.jsonl,否则不会启用文件记录。一个宣传不存储任何内容的工具不会自行开始写入文件。日志供操作员从文件中查看;它刻意不作为工具提供,因为把“近期决策”交给任何客户端,就等于把每个调用者的问题交给所有其他调用者。
而且,这些记录多年后仍可验证。 启用签名后,每条记录都会链接到前一条记录,并使用 ML-DSA-65,即 NIST 后量子签名标准(FIPS 204) 进行签名:修改、删除、插入或重新排序记录,都会被 schemagate audit verify 检出,并指出行号和原因。采用后量子签名,是因为审计日志会保存多年,时间长到今天的 RSA 和 ECDSA 签名届时可能已可伪造。它可以回答审计员的问题:“你能证明模型从未向这个用户展示过薪资表吗?”任何持有公钥的人都可以运行检查来验证。
pip install "schemagate[pq]"                       # PyCA cryptography >= 48 (OpenSSL)
schemagate audit keygen --out ./keys               # private key stays with the server
SCHEMAGATE_AUDIT_LOG=1 SCHEMAGATE_AUDIT_SIGNING_KEY=./keys/audit-signing-key.pem \
  python -m schemagate.mcp_server
schemagate audit verify ~/.schemagate/audit.jsonl --public-key ./keys/audit-signing-key.pub.pem
# OK  1204 signed records (ML-DSA-65), seq 0..1203, no edits, gaps or reordering
schemagate audit head ~/.schemagate/audit.jsonl     # keep this SEQ:HASH elsewhere
它不会声称能做到的事:能够写入文件的人,仍然可以删除最新的记录,因为较短的链仍然有效。将 head 保存在其他地方(例如工单或另一个系统),然后使用 verify --head SEQ:HASH;如果日志不再延续到该位置,验证就会失败。签名不会加密:日志仍和以前一样可读,也仍然不包含任何行数据或被扣留内容的名称。它证明的是 schemagate 的决策,而决策是否正确,取决于它获得的角色是否正确。每个服务器进程写入一个日志;如果无法加载已配置的密钥,服务器会在启动时停止,而不会写入未签名的证据。
它会从已执行的 SQL 中学习。 当 answer 生成并执行查询后,问题和查询会被记住——绝不记录行数据。下次遇到类似问题时,该查询读取过的表会固定加入选择结果中,并将问题和查询作为已完成的示例展示给模型,位置在 DDL 和问题之间。这两者都不会扩大调用者的可见范围:固定表仍须通过相同的可见性检查;只有当示例中提及的所有表对该调用者均可见时,才会展示示例。每条存储的查询在写入和读出时都会重新检查是否为只读。除非设置 SCHEMAGATE_MEMORY=<path>,或设置为 =1 以写入 ~/.schemagate/memory/<db>.jsonl,否则只保存在内存中;如果没有记住任何内容,提示词与此功能出现之前逐字节相同。CLI 提供 --memory,Studio 会在连接时使用它。相似度由目录自身的嵌入器计算——确定性、离线运行,而且对“相似”的判定较弱:它匹配的是措辞,而非含义;这可以接受,因为示例仅供参考,固定项则受访问控制约束。
SCHEMAGATE_DATABASE_URL=demo 会提供捆绑的架构。
SCHEMAGATE_VALUES=1 等同于服务器的 --values:它会在启动时读取短小、非个人信息列中的不同值,让模型写出 'CARD' 而不是 'Card'。这会读取行数据,因此默认关闭,只有显式设置后才会启用;SCHEMAGATE_VALUES_BUDGET 以秒为单位限制读取时长(默认值为 30;如果钱包后面连接的是大型架构,可以调高该值)。
若要为团队托管,而不是只供一台桌面设备使用:
SCHEMAGATE_MCP_TRANSPORT=streamable-http SCHEMAGATE_MCP_PORT=8765 python -m schemagate.mcp_server
并在它前面接入身份提供方,这样每个人自己的令牌就能决定他们看到什么:
SCHEMAGATE_MCP_OAUTH_ISSUER=https://login.microsoftonline.com/<tenant>/v2.0 \
SCHEMAGATE_MCP_OAUTH_AUDIENCE=api://schemagate \
SCHEMAGATE_MCP_OAUTH_RESOURCE=https://schemagate.example.com/mcp \
SCHEMAGATE_MCP_TRANSPORT=streamable-http SCHEMAGATE_MCP_HOST=0.0.0.0 python -m schemagate.mcp_server
它的设计经久耐用。启动后,索引会保存在内存中,因此数据库宕机不会连带服务一起停止——select_schema 会继续基于上一次成功的反射结果响应,而 refresh_catalog 会报告故障,而不是抛出异常。
权限信息可能有多旧? 服务在构建目录时读取权限:来自配置文件的限制,以及在设置 SCHEMAGATE_RESTRICT_FROM_GRANTS=1 时来自数据库自身的 GRANT。默认情况下,目录会一直使用,直到调用 refresh_catalog,因此数据库中的 REVOKE 要到那时才会传到服务。设置 SCHEMAGATE_CATALOG_MAX_AGE=300 后,使用超过 5 分钟的目录会先重新读取:GRANT 或 REVOKE 会在这个时间窗口内生效,而不是等到下一次调用。如果重新读取失败,服务不会继续使用旧权限响应:select_schema、list_objects、describe_object、run_query 和 answer 都会拒绝请求,并返回“权限已过期”,直到重新读取成功(最多每 5 秒重试一次);health 会显示 catalog_stale 和原因。如果重新读取既未失败也未返回,也就是数据库接受了连接后便无响应,同样会受到限制:调用方最多等待 SCHEMAGATE_REREAD_TIMEOUT 秒(默认 30 秒),之后会以相同方式被拒绝,而重新读取会继续运行;如果它返回,下一次调用就会使用它带回的内容。来自 groups 解析器的调用方角色有自己的时限,即其 ttl。每个工具都会捕获所有异常并返回 {"error": ...};错误请求不会影响其他客户端的会话。health 会向负载均衡器报告服务状态。一项测试会向每个工具发送 125 种垃圾输入,然后检查后续正常请求是否仍能成功;另一项测试也会通过 stdio 上的真实客户端执行相同检查。兼容 MCP SDK 1.x 和 2.x;2.0 的重命名曾导致一次全新安装失败,现在已有兼容层和相应测试。
LangChain。 一个标准的 BaseRetriever,可与其他组件组合使用:
pip install 'schemagate[langchain]'
from schemagate.integrations.langchain import SchemagateRetriever, prompt_fragment

retriever = SchemagateRetriever(catalog=cat, top_k=6,
                           principal=Principal("okta:jdoe", roles={"finance"}))
chain = retriever | RunnableLambda(prompt_fragment) | your_sql_prompt | llm
主体在构造时绑定,这是有意为之。为每个调用方创建一个 retriever;如果 retriever 已经持有身份信息,链就不会忘记传递身份。
LlamaIndex。 同一个 retriever,作为 LlamaIndex BaseRetriever:
pip install 'schemagate[llamaindex]'
from schemagate.integrations.llamaindex import SchemagateRetriever, prompt_fragment

retriever = SchemagateRetriever(cat, top_k=6, principal=Principal("okta:jdoe", roles={"finance"}))
ddl = prompt_fragment(retriever.retrieve("revenue by month"))
jev4pg。 schemagate.integrations.jev4pg.ScopedCatalog 封装了 jev4pg 的多租户目录,使其规划器、SQL 验证器和语义运算符只能看到每个调用方有权读取的内容。参见 docs/jev4pg.md。
关于文本内容的问题。 semantic_query(MCP,默认关闭)会在执行相同范围检查的情况下运行你的 SQL,然后询问模型哪些行的文本符合某项条件,或为每行生成一个简短回答。参见 docs/semantic-operators.md。
回答前先查看数据。 deep_answer(MCP,默认关闭)允许模型执行小规模探索性读取,例如在编写最终查询前发现列中的值是 Praha,而不是 Prague。每一步都会经过与 run_query 相同的范围检查和审计。在默认的自适应模式下,只有普通查询失败、结果为空或仅返回零值时,它才会进行探索。在 220 道 BIRD 题目上使用 Gemini 2.5 Flash 测试时,普通模式得分为 36.8,自适应模式为 54.5。参见 docs/deep-answer.md。
业务规则。“财年从 7 月 1 日开始”“排除测试租户”:这些知识不会体现在架构中。将其写入 Markdown 文件,或写在 Studio 的 业务规则 框中。每条规则都可以关联表,并对某些角色隐藏,只有相关规则才会进入提示词。参见 docs/business-rules.md。
在 Oracle Cloud 上
已认证可在 Oracle AI Database 26ai 上运行。有两种接入方式,均无需 API 密钥 — 目录编制由 OCI Generative AI 在你自己的 OCI 身份下运行,因此提示词(仅限架构元数据,从不包含行数据)会留在你的租户中。
在 Cloud Shell 中运行,约 1 分钟,无需 VM:
pip install --user 'schemagate[oracle,oci]'
schemagate describe --url 'oracle+oracledb://@' --provider oci \
    --model google.gemini-2.5-pro --config catalog.json
或者只需单击一次,即可部署一个持续运行、供团队使用的 MCP 端点:

这会在你自己的租户中打开 Resource Manager,并加载该堆栈 — 其中包含一台符合 Always Free 条件、运行 MCP 服务的 VM;该服务连接到它创建的 Autonomous Database,也可以连接到你已有的数据库。详情和 Terraform:oci/。
在自己的机器上使用 OCI Generative AI
所有操作都在你的 OCI 身份下运行,费用计入你的租户。数据库中不会安装任何内容 — 无需 Select AI 配置文件,权限也不超出 SELECT。
pip install 'schemagate[oracle,oci,mcp]'
在 Windows 上,OCI SDK 的文件路径可能非常长:请安装到较短的路径(python -m venv C:\sg)或启用长路径,否则 pip 会在安装过程中途失败。
登录使用常规 OCI 方式:通过 API 密钥(Console › Profile › API keys)获取 ~/.oci/config,或者在 OCI 内运行时使用资源主体/实例主体。权限只需为你的组设置一条策略 — 无需动态组,也无需对数据库进行任何操作:
allow group <your-group> to use generative-ai-family in compartment <compartment>
| 变量 | |
|---|---|
OCI_COMPARTMENT_ID | 启用 OCI Generative AI(未设置其他密钥时,它是选用的提供方) |
OCI_REGION | Generative AI 区域,例如 us-chicago-1、us-phoenix-1 |
SCHEMAGATE_DESCRIBE_MODEL | 用于自动生成描述的模型。OCI 必填 — 没有默认值,因为模型 ID 因区域而异 |
选择所在区域提供按需服务的模型。 某个区域的目录可能会列出仅支持专用集群的模型;调用这些模型会失败,并返回 404 Entity with key <model> not found。请改选其他模型(在 us-phoenix-1,2026 年 9 月,google.gemini-2.5-flash 支持按需使用;目录中列出的几个 Llama 和 Cohere 模型则不支持)。即使模型设置错误,MCP 服务仍会启动 — 只是会跳过描述生成,因此请检查日志。
在 Autonomous Database 上运行 MCP 服务,获取值和描述:
{"mcpServers": {"schemagate": {
  "command": "python", "args": ["-m", "schemagate.mcp_server"],
  "env": {
    "SCHEMAGATE_DATABASE_URL": "oracle+oracledb://@",
    "SCHEMAGATE_CONNECT_ARGS": "{\"config_dir\": \"C:/wallet\", \"wallet_location\": \"C:/wallet\", \"wallet_password\": \"...\", \"user\": \"APP\", \"password\": \"...\", \"dsn\": \"mydb_high\"}",
    "SCHEMAGATE_VALUES": "1",
    "SCHEMAGATE_VALUES_BUDGET": "120",
    "OCI_COMPARTMENT_ID": "ocid1.compartment.oc1..…",
    "OCI_REGION": "us-phoenix-1",
    "SCHEMAGATE_DESCRIBE_MODEL": "google.gemini-2.5-flash"
  }}}}
SCHEMAGATE_VALUES_BUDGET 的单位是秒;对于使用钱包连接的大型架构,默认值 30 可能会导致值读取提前结束。系统会排除 Oracle 维护的架构 — 包括每个 Autonomous Database 都附带的 SH 和 SSB 示例 — 因此目录中只会包含你拥有或获准访问的架构。在 CLI 中,--answer --provider oci --model <id> 会使用相同模型编写 SQL,并通过同一连接以只读方式运行。
在 Oracle 中保存索引
MemoryStore 会在每次进程启动时重建。对几百个对象来说没问题,但不适合长期运行的服务。OracleStore 使用 Oracle 23ai 的原生 VECTOR 类型在 Oracle 中保存向量,因此最近邻搜索会在数据库中运行:
from schemagate.stores.oracle import OracleStore

store = OracleStore(dsn="user/pw@host:1521/FREEPDB1", dim=512)
store.create_schema()                       # idempotent

cat = Catalog(store=store).bootstrap("oracle+oracledb://…")
传入 connection= 而不是 dsn=,即可复用应用的连接池。它不会关闭并非由它打开的连接。
作用域条件是计分子查询中的谓词,而不是在取回行之后才应用的筛选条件。调用者无权查看的行永远不会参与排序,也不会离开数据库。
与上文相同的注意事项:26 项测试固定了 SQL、绑定类型和作用域谓词,并使用独立的 Oracle 解析器检查了每条语句,但尚未在实际运行的 23ai 实例上执行过。要进行实际验证:
export SCHEMAGATE_ORACLE_DSN='user/password@host:1521/FREEPDB1'
pytest tests/test_store_conformance.py -v
Oracle Cloud 的 Always Free ATP 已足够。
可能让你踩坑的地方
归档副本和暂存副本已处理,但要了解处理方式。 如果你的数据仓库中有
orders、orders_bkp 和 stg_orders,这些副本在较短的文档中包含相同的名称词,而余弦相似度偏好较短的文档。如果不加处理,一个只有三列的 _tmp 副本会排在它所复制的二十五列表之前,即使真实表上有提示也是如此——我亲眼见过。因此,名称为某个真实对象名称加上 _bkp、_old、_tmp、_v2、
_archive 等后缀,或以 stg_/tmp_ 开头的对象,排名会低于它所影射的对象。仅当真实对象存在时才会这样:如果只有一个 pricing_v2,而没有 pricing,则不会处理它。仅限同一架构。并且,如果你直接指定副本名称,则绝不会这样——请求 fact_claim_line_v2 会得到 fact_claim_line_v2。相关列表是 DEFAULT_SHADOW_SUFFIXES 和 DEFAULT_SHADOW_PREFIXES;可将自定义列表传给 Catalog(...),或传入空元组来关闭此功能。cat.shadows() 会显示检测到的对象。
标识符长度。 PostgreSQL 在创建时会将名称截断为 63 个字节。这是数据库的行为,不是 schemagate 的行为,我们无法从这边解决。
非英语架构也能正常使用,包括中文、日语和韩语;重音符号会双向折叠,因此搜索 facturacion 可以找到 facturación。但用英语提问无法找到名称为西班牙语的表。仅靠词汇层面无法弥补这一点,可以通过描述来解决。
top_k 不是硬性上限。 选择完成后还会扩展外键,并额外加入关联表。这是有意为之——引用未包含表的 SQL 无法运行——但请为提示词预留足够的预算。
状态
v1.0。公共 API 稳定。
本 README 说明的名称——Catalog 及其方法、Principal、
Selection、schemagate CLI 及其标志、MCP 工具名称、目录配置文件和 LangChain 检索器——在 2.0 之前都会继续可用,不会出现破坏性变更。以下划线开头的内容均为内部实现,可能在任何版本中变动。
有两项内容不在这项承诺范围内。下表中标记为未完成的项目,直到状态变为已完成为止。另一项是排序:检索会在每个版本中持续调整,因此问题返回的表集合可能会在 1.x 版本之间发生变化。不变的是关键部分——调用者无权读取的表绝不会出现在结果中。
| 反射 | 已在 SQLite、PostgreSQL 16、Oracle 26ai、MySQL 8.4 和 SQL Server 2022 上通过认证 |
MemoryStore | 已完成 |
| AI 编目 | 已完成,已使用模拟提供方进行离线测试 |
| CLI | 已完成 |
Studio(schemagate studio 和托管演示) | 已完成,测试由真实浏览器驱动 |
| MCP 服务 | 已完成,已通过真实 MCP 客户端测试 |
| LangChain 检索器 | 已完成,已针对 langchain-core 测试 |
| LlamaIndex 检索器 | 已完成,已针对 llama-index-core 测试 |
OracleStore | 已编写并通过静态验证,尚需在线运行 |
| pgvector 存储 | 尚未开始 |
import schemagate 不会导入任何提供方 SDK,并且有测试对此进行断言。
默认嵌入向量在不同进程、机器和 Python 版本之间保持稳定,因此缓存或持久化的向量始终有效。此项由一项测试强制保证:该测试会在不同 PYTHONHASHSEED 值下,通过全新子进程运行嵌入器,因为这一点曾经出过问题,其他检查都没能发现。
Apache-2.0。Ashish Sinha。
专利申请中:美国临时专利申请 64/183,987,提交于 2026 年 10 月 25 日。本代码的使用依据 Apache-2.0 许可,包括其第 3 节中的专利许可。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。