关于 Workflow Generator
Workflow Generator 扫描代码库并生成 WORKFLOW.html,面向希望查看系统结构和并发瓶颈的开发者。它覆盖多种语言,输出依赖图及容量静态分析估算,并可叠加访问日志数据。
主要功能
- 01扫描多语言项目并生成 HTML 报告
- 02绘制架构、数据流与代码依赖图
- 03估算并发上限和吞吐瓶颈
- 04按目录聚合大型项目图表
- 05叠加访问日志并生成 k6 脚本
适用场景
- 01快速了解陌生代码库的组件关系
- 02定位吞吐量限制及潜在瓶颈
- 03用访问日志对静态估算进行核验
MCP 相关
MCP 服务提供 generate_workflow 工具以扫描项目并写入 WORKFLOW.html,以及 analyze_workflow 工具以返回结构化 JSON 摘要。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
workflow-generator
扫描任意项目并生成 WORKFLOW.html——一张深色模式的可视化系统图,展示每个组件、它们之间的通信方式,以及实际吞吐量上限。
支持 Python、Node.js、Go、Java、Rust、Ruby 和混合项目。核心扫描器无需外部依赖。
不会扫描 vendored 和生成的目录(node_modules、venv、site-packages、dist 等),
并且容量数值会明确标注为静态分析估算值。
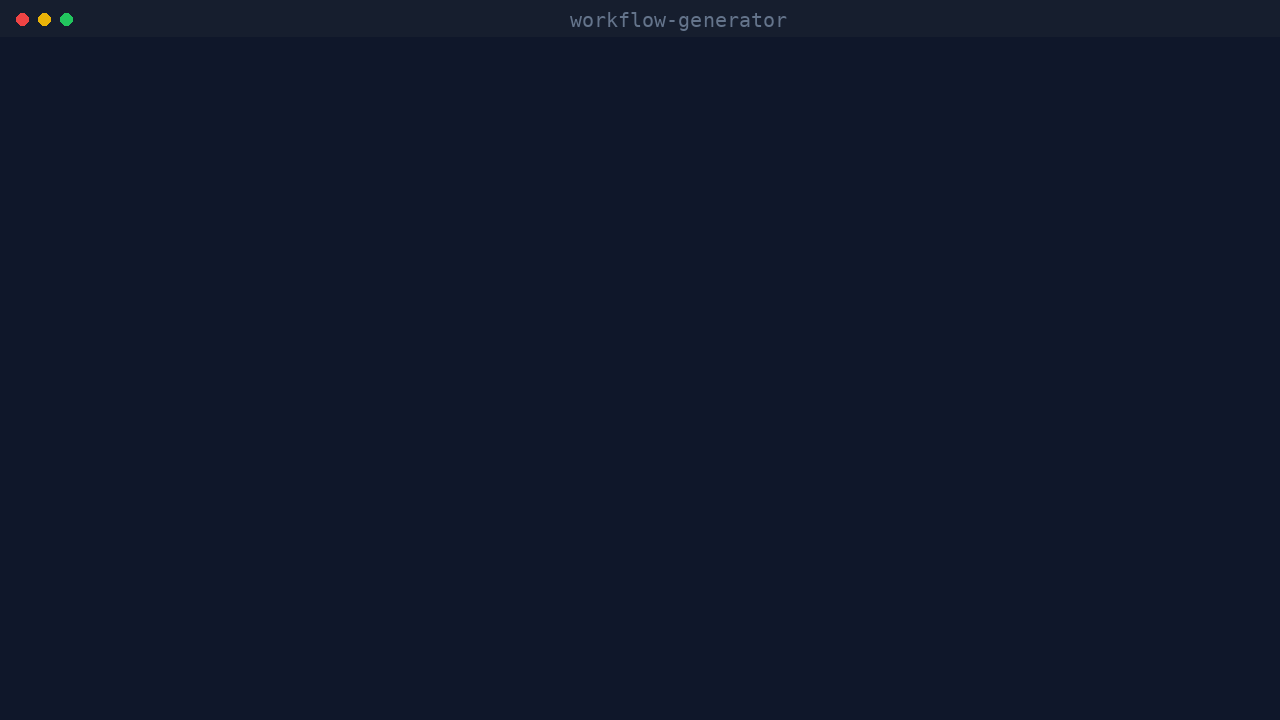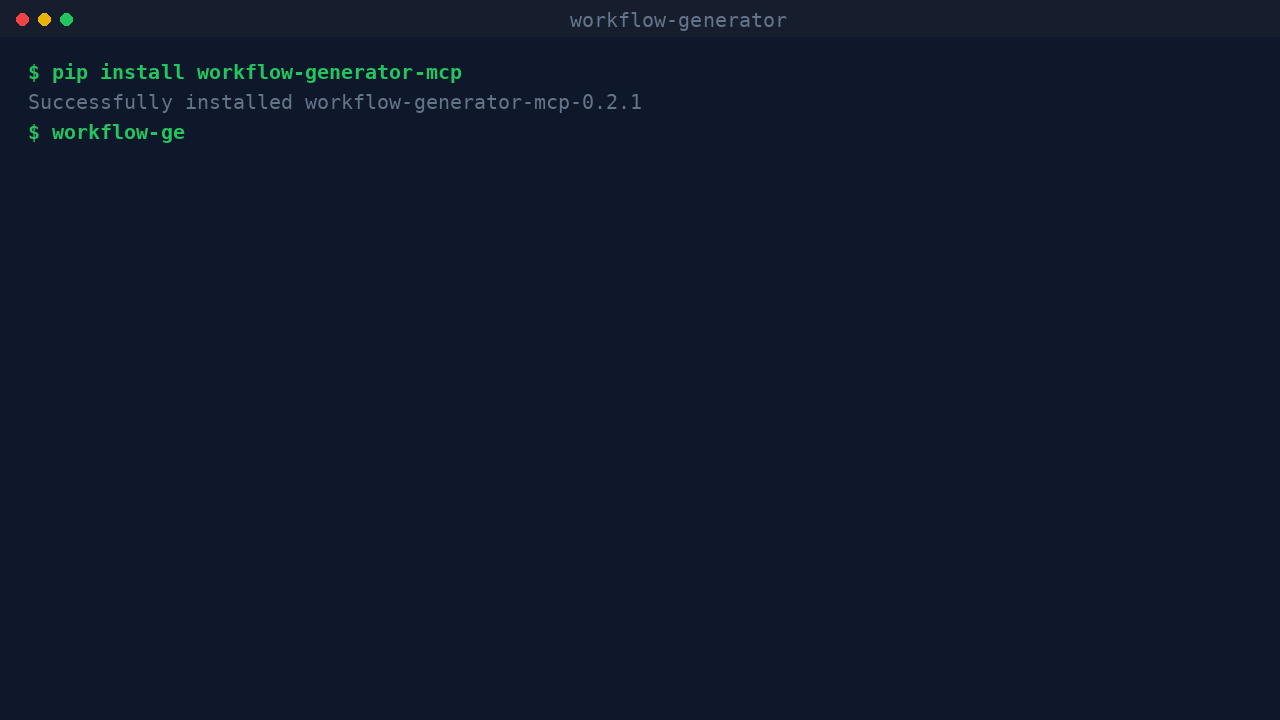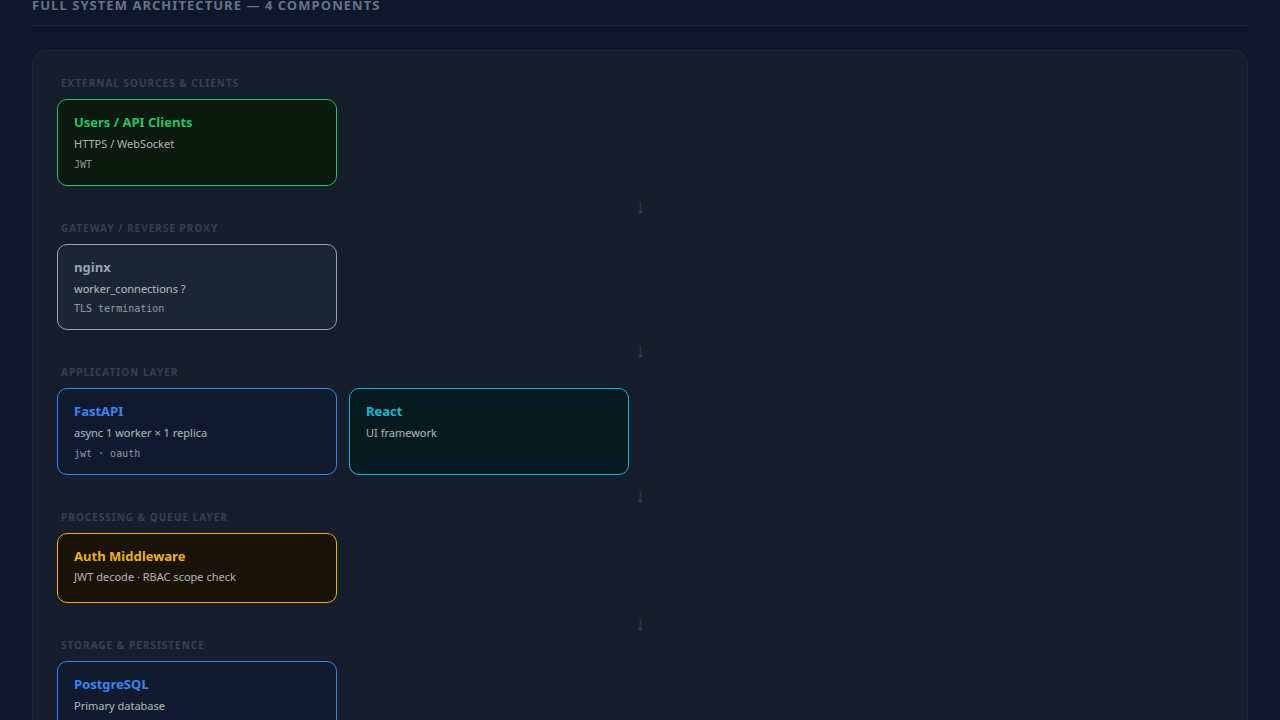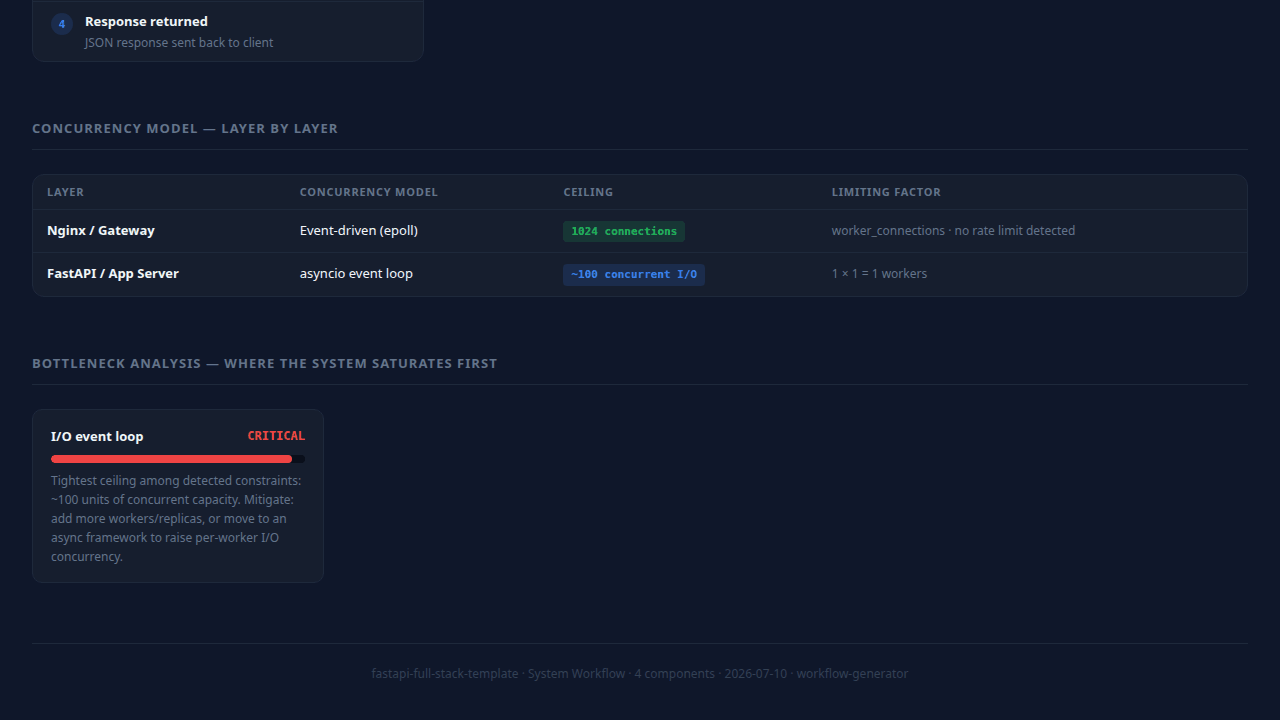
在线演示 →——基于 fastapi/full-stack-fastapi-template 生成,未经修改。
(真实的 CLI 输出,未经脚本处理——如果不想自动播放,可查看静态截图)
生成内容
每个生成的页面都包含:
| 区域 | 内容 |
|---|---|
| 统计行 | Worker · 并发 I/O 上限 · 信号量限制 · 速率限制 · 实际吞吐量 |
| 架构图 | 分层流程:外部来源 → 网关 → API → 队列 → AI → 存储 |
| 数据流卡片 | 写入路径、读取/查询路径、后台任务——根据检测结果推断 |
| 并发能力表 | 每一层:模型 · 上限 · 限制因素 |
| 瓶颈分析 | 按 CRITICAL → LOW 排序,并附带缓解建议 |
| 代码库依赖关系图 | 力导向的模块/导入关系图——点击节点可聚焦其相邻节点,悬停可查看文件详情。导入方向的边与实际观察到的流量明确区分(见下文) |
| 引导式导览 | 突出显示每个区域的分步讲解;首次打开报告时自动显示,也可随时点击 ? 按钮重新播放 |
代码库依赖关系图
每个源文件(Python、JS/TS、Go、Java、Rust、Ruby)都会成为一个节点;每个实际导入都会成为一条边——通过适合相应语言的解析器解析(Python 使用 ast 模块,JS/TS/Go/Java/Rust/Ruby 使用正则表达式),而不是靠猜测。与已检测到的组件(LLM 调用、数据库客户端、队列)相匹配的文件也会连接到相应组件,让你准确看到哪些文件在与 Redis、OpenAI 等交互。大型仓库(350 个以上文件)会自动聚合为目录级节点,以保持图表清晰;可使用 --graph-detail files 或 --graph-detail dirs 覆盖此设置。
测试文件(tests/、test_*.py、conftest.py、*.spec.ts、*_test.go 等)会在下方单独显示为 测试图,展示每项测试会访问哪些模块和服务。夹具和测试替身会列出它们所测试的每项服务,因此将它们放入主图会让服务边淹没真实的依赖结构。
两个部分都提供 流程 | 图表 切换,且共用相同的节点和边。流程(默认适用于不超过 80 个节点的图)是从左到右的分层图:各列表示从源头(HTTP 入口以及没有被导入的文件)开始的依赖深度,每个检测到的服务在最后一列中都有自己的节点,导入循环则以虚线绘制。图表是力导向视图。移动的圆点会显示双向数据流:实心圆点表示调用/请求,空心圆点表示返回/响应。在边数超过 60 条的图中,只有被点击或悬停的节点路径会播放动画。搜索、“隐藏孤立节点”和所选节点在两个视图中共用。
较旧的分层 完整系统架构 图默认处于折叠状态,因为架构图涵盖了相同内容。
默认情况下,图表只显示 代码 所表达的内容(导入方向、静态的“此文件调用 Redis”),这虽然真实,但不等同于实际流量。传入 --access-log /path/to/access.log(任何 combined/common 日志格式),即可在 HTTP 入口边上叠加实际观测到的请求数——生成的报告还会附带一个可直接运行的 k6 负载测试脚本,覆盖最多 5 条检测到的路由,这样就可以通过真实测量来验证“实际吞吐量”,而不是只依赖静态分析估算。
检测内容
| 类别 | 示例 |
|---|---|
| API 框架 | FastAPI、Flask、Django、Express、Nest.js、Gin |
| 网关 | nginx、Caddy、Traefik(含速率限制和 worker_connections) |
| LLM 提供商 | OpenAI、Anthropic Claude、Cohere、AWS Bedrock |
| 向量存储 | Qdrant、Pinecone、Weaviate、ChromaDB、pgvector、FAISS、Milvus |
| 数据库 | PostgreSQL、MySQL、MongoDB、SQLite、Redis |
| 队列 | Celery、BullMQ、Kafka、RabbitMQ、RQ、AWS SQS |
| 异步原语 | asyncio.Semaphore、run_in_executor、asyncio.gather、asyncio.Lock |
| 工作进程 | --workers N(uvicorn/gunicorn)、replicas:(docker-compose)、PM2 实例 |
| 外部来源 | Jira、Azure DevOps、Slack、GitHub、Stripe、Salesforce、Twilio |
| 评估 | TruLens、RAGAS、LangSmith |
安装
pip(CLI + MCP 服务)
pip install workflow-generator-mcp

workflow-generator . WORKFLOW.html       # CLI: scan and write the report
workflow-generator-mcp                    # stdio MCP server
安装好 pip 后,任何 MCP 主机配置都可以简化为:
{
  "mcpServers": {
    "workflow-generator": { "command": "workflow-generator-mcp" }
  }
}
Claude Code(技能)
mkdir -p ~/.claude/skills
git clone https://github.com/askuma/workflow-generator.git ~/.claude/skills/workflow-generator
然后,在任意 Claude Code 会话中:
/workflow-generator
/workflow-generator /path/to/project
MCP 服务(Claude Desktop、VS Code、Cursor、Zed、Windsurf、Continue)
1. 安装依赖:
pip install mcp
2. 添加到 MCP 主机配置中(将 ~ 替换为实际的主目录路径):
Claude Desktop
~/Library/Application Support/Claude/claude_desktop_config.json(Mac)
%APPDATA%\Claude\claude_desktop_config.json(Windows)
{
  "mcpServers": {
    "workflow-generator": {
      "command": "python3",
      "args": ["~/.claude/skills/workflow-generator/mcp/server.py"]
    }
  }
}
VS Code
.vscode/mcp.json
{
  "servers": {
    "workflow-generator": {
      "type": "stdio",
      "command": "python3",
      "args": ["~/.claude/skills/workflow-generator/mcp/server.py"]
    }
  }
}
Cursor
~/.cursor/mcp.json
{
  "mcpServers": {
    "workflow-generator": {
      "command": "python3",
      "args": ["~/.claude/skills/workflow-generator/mcp/server.py"]
    }
  }
}
Zed
.zed/settings.json
{
  "context_servers": {
    "workflow-generator": {
      "command": {
        "path": "python3",
        "args": ["~/.claude/skills/workflow-generator/mcp/server.py"]
      }
    }
  }
}
Windsurf
~/.windsurf/mcp_config.json
{
  "mcpServers": {
    "workflow-generator": {
      "command": "python3",
      "args": ["~/.claude/skills/workflow-generator/mcp/server.py"]
    }
  }
}
3. 重启工具,然后询问:
generate a workflow diagram for this project
how many concurrent requests can this handle?
show me the system architecture
提供的 MCP 工具:
generate_workflow— 扫描项目,写入WORKFLOW.html,并可选择在浏览器中打开analyze_workflow— 返回结构化 JSON 摘要(不写入文件)
命令行(独立运行)
除了 Python 3.8+,无需安装其他内容:
python3 ~/.claude/skills/workflow-generator/scripts/analyze.py . ~/WORKFLOW.html
# then open ~/WORKFLOW.html
可选标志:
--access-log /path/to/access.log   # overlay real request counts onto the dependency graph
--graph-detail auto|files|dirs     # force file-level or directory-level graph nodes (default: auto)
输出示例(终端)
Written: /your/project/WORKFLOW.html
Framework: FastAPI · Workers: 8 · Concurrent I/O: ~800
Practical throughput: ~50–200 req/min
Bottleneck: OpenAI (LLM latency 3–30s per call)
Gateway: nginx · 2 rate limit zone(s)
LLM: OpenAI · eval: TruLens RAG Triad
Storage: Qdrant, Redis
External sources: Jira, Azure DevOps, Slack
仓库结构
workflow-generator/
├── SKILL.md                        ← Claude Code skill definition
├── INSTALL.md                      ← detailed per-platform install guide
├── workflow_generator_mcp/
│   ├── analyze.py                  ← core scanner + HTML renderer (stdlib only)
│   └── server.py                   ← MCP stdio server (package form)
├── scripts/
│   └── analyze.py                  ← thin compatibility shim -> workflow_generator_mcp/analyze.py
├── tests/                          ← pytest suite for the scanner
├── mcp/
│   ├── server.py                   ← MCP stdio server
│   └── requirements.txt            ← pip install mcp
└── copilot/
    ├── index.js                    ← GitHub Copilot Extension (Express)
    ├── package.json
    └── openai_function.json
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。