关于 GreenPick
GreenPick 是面向开发者的 MCP 服务,用于在设计阶段选择云基础设施。它比较不同区域的碳排放、成本和延迟,并提供调度、规格调整与部署建议;数据为方向性估算,而非审计核算。
主要功能
- 01跨区域比较碳排放、成本与延迟
- 02按电网碳强度安排作业
- 03估算训练与推理排放
- 04实例选择与规格调整
- 05检查流量费用与数据驻留
- 06提供美国和欧盟实时电网数据
适用场景
- 01部署前比较云区域
- 02选择电网更清洁的批处理时段
- 03估算 GPU 训练或 LLM 推理排放
- 04检查流量费用是否抵消减排收益
MCP 相关
GreenPick 通过 stdio 提供包含 15 个工具的 MCP 服务。MCP 客户端可请求区域比较、调度建议、工作负载估算、效率检查和方法说明。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx greenpickGREENPICK_CARBON_SOURCECarbon data source: 'auto' (US->EIA, EU->ENTSO-E, Canada->Hydro-Québec/IESO live), 'mock' (offline: typical monthly values from a year of real data), 'eia', 'entsoe', or 'electricitymaps'. Defaults to offline.EIA_API_KEY密钥Free US EIA-930 grid data API key (optional; enables live US carbon).ENTSOE_TOKEN密钥Free EU ENTSO-E grid data token (optional; enables live EU carbon + day-ahead forecast).ELECTRICITYMAPS_TOKEN密钥Electricity Maps API token (optional; used when GREENPICK_CARBON_SOURCE=electricitymaps).GREENPICK_CACHE_TTL_SECONDSCache lifetime for fetched grid data, in seconds.GREENPICK_LOG_LEVELLogging level (DEBUG, INFO, WARNING, ERROR).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
15收录的工具列表 · 更新于 2 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| vcpu | number | 是 | |
| ram_gb | number | 是 | |
| regions | any | 否 | |
| user_lat | number | 是 | |
| user_lon | number | 是 | |
| providers | any | 否 | |
| optimize_for | string | 否 | |
| baseline_region | any | 否 | |
| max_added_latency_ms | any | 否 | |
| est_monthly_egress_gb | number | 否 |
详细介绍
GreenPick
在部署之前,编写更环保、成本更低的云基础设施。


一款设计阶段的可持续性协作助手,以 MCP 服务的形式运行于你的氛围式编程环境(Cursor / Claude Code / Kiro)中。询问它应该部署到哪里、何时运行作业,或如何调整资源规格,它会在几秒内于编辑器中给出坦诚的碳排放 + 成本 + 延迟权衡。(它会在你提问时响应;基础设施代码变更时自动提醒已列入路线图。)
状态:可用——15 个工具。 支持美国(EIA-930)和欧盟(ENTSO-E)的实时碳排放数据、跨云成本对比(由 Vantage 刷新)、各维度红/黄/绿评级、碳感知调度与日前预测、GPU 训练和 LLM 推理的碳排放、调整资源规格、服务模式及数据本地化/驻留检查——以上功能均已推出。离线或没有 API 密钥时,会回退到明确标注的模拟数据。
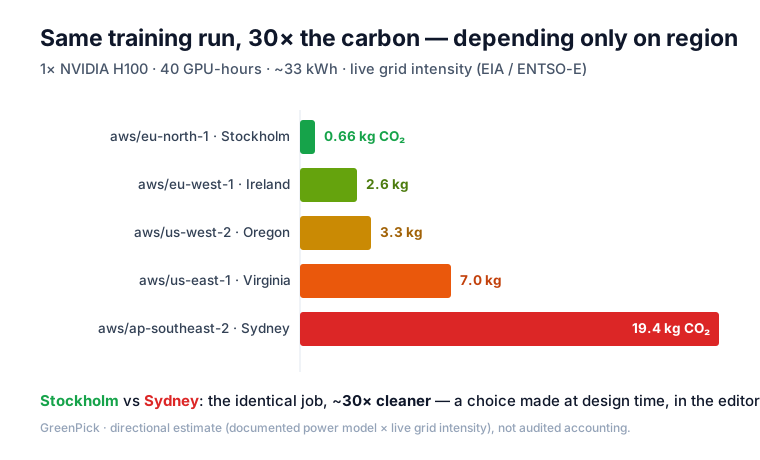
同一项 40 GPU 小时的训练任务,在斯德哥尔摩排放约 0.7 kg CO₂,在悉尼则约为 19 kg——仅区域选择就造成约 30 倍的差异。向 GreenPick 提问,它会在你仍处于编辑器中、提交之前,揭示这一差异(以及成本和延迟方面的权衡)。
▶ 观看 5 分钟演示——三个场景,包含真实工具输出(训练任务选址、出口流量反噬、预测)。
功能
- 🧮 调整资源规格,同时降低成本 和 碳排放——这是 FinOps 的收益,也是碳排放方面的双重收益。节省成本是运行它的理由;减碳则是额外收获。
- ⏱ 碳感知调度——在电网最清洁时运行可延迟的作业(ETL、批处理、训练),支持当前或日前调度。每个周期性作业都需要做出这个决策。
- ⚡ GPU 训练和 LLM 推理的碳排放——估算运行的碳足迹,并找出更环保的运行地点和时间;选择规模和部署位置,才能真正改变排放数字。
- 🌍 更环保的区域选择——按碳排放排序,同时展示成本和延迟方面的权衡,而非将其隐藏。
- 🛡 反噬防护——当更环保的选择因出口流量而得不偿失,或触及数据驻留限制时发出提示。
- 🔌 美国和欧盟的实时电网数据,并提供坦诚的模拟数据回退——无需 API 密钥即可开始使用。
目录
为何开发
同一项 Web 服务在不同区域运行时,产生的 CO₂ 会大不相同,因为各地电网的碳强度不同。现有工具要么只对区域进行抽象排名,要么等部署之后才测量碳排放。GreenPick 会在你做出选择时进行分析,并告诉你更环保的选择会带来怎样的延迟和成本——让你在充分了解情况后决定接受还是拒绝。
它是什么 / 不是什么
- **是:**为开发者在构建过程中选择云区域提供方向性的“更绿色选择”建议,并说明其中的权衡。
- **不是:**经过审计的碳核算、ESG/Scope-2 报告,也不是实时调度器。GreenPick 不声称符合 GHG-Protocol 或 ISO 标准——这些是付费数据供应商(Electricity Maps、WattTime)提供的服务。GreenPick 用于决策,而非披露。
与现有方案的区别
- 测量工具(Cloud Carbon Footprint、CodeCarbon、Kepler)会在你部署后,报告已经排放的碳。GreenPick 则在选择之前提供建议。
- 云服务商自有工具(AWS CCFT、Azure、Google 的“Low CO₂”区域标签)只覆盖一家云服务商,而且只显示碳排放。GreenPick 支持跨云比较,并权衡碳排放、成本和延迟,让你看到其中的取舍,而不只是一个绿色徽章。
- CI/CD 碳排放工具在合并时针对流水线任务发挥作用。GreenPick 更早介入,在编辑器中覆盖更多决策(调度、规格调整、训练/推理、出口流量和数据驻留)。
- 电网数据 SDK(Electricity Maps、WattTime、GSF Carbon Aware SDK)是构建模块;GreenPick 则是在此类数据之上构建的决策层。
跨云、兼顾碳排放 + 成本 + 延迟、在设计时于编辑器中提供建议,并配有防反效果保护——这一组合正是其他方案都未能实现的部分。
范围
- 服务商:AWS、GCP、Azure 区域。
- 工作负载:长期运行的Web/API 服务、GPU 训练任务,以及可延后任务(ETL / 批处理 / 备份)——分别提供部署位置和执行时间建议。
- 碳排放 = 按区域划分的电网碳强度(方向性指标,反映某一时点;美国和欧盟提供实时数据),以及用于前瞻性调度的次日预测(欧盟)。
- 成本 = 计算 + 出口流量的粗略估算(确定性的静态表格,可在不同云之间公平比较;绝不由 LLM 臆造)。
- 延迟 = 到指定用户位置的地理估算值。
- 效率优化手段:更绿色的实例系列(每瓦性能)、规格调整(同时考虑成本和碳排放),以及用于跟踪应用长期表现的碳指标框架。
- 防护措施:检查数据本地性 / 出口流量是否产生反效果,并标记跨司法管辖区的数据驻留问题。
- **仅使用免费数据。**不提供基于流量追踪的消耗核算;碳排放预测仅表示相对趋势,而非绝对值。
路线图:数据格式 / 引擎效率建议、次国家级电网区域、CI/CD 集成。
参见 docs/user-questions-backlog.md。
MCP 工具
共 15 个工具,按使用目的分组。
选择区域
| 工具 | 功能 |
|---|---|
compare_regions_tri_axis | 按碳排放对候选区域排序,并权衡成本和延迟;推荐一个选择,各指标以 R/Y/G 评级。传入 regions,即可只对你实际考虑的区域排序。 |
greener_alternative_to | “你选择了 X——在延迟增加不超过 +N ms 的条件下,最绿色的区域是 Y(碳排放 −Z%,成本 Δ)。”这是核心提示。 |
region_carbon_now | 查询某区域当前的 gCO₂/kWh,并显示来源、时间戳和数据新鲜度。 |
安排任务时间(调度)
| 工具 | 功能 |
|---|---|
cleanest_hours_to_run | 找出近期最清洁的时段,用于安排可延后的任务(ETL、备份、训练),并给出减排百分比。传入 window_hours,指定已知任务时长,即可找出最清洁的连续时段及其开始时间。 |
cleanest_time_of_day | 对于周期性任务(如每晚运行的批处理):根据近期多个日期的平均值,找出该区域一天中最清洁的时段。反映每日规律,不是 7 天的每周规律。 |
carbon_forecast | 前瞻预测:根据欧盟次日风能 + 太阳能预测(ENTSO-E),找出即将到来的最清洁时段。提供相对排序;美国 / 未覆盖区域会退回到近期历史规律。 |
估算工作负载的碳排放
| 工具 | 功能 |
|---|---|
estimate_workload_carbon | 估算某个区域中工作负载每月的 CO₂ 千克数(这是估算值,不是测量值)。 |
estimate_training_carbon | 估算 GPU 训练运行的碳排放(基于 TDP 的能耗 × 实时电网数据),并提供更绿色的地点(区域排名)和时间(最清洁时段)——这两个因素叠加后,可优化可移植且可延期的训练任务。 |
estimate_inference_carbon | 按模型规模类别 × 输出 token 数 × 请求数(× 实时电网数据),估算 LLM 推理工作负载的能耗和 CO₂ 排放。结果为低至高的范围;缩小规模类别是最有效的杠杆。适合自托管;并非针对具体模型的排行榜。 |
效率与防护措施
| 工具 | 功能 |
|---|---|
greener_instance_family | 通过每瓦性能指标,在同一区域中找到更绿色的同等规模实例系列(更新一代或 ARM Graviton 级别的实例可用更少能耗完成相同工作)。 |
rightsizing_check | 调整实例规模(FinOps 最有效的优化手段),并提供对应的碳排放数据:如果配置过度,缩小规模可同时降低成本和碳排放 → 给出适当规模的目标配置,以及每月节省的美元和 CO₂ 千克数。 |
data_locality_egress_check | 当计算任务远离数据所在位置可能适得其反时发出警告:提供方向性的出站流量费用和粗略的传输碳排放数据,并判断迁移到更绿色区域是否仍有净收益。 |
serving_pattern_advice | 面向用户的平台:应从一个区域还是多个区域提供服务?综合考量按流量加权的延迟和碳排放,以及多区域数据同步的出站流量费用和跨司法辖区的数据驻留问题。 |
测量与理解
| 工具 | 功能 |
|---|---|
carbon_metric_scaffold | 生成可粘贴的 Python 埋点代码,让应用随时间报告自身的估算碳排放——可观测代理指标 × GreenPick 的功耗模型 × 实时电网数据。用于自行跟踪,结果仅供参考;不是运行时计量器。 |
explain_methodology_and_limits | 说明所用假设,以及 GreenPick 明确不作出的承诺。 |
数据来源(免费;可通过统一接口替换)
- EIA-930(美国平衡主管机构)和 ENTSO-E(欧盟区域)——实时电网碳排放数据,
按区域自动路由。两者也会根据近期每小时历史数据,提供
cleanest_hours_to_run。 - Mock——确定性离线默认数据;会清楚标记为
quality: "mock",避免被误认为真实读数。缺少密钥或区域不在覆盖范围内时使用。 - 成本:使用带日期的静态定价表(
data/pricing.json),通过scripts/refresh_pricing.py从 Vantage 实时价格更新,并对三家云服务商采用统一的匹配方法。 - 实例系列效率:方向性的每瓦性能乘数(
data/instance_families.json)。 - 延迟:根据区域坐标与用户位置之间的大圆距离估算。
在 .env 中设置 EIA_API_KEY 和 ENTSOE_TOKEN(均免费)以获取实时碳排放数据;GREENPICK_CARBON_SOURCE
用于选择数据源(auto 会将美国请求路由至 EIA、欧盟请求路由至 ENTSO-E,其余使用 mock)。
数据层采用可替换的仓库模式(默认使用 MOCK,支持离线运行)。这里不会凭空编造数字:LLM 负责撰写理由说明,代码负责提供数值。
明确的局限性(已内置于工具中)
数据仅供参考,未经审计。区域到电网分区的映射为近似值。碳排放数据是某一时点的数据,并非按流量追踪的实际消耗。成本仅为大致估算,不是报价。延迟为地理距离估算。“更绿色”假设电网碳强度占主导因素,不考虑隐含碳、硬件碳和服务提供商的可再生能源证书。
快速开始
# Python 3.11+
pip install greenpick          # from PyPI
python -m greenpick            # run the MCP server (stdio)
也可以从源码安装,用于开发(可编辑安装 + 测试):
git clone https://github.com/bithug01/greenpick.git
cd greenpick
pip install -e ".[dev]"
cp .env.example .env            # defaults to mock data — works offline
python -m greenpick             # run the MCP server (stdio)
pytest                          # run tests
要将其连接到 MCP 客户端(例如 Kiro / Claude Code / Cursor),请将客户端指向此目录下的
python -m greenpick。如需切换数据源,请参阅 .env.example。
常见问题
我需要 API 密钥吗? 不需要——GreenPick 开箱即用,并运行明确标注的模拟数据。若要获取实时碳数据,请在 .env 中设置两个免费的密钥(美国使用 EIA_API_KEY,欧盟使用 ENTSOE_TOKEN),并设置 GREENPICK_CARBON_SOURCE=auto。没有这些密钥也能正常运行;只是会显示 quality: "mock"。
为什么是“趋势性”数据,而不是经过审计的数据? 因为它用于设计阶段的决策,而不是合规报告。“斯德哥尔摩比悉尼清洁约 30 倍”足以让你在几秒内选定区域——而认证数据属于另一项工作,需要使用其他工具(Electricity Maps、WattTime)。GreenPick 用于决策,而非披露,并且每个工具的限制说明中都会明确这一点。
我的云服务商说该区域已经 100% 使用可再生能源——那区域真的重要吗? 这是基于市场的核算方式(服务商按年通过可再生能源证书/PPA 匹配用量)。GreenPick 使用基于位置的核算方式——也就是你实际取电的电网在每个时段的碳强度。这两种方式都合理(GHG Protocol 要求同时采用两者),回答的是不同问题:基于市场的核算关注采购声明;基于位置的核算关注你的工作负载此刻实际依赖的电网。GreenPick 有意采用基于位置的核算,因为这才是部署位置/时间选择真正会影响的因素——你无法改变服务商年度 REC 组合,但可以选择更清洁的电网或时段。我们有意忽略 REC,并非疏忽。
没有实时数据的区域会怎样? 系统会回退到近期历史模式或模拟数据,并标明所用数据类型——绝不会把回退数据显示为实时读数。若没有日前数据源(例如美国),预测也会回退到历史数据,并明确标注。
它能按碳排放对 Claude、GPT 和 Llama 排名吗? 不能,这是有意为之。estimate_inference_carbon 按模型大小类别(便于自托管)工作,而不是生成指定模型的排行榜——供应商不会披露足以支持此类可靠排名的服务细节。
我该怎么向它提问? 你不需要直接调用工具——只需用自然语言与 MCP 客户端对话(“哪里是运行这个任务最绿色的区域?”),客户端就会调用相应工具。请参阅演示,了解哪些问题会触发各项工具。
贡献
欢迎以任何形式贡献——提交错误报告、修正数据源、完善说明,或贡献代码。简要说明请参阅 CONTRIBUTING.md。GreenPick 唯一的要求是:保持诚实且只提供趋势性判断——不编造数字,不提供数据无法支撑的精确度(这正是整个项目坚持的原则)。
许可证
MIT——请参阅 LICENSE。© 2026 Data Science Advisers, LLC.
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。