关于 calibre-mcp
calibre-mcp 将 MCP 客户端连接到 Calibre 电子书库,支持搜索、阅读和元数据整理。它结合语义与关键词检索,并通过显式启用和操作确认保护写入功能。
主要功能
- 01语义与关键词混合搜索
- 02搜索全库或指定书籍
- 03读取段落与插图
- 04审计和整理元数据
- 05需启用并确认的写入操作
适用场景
- 01在电子书库中查找相关段落
- 02按概念而非书名定位章节
- 03识别重复书籍并修复元数据
- 04谨慎执行批量元数据修改
MCP 相关
该服务向 MCP 客户端提供 19 种工具,用于搜索、阅读、浏览和整理 Calibre 书库。写入工具默认关闭,须显式启用相关开关。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y calibre-mcpCALIBRE_MCP_SERVER_URLCalibre Content Server base URL (default http://localhost:8080)CALIBRE_MCP_LIBRARYLibrary name; empty = auto-detect the server's default libraryCALIBRE_MCP_ENABLE_WRITESet to 1 to enable the write tools (update/bulk-update/add/remove); off by defaultCALIBRE_MCP_CALIBREDB_PATHPath to the calibredb binary; empty = auto-discover the standard install location本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
14收录的工具列表 · 更新于 1 天前
此工具无需参数。
详细介绍
📚 calibre-mcp




现有最强大的 Calibre MCP 服务 —— 将 Claude(或任何 MCP 客户端) 连接到你的 Calibre 电子书库,按含义而非 仅按关键词搜索。
向你的 AI 助手提问*“我的哪些书讲解了消费者组再平衡?”*,即可获取 准确的章节——无论是从 800 多本书中搜索,还是只在一本书中搜索。通过自然语言整理元数据、去重并安全编辑 你的书库。
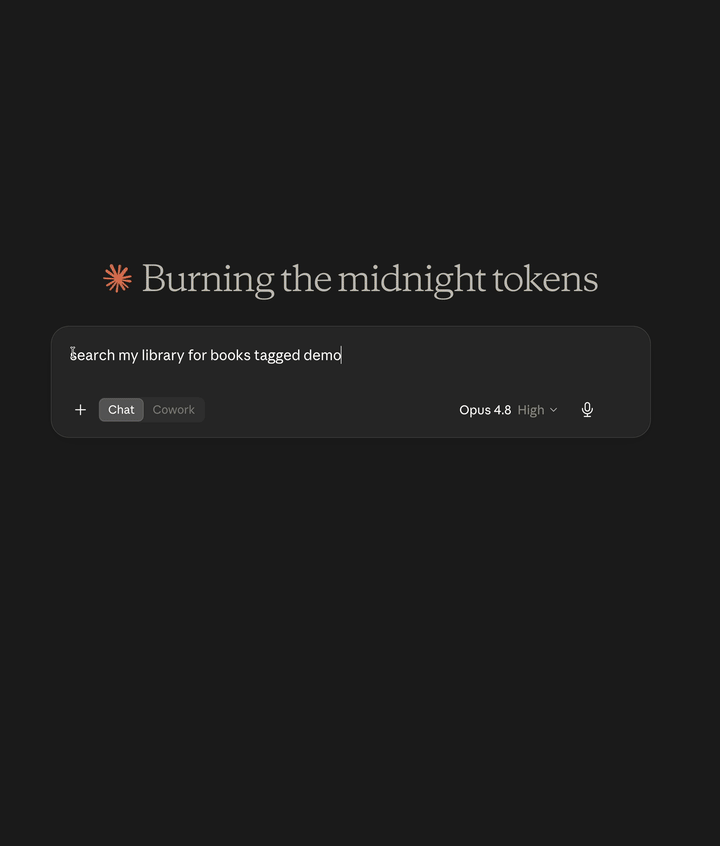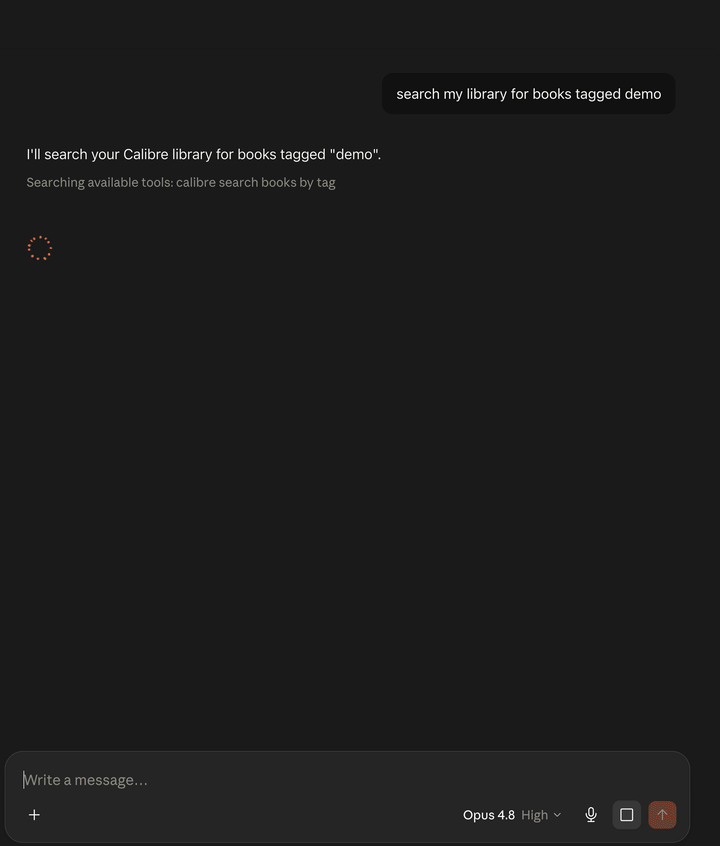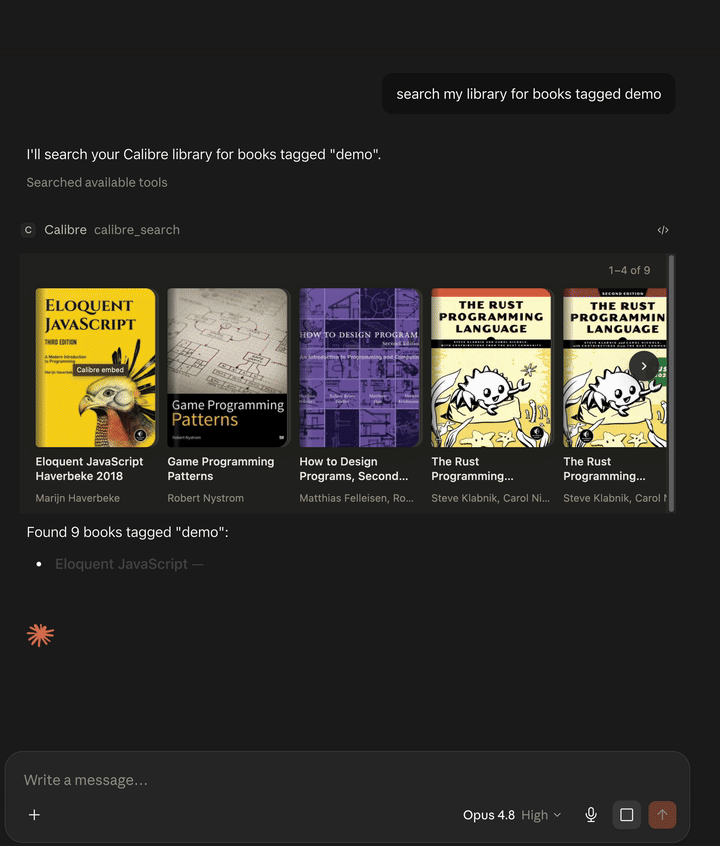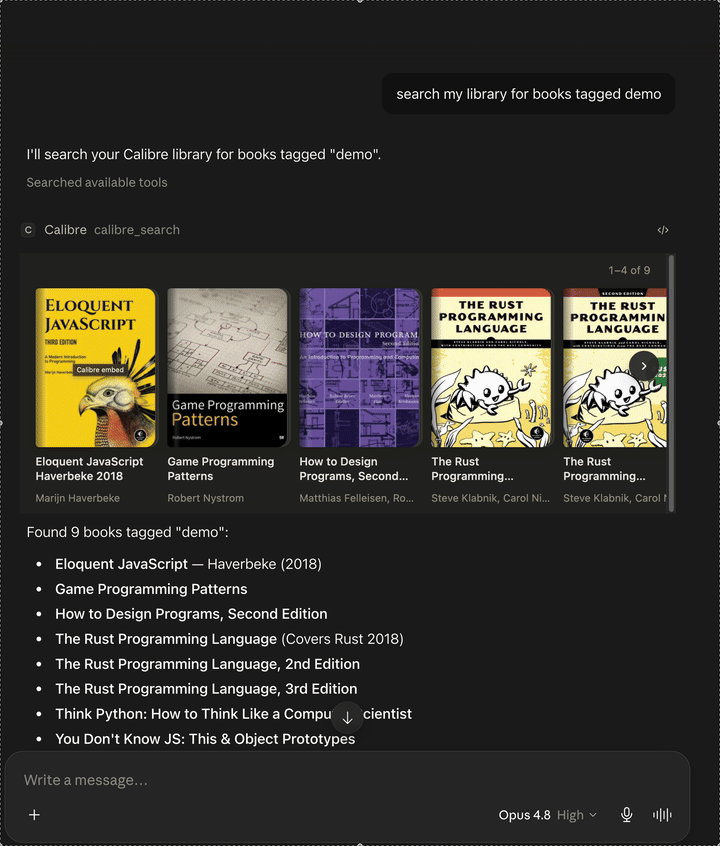
一个问题 → 语义搜索 → 3D 封面流 → 图书卡片 → 准确段落 → 图表查看器,全部在 Claude Desktop(MCP Apps)中完成
✨ 亮点
- 19 种工具,涵盖完整功能:搜索、阅读内容、浏览分类、整理书库,以及(选择启用后)写入——更新元数据、批量编辑、合并重复项、导入、删除和管理合集(命名的主题筛选器)。
- 语义搜索——基于含义的混合向量 + 关键词检索,可搜索整个书库,也可在单本书中搜索。支持多语言(已验证英语和俄语,也支持跨语言查询)。其他 Calibre MCP 服务均不具备此功能。
- 聊天内 UI(MCP Apps)——在支持 MCP Apps 的宿主(Claude Desktop)中,书库搜索会呈现交互式封面轮播;
calibre_get_book会显示包含封面、评分和阅读/相似操作的图书详情卡片;calibre_get_figures会显示图表查看器,展示助手获取的相同图表。纯文本宿主不受影响。 - 整理工具——通过合并安全评分查找重复项、审计元数据质量,并通过 Open Library / Google Books 为文件名为原始名称的书籍恢复真实元数据(
795731065.pdf→ Fundamentals of Software Engineering)。 - 默认安全——除非明确启用写入,否则仅限读取;破坏性操作会先预览并要求确认;所有写入操作都通过 Content Server 执行,因此不会与 Calibre GUI 发生竞争。
📋 要求
- Calibre,并且Content Server 正在运行(在 Calibre 中选择:连接/共享 → 启动 Content Server)。已在 Calibre 9.x 上测试;近期版本应该都能正常使用。
- 使用 npm/npx 安装需要 Node.js ≥ 22.16(Claude Desktop 一键安装包无需此项——Desktop 自带运行时)。
- 可选,为获得最佳 PDF 文本提取效果:poppler 的
pdftotext(brew install poppler)或安装了 PyMuPDF 的 Python 3(pip install pymupdf)。如果没有这些工具,服务会退回使用 Calibre 的ebook-convert。
🚀 快速开始
最简单的方式——让你的 Agent 为你安装
获取引导式安装技能,然后把整个任务交给你的 Agent:
npx skills@latest add caelum29/calibre-mcp # pick calibre-mcp-setup
然后告诉你的 Agent:“set up calibre-mcp”。calibre-mcp-setup 技能会处理以下所有事项——预检(Node、calibredb、Content Server)、Calibre 端配置、适用于你的客户端(macOS/Windows/Linux)的正确安装方式,以及 calibre_ping 验证——只会询问需要你回答的问题(使用哪个客户端、是否启用写入)。适用于任何兼容 Agent-Skills 的运行环境(Claude Code、Copilot、Amp 等)。想手动操作?请选择下方的客户端。
Claude Code
仅安装 MCP 服务:
claude mcp add calibre -- npx -y calibre-mcp
也可以安装插件——一步安装服务和配套技能,安装时可通过设置对话框配置(服务 URL、书库、写入权限):
/plugin marketplace add caelum29/calibre-mcp
/plugin install calibre-mcp@caelum29
Claude Desktop(一键安装)
从最新版本下载 .mcpb 包并打开——Claude Desktop 会安装该包并提示你设置配置(服务 URL、书库、是否启用写入)。无需使用终端。
关于安装警告。 Claude Desktop 会对每个从文件而非内置目录安装的扩展显示 “安装将授予此扩展访问你电脑上所有内容的权限……Anthropic 尚未验证开发者信息”——这并非该扩展独有。服务会以你的用户账户运行在本地 Node 进程中,与下方的
npx安装方式完全相同;该包由 CI 从此代码库构建并发布,因此你可以审查正在运行的内容。点击安装以继续。
为保持轻量,该包不包含可选的嵌入依赖,因此两个语义搜索工具会报告自身不可用。元数据和全文搜索均可正常使用。如需语义搜索,请改用下方的 npx 安装方式。
Claude Desktop(JSON 配置)
添加到 claude_desktop_config.json:
{
  "mcpServers": {
    "calibre": {
      "command": "npx",
      "args": ["-y", "calibre-mcp"]
    }
  }
}
Cowork
在 Claude Desktop 中配置服务(使用上述任一种方式)——Desktop 会自动将本地 MCP 服务桥接到 Cowork。无需额外设置。
仅安装技能——适用于任何 Agent(Claude Code、Codex、Cursor 等)
代码库中的 Agent Skills——引导式安装器(calibre-mcp-setup)、calibre-mcp 使用指南以及两个 distill 技能——可通过 skills.sh 安装器安装到任何兼容 Agent-Skills 的运行环境中:
npx skills@latest add caelum29/calibre-mcp
通过交互方式选择技能和目标 Agent。两种理念与 mattpocock/skills 相同:skills.sh 会将文件复制到你的环境中,方便你修改;而上方的 Claude Code 插件会将它们作为受管理且自动更新的套件。无论选择哪种方式,这些技能都会调用此 MCP 服务的工具,因此也请安装该服务——或者让 calibre-mcp-setup 技能代劳:它会引导任何 Agent 完成预检、针对各客户端的安装(macOS/Windows/Linux)以及验证。
初次体验——五条提示词之旅
服务会自动检测你的默认书库;如果无法访问 Content Server, 则会在 stderr 中记录一条可执行的提示。然后按顺序尝试:
- “列出我的 calibre 书库”——检查连接是否正常。
- “查找关于 Rust 的书籍”——搜索元数据;在 Claude Desktop 中,结果会显示为上方的封面轮播。
- “给我看看《The Rust Programming Language》”——查看完整元数据;显示为书籍卡片,包含封面、评分和各格式的阅读按钮。
- “给我看看《JWT Handbook》中的图 2.3”——该图会作为图像提供给助手;在 Claude Desktop 中,还会显示在可缩放和平移的图片查看器中。如果第一次的描述与你看到的内容不符,可以问 “看看这张图片——它实际展示了什么?”:模型有时会在读取像素之前,凭记忆回答有关图片的问题(工具结果会提示模型查看图片;请参阅故障排除)。
- “为我的 Kafka 书籍构建语义索引”——为基于含义的搜索进行一次性准备(见下文)。
- “我的哪些书籍讲解了消费者组再平衡?”——执行语义搜索;返回按相关性排序的书籍,或在限定到一本书时返回具体段落。
额外提示:*“我的书库有什么问题?”*会运行质量审核(检查缺失的元数据、原始文件名作为标题、无效的 ISBN)。
✍️ 启用写入
写入工具(calibre_update_book、calibre_bulk_update、calibre_add_book、
calibre_remove_book、calibre_merge_books、calibre_manage_bundles)默认隐藏——
包括 calibre_manage_bundles 的只读 list 操作,因为开关针对的是工具,而非操作。必须启用两个相互独立的开关:
-
MCP 端开关——设置
CALIBRE_MCP_ENABLE_WRITE=1(或在桌面应用的捆绑包设置中勾选 启用写入)。未启用此开关时,写入工具甚至不会注册。 -
Calibre 端开关——Content Server 必须允许本地写入。默认情况下,嵌入在 Calibre GUI 中的服务为只读,因此需要启用下方的 GUI 选项,或使用
--enable-local-write运行独立服务:# quit the Calibre GUI first (it holds the library lock), then: calibre-server --enable-local-write --port 8080 "/path/to/Calibre Library"或者,无需退出应用即可为嵌入 GUI 的服务启用此功能:打开 Calibre → 首选项 → 通过网络共享 → 高级,勾选 “允许未经身份验证的本地连接修改书库” (即允许本地写入访问),然后从 GUI 重启 Content Server。 这相当于为嵌入式服务设置
--enable-local-write。
仅启用第一个开关时,写入工具会显示,但 Calibre 会拒绝写入—— 错误消息会明确说明这一点。对嵌入 GUI 的服务进行读取不受影响。
安全行为:calibre_bulk_update 要求明确选择书籍(ids 或
query——默认不会选择“所有书籍”),并会预览更改,直到你传入
preview: false。calibre_remove_book 在传入 confirm: true 之前只会执行试运行;
删除会永久移除记录和文件。calibre_merge_books 在传入 confirm: true 之前会显示完整的
合并计划;被移入废纸篓的源书籍仍可从 Calibre 的废纸篓中恢复(safe 模式会完整保留它们)。calibre_add_book 只会从列入白名单的文件夹导入文件(CALIBRE_MCP_ADD_ROOTS)。
🔎 语义搜索
深入了解:
docs/SEMANTIC-SEARCH.md— 索引、混合检索和重排序的工作原理。
基于含义的搜索需选择启用,并且需要满足以下两项:
- 嵌入依赖项 —
@huggingface/transformers是一个optionalDependencies条目,因此普通的npx calibre-mcp/npm install会自动安装它。 (只有 MCPB 捆绑包不包含它。) - 索引 — 请 Claude 对你关注的书籍运行
calibre_build_index(通过 ID 或 Calibre 查询指定)。 首次构建时会将嵌入模型(multilingual-e5-small,约 118 MB,一次性下载)下载到索引目录;之后所有操作都可离线运行。在 Apple Silicon 上,索引速度约为每秒 100 个文本块。
重要
搜索结果会由交叉编码器重排序模型进一步优化,该模型需单独下载,大小约 576 MB,且只需下载一次。
calibre_build_index会在构建期间预先下载它——这一步本来就需要等待。如果你跳过这一步,直接在尚未缓存该模型的设备上搜索,那么首次混合/向量搜索会触发下载。重排序也会让每次语义搜索额外消耗数秒 CPU 时间;设置CALIBRE_MCP_RERANK=off可将其禁用(速度更快,但排序精度会明显降低)。
之后,calibre_semantic_search 就能回答诸如*“我的哪些书介绍了消费者组再平衡?”*之类的问题——可搜索整个藏书(scope: library,按书籍排序),也可在一本书内搜索(scope: book,返回带位置的段落)。默认使用混合检索:向量余弦相似度 + 词干化关键词 FTS,通过倒数排名融合进行合并,然后在交叉编码器模型可用时对排名靠前的 30 个候选项进行重排序。使用一种语言提出的查询也能找到另一种语言的段落(已验证 EN⇄RU)。
没有嵌入模型?关键词搜索仍可用。 mode: keyword 在查询时不使用模型,但需要索引。如果未安装嵌入模型(默认的 MCPB 捆绑包不包含它),请构建一个仅含关键词的索引——使用 keywordOnly: true 运行 calibre_build_index;或者在模型不存在时,系统会自动构建此类索引——然后使用 mode: keyword 搜索。此路径完全不依赖机器学习。此时,mode: vector 会给出可据以采取行动的错误提示,而 mode: hybrid 会降级为关键词搜索(并附带说明);安装模型后重新构建索引(force: true),即可加入语义排序。
🧰 工具
包含参数和示例的完整参考:
docs/TOOLS.md。
| 工具 | 访问权限 | 功能 |
|---|---|---|
calibre_search | 读取 | 按书名、作者、ISBN、标签或 Calibre 查询语法(mode: meta)查找图书,或进行全文搜索(mode: fts);scope: book 用于搜索单本书;filter 用于限定到某个合集 |
calibre_get_book | 读取 | 获取单本书(按 id 或 uuid)的完整元数据、格式和封面链接;include_cover: true 会在结果中嵌入封面图片 |
calibre_get_content | 读取 | 以长度受限的摘录形式读取图书文本;通过游标遍历全书。structure: true 会返回章节映射(标题、偏移量、各章节游标)——EN + RU/UK |
calibre_get_figures* | 读取 | 列出图书中的插图及其说明和页码位置;获取的插图会在聊天内的插图查看器中显示 |
calibre_list_categories | 读取 | 浏览标签、作者、丛书、出版商和自定义列及其计数 |
calibre_list_libraries | 读取 | 列出 Content Server 公开的图书馆(以及默认图书馆) |
calibre_semantic_search | 读取 | 基于含义的搜索;mode: hybrid|vector|keyword,可限定到图书馆或单本书;filter 用于限定到某个合集 |
calibre_build_index | 读取* | 为选定的图书构建/刷新本地语义索引(仅写入本地索引文件);keywordOnly: true 会构建无需模型的关键词索引 |
calibre_find_duplicates | 读取 | 返回重复项分组及合并安全评分;mode: compare 会比较两本书的差异 |
calibre_quality_report | 读取 | 审查缺失的元数据、原始文件名形式的书名、无效 ISBN、作者排序问题和丛书缺漏 |
calibre_recover_metadata | 读取 | 通过 Open Library → Google Books 提议真实元数据;仅供预览,使用 calibre_update_book 应用 |
calibre_extract_isbn | 写入 | 扫描图书正文以查找有效 ISBN,并将其设为 isbn 标识符;先预览,再通过 apply: true 应用 |
calibre_update_book | 写入 | 为单本书设置元数据字段(包括 #custom 列);返回已应用的差异 |
calibre_bulk_update | 写入 | 对一组图书应用相同更改;必须指定选择范围,先预览 |
calibre_add_book | 写入 | 导入本地电子书文件(路径需在白名单内) |
calibre_remove_book | 写入,有破坏性 | 永久删除图书(记录和文件);除非确认,否则仅试运行 |
calibre_merge_books | 写入,有破坏性 | 合并重复记录:将格式移至目标图书、按 Calibre 的规则合并元数据,并将源记录移入回收站;除非确认,否则仅显示试运行计划 |
calibre_manage_bundles | 写入 | 列出/创建/更新/删除合集(Bundle)——由 Calibre 保存的搜索提供支持的命名主题过滤器;名称以 - 开头的合集会自动在发现搜索中隐藏其中的图书;先预览 |
calibre_ping | 读取 | 健康检查:确认 Calibre 是否端到端可访问 |
* 插图会以真实图片的形式呈现给助手,但模型有时会在查看插图前凭记忆描述它——如果首次描述与图片不符,请再次询问:“看看这张图片——它实际展示了什么?”(详情见故障排除)。
在 MCP Apps 宿主中,calibre_search 和 calibre_semantic_search(图书馆范围)的结果会以封面墙轮播形式呈现,calibre_get_book 会呈现为图书卡片,calibre_get_figures 则会呈现为插图查看器(阅读窗格 + 边栏栏位,点击即可放大到 100%),让你看到助手正在阅读的图表——封面从本地 Content Server 加载。在其他所有环境中,这些工具都会返回常规文本结果;两种方式都无需配置。
📚 配套技能:calibre-distill
一款 Agent Skill,可通过调用上述工具,将书库中的书籍提炼成可重复使用的结构化技能
(框架、思维模型、术语表、速查表)——包括章节
映射(calibre_get_content structure=true)以及书内关键词和语义搜索。支持 EN 和 RU/UK 书籍,无需临时文件;还可选择通过受门控的写入工具,将所学内容写回目录(标签 + 提炼笔记)。
该技能随此仓库一同提供,位于 skills/calibre-distill/。可通过
npx skills@latest add caelum29/calibre-mcp 或 Claude Code 插件安装(参见
快速开始),也可以手动创建符号链接:
ln -s "$PWD/skills/calibre-distill" ~/.claude/skills/calibre-distill
然后提出请求,例如:“将书籍 187 提炼成名为 kafka-ops 的技能”。注意:MCPB 安装包 无法包含技能——在 Claude Desktop 上需单独安装技能,且与 MCP 服务分开安装。
配套技能:calibre-distill-topic
一个同系列技能,可将多本书(≥3)中关于同一主题的内容综合成单个
以概念为键的技能——包含决策框架、按概念划分的章节、跨来源配置
表、明确的*“来源之间存在分歧或互补之处”*章节,以及可用作实时来源绑定的 ISBN
参考书目。若想基于一组书籍而非单本书构建主题学习辅助材料,请使用此技能(单本书提炼请使用
calibre-distill)。该技能位于 skills/calibre-distill-topic/;
可通过与上述相同的 skills.sh / 插件 / 符号链接方式安装。
然后提出请求,例如:“将书籍 187 182 571 186 中有关 kafka 可靠性的内容综合成一项技能。”
可使用随附的验证器检查生成的技能——逐字重合度(相对于源书籍的 8-gram 分片)、引文预算、压缩下限、标题映射、游标泄漏和归属信息:
pnpm build && node scripts/legal-gate.mjs <skill-dir> --book <id> [--book <id>…]
⚙️ 配置
所有配置均为可选——只要 Content Server 正在默认端口运行,无需任何配置即可使用。环境变量(桌面 安装包以 UI 字段形式提供相同设置):
| 变量 | 默认值 | 用途 |
|---|---|---|
CALIBRE_MCP_SERVER_URL | http://localhost:8080 | Calibre Content Server 基础 URL |
CALIBRE_MCP_LIBRARY | 自动检测 | 书库名称;留空 = 服务器的默认书库 |
CALIBRE_MCP_ENABLE_WRITE | off | 写入总开关(1/true/yes) |
CALIBRE_MCP_CALIBREDB_PATH | 自动发现 | calibredb 二进制文件;先通过标准安装路径查找,再通过 PATH 查找 |
CALIBRE_MCP_INDEX_DIR | 平台数据目录¹ | 语义索引 + 嵌入模型缓存 |
CALIBRE_MCP_SEMANTIC_FLOOR | 0.78 | 语义结果被标记为低置信度的余弦得分下限 |
CALIBRE_MCP_RERANK | on | 语义搜索中启用交叉编码器重排阶段(模型约 576 MB,每次查询需消耗数秒 CPU 时间);设为 off/false/0 可禁用 |
CALIBRE_MCP_MAX_BOOK_BYTES | 268435456(256 MB) | calibre_build_index / calibre_get_content 可提取的最大书籍下载大小;更大的书籍将被跳过² |
CALIBRE_MCP_INDEX_BUSY_TIMEOUT_MS | 5000 | 索引写入等待另一个服务器进程释放索引的时长(例如 Claude Desktop 和 Claude Code 同时运行);超时后失败 |
CALIBRE_MCP_ADD_ROOTS | ~/Documents、~/Downloads | calibre_add_book 可从中导入书籍的文件夹(以路径分隔符分隔) |
CALIBRE_MCP_BOARD_STYLE | shelf | MCP Apps 宿主中的搜索结果小部件样式:shelf(可滚动的封面书架)或 coverflow(3D 封面流;桌面安装包将其显示为 Coverflow 搜索结果切换项) |
¹ macOS:~/Library/Application Support/calibre-mcp/index;Windows:
%APPDATA%\calibre-mcp\index;Linux:$XDG_DATA_HOME/calibre-mcp/index。
² 设置大小上限时,应以 Content Server 提供的文件大小为准,而非磁盘上的文件大小——服务器返回的副本可能大得多(例如,8 MB 的 PDF 可能会以 70 MB 的大小提供),因此按磁盘文件大小设置上限会导致书籍被悄然跳过。
🩺 故障排查
更多症状和解决方法:
docs/TROUBLESHOOTING.md。
- “Calibre 无法访问”/连接被拒绝 — Content Server 未运行。
在 Calibre 中选择 连接/共享 → 启动 Content Server,或将
CALIBRE_MCP_SERVER_URL指向正确的主机和端口。 - 写入被拒绝/“Forbidden” — Content Server 不允许本地写入。
请参阅上文的 启用写入:运行独立服务并添加
--enable-local-write,或者勾选 GUI 中的 通过网络共享 → 高级 选项, 然后重启 Content Server。 - 全文搜索没有结果/报错 — 未为该书库启用 Calibre 的 FTS 索引。在 Calibre 中选择 首选项 → 搜索 → 全文搜索,启用该功能,并 等待索引完成(大型书库可能需要一些时间)。
- “embedding model unavailable” — 未安装可选的
@huggingface/transformers软件包 (MCPB bundle 中未安装是正常的)。请使用 npx 安装,或在服务旁运行npm install @huggingface/transformers。若要在没有该软件包的情况下搜索,请构建 仅关键词索引(calibre_build_index keywordOnly=true),并使用mode: keyword。 - 找不到
calibredb— 安装 Calibre,或将CALIBRE_MCP_CALIBREDB_PATH设置为 该二进制文件的路径(macOS:/Applications/calibre.app/Contents/MacOS/calibredb)。 - PDF 提取出的文本为空 — 这是扫描版/图像 PDF;Calibre 没有 OCR 功能,我们也没有。
- 找不到书库(404) — 传入
calibre_list_libraries显示的书库显示名称或ID;不确定时, 请不要设置书库,让服务使用默认书库。
🛠️ 开发
pnpm install
pnpm build        # tsc → dist/
pnpm test         # vitest (unit; no network, no model download)
pnpm test:model   # gated embedding-model integration tests (~118 MB download)
pnpm inspect      # MCP Inspector against the built server
pnpm pack:mcpb    # build the Claude Desktop .mcpb bundle
代码库采用整洁架构:工具处理器、Calibre 客户端和语义核心均不依赖 SDK;只有 src/server.ts 会用到 MCP SDK。面向用户的文档——工具
参考和语义搜索指南——位于 docs/。
欢迎在 讨论区中提出问题、想法和使用方案;错误报告和 PR 请提交至 Issues。
📄 许可证
MIT © 2026 Artem Sorochynskyi
这是一个独立项目,与 Calibre 无关联。
Calibre 本身是
Kovid Goyal 的开源项目(GPLv3)——
此服务通过 calibredb 和 Content Server 驱动 Calibre,将其作为独立程序运行。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。