关于 searchts
searchts 是面向 AI Agent 的开源网页读取工具,可将网页提取为 Markdown,并在无法访问时明确说明。它结合分级解锁、搜索、分享对话解码、资源抓取和视频转录。
主要功能
- 01分级访问受阻及 JavaScript 网页
- 02解码八个平台的分享对话
- 03免密钥网页搜索
- 04提取并下载网页资源
- 05转录支持的视频内容
- 06清理提示词注入迹象
适用场景
- 01读取内置抓取无法访问的网页
- 02获取完整的 AI 对话分享内容
- 03搜索网页并打开结果页面
- 04收集网站图片、字体和 SVG
- 05转录没有字幕的视频
MCP 相关
它可作为 MCP 服务运行,向 MCP 客户端提供网页读取及相关能力。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
9收录的工具列表 · 更新于 3 天前
此工具无需参数。
详细介绍
searchts
为 AI Agent 解锁网页并读取内容,无需密钥。 (私下说,就是“搜索这玩意儿”。)
它会读取网页;如果做不到,就会明确告诉你的 Agent。
当 Claude、Cursor、Codex 或其他 Agent 获取 URL 时,返回的内容经常是一团糟:403 机器人拦截页、空白的 JavaScript 外壳、被截断的 AI 聊天分享链接,或者登录页面——模型却会若无其事地把它总结成文章。searchts 是你的 Agent 调用的网页阅读器。它是开源软件(MIT),免费、无需 API 密钥,默认拒绝使用付费住宅代理,并可作为 MCP 服务、命令行工具或 Python 库运行。




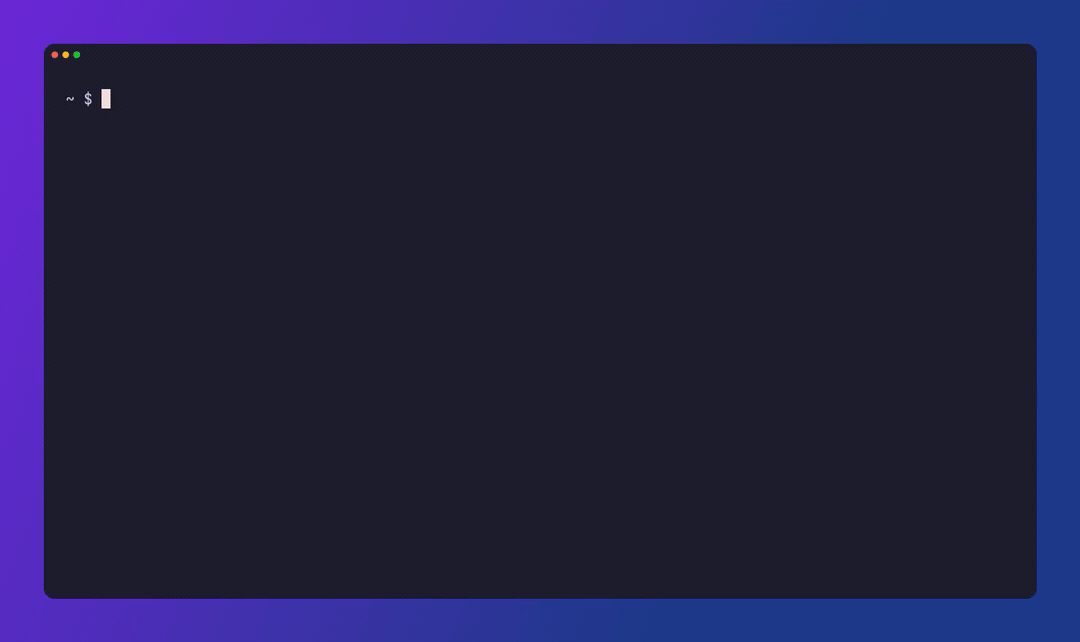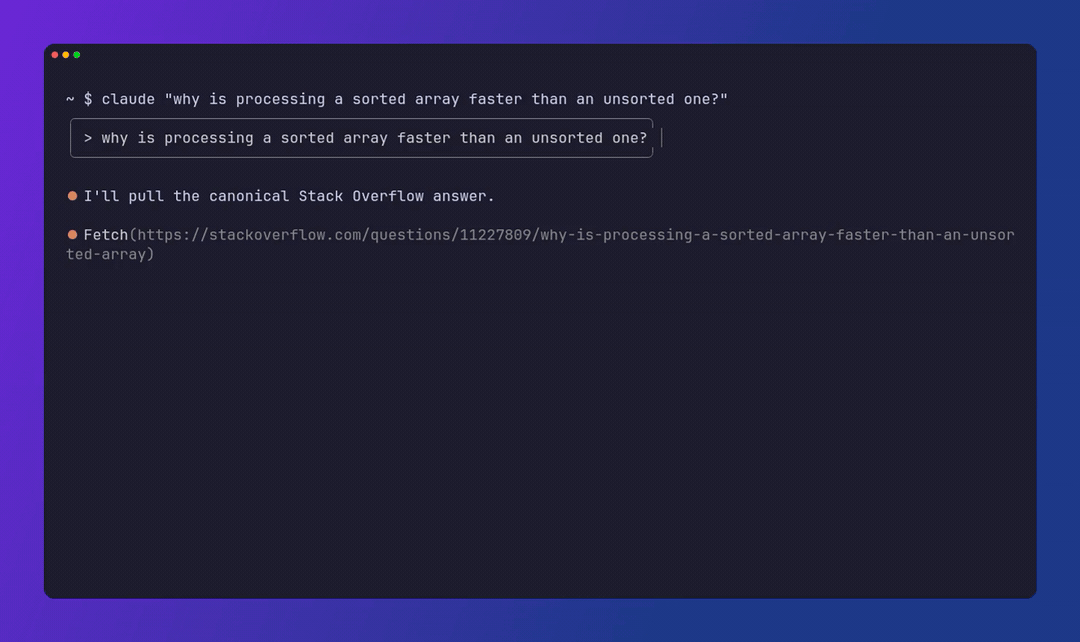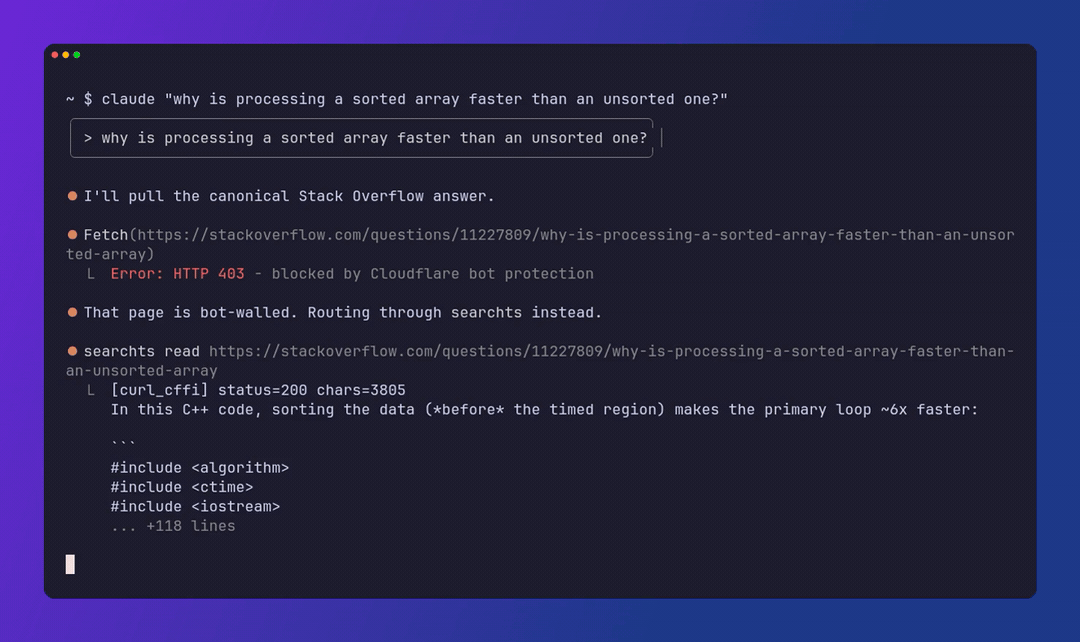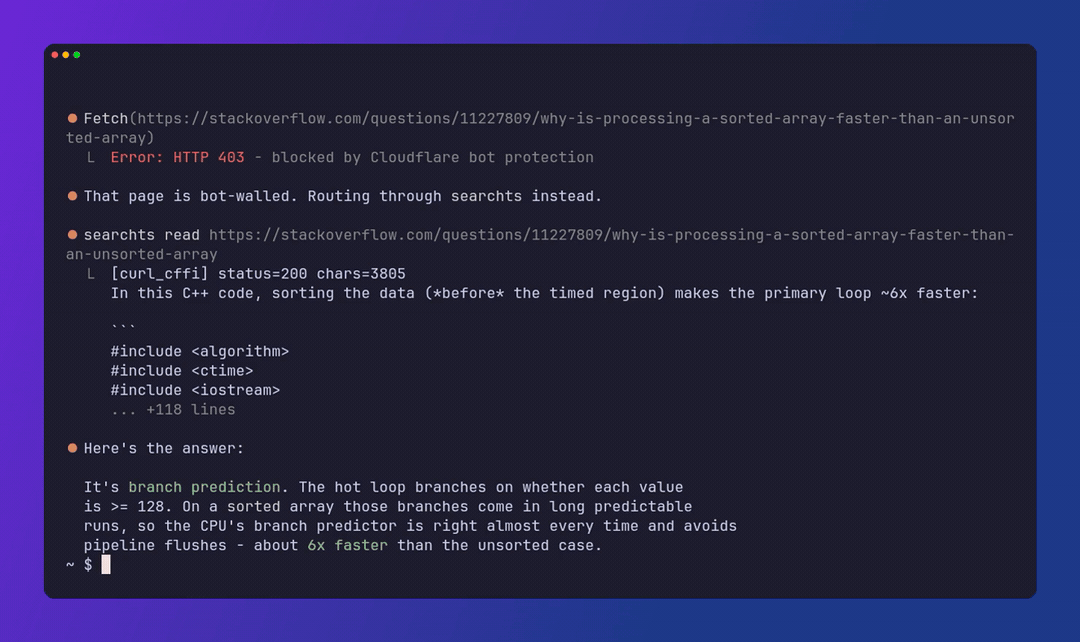
一行命令安装到 Agent
只需一条命令,即可将 searchts 添加到 Claude Code、Cursor 或任何 MCP 客户端。无需 API 密钥:
claude mcp add searchts -- uvx --from "searchts[mcp]" searchts mcp serve
若要全局安装并添加隐身浏览器(最难处理的关卡会用到),请使用:
pipx install "searchts[mcp]" && searchts install --browser
claude mcp add searchts -- searchts mcp serve
安装介绍了 uvx、pipx、venv 和浏览器扩展的用法。命令行工具、MCP 服务和 Python 库都调用同一条读取流程。
Agent 内置的网页获取功能做不到的三件事
1. 解码 ChatGPT、Claude、Gemini、Grok、Poe、DeepSeek、Perplexity 和 Copilot 的完整分享链接
分享的对话不会以纯文本形式出现在初始页面 HTML 中。直接获取只会得到 JavaScript 外壳;即使使用渲染器,也可能在对话中途截断。searchts read 能识别分享 URL,并将每个提供方自己的数据通道解码为完整、标注角色的 Markdown,无需密钥,也无需登录:
searchts read https://chatgpt.com/share/...        # turbo-stream payload in the page (no browser)
searchts read https://claude.ai/share/...          # keyless snapshot API behind Cloudflare (no browser)
searchts read https://gemini.google.com/share/...  # keyless batchexecute RPC (no browser)
searchts read https://chat.deepseek.com/share/...  # stealth render, auto-scrolls past list virtualization
支持八家提供方:ChatGPT(包括 /share/<uuid> 和较新的 /s/<prefix>_<id> 短链接)、Claude、Gemini、Grok、Poe、DeepSeek、Perplexity 和 Copilot。前五家无需浏览器。后三家会使用隐身层:滚动页面,直到页面高度不再变化,展开折叠内容,然后读取。
2. 突破机器人拦截;如果做不到,就明确报错,而不是对着登录页面胡编乱造
每次 searchts read 都会逐级尝试三层开源解锁器,并记住每个域名上哪一层成功:
curl_cffi会模拟真实 Chrome 的 TLS/JA3 和 HTTP/2 指纹。速度快、本地运行、保护隐私。- Jina Reader(
r.jina.ai)会在页面内容需要运行 JavaScript 才能显示时渲染页面。默认启用;设置SEARCHTS_NO_JINA=1可避免将 URL 发送到 Jina 的服务器。 patchright是按需启动的隐身 Chromium,只有在更简单的层级都失败后才会启动。--human会打开真实浏览器,以便由人手动通过页面验证。
searchts read https://some-js-heavy-or-fingerprinted-site.com --scrub
# Tier 1 (curl_cffi) -> 403 | Tier 2 (Jina) -> clean Markdown returned, injection scrubbed

searchts read https://www.linkedin.com/in/someone/
# Fails loudly: reports the exact tier and login-wall reason. stdout stays empty.
--scrub 会剥除不可见字符和双向文本字符,并在不可信文本到达模型之前标记提示词注入迹象。
你主动提供的登录凭据,与 searchts 自行猜测的登录凭据不同。在 0.15.0 中,本地凭据复用默认关闭,并限制为命令中指定的单个主机:--cookies-from-browser <browser> --yes、--cookies <path> 或 --cdp-port <port>。如果不使用其中任何一种方式,遇到拦截页时会报错,而不会把它当作文章。
3. 转录视频并抓取指纹验证的设计素材
searchts transcribe https://youtu.be/...                     # YouTube, TikTok, Instagram Reels, Reddit
searchts transcribe https://www.instagram.com/reel/... --cookies-from-browser chrome
searchts grab https://stripe.com --kinds images,fonts,svg --read --out ./stripe-kit
转录优先使用字幕;没有字幕时,则通过 yt-dlp 获取音频并使用 Whisper 转录。grab 会通过同一解锁器提取页面上的图片、图标、CSS、字体、SVG 和调色板,因此即使是有指纹验证的 CDN 也能处理,而不只是开放的 CDN。
原生网页搜索
内置抓取功能不会搜索。默认情况下,searchts search 使用无需密钥的 DuckDuckGo,并通过 SearXNG、Exa、Brave 和 Tavily 进行互惠排名融合。摘要不是网页内容。请阅读每个 URL。
searchts search "open source vector db"
存在的原因
我创建 searchts,是因为 Claude 在我让它替我阅读网页时总是碰壁。起因是一个 Devpost 黑客马拉松页面及其条款:页面甚至没有设限,但 Claude 仍然无法阅读。
最初几个版本是我和 Claude 一起构建的,却在另一个方面失败了。它们无法获取页面时,会把拿到的任何内容都交回来,Agent 就把加载页面总结成了文章。因此,searchts 有一条高于其他一切的规则:返回真实页面,否则就明确失败并说明原因。它绝不会向你的 Agent 提供虚假的读取结果。
searchts 对比
searchts 源自 Agent-Reach 的渠道/诊断脚手架,之后用逐级升级的解锁器、分享链接解码器和 MCP 服务替换了读取/搜索核心。
| 能力 | 内置 WebFetch / curl | Agent-Reach | 托管式抓取工具(Firecrawl、Jina Pro) | searchts |
|---|---|---|---|---|
| 架构 | 简单的 HTTP 抓取 | 用于第三方 CLI(yt-dlp、OpenCLI、Jina)的安装器和按平台路由器 | 托管式抓取与爬虫集群 | 本地逐级升级解锁器 + MCP 服务 + CLI |
| 机器人/JS 升级处理 | 无 | 一次 Jina Reader 网页请求 | 托管代理和渲染 | curl_cffi(TLS/JA3)→ Jina → patchright 隐身模式 + --human |
| 登录或拦截 | 将 200 OK 登录 HTML 交给模型,或报错 | 取决于上游 CLI 及其会话 | 额度、限制或不完整的 HTML | 明确失败并说明层级和原因;可选择复用本地登录 |
| AI 聊天分享链接 | 空的 JS 外壳或被截断的内容 | 没有分享链接解码器;依赖 Jina | 渲染器可能会截断长聊天内容 | 原生解码器 + 自动滚动的隐身渲染(8 个提供商) |
| 网页搜索 | 无 | 通过 mcporter 使用 Exa | 付费搜索端点 | 无需密钥的 DuckDuckGo + 跨 SearXNG / Exa / Brave / Tavily 的 RRF。摘要不是网页内容 |
| 提示词注入清理 | 无 | — | — | 内置(--scrub) |
| 基准测试 | 无 | 无 | 营销宣传的通过率 | 可复现的双套件评分卡(Smoke 与 Walled) |
| 默认费用 | 免费 | 免费,但需安装相应 CLI | API 密钥和按页计费额度 | 免费、MIT 许可、无需密钥(默认不使用付费住宅代理) |
功能
- 读取 Agent 自身的抓取功能无法读取的页面:浏览器指纹检查页面、仅含 JavaScript 的页面,以及部分机器人拦截页面
- 当读取结果不是真实页面时,明确失败(例如用户未提供登录信息的页面、需要人工解决的谜题,或作为地址本身的拦截页面),并说明失败的层级和原因
- 读取 ChatGPT / Claude / Gemini / Grok / Poe / DeepSeek / Perplexity / Copilot 的完整分享对话
- 兼容 Claude、Codex 和 MCP Agent
- 提取整洁的 Markdown,可直接提供给模型
- 当页面内容超过返回范围时(例如下一页、信息流或折叠文本),会明确提示,并重建搜索结果和提取器会破坏的内容
- 无需 API 密钥即可搜索网页(DuckDuckGo,以及 SearXNG、Exa、Brave 和 Tavily)。摘要不是网页内容
- 下载页面素材(图片、字体、调色板)
- 转录视频,优先使用字幕
- 列出页面中的图片、视频和嵌入内容。
searchts get <url>会通过同一解锁流程获取其中一个 URL - 对于播放器页面,返回字幕;若无法获取,则会失败并指出可使用
searchts transcribe获取音频
当读取结果指向下一步时
search 会输出一列 URL,并附上一行说明:片段不是页面。请读取每个 URL。
播放器页面(YouTube 观看 URL、TikTok 视频、Instagram reel、v.redd.it 文件,或包含视频的 X 帖子)会返回字幕;如果失败,则会输出空的 stdout,并指出音频应使用 searchts transcribe。不含视频的 X 帖子仍可读取页面。获取字幕无需密钥。音频应使用转录命令,而不是另一个读取器。
searchts transcribe https://youtu.be/...                     # audio, when read found no captions
searchts transcribe https://www.instagram.com/reel/... --cookies-from-browser chrome
searchts get https://example.com/logo.svg -o logo.svg        # one file a read named
searchts grab https://stripe.com --kinds images,fonts,svg --read --out ./stripe-kit
当文件集合本身就是交付内容时,grab 会保存这些文件。它使用相同的解锁器,因此受指纹验证的 CDN 也遵循与读取相同的阶梯。
软件包为何免费
你安装的软件包免费且无需密钥。抓取和浏览器都在你的机器上,通过你的网络连接运行。它不捆绑住宅代理。唯一托管的阶梯 Jina Reader 免费,也可以关闭。这并不意味着每个难以读取的页面永远免费。需要通过我们运营的出口才能读取的内容,属于另一种产品,并非此软件包的默认功能。评分卡记录了此版本实际读取的内容,而不是一份永远无法突破的屏蔽列表。
解锁器
searchts 会通过逐级升级的阶梯读取任意 URL,并在首个返回真实内容的层级停止:
- curl_cffi:模拟真实 Chrome 的 TLS/JA3 和 HTTP2 指纹进行抓取。可绕过用户代理和指纹过滤。快速、本地、私密。
- Jina Reader:JavaScript 渲染中继(
r.jina.ai),用于只在运行 JS 后才填充内容的页面。默认开启——在此阶梯中,目标 URL 会发送到 Jina 的服务器。使用SEARCHTS_NO_JINA=1或配置jina: false选择退出(仅使用本地 curl + 隐身模式)。 - stealth browser:无法被检测到的无头 Chromium(patchright),仅在成本更低的层级失败后才延迟启动,用于实时 JS / Cloudflare 托管挑战。
如果所有层级都未返回真实内容,可选的人机协作步骤会打开真实浏览器,让你通过一次验证后继续。这既适用于交互式 CAPTCHA,也适用于软性屏蔽:以 HTTP 200 提供的登录页面不算挑战,但它仍然是只有人类才能通过的页面。屏蔽检测基于短语(而非供应商名称),因此不会错误拒绝仅嵌入机器人传感脚本的正常页面。内容会通过 trafilatura 提取为干净的 Markdown。
它不会做什么。 它不会把屏蔽页面冒充成文章。用户未提供登录信息时,读取仍会失败并说明原因。0.15.0 中加入了本地复用,但仅限于你为命令中指定的单个站点提供会话时(--cookies-from-browser <browser> --yes、--cookies <path> 或 --cdp-port <port>)。基于 Firefox 的 Zen 配置文件使用只读 SQLite;Vivaldi 等 Chromium 浏览器则会通过环回 CDP 端口,使用一次性配置文件副本打开,之后 searchts 会将其删除。使用 Vivaldi 无需安装 Chrome,也无需在 PATH 中添加 Chrome。尚未实现登录远程浏览器(F27)。DataDome 设备检查不代表永久失败:隐身浏览器应能让该脚本运行完毕,并处理简单的点击操作(继续、勾选复选框、按住不放这类单步操作)。如果谜题要求人识别图像,则仍会停止。默认情况下,此软件包不会通过付费住宅代理转发你的请求。发布版本不会声称能够读取某个站点,除非它确实可以读取。当前评分卡中 datadome.co 仍然读取失败。这是测量结果,不是规则。
AI 聊天分享链接
AI 聊天应用的分享链接格外棘手:对话不会以可提取文本的形式出现在网页 HTML 中,因此直接抓取只会返回一个空壳;渲染器也可能在聊天内容中途截断。searchts read 能识别这些 URL,并改为解码各服务提供方自己的数据通道,以角色标注的 Markdown 返回完整对话,无需密钥,也无需登录:
| 服务提供方 | 分享 URL | 读取方式 |
|---|---|---|
| ChatGPT | chatgpt.com/share/…、chatgpt.com/s/… | 页面中嵌入的 turbo-stream 负载 |
| Claude | claude.ai/share/… | 无需密钥的快照 API(位于 Cloudflare 后) |
| Gemini | gemini.google.com/share/… | 无需密钥的 batchexecute RPC |
| Grok | grok.com/share/…、x.com/i/grok/share/… | 无需密钥的分享链接 API |
| Poe | poe.com/s/… | 页面中嵌入的 __NEXT_DATA__ 负载 |
| DeepSeek | chat.deepseek.com/share/… | 隐匿渲染,并滚动到末尾 |
| Perplexity | perplexity.ai/search/…、perplexity.ai/page/… | 隐匿渲染,并滚动到末尾 |
| Copilot | copilot.microsoft.com/shares/…、…/shares/pages/… | 隐匿渲染,并滚动到末尾 |
前五种不需要浏览器。后三种是 JavaScript 空壳,初始 HTML 中没有任何内容,因此会使用隐匿层:等待对话渲染完成,自动滚动,直到页面高度不再变化(否则列表虚拟化会截断较长的聊天内容),然后展开折叠的部分再读取。目前,基准测试覆盖了无需浏览器即可读取的五种;需要浏览器的三种尚未纳入其中。
ChatGPT 有两种链接形式:/share/<uuid> 用于分享整个对话,较新的 /s/<prefix>_<id> 短链接则用于分享单轮内容(t_ 表示线程,m_ 表示消息,dr_ 表示深度研究,cd_ 表示 Codex)。两种形式都支持读取。
每个服务提供方都是一个可直接使用的插件模块(searchts/share_extractors/);如果服务提供方更改格式,提取就会回退到常规解锁器层级,而不会失败。
实际效果如何?
与其让你相信我们,不如看可复现的双套件基准测试:searchts 会在两组网页上运行解锁器,并报告无需密钥即可读取的页面数量,以及每个页面使用的层级。
- Smoke — 一组小型公开网页(对照页面、开放文档、AI 聊天分享链接)。用于检测回归,不能证明其能处理严格的反机器人防护。
- Walled — 使用真实限制机器人访问的服务(Reddit、设有登录墙的 LinkedIn、采用 Cloudflare/DataDome 级防护的网站、X、Booking)。正文内容低于解锁器的最低内容阈值,就算失败而非通过;预期中的受限访问失败会如实报告,不会粉饰成 100%。
最近一次提交的运行读取了 12/12 个 Smoke 页面和 2/7 个 Walled 页面。受限访问的结果才是重点:五个真实防护墙都被报告为失败,而不是用虚假的 100% 掩盖。
这两项会有意分开报告——Smoke 的数字并不代表“能否突破防护墙”。请参阅 benchmarks/README.md。
python -m benchmarks.run                       # both suites, print a scorecard
python -m benchmarks.run --suite walled       # the real walled pass rate only
python -m benchmarks.run --out docs/          # write docs/scorecard.md + results.json
最新运行结果:docs/scorecard.md。添加你自己的目标——请参阅 benchmarks/README.md。
这些数字只有在住宅网络连接下才有意义:数据中心 IP(或会改变 TLS 指纹的 VPN)对快速 curl_cffi 层的拦截,比真实用户遇到的情况更严重。
安装
保留这种方式(全局隔离 CLI,包含 MCP 附加项):
pipx install "searchts[mcp]"
无需安装即可试用(一次性运行,复制粘贴即可):
uvx --from "searchts[mcp]" searchts <verb>
仅用于 venv / 打包(CLI 不推荐采用此方式):
python -m venv .venv
source .venv/bin/activate   # Windows: .venv\Scripts\activate
pip install "searchts[mcp]"
普通安装已包含隐身浏览器库(patchright)、浏览器 Cookie、MCP 服务、打包的 ffmpeg,以及 YouTube 所需的 JavaScript 运行时(通过 yt-dlp[deno] 提供的 deno)。无需在系统中安装任何内容。[mcp]、[browser] 和 [cookies] 附加项仍可解析为空别名,因此现有配置仍可正常使用。
首次设置。列出各项及其大小,只需确认一次,且默认勾选所有项目:用于隐身浏览器的 Chromium(约 170 MB)、用于 X 的 twitter-cli(约 39 MB)、用于 Reddit 的 rdt-cli(约 15 MB)、linkedin-scraper-mcp(约 214 MB)、mcporter(约 77 MB,需要 Node.js)和用于 GitHub 的 gh(约 13 MB)。本地 Whisper 模型会列出其大小,并在你首次进行本地转录时询问是否安装。网站登录不包含在这次确认中;每个网站在读取内容需要登录时都会单独询问。
searchts install                                 # a terminal asks once; type ids to uncheck
searchts install --yes --skip linkedin,mcporter  # agents: no prompt, nothing outside the list
searchts install --dry-run --json                # the list as searchts.setup.v1, changes nothing
如果没有终端且未使用 --yes,列表中的内容都不会安装;程序会打印列表和确切的确认命令。仅安装隐身浏览器:searchts install --browser。
更新正在运行的副本(searchts upgrade 是同一命令):
searchts update
更新检查与 Agent 提示
searchts 每 24 小时最多向 GitHub 查询一次
capad-xyz/searchts
的最新版本(GET https://api.github.com/repos/capad-xyz/searchts/releases/latest)。这唯一的
请求会携带 searchts/<version> User-Agent,不会包含任何关于你或你机器的信息。查询结果会缓存在
~/.searchts/update-check.json 中,有效期为 24 小时;
查询失败时不会显示提示。
如果有更新版本:
searchts read --json、searchts grab --json和searchts doctor --json会添加顶层update_available对象,{"current": "...", "latest": "...", "command": "searchts update"}。如果没有较新版本,则不会添加该对象, 因此现有解析器不会看到新键。searchts search --json会继续让 stdout 保持为纯数组,并在 stderr 中以一行 JSON 打印{"update_available": {...}}。- 成功的 MCP 工具结果(不包括
Error: ...字符串)会附带同一个对象;此外,每 24 小时最多会有一次 提示 Agent 告知你。提示记录保存在~/.searchts/update-notice.json中。 - 在终端中运行时,仍会显示现有的 stderr 提示。
不会自动安装、下载或更改任何内容。 请自行运行
searchts update。设置 SEARCHTS_NO_UPDATE_CHECK=1 可关闭检查、
提示和 stderr 提示。
快速入门
read 是读取命令。search 用于查找要读取的 URL。网页内容以语音形式呈现,或文件未包含在文本中时,read 会调用 transcribe 和 get。
searchts read https://en.wikipedia.org/wiki/Ada_Lovelace   # the page as Markdown, or a plain failure
searchts search "open source vector db"    # native multi-provider web search, keyless by default
searchts transcribe https://youtu.be/...   # the audio, when a read found no captions
searchts get https://example.com/logo.png  # one file a read named
searchts grab https://example.com          # the set of files, when the files are the deliverable
searchts doctor                            # see what is configured and working
read 参数:--json、--backend <tier>、--human(将 CAPTCHA 或登录墙交由真实浏览器处理)、--scrub(清除注入内容)、--pages <n>(仅 curl 模式下跟进下一页,最多 5 页)、--items <n>(持续跟进,直到保留这么多列表行;如果只有滚动动态消息流才能加载更多内容,也会滚动消息流)、--expand(展开折叠内容:关闭的 <details> 和标有“阅读更多”“显示更多”“查看更多”的按钮;不会打开链接、表单或登录入口,也只会指出“继续阅读”付费墙,不会将其打开)、--proxy <url>(通过代理路由;--proxy-trusted 允许远程代理运营方查看 Cookie 请求头)。需要登录的网站读取选项,均需主动选择,且仅对命令中指定的那个网站生效:使用 --yes 搭配 --cookies-from-browser <browser>(为本次会话复制该网站的 Cookie)、--cookies <path>(由 searchts 管理的 Cookie 文件)、--cdp-port <port>(从本地主机调试端口获取 Cookie)。
请求数量受上限约束,searchts 不能超出上限请求:SEARCHTS_MAX_PAGES(默认值为 5)、SEARCHTS_MAX_ITEMS(默认值为 300)、SEARCHTS_MAX_EXPAND_CLICKS(默认值为 8)。可在环境变量中设置,或在 ~/.searchts/config.yaml 的 more: 块中设置(环境变量优先)。超出上限的请求会被截断,而不是悄悄减少,提示会附在你读取的文本中:[items: asked for 900, the ceiling is 300]。--expand 仍是是/否选项;展开到什么程度由你的上限决定,而非某个标志。只能通过滚动加载的列表,以及需要 JavaScript 的折叠内容,都需要浏览器:searchts install --browser。滚动操作会打开独立浏览器,该浏览器不带代理和 Cookie,因此携带其中任一项的读取操作不会滚动,并会说明原因。这三个上限也是 Reddit 读取的所有上限:帖子卡片、评论和搜索结果都算作行,因此只有 SEARCHTS_MAX_ITEMS 决定会返回多少条;任何未返回的内容都会以数量显示,而不是直接丢弃。
login 子命令:searchts login keep <url> --cookies-from-browser zen --yes(或 vivaldi)只会将该网站的 Cookie 复制到 searchts 存储中;之后直接运行 searchts read <url> 即可使用已保存的登录状态。searchts login signin <url> 会打开一个干净的登录窗口;添加 --yes 可保留其中的 Cookie。searchts login list 会显示每个已保留网站当前的 Cookie 数量、来源浏览器或 signin,以及过期时间(仅为最晚时间,不作保证)。searchts login sweep 会立即离线删除过期 Cookie;searchts 也会在每条命令启动时清理,并列出删除内容。它绝不会创建 cron、launchd 或任务计划程序条目。searchts login check <site> [--url <signed-in-page>] 会使用已保存的 Cookie 直接读取一个仅限登录用户访问的页面,并以 0 表示已登录、1 表示已退出、2 表示未知;遇到验证码或封锁时结果为未知,公开页面永远不算作已登录。login kill <url> 会删除 searchts 保存的副本;除非传入 --also-browser,否则不会更改你自己的浏览器。login purge-scratch 会删除临时副本。
当已保留的浏览器登录状态将在 24 小时内过期,或读取操作遇到登录墙时,可以重新复制该登录状态。只有在你已记录对该网站的确认、该次运行传入 --yes,或终端提示你确认时,才会执行;否则 searchts 会说明跳过复制及其原因。通过 login signin 保留的登录状态没有可用于重新复制的浏览器来源,因此只会提示你再次运行 login signin。每项自动操作都会打印一行记录(网站、浏览器或 signin、操作、数量、原因),而 searchts read --json 会在 cookie_actions 中包含相同信息。Cookie 值绝不会被打印或记录。
search 标志:-n <count>、--json、--provider <name>。内容输出到 stdout(可通过管道传递);状态输出到 stderr。
grab 标志:--out <dir>、--kinds <images,icons,css,fonts,svg,inline_svg>、--scripts、--read(同时保存 page.md)、--max <n>、--tokens <n>(半径、阴影和间距值;默认值为 24,上限为 200)、--json。
read --media <n> 用于限制从页面保留的内嵌媒体数量。install --channels twitter,reddit,opencli,linkedin 指定可选集成,install --system-deps(别名为 --apply)用于选择启用系统更改,install --env local|server|auto 用于选择目标。uninstall --keep-config 会保留配置目录,skill install --dir <dir> 会将斜杠命令写入其他位置;其余子命令为 check-update、setup、watch 和 version。searchts help --json 是机器可读的命令目录;docs/cli.md 列出了所有标志、默认值和示例。
在 AI Agent 中使用
只需一行,即可将 searchts 添加到 Agent 中——作为 MCP 服务,或作为 Claude Code 斜杠命令:
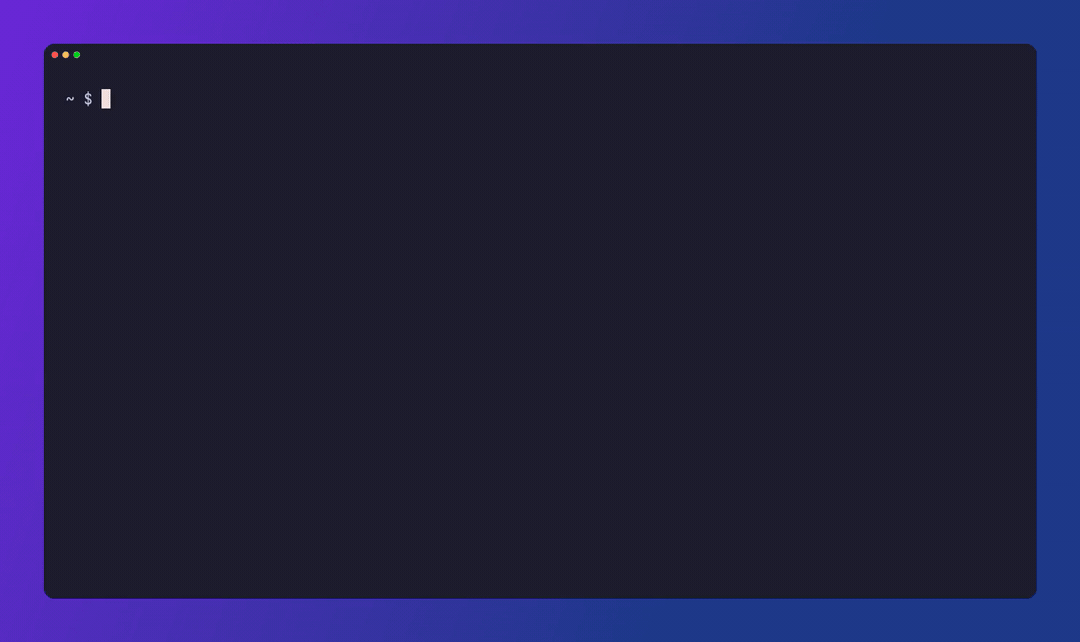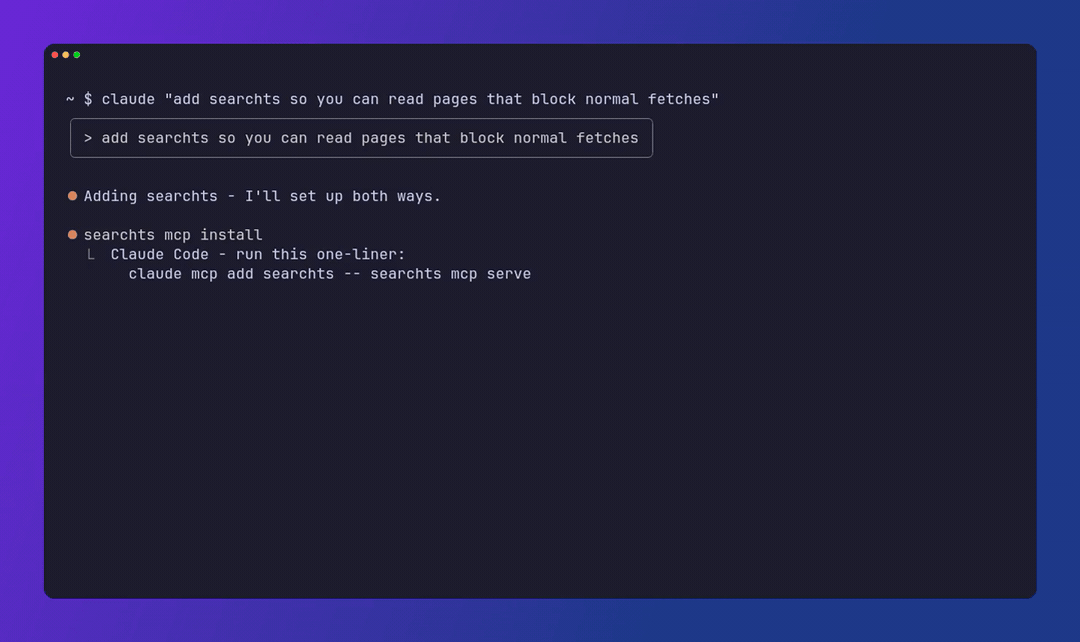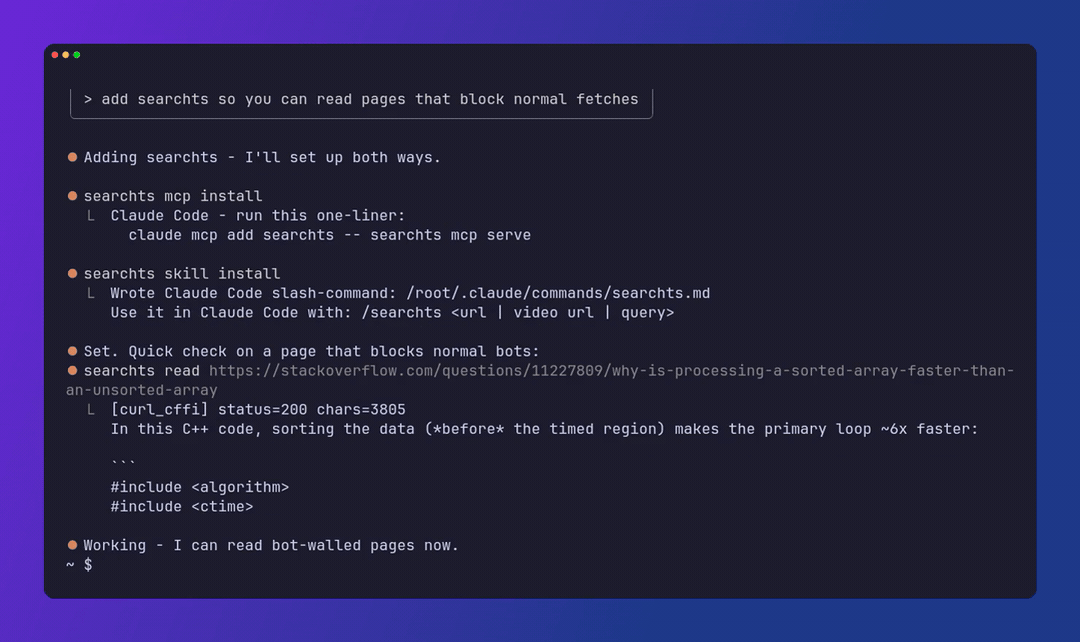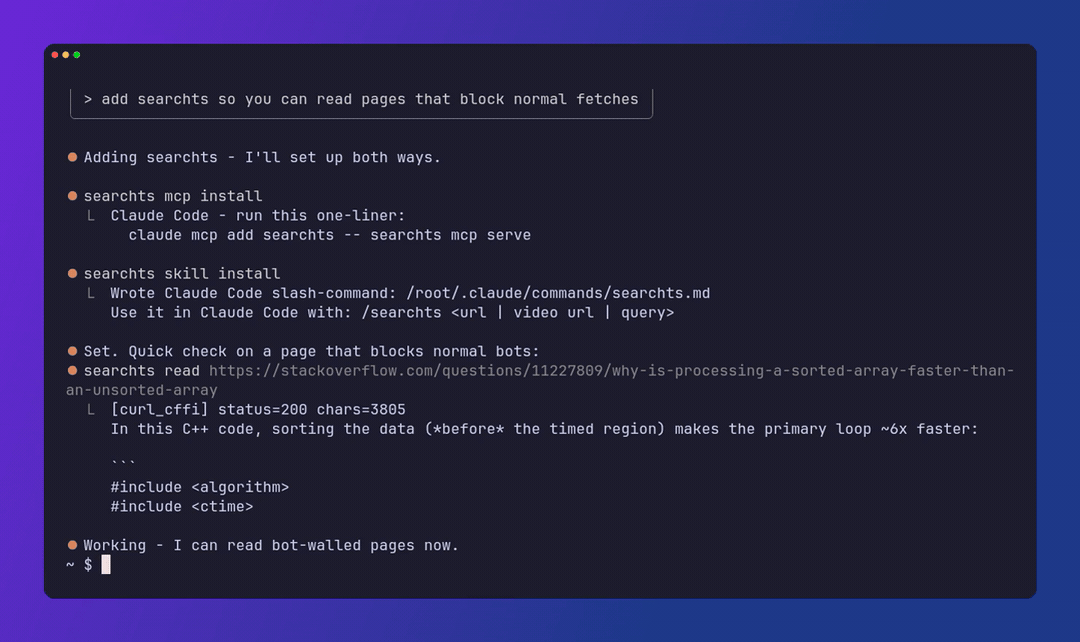
两种方式,都只需一条命令:
# 1) MCP: always-on read_url + web_search + fetch_asset + grab_site + get_status + transcribe + login_status / login_signin / login_check / login_kill
# Try / no install / Claude cannot see PATH:
claude mcp add searchts -- uvx --from "searchts[mcp]" searchts mcp serve
# Keep (after pipx install "searchts[mcp]"):
#   claude mcp add searchts -- searchts mcp serve
# Desktop / Cursor / the other local agents: `searchts mcp install`
# writes the stdio server into each client already on the machine.
# First read: Wikipedia shows more than example.com, which is one short paragraph.

# 2) Skill: /searchts in Claude Code, plus SKILL.md for Claude and OpenCode
searchts skill install        # ~/.claude/commands/searchts.md and the SKILL.md bundle
参阅 MCP 服务参考,了解全部 10 个工具(read_url、web_search、fetch_asset、grab_site、get_status、transcribe、login_status、login_signin、login_check、login_kill)、它们的输入和输出,以及各自的适用场景。
功能
- 逐级解锁开源网站:依次使用 curl_cffi、Jina Reader 和隐身浏览器。
- 多提供商搜索与排名融合:DuckDuckGo(默认无需密钥),以及配置后可用的 SearXNG、Exa、Brave 和 Tavily;使用倒数排名融合合并结果,并去除重复项。
- 视频转录:通过 yt-dlp 提取音频,再使用 Whisper 转录 YouTube、TikTok、Instagram 和 Reddit 视频。
- 资源与设计抓取工具:
searchts grab <url>会下载页面的图片、图标、css 和字体,并提取配色方案及页面使用的字体;searchts get <url>则会获取单个资源。两者都会使用同一套逐级解锁机制,因此可用于有指纹验证的 CDN,而不只是开放的 CDN。 - 提示词注入清理:移除不可见字符和双向文本字符,标记注入迹象,并可选择进行编辑,以便更安全地将不可信页面内容提供给模型。
- 按域名记忆后端:记住每个域名上奏效的层级,并优先尝试该层级(设置
SEARCHTS_NO_MEMORY=1可禁用)。 - 退出 Jina:默认启用 JS 渲染中继;设置
SEARCHTS_NO_JINA=1(或在~/.searchts配置中设为jina: false)即可跳过,因此 URL 不会发送到r.jina.ai。 - 使用方式:命令行工具、MCP 服务(
read_url、web_search、fetch_asset、grab_site、get_status、transcribe、login_status、login_signin、login_check、login_kill)和 Python 库。
作为库使用
from searchts import unlocker
r = unlocker.fetch("https://example.com")
print(r.backend, r.status, r.text)

from searchts.search import search
for hit in search("open source vector db", max_results=5):
    print(hit.title, hit.url)
工作原理及限制
- 免费软件包通过你自己的网络连接运行,适用于个人使用量。不附带代理池。
- 脚本检查(包括简单的点击操作)由隐身浏览器处理。需要人工解决的谜题,以及用户未提供账号信息的登录,仍然无法通过。此类情况可使用
--human。仅针对地址的封锁属于另一层问题;这不是解决方案,也不意味着 DataDome 无法应对。 - Reddit 只是同一梯队中的一个已知主机文件,并非绕过手段。 列表、帖子、个人资料和搜索结果会以卡片形式读取;
--items会沿用 Reddit 自己的下一篇帖子游标,--expand会展开其“更多回复”控件,因此仍需要浏览器层,也不能保证能读取所有 Reddit URL。能否通过某个层级读取,取决于浏览器配置文件:Reddit 根据配置文件的使用情况决定是否显示“证明你是人类”验证,而不是根据地址决定。因此,新建的配置文件会在每个页面都遇到验证,而已用热的配置文件(持久化的~/.searchts/browser-profile)则不会——在这台机器上,新配置文件的首次运行在所有层级都被拒绝,而几分钟后执行相同命令便能读取内容。使用临时HOME会丢弃该配置文件,因此临时 CI 或测试机器测到的只是冷启动结果。遇到无法访问的页面时,工具会说明具体原因:私密、封禁、隔离、仅限 18 岁以上用户、已删除或已归档,而不是只返回导航栏。 - 某些平台(尤其是 Instagram,以及 2026 年的 YouTube)可能需要你的浏览器 Cookie,也可能间歇性失败;这是平台方面的问题。
- 反机器人系统不断演进;这是一场军备竞赛,相关技术可能需要偶尔更新。请遵守各网站的服务条款并负责任地使用。
配置
搜索无需密钥(使用 DuckDuckGo)。其他功能均为可选,可通过 searchts configure 或 .env 配置(参见 .env.example):
- 搜索提供商:配置 Exa、Brave、Tavily API 密钥,或自托管的
SEARXNG_URL,以获取更多、更好的结果。 - 转录:配置 Groq 或 OpenAI(Whisper)密钥。
ffmpeg和yt-dlp随 searchts 一起提供(若 PATH 中有ffmpeg,则优先使用)。对于需要登录的视频:searchts transcribe URL --cookies-from-browser chrome(需主动启用;read有自己的启用选项,参见上面的read标志)。 - GitHub 令牌:用于提高速率限制。
运行 searchts doctor,检查已配置且可正常工作的项目。
可选集成
核心功能是 read / search / transcribe。每次 searchts read 都会通过
unlocker.fetch 执行,不会按平台分发请求。searchts doctor 只会探测可选 CLI
(gh、twitter-cli、opencli、mcporter)是否位于 PATH 中且已通过身份验证。
检测到这些 CLI 并不表示 searchts 会通过它们读取相应网站。
路线图
尚待处理的工作见 PLAN.md。ROADMAP.md 描述发展方向,而非任务列表。已发布的内容见 docs/plan-shipped.md。
致谢
searchts 基于 Agent-Reach(MIT)构建并加以扩展,复用了其渠道、安装程序和诊断架构。渐进式开源解锁器、多提供商搜索与排名融合、提示词注入清理、按域名记忆后端、人机协同 CAPTCHA 流程、视频转录渠道、read_url / web_search MCP 工具,以及 read / search CLI 命令均为 searchts 新增功能。感谢原作者。
许可证
MIT。详见 LICENSE。原始部分 Copyright (c) 2025 Agent Eyes;修改和新增部分 Copyright (c) 2026 capad-xyz。
由 capad 构建。有问题或反馈?请提交 issue,或发送邮件至 [email protected]。
趣闻:“searchts”并没有官方的缩写含义。私下里,它代表“search this shit”。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。