关于 Cluefinch MCP
Cluefinch MCP 是面向 AI Agent 的本地优先网页研究服务,使用配置的 SearXNG 实例搜索。它整合网页读取、链接导航和多来源收集,并支持分段读取长文档。
主要功能
- 01通过 SearXNG 搜索
- 02获取并清理网页
- 03分段读取长页面
- 04沿来源链接导航
- 05收集并去重多个来源
- 06报告收集过程中的缺口
适用场景
- 01按语言或域名筛选网页来源
- 02阅读长文档中的选定部分
- 03沿文档链接和分页浏览
- 04从多个网址和查询收集材料
MCP 相关
向 MCP 客户端提供 web_search、web_fetch、web_links 和 research_collect 四种工具。它通过 stdio 运行本地服务,并以 SearXNG 作为搜索后端。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
4收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| query | string | 是 | 搜索词。需要多个查询变体和已获取的摘录时,请改用 research_collect。 |
| domain | any | 否 | 在查询中包含 site:domain,例如 docs.python.org。请使用主机名,而非页面 URL。可与 exclude_domains 组合使用。 |
| engines | any | 否 | 可选的引擎子集:google、google cse、brave、wikipedia、wikidata。省略时使用 SearXNG 默认值。 |
| language | any | 否 | 语言/区域设置,例如 en 或 ru。省略时可使用任何语言。 |
| time_range | any | 否 | 可选的时效筛选:day、week、month 或 year。 |
| max_results | integer | 否 | 请求的候选结果数。默认值为 10;配置上限为 20。这是结果数量上限,不是搜索分页。 |
| safe_search | any | 否 | 0=关闭,1=中等,2=严格。省略则使用提供方默认值。 |
| exclude_domains | any | 否 | 使用 -site: 运算符排除域名,例如 ['pinterest.com', 'example.org']。提供方支持情况各异;请核实返回的 URL。 |
详细介绍
Cluefinch MCP
面向 AI Agent 的深度研究基础设施。
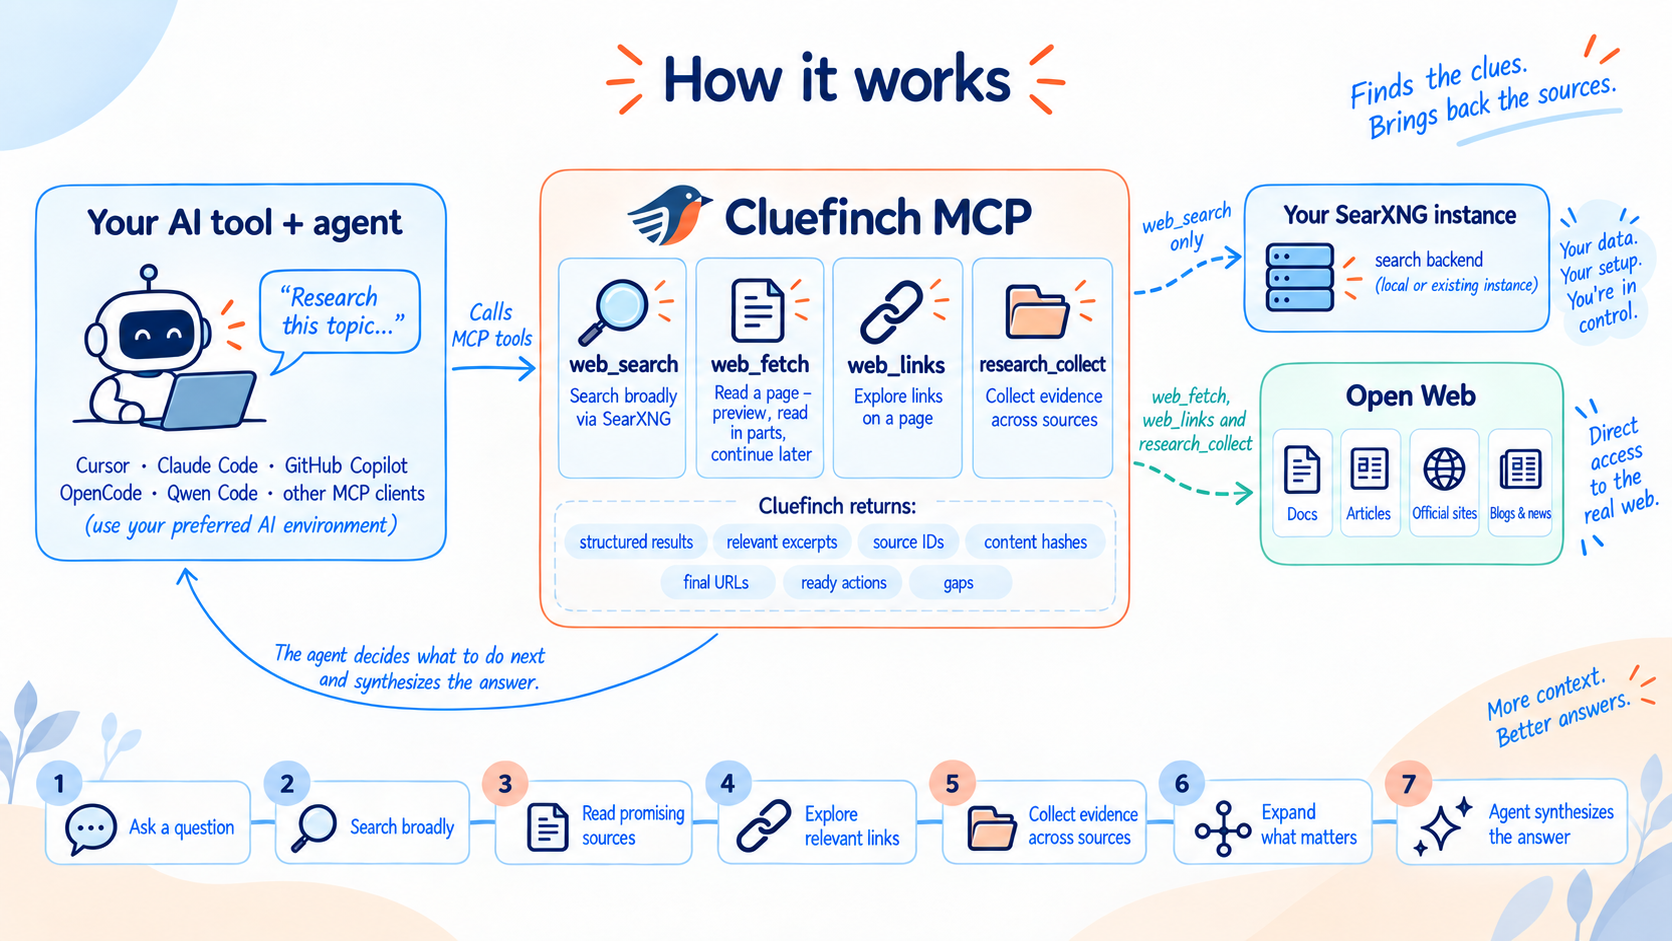
Cluefinch MCP 为 AI Agent 提供一套完整工具包,让它们通过模型上下文协议(MCP)使用 Web。
借助 Cluefinch,Agent 可以搜索 Web、阅读网页、浏览相关来源并开展深入研究。
Cluefinch MCP 可将互联网融入 AI Agent 的工作空间——无论是查找单个事实,还是跨多个来源开展复杂的多步骤研究。
Cluefinch MCP 完全免费使用,无需付费订阅。无论 AI Agent 使用本地大模型还是基于云的模型,都可以使用它;此外,它不需要商业搜索 API 或云托管深度研究服务的订阅。
Cluefinch MCP 不会限制搜索查询或研究运行的次数。
你的 Agent 可以获得高效使用 Web 所需的工具,同时你仍可掌控这些工具的使用方式。Cluefinch 可轻松集成到兼容 MCP 的 AI 工具中,并融入你现有的工作流。
Cluefinch MCP 的功能
Web 搜索
Cluefinch MCP 让 Agent 可以通过你自己的 SearXNG 实例搜索互联网。
Agent 可以构建和优化搜索查询、使用不同的搜索引擎、按语言或域名限制搜索,并在需要时发起后续或修订后的查询。
Web 阅读
找到有用的链接后,Agent 可以通过 Cluefinch MCP 打开页面,并获取经过清理、可供模型处理的文本。
无需一次性将大型页面全部加载到模型的上下文中。Agent 可以分块阅读,从指定位置继续,并且只在确有需要时请求更多上下文。
来源导航
找到有用的页面后,Agent 可以检查其中的 HTTP/HTTPS 链接,并利用来源自身的结构继续研究:浏览文档章节和报告章节、翻阅分页、打开相关页面并找到一手资料——无需每一步都返回搜索引擎。
深度研究
Cluefinch MCP 为 Agent 提供工具,让它能够开展多来源研究工作流。
Agent 可以同时探索多个调查方向,结合搜索结果与已知 URL,从不同来源收集材料,检查长文档中最相关的部分,并随着新问题的出现深入调查。
研究过程由 Agent 掌控:它决定接下来搜索什么、哪些来源值得深入检查、如何解读收集到的材料,以及何时已有足够证据给出答案。
研究的深度——从快速查询产品信息到复杂的多阶段分析——取决于任务、模型和用户的指示。
快速开始
Cluefinch MCP 需要 Python 3.12.4 或更高版本。
1. 安装 Cluefinch MCP
python -m pip install cluefinch
安装后,请确保 cluefinch 可执行文件可通过 PATH 环境变量访问。
在 Windows 上:
where.exe cluefinch
在 macOS 和 Linux 上:
command -v cluefinch
如果找不到 cluefinch,请将已安装可执行文件所在的目录添加到 PATH。
2. 启动 SearXNG
Cluefinch 使用 SearXNG 作为搜索后端。如果你还没有自己的 SearXNG 实例,仓库中提供了可直接使用的本地配置示例:
examples/searxng/compose.yamlexamples/searxng/settings.yml
运行此示例需要支持 Docker Compose 的 Docker。
将这些文件下载到单独的目录中,并在同一目录下创建一个 .env 文件,其中包含随机生成的 SEARXNG_SECRET。
在 macOS 和 Linux 上:
printf 'SEARXNG_SECRET=%s\n' "$(openssl rand -hex 32)" > .env
在 Windows PowerShell 上:
$secret = -join ((1..64) | ForEach-Object { '{0:x}' -f (Get-Random -Maximum 16) })
"SEARXNG_SECRET=$secret" | Set-Content -Encoding ascii .env
然后使用 Docker Compose 启动 SearXNG:
docker compose up -d
默认情况下,本地 SearXNG 实例可通过以下地址访问:
http://127.0.0.1:8081
3. 将 Cluefinch MCP 连接到你的 AI 工具
Cluefinch 可轻松连接到常用 AI 工具,并通过 stdio 作为标准的本地 MCP 服务运行。
下一节提供了可直接使用的连接示例。
与 AI 工具集成
Cluefinch MCP 使用标准的本地 MCP stdio 传输,因此在大多数客户端中,你只需指定 cluefinch 命令。
下面是将 Cluefinch 集成到一些常用 AI 工具的最简示例。Cluefinch 也可与其他支持通过 stdio 运行本地 MCP 服务的客户端搭配使用。
以下示例使用 Quick Start 一节中所示的 http://127.0.0.1:8081 作为 SearXNG 地址。
如果你的 SearXNG 实例未使用默认地址,请在客户端配置的 MCP 服务环境中传入 MCP_SEARCH_SEARXNG_URL。
Cursor
将 Cluefinch 添加到项目的 .cursor/mcp.json,或添加到 Cursor 的全局 MCP 配置中:
{
  "mcpServers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
重新启动 MCP 连接后,Cursor 将发现 Cluefinch 工具,并可在 Agent 任务中使用它们。
Claude Code
只需一条命令即可添加 Cluefinch:
claude mcp add --scope user cluefinch -- cluefinch
验证连接:
claude mcp list
Codex
使用以下命令添加 Cluefinch:
codex mcp add cluefinch -- cluefinch
验证连接:
codex mcp list
VS Code 中的 GitHub Copilot
将本地 MCP 服务添加到 .vscode/mcp.json:
{
  "servers": {
    "cluefinch": {
      "type": "stdio",
      "command": "cluefinch"
    }
  }
}
之后,GitHub Copilot 在 Agent 模式下即可将 Cluefinch 作为一组 MCP 工具使用。
OpenCode
将 Cluefinch 添加到 opencode.jsonc:
{
  "$schema": "https://opencode.ai/config.json",
  "mcp": {
    "cluefinch": {
      "type": "local",
      "command": ["cluefinch"],
      "enabled": true
    }
  }
}
Qwen Code
若要进行用户级配置,请将 Cluefinch 添加到 ~/.qwen/settings.json;若要针对特定项目配置,请添加到 .qwen/settings.json:
{
  "mcpServers": {
    "cluefinch": {
      "command": "cluefinch",
      "args": []
    }
  }
}
重新启动 Qwen Code 后,你可以使用 /mcp 命令验证连接。
OpenClaw
使用以下命令添加 Cluefinch:
openclaw mcp add cluefinch --command cluefinch
或者在 openclaw.json 中手动配置:
{
  "mcp": {
    "servers": {
      "cluefinch": {
        "command": "cluefinch",
        "transport": "stdio"
      }
    }
  }
}
验证连接:
openclaw mcp probe cluefinch
Hermes Agent
将 Cluefinch 添加到当前 Hermes 配置所使用的 config.yaml 文件中:
mcp_servers:
  cluefinch:
    command: "cluefinch"
    args: []
保存配置后,重新启动 Hermes。
配置 Agent 行为
Agent 使用可用的 Cluefinch MCP 工具来拟定搜索查询、选择来源并管理研究流程。你可以通过 AGENTS.md 中的指令,或在 AI 工具中设置等效选项,为这一流程定义自己的规则。
这些指令可以规范常规搜索和多阶段深度研究,包括如何使用各个 Cluefinch MCP 工具。
例如,你可以要求 Agent 先制定研究计划,通过 web_search 执行多轮细化查询,使用 web_links 浏览章节和相关页面,优先选用一手来源,并通过 web_fetch 分段阅读大型文档。
对于多来源收集和初步筛选,Agent 可以使用 research_collect。你还可以在指令中定义复用已收集上下文、核查相互冲突的来源、限制额外搜索轮次,以及将事实证据与解读分开等规则。
代码库中包含一个 AGENTS.md 文件,其中提供了此类深度研究工作流的现成示例。你可以以此为起点,将其简化以用于快速研究,或根据自己的任务、模型和输出要求进行调整。
Cluefinch MCP 工具
在 MCP 层面,Cluefinch 提供了四种互补的工具,帮助 Agent 从网页搜索到阅读特定来源,再到开展多来源研究。
web_search
web_search 通过配置的 SearXNG 实例执行搜索,并返回可能有用的来源链接。
Agent 可以控制结果数量、选择搜索引擎和语言、使用安全搜索、将搜索范围限定在特定域名,或排除不需要的域名。Cluefinch 还会报告一个或多个 SearXNG 引擎未能响应的情况,避免 Agent 将不完整的结果集误认为完整结果。
web_fetch
web_fetch 可直接读取网页。Cluefinch 会从指定的 URL 下载 HTML,提取正文,将其转换为 Markdown,并仅返回 Agent 所需的部分内容。
Agent 可以先请求页面的简短预览,判断来源是否有用,然后仅在需要时继续阅读。长文档可以从选定位置开始分段阅读。Cluefinch 会返回 next_start 和可直接使用的 continuation 操作,因此 Agent 无需手动计算下一个位置。除了内容,Agent 还会收到继续安全浏览同一保留版本提取文本所需的元数据。
web_links
web_links 从 HTML 页面中提取 HTTP/HTTPS 导航链接,并按文档顺序返回。这使 Agent 能够检查已找到来源的结构:文档章节、报告章节、分页、附录、一手来源引用以及相关页面。
这在深度研究中尤其有用。找到有力来源后,Agent 可以检查其结构,通过 web_fetch 仅打开相关章节,然后使用 research_collect 从多个选定来源收集材料。这可以减少不必要的搜索,有助于保留研究上下文,并支持对一手材料进行更深入的研究。
相对链接会使用文档的基础 URL 解析为绝对 URL。必要时可以按来源筛选链接,也可以通过多次请求分段获取大量链接。
Cluefinch 还会为每组保留的链接建立版本。如果页面的导航在请求之间发生变化,Agent 就不会从过时列表中的旧位置继续读取。
提取链接不会向其目标地址发送请求。只有当 Agent 随后决定获取其中某个 URL 时,才会执行完整的出站安全验证。
research_collect
research_collect 旨在同时处理多个来源。你可以提供多个搜索查询、特定 URL,或两者兼有。
Cluefinch 会收集可用来源,根据重定向后的最终 URL 对文档去重,并从长文档中找出最相关的段落。每个选定段落都是提取文本中的精确片段,并带有稳定坐标,因此 Agent 之后可以返回该段落,并在需要时请求更多上下文。
每个来源都会获得稳定的 source_id,而收集过程中出现的问题(例如 URL 无法访问、搜索失败或最终文档重复)会在 gaps 中明确报告。Agent 会判断是否已收集足够材料,以及哪些来源值得深入检查。
完整的工具架构、参数、限制和响应语义见 docs/REFERENCE.md。
Cluefinch 高效且安全的原因
Cluefinch 的四个 MCP 工具背后有一个检索层,用于处理长文档、重复请求、网络限制,以及对外部内容的安全访问。
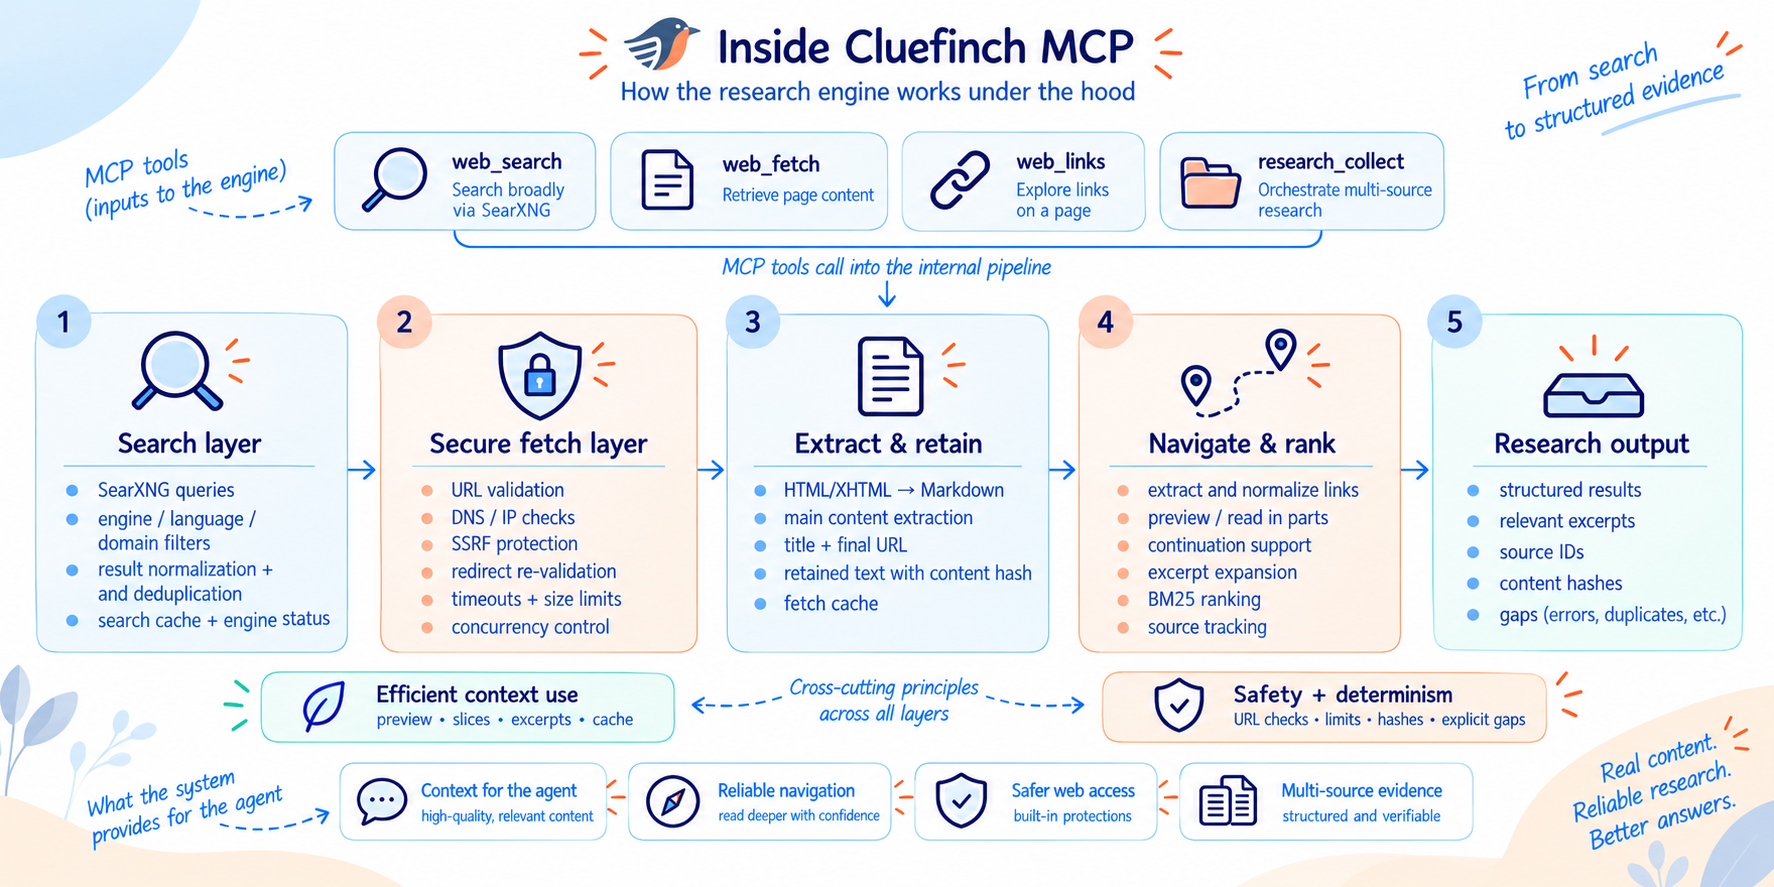
高效利用上下文和 token
Cluefinch 允许 Agent 仅将当前任务所需的页面内容发送给模型,而不是把整个文档都加载到上下文中。
提取的文档可以逐步读取。Agent 会收到下一段内容的位置,并且只在确实需要更多内容时继续读取。对于单独的研究段落,它也可以请求更多上下文,而无需重新读取整个文档。
导航使用保留的提取文本中的位置,让 Agent 能够准确返回先前找到的段落。这有助于模型更高效地利用上下文窗口,并且只在当前工作阶段对相关来源内容上花费 token。
提取文本的版本控制
提取文本的每个保留版本都会获得一个 content_hash。
当 Agent 使用 expected_content_hash 继续读取,或扩展先前选定的段落时,Cluefinch 会校验该哈希值。可直接使用的续读和扩展操作会自动传递该值。如果页面内容已更改,导致旧坐标不再可靠,工具会报告内容变更,而不是从旧位置返回过时段落。
这样可以更可靠地继续读取不断变化的来源,并降低悄然混用不同文档版本段落的风险。
来源溯源与可追踪性
Cluefinch 会保留重定向后的最终 URL,并再次根据最终文档地址对来源去重。因此,指向同一材料的不同链接不会被视为独立来源。
每个规范化的最终 URL 都会获得稳定的 source_id,以便在研究过程的不同阶段一致地识别同一来源。
对于长文档,Cluefinch 会将提取的文本拆分为有界段落,并使用 BM25 对其相关性进行排序。选定段落会保留为带有坐标的提取源文本精确片段,因此模型收到的来源材料之后可以重新查看,并扩展以获取更多上下文。
明确说明限制,而非依赖隐藏假设
Cluefinch 会明确报告可能影响检索数据完整性的情况。
如果部分来源无法检索或处理,research_collect 会返回 gaps。web_search 会单独报告未响应的 SearXNG 引擎。读取页面时,Cluefinch 还会区分两种情况:是否还有保留的文本可供读取,以及是否因配置的保留上限而丢弃了提取文档的末尾内容。
这样一来,Agent 能看到检索结果不完整,而不会把部分结果误认为完整结果。Agent 仍需自行判断收集的信息是否足以继续分析或给出答案。
缓存与数据复用
搜索结果和提取的页面会临时存储在本地、按进程隔离的 TTL/LRU 缓存中。在缓存条目仍有效时,再次请求同一资源即可避免发起另一次 HTTP 请求。缓存复用前仍会验证页面 URL,这可能涉及 DNS 查询。
对于相同的并发搜索请求,以及对同一页面的并发抓取请求,Cluefinch 会合并处理,避免并行 Agent 操作产生重复网络流量。
缓存与上下文管理相辅相成:增量读取有助于节省模型 Token,而本地缓存可避免从互联网重复下载相同数据。
安全访问外部页面
Agent 可能会收到搜索结果中的链接和任意网站链接,因此 Cluefinch 会将每个 URL 都视为潜在的不可信内容。
获取内容前,Cluefinch 会验证 URL 方案、主机名、DNS 结果和最终 IP 地址。本地、私有、保留、多播及其他不安全地址都会被拦截。重定向后会再次验证,并在连接前再次验证。Cluefinch 会连接到已验证的数字 IP,同时在 HTTP 和 TLS 中保留原始主机名。
Cluefinch 还会限制响应和解压后数据的大小、重定向次数、下载时间、并发网络活动,以及文本提取所使用的资源。同一主机的请求之间也会留出时间间隔。
这些措施主要用于防范 SSRF 和不受控的资源消耗。网页文本仍是不可信内容,Agent 不应自动将其视为指令。
搜索与网页获取相分离
Cluefinch 仅将 SearXNG 用作搜索后端。它用于发现潜在来源,但不会充当读取网页的代理。
Agent 打开找到的 URL 时,Cluefinch 会通过自身受保护的抓取层直接获取页面。将发现与获取分开,便于独立管理安全性、缓存、文本提取和长文档读取。
SearXNG 仍是独立服务,而 Cluefinch MCP 在用户环境中本地运行,无需自建云端检索服务,也不包含内置遥测功能。
研究示例
浏览真实研究会话,了解 AI Agent 如何使用 Cluefinch MCP 调查技术问题、自行决定研究方向,并随着调查推进调整策略。
配置 Cluefinch MCP
Cluefinch MCP 可通过以 MCP_SEARCH_ 为前缀的环境变量进行调整,以适配特定环境和 Agent 工作负载。
在大多数情况下,默认值就足够了。主要设置如下:
| 设置 | 默认值 | 用途 |
|---|---|---|
MCP_SEARCH_SEARXNG_URL | http://127.0.0.1:8081 | SearXNG 地址 |
MCP_SEARCH_ENGINES | google,google cse,brave,wikipedia,wikidata | 允许显式指定的引擎子集;省略 engines 时使用 SearXNG 默认值 |
MCP_SEARCH_MAX_RESULTS | 20 | 每次搜索的结果数上限 |
MCP_SEARCH_MAX_SOURCES | 10 | research_collect 尝试收集的来源数上限 |
MCP_SEARCH_MAX_QUERIES | 10 | 单次 research_collect 调用中的搜索查询数上限 |
MCP_SEARCH_MAX_FETCH_CHARS | 20000 | 单个返回页面片段的大小上限 |
MCP_SEARCH_MAX_TEXT_CHARS | 100000 | 每个页面保留的提取文本量上限 |
MCP_SEARCH_FETCH_CONCURRENCY | 3 | 并发获取页面数上限 |
MCP_SEARCH_FETCH_TTL | 600 | 获取的页面在本地缓存中的有效期,单位为秒 |
MCP_SEARCH_SEARCH_TTL | 300 | 搜索结果在本地缓存中的有效期,单位为秒 |
例如,如果 SearXNG 在其他地址运行:
export MCP_SEARCH_SEARXNG_URL=http://127.0.0.1:8888
也可以通过 MCP 客户端的服务配置直接传入相同的变量。
完整的设置列表、默认值和具体行为详见 docs/REFERENCE.md。
当前限制
Cluefinch MCP 专为通过 HTTP/HTTPS 搜索和检索普通网页而设计。当前版本支持 HTML/XHTML 和文本提取,不运行完整浏览器。
Cluefinch MCP 目前不包括:
- JavaScript 渲染或浏览器自动化;
- PDF 文本提取;
- 已认证会话或私有页面;
- 绕过 CAPTCHA 或付费墙;
- 向量搜索或基于嵌入的检索;
- 托管式 SaaS、REST API 或内置遥测。
如果某个页面几乎完全依赖 JavaScript,或必须通过身份验证才能访问,Agent 应寻找替代 HTML 来源、公开文档、镜像或其他可访问来源。
这些限制适用于当前版本的 Cluefinch MCP,有助于保持架构本地化、可预测,并由你掌控。
开发环境设置
要处理源代码,你需要 uv 和 Python 3.12.4 或更高版本。
git clone https://github.com/cluefinch/mcp-server.git
cd mcp-server
uv python install 3.12
uv sync --locked
随后,你可以直接从工作树运行服务:
uv run cluefinch
如果开发时需要本地 SearXNG 实例,请使用现成的配置示例。如果你已有自己的 SearXNG 实例,只需通过 MCP_SEARCH_SEARXNG_URL 设置其地址。
项目的主要检查项如下:
uv run ruff check mcp_search tests scripts
uv run ruff format --check mcp_search tests scripts
uv run pytest -q
uvx --from 'pyright==1.1.414' pyright --pythonpath .venv/bin/python mcp_search scripts
uv build
CI 会在 Ubuntu 和 Windows 上测试受支持的 Python 版本,并验证直接依赖项的最低版本要求。
有关本地开发环境、冒烟测试、IDE 设置、Agent 行为评估以及可发布树要求的详细信息,请参阅 docs/DEVELOPMENT.md。
贡献、支持与安全
如果你想提出更改、报告问题或为项目做贡献,请先阅读 CONTRIBUTING.md。其中说明了拉取请求、测试和开发者来源证明(DCO)的要求。
如有使用方面的问题或需要支持,请参阅 SUPPORT.md。
如果你发现漏洞或其他安全相关问题,请勿在常规 GitHub Issue 中公开详情。负责任的报告流程见 SECURITY.md。
创建公开的 Issue 或 Pull Request 时,请勿公开机密信息、私有 URL、非公开页面的内容、本地捕获文件或其他敏感数据。
许可证
Cluefinch MCP 原始代码依据 Apache License 2.0 发布。
SearXNG 作为独立的外部服务使用,仍依据 GNU AGPL-3.0 许可。Cluefinch MCP 的 Apache-2.0 许可证不适用于 SearXNG、其依赖项或 Agent 检索的网页内容。
有关第三方组件及其许可证的更多信息,请参阅 THIRD_PARTY_NOTICES.md;SearXNG 集成和分发方面的注意事项见 docs/SEARXNG_COMPLIANCE.md。
版权和署名信息请参阅 NOTICE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。