关于 Omneum
Omneum 是面向 AI Agent 工作流的开源上下文评估器,可通过 Python SDK 或 MCP 服务使用。它依据来源信息和依赖关系评估主张支持度与来源可靠性,不解读原始文本,也不需要额外模型调用。
主要功能
- 01评估主张支持度和来源可靠性
- 02识别来源之间的依赖关系
- 03利用来源和沿袭元数据
- 04在令牌预算内选择上下文
- 05本地运行并使用 SQLite 持久化
- 06可选部署 PostgreSQL
适用场景
- 01检索后评估证据质量
- 02减少共享来源造成的重复证据
- 03在预算内选择上下文片段
- 04将薄弱证据转交进一步核验
MCP 相关
Omneum 可作为 MCP 服务运行,将 MCP 客户端连接到已安装的本地评估服务。其工具可供 Agent 评估映射后的观察记录并选择上下文片段。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
我们还没有获取到这个服务的安装包或远程地址,请按项目 README 中的说明安装。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
什么是 Omneum
面向 AI Agent 的开源上下文评估工具。



AI Agent 通常会从许多不同来源汇集上下文——RAG 流程、网络搜索、API、数据库、文件、记忆系统、其他 Agent 等等——但将几十个未经处理的片段塞进单个上下文窗口,可能会让模型面对一堆从未为其整理过的信息。
大多数 Agent 都专注于检索更多上下文。Omneum 则致力于确保传递给模型的上下文干净可靠。
⚡ 为 AI Agent 快速审计上下文。
评估延迟中位数为 33 ms: 在 Apple M5 上,基于 250 条观测、3 个独立来源和 84 条声明进行测量。无需额外的大模型推理或模型裁判步骤。
感知依赖关系: 检测多个检索到的上下文片段是否重复了同一上游来源的信息。
默认在本地运行: 内容盲图算法完全在你的环境中运行,支持 SQLite 持久化和可选的 PostgreSQL 部署。
快速入门
安装 Python 包:
pip install omneum
运行内置演示:
python -m omneum.demo
创建 evaluate.py,针对单条声明评估三条观测。其中两个来源引用了同一份上游文档。
import omneum
from omneum.explanations import explain_evaluation

observations = [
    {
        "url": "https://a.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": ["https://sec.example"],
    },
    {
        "url": "https://b.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": ["https://sec.example"],
    },
    {
        "url": "https://c.example",
        "value": 4200000000,
        "claim": {
            "entity_namespace": "company",
            "entity": "acme",
            "attribute": "fy2025_gross_revenue",
        },
        "upstream": [],
    },
]

result = omneum.evaluate(observations)
print(explain_evaluation(result))
运行:
python evaluate.py
输出:
Omneum Evaluation
Evaluation latency: 1.6 ms

Fy2025 gross revenue

  4200000000
  Support: 0.67
  Supporting sources: 3
  Estimated independent support: 2.00
  Dependency signal coverage: 1.00

  Explanation:
    3 sources support this claim, with an estimated 2.00 independent sources. The available dependency signals indicate that some supporting sources are related.
evaluate() 会在进程内运行 Omneum 的图算法评估流程,计算来源可靠性和声明支持度分数,并根据来源之间的依赖关系进行调整。
对于原始检索文本,可使用可选的 extract_observations() API,在评估前通过大模型提取结构化声明。请参阅 Python SDK。
为什么选择 Omneum,以及它的工作原理
现代 Agent 流水线会使用多种不同技术来决定哪些上下文应传递给模型:
语义相似度(向量数据库)。 看起来与提示词最接近的文本片段胜出。
语义重排。 根据上下文与查询的相关性,对检索到的上下文重新排序。
LLM-as-a-Judge。 大模型读取检索到的上下文,并按照一组指令对其进行评估。
这些技术在选择上下文方面可能非常有效,但相关性只是上下文质量的一个维度。
文本块仍可能包含相互矛盾或过时的信息。多个检索到的文本块可能没有去重,或者虽然共享同一个上游来源,却看起来彼此独立。这会导致上下文膨胀:低质量信息占用上下文窗口容量,而这些容量本可以用于更高质量的信息。
Omneum 解决了其中许多局限:它通过基于图的数学分析对主张及其支持来源之间的关系进行建模。重要的是,这种分析不会天真地假设每个来源都是独立获取信息的。同一信息往往会在多个来源之间传播。如果不追踪依赖关系,Agent 就无法区分五个独立观察结果和同一信息被重复五次。
Agent 流水线已经会处理与检索上下文一同提供的结构化元数据。Omneum 利用可用的溯源和沿袭元数据来估算来源之间的依赖关系,然后将这些估算结果纳入来源可靠性和主张支持度评分的计算。
这些评分的计算不需要解读上下文的语义含义。例如,在考察如下主张时:
“Acme 报告称,2025 年的营收为 42 亿美元。”
其支持度评分取决于支持该主张的来源的可靠性。而这些来源的可靠性又来自它们所支持的主张。
这个定义看似循环,事实也确实如此。尽管如此,它仍能得出定义明确的可靠性概念,帮助区分支持充分的上下文和支持薄弱的上下文。
Omneum 的生产级推理算法会计算这些可靠性和支持度评分。探索实验与研究 →
Omneum 的适用位置
Omneum 可通过 Python SDK 在本地运行,也可作为 Model Context Protocol(MCP) 服务运行。它会在你现有的检索或排序技术栈中添加一个轻量级的检索后评估层;无需推理请求,也无需额外的模型调用。
检索 / 工具 → 重排(可选)→ Omneum 评估 → Agent 控制流 → 大模型
Omneum 会返回上下文质量信号;你的 Agent 会在整个工作流中据此做出考虑证据的决策。
MCP 安装
**注意:**本教程假设使用 Python 3.11–3.14。目前尚不支持其他语言的 SDK。
支持的平台:
| 平台 | 支持 |
|---|---|
| macOS(Apple Silicon / arm64) | ✅ |
| macOS(Intel / x86_64) | ✅ |
| Linux(Ubuntu 22.04+ / x86_64) | ✅ |
1. 安装本地评估器
运行安装程序以配置本地评估器:
omneum install
请使用常规登录账户运行 omneum install。不要使用 sudo 运行该命令。
安装程序会在非特权状态下下载并验证评估器版本。守护进程版本固定为已安装的 Python 包版本。例如,Omneum 1.0.3 只接受来自 v1.0.3 的守护进程资源;它不会解析 latest,也不会回退到其他版本。
安装前会使用版本发布中的 SHA256SUMS 验证压缩包。如果校验和缺失、摘要不匹配、压缩包条目异常、存在链接或路径遍历,安装程序会停止,不会运行压缩包中的任何内容。
仅在安装计算机级服务文件时才会请求管理员权限。在 Ubuntu 上,这包括以下受管理的运行时:
/opt/omneum
以及以下公共客户端配置:
/etc/omneum/config.toml
评估器作为系统服务运行,因为它的 VOPRF 私钥与登录账户和 MCP 进程隔离。在 macOS 上,它由 launchd 运行;在 Ubuntu 上,它由 systemd 以独立的服务身份运行。
omneum-server 会将 MCP 客户端连接到已安装的本地服务。安装程序最后会通过该路径发送 VOPRF 请求,并使用配置的公钥验证响应。仅仅服务正在运行并不代表安装成功。
有关服务账户、套接字、安装路径、自定义端点和故障处理,请参阅 docs/guides/installation.md。
2. 连接 MCP 客户端
将 Omneum 添加到 MCP 客户端配置中:
{
  "mcpServers": {
    "omneum": {
      "command": "omneum-server"
    }
  }
}
重启 MCP 客户端,即可向 Agent 提供 Omneum 的工具。
如果 MCP 客户端找不到 omneum-server,请将 command 设置为 command -v omneum-server 返回的绝对路径。
3. 验证连接
请 Agent 调用 Omneum 的 ping 工具。成功的响应会返回 "status": "ok",确认 Agent 可以访问 Omneum MCP 服务。
运行评估
使用 Omneum 的 Python SDK 和本地 MCP 服务评估检索到的上下文。
1. 映射检索到的上下文
使用 ContextMapper 将检索到的记录映射为 Omneum 观察项。此示例使用三个来源,其中两个引用同一上游文档。
import asyncio
from datetime import datetime, timezone

from omneum.mcp import StdioServerParameters
from omneum import (
    ContextMapper,
    OmneumClientConfig,
    Source,
    open_stdio_client,
)

now = datetime.now(timezone.utc)

records = [
    {
        "id": "obs-1",
        "raw_text": "Acme reported FY2025 gross revenue of $4.2 billion.",
        "url": "https://example.com/report-a",
        "value": 4_200_000_000,
        "upstream": ["https://example.com/filing"],
        "observed_at": now,
    },
    {
        "id": "obs-2",
        "raw_text": "FY2025 gross revenue for Acme was $4.2 billion, per the filing.",
        "url": "https://example.org/report-b",
        "value": 4_200_000_000,
        "upstream": ["https://example.com/filing"],
        "observed_at": now,
    },
    {
        "id": "obs-3",
        "raw_text": "Acme's FY2025 gross revenue totaled $4.2 billion.",
        "url": "https://example.net/report-c",
        "value": 4_200_000_000,
        "upstream": [],
        "observed_at": now,
    },
]

mapper = ContextMapper(
    source=lambda r: Source(kind="web_document", identifier=r["url"]),
    entity_namespace=lambda r: "company",
    entity=lambda r: "acme",
    attribute=lambda r: "fy2025_gross_revenue",
    value="value",
    observation_id="id",
    observed_at="observed_at",
    upstream_sources=lambda r: [
        {"kind": "web_document", "identifier": url}
        for url in r["upstream"]
    ],
)
SDK 会处理规范化。请参阅规范化。
2. 评估上下文
连接到 omneum-server 并调用 evaluate_mapped():
async def main():
    config = OmneumClientConfig.from_local_deployment()
    server = StdioServerParameters(command="omneum-server")

    async with open_stdio_client(config, server=server) as client:
        evaluation = await client.evaluate_mapped(
            records,
            mapper,
        )
        print(evaluation.explanation)


asyncio.run(main())
将两个 Python 代码块都保存到 evaluate_mcp.py,然后运行:
python evaluate_mcp.py
若要在一次操作中评估并选择本地保留的文本块,请将
evaluate_mapped() 调用替换为:
from omneum import DependencyEstimatorConfig
from omneum.context_selection import claim_id

observations = mapper.map_many(records)
chunks = [
    {"chunk_id": record["id"], "raw_text": record["raw_text"],
     "claim_ids": [claim_id(observation.claim)]}
    for record, observation in zip(records, observations)
]
estimator = DependencyEstimatorConfig(
    upstream_weight=1.0, citation_weight=0.0, assertion_lineage_weight=0.0,
    ownership_weight=0.0, temporal_weight=0.0, graph_weight=0.0,
    temporal_window_seconds=7200.0,
)
result = await client.evaluate_context_with_chunks(
    observations, chunks, estimator=estimator, token_budget=200,
    strategy="coverage_support",
)
evaluation = result["evaluation"]
selected_chunks = result["chunks"]
context = result["context"]
evaluation 会保留来源可靠性、声明支持度和评估遥测数据。
chunks 只包含按效用降序排列的已选 {chunk_id, score, raw_text} 记录;context 会按相同顺序呈现这些记录。原始文本会保留在客户端内存中,绝不会包含在 MCP 请求中。使用方 Agent 会自行组装模型请求。
默认预算会统计 Unicode 单词和标点符号,包括文本块标题。传入 count_tokens=your_token_counter 可按特定模型进行统计。策略包括 retrieval、max_support、mean_support 和 coverage_support;覆盖率选择会单独记录边际增益和最终文本块效用。
3. 评估结果
evaluation.explanation 会格式化评估结果,便于检查。
Omneum Evaluation
Evaluation latency: 10.6 ms

Fy2025 gross revenue

  4200000000
  Support: 0.67
  Supporting sources: 3
  Estimated independent support: 2.00
  Dependency signal coverage: 1.00

  Explanation:
    3 sources support this claim, with an estimated 2.00 independent sources. The available dependency signals indicate that some supporting sources are related.
三个来源报告了相同的值,但其中两个引用了同一份上游文档。Omneum 会识别这一依赖关系,并估算有 2.00 个相互独立的支持来源,而不是将三个来源都视为独立证据。
Agent 可以利用此结果触发更多检索,或在生成响应前将执行流程转回验证步骤。
请参阅评估架构,了解结果字段。
集成
使用 Python SDK 和 ContextMapper,将 Omneum 集成到你的 Agent 中。
框架示例:
如需完整的框架无关工作流,请参阅 企业策略示例。
可选:为 Omneum Network 做贡献(封闭测试版)
Omneum 默认在本地运行。你可以选择向共享的 Omneum Context Graph 提交观察记录,而无需上传原始上下文。
网络贡献有助于在不同 Agent 部署之间构建共享证据库,让 Context Graph 的覆盖范围不再局限于单个安装实例。
贡献通过 RFC 9497 VOPRF 实现保护隐私的加密关联。网络贡献默认处于禁用状态。即使不启用此功能,本地评估也能正常运行。
目前,Hosted Network 仅向获批的测试版参与者开放注册。
请参阅启用网络贡献(MCP)开始使用,或参阅网络贡献的工作原理了解技术细节。
数据模型与评估
观察记录
上下文不只是文本片段的集合。Omneum 将 Agent 接触到的信息表示为观察记录——不可变的记录,用于保留结构化数据及其来源信息。首个受支持的类型是断言观察记录,用于记录一项声明、其来源,以及评估所需的元数据。
Observation(
    observation_id="obs-1",
    source=source,
    claim=claim,
    observed_at=datetime.now(timezone.utc),
)
观察记录会保留可用的来源信息和元数据,包括来源所有权、时间戳、引用、上游来源关系和断言沿袭关系。多条断言观察记录可以支持同一项声明,也可以报告相互冲突的值,而不会被合并或覆盖。观察记录不是对真相的判断,而是保留所报告的证据。
来源
来源用于标识断言的出处。每个来源都有一个 kind 和一个规范化的 identifier,用于在多条观察记录中识别同一来源。来源可以是网络文档、数据库、内部服务或其他信息提供方。
Source(
    kind="web_document",
    identifier="https://example.com/acme-filing",
)
声明
声明表示从检索上下文(例如文本块和工具输出)中提取的特定断言。每条声明由 entity_namespace、entity、attribute 和 value 组成。集成 Agent 或检索流水线会提取这些字段,ContextMapper 会将它们映射到 Omneum 的数据模型中。
Claim(
    entity_namespace="company",
    entity="acme",
    attribute="fy2025_gross_revenue",
    value=4_200_000_000,
)
来源依赖性
多个来源可能报告相同的声明,却没有提供独立支持。Omneum 会根据上游溯源关系、引用、断言溯源关系、共同所有权、时间戳和图结构来估算来源依赖性。
估算出的来源依赖性会在计算每条声明的独立支持度时,调整相关来源的贡献。
ContextMapper
ContextMapper 会将 Agent 和检索流水线中的结构化数据映射到 Omneum 的观察模型中。它定义如何从现有记录中读取来源标识符、声明字段、时间戳和溯源元数据。
ContextEvaluation
ContextEvaluation 会返回经过来源依赖性调整的来源可靠性和声明支持度分数,以及冲突和溯源信息。
evaluation = await client.evaluate_mapped(
    records,
    mapper,
)
print(evaluation.explanation)
性能与准确性
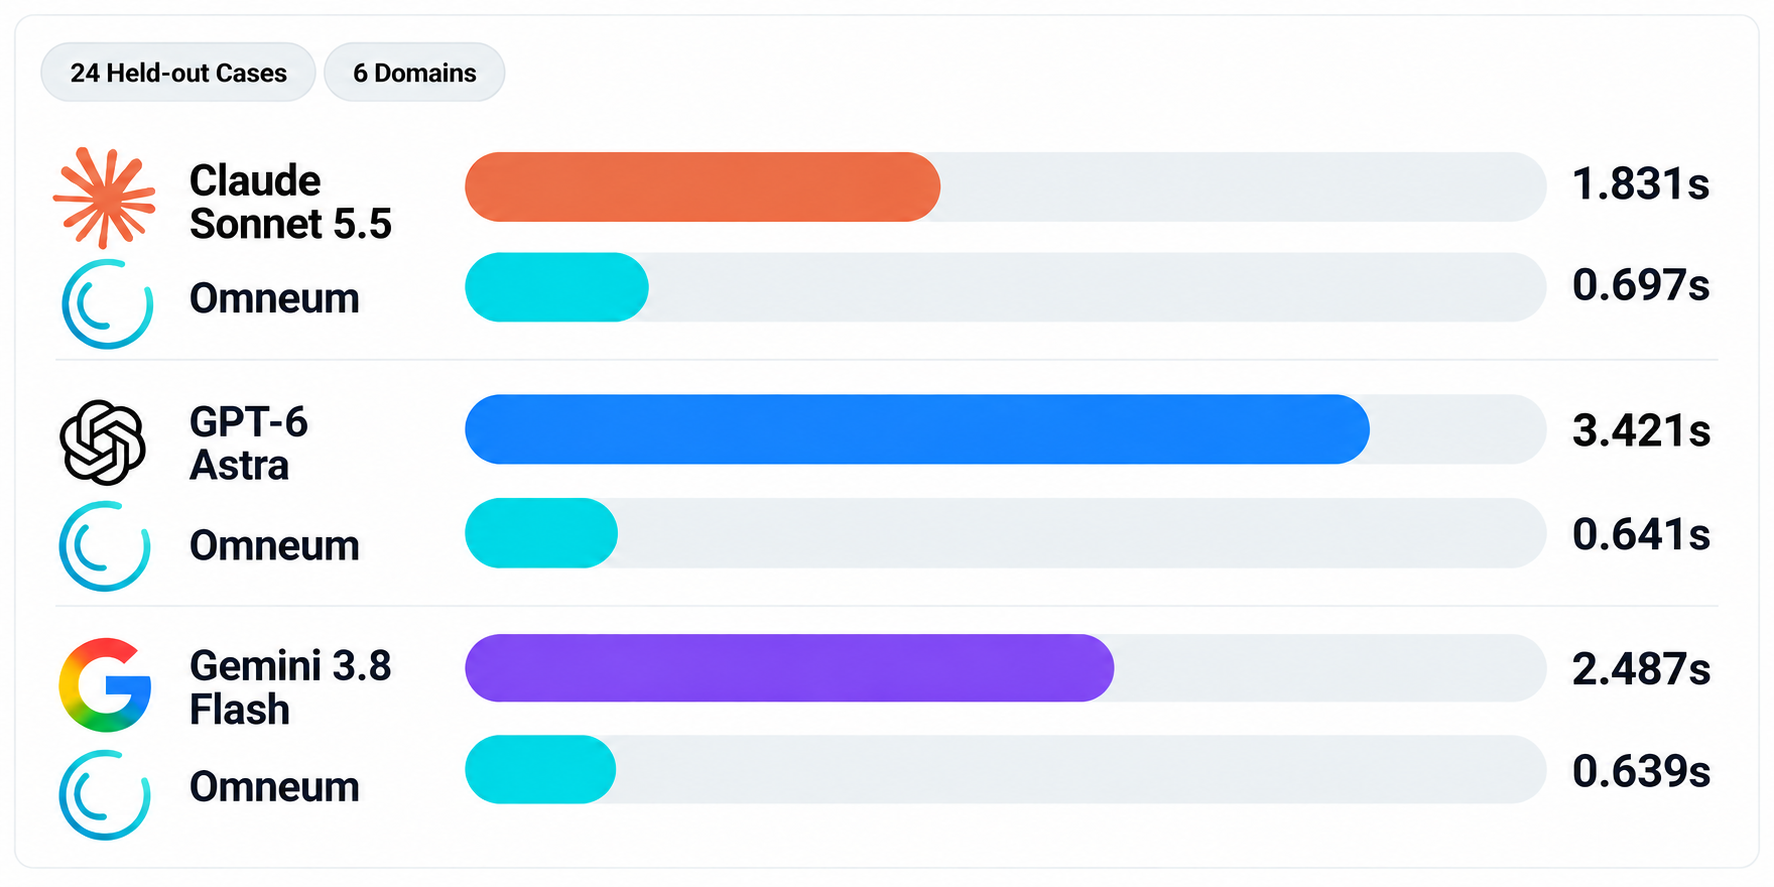
在 六个领域的 24 个留出案例上进行了评估:编码 Agent、企业级 RAG、研究与分析 Agent、多 Agent 系统、数据分析 Agent,以及支持与运维 Agent。
语义重排序器
衡量 Omneum 与语义重排序器结合使用时,在不同 Agent 工作流中如何改进证据选择。
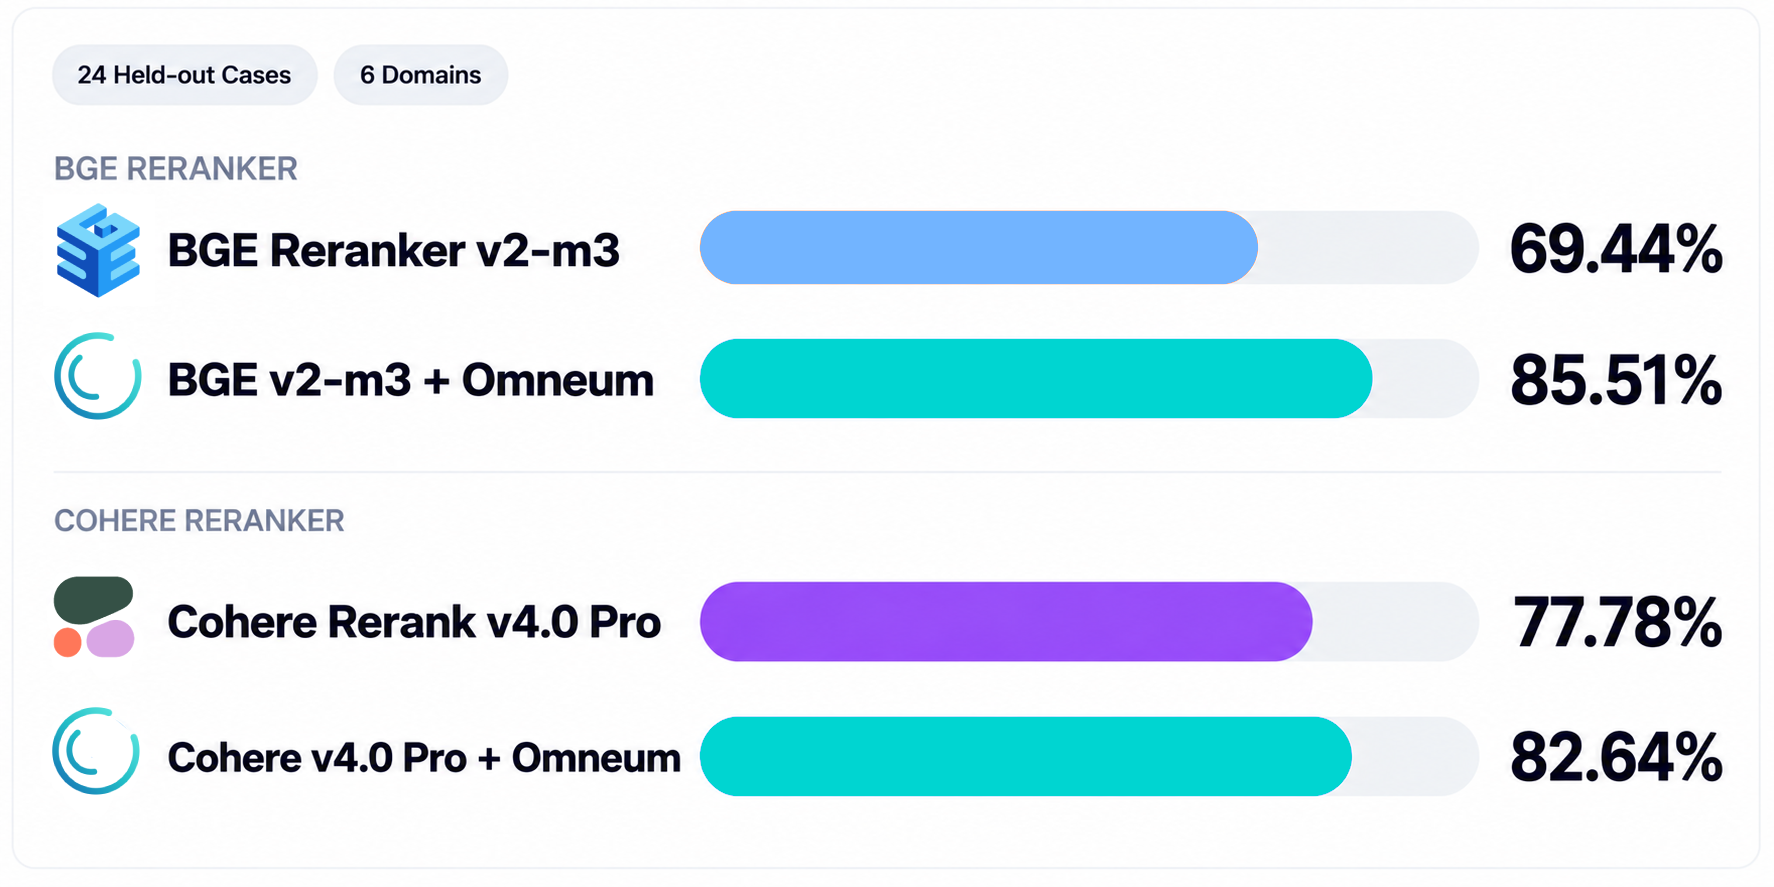
| 配置 | 精确率 ↑ | 召回率 ↑ | 答案准确率 ↑ | 选择 p50 ↓ | 端到端 p50 ↓ | 生成器令牌数 ↓ | 生成器成本 ↓ |
|---|---|---|---|---|---|---|---|
| BGE Reranker v2-m3 | 69.44% | 47.46% | 91.67% | 201 ms | 2.467s | 11,941 | $0.074618 |
| BGE + Omneum | 85.51% | 59.31% | 87.50% | 660 ms | 3.020s | 11,595 | $0.070662 |
| Cohere Rerank v4.0 Pro | 77.78% | 53.99% | 87.50% | 151 ms | 2.634s | 11,577 | $0.071242 |
| Cohere + Omneum | 82.64% | 55.72% | 79.17% | 624 ms | 3.176s | 11,535 | $0.070654 |
成本仅反映估算的下游生成器 API 使用费用;不包括重排序器 API 费用和本地计算成本。Omneum 在两组对比中均提高了选择精确率和召回率。
前沿大模型评审器
每个大模型评审器都在相同的特定模型基准配置下与 Omneum 一同评估。
| 配置 | 精确率 ↑ | 召回率 ↑ | 回答准确率 ↑ | 选择 p50 ↓ | 端到端 p50 ↓ | 生成器 Token 数 ↓ | 生成器成本 ↓ |
|---|---|---|---|---|---|---|---|
| BGE + Claude Sonnet 5.5 评审器 | 92.36% | 65.24% | 95.83% | 1.831s | 4.165s | 11,356 | $0.068208 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.697s | 3.141s | 11,811 | $0.072822 |
| BGE + GPT-6 Astra 评审器 | 92.78% | 65.45% | 92.50% | 3.421s | 5.849s | 111,247 | $0.658998 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.641s | 2.983s | 115,119 | $0.698310 |
| BGE + Gemini 3.8 Flash 评审器 | 94.44% | 66.28% | 95.83% | 2.487s | 4.924s | 114,250 | $0.686916 |
| BGE + Omneum | 86.11% | 59.34% | 91.67% | 0.639s | 3.130s | 115,535 | $0.702470 |
成本仅反映下游生成器 API 用量的估算值;不包括大模型评审器推理成本和本地计算成本。相较于前沿大模型评审器,Omneum 的选择质量和下游回答准确率具有竞争力,选择延迟降低 2.6–5.3 倍,且无需额外的大模型推理步骤。
详细评估: 方法 · 编码 Agent · 企业级 RAG · 研究 Agent · 多 Agent 系统 · 数据分析 · 支持运营
生产环境
Omneum 默认使用 SQLite 作为本地存储后端。使用外部数据库的部署也支持 PostgreSQL。
| 组件 | 实现 |
|---|---|
| MCP 服务 | 本地 omneum-server 进程 |
| 评估器 | 受管理的本地守护进程 |
| 本地数据库 | SQLite |
| 图模型 | 关系型 source、claim、observation 和 dependency 表 |
| 外部数据库 | PostgreSQL |
| 图扩展 | Apache AGE |
| 服务管理器 | macOS 上的 launchd;Ubuntu 上的 systemd |
| 密码学 | RFC 9497 VOPRF、Ristretto255-SHA512 |
本地安装会自动创建 context.db:
macOS
~/Library/Application Support/Omneum/context.db

Linux
~/.local/share/omneum/context.db
对于数据目录祖先目录不安全的新默认图,Omneum 会使用
~/.omneum/data/context.db。现有图和显式指定的路径绝不会被
静默迁移;共享目录的权限会保持不变。
使用外部数据库的部署可以配置 PostgreSQL。Apache AGE 为 PostgreSQL 部署提供图投影。
有关存储架构和部署选项,请参阅 docs/storage.md。
安全与隐私
Omneum 在本地评估上下文。omneum-server、评估器守护进程和 context.db 均在本地环境中运行。
| 组件 | 边界 |
|---|---|
| 上下文 | 传递至本地评估路径 |
| 上下文图 | 存储在本地 context.db 中 |
| VOPRF 私钥 | 由评估器守护进程持有 |
| MCP 进程 | 无法读取评估器的私钥 |
| 源负载 | 图中不需要 |
| Omneum Network | 可通过摄取 API 选择性贡献 |
Omneum 会在不同 MCP 会话之间保留本地上下文图。
application data
      │
      ▼
  omneum-server
      │
      ├── evaluator daemon
      │
      └── context.db
本地持久化与向 Omneum Network 贡献数据可分别配置。
| 选项 | 行为 |
|---|---|
| 本地持久化 | 将观察结果写入 context.db |
| 网络贡献 | 通过摄取 API 向 Omneum Network 发送假名化观察结果 |
有关向 Network 贡献数据的信息,请参阅 Omneum Network;有关上下文图存储的信息,请参阅 本地持久化。
外部评估
外部评估及其测试输入和 Omneum 输出已发布在 evals/ 中。
SearchTS。 SearchTS 0.13.0 通过 curl_cffi 从 thenewstack.io 获取了与通过 stealth-browser 从 go.dev 获取的相同 Go 1.22 声明。Omneum 收到了两次抓取各自的原始 final_url 和 fetched_at 值。评估结果为:估算的独立支持度 2.00、成对依赖度 0.0000,依赖信号覆盖率 0.25。查看结果 →
Jawz。 对 Omneum 1.0.3 的独立评估,涵盖来自 5 个来源、针对 10 项声明的 14 条金融观察结果。声明 FRED 溯源信息后,依赖度评分为 1.00;省略溯源信息则将平均依赖度从 0.70 降至 0.42,而 estimator v4 检测出共享序列对之间存在部分依赖(0.10)。无关对照组保持在 0.00。测试在隔离网络的 Linux Docker 环境中确定性运行。查看结果 →
Bastra Recall。 Recall 在一个包含 30 条记忆的合成测试框架上运行了 Omneum 1.0.3 dependency-estimator-v4。共享同一上游来源的 4 条记忆折算为 1.0 个有效独立支持来源;3 个独立来源则保持为 3.0。仅改变时间的测试从时间戳相同时的 2.5 个有效来源连续变化至 48 小时时的 3.0。评估还发现了一个尚未解决的溯源链问题:由于当前仅沿直接溯源边计算依赖度,v1 → v2 → v3 → v4 的结果为 1.6 而非 1.0。查看结果 →
贡献
欢迎贡献。请参阅 CONTRIBUTING.md。
如果发现安全问题,请按照 SECURITY.md 中的私下报告流程处理,而不要公开提交 issue。
许可证
Omneum 根据 MIT License 开源。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。