关于 ArcadeDB MCP Server
ArcadeDB MCP Server 是 ArcadeDB 内置的 MCP 接口,面向使用图、文档、向量和时间序列数据的团队。它支持 AI 助手和大模型接入这一事务型多模型数据库。
主要功能
- 01事务型多模型数据库
- 02支持图、文档、键值和向量模型
- 03支持 SQL、Cypher、Gremlin 和 GraphQL
- 04全文检索与地理空间查询
- 05内置 MCP 服务
适用场景
- 01将 AI 助手接入 ArcadeDB
- 02构建图应用和知识图谱
- 03运行时间序列分析
- 04结合图遍历与向量相似度
MCP 相关
ArcadeDB 内置 Model Context Protocol 服务,供 AI 助手和大模型集成。README 未说明具体工具或传输方式。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
专为极致性能打造的多模型 DBMS








| 测试套件 | 运行频率 | 状态 |
|---|---|---|
| Java CI - 测试 | 每次推送到 main 时 |  |
| HA 集成(Raft、嵌入式) | 每天 |  |
| HA 韧性(Docker、故障注入) | 每天 |  |
| HA 混沌测试(随机故障,60 min) | 每周 |  |
| 负载测试 | 每天 |  |
| Bolt 驱动程序版本矩阵 | 每天 |  |
| 原生镜像构建 | 每天 |  |
| 基准测试 | 每周 |  |


ArcadeDB 是一款完全支持事务的 DBMS,支持 ACID 事务、结构化和非结构化数据、原生图引擎(记录之间通过链接关联,而非使用联接)、全文索引、地理空间查询和高级安全功能。
ArcadeDB 支持以下模型:
- 图数据库(兼容 Neo4j Cypher、Apache Tinkerpop Gremlin 和 OrientDB SQL)
- 文档数据库(兼容 MongoDB 驱动程序、MongoDB 查询和 OrientDB SQL)
- 键/值(兼容 Redis 驱动程序)
- 搜索引擎
- 时间序列(支持 InfluxDB Line Protocol、Prometheus remote_write/read 和 PromQL)
- 向量嵌入
- 地理空间
ArcadeDB 支持多种语言:
- SQL(源自 OrientDB SQL)
- Neo4j Cypher (Open Cypher)
- Apache Gremlin (Apache Tinkerpop v3.7.x)
- GraphQL 语言
- MongoDB 查询语言
ArcadeDB 的关键功能:
- 70+ 种内置图算法 — 路径查找、中心性分析、社区检测、链接预测、图嵌入等,开箱即用
- 并行查询执行 — SQL 查询利用多个 CPU 核心,加快大型数据集上的执行速度
- 物化视图 — 预先计算查询结果并存储,且自动维护
- MCP 服务 — 内置 Model Context Protocol 服务,可集成 AI 助手和大模型
- AI 助手 — Studio 中集成的 AI 助手(Beta),可协助查询和数据库管理
- 地理空间索引 — 使用
geo.*SQL 函数执行原生空间查询和邻近搜索 - 时间序列 — 列式存储,采用 Gorilla/Delta-of-Delta 压缩,支持 InfluxDB/Prometheus 数据写入、PromQL 查询和 Grafana 集成
- 哈希索引 — 可扩展哈希,在 LSM-Tree 索引之外加速精确匹配查找
ArcadeDB 可通过以下方式使用:
- 在 Java 虚拟机上从任何语言嵌入
- 通过绑定从 Python 嵌入:arcadedb-python-bindings
- 通过 HTTP/JSON 远程使用
- 通过 Postgres 驱动程序 远程使用(ArcadeDB 实现了 Postgres Wire 协议)
- 通过 Redis 驱动程序 远程使用(仅实现了部分操作)
- 通过 MongoDB 驱动程序 远程使用(仅实现了部分操作)
- AI 助手可通过内置的 MCP 服务(Model Context Protocol)使用
如需了解更多信息,请参阅文档。
使用场景
在 arcadedb-usecases 仓库中探索真实案例——这些项目开箱即用,包含 Docker Compose、SQL 架构和可运行的演示,涵盖:
- 推荐引擎 — 图遍历 + 向量相似度 + 时间序列
- 知识图谱 — 使用全文搜索的合著网络和引用网络
- Graph RAG — 使用 LangChain4j 和 Neo4j Bolt 的检索增强生成
- 欺诈检测 — 使用 Cypher 处理图、向量和时间序列信号
- 实时分析 — 使用时间序列进行 IoT 和服务监控
- 社交网络分析 — 使用多语言查询的物化视图仪表板
- 供应链 — 使用 PostgreSQL 协议和 JavaScript 实现多层级可见性
5 分钟快速上手
使用 Docker 启动 ArcadeDB Server:
docker run --rm -p 2480:2480 \
           -v arcadedb-config:/home/arcadedb/config \
           -v arcadedb-databases:/home/arcadedb/databases \
           -e ARCADEDB_SETTINGS="-Darcadedb.server.rootPassword=playwithdata -Darcadedb.server.defaultDatabases=Imported[root]{import:https://github.com/ArcadeData/arcadedb-datasets/raw/main/orientdb/OpenBeer.gz}" \
           arcadedata/arcadedb:latest
--rm 会同时删除容器的匿名卷,因此两个命名卷会在多次运行中保留导入的 OpenBeer 数据库(databases),以及服务器在运行时写入的用户、组和 API 令牌(config)。如需重新开始,请使用 docker volume rm arcadedb-config arcadedb-databases 删除它们。
通过 ARCADEDB_SETTINGS 传入数据库设置,并通过 JAVA_OPTS 传入额外的 JVM 标志:Docker 会替换环境变量,而不是向其中追加内容,因此将两者分开可保留映像自带的垃圾回收器和堆内存设置(ARCADEDB_OPTS_GC 和 ARCADEDB_OPTS_MEMORY)。堆内存会按容器内存限制的百分比设置,因此 docker run -m 512m 和数 GB 的生产容器都无需进一步调整即可运行。
映像运行于 Java 25;此时 server.sh 也会启用紧凑对象头(-XX:+UseCompactObjectHeaders),但会先检查 JVM 是否接受该标志(Java 25 或更高版本的原生发行版也会执行相同操作);可设置 ARCADEDB_OPTS_HEADERS 来覆盖此设置,或将其设为空值以选择不启用。
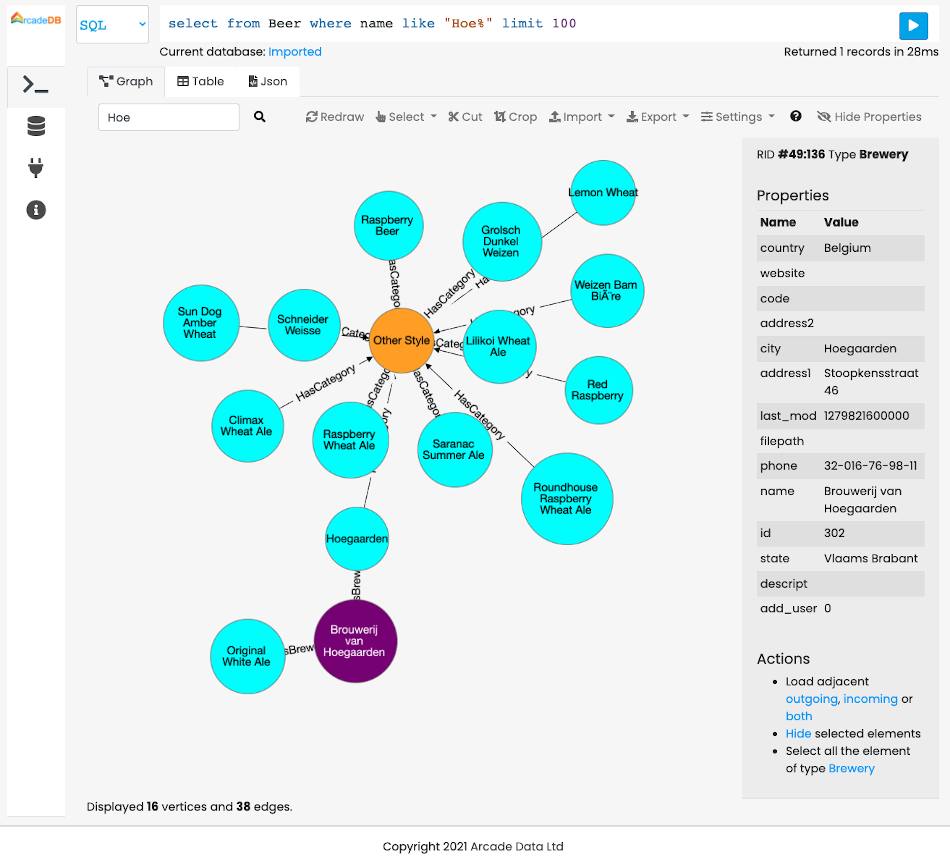
现在,在浏览器中打开 http://localhost:2480,试用 ArcadeDB Studio 和导入的 OpenBeer 数据库,找到你最喜欢的啤酒。
ArcadeDB 已为云环境做好准备,支持 Docker 和 Kubernetes。
你也可以下载最新版本,将其解压到本地硬盘,然后使用 bin/server.sh 启动服务器;Windows 用户可使用 bin/server.bat。
发行版本
发行版本(大约每月一次)有四种变体:
full- 完整软件包,包含所有模块minimal- 此软件包不包含gremlin、redisw、mongodbw、graphql模块headless- 此软件包不包含gremlin、redisw、mongodbw、graphql、studio模块base- 仅包含核心引擎、服务器和网络功能,不包含任何可选模块(console、gremlin、studio、redisw、mongodbw、postgresw、grpcw、graphql、metrics)
仓库主分支的每夜构建版本可在此处找到。
你也可以使用自定义软件包构建器构建仅包含所需模块的自定义发行版:
curl -fsSL https://github.com/ArcadeData/arcadedb/releases/download/26.3.1/arcadedb-builder.sh | \
  bash -s -- --version=26.3.1 --modules=gremlin,studio
可选模块包括:console、gremlin、studio、redisw、mongodbw、postgresw、grpcw、graphql、metrics。此构建器支持交互模式、Docker 映像生成,以及基于本地 Maven 仓库的离线构建。
此外,还提供实验性的 GraalVM native-image 构建(启动快、内存占用低、无需 JVM)——有关先决条件、构建/目标矩阵和 Docker 用法,请参阅 docs/native-image.md。
Java 版本
从 ArcadeDB 24.4.1 开始,代码与 Java 21 兼容。
Java 21 软件包可在 Maven central 获取,Docker 镜像可在 Docker Hub 获取。
对于暂时无法升级到 Java 21 的用户,我们也通过 GitHub 软件包在单独的 java17 分支上支持 Java 17。
要在项目中使用 Java 17,请将仓库添加到 pom.xml,并按如下方式引用依赖项:
<repositories>
    <repository>
        <name>github</name>
        <id>github</id>
        <url>https://maven.pkg.github.com/ArcadeData/arcadedb</url>
    </repository>
</repositories>
<dependencies>
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-engine</artifactId>
    <version>26.3.1-java17</version>
</dependency>
</dependencies>
Docker 镜像也可在 ghcr.io 获取:
docker pull ghcr.io/arcadedata/arcadedb:26.3.1-java17
将 Gremlin 与引擎一起嵌入
嵌入 Gremlin 时,无论是与 arcadedb-engine 一起嵌入还是单独嵌入,都始终使用 Gremlin 的 shaded classifier。其 ANTLR 运行时会重定位到私有包中,因此在共享类路径中绝不会与引擎的 ANTLR 4.13.2 冲突。
普通的 arcadedb-gremlin jar 会将 ANTLR 解析为引擎的 4.13.2 版本(通过 arcadedb-engine 传递引入),而引擎的 SQL/Cypher 解析器需要此版本。TinkerPop 的 Gremlin 字符串查询解析器附带一个预编译的 ANTLR 4.9.1 解析器,它只能通过 shaded jar 内重定位后的运行时进行反序列化,因此单独使用普通 jar 无法运行 Gremlin 字符串查询——请使用 shaded classifier。
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-engine</artifactId>
    <version>26.8.1</version>
</dependency>
<dependency>
    <groupId>com.arcadedb</groupId>
    <artifactId>arcadedb-gremlin</artifactId>
    <version>26.8.1</version>
    <classifier>shaded</classifier>
</dependency>
构建与测试
构建整个项目(跳过测试):
mvn clean install -DskipTests
构建 Docker 镜像(跳过测试):
mvn clean install -DskipTests -Pdocker
运行单元测试:
运行完整的单元测试套件:
mvn test
部分测试带有标签,用于说明其运行成本:
slow- 耗时明显较长的功能测试(大型批次、耗时数秒、较大的负载)benchmark- 不用于常规 CI 运行的微基准测试;默认排除(见下文)
默认情况下会排除带有 benchmark 标签的测试,因此直接运行 mvn test 已会跳过这些测试。若还要跳过 slow 测试,只运行快速测试:
mvn test -DexcludedGroups="slow,benchmark"
若只运行特定标签的测试(例如单独运行 benchmark 测试),请清除默认排除项,否则它会抵消筛选条件,导致没有测试运行:
mvn test -Dgroups="benchmark" -DexcludedGroups=
运行集成测试:
运行所有集成测试(需要 Docker):
mvn verify -Pintegration
运行集成测试,但排除端到端、负载和 HA 测试:
mvn verify -Pintegration -pl !e2e,!load-tests,!e2e-ha
运行端到端测试:
所有端到端测试(需要 Docker):
mvn verify -Pintegration -pl e2e,load-tests,e2e-ha
测试套件一览
代码库由多个互补的测试套件覆盖,每个套件都有不同的范围。“CI”列说明了各套件的运行时间;定时运行的套件在本页顶部有状态徽章。
| 套件 | 运行方式 | CI | 范围 |
|---|---|---|---|
| 单元测试 | mvn test (*Test) | 每个 PR | 在进程内隔离测试单个组件,运行速度快:引擎内部组件(存储、页面、WAL、索引、序列化)、查询解析和执行(SQL、Cypher、Gremlin、GraphQL)、架构、图遍历和安全。覆盖范围最广;无需外部服务。CI 按 JUnit 标签将测试拆分到不同通道:slow(耗时较长的功能测试)和 vector(LSM 向量索引重建)在各自的通道中运行,默认排除 benchmark。 |
| 集成测试 | mvn verify -Pintegration (*IT) | 每个 PR | 在同一 JVM/模块中测试跨多个组件或运行中服务的功能:HTTP/REST API、线协议(Postgres、MongoDB、Redis、Bolt、gRPC)以及跨模块行为。部分测试需要 Docker。 |
高可用集成测试(ha-raft) | mvn verify -Pintegration -pl ha-raft | 每日 | 在一个 JVM 中启动多个服务组成的 Raft 高可用集群:复制、领导者选举、架构和安全传播、快照安装,以及落后副本的追赶。由于耗时较长,已从 PR 流水线中移出。 |
端到端测试(e2e) | mvn verify -Pintegration -pl e2e | 每个 PR | 针对 Docker 容器中的真实 ArcadeDB 服务进行黑盒测试(Testcontainers),按照外部客户端的使用方式进行测试:JDBC/Postgres 查询、远程 Java API、服务端 JavaScript 函数,以及 Bolt 和 gRPC 驱动程序。 |
负载测试(load-tests) | mvn verify -Pintegration -pl load-tests | 每日 | 在容器中的单服务和三节点集群上,以持续并发负载测试吞吐量和稳定性,包括高吞吐量文档和时间序列数据写入。验证竞争情况下不会丢失或损坏数据。 |
高可用端到端测试(e2e-ha) | mvn verify -Pintegration -pl e2e-ha | 每日 | 在脚本化故障下验证 Raft 集群的弹性和正确性:领导者故障切换、滚动重启、脑裂、网络分区/延迟/丢包、复制收敛,以及集群范围的操作(备份/恢复、导入、删除数据库、用户管理)。使用 Testcontainers 和故障注入(Toxiproxy)。 |
高可用混沌测试(HaChaosIT) | mvn verify -Pintegration -pl e2e-ha -Dit.test=HaChaosIT -Dfailsafe.excludedGroups= | 每周 | 针对容器化集群进行长时间随机测试(默认 60 分钟):并发写入期间,由带种子的调度器注入故障(终止、停止、滚动重启、暂停、隔离、分裂、延迟、丢包,以及冻结超过 60 s 且必须在不重新格式化其 Raft 存储的情况下恢复的副本);每个步骤后都会针对所有副本检查每次已确认的写入。每次运行都会打印种子,以便通过 -Dchaos.seed=... 重放故障;可通过 -Dchaos.nodes、-Dchaos.duration、-Dchaos.faults、-Dchaos.writers 调整参数。带有 chaos 标签,因此普通的 e2e-ha 运行会跳过它。 |
| 基准测试 | mvn verify -Dgroups=benchmark -DexcludedGroups= | 每周 | 微基准测试和对比测试(@Tag("benchmark"))。这些测试用于测量而非断言,并且在其他所有运行中都会排除。 |
Python 客户端(e2e-python) | cd e2e-python && pytest tests/ | 每个 PR | 针对 Docker 容器中的服务(Testcontainers),验证 Postgres 线协议与真实 Python 客户端(psycopg2、asyncpg)及 SQLAlchemy ORM 的兼容性,并验证 Bolt 协议与官方 neo4j 驱动程序的兼容性。 |
JavaScript 客户端(e2e-js) | cd e2e-js && npm install && npm test | 每个 PR | 针对 Docker 容器中的服务(Jest + Testcontainers),验证 Node.js 客户端通过 Bolt(neo4j-driver)和 Postgres(pg)协议连接的兼容性。 |
C# 客户端(e2e-csharp) | cd e2e-csharp/ArcadeDB.E2ETests && dotnet test | 每个 PR | 针对 Docker 容器中的服务(xUnit + Testcontainers),从 .NET 验证 Postgres 线协议(Npgsql)和 Bolt 协议(Neo4j.Driver,普通连接和 TLS)的兼容性。 |
Go 客户端(e2e-go) | cd e2e-go && go test ./... | 每个 PR | 针对 Docker 容器中的服务,使用官方 neo4j-go-driver 验证 Bolt 协议兼容性,包括普通连接和 TLS。与其他客户端测试套件一样,实现共享的场景规范 bolt/conformance/spec.yaml。 |
| Bolt 驱动程序矩阵 | bolt-nightly.yml 工作流 | 每日 | 使用各官方驱动程序的多个已发布版本,重新运行 JavaScript、Python、C# 和 Go 测试套件中的 Bolt 测试,并将结果发布到 COMPATIBILITY.md。 |
Studio(e2e-studio) | cd e2e-studio && npm install && npm test | 每个 PR | 使用 Playwright 测试 Studio Web UI:创建数据库、执行查询和绘制图表、图视图(样式、上下文菜单、导出)、表格视图和向量搜索。 |
社区
加入我们遍布世界各地的社区,一起交流想法、讨论 ArcadeDB 相关话题并寻求帮助。
- 在 Discord 上与我们实时聊天
- 在 Twitter 上关注我们
- 或在 Bluesky 上关注我们
- 在 LinkedIn 上与我们联系
- 或在 Facebook 上与我们联系
- 在 Stack Overflow 上查看带有
#arcadedb标签的问题 - 查看我们的官方博客
安全
如有安全问题,请发送邮件至 [email protected],而不要在 GitHub 上公开提交问题。
许可证与致谢
ArcadeDB 可免费用于任何用途,并采用宽松的 Open Source Apache 2 许可证。我们承诺始终保持开源——请参阅我们的治理,了解确保这不仅仅是一句承诺的结构性保障。如果您需要商业支持,或需要尽快修复问题,请查看我们的定价页面。
第三方致谢和版权声明请参阅:
- NOTICE - 法律要求的致谢信息
- ATTRIBUTIONS.md - 详细的第三方致谢
- LICENSE - 完整的许可证文本
- GOVERNANCE.md - 许可证保障和项目治理
致谢
 感谢 YourKit 为我们的提交者提供 YourKit Profiler。
贡献
我们非常欢迎您参与 ArcadeDB 项目。 如果您愿意提供帮助,可以在贡献指南中了解如何为本项目作出贡献。
祝您畅享数据!
ArcadeDB 团队
随时间变化的 Star 数
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。