关于 footnote
Footnote 是面向基于 ERP 和财务数据构建 AI 应用的团队的 MCP 服务,适用于需要将答案关联到源记录的场景。它采用类型化操作、验证实体、通过 SQL 聚合数据,并保存防篡改的溯源日志,而不是让模型生成数值。
主要功能
- 01类型化操作目录,避免模型编写 SQL
- 02查询前验证实体
- 03通过 SQL 计算聚合值
- 04随结果返回记录链接
- 05保存哈希链式溯源记录
- 06拒绝无匹配操作的问题
适用场景
- 01将财务数值追溯至源发票
- 02审查风险判断背后引用的事实
- 03导出或验证溯源日志
- 04拒绝缺乏支持的预测问题
MCP 相关
它通过 MCP 暴露业务数据的固定类型化操作目录。结果包含结构化内容、记录链接和溯源元数据;声明级引用需要在宿主端集成。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y @brick-byte/footnoteDATABASE_URL密钥Postgres connection string. Omit to use the built-in SQLite sample database.PROVENANCE_DBPath to the SQLite provenance log. Defaults to in-memory, which discards the trail on exit.PROVENANCE_ACTORIdentity recorded against each provenance record. In production this comes from the request's auth.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Footnote

**一个 MCP 服务,可防止 AI 在回答 ERP 和财务数据相关问题时产生虚构数字。**答案中的每个数字都可追溯到生成它的数据库行:读取时可点击查看,可导出供审计人员检查,并具有防篡改性。
兼容任何 MCP 客户端:Claude Desktop、Cursor、Microsoft Agent Framework、Semantic Kernel (.NET)、LangChain,或你自己的循环。
一个 MCP 服务、一个溯源存储,以及一个展示它们组合效果的演示 UI。
最快的试用方式:
// claude_desktop_config.json
{ "mcpServers": {
    "footnote": {
      "command": "npx",
      "args": ["-y", "@brick-byte/footnote"],
      "env": {
        "PROVENANCE_DB": "/path/to/provenance.db",
        "PROVENANCE_ACTOR": "your-name",
        // Omit for the built-in SQLite sample data.
        "DATABASE_URL": "postgres://user:pass@localhost:5432/erp"
      }
    } } }
或者在本地运行演示 UI:
npm install
npm run demo      # http://localhost:4711
npm test          # 26 tests, including the invariants below
需要 Node 22.5+(使用内置的 node:sqlite,因此无需安装数据库)。
Postgres 为可选项。同一套架构、种子数据和查询集均可在 Postgres 上运行,并且两种数据库都必须通过同一套测试:
npm run db:up     # Postgres 17 in Docker, seeded from migrations/001_init.sql
npm run test:pg   # the identical 26 tests, against Postgres
npm run demo:pg   # the demo, against Postgres
问题所在
语言模型生成的是看似合理的续写,而非真实内容。让它查询业务数据库,它就会信心十足地报告一个没有任何查询结果支持的数字——而这个虚构数字与真实数字难以区分,因为两者都来自同一套机制。
常见的解决办法在这里行不通。不确定性信号能捕捉模糊的情况,却抓不住流畅作答的情况。使用同一模型构建的验证器,既能轻易确认虚构内容,也能轻易发现它。而在财务、库存或采购场景中,“模型是这么说的”并不是任何人可以据此采取行动的答案。
有效的办法是从结构上解决:绝不让模型生成数字。
架构
  question
     │
     ▼
  model ──────────► picks an operation from a catalog and supplies typed args
     │                (it cannot write SQL, cannot invent an operation)
     ▼
  contract layer ─► validates params, resolves entities against the database,
     │                rejects anything that does not exist
     ▼
  deterministic ──► executes the query; SQL does all aggregation
  core                returns values + the evidence behind each one
     │
     ▼
  provenance ─────► appends a hash-chained record, server-side,
  store               where the model cannot influence it
     │
     ▼
  host UI ────────► fills slots from structured output and renders each
                      claim as a clickable citation
模型负责转换和措辞——这两件事它都擅长。数字则来自记录系统。
强制保障
这些是测试,不是指南。只要其中任何一项失效,npm test 就会失败。
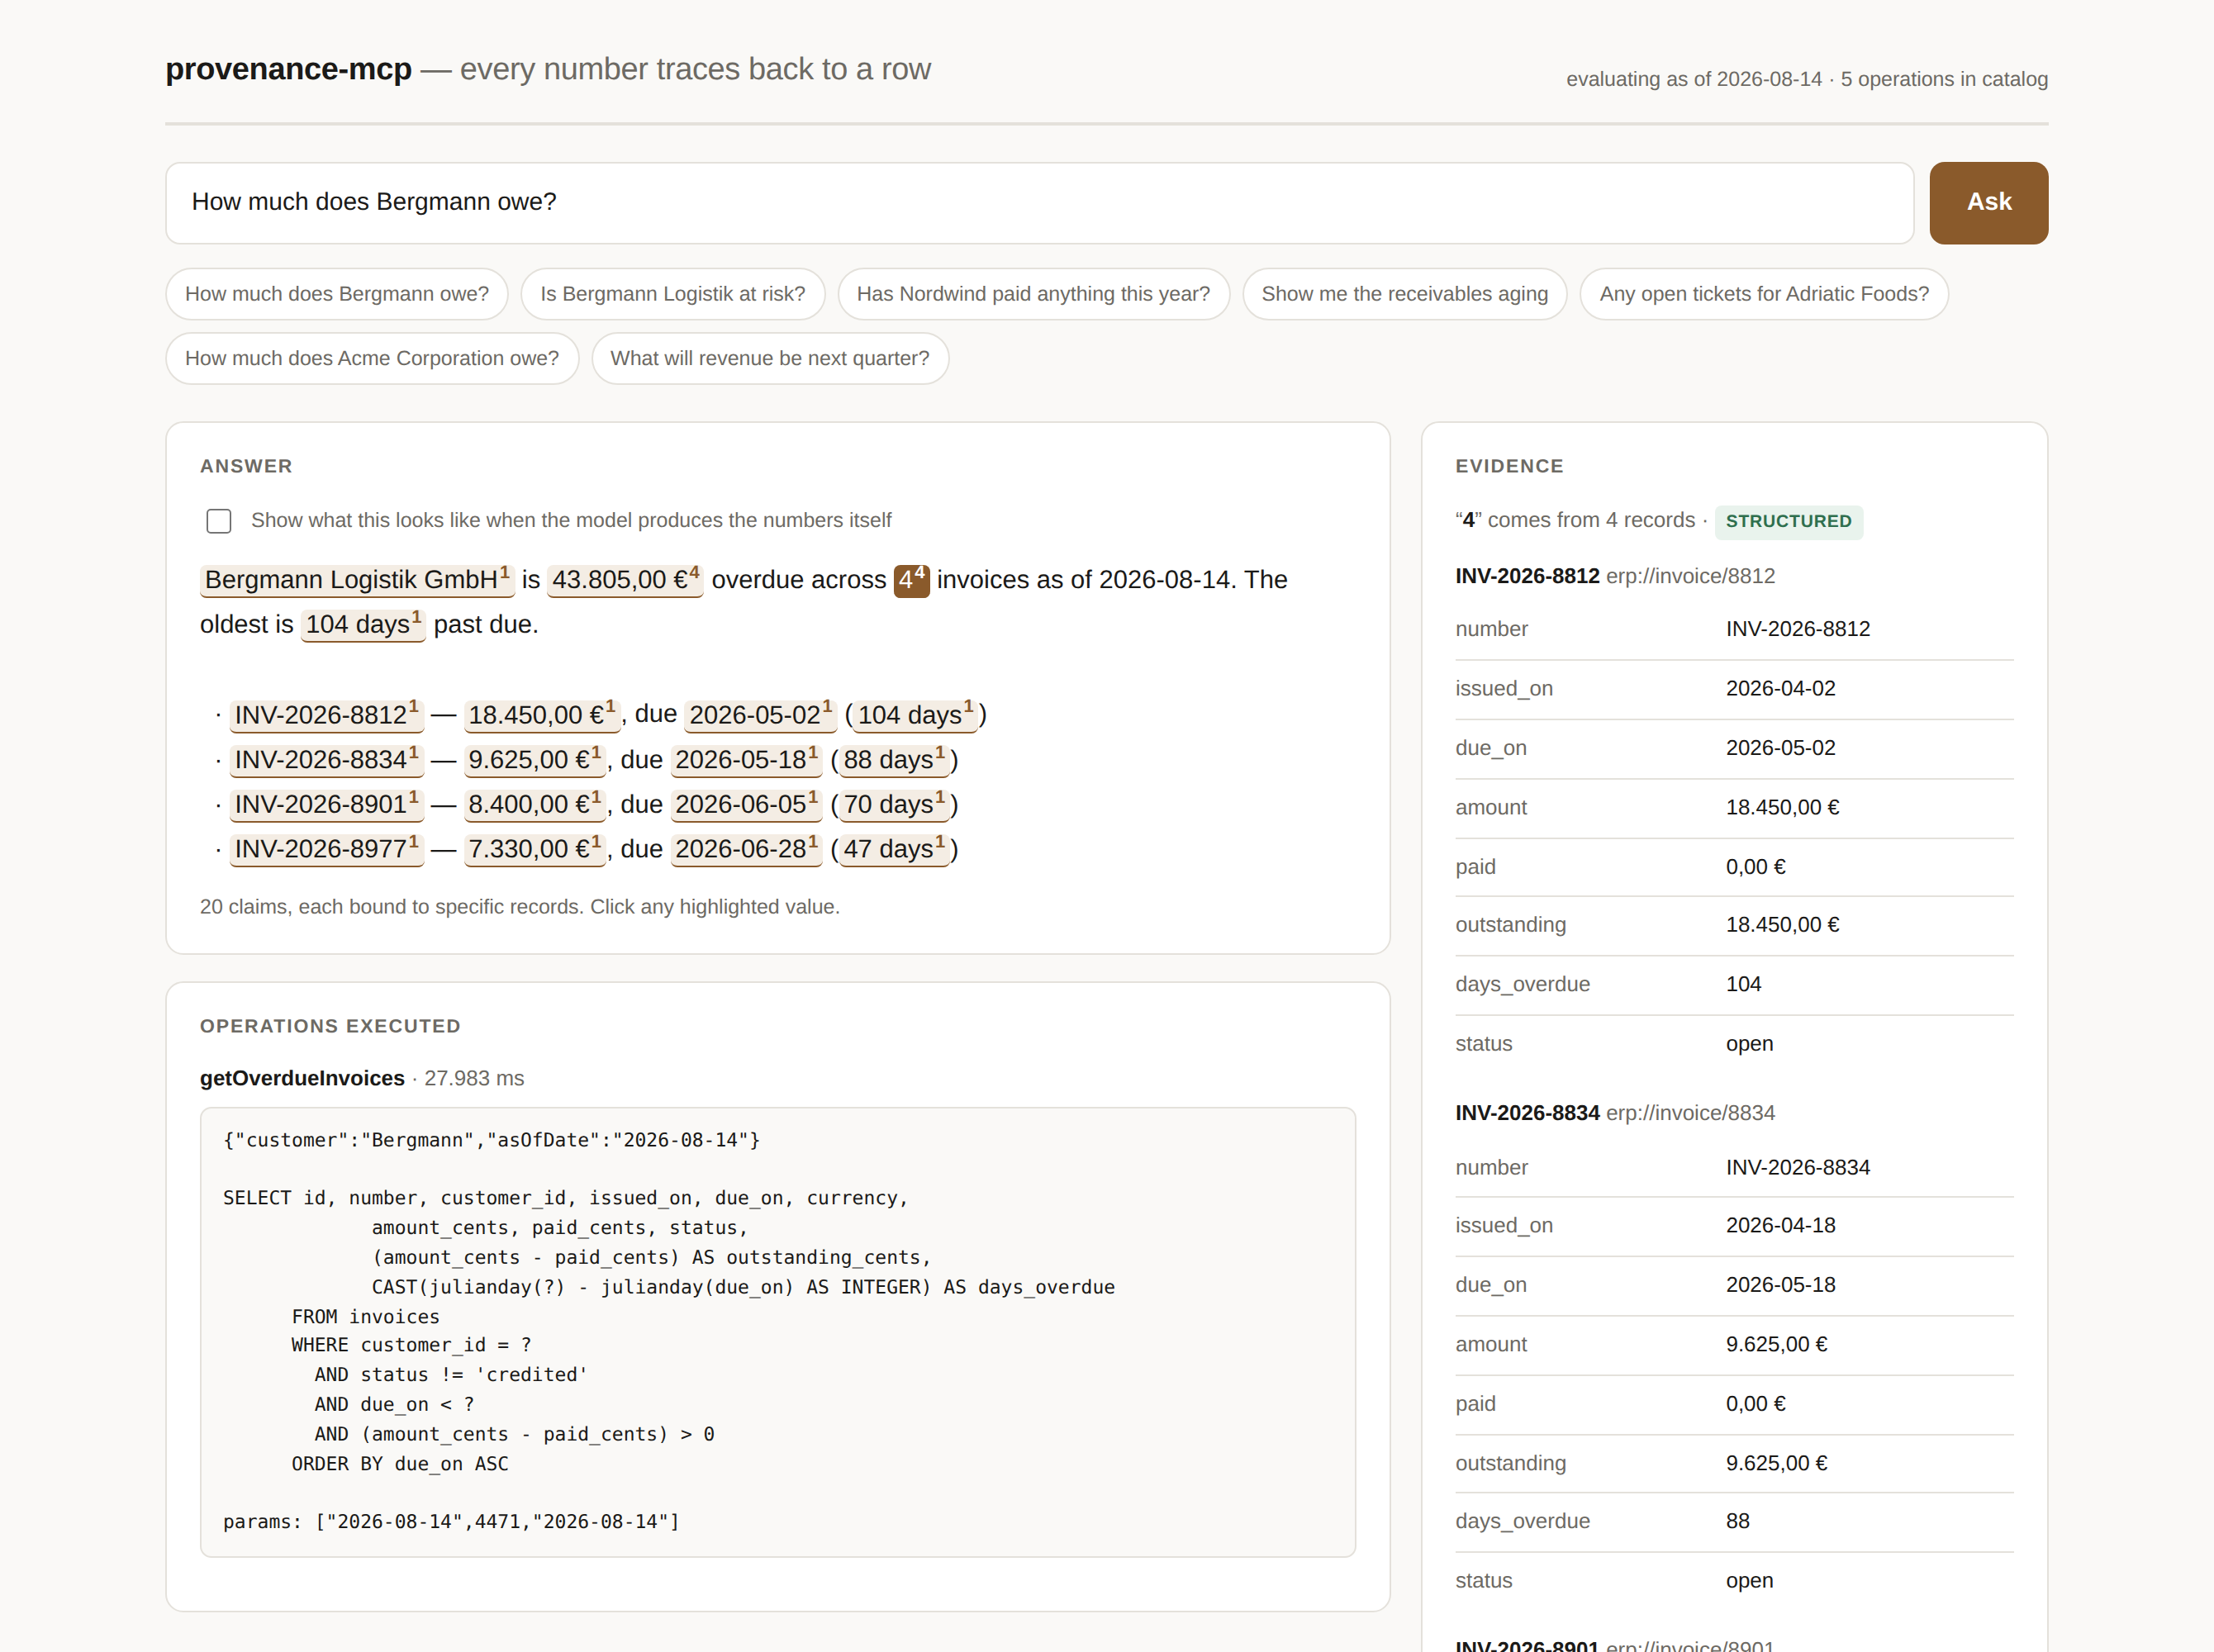
**不会生成任何数字。**值会从操作的结构化输出中原样复制到模板插槽中。测试会断言,答案中的每个金额数字都有证据支持的声明作为依据,并且所述总额等于其引用记录之和。
**运行任何查询前都会验证实体。**如果客户是虚构的,就会返回可恢复错误,并列出真实的备选项,而不是静默返回空结果,让模型自行编造解释。
**聚合在 SQL 中完成。**模型选择要运行哪种聚合,但绝不决定聚合结果。
**空结果由代码处理。**这是最容易触发虚构内容的情况:在句子中途把空结果集交给模型,它就会编造内容来完成句子。操作会改为设置明确的 emptyReason。
无法路由的问题会被拒绝。“下季度的收入会是多少?”没有对应的操作,因此不会生成答案。拒绝是正式的处理结果,而不是失败。
**溯源信息由服务端写入。**模型绝不会报告自身的溯源信息。依赖模型主动选择引用的溯源信息毫无价值。
**日志具有防篡改性。**每条记录都包含其前一条记录的哈希。npm run verify 会遍历哈希链,并报告写入后被修改的第一条记录。
查询排序顺序是经过测试的契约。listCustomers 必须按记录顺序返回,因为实体提取会选择第一个匹配项。若改为按名称排序,就会导致本项目旨在防止的问题:句子流畅、数字真实、引用的行也正确,却说的是错误的公司。对此有专门的测试。
不只是数据,还有解读
更难处理的是判断。“Bergmann 有风险”是一个结论,没有可供核对的行——而缺乏依据的解读比缺乏依据的数字更危险,因为它看起来像洞见,而且经得起审查。
这里的回答先给出结论,再将每个前提列为一条单独引用的事实:
Bergmann Logistik GmbH shows two independent risk signals.
This is an interpretation — the underlying facts are:

  · 43.805,00 € overdue across 4 invoices, oldest 104 days past due
  · 2 open support tickets, 1 high severity
  · agreed payment terms of 30 days, account owned by Ana Kovač

The conclusion is the model's. Every fact above is a record you can open.
人们可以不同意其中的推理,同时仍然信任输入信息。
来源记录格式
{
  "id": "…", "sequence": 1, "timestamp": "2026-08-14T09:12:04.000Z",
  "actor": { "id": "zoran", "role": "controller" },
  "question": "How much does Bergmann owe?",
  "answer": "Bergmann Logistik GmbH is 43.805,00 € overdue across 4 invoices…",

  // Each claim indexes a span of the answer and names its evidence.
  "claims": [
    {
      "text": "43.805,00 €",
      "span": { "start": 25, "end": 36 },
      "evidenceIds": ["invoice:8812", "invoice:8834", "invoice:8901", "invoice:8977"],
      "origin": "structured"        // never "generated" for a value
    }
  ],

  // The query, so the result is reproducible.
  "operations": [
    { "name": "getOverdueInvoices",
      "arguments": { "customer": "Bergmann", "asOfDate": "2026-08-14" },
      "query": { "sql": "SELECT …", "params": ["2026-08-14", 4471, "2026-08-14"] },
      "durationMs": 0.42 }
  ],

  // Field values, not just IDs — the export stands alone if the source moves on.
  "evidence": [
    { "id": "invoice:8812", "type": "invoice", "recordId": "8812",
      "uri": "erp://invoice/8812",
      "fields": { "number": "INV-2026-8812", "due_on": "2026-05-02",
                  "outstanding": "18.450,00 €", "days_overdue": 104 } }
  ],

  "previousHash": "0000…", "hash": "9aa2ba…"
}
origin 是关键字段。structured 表示该值是从某项操作的输出中复制而来。generated 表示该值由模型生成——对于数字而言,这正是本项目要防止的情况。
MCP 详情
该服务使用协议中支持这项工作的部分:
| 功能 | 用途 |
|---|---|
inputSchema | 模型获得的是类型明确的目录,而不是查询语言 |
structuredContent | 数值以经过验证的 JSON 与文字内容一同返回,因此数据无需经过生成的令牌往返传递 |
resource_link | 每条被访问的记录都会以 erp:// URI 的形式返回——这是可点击引用背后的深层链接基础 |
annotations.audience | 记录链接会标记为面向用户 |
_meta | 携带来源记录的 ID 和哈希,方便宿主获取完整追踪记录 |
isError | 虚构的实体会产生可恢复的工具错误,模型可以据此修正,而不是导致协议故障 |
MCP 不会提供的功能,以及本仓库额外实现的内容:协议中没有任何机制能将这项声明与那份证据绑定起来。协议会提供链接;声明与证据之间的映射及其呈现方式由宿主负责。这种绑定才是产品的核心。
通过标准输入/输出独立运行:
npm run mcp
claude_desktop_config.json 配置项位于本 README 的顶部。
从源代码运行(用于开发)
{ "mcpServers": {
    "footnote": {
      "command": "npx",
      "args": ["tsx", "--experimental-sqlite", "/path/to/footnote/src/mcp-server.ts"],
      "env": { "PROVENANCE_DB": "/path/to/provenance.db", "PROVENANCE_ACTOR": "your-name" }
    } } }
与普通 MCP 相比,你能获得什么,以及哪些功能需要宿主集成
任何 MCP 客户端——Claude Desktop、Microsoft Agent Framework、Semantic Kernel、LangChain,或你自己的循环——现在都能调用此服务。你能获得:
- 固定的类型化操作目录;模型无法编写 SQL,也无法虚构操作
- 实体验证,因此虚构的客户会被判定为错误,而不是返回空结果
- 使用 SQL 进行聚合,而非交由模型处理
- 当问题无法映射到任何操作时,系统会拒绝回答,而非自行发挥
- 用于标识每条被访问记录的
resource_link条目 - 服务器端记录每次调用的哈希链式来源日志
你无法获得的是:可点击的声明级引用。使用普通 MCP 时,框架会接收 structuredContent 和资源链接,然后由它自己的模型组织答案——此时,具体声明与其证据之间的绑定已经消失,数字也会再次经过生成的令牌传递。
保留这种绑定是宿主端的工作,因为协议中没有任何机制能承载它。src/web.ts 和 src/public/index.html 是参考实现:声明文本区段、引用标记、记录解析。大约 200 行。将其移植到你的宿主中,就能获得另一半功能。
在演示中试试这些问题
| 问题 | 展示内容 |
|---|---|
| Bergmann 欠了多少? | 每个数字都可以点击,查看对应的发票 |
| Bergmann Logistik 有风险吗? | 一种解读,并附有分别引用的前提 |
| 显示应收账款账龄分析 | 使用 SQL 计算的整体聚合 |
| Acme Corporation 欠了多少? | 虚构实体 → 拒绝回答并提供真实的替代项 |
| 下季度的收入会是多少? | 无法路由 → 拒绝回答,而非自行发挥 |
切换 “显示模型自行生成数字时的效果” 进行对比:格式完全相同,文字流畅,每个数字都错了,而且输出中没有任何标记能指出这一点。
布局
migrations/001_init.sql  schema + seed, shared by both backends and Docker
src/database.ts     the Db seam — SqliteDb and PostgresDb behind one interface
src/db.ts           opens the ERP database, applies the migration
src/operations.ts   the catalog — the model's entire callable surface
src/compose.ts      slot-filling; claims and spans are emitted here
src/provenance.ts   append-only hash-chained store, export, verification
src/mcp-server.ts   MCP server over stdio
src/web.ts          demo host application
src/verify.ts       npm run verify / npm run export
test/run.ts         26 tests covering the invariants above, on both backends
docker-compose.yml  Postgres 17, seeded from the same migration
只有 operations.ts 会以一种方言编写 ERP SQL,并使用 ? 占位符。
PostgresDb 会将它们改写为 $1..$n。两个数据库引擎之间唯一真正不同的表达式——计算两个日期之间的整天数,在 SQLite 上使用 julianday(),在 Postgres 上使用日期相减——被命名为 Db 接口上的 daysBetween,而不是直接内联。移植时,只有这个地方可能悄无声息地改变数值,因此它被单独隔离,测试套件也会断言两者得出的天数相同。
状态与限制
v0,且如实说明了范围。
- 你无法为别人的 AI 添加来源信息。 如果答案来自 SAP Joule 或 Dynamics Copilot,你无法访问它们的检索流程或渲染方式。这种方法适用于你自己构建的、基于业务数据的 AI 层。
- 厂商提供了引用,但功能有限。 截至 2026 年 8 月,SAP、Microsoft、NetSuite 和 Salesforce 都支持跳转到知识内容的引用,例如帮助文章、PDF 和文档。但没有一家提供通用机制,能将某个数值关联到其背后的交易记录。数字类答案在所有产品中都是最薄弱的一环。
- 演示项目的意图路由刻意采用简单的关键词匹配,因此无需 API 密钥即可运行。在实际部署中,由模型生成工具调用,而此代码仍负责填充参数槽位。重点在于架构,而非路由。
- 写入操作不在范围之内。在 ERP 中,编造一条读取结果令人尴尬;编造一条写入记录则会损坏账本。写入操作应置于提议 → 验证 → 确认流程之后。
- 数据保留、访问控制,以及针对特定 ERP 的真正深度链接解析器,是最后一公里——而真正的产品价值就在最后一公里。
值得了解的先行项目
- OpenTelemetry GenAI 语义约定 — 为 GenAI 客户端和 MCP 提供跨度。仍处于早期阶段,覆盖范围远未达到记录级来源信息。
- OpenLineage — 数据集和作业的血缘追踪。理念相同,但位于下一层,追踪的是表,而非声明。
- LLM 可观测性 — Langfuse、LangSmith、Arize、Datadog。为调试应用的工程师提供追踪,而非为阅读答案的人提供来源信息。
许可证
MIT。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。