关于 growmos
growmos 是面向开发者和 AI Agent 的仓库级知识图谱与持久记忆工具,可将文档和会话整理为带来源的关系,并通过引用回答问题。它支持多种 Agent CLI,也可作为 MCP 服务使用。
主要功能
- 01从文档增量构建知识图谱
- 02记录带来源的实体与关系
- 03查询图谱并引用边作为依据
- 04对声明进行事实核查
- 05评估图谱质量与覆盖情况
- 06导出并离线浏览图谱
适用场景
- 01让多个 Agent 共享代码库背景
- 02追溯架构决策及其依赖关系
- 03核验 Agent 对项目事实的陈述
- 04在提交后更新文档形成的图谱
MCP 相关
growmos 可通过零依赖的 stdio MCP 服务暴露上下文、查询、搜索、记忆、关联、核查及任务处理等工具,供 MCP 客户端直接调用。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
12收录的工具列表 · 更新于 2 周前
此工具无需参数。
详细介绍
growmos


与代码仓库共同成长的动态知识图谱。 为人类和 AI Agent 提供共享且携带来源信息的记忆,可即插即用地搭配 Claude Code、Codex、Grok、Cursor、Gemini 或任何支持 MCP 的命令行工具。零依赖。MIT。
“每个 Agent 的记忆都会随着其上下文窗口消失。” growmos 是底层的那一层:一个持久、可查询的世界模型,让今天的会话能从昨天结束的地方继续—— 也让五个 Agent 共享同一份代码库视图,而无需将它传递给任何人的 上下文窗口。
由 Codician 构建,是一种开放、与工具无关的实现,采用了《多 Agent 系统的知识图谱工程:Anthropic 实践指南》中介绍的知识图谱方法论(提取 → 解析 → 组装 → 查询,并通过评估循环闭合)。完整方法论请见 METHODOLOGY.md。
   docs, ADRs, READMEs, sessions ──▶ 1. Extraction ──▶ 2. Resolution ──▶ 3. Assembly ──▶ 4. Querying
                                     (agent packet)    (agent packet)    (deterministic)  (grounded answers,
                                                                                            edge citations)
                     ▲                                                                            │
                     └──────────────── growmos remember / link / journal  ◀── agents develop ◀────┘
                                       evaluation loop: change prompt → growmos eval → watch F1 move
▶ 在线演示 — 点击浏览 growmos 自己的图谱 · Apollo 语料演示 · 网站
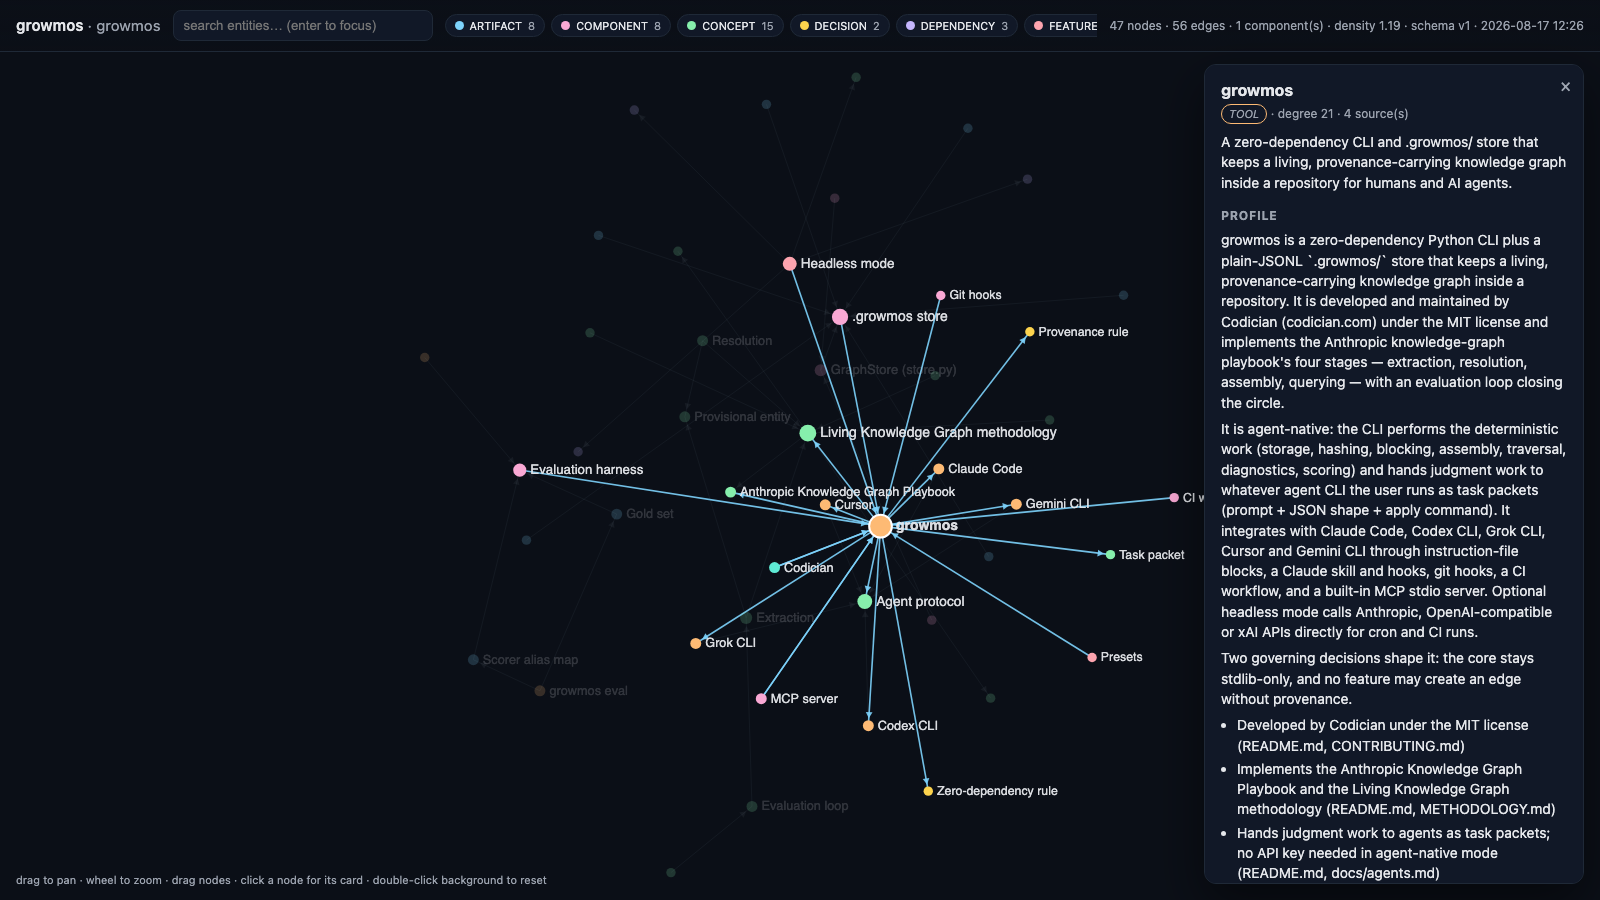
growmos view — 开发几天后,你的图谱就会呈现这样的状态:枢纽按度数调整大小、按类型着色,每条边都带有来源信息,点击即可查看档案。
多 Agent 系统和长时间运行的编码会话有一个共同的弱点:上下文窗口一结束,记忆也随之消失。RAG 能呈现内容片段,却无法将事实串联起来。知识图谱以实体为节点、以简短的动词短语关系为边,并为每条边记录来源,让多跳问题(“我们在 ADR-7 中替换的东西有哪些依赖项?由谁负责?”)可以通过图遍历来解答,为评估者提供真实依据,而不是凭感觉判断,还能在重启后保留记忆。
growmos 让它成为你代码仓库中的一个活体:
- 它会吸收你写下的内容。 文档、ADR、README、设计笔记、会话记录。内容经过哈希;只有发生变化的内容才会重新进入处理流水线(从设计上保证增量处理)。
- 它会随 Agent 的开发而成长。
growmos remember/link/journal是带有来源记录(session:2026-08-17)的单行写入方式。每次提交后,Git 钩子都会将变更的文档加入队列。 - 它会自行解析。 新名称会与规范集合进行匹配;未匹配的名称会成为单元素的临时集群(绝不会悄无声息地丢失任何内容);随后,Agent 会根据描述对临时实体进行聚类(“Edwin Aldrin” → “Buzz Aldrin”)。
- 它会给出带引用的答案。
growmos query会序列化问题周围的 k 跳子图;答案必须引用边 ID;growmos check会根据边对声明进行事实核查。 - 它会自行评估——无需手动操作。
growmos next还会发放黄金集数据包(Agent 根据源文档编写参考答案)和定期的复核数据包(根据来源核实一个节点的边),因此growmos eval(P/R/F1,原始值和解析后值)、包含 10 项的growmos doctor检查清单以及健康信号(连通分量、密度、压缩率)都能自动保持正常。每个黄金集文件都会记录复核者(agent/human)——人类可随时推翻结果,但绝不必亲自操作。 - 它会展示自身。
growmos view会打开一个独立的离线交互式浏览器(力导向布局、搜索、类型筛选、点击节点查看其概况、边和来源记录)——无需服务器,也没有依赖项。其他用途可使用growmos export --format html|json|dot|mermaid|cypher|sql。 - 它原生支持 Agent。 无需 API 密钥:CLI 负责确定性工作,并将需要判断的工作(提取、解析、摘要)作为任务数据包交给你已经在使用的任意 Agent——其中包含提示词、JSON 格式以及精确的
growmos apply …命令。可选的无头模式(growmos ingest)会调用 Anthropic / OpenAI-compatible / xAI API,用于 cron 和 CI。
安装
pip install growmos # or: pipx install growmos / uv tool install growmos
Python ≥ 3.9,无依赖项。(从源码安装:pip install .)
60 秒快速开始
cd your-repo
growmos init                 # creates .growmos/, detects your agent CLI, wires it, scans docs
growmos next                 # → first task packet (extraction of README.md)
从此以后,它会自行运行:
- Claude Code(钩子):会话开始时注入简报;如果有待处理的工作,就会告知 Agent 运行循环;每轮结束时,
Stop钩子会扫描你的文档,如果出现了新的数据包,就会让 Agent 继续运行,直到图谱更新完毕并记录到日志中。你不必提出请求。 - Codex / Grok / Cursor / Gemini(无钩子):相同的协议写在
AGENTS.md/.cursor/rules中——“如果简报显示有待处理的工作,就在停止前运行循环。”Agent 会遵循该协议;你仍然可以说*“扩展知识图谱”或“图谱对 X 有什么说法?”*。 - 键盘前无人操作: 每次提交后,Git 钩子都会将变更的文档加入队列;cron/CI 中的
growmos ingest(无头模式)则会通过 API 密钥完成整个循环。
手动运行时,循环如下:
growmos next                                 # packet: prompt + shape + apply command
#   … agent produces the JSON …
growmos apply extraction out.json --source src_ab12 --chunk 0
growmos next                                 # → resolution → profiles → gold set → review → "up to date"
growmos query "what depends on the Store and who decided that?"
growmos remember "Scheduler" --type COMPONENT --desc "Schedules jobs; depends on Store."
growmos link "Scheduler" "depends on" "Store"
growmos journal "Moved Store to Postgres (ADR-001)."
growmos check "(Alice Chen) --[owns]--> (Scheduler)"
growmos view                                 # open the interactive explorer in your browser
growmos status · growmos context · growmos doctor · growmos eval · growmos sample
与 Agent 命令行工具即插即用
| 命令行工具 | growmos init --agent … 写入的内容 | Agent 如何使用 |
|---|---|---|
| Claude Code | CLAUDE.md 块、.claude/skills/growmos/SKILL.md、.claude/settings.json 中的 SessionStart/Stop hooks、.mcp.json | 会话开始时注入上下文;遇到图谱相关请求时触发技能;MCP 工具 |
| Codex CLI | AGENTS.md 块(+ 可选的 MCP 服务) | Codex 读取 AGENTS.md;如果你更倾向于使用工具,可将 growmos mcp 作为 MCP 服务运行 |
| Grok CLI / others | AGENTS.md 块、.mcp.json | 任何遵循 AGENTS.md 或 MCP 的命令行工具 |
| Cursor | .cursor/rules/growmos.mdc(alwaysApply) | 每次聊天都会加载规则 |
| Gemini CLI | GEMINI.md 块 | 相同的协议 |
| Any file | growmos integrate file --file path/to/instructions.md | 在任意位置追加协议块 |
| git | growmos integrate hooks → post-commit、post-merge、post-checkout | 自动将更改的文档加入队列 |
| CI | growmos integrate ci → .github/workflows/growmos.yml | 每个 PR 都运行 doctor 和 eval |
| MCP | growmos integrate mcp → .mcp.json(+ .cursor/mcp.json) | 供任何 MCP 客户端使用的工具(见下文) |
growmos init --agent all 会完成上述所有操作。一切都具备幂等性(标记块、JSON 合并)。
MCP 服务(任何支持 MCP 的客户端)
growmos mcp 是一个零依赖的 MCP stdio 服务。按注册其他 MCP 服务的方式注册即可——growmos integrate mcp 会为你写入配置,也可以自行粘贴:
{
  "mcpServers": {
    "growmos": {
      "command": "growmos",
      "args": ["mcp"]
    }
  }
}
| 客户端 | 位置 |
|---|---|
| Claude Code | 仓库中的 .mcp.json(由 growmos init / integrate claude 写入),或 claude mcp add growmos -- growmos mcp |
| Cursor | .cursor/mcp.json(由 integrate cursor / integrate mcp 写入) |
| Codex CLI | ~/.codex/config.toml:[mcp_servers.growmos] command = "growmos" args = ["mcp"] |
| Gemini CLI | ~/.gemini/settings.json → mcpServers.growmos,如上所示 |
| Grok CLI / others | 其 MCP 配置,使用相同的 JSON 格式 |
mcp-name: com.codician/growmos
提供的工具:growmos_context、growmos_query、growmos_entity、growmos_search、
growmos_remember、growmos_link、growmos_journal、growmos_check、growmos_next、
growmos_apply、growmos_status、growmos_sample。注册后,Agent 会直接调用这些工具,而不是通过 shell 执行命令——例如 “Store 有哪些依赖项?” → growmos_query;“记住 Scheduler 现在使用 Kafka” → growmos_remember + growmos_link;“扩展图谱” → 循环调用 growmos_next / growmos_apply。
.growmos/ 中的内容(提交到版本库)
.growmos/
  config.json       include globs, caps (max_docs_per_run, max_entities_per_doc), provider
  schema.json       versioned entity types + predicate hints (bump on change; rows carry schema_version)
  state.json        the loop's state file: runs, pending re-summarizations, last sample/eval
  sources.jsonl     every document eaten: ref, sha256, status (pending|extracted|note|missing)
  mentions.jsonl    raw per-document extraction output (append-only provenance)
  entities.jsonl    canonical nodes (id, name, type, description, sources, mentions, provisional)
  aliases.jsonl     alias → entity (the alias map)
  relations.jsonl   edges: source, predicate, target, sources[], confidence (= corroborating docs)
  profiles/*.json   hub-node profiles (summary, key facts, time range), keyed to source-set hash
  prompts/*.md      the four playbook prompts + evaluator prompt — yours to tune
  eval/gold/*.json  hand-labelled gold sets · eval/aliases.json scorer alias map
  journal.md        the shared memo, append-only
纯 JSONL:易于比较差异、便于合并、可搜索、可查看(growmos view)且可导出
(growmos export --format html|json|dot|mermaid|cypher|sql)。存储是基础设施层面的决策,而非处理流水线层面的决策:
相同的架构可映射到 Neo4j 或三张 Postgres 表。
配置与大型项目
所有可调参数都在 .growmos/config.json 中(growmos config <key> [value])。默认值适用于普通仓库;对于大型项目,有三个重要参数:
max_docs_per_run(默认值:每天 50 个)——用于防止无人值守运行失控的限速措施,而非硬性限制。当你或你的 Agent 在执行回填时,可运行growmos next --force或growmos config max_docs_per_run 0。Agent 会收到相关说明,因此不会因此停滞。include/exclude——指定哪些文档属于知识(默认包括 README、ADR、设计文档;永不包括源代码——Agent 通过remember/link写出代码的含义)。chunk_chars(6 000)——长文档的分块大小。
完整参考(所有键、单仓多模块项目、成本说明):docs/configuration.md。
预设
growmos init --preset software|general|research|business——使用相同的提示词,并扩展实体词汇表(该手册中的五种基础类型 + 领域类型)。growmos remember --type NEWTYPE 可即时扩展架构(架构版本号会递增)。
无头/夜间模式(可选)
export ANTHROPIC_API_KEY=…    # or OPENAI_API_KEY / XAI_API_KEY, or GROWMOS_PROVIDER + GROWMOS_BASE_URL
growmos ingest --scan          # extraction (fast model) → resolution → profiles (reasoning model)
growmos query "…" --auto
遵循 playbook 的模型分工(用快速模型进行高吞吐量提取,用更强的模型进行判断)。使用 max_docs_per_run 限制每次运行的上限(默认每天 50 份;进行大规模回填时,可运行 growmos next --force 或 growmos config max_docs_per_run 0)。对于大型语料库,提示词缓存和批处理是顺理成章的下一步优化。
内置的运维规范
- 抽样检查图谱 —
growmos sample(doctor 会在 7 天后发出警告)。 - 限制提取量 —
max_docs_per_run(每天 50 份;这是减速带,不是路障:运行growmos next --force,或在进行大规模回填时运行growmos config max_docs_per_run 0)、max_entities_per_doc。 - 对架构进行版本管理 —
growmos schema bump --note … --add-type …。 - 绝不丢失名称 — 未匹配的名称会被分配到仅含一个元素的集群。
- 每条边都有溯源信息 — 并记录佐证计数。
- 仅在来源集合发生变化时重新生成摘要 — 配置文件会携带来源集合哈希值。
- 监控连通性和密度 —
growmos status会输出连通分量/密度/压缩率。
文档
- METHODOLOGY.md — 持续演进的知识图谱方法论,与工具无关
- docs/agents.md — 各 CLI 的设置和 Agent 协议
- docs/file-format.md — 存储布局和 JSON 结构
- docs/evaluation.md — 黄金集、评分、提示词调优循环
- docs/configuration.md — 所有配置项、大型项目、单体仓库
- docs/headless.md — 提供方模式、cron、CI
- examples/apollo — 通过一个脚本重建 playbook 中的 Apollo 语料库
贡献
欢迎提交 PR — 请参阅 CONTRIBUTING.md。运行 python -m unittest discover -s tests。
MIT © 2026 Codician。与 Anthropic 无关联;本项目实现的方法论综合了 Anthropic 公开的知识图谱指南和 Agent 模式写作。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。