关于 mcp-page-finder-extractor
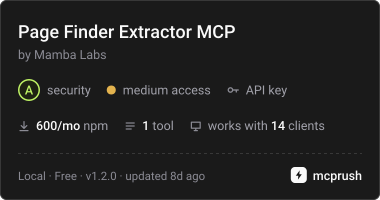
mcp-page-finder-extractor 根据域名或公司身份,在公司的公开网站上查找指定类型的页面。它支持 46 种页面类型和 11 种欧洲语言的发现词汇,也可选取结构化字段。
主要功能
- 01查找 46 种公司页面类型
- 02接受域名或公司身份
- 03支持 11 种欧洲语言的发现词汇
- 04可选提取结构化页面字段
- 05返回网址、发现方式和置信度
适用场景
- 01批量查找多家公司的定价页面
- 02查找安全或合规页面以供审核
- 03从公司公开页面提取结构化字段
MCP 相关
该 MCP 服务提供 `find_company_page` 工具,用于定位页面并可选提取字段。结果以数据集形式返回,读取公司自有网站上的公开页面。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
1收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| mode | enum | 否 | locate 返回页面 URL、查找方法和置信度。locate_and_extract 还会读取页面,并将结构化字段返回到第二个 findings 数据集中。默认值:"locate"。locate | locate_and_extract |
| domain | string | 否 | 单个公司域名,例如 stripe.com。协议和路径会被剥除。请提供此参数、domains 或 companies 中的一项。 |
| domains | array | 否 | 多个公司域名。每个域名都会返回一行,包括未找到任何内容的域名。 |
| companies | array | 否 | 已知公司名称但没有域名的公司。此路径会先进行身份解析,并将其作为单独事件收费。只要有域名,就请改用 domains。 |
| knownUrls | object | 否 | 按页面类型提供已有的 URL,例如 {"pricing": "https://stripe.com/pricing"}。对于已提供 URL 的页面类型,将跳过发现步骤,因此速度更快且结果准确。 |
| pageTypes | array | 否 | 要查找的页面类型。每种类型都会消耗一个 locate 事件并增加请求数,因此请只指定实际会用到的类型。默认值:["pricing"]。 |
| skipCache | enum | 否 | false 使用 14 天缓存。true 强制重新抓取。默认值:"false"。false | true |
| allowRender | enum | 否 | 对于不提供可读 HTML 的页面,设为 true 会打开浏览器;北欧的投资者日历大多属于此类。遇到屏蔽、CAPTCHA、登录页或 robots.txt 时,绝不会使用浏览器。默认值:"true"。true | false |
| concurrency | any | 否 | 一次处理的公司数量。对于每家公司,Actor 仍会严格地一次只发送一个请求,并在请求之间设置延迟,因此不会对任何单个网站造成不礼貌的访问。可以是数字或数字字符串。默认值:10。 |
| languageHints | array | 否 | 优先尝试的语言代码,例如 ["de","fr"]。默认情况下,词汇已涵盖全部 11 种语言;此参数只会调整顺序,不会缩减词汇范围。 |
| maxPagesPerType | any | 否 | 介于 1 和 12 之间。放弃前针对每种页面类型打开的候选页面数。调低此值会更快,但找到的内容更少。可填写数字或数字字符串。默认值:4。 |
| extractionFields | array | 否 | 适用于任意页面类型的通用提取字段菜单。仅在 locate_and_extract 模式下使用。省略此参数可提取全部字段。 |
| maxRequestsPerInput | any | 否 | 介于 5 和 200 之间。针对单个公司网站的请求硬上限。达到上限时会返回 coverage partial,而不是误报为未找到。可填写数字或数字字符串。默认值:60。 |
| extractPageTypeFields | enum | 否 | 设为 true 时,还会运行与页面类型绑定的字段映射:定价方案、申报条目及推导出的财年结束日期、认证、ATS 主机和管辖法律。仅在 locate_and_extract 模式下使用。默认值:"true"。true | false |
详细介绍
页面查找与提取 MCP 服务



提供公司域名和页面类型,它便会在该公司自己的网站上查找相应页面,并返回 URL、查找该页面的方法以及该方法的置信度。
支持 46 种页面类型。支持 11 种欧洲语言的页面发现词汇。还可选择读取页面并返回结构化字段。
封装了 Mamba Labs 的 Page Finder and Extractor actor。
安装
npx -y @mambalabsdev/mcp-page-finder-extractor
需要在 APIFY_TOKEN 中设置 Apify API 令牌。请在 console.apify.com/account/integrations 创建令牌。
Claude Desktop
{
  "mcpServers": {
    "mamba-page-finder-extractor": {
      "command": "npx",
      "args": ["-y", "@mambalabsdev/mcp-page-finder-extractor"],
      "env": {
        "APIFY_TOKEN": "your-apify-token"
      }
    }
  }
}
工具
find_company_page
| 输入 | 必填 | 功能 |
|---|---|---|
domain | 三者之一 | 单个公司域名,例如 stripe.com |
domains | 三者之一 | 多个公司域名 |
companies | 三者之一 | 按名称指定公司,格式为 {name, country?, isin?, ticker?, url?}。身份解析会先运行,并单独计费 |
pageTypes | 否 | 要查找的 46 种页面类型。默认值为 ["pricing"] |
mode | 否 | locate 用于查找 URL;locate_and_extract 还会读取页面。默认值为 locate |
knownUrls | 否 | 你已持有的 URL,按页面类型指定。对这些 URL 跳过发现流程 |
extractionFields | 否 | 与页面无关的提取字段菜单 |
extractPageTypeFields | 否 | 同时运行与页面类型关联的字段映射。默认值为 "true" |
maxPagesPerType | 否 | 每种类型打开 1 到 12 个候选页面。可填数字或数字字符串。默认值为 4 |
maxRequestsPerInput | 否 | 每家公司请求数上限为 5 到 200。可填数字或数字字符串。默认值为 60 |
allowRender | 否 | 对需要 JavaScript 的页面打开浏览器。默认值为 "true" |
languageHints | 否 | 优先尝试的语言代码。此选项会调整词汇顺序,但不会缩短词汇列表 |
max_charge_usd | 否 | 本次运行的支出上限,单位为美元。若某家公司的最坏情况下的费用会超过此上限,则不会启动该公司的处理,并会写入一条提示行。留空表示不设自定义上限 |
concurrency | 否 | 同时处理的公司数量。每家公司仍一次只发出一个请求,并会等待一段时间。可填数字或数字字符串。默认值为 10 |
skipCache | 否 | "true" 会强制重新抓取,而不使用 14 天缓存 |
46 种页面类型:pricing、demo_request、free_trial、procurement_vendor、about、leadership_team、locations、investor_relations、annual_report、governance、security_trust_center、compliance_certifications、privacy_policy、terms_of_service、dpa_subprocessors、accessibility_statement、status_page、careers、job_board、benefits、culture、documentation、api_reference、integrations、changelog、roadmap、developer_portal、blog、press_newsroom、case_studies、customers_logos、resources_library、events_webinars、podcast、media_kit、partners、reseller_channel、affiliate_program、marketplace_listing、community、contact、support_help_center、login_app、sustainability_esg、diversity_programs、giving_volunteering。
读取输出
每个输入始终对应一行平铺记录,包括未找到任何内容的输入。
{type}_url是查找到的页面,例如pricing_url。{type}_found的值为true、false或null。这些值绝不会合并。false表示已读取网站、搜索了链接图和站点地图,但页面不存在。null表示可读取的信息不足,无法作出判断。{type}_method表示查找方式:known_url、known_host、homepage_anchor、footer_anchor、section_hop、sitemap或path_guess。不同方式的精准度差异很大。{type}_confidence是针对该查找方式的评分,不会与其他方式混合。对于客户会看到的任何内容,阈值设为 0.8。path_guess的评分绝不会高于 0.6。coverage和fetch_status表示检查是否完成。信任false之前,请先查看这两个字段。
在 locate_and_extract 模式下,结构化字段会写入第二个 findings 数据集,每个字段一条记录,并通过 input_key 关联回输入,因为 11 行申报信息无法放在一个单元格中。
计费
按事件使用 Apify credits 付费。大致按免费层级计算:每找到一种页面类型收费 $0.004,每提取一个页面收费 $0.003,每解析一个公司名称收费 $0.007,另加标准的 actor 启动费用。
截至 2026-11-10 前免费:从 2026-10-26 起,三种工作事件均不收费,每次运行只需支付 actor 启动费用。上述价格将于 2026-11-10 05:01 UTC 起恢复。
实际发生的查找会计费,包括没有找到结果的查找,因为两种情况的工作量相同。未实际发生的查找不计费:无效域名、拒绝访问或 robots.txt 禁止访问时,会返回 found: null,且不收取查找费用。
除非你使用 companies 路径,否则不会收取身份解析费用。
此服务的功能与限制
它会读取公司自有网站上公开提供的页面。它会遵守每个主机的 robots.txt(包括 Crawl-delay),每个域名每次只发送一个请求,并在请求之间加入延迟;它还会发送注明自身身份的描述性用户代理。它不会伪装成浏览器,不会对请求头进行签名,也不会通过重试绕过访问限制。若页面虽公开提供,但需要 JavaScript 才能读取,则会使用浏览器渲染;但绝不会使用浏览器绕过访问控制。
个人数据。 两种页面类型可能返回有姓名的个人:contact 会返回公司在自有联系页面上公布的联系信息块,about 会返回公司在自有关于页面上公布的领导层姓名。只包含公司自行公布的信息,不推断属性,也不从其他来源查找。这些记录带有 is_personal_data: true 和 lawful_basis,因此可以通过一个条件筛选掉整类记录;或者将 contact 和 about 排除在 pageTypes 之外,这样就不会生成这些记录。若要获取公司人员名单,请改用 Team Page People Extractor。
此服务为只读。它会启动一次 actor 运行并返回数据集,不会在其他任何位置写入内容。
Mamba Labs GTM Suite
此服务是 Mamba Labs MCP 服务之一,专为市场拓展数据而设;每个服务都由 Apify Store 上的独立 actor 提供支持。如果你更愿意安装一个软件包,而非多个软件包,@mambalabsdev/mcp-gtm-suite 可通过单个服务提供整套工具。
可在 Apify Store 或 npm 浏览全部服务。
如果你想获取公司人员名单,而不是查找公司网站上的页面,请改用 Team Page People Extractor 和 Contact Classifier。此 actor 仅在联系信息块恰好位于你要求查找的页面上时,才会返回该信息块。
来源
此 actor 位于 Apify Store。此封装项目位于 github.com/mambalabsdev/mcp-page-finder-extractor,采用 MIT 许可证。
由 Mamba Labs 构建。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。