关于 Knowledge Graph RDBMS
Knowledge Graph RDBMS 是基于 SQLite/Postgres 的标签属性图数据库,适合需要嵌入式图存储、Agent 记忆或可追溯数据的开发者。它将受控写入与追加式事件日志结合,支持审计、重放和回滚。
主要功能
- 01SQLite 中的标签属性图
- 02多本体路由
- 03受控且可审计的写入
- 04事件重放与回滚
- 05提供库、CLI 和 MCP 服务
适用场景
- 01在应用中嵌入图数据存储
- 02为 Agent 保存可审计的记忆
- 03从声明式数据集重建图
- 04将关系型数据建模为实体和关系
MCP 相关
MCP 服务向客户端提供图数据访问能力。写入经过安全门控并记录到事件日志,与 CLI 和库共用同一写入路径。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx knowledge-graph-rdbmsKGRDBMS_HOMEStorage root for ontology databases and the event log. Defaults to ~/.kgrdbms.KGRDBMS_DEFAULT_ONTOLOGYName of the default ontology used when a tool call omits the `ontology` argument. Defaults to "default".本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
knowledge-graph-rdbms


完全由你掌控的嵌入式知识图谱——存于一个 SQLite 文件中。
原生支持 SQLite · 核心零依赖 · MCP 就绪 · 事件溯源 · 可逆。
将任何事物建模为实体和关系——Agent 记忆、应用本体、声明式数据集,或“数据是图的 SQLite”——无需运行 Neo4j、RDF、Docker 或独立图服务。无需 Cypher,无需 JVM,无需服务端:只需五张表和一个可复制、检查及版本管理的文件。
pip install "knowledge-graph-rdbms[mcp]"

# write a fact — auto-creates the graph in one SQLite file
kg node add person:ada --kind Person --name "Ada Lovelace"

# every write is logged; tail the log and roll any event back by id
kg events -n 5
kg revert <event_id>

# rebuild the graph as of any past moment — literal time travel
kg replay --upto 2026-01-01T00:00:00

# expose the whole graph to an AI agent over MCP
kg serve
   Agent / CLI / Python
            │
     gated + logged writes
            │
   SQLite label property graph
            │
    replay · revert · time-travel
Python 3.10+ · MIT · 核心零依赖 · 库 + 命令行 + MCP
世界并非表格中的行,而是事物、事物所属的类别,以及它们之间的关系。标签属性图恰好能捕捉这些内容,不多不少:节点(实体)、带类型的边(关系)、标签(集合)和 JSON 属性(其他一切)。无需预先设计架构;含义随着事实不断累积,而图的形态始终能灵活适应所描述的领域。
正是这种灵活性,使其成为 AI Agent 的天然基础。为 Agent 提供连接到此图的 MCP 接口,它便能发挥自身所长:读取领域信息、对学到的内容建模、关联概念,并基于结构而非文字进行推理。每次写入都会经过门控、记录归属并追加到事件日志中——因此,Agent 可以自由重塑图谱,而你仍能保留所有凭证:审计它、重放到任意时间点,或用一条命令回滚更改。这是一种记录原因而不仅仅是内容的记忆——它存于一个可嵌入的文件中,能随 Agent 运行到任何地方:笔记本电脑、CI 任务、无服务器函数或 Pi。
小巧到足以了然于心,灵活到足以为万物建模。
目录
- 适用场景
- 为什么不选 X?
- 30 秒了解核心概念
- 设计理念
- 数据模型
- 架构:三个入口,一个引擎
- 多种本体:一个控制平面
- 发现:查询前先读取架构
- 跨本体:联邦与主干
- 事件溯源:图谱是一个投影
- 安全门控:不变量与策略
- 安装
- 快速入门
- 性能
- RDF 互操作:导出、SPARQL、RDF-star
- 命令参考
- 项目结构
- 开发
- 许可证
适用场景
它适用于你想要完全掌控的图——足够小,便于检查;足够快,可以嵌入;足够透明,值得信赖:
- 嵌入式本体——随单个应用或服务一起发布的知识图谱,存于一个可复制和版本管理的文件中。
- Agent 和助手记忆——AI 可通过 MCP 读取和写入的事实,具有完整的审计跟踪,并可通过一条命令回滚。
- 声明式数据集——将基础图描述为 YAML/JSON 事实,并以确定性的方式将其重放到可查询的图中。
- “SQLite,但我的数据是图”——当关系型数据行开始描述关系时,这些数据就有了天然的归属地。
设计中心是读取密集型、单写入者、最多数百万节点——与 SQLite 本身的最佳适用场景相同:一个文件、进程内运行,无需启动服务。这能满足许多意想不到的实际工作需求。对于超出这一范围的工作负载,性能 会明确展示曲线从何处开始转折,以及专用图引擎何时值得承担额外的复杂性。
为什么不选 X?
坦诚比较——选择合适的工具,并准确了解何时该选择本工具。
为什么不选 Neo4j?
需要深度遍历、复杂的 Cypher 模式匹配、并发写入者或集群图基础设施时,选择 Neo4j。想要小型嵌入式图、Agent 记忆、可审计性、本地优先的数据掌控权以及 SQLite 部署的简便性时,选择 kgrdbms。
为什么不选 NetworkX?
NetworkX 非常适合内存中的算法。kgrdbms 则适用于持久化图状态,提供持久存储、CLI/MCP 访问、事件历史记录和回滚。
为什么不选 RDFLib?
RDFLib 适用于 RDF 图和关联数据工作流。kgrdbms 是带标签的属性图,以 RDF 作为导入/导出边界,而非三元组存储。
为什么不直接用 SQLite 表?
因为有些领域天然由实体和关系构成,而不是矩形表格。kgrdbms 让存储保持简单,同时使模型呈现图结构。
30 秒了解这个理念
带标签的属性图只需要四种基本元素:
| 基本元素 | 含义 |
|---|---|
| 节点 | 一个稳定的 ID、一个 kind 和一个用于显示的 name |
| 边 | 两个节点之间带类型的有向关系 |
| 标签 | 节点上的集合成员关系(每个节点可以有多个) |
| 属性 | 节点或边上的 JSON 键值对集合 |
将这些存入 SQLite,再添加几个索引,就得到了一个知识图谱。本项目中的其他一切——遍历、仅追加的历史记录、安全关卡、CLI、MCP 服务——都构建在这四种事实之上。
from kgrdbms import Graph

with Graph(path="demo.db") as g:
    g.add_node("person:ada", kind="Person", name="Ada Lovelace",
               labels={"Person"}, properties={"born": 1815})
    g.add_node("field:cs", kind="Field", name="Computer Science")
    g.add_edge("person:ada", "field:cs", "FOUNDED", properties={"year": 1843})

    print(g.shortest_path("person:ada", "field:cs"))
flowchart LR
    ada(["person:ada<br/>:Person<br/>born=1815"])
    cs(["field:cs<br/>:Field"])
    ada -->|"FOUNDED (year=1843)"| cs
设计理念
1. 简单可靠的存储是一项优势。 SQLite 已经解决了持久性、事务、索引和递归查询。我们不重复造轮子。一个文件,复制它即可备份;用任何 SQLite 工具打开它即可检查。
2. 模式一屏就能看完。 五张表,没有意外。你可以读完整个存储层,准确知道每条事实存在哪里。清晰易读胜过巧妙设计。
3. 状态是数据的纯函数。 你查询的是一种投影。事实来源是只追加的事实日志,以及可选的声明式种子数据。整个图谱都可以重现:state = replay(seed + log)。这一特性让审计、撤销和时间回溯都不费吹灰之力。
4. 变更受到门控,且门控分为两层。 允许 Agent 通过线路重写你的图谱时,你需要规则。有些规则是可配置的(策略);有些则必须是不可协商的(编译时内置的不变量)。我们有意将机制与策略分开。
5. 一个引擎,多种入口。 库调用、kg 命令和 MCP 工具都会通过同一条受门控、记日志的写入路径,写入同一个文件。不存在“CLI 版本”的事实或“MCP 版本”的事实——只有一份事实。
6. 只有在需要时才为速度付费。 每次单独写入都会独立提交(默认安全)。批量路径(batch()、add_nodes、add_edges)允许你在确有需要时,将吞吐量提升约 10 倍。
数据模型
图谱由五张表组成。这就是整个存储层。
erDiagram
    nodes ||--o{ node_labels : "is labeled"
    nodes ||--o{ node_properties : "has"
    nodes ||--o{ edges : "from / to"
    edges ||--o{ edge_properties : "has"

    nodes {
        text id PK
        text kind
        text name
        text created_at
    }
    node_labels {
        text node_id FK
        text label
    }
    node_properties {
        text node_id FK
        text key
        text value_json
    }
    edges {
        text id PK
        text from_node FK
        text to_node FK
        text type
    }
    edge_properties {
        text edge_id FK
        text key
        text value_json
    }
重要的设计说明:
- 边以
(from_node, type, to_node)为唯一键。 重新添加相同三元组时会更新其属性,而不是重复创建。设计上就是幂等的。 - 属性是 JSON。 值会按存储时的 JSON 类型原样往返——整数、布尔值、列表、嵌套对象。
- 外键会级联。 删除一个节点,其标签、属性和关联边也会一并删除;此行为由 SQLite 强制执行。
slug()会对自然语言 ID 去重。 两个字符串生成相同的 slug 后,就会成为同一个节点——这是将文本概念转换为稳定 ID 的关键技巧。- ID 是 CURIE。
person:ada-lovelace、company:apple——一种紧凑的 URI:prefix:reference,其中前缀是简短且稳定的类型标记,引用部分则经过 slug 处理(slug(name, prefix="person")会生成这些 ID)。如今它仍是普通字符串,只有在你发布到链接数据领域时才会扩展为完整的 IRI,因此互操作是一种低成本、可增量采用的选项,而非预先付出的代价。ID 是地址,不是记录:身份放在 ID 中,可变事实放在属性中。
第六张表 graph_events 保存只追加的历史记录(见下文)。它与其他表共用同一个文件和连接。
架构:三个入口,一个引擎
flowchart TD
    subgraph doors["front doors"]
        CLI["kg<br/>(command line)"]
        MCP["kgrdbms-mcp<br/>(MCP server)"]
        LIB["import kgrdbms<br/>(library)"]
    end

    SVC["service.py — gated + logged write path"]
    GATE{"invariants.enforce<br/>then policy.mutation_check"}
    GRAPH[("SQLite file<br/>nodes · edges · labels · properties")]
    LOG[["graph_events<br/>(append-only log)"]]

    CLI -->|writes| SVC
    MCP -->|writes| SVC
    LIB -->|writes| SVC
    SVC --> GATE
    GATE -->|"pass"| GRAPH
    GATE -->|"record fact"| LOG

    CLI -.->|reads| GRAPH
    MCP -.->|reads| GRAPH
    LIB -.->|reads / fast bulk writes| GRAPH
CLI、MCP 服务和你自己的 Python 代码都会通过 service.py 进行变更,因此安全门控和事件日志记账只存在于一个地方,不会因入口不同而出现偏差。
门控会在调用时通过各自的模块解析 invariants.enforce 和 policy.mutation_check——因此,修改策略(或在测试中对其进行 monkeypatch)后,所有入口都会同时生效。
该库还提供一条直接、快速、不记日志的路径(
g.add_node(...)、g.add_nodes(...))。它适用于批量加载,但这些写入不会记录在事件日志中——请参见事件溯源下方的警告。
多种本体,一个控制平面
一个图是引擎。控制平面让所有三个入口都能通过这一个引擎访问多个命名本体——每个本体对应一个独立的 SQLite 文件(当工作负载值得时,也可以拥有完全独立的引擎)。你指定本体名称;解析器负责路由。其他一切都不变——门控、日志和 service.py 写入路径完全相同;只是按名称选择它们作用于哪个图和日志。
flowchart TD
    subgraph doors["front doors, now ontology-aware"]
        CLI["kg --ontology coffee …"]
        MCP["kg_node_get(ontology='coffee')"]
        LIB["resolve('coffee')"]
    end
    RES["resolver.py<br/>name → (backend, events, entry)"]
    IDX[["index.db<br/>the registry — itself a kg"]]
    REG{"backend registry"}
    SQ[("sqlite · live")]
    PG[("postgres · live")]
    NEO[("neo4j · stub")]

    CLI --> RES
    MCP --> RES
    LIB --> RES
    RES -->|"look up the name"| IDX
    RES -->|"open the engine"| REG
    REG --> SQ
    REG -.-> PG
    REG -.-> NEO
- 注册表本身就是一个 kg。 本体是索引图(
<root>/index.db)中的节点,因此列出本体是一条查询,注册本体则是一次 upsert——无需新增存储机制。一个数据库的数据库。 - 默认本体就是旧文件。 省略名称,就会访问
<root>/graph.db,与之前完全相同。多本体功能纯属增量添加;没有任何内容迁移,所有现有命令的行为都保持不变。 - 隔离由文件系统实现。 每个本体都是独立文件,并拥有自己的事件日志。“Coffee 不知道 Ada”,因为它们是不同的文件——没有租户 ID、没有行过滤,也没有泄漏面。
- 引擎可插拔。 后端是一个按名称注册的工厂。
sqlite和postgres已可用;neo4j是一个占位实现,会进行路由,但在构建完成前会明确报错。大多数本体仍使用嵌入式 SQLite——这是零依赖的默认方案;而特定的重型本体可以在其工作负载(而非行数)变得复杂时,升级到专用引擎。理念 #6:“只有在你要求时才为速度付费”,从批处理推广到了整个引擎。 - 历史由控制平面而非引擎负责。 非 sqlite 本体会将其只追加事件日志保存在控制平面 SQLite 存储中(
<root>/ontologies/<slug>/events.db);引擎只是重放和撤销所作用的投影。因此,基于 Postgres 的本体仍然拥有完整的审计、时间回溯和一条命令撤销能力——图数据在 Postgres 中,历史在 SQLite 中。
pip install "knowledge-graph-rdbms[postgres]"     # the psycopg-backed engine
kg ontology create big --backend postgres \
   --location "postgresql://user:pass@host:5432/db" --stance inferential
kg --ontology big node add company:acme --kind Company --name Acme   # writes to Postgres
kg ontology create coffee --stance inferential       # register (lands in index.db)
kg ontology list                                     # the database of databases
kg --ontology coffee node add drink:latte --kind Drink --name Latte
kg --ontology coffee out drink:latte                 # scoped to that ontology
指定图有两种方式,与 MCP 的 ontology 参数对应:--ontology NAME 通过解析器路由(命名、已注册、多引擎),而
--db PATH 则保留为直接访问某个确切文件的原始逃生通道,不触及注册表。
发现:查询前先读取架构
你没有构建的图是不透明的:有哪些 kind?有哪些边类型?Person 上有哪些属性键?schema() 一次读取即可回答所有这些问题——它是查询前要读取的地图,而不是靠试探性调用来猜测。
kg schema             # kinds, edge types, labels, and property keys per kind — with counts
kg schema --samples   # + a few example ids per kind and the enum-like values a key takes
返回的是观测到的词汇表——对图中实际内容的概况,而非强制执行的架构(图仍然是无架构的)。MCP 工具 kg_schema 带有一条指令,要求先调用它,以便 Agent 在行动前先读取地图。这是一次普通读取——纯粹的 GROUP BY 聚合,无需门控;与其他读取一样,它也有联邦形式(见下文),可一次性合并多个本体中的词汇表。
跨本体:联邦读取与主干
控制平面每次调用只路由到一个本体。其上有两个层次,可同时跨多个本体工作:读取通过联邦执行,写入则经由主干处理。
flowchart TD
    Q["kg fed node person:ada"] --> FED["federation.py<br/>multithreaded fan-out"]
    FED -.->|own thread + connection| O1[("people")]
    FED -.->|own thread + connection| O2[("papers")]
    FED -.->|own thread + connection| O3[("coffee")]
    O1 --> M["merge, tagged by source<br/>(identity-aware)"]
    O2 --> M
    O3 --> M

    L["kg link same-as …"] --> BB["backbone.py"]
    BB --> IDX[["index.db — the backbone<br/>Ref + Prefix nodes, SAME_AS edges<br/>gated + logged"]]
联邦读取——跨本体、多线程
联邦读取是一种扇出操作:在各自的线程中打开每个成员本体(每个线程拥有独立连接——SQLite 会在查询期间释放 GIL,因此 N 个本体可以并发读取),并合并按来源标记的结果。没有单独的“联邦” API:每种基础读取都支持可选的 ontologies=[...] 范围参数。
from kgrdbms import Federation

fed = Federation(["people", "papers", "coffee"])   # or Federation.all()
fed.schema()                 # unioned vocabulary + a per-ontology breakdown
fed.nodes_by_kind("Person")  # [Located(ontology, node), ...] — tagged by source
fed.node("person:ada")       # every occurrence across worlds, identity-merged
kg fed schema                # union vocabulary across ALL ontologies
kg fed node person:ada       # find an id across the federation (identity-aware)
联邦读取绝不写入,也绝不会静默丢弃成员(成员发生异常时会向上传递);parallel=False 会强制按顺序执行,便于调试。
主干 — 跨本体链接
叶子边无法跨本体:它的外键位于一个文件中。跨本体结构由主干承载,而且无需新增存储——它就是不断扩展新类型的索引图。链接会为每个端点创建一个轻量级 Ref 代理节点(id <ontology>::<node_id>,在索引内部满足外键约束),并通过一条边连接;前缀注册表则会变成 Prefix 节点。两者都经过同一条受控 + 记录日志的 service 路径,因此跨域断言与叶子数据一样,都可审计、可逆转、可重放。
kg link add coffee drink:latte ENJOYED_BY people person:ada   # a typed cross-ontology edge
kg link same-as people person:ada wiki person:ada-lovelace    # "same real-world entity" (symmetric)
kg link cluster people person:ada                             # the transitive SAME_AS cluster
kg prefix add person https://kg.local/person/                 # CURIE prefix -> IRI (identity backbone)
身份按本体选择启用。 默认情况下,身份是本地的——两个本体中的 person:ada 是不同节点,直到你通过主干将它们链接起来。使用 --shared-identity 创建的本体会选择启用全局身份,此时联邦会将这类本体中相同 CURIE 的节点视为同一实体并进行合并。
事件溯源:图是一个投影
你查询的图是缓存。只追加的事件日志才是真实数据源。 每次受控变更都会记录一条可逆事实。
flowchart LR
    SEED["genesis seed<br/>(optional, declarative)"] -->|"seed once"| PROJ
    LOG[["event log<br/>append-only, never deletes a row"]] -->|"replay in order"| PROJ[("graph projection<br/>what you query")]
    PROJ -->|"every gated mutation appends a fact"| LOG
由于日志永远不会丢失任何一行,你可以同时获得以下三项:
- 审计就是考古。 每项变更都会标注时间戳和操作方。
kg events会持续输出历史记录。 - 撤销是一条事件,而非删除。
compensate()(CLI:kg revert <id>)会发出逆向事件。原始记录会保留;你可以看到它已被撤销,以及由谁撤销。 - 时间旅行。
replay(upto_ts=...)会重建截至任意过去时刻的投影。
sequenceDiagram
    participant U as you
    participant L as event log
    participant G as graph projection
    U->>L: NODE_UPSERT person:ada
    L->>G: apply → ada exists
    U->>L: revert(that event)
    L->>L: append NODE_DELETE (compensates)
    L->>G: apply → ada gone
    Note over L: both rows remain — history is intact
两种写入路径,各有用途
你可以选择每次写入与历史记录的关联方式:
- 记录日志路径 — CLI、MCP 服务和
service.*。每次变更都会经过控制并追加到日志,因此可审计、可逆转,并且可通过replay()精确重现。如果时间线就是真实数据,那么你需要的就是这条路径。 - 直接路径 —
g.add_node、g.add_nodes、g.batch()。写入直接进入投影:这是批量加载或暂存数据最快的方式。它们不会记录到日志中,因此replay()(从日志重建)不会包含这些数据。
按工作负载选择:原始加载追求速度时用直接路径,需要保留历史记录时用记录日志路径。你也可以两者兼用——kg import 会在单个 batch() 中运行记录日志路径,因此批量加载既快速又有完整记录。
重放种子只是一个可调用对象,因此你可以用 YAML/JSON 声明基础图,并在应用记录日志的增量变更前,以确定性的方式重新播种:
from kgrdbms import Graph, EventLog, replay

def genesis(g):
    # re-create your declared base facts (e.g. parsed from YAML)
    g.add_node("root", kind="Root", name="root")

replay(graph, events, genesis=genesis)              # rebuild from seed + log
replay(graph, events, genesis=genesis, upto_ts=ts)  # ...as of an instant
虚拟边:无需存储的关系
事件溯源适用于整理后的事实,但不适用于高基数、机器生成的关系层;这类关系层已经存在于某个运营数据存储中,数据新鲜且权威。每晚将 10 万条关联边镜像到图中(以及日志中),既浪费资源,又会立刻变得过时。
虚拟边则反其道而行。本体只存储一个绑定——一个边类型,以及一段 SQL,用于针对外部数据源解析其实例。在遍历时,解析器会运行该查询,并以当前节点为参数,实时合成边。零复制、始终最新、单一事实来源——用图自身的术语来说,这就是基于本体的数据访问。
flowchart LR
    Q(["kg_edges('company:NVDA')"]) --> U{"union traversal"}
    STORE[("event-sourced graph<br/>curated, logged edges")] -->|"stored edges"| U
    U -->|"for each _VirtualEdge binding"| R["resolver<br/>runs bound SQL, ? = 'NVDA'"]
    R -.->|"parameterized query"| EXT[("operational store<br/>system-of-record")]
    EXT -.->|"rows → synthesized edges<br/>_virtual: true"| R
    R --> U
    U --> OUT[/"merged edge list<br/>stored + live"/]
# Bind CO_HELD_WITH to a query over the operational store (here, any DB-API source)
kg_virtual_edge_add(
    edge_type="CO_HELD_WITH",
    query="SELECT b AS to_id, shared FROM co_held WHERE a = ?",  # '?' sqlite, '%s' postgres
    dsn_env="OUROBOROS_DSN",          # credentials by reference — never in the graph
    source="id_slug",                  # company:NVDA -> bind "NVDA"
    target_id_template="company:{value}",
    prop_cols=["shared"], directions="both", ontology="market",
)

# now ordinary traversal unions stored + virtual edges; virtual ones carry _virtual:true
kg_edges("company:NVDA", direction="out", ontology="market")
# -> [{to: "company:AMD", type: "CO_HELD_WITH", properties: {shared: 12, _virtual: true}, …}]
两个特性让它既安全又简单:
- 只读。 虚拟边绝不会被写入,因此无需经过整套受控写入/事件日志/补偿机制。绑定是配置;边则是视图。无需使任何内容失效、重放或撤销。
- 使用参数,绝不插值。 SQL 模板由操作人员编写;每个节点的值始终通过驱动程序进行绑定,绝不会格式化后写入字符串。凭据通过
dsn_env(环境变量名称)传入,因此密钥不会进入图或版本控制。
绑定以保留类型(_VirtualEdge)节点的形式存放在本体中,因此会随本体一起移动,并与模式一同进行版本管理。这为模式图/数据图拆分提供了接口:将整理后的模式(类型、契约、准则)保存在可移植的 SQLite 本体中,并直接从记录系统中虚拟化已填充的扩展——无需 ETL,也不会产生偏差。
flowchart TB
    subgraph SG["schema graph — portable SQLite ontology"]
        T["types · contracts · doctrine"]
        B["_VirtualEdge bindings<br/>(edge TYPE + SQL + dsn_env)"]
    end
    subgraph DG["data graph — virtualized extension"]
        E["live edges, resolved on traversal"]
    end
    SOR[("system-of-record<br/>operational store")]
    B -.->|"resolves against"| SOR
    SOR -.->|"synthesizes"| E
    T --- E
Iceberg 数据源:虚拟化湖仓
记录系统并不总是运营数据库。大量机器生成的关系数据会进入湖仓——存储于对象存储中的 Apache Iceberg 表,按快照进行版本管理,并由目录管理。通过设置 source_type="iceberg",虚拟边可以直接从 Iceberg 解析数据,并使用 DuckDB 作为扫描引擎:
kg_virtual_edge_add(
    edge_type="CO_HELD_WITH",
    query="SELECT b AS to_id, shared FROM co_held WHERE a = ?",  # '?' — DuckDB binds it
    source_type="iceberg",
    catalog={                          # pyiceberg catalog props; any value as
        "name": "lake",                #   "env:VAR" is resolved from the env, so
        "type": "rest",                #   tokens/keys never sit in the graph
        "uri":  "env:ICEBERG_REST_URI",
        "warehouse": "s3://lake/wh",
    },
    table="analytics.co_held",         # namespace.table — query uses the leaf name
    # snapshot_id=...,                  # optional: pin a version for time-travel
    source="id_slug", target_id_template="company:{value}",
    prop_cols=["shared"], directions="both", ontology="market",
)
这种拆分与 Iceberg 自身的架构相呼应:pyiceberg 负责标识和版本管理——它加载目录,将 namespace.table 映射到当前元数据指针(或指定的 snapshot_id),这正是模式图真正关心的层;DuckDB 负责扫描——它读取解析后的表(当前支持格式版本 2;后续版本会随扩展功能的完善而加入),并执行绑定中的参数化查询。表会以具名 DuckDB 视图的形式公开,因此查询可以针对普通表名编写——与 SQLite/Postgres 场景完全相同,解析器的参数绑定路径也保持不变。使用 iceberg extra 安装(pip install 'knowledge-graph-rdbms[iceberg]')。
pyiceberg 支持的任何目录都能使用——只需替换 catalog 字典:
| 目录 | catalog 配置 |
|---|---|
| AWS Glue | {"type": "glue"}(区域/凭据来自 AWS 凭据链) |
| S3 Tables(托管式 Iceberg) | {"type": "rest", "uri": "https://s3tables.<region>.amazonaws.com/iceberg", "warehouse": "<table-bucket-arn>", "rest.sigv4-enabled": "true", "rest.signing-name": "s3tables", "rest.signing-region": "<region>"} |
| 本地/SQL 目录 | {"type": "sql", "uri": "sqlite:///…", "warehouse": "file://…"} |
当解析后的元数据位于 s3://(S3 Tables、Glue 或普通 S3 数据湖)时,打开器会自动加载 DuckDB 的 httpfs/aws 扩展及凭据链密钥——DuckDB 会使用主机的 AWS 身份(包括 SigV4)读取托管存储。此功能已通过 AWS S3 Tables 的实时测试验证,见 tests/test_iceberg.py::test_s3tables_live_resolve(通过 KG_ICEBERG_S3TABLES_ARN 选择启用)。
工具:kg_virtual_edge_add、kg_virtual_edges_list、kg_virtual_edge_remove。
安全门:不变量与策略
当你开放图谱供实时变更时——尤其是通过 MCP 开放给 AI Agent 时——“谁有权更改什么”就成了一个实际问题。这里的答案分为两层,而且顺序很重要。
flowchart LR
    REQ(["mutation request"]) --> INV{"invariants.enforce<br/>compiled-in rule violated?"}
    INV -->|yes| E1[/"InvariantViolation<br/>(cannot be configured away)"/]
    INV -->|no| POL{"policy.mutation_check<br/>configured rule denies?"}
    POL -->|yes| E2[/"PermissionError"/]
    POL -->|no| APPLY["apply to graph"]
    APPLY --> REC[("record reversible event")]
invariants.py是机制。 此处的规则由代码强制执行,优先于策略,且无法通过配置关闭,也无法通过通信绕过。修改规则需要更改代码并重新部署。默认情况下不强制执行任何规则——不变量本质上与具体领域相关。policy.py是配置。 一个mutation_check(ctx) -> Decision函数。默认策略宽松(允许所有操作)。编辑它,封锁绝不能更改的部分。通常 5 到 10 行就足够了。
不变量会首先运行,因此宽松(或遭到破坏)的策略绝不能重新开放已被不变量封锁的内容。这正是将两者分开的全部原因。
# policy.py — append-only example: callers may add, never delete or modify
def mutation_check(ctx):
    if ctx.operation in {"node_delete", "edge_remove", "graph_clear"}:
        return Decision.deny("policy is append-only; no deletions")
    return Decision.allow()
安装
pip install knowledge-graph-rdbms            # core library + the kg CLI
pip install "knowledge-graph-rdbms[mcp]"     # + the MCP server
或者,要将 kg / kgrdbms-mcp 命令全局添加到 PATH 中
(使用 uv 或 pipx):
uv tool install "knowledge-graph-rdbms[mcp]"
# or, from a local checkout, editable:
uv tool install --editable "/path/to/knowledge-graph-rdbms[mcp]"
存储位置默认为 ~/.kgrdbms/graph.db。可使用 KGRDBMS_HOME
环境变量覆盖,也可通过每条命令的 kg --db PATH 指定,或在代码中使用
Graph(path=...) 指定。
快速入门
作为库使用
from kgrdbms import Graph

with Graph(path="demo.db") as g:
    g.add_node("person:ada", kind="Person", name="Ada Lovelace", labels={"Person"})
    g.add_node("field:cs", kind="Field", name="Computer Science")
    g.add_edge("person:ada", "field:cs", "FOUNDED", properties={"year": 1843})

    for edge, target in g.out("person:ada"):
        print(edge.type, "->", target.name)
    print(g.shortest_path("person:ada", "field:cs"))
批量加载 — 每次写入都会单独提交(每次都执行一次 fsync),因此 进行批量操作时,请选择使用一个事务,速度可提高约 10 倍:
# fastest: executemany under a single commit
g.add_nodes([
    {"id": "person:ada", "kind": "Person", "name": "Ada", "labels": ["Person"]},
    {"id": "field:cs", "kind": "Field", "name": "Computer Science"},
])
g.add_edges([("person:ada", "field:cs", "FOUNDED")])  # dicts / Edge objects work too

# or batch() — defer commits for any mix of writes, atomic rollback on error
with g.batch():
    for spec in many_specs:
        g.add_node(**spec)
作为 CLI 使用
kg 命令随核心安装包提供(标准库 argparse,无需额外
依赖)。读取操作直接访问图谱;写入操作会经过与 MCP 服务相同的安全门和事件
日志,因此 kg replay / kg revert 可以正常工作,自定义策略也会在控制台中生效。
kg node add person:ada --kind Person --name "Ada Lovelace" \
    --label Person --prop born=1815 --prop fields='["math","cs"]'
kg node add field:cs --kind Field --name "Computer Science"
kg edge add person:ada field:cs FOUNDED --prop year=1843

kg out person:ada                 # outbound edges
kg path person:ada field:cs       # shortest path
kg nodes-by-kind Person
kg stats
kg schema                         # observed vocabulary — kinds, edge types, labels, keys-per-kind
kg schema --samples               # + example ids and enum-like property values per kind
kg --json node get person:ada     # machine-readable output for piping

kg events -n 10                   # tail the event log
kg revert <event-id>              # undo a mutation (compensating event)
kg replay                         # rebuild the projection from the log

kg import graph.json              # bulk {nodes, edges} import (gated + logged)

kg ontology create coffee --stance inferential   # register a named ontology
kg ontology list                  # the registry (database of databases)
kg --ontology coffee node add drink:latte --kind Drink   # route to it
kg serve                          # launch the MCP server (needs [mcp])
--prop key=value 的值会尽可能解析为 JSON(born=1815 → int,
ok=true → bool,tags='["a"]' → list),否则保留为普通字符串。
使用 --ontology NAME 指定一个具名本体(通过解析器路由,默认使用:
默认本体);--db PATH 则可绕过解析器,直接访问指定的确切文件。
退出代码:0 成功 · 1 未找到 / 输入错误 · 2 策略拒绝 · 3
违反不变量。
作为 MCP 服务使用
pip install "knowledge-graph-rdbms[mcp]"
claude mcp add kgrdbms -- kgrdbms-mcp          # register with Claude Code
或者,手动编辑客户端配置(例如 Claude Desktop):
{ "mcpServers": { "kgrdbms": { "command": "kgrdbms-mcp" } } }
它通过一个引擎开放带 kg_ 前缀的工具。读取工具——kg_schema(词汇表,预期首先调用)、
kg_node_get、kg_find(按类型和/或标签查找)、kg_edges、kg_neighborhood、
kg_shortest_path、kg_descendants——均可选择传入 ontologies=[...],一次调用即可
跨多个本体查询。接下来是受安全门保护的写入工具(kg_node_upsert、kg_edge_add、kg_edge_remove、
kg_node_delete)、批量组合工具(kg_import——一次调用即可批量导入完整的 {nodes, edges},让
Agent 通过一次工具调用而非数十次调用填充一个本体)、跨本体骨干工具(kg_link、kg_links_of、
kg_identity、kg_prefix_add、kg_prefix_resolve)、RDF 互操作工具(kg_rdf_export、kg_rdf_import——见下文),以及
事件日志工具(kg_events_tail、kg_event_revert、kg_replay)。每次写入都会经过
不变量和策略安全门并记录下来——无论使用 CLI 还是 MCP 服务,都使用相同的引擎和文件。
每个工具都可选择传入 ontology 名称;kg_ontologies_list /
kg_ontology_create / kg_ontology_delete 则用于管理注册表——因此 Agent 可以完全通过 MCP
发现、创建、路由到不同本体并删除本体。
远程服务(需身份验证)
stdio 是连接到单个本地客户端的私有管道。若要让其他设备访问同一个图谱,例如另一台笔记本电脑、手机,或运行在 Tailscale 等私有网状网络中的 Agent,可改用 HTTP 服务。引擎和文件都相同;只改变入口传输方式,而且完全是增量式的:不加任何标志时,kg serve 仍然使用 stdio,逐字节保持不变。
# bind an HTTP transport; require a bearer token on every request
export KGRDBMS_MCP_TOKEN="$(python -c 'import secrets; print(secrets.token_urlsafe(32))')"
kg serve --transport streamable-http --host 0.0.0.0 --port 8970
--host/--port用于选择绑定地址(默认值为127.0.0.1:8000,仅限 localhost;扩大绑定范围始终需要主动选择)。--allow-host HOST用于声明客户端连接时使用的Host标头值。MCP 传输默认启用 DNS 重绑定保护,因此绑定到 localhost 以外的地址后,必须列出客户端使用的主机名/IP(绑定主机和 localhost 始终允许)。可重复指定;host:*格式可匹配任意端口;如果前置代理已验证 Host,可使用哨兵值--allow-host '*'关闭 Host 检查。例如:--allow-host graph.example.com:*。- 设置
KGRDBMS_MCP_TOKEN后,HTTP 传输(streamable-http、sse)会拒绝所有缺少匹配Authorization: Bearer <token>标头的请求(使用恒定时间比较)。令牌从环境变量中读取,而非通过标志传入,因此不会出现在 shell 历史记录或进程列表中。stdio 会忽略它。 - 不会增加任何依赖。 该检查是一个小型 ASGI 包装器,只使用标准库中的
hmac,并运行在[mcp]附加项已安装的uvicorn/starlette之上。身份验证作用于连接;不变量 + 策略门控仍会决定已连接的客户端可以更改哪些内容。
将客户端指向该 URL 即可——Claude Code 原生支持远程 HTTP MCP:
claude mcp add --transport http kgrdbms https://your-host:8970/mcp \
  --header "Authorization: Bearer $KGRDBMS_MCP_TOKEN"
{ "mcpServers": { "kgrdbms": {
    "type": "http",
    "url": "https://your-host:8970/mcp",
    "headers": { "Authorization": "Bearer ${KGRDBMS_MCP_TOKEN}" }
} } }
令牌用于验证连接身份,但不会加密连接。请通过提供传输安全的网络运行服务(WireGuard/Tailscale 网状网络,或 TLS 反向代理),不要将纯 http:// 端口暴露到开放互联网。
性能
所有数据均来自 bench/benchmark.py,该脚本会报告完整的分布情况(p50–p99),而非单次结果;下方图表则由 bench/charts.py 直接根据这些数据绘制。只需一条命令,即可在自己的机器上运行两者。(数据展示:Apple Silicon、CPython 3.14、SQLite 3.50,仅供参考,不构成承诺。)
| 操作 | 吞吐量 |
|---|---|
node(id) 点查 | 约 120,000 / 秒 |
add_node(每次调用,持久化) | 约 17,000 / 秒 |
batch() 中的 add_node | 约 157,000 / 秒 |
add_nodes([...]) 批量操作 | 约 189,000 / 秒 |
replay()(事件数/秒) | 约 26,000 / 秒 |
写入——批处理带来的提升
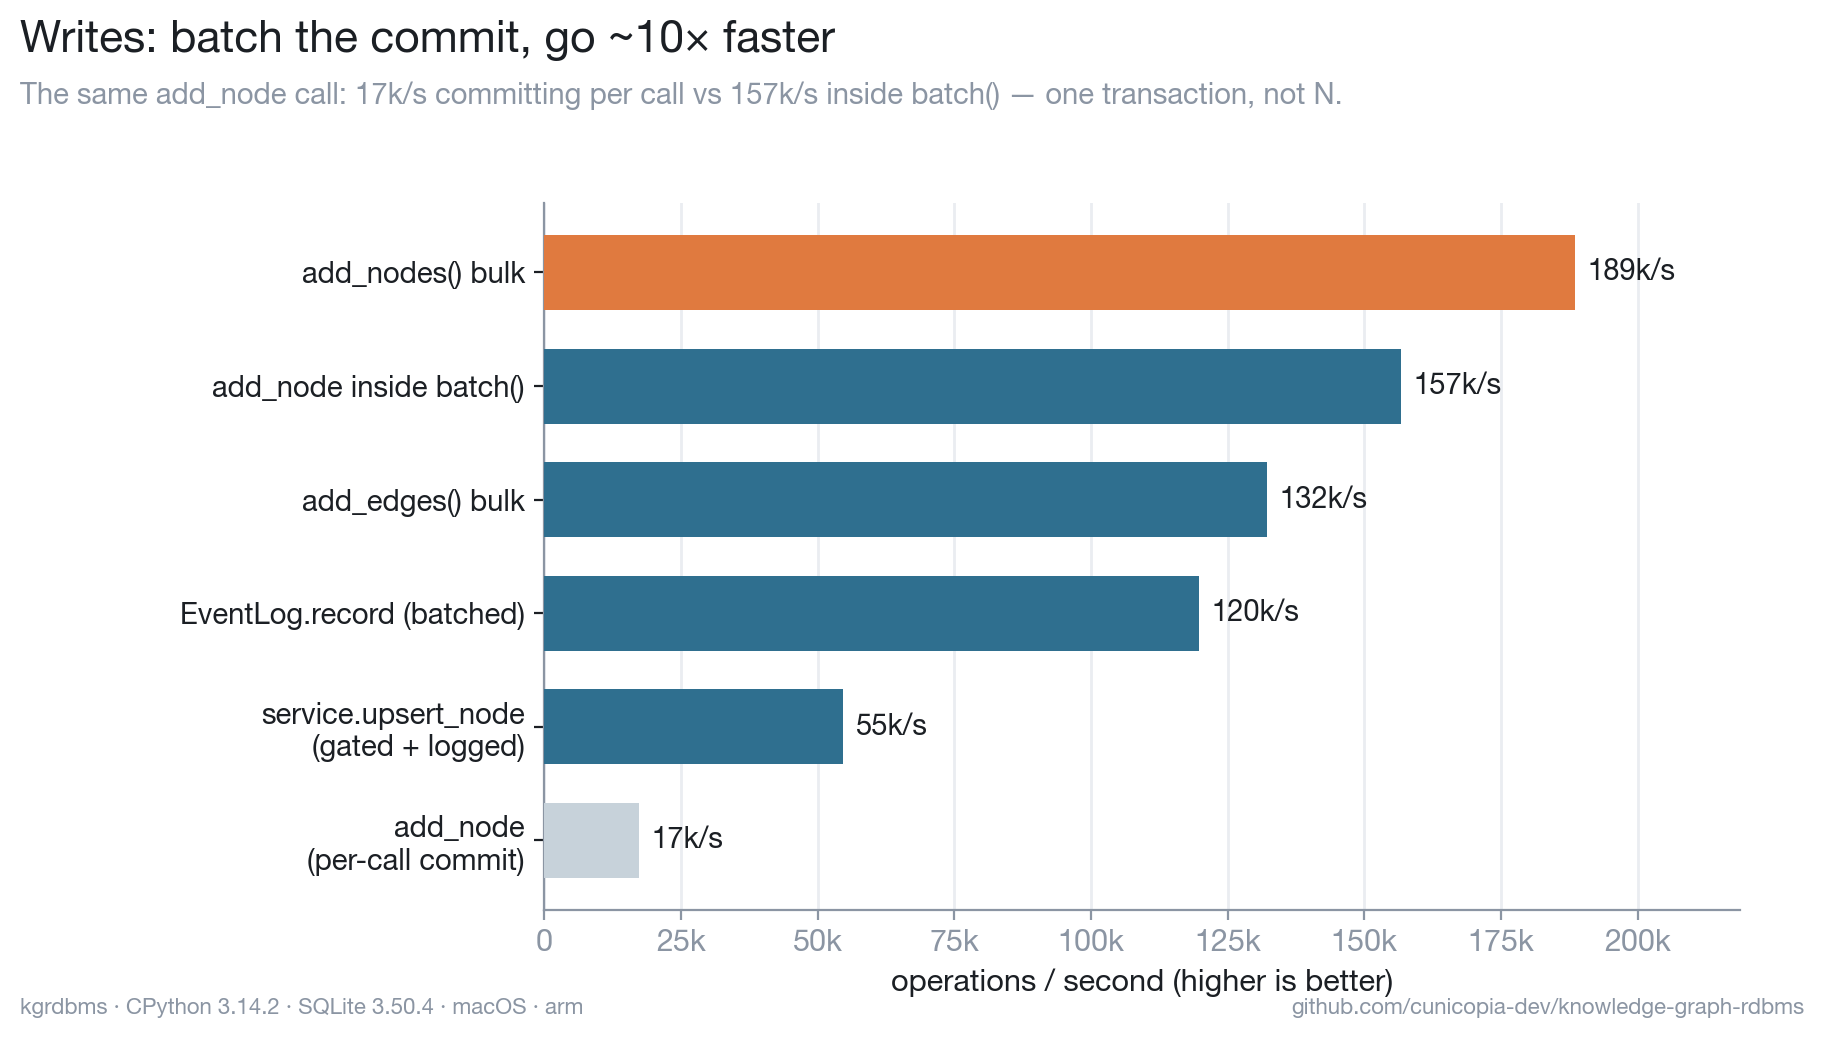
每次单独写入都会自行提交,以确保持久性。用 batch() / add_nodes / add_edges 包装批量加载操作,可将每次调用的提交合并为一个事务,速度提升约 10 倍——引擎不变,只需告知它即将进行批处理。经过门控和日志记录的路径(CLI 和 MCP 服务使用的路径)会为每次写入增加不变量 + 策略检查及事件记录,但仍能达到每秒数万次操作。
读取——速度快,尾延迟也如实呈现
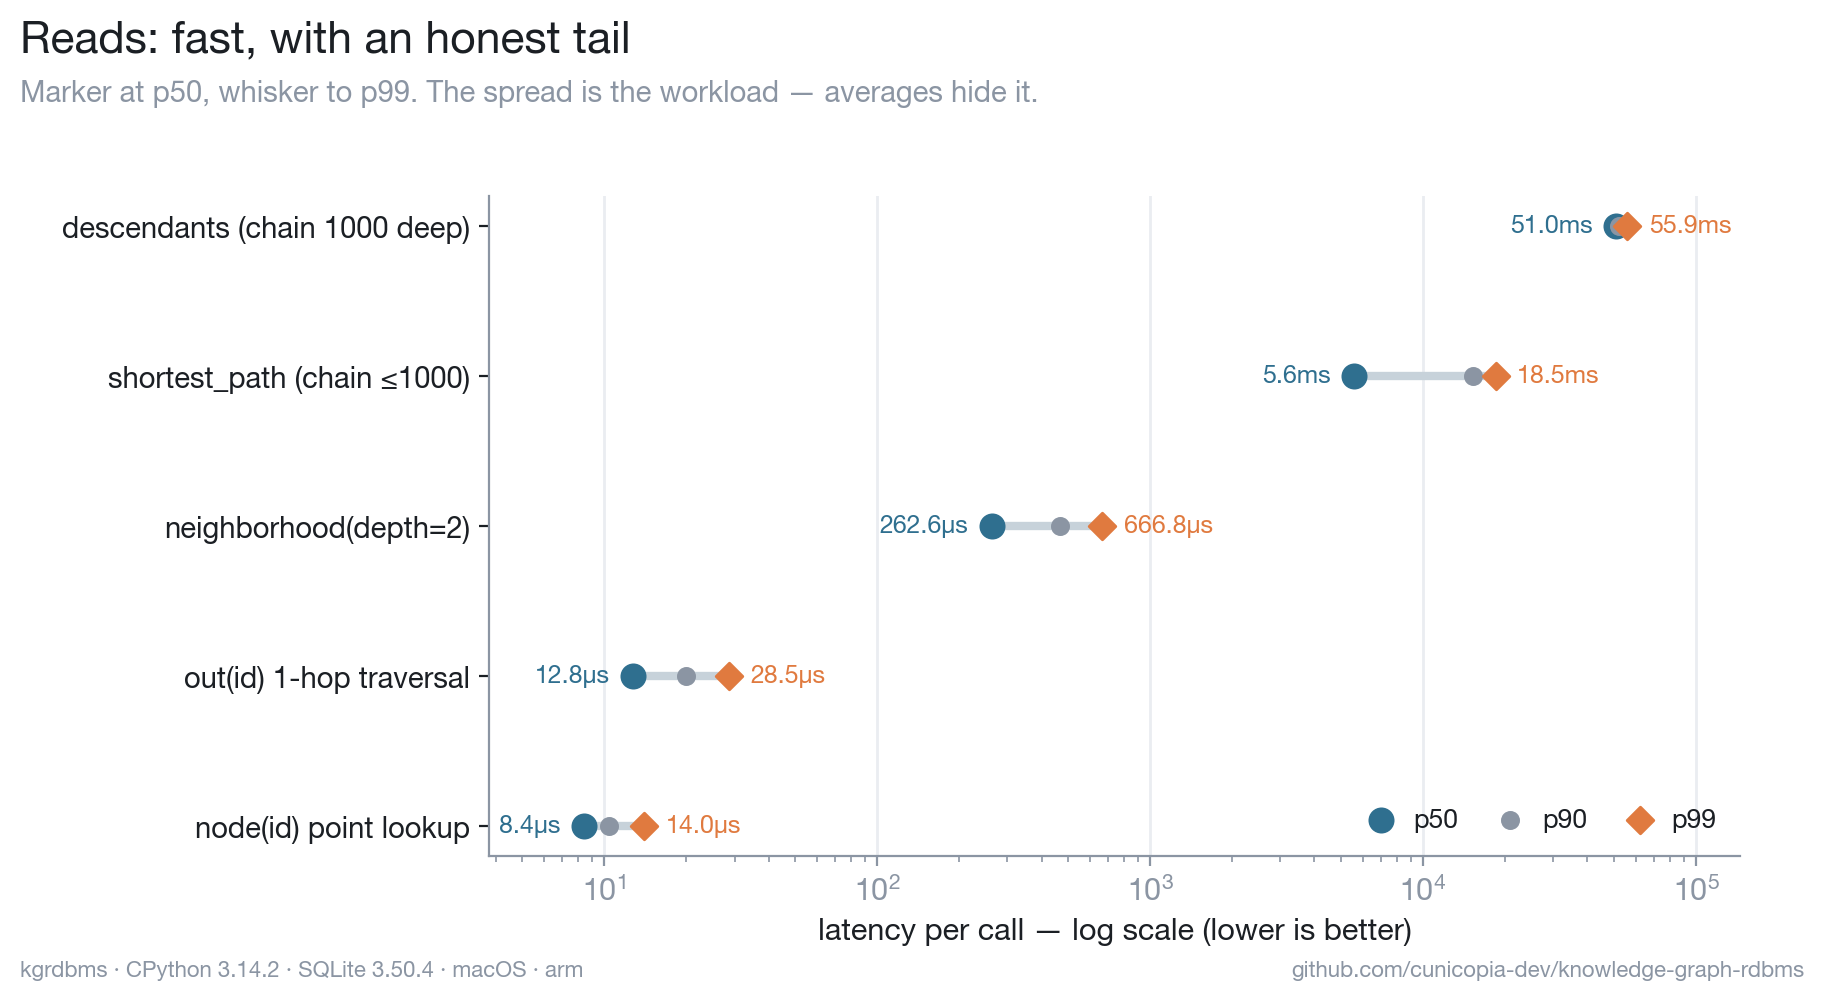
点查的延迟为个位数微秒,多节点读取则通过固定数量的查询加载整个结果集(不会出现 N+1 扩散)。图表有意展示 p50 → p99:随机选取的 shortest_path 端点会导致有些遍历很短,有些则跨越整条链;平均值会掩盖这种尾部情况。
关于运行时的说明
kgrdbms 使用 Python,而出于性能考虑,这一点并不构成问题:同一个 SQLite 引擎可运行于 CPython、Node 和 Bun 之下,因此它们之间的差距纯粹来自绑定开销——不到 2×,而且不同操作的结果也并非总是某个运行时占优。
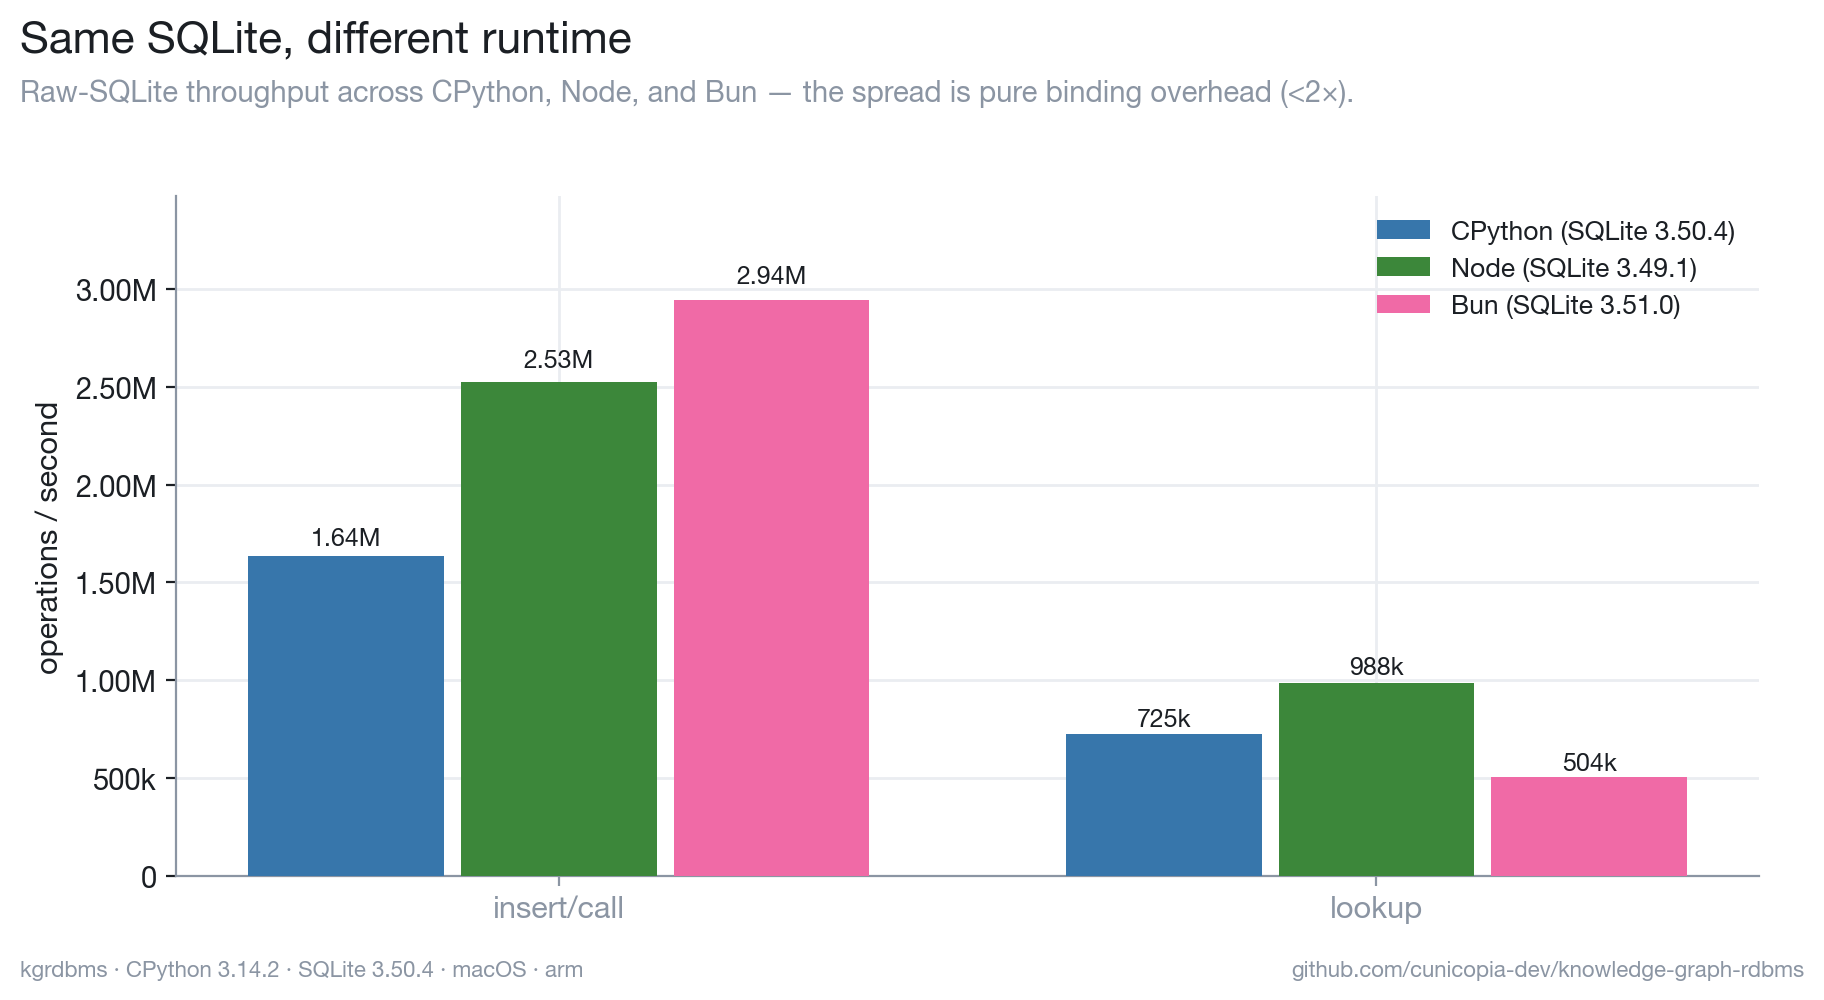
真正带来显著提升的杠杆是事务批处理(约 10×,见上图),而非语言。运行 python bench/runtimes/compare.py 即可复现。
性能曲线的拐点
我们将它与 Neo4j 进行了对比——相同的图、相同的查询、相同的方法
(完整测试套件和复现方法见 bench/neo4j/):
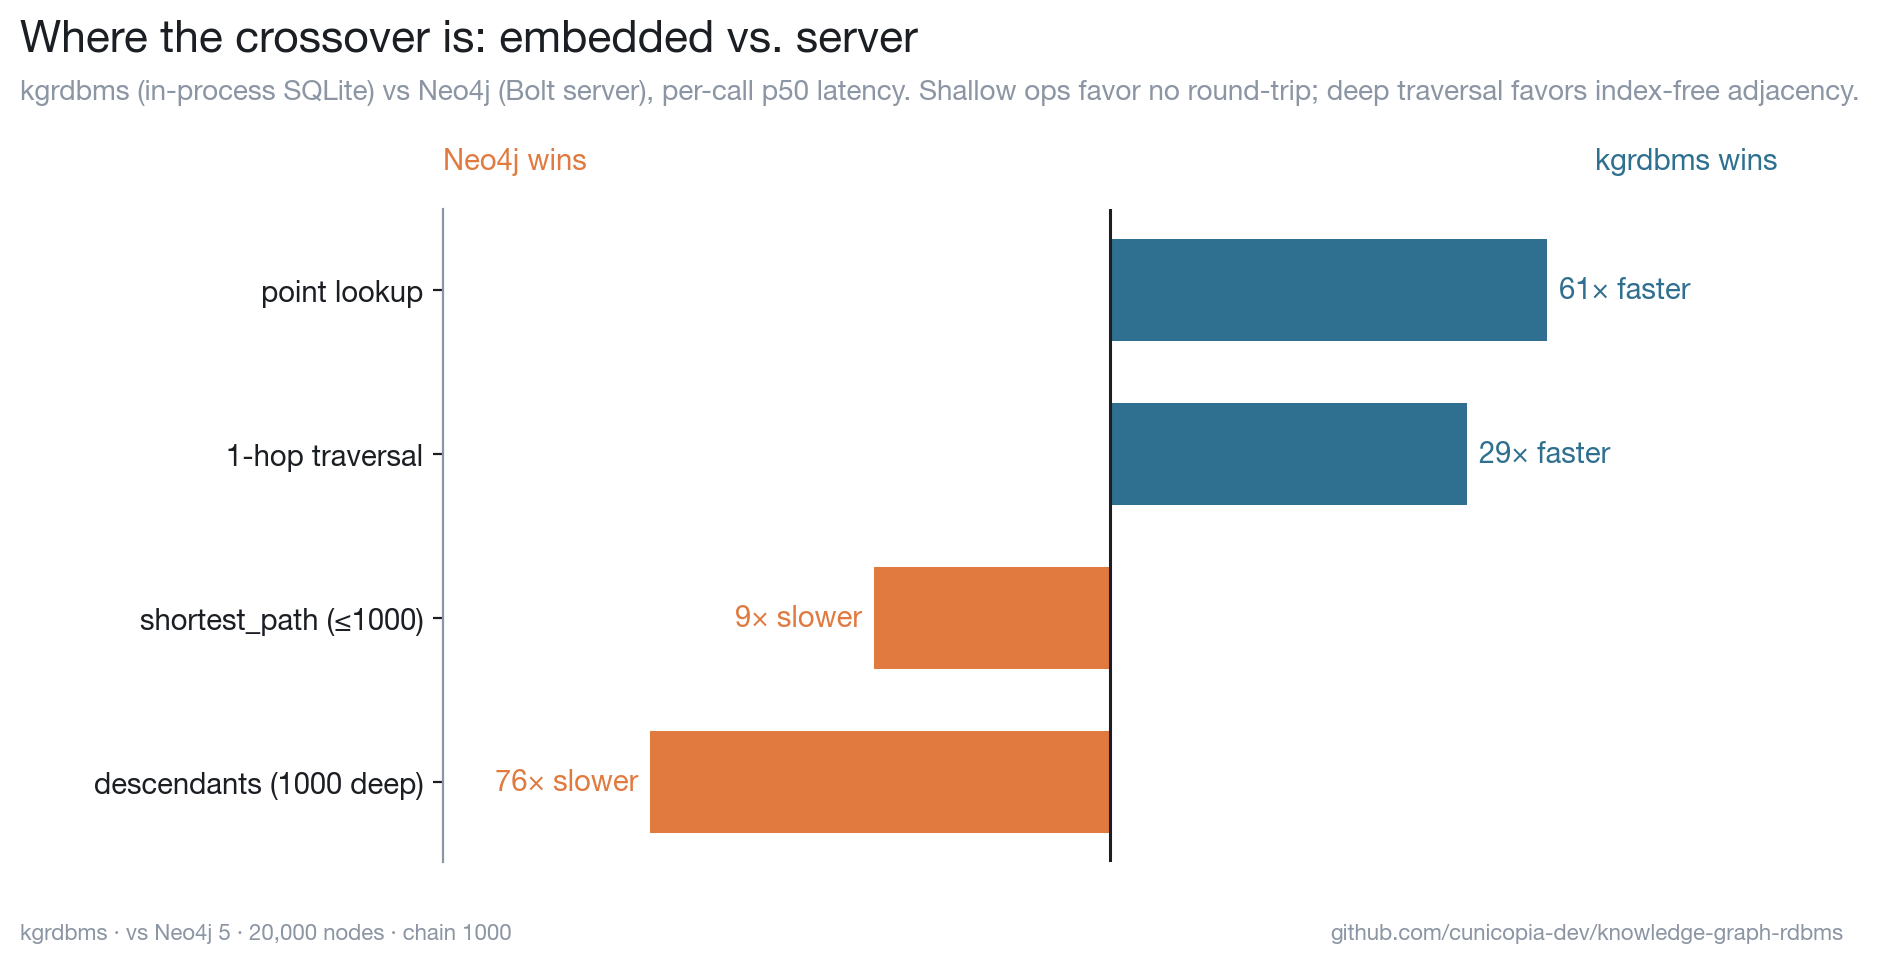
查询会被编译为基于 B-tree 索引的 SQL,因此每次遍历跳转都是一次索引查找——对于点查询和浅层遍历而言,开销极低。这里的进程内查找约为 7µs,而同一个查询在 Neo4j 中要先支付一次 Bolt 往返开销(约 0.4ms),之后才会触及数据。因此,对于构成 Agent 记忆核心的小型高频操作,嵌入式图数据库的速度快 30–60×。
专用引擎恰恰会在工作负载(而非行数)变得深层时领先:
- 深层、高扇出遍历。 无索引邻接通过节点之间的直接指针进行遍历。深度为 1,000 的遍历在 kgrdbms 中耗时约 52ms(递归 CTE + 行数据填充),而 Neo4j 约需 0.7ms;它在自身的往返开销预算内通过指针追踪完成遍历——结果反过来快了 76×。
- 复杂模式匹配。 Cypher 规划器能够以固定遍历 API 不会尝试的方式优化多模式查询。
- 并发写入和横向扩展。 单文件 SQLite 同一时间只能有一个写入者;集群引擎则不受此限。
经验法则:以读取为主、遍历较浅且节点数不超过数百万时,正是它的绝对优势领域;深层遍历或模式匹配密集型工作,则是专用引擎值得其复杂性的场景。拐点取决于工作负载的形态,并非某个神奇的固定数字——因此我们测量了自己的情况,你也可以测量自己的情况。
SQLite 与在线 Postgres 引擎的对比
由于 postgres 是在线后端,你可以对两个引擎运行相同的操作套件,直接观察往返开销
(bench/postgres/)。嵌入式 SQLite 在小型高频操作上快 30–60×——点查询在进程内完成,而 Postgres 的点查询需要支付一次本地主机往返开销。例外是那种以单次服务端查询运行的深层遍历:递归 CTE descendants 的表现是 Postgres 领先(约 0.5×),而在同一条链上执行逐跳 BFS 的 shortest_path 则慢了 67×——遍历相同,结论相反,完全取决于工作需要跨越网络多少次。Postgres 的优势在于并发和规模,而非单线程延迟;控制平面允许你将某个本体升级到 Postgres,同时让高频、浅层的本体继续使用嵌入式引擎。
RDF 互操作:导出、SPARQL、RDF-star
存储仍是标签属性图。RDF 在此只是边界格式,而非存储模型——没有三元组存储、没有 OWL,也没有内置 SPARQL 引擎。项目只采用一个 RDF 概念,因为这是唯一难以事后改造的部分:稳定身份(CURIE 节点 ID)。CURIE 终于能在这里展开为真正的 IRI。
kg rdf export                         # Turtle, to stdout (RDF-star edges)
kg rdf export --format ntriples --out graph.nt
kg rdf import graph.nt                 # back in — gated, logged, replayable
导出无需依赖。节点 ID 往返后仍是 CURIE,因为前缀绑定会让 IRI 折叠回你存储的原样:
@prefix person: <https://kg.local/person/> .
@prefix kg:     <https://kg.local/vocab#> .

person:ada a kg:Person ;
    kg:name "Ada Lovelace" ;
    prop:born "1815"^^xsd:integer ;
    rel:influences person:grace .

<< person:ada rel:influences person:grace >> prop:since "2020"^^xsd:integer .
最后一行才是关键。普通三元组没有地方附加边的属性;--edge-strategy 决定它们如何转换:
| 策略 | 边 {since: 2020} 转换为 | 适用场景 |
|---|---|---|
rdf-star(默认) | << :ada :influences :grace >> :since 2020 | 支持 star 的存储(Stardog、Jena 4.3+、Oxigraph) |
reification | 携带 s/p/o 及各项属性的 rdf:Statement 节点 | rdflib 和任何 RDF 1.1 工具 |
lossy | 原始三元组;丢弃属性(报告数量) | 只需要拓扑结构时 |
SPARQL? 可以——针对导出结果,在任何存储中都行。你不会嵌入查询引擎(那会违背零依赖、无 SPARQL 的设计);你会输出一个真正的引擎可以查询的图:
import rdflib
from kgrdbms import rdf

# rdflib is RDF 1.1 — no star — so emit reification for it:
ttl = rdf.export(graph, "turtle", rdf.IriContext(edge_strategy="reification"))
store = rdflib.Graph(); store.parse(data=ttl, format="turtle")
store.query("SELECT ?s ?o WHERE { ?s <https://kg.local/rel/influences> ?o }")
要对 rdf-star 导出结果使用 SPARQL-star,请将 Turtle 交给原生支持 star 的存储(Stardog、Jena、Oxigraph、GraphDB)。导入 Turtle/外部 RDF 需要可选扩展(pip install "knowledge-graph-rdbms[rdf]",该扩展会安装 rdflib);N-Triples 导入和所有导出均无需依赖。导入的 RDF 与其他所有写入操作一样,会经过相同的受控且有日志记录的流程,因此可审计、可重放。
命令参考
| 命令 | 功能 |
|---|---|
kg stats | 节点/边数量和数据库路径 |
kg schema [--samples] | 已观察到的词汇:类型、边类型、标签、每种类型的键 |
kg node add ID --kind K … | 创建或更新节点(受控 + 记录日志) |
kg node get ID | 获取节点 |
kg node del ID | 删除节点(级联删除边) |
kg node set-prop ID KEY VAL | 设置一个属性 |
kg node add-label ID LABEL | 添加标签 |
kg edge add FROM TO TYPE | 添加一条边 |
kg edge rm FROM TO TYPE | 删除一条边 |
kg nodes-by-kind KIND | 列出指定类型的节点 |
kg nodes-by-label LABEL | 列出带有指定标签的节点 |
kg out ID [--type T] | 出边 |
kg in ID [--type T] | 入边 |
kg path FROM TO | 最短无向路径 |
kg neighbors ID [--depth N] | N 跳范围内的节点 |
kg descendants ID TYPE | 沿一种边类型可到达的节点 |
kg events [-n N] | 查看事件日志末尾 |
kg revert EVENT_ID | 撤销一个事件(补偿事件) |
kg replay [--upto TS] | 根据日志重建投影 |
kg import FILE | 批量导入 {nodes, edges}(受控 + 记录日志) |
kg rdf export [--format F] | 序列化为 Turtle/N-Triples(RDF-star) |
kg rdf import FILE | 将 RDF 加载回来(受控 + 记录日志) |
kg ontology list | 列出已注册的本体(注册表) |
kg ontology create NAME … | 注册一个本体(--backend、--stance、--shared-identity) |
kg ontology delete NAME [--purge] | 注销一个本体(--purge 还会删除其数据) |
kg fed schema [--samples] | 所有本体的词汇并集(多线程扇出) |
kg fed stats | 联邦范围内的节点/边总数 |
kg fed nodes-by-kind KIND / nodes-by-label LABEL | 跨本体列出节点,并标记来源 |
kg fed node ID | 在联邦范围内查找 ID(考虑实体身份) |
kg link add FROM_ONT FROM TYPE TO_ONT TO | 跨本体边(基础骨架) |
kg link same-as A FROM B TO | 声明两个节点是同一实体(对称) |
kg link of ONT ID | 与某节点相连的跨本体链接 |
kg link cluster ONT ID | 传递闭包 SAME_AS 身份集群 |
kg prefix add P IRI_BASE | 将 CURIE 前缀绑定到 IRI 基础地址 |
kg prefix expand CURIE / contract IRI | 通过注册表转换 CURIE ↔ IRI |
kg serve [--transport T] | 运行 MCP 服务 |
在任何命令中添加 --json 可输出机器可读的数据。使用
--ontology NAME 指定目标图(通过解析器路由;默认:默认本体)
或使用 --db PATH(直接操作某个指定文件,不经过注册表)。
项目结构
kgrdbms/
├── graph.py        # the label property graph over SQLite (no internal deps)
├── events.py       # append-only event log: record, compensate, replay
├── policy.py       # configurable mutation policy (permissive by default)
├── invariants.py   # compiled-in invariants, checked before policy (no-op default)
├── service.py      # the shared gated + logged write path
├── resolver.py     # control plane: ontology name → (backend, events, entry) + the index
├── federation.py   # cross-ontology reads: multithreaded fan-out, identity-aware merge
├── backbone.py     # cross-ontology links + prefix/IRI registry (lives in the index graph)
├── backends/       # pluggable engine registry
│   ├── base.py     #   GraphBackend protocol + raising stub skeleton
│   ├── sqlite.py   #   live engine (adapter over Graph)
│   ├── postgres.py #   live engine (psycopg; jsonb + recursive CTEs); [postgres] extra
│   └── neo4j.py    #   stub (deep-traversal escalation)
├── rdf.py          # RDF boundary: Turtle/N-Triples export + import (RDF-star); rdflib only for [rdf] import
├── cli.py          # the `kg` command (stdlib argparse)
└── mcp_server.py   # the MCP server (optional [mcp] extra)
graph.py 不导入任何内部模块——它本身就是一个可用、无依赖的 LPG。
其他所有模块都构建于其之上;service.py 仅依赖
GraphBackend 协议,而不依赖任何具体引擎。
开发
git clone <repo> && cd knowledge-graph-rdbms
uv venv && uv pip install -e ".[dev]"
pytest                       # 107 tests
python bench/benchmark.py    # benchmark with p50–p99 (see bench/README.md)
许可证
MIT。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。