关于 yt-mem-ai
yt-mem-ai 是面向助手和 MCP 主机的本地 YouTube 视频库,可转录视频并索引文本以供搜索,也支持生成摘要、时间戳高光、问答、简报和视频串烧。
主要功能
- 01使用字幕或离线 Whisper 转录
- 02在本地保存并搜索转录文本
- 03跨视频查找带时间戳的片段
- 04跟踪订阅内容并生成简报
- 05生成摘要、问答和演示文稿
- 06制作高光文档和视频串烧
适用场景
- 01在个人视频库中搜索主题
- 02按时间戳回顾关键片段
- 03将新订阅视频整理为简报
- 04把视频转换为摘要或演示文稿
MCP 相关
yt-ai-mcp 服务通过类型化工具提供视频库功能,包括 analyze_video;MCP 主机还可使用常见视频工作流的提示词。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
yt-mem-ai — AI 助手的本地 YouTube 记忆
让 Claude、Codex、Cursor 或任何 MCP 宿主都能替你观看 YouTube:转录视频、记住视频内容、关注你的订阅频道,并将所有内容整理成摘要、带时间戳的精彩片段、问答、简报和视频集锦。 所有操作都在你的设备上完成——无需云服务,也无需 API 密钥。
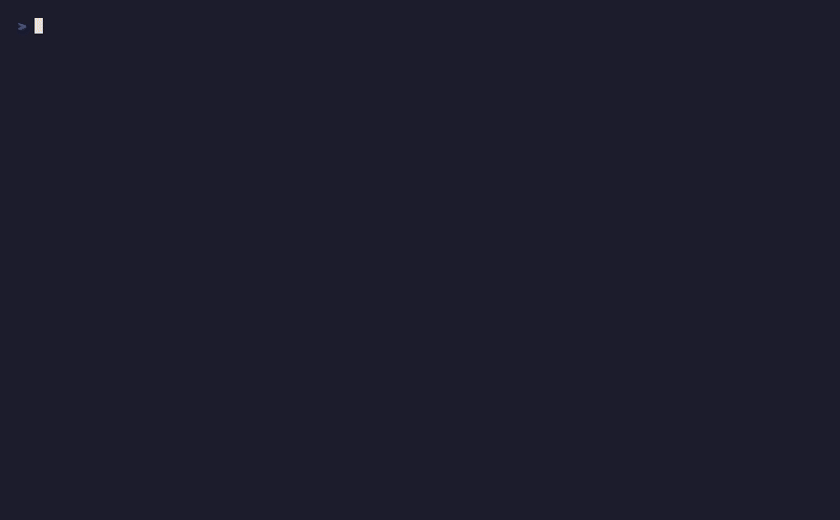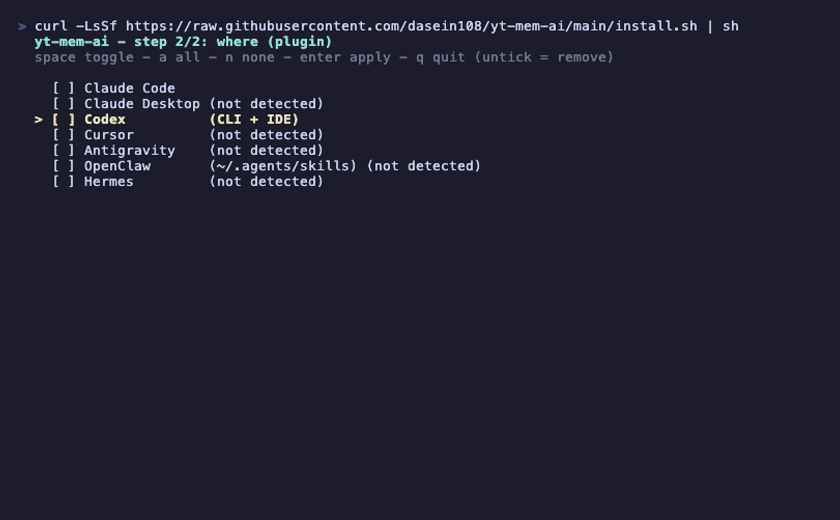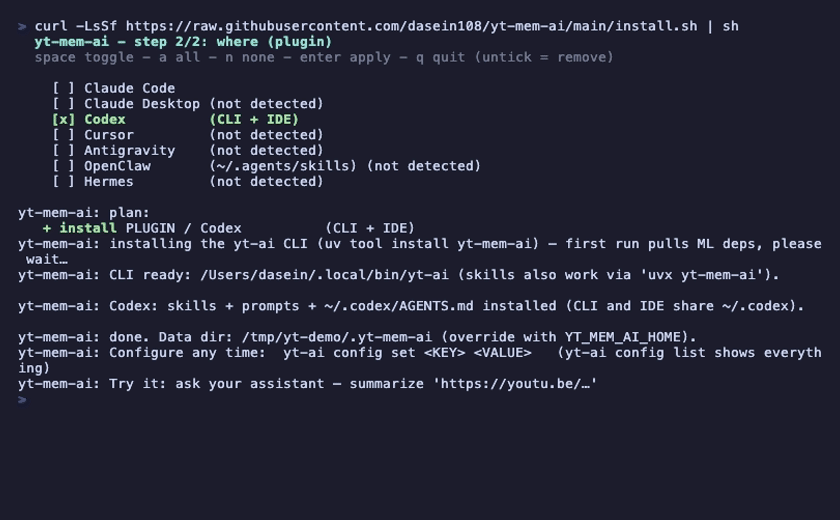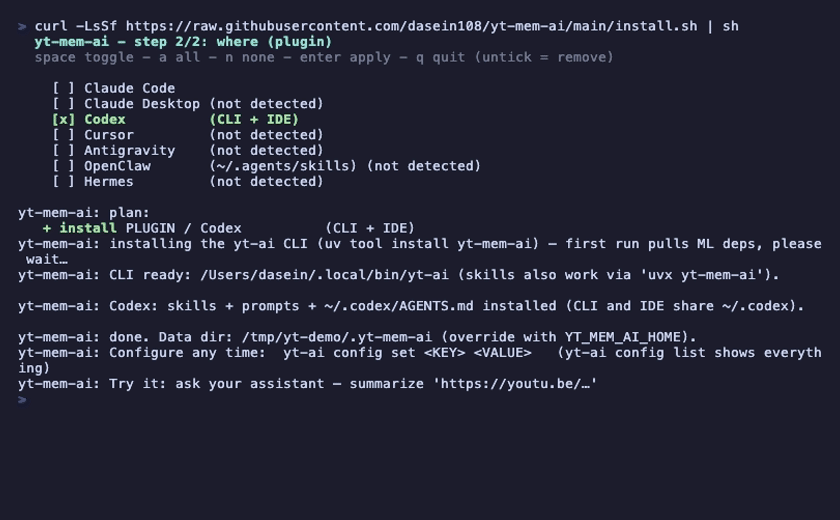
一条命令,两个问题——这里展示的是将技能接入 Codex。
示例——“根据这个视频制作一份演示文稿” (Andrej Karpathy:从氛围编程到 Agentic Engineering,Sequoia,30 分钟)→ 13 张幻灯片,PDF, 每条引述都标注了转录内容中的时间戳。只需一次请求,即可从视频生成幻灯片。
目录
功能
- 🎧 转录任意视频——有 YouTube 字幕时使用字幕(速度快,支持任何语言),没有字幕时则离线使用 Whisper。
- 🧠 记住你看过的内容——每份转录文本都会在本地存储并建立索引,让你的资料库始终可搜索。任何内容都不会离开你的设备。
- 🔎 找到对应片段——询问“那个视频里关于 X 说了什么”,即可获得答案和可直接跳转的时间戳。
- 📡 关注你的订阅频道——获取新上传的视频,并将当天的内容整理成一份简报。
- ✍️ 让助手帮你写作——生成摘要、精彩片段、问答和幻灯片,使用视频本身的语言,以及你已付费使用的模型。
- ❤️ 了解你的喜好——为视频点赞或点踩,并从自己的资料库中获取推荐。
- 🎬 还能制作媒体内容——可点击的精彩片段文档、静帧画面,以及渲染好的混剪视频。
- 🔌 兼容你的工具——Claude Code、Claude Desktop、Codex、Cursor、Antigravity、OpenClaw、Hermes:可选技能或 MCP,随你决定。
安装方法
1. 连接你的助手 ⭐
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh | sh
交互式向导会启动。选择所需功能,勾选你的应用,然后按回车:
step 1/2 — what (pick one)     step 2/2 — where (tick any)
> Plugin  skills + CLI         [x] Claude Code    [ ] Claude Desktop
  MCP     typed tools          [x] Codex          [ ] Cursor
                               [ ] Antigravity    [ ] OpenClaw   [ ] Hermes
插件让你的助手能够响应普通请求——“总结这个视频”。MCP则为它提供一组工具。不确定该选哪个?先从插件开始;之后可以再次运行向导来安装另一个。
向导会安装所需的一切,勾选你已有的内容,并移除你取消勾选的内容(它会先显示计划并征求确认)。然后重启应用并试试:*总结“https://youtu.be/…”*。
已经知道自己需要什么?跳过这些问题:
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh \
  | sh -s -- --plugin --claude-code --codex
curl -LsSf https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/install.sh \
  | sh -s -- --mcp --claude-desktop --cursor
宿主:--claude-code --claude-desktop --codex --cursor --antigravity
--openclaw --hermes,或 --all。完整标志列表和卸载说明:
integrations/README.md。想让 Agent 帮你操作?将
integrations/PROMPT.md 粘贴到任意助手中。
2. 手动配置 MCP — 添加一条配置,自动安装
无需预先安装:宿主首次启动服务时,uvx 会获取软件包,之后会将其缓存。将以下内容添加到宿主的 MCP 配置中:
{
  "mcpServers": {
    "yt-mem-ai": {
      "command": "uvx",
      "args": ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
    }
  }
}
设置就这么简单——无需路径,也无需 env 块。设置保存在
~/.yt-mem-ai/config.env 中,Agent 可以通过
config_set 工具自行写入(你也可以使用 yt-ai config set)。
| 宿主 | JSON 配置位置 |
|---|---|
| Claude Desktop | macOS:~/Library/Application Support/Claude/claude_desktop_config.json · Windows:%APPDATA%\Claude\claude_desktop_config.json — 重启应用 |
| Claude Code | claude mcp add -s user yt-mem-ai -- uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp |
| Cursor | ~/.cursor/mcp.json(重新加载 Cursor) |
| Antigravity | ~/.gemini/config/mcp_config.json(重启) |
| Codex | ~/.codex/config.toml — TOML,见下文(或 codex mcp add yt-mem-ai -- uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp) |
| OpenClaw | openclaw mcp add yt-mem-ai --command uvx --arg --from --arg 'yt-mem-ai[mcp]' --arg yt-ai-mcp(或 ~/.openclaw/openclaw.json → mcp.servers) |
| Hermes | ~/.hermes/config.yaml 中的 mcp_servers: 下 — YAML,见下文 |
# ~/.codex/config.toml
[mcp_servers.yt-mem-ai]
command = "uvx"
args = ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
# ~/.hermes/config.yaml
mcp_servers:
  yt-mem-ai:
    command: "uvx"
    args: ["--from", "yt-mem-ai[mcp]", "yt-ai-mcp"]
    enabled: true
重启应用后,工具便会显示——工具的用途请参见用法。
没有显示任何内容,或宿主超时? 首次启动会下载依赖项,耗时可能超过宿主的启动检查。先运行一次
uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp --help,然后重新打开应用。如果 宿主仍无法启动,请使用绝对路径——运行uv tool install 'yt-mem-ai[mcp]',并将which yt-ai-mcp的输出设为command,同时使用"args": [](图形界面应用通常无法在PATH中找到~/.local/bin)。
3. Claude Desktop — 技能(在应用中安装)
Desktop 将插件保存在你的 Claude 账户中,而非磁盘上,因此无法通过其他方式为你安装。只需在应用中花一分钟:
自定义(左侧边栏)→ 插件 → 个人插件 → + → 添加市场 → 从代码仓库添加 →
https://github.com/dasein108/yt-mem-ai→ 添加 → 安装yt-mem-ai
然后提问:*总结“https://youtu.be/…”*。卸载方式相同。同一 插件也适用于 claude.ai 和 Cowork。更喜欢使用工具而非技能?上述 MCP 配置同样适用于 Desktop——而且可以用脚本完成。
手动安装技能 — Codex、Cursor、Antigravity、OpenClaw、Hermes
各宿主会从用户级目录加载 SKILL.md 文件:Codex
~/.codex/skills/(CLI 和 IDE 共用,v0.117.0+)、Cursor ~/.cursor/skills/、
Antigravity ~/.gemini/skills/、OpenClaw ~/.agents/skills/、Hermes
~/.hermes/skills/(在 Hermes 中会成为 /yt 和 /yt-agent)。
# from a checkout
cp -R skills/yt skills/yt-agent ~/.codex/skills/

# without a checkout
for s in yt yt-agent; do
  mkdir -p ~/.codex/skills/$s
  curl -LsSf "https://raw.githubusercontent.com/dasein108/yt-mem-ai/main/skills/$s/SKILL.md" \
    -o ~/.codex/skills/$s/SKILL.md
done
Codex 附加内容:/yt-* 提示词(integrations/codex/prompts/*.md →
~/.codex/prompts/)以及 integrations/codex/AGENTS.md → ~/.codex/AGENTS.md。
完整指南:skills/README.md。
4. 独立使用 CLI
技能会调用它,但它本身也是一款非常实用的独立工具:
uvx yt-mem-ai --help          # zero-install run
uv tool install yt-mem-ai     # or install the persistent `yt-ai` command
需要 Python 3.11+ 和 uv;只有使用
supercut / frame 时才需要 ffmpeg。
桌面 UI 位于独立代码仓库中: yt-mem-ai-desktop — 它 依赖此软件包,并运行自己的本地 REST API。
入门
已安装并重启宿主?现在就绪。只需与助手对话 ——
技能(或 MCP 提示词 + analyze_video)会为你完成摄取:
“总结 https://youtu.be/dQw4w9WgXcQ” → 摄取视频(字幕 → whisper),然后撰写执行摘要 以及要点,使用视频本身的语言。
“用时间戳告诉我那个视频的精彩内容” → 通过语义搜索找到 3–8 个深层链接片段(
watch?v=…&t=123s)。
“我看过哪些关于检索增强生成的内容?” → 搜索你资料库中的所有转录文本,并引用相关片段。
“把我的订阅处理成今天的摘要” → 发现新上传的视频,进行摄取,并写入
digests/<DATE>.md。
更喜欢使用终端?首次运行方式相同:
yt-ai fetch 'https://www.youtube.com/watch?v=VIDEO_ID'   # ingest one video
yt-ai search "what was said about embeddings"            # search your library
yt-ai status                                             # what's in the store
所有内容都会保存到 ~/.yt-mem-ai/(资料库、日志、下载内容)。
首次运行较慢 — 这是正常的。 安装过程会拉取 ML 堆栈 (torch、LanceDB、sentence-transformers,磁盘占用约 1 GB),而首次
fetch或search还会下载嵌入模型。如果视频没有字幕,还会下载 Whisper 模型(small,约 460 MB)——字幕路径不需要它。所有内容都会缓存, 所以只会下载一次,而不是每个视频都下载。在 GUI 宿主上,首次启动 MCP 可能会因同样的原因 而超过应用的启动检查时间:在终端中运行一次uvx --from 'yt-mem-ai[mcp]' yt-ai-mcp --help以预热缓存,然后重新打开应用。
日常流程
yt-ai discover               # what's new in your subscriptions
yt-ai fetch-pending          # transcribe today's batch
然后在助手中输入:“处理订阅” → 生成每个视频的摘要和
digests/<DATE>.md;还可以选择运行
yt-ai compile --out compilations/$(date +%F).md,将当天的精彩内容整理为
可点击链接。
用法
与助手对话(技能和提示词)
此插件附带两个技能。MCP 宿主也能通过提示词使用相同的操作指南
(yt_summarize、yt_highlights、yt_qa、yt_presentation、yt_digest、
yt_review、yt_group),因此即使不支持技能,也不会损失任何功能。
| 技能 | 用途 |
|---|---|
yt | 入口 — 执行任意操作和完整流程(日常流程、单个视频);将分析交给 yt-agent |
yt-agent | 处理各类场景 — 单个视频 → 摘要 / 精彩片段 / 问答 / 演示文稿;订阅 → 每日摘要;跨视频回顾;一组视频 |
| 你说的话 | 执行的操作 | 保存位置 |
|---|---|---|
“总结 <url>” | 摄取 → 执行摘要 + 要点 | 聊天中、存储中的 save_summary |
“<url> 的精彩片段” | 3–8 个带时间戳的深层链接片段 | 聊天中 + 存储中 |
“关于 <url> 的问答” | 3–6 组有依据的问答 | 聊天中 + 存储中 |
“根据 <url> 制作演示文稿” | 以 --- 分隔的幻灯片 | slides/<id>.md |
| “处理订阅” | 发现 → 摄取 → 逐个视频分析 | digests/<DATE>.md |
| “回顾我这周看过的内容” | 跨视频主题文章 | reviews/<DATE>.md |
“分析这些视频:<ids/urls/channel>” | 摄取一组视频 → 逐个分析 + 综合分析 | groups/<label>.md |
技能不会直接访问数据库 — 它们会调用 CLI,因此相同的
工作流可在任何宿主上运行。你可以手动安装或粘贴这些技能:
skills/README.md。
MCP 工具
yt-ai-mcp 服务将整个引擎封装为类型化工具。analyze_video
是单步入口:它会摄取视频并返回转录文本,供模型自行撰写摘要。
| 类别 | 工具 | 描述 |
|---|---|---|
| 分析 | analyze_video | 摄取视频并返回转录文本(以及标题、频道、语言和现有摘要)。任何摘要/要点/问答请求都应先调用此工具。 |
| 摄取 | fetch | 下载、转录并嵌入一个视频(force、captions_only、prefer_whisper)。 |
discover | 获取订阅源中的新上传内容(增量处理;after、deep、min_duration)。 | |
fetch_pending | 批量摄取自某日期以来发现的所有内容。 | |
channel_list | 列出某频道最近上传的视频(不摄取)。 | |
| 媒体库 | search | 对所有片段进行混合/向量/FTS 搜索,并显示时间戳。 |
show | 查看一个视频的元数据和完整转录文本。 | |
list_videos | 按状态/日期/频道列出已存储的视频。 | |
status | 按生命周期状态统计数量。 | |
| 摘要 | save_summary | 保存摘要、要点和问答,供 compile 和 supercut 使用。 |
| 偏好 | like / dislike | 记录对某个视频的反馈。 |
recommend | 根据你喜欢的视频,为未评分的视频排序。 | |
| 媒体 | compile | 生成带深层链接的要点文档,并按分钟数限制预算。 |
supercut | 将选中的要点渲染为一个带标签的 mp4(需要 ffmpeg 和网络)。 | |
frame | 截取指定时间戳的静帧。 | |
| 配置 | config_list / config_get | 查看设置、值及其来源(敏感信息会隐藏)。 |
config_set / config_unset | 在聊天中更改设置——代理凭据、浏览器 Cookie、嵌入模型。 | |
| 维护 | reembed | 更改嵌入模型后,重新嵌入整个媒体库。 |
服务详情、提示词列表和原始配置:integrations/mcp/README.md。
CLI 命令
yt-ai fetch <url>            # download + transcribe + embed + store one video
yt-ai fetch <url> --captions-only  # captions only: no audio download / no whisper (fails if none)
yt-ai transcript <url>       # same pipeline
yt-ai discover               # new subscription uploads (--after/--deep/--min-duration/--json); incremental by default
yt-ai fetch-pending          # batch-fetch pending 'discovered' videos (since --since, default today; --limit)
yt-ai list                   # list stored videos (--status/--since/--json)
yt-ai show <video_id>        # metadata + transcript (--json)
yt-ai status                 # counts by status
yt-ai search "<query>"       # semantic search (--hybrid/--fts/--vector, -k N)
yt-ai save-summary <id> "<summary>" --highlights '<json>' --qa '<json>'  # persist a summary (used by skills)
yt-ai like <video_id>        # mark liked (feeds recommendations)
yt-ai dislike <video_id>     # mark disliked
yt-ai recommend              # rank your unrated fetched videos by taste (--limit/--json)
yt-ai compile                # deep-linked highlights doc, budget-bounded (--since/--max-minutes/--json/--out)
yt-ai supercut               # video reel of highlights, re-downloaded + labeled (--since/--max-minutes/--out/--keep-clips)
yt-ai frame <video_id> --at <ts>  # still frame at a timestamp (seconds or H:M:S) → frames/<id>_<s>s.png
yt-ai reembed                # re-embed all chunks with the current YT_EMBEDDING_* config
yt-ai channel-list <url>     # list a channel's recent uploads (--limit/--from/--to/--json); enumerate only
yt-ai config list            # get/set any .env setting: config get/set/unset/path (reconfigure from CLI or chat)
示例
案例:从一门由 10 部 YouTube 视频组成的课程制作一本完整的 PDF 教材。
examples/defi-crypto-options.pdf — 一本 96 页的俄语教育书籍,基于系列视频 «DeFi. Бесплатный
вводный курс по крипто-опционам»(@Menaskop)编写。
流程:确定系列中的 10 部视频 → 获取 ru-orig 字幕(yt-dlp +
浏览器 Cookie;无需 Whisper)→ 逐个视频制作结构化摘要 → 建立共享框架(术语表、符号说明、插图目录)→ 改写成 10 章(约 28.5k 个单词)
- 重绘 47 幅矢量插图 → 使用 Typst 汇编并渲染。 这不是摘要,而是从第一原理出发撰写的章节,包含详尽示例、图表、 术语表,以及每章返回对应视频的深层链接。
配置
无需任何配置即可开始——默认情况下,存储、日志和下载内容都位于 ~/.yt-mem-ai/ 下,并使用本地嵌入模型。需要时再进行调整:
| 设置 | 作用 |
|---|---|
YT_STORE_PATH | LanceDB 目录 |
YT_EMBEDDING_BACKEND | local(sentence-transformers)或 openai |
YT_EMBEDDING_MODEL | 例如,非英语视频库可使用 paraphrase-multilingual-MiniLM-L12-v2 |
OPENAI_API_KEY | 仅用于 openai 嵌入后端 |
YT_COOKIES_BROWSER | chrome/firefox/…——解决 YouTube 的“确认你不是机器人”提示 |
YT_CAPTION_LANGS | 首选字幕语言(默认 en,没有匹配项时使用任意字幕轨道) |
WEBSHARE_PROXY_*、YT_USE_WEBSHARE | 可选的轮换代理 |
YT_CHUNK_TARGET_S | 嵌入的分块时长 |
通过命令行或 Agent 配置——无需手动编辑 .env,使用 yt-ai config(或 MCP config_* 工具,让 Agent 能在聊天中自行重新配置):
yt-ai config list                  # every setting, value, and source
yt-ai config set WEBSHARE_PROXY_USERNAME <user>
yt-ai config set WEBSHARE_PROXY_PASSWORD <pass>
yt-ai config set YT_EMBEDDING_MODEL paraphrase-multilingual-MiniLM-L12-v2
yt-ai config get OPENAI_API_KEY    # secrets masked (--reveal to show)
默认情况下,set 会写入全局配置文件(~/.yt-mem-ai/config.env),因此无论 MCP 服务的工作目录是什么,它都能读取该文件;--project 则会写入 ./.env。优先级:进程环境变量 > 项目 .env > 全局配置文件;config list 会显示每个值的来源。
内部原理
以下内容均为选读——内部实现、调优和开发者说明。
工作原理
yt-dlp → captions (or Whisper) → chunks → embeddings → LanceDB
                                                          ↓
                     your assistant reads + writes summaries back
CLI 负责繁重的 I/O 操作并管理存储;技能和 MCP 工具只是轻量级调用方。视频会依次经历 discovered → downloaded → transcribed → summarized;直播流会获得终止状态 stream,并在批量导入时跳过(需要时可使用 yt-ai fetch <url> 转录)。数据存储在嵌入式 LanceDB 中(包含 videos、channels、transcripts、chunks、summaries、feedback),每个分块都有向量,并配有全文索引——这让混合搜索成为可能。
命令详情
评分与推荐——为已获取的视频点赞或点踩,然后运行 yt-ai recommend,根据用户喜欢的视频(减去不喜欢的视频)及其转录嵌入,为其余视频排序。尚未点赞任何视频时,则按发布时间从近到远排序。
discover 是增量式的——它通过一次扁平调用拉取最新的动态条目(受 YT_DISCOVER_FEED_LIMIT 限制),为每条内容标注一个近似时间戳,并仅保留比上次运行的最高时间戳早 1 小时以内的最新条目(由 YT_DISCOVER_OVERLAP_S 控制),以免按小时取整的日期导致遗漏边界视频。已处理的视频会被过滤。--after YYYY-MM-DD 可覆盖截止时间。
compile 与 supercut 的区别——compile 会将当天的精彩片段渲染为 Markdown 深度链接(watch?v=ID&t=<start>s),按视频从新到旧排列,并受 --max-minutes 限制(默认 20 分钟);它会即时生成,除非指定 --out,否则输出到 stdout。supercut 会以 720p 重新下载每段精彩片段,叠加标签,并将所有片段拼接到 supercuts/<date>.mp4,同时生成 .refs.md 附属文件,列出来源(以及失败后跳过的片段)——速度慢得多,需要网络和 ffmpeg,但生成的视频可供分享。
嵌入、代理及其他调优
嵌入: YT_EMBEDDING_BACKEND=local|openai。本地模式使用
sentence-transformers(YT_EMBEDDING_MODEL,默认值为 all-MiniLM-L6-v2)——对于
非英语资料库,请设置为 paraphrase-multilingual-MiniLM-L12-v2(384 维,支持 50 多种
语言),以实现跨语言语义搜索。openai 模式使用
text-embedding-3-small|large(需要 OPENAI_API_KEY)。更改模型后,
运行 yt-ai reembed 迁移现有资料库(重新嵌入所有分块;无需重新获取)。
代理 / VLESS: YT_USE_WEBSHARE 默认为关闭。如果你已经使用
系统级代理 / VPN(VLESS/Xray 等),请保持关闭——流量会经由该
隧道传输。在其上叠加 Webshare 代理会导致通过身份验证的
订阅源失效(其 CONNECT 隧道会返回 405)。只有在没有其他代理且 YouTube 对你的
原始 IP 限速时,才设置 YT_USE_WEBSHARE=true。发现功能调优:YT_DISCOVER_FEED_LIMIT(最新内容数量上限,默认值为 60)、
YT_DISCOVER_OVERLAP_S(增量重叠时长,默认值为 3600)、YT_DISCOVER_TIMEOUT_S。
在检出副本中工作? 运行 uv sync --extra dev,然后运行 cp .env.example .env
即可将设置保存在项目本地,而不是 ~/.yt-mem-ai/config.env 中。
作为 Python 包使用
yt-mem-ai 是一个常规库——CLI 是对 run_*
核心函数的轻量 Typer 封装,你可以直接调用这些函数。一切都在本地运行:无需服务,无需 API 密钥(除非
你选择 openai 嵌入后端)。
pip install yt-mem-ai # or: uv add yt-mem-ai
from dataclasses import replace
from pathlib import Path

from yt_mem_ai.config import load_config
from yt_mem_ai.cli import open_store, run_fetch, run_search, run_list, run_save_summary
from yt_mem_ai.store import db as store

# Config comes from ~/.yt-mem-ai/config.env < ./.env < process env.
# Override any field in code (Config is a frozen dataclass):
cfg = replace(load_config(), store_path=Path("~/.yt-mem-ai/lance").expanduser())

db = open_store(cfg)          # opens LanceDB + creates tables/indexes once
                              # pass db=... to every run_* call to reuse it

# 1. Ingest: download → transcribe (captions → whisper) → chunk → embed → store
video_id = run_fetch("https://www.youtube.com/watch?v=dQw4w9WgXcQ", cfg, db=db)
# captions only (no audio download, no whisper):
# video_id = run_fetch(url, cfg, db=db, captions_only=True)

# 2. Read what was stored
video = store.get_video(db, video_id)
text = store.get_transcript_text(db, video_id)
print(video.title, video.channel, video.duration_s, len(text or ""))

for c in store.list_chunks(db, video_id)[:3]:
    print(f"[{c['start_s']:.0f}s] {c['text'][:80]}")

# 3. Semantic search across the whole library (hybrid | vector | fts)
for hit in run_search(cfg, "retrieval augmented generation", mode="hybrid", k=5, db=db):
    print(hit["video_id"], hit["start_s"], hit["text"][:100])

# 4. Bring your own LLM: summarize the transcript however you like, then persist
summary_md = my_llm(text)                       # any model / provider
run_save_summary(
    cfg, video_id, summary_md,
    highlights_json='[{"t": 42, "text": "key moment"}]',
    qa_json='[{"q": "What is it about?", "a": "..."}]',
    db=db,
)
print(store.get_summary(db, video_id))

# 5. Library queries
for v in run_list(cfg, status="transcribed", since="2026-01-01", db=db):
    print(v.video_id, v.published_at, v.title)
其他核心函数的形式相同(run_x(cfg, ..., db=db)):run_discover、
run_fetch_pending、run_channel_list、run_recommend、run_feedback、
run_compile、run_supercut、run_frame、run_reembed。也可以导入更底层的组件——yt_mem_ai.download.download、yt_mem_ai.transcript.get_transcript、
yt_mem_ai.store.embeddings.build_embedder / chunk_segments、
yt_mem_ai.store.db(LanceDB 增删改查 + search_chunks)。
存储使用纯 LanceDB,因此你也可以直接打开:
import lancedb
from pathlib import Path
tbl = lancedb.connect(Path("~/.yt-mem-ai/lance").expanduser()).open_table("chunks")
df = tbl.to_pandas()      # video_id, start_s, end_s, text, vector
日志记录
CLI 会将结构化 JSON 事件写入 logs/common.jsonl(通过
obs.log_event/blog)——每行一个对象,{ts, source, level, event, msg, ...ctx}。使用 YT_LOG_FILE 覆盖路径;该文件已被 gitignore 排除。使用 jq 查看:
jq -c 'select(.level=="error")' logs/common.jsonl   # every error
tail -f logs/common.jsonl | jq -c '{ts,event,msg}'  # live tail, compact
测试
uv run pytest -q                       # offline unit tests (fake embedder)
YT_RUN_INTEGRATION=1 uv run pytest -q  # + real sentence-transformers integration
发布(维护者)
版本取自 git 标签(hatch-vcs)。创建标签、构建并发布:
git tag -a vX.Y.Z -m "vX.Y.Z" && git push origin vX.Y.Z
uv build                                # → dist/ (sdist + wheel)
sh scripts/publish.sh dist/yt_mem_ai-X.Y.Z*   # uploads to PyPI
scripts/publish.sh 会在需要时从 .env(已被 gitignore 排除)加载
UV_PUBLISH_TOKEN,因此无需每次都导出——在 .env 中添加一次 UV_PUBLISH_TOKEN=pypi-…
即可(参见 .env.example)。也可以使用:set -a; . ./.env; set +a; uv publish dist/*。
如果令牌泄露,请在 PyPI 上轮换令牌。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。