关于 Heddle
Heddle 是面向编码 Agent 的 MCP 服务,将软件单元表示为带依赖关系的内容寻址契约。它缓存验证结果、计算变更影响范围,并为代码生成提供精简上下文。README 标明该项目此前以 heddle-mcp 名称发布,现已称为 Hashloom。
主要功能
- 01以 YAML 契约描述软件单元
- 02按契约与依赖哈希缓存验证结果
- 03计算直接及传递依赖的失效范围
- 04提供契约、依赖签名和调用方上下文包
- 05报告契约状态与验证缓存情况
适用场景
- 01按契约生成或重生成代码
- 02契约变更后定位受影响单元
- 03重复验证时复用未失效的测试结果
MCP 相关
作为 MCP 服务,它提供读取和写入契约、查询依赖影响范围、验证实现以及查看状态的工具,供编码 Agent 使用。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
hashloom

Hashloom 将软件单元视为内容寻址的契约,而不是文件。 一个让 Agent 以低成本反复重新生成的 MCP 服务。
由于契约采用内容寻址且感知依赖关系,Agent 可以复用验证结果、精确计算影响范围,并根据几百个 token 的上下文重新生成代码,而不必重新读取整个文件。构建系统会询问哪些文件发生了变化。Hashloom 会询问哪些软件义务发生了变化。
这个名字是一个新造词,准确地说明了它的含义:一台由哈希值确定键位的织机。在织机上,经线是固定而持久的线,梭子则将一次性的纬线织入其中。契约是经线。代码是纬线。(在 0.3.3 之前,这个项目以 heddle-mcp 的名称发布;引擎并未改变。)
问题
Agent 不断花费成本重新发现软件结构。规范驱动开发工具将规范作为持久产物,并让代码可以重新生成,但它们基于普通文件运行,因此每次重新生成都要重新推导项目已知的信息:
- 获取上下文的成本很高。 重新生成一个单元意味着重新读取整个规范文件和源文件:要花费数千个 token,才能了解几百个 token 就能传达的信息。
- 验证结果未缓存。 每次重新生成都会重新运行(并重新读取输出)全部相关测试,即使单元的契约没有变化也不例外。
- 影响范围取决于约定,而非机制。 规范发生变化时,没有任何机制能准确告知 Agent 哪些依赖项已失效。
模型
Hashloom 将每个软件单元视为具有明确依赖关系的内容寻址契约,而不是文件。契约是一个简短的 YAML 规范(签名、不变量、示例、依赖项名称);其背后的实现则是可以重新生成的纬线。由于每个契约都有哈希值,且依赖项均有名称,Agent 不必再从文件中反复推导结构,hashloom 可以一次性计算并提供这些结构。
效果
这一模型带来三项纯粹由机制实现的优势:
- 验证缓存。 绿色测试结果以契约、实现和依赖项的哈希值为键,之后从缓存中提供,直到其中某项发生变化。只有缓存未命中时才会运行 pytest。
- 机械化计算影响范围。 契约变更时,会按哈希值报告精确的失效依赖项集合,包括传递依赖,而不是依靠约定。
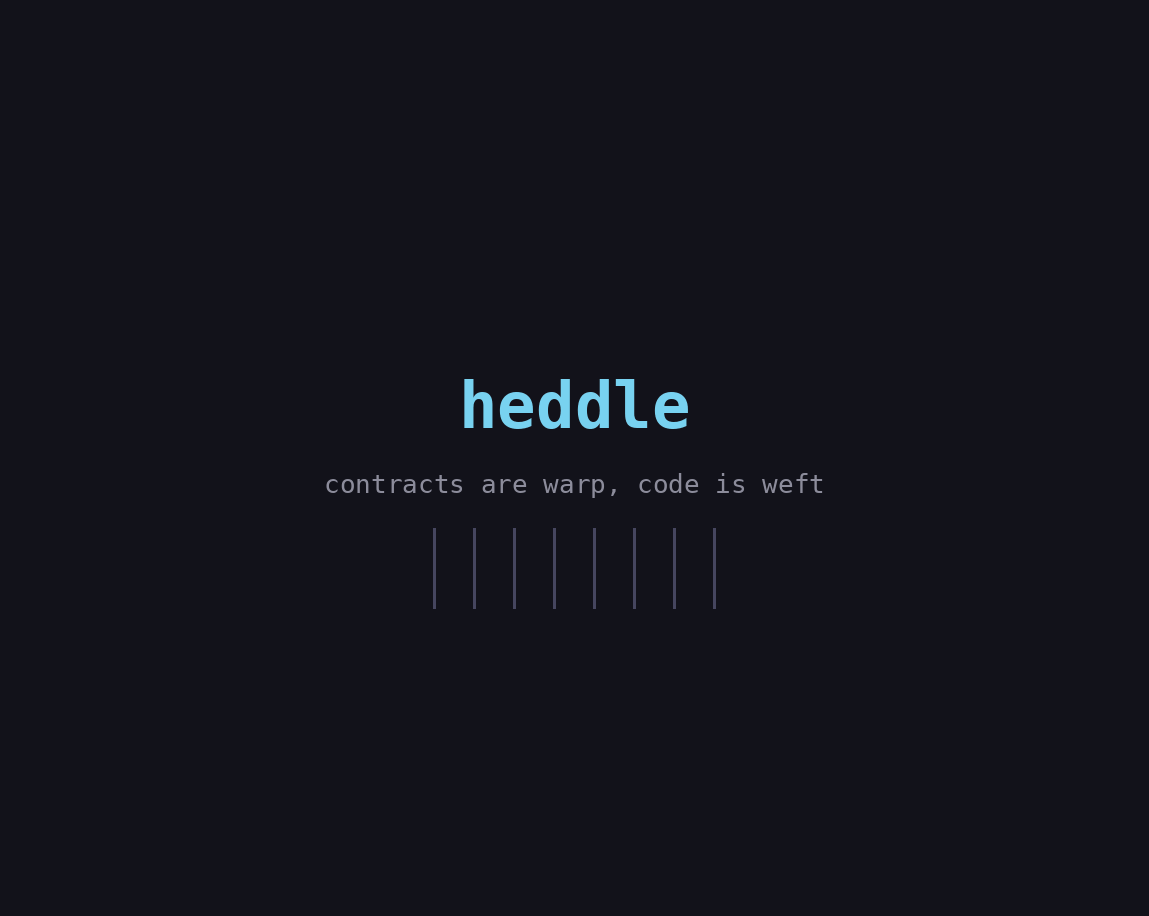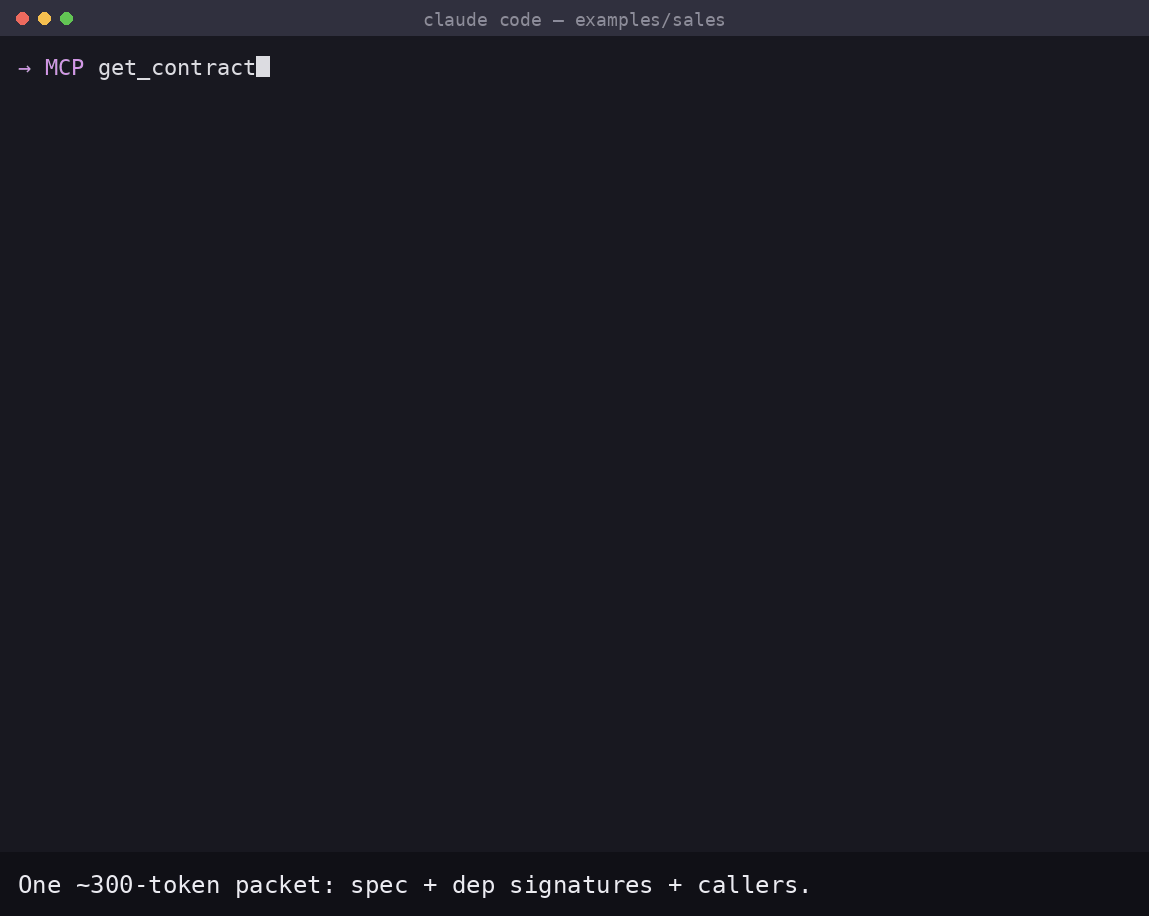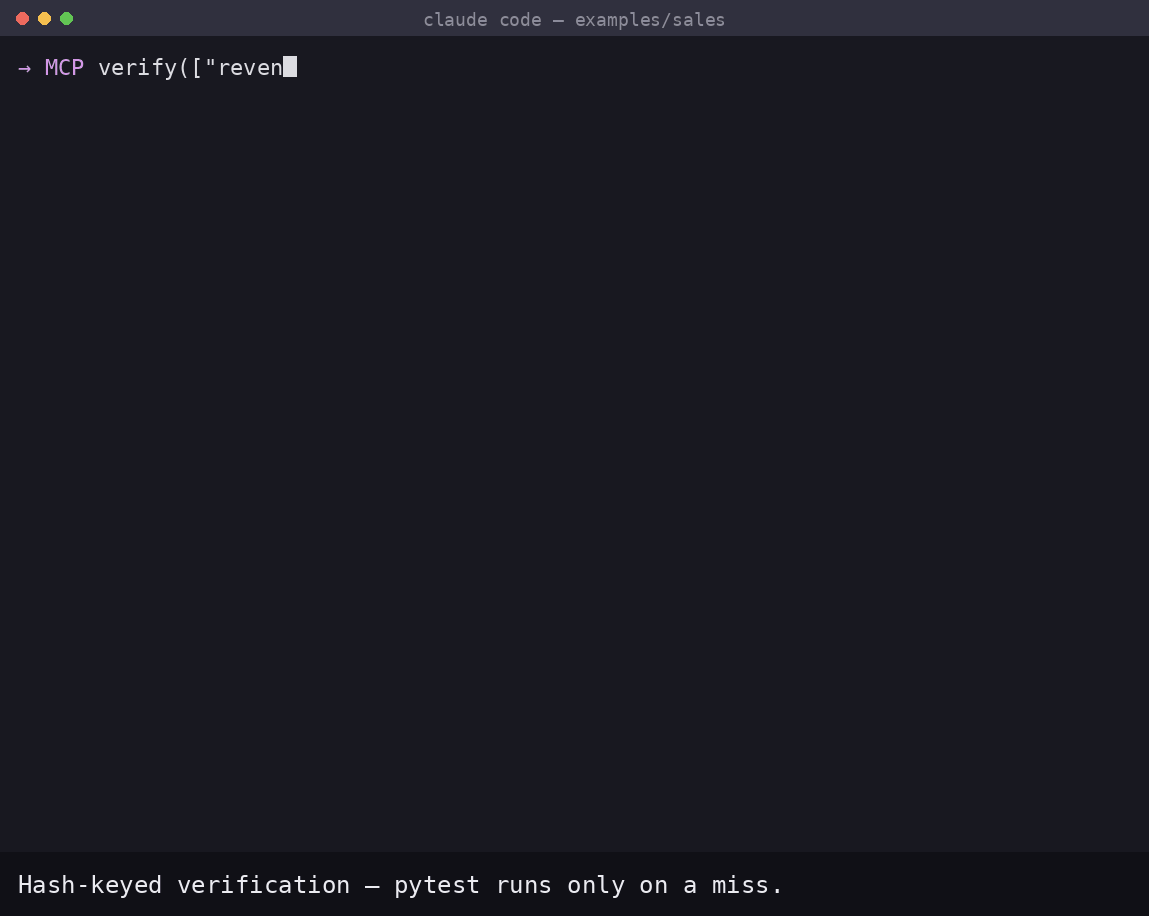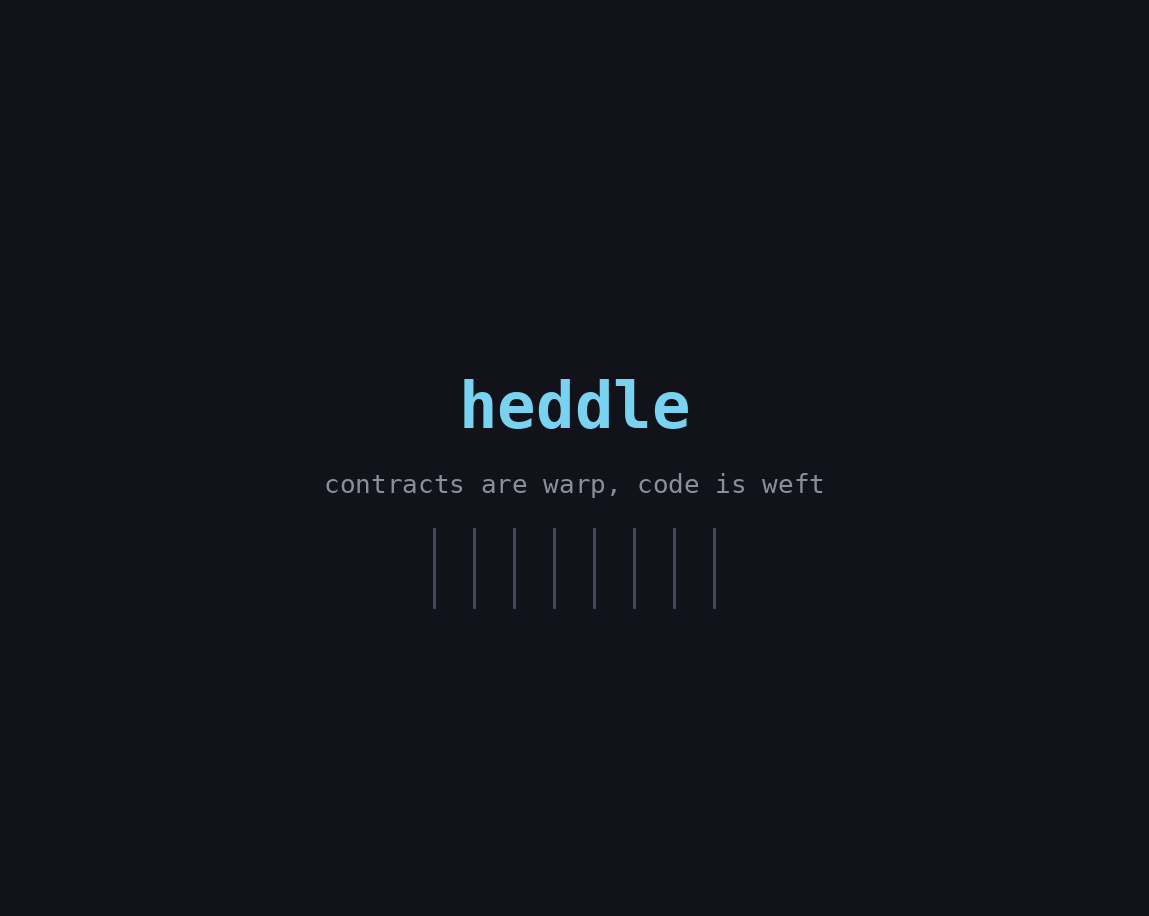
- 精简的上下文数据包。 重新生成单元的 Agent 会收到一个包含该单元契约、其依赖项的签名和调用方的上下文数据包,仅有几百个 token,而不必读取整个文件闭包。
数字
在一个包含 20 个契约的示例项目中执行相同的三项重新生成任务:一次直接读取文件,一次通过 hashloom(使用 tiktoken cl100k,通过 uv run python bench/benchmark.py 复现):
| 任务 | 原始文件 | hashloom | 缩减比例 |
|---|---|---|---|
| revenue_by_region | 1,925 | 369 | 5.2x |
| top_customers | 2,137 | 337 | 6.3x |
| revenue_by_category | 1,942 | 396 | 4.9x |
| 总计 | 6,004 | 1,102 | 5.4x |
原始模式统计基于文件的 Agent 每项任务会读取的内容:单元的规格文件、所有传递依赖的规格文件、依赖闭包中的每个源模块、单元的测试文件,以及运行测试套件的输出。这种基线设定刻意偏向宽松:假设 Agent 已经知道确切的依赖闭包,而 hashloom 恰好会为你计算出这一信息。
通过 bench/sweep.py,同一套方法会遍历五个示例项目中的每个单元——Python、Go、TypeScript、Java 和 C#——并适用于任何 hashloom 项目,包括你的项目。完整遍历的平均值低于门槛(因为其中包含收益微乎其微的叶类型);比例取决于依赖深度,因此依赖更深的项目得分更高。所有数据、分布情况和坦诚的注意事项都在 docs/benchmarks.md 中。
快速入门
pip install hashloom
# or from source: pip install "git+https://github.com/davet47/hashloom"

cd your-project
hashloom init                 # creates .hashloom/ and contracts/
hashloom index                # builds the store from contracts/
将 Claude Code 指向它:
claude mcp add hashloom -- hashloom serve
(Stdio 传输;服务会从其工作目录开始向上查找最近的 .hashloom/,以此解析项目。)
刚开始接触这种工作流?docs/getting-started.md 将介绍如何与 Agent 合作,以契约优先的方式构建软件包——需要提供给它的工作规则、审查循环,以及验证门禁。
契约
contracts/ 中每个单元对应一个 YAML 文件。简洁、可手动编写,也可进行哈希处理:
name: revenue_by_region
signature: "(sales: list[Sale]) -> dict[Region, float]"
deps: [Sale, Region]            # other contract names
invariants:
  - excludes sales where completed is false
  - excludes sales with null amount
examples:
  - in:  "[Sale(region='QLD', amount=10, completed=True)]"
    out: "{'QLD': 10.0}"
tests: [tests/test_revenue.py::test_revenue_by_region]   # pytest node IDs
impl: src/revenue.py::revenue_by_region                  # current woven weft
status: inferred        # reverse-engineered, not yet human-reviewed; omit once confirmed
子目录用作命名空间:contracts/billing/invoice.yaml 对应契约
billing/invoice,因此不同文件夹中可以存在相同的短名称。契约的
name 必须与其在 contracts/ 下的路径一致。
何时编写契约
契约应落在稳定的接缝上:这是其他单元所依赖的接口,并且你预计它的寿命会超过当前实现。其背后的实现是可弃用的编织层,可以自由重新生成。在不值得放置契约的地方不放契约,属于正确做法,并非失败。真正的失败模式恰恰相反:把你乐于重写的内部实现过度固定下来,让持久层变成繁琐工作。
契约是需要审查的产物。编写契约成本很低,而且还在不断降低,因此真正的成本在于审查,而非编写。错误的契约比没有契约更糟,因为持久化的产物此时是在撒谎:Agent 会重新生成代码,以满足一份本身就不正确的规格。审查契约时,应像审查接口一样,而不是像浏览生成的代码一样。
Agent 从现有代码逆向推导出的契约可以声明自己尚未通过审查:status: inferred。随后,工具会对任何依赖该契约的影响范围或验证结果进行标记——默认只标记,绝不拒绝(依赖项上标记 inferred: true,验证结果中包含 inferred 列表,并在 status 中提供审查队列)。希望未经审查的契约直接导致失败的团队,可以选择启用严格来源模式(.hashloom/config.json → {"strict_provenance": true}):此时,verify 会以结构化的 inferred_contract 错误拒绝此类单元——不运行测试,不缓存判定结果——直至契约通过审查;读取和写入仍仅提供建议,因此草稿仍可提交并供检查。未指定状态即表示 confirmed;审查后确认推断所得契约无需任何成本:状态表示来源,而非含义,因此切换状态不会使任何内容失效(严格模式下,原先已通过的结果会在确认后恢复)。
哈希语义
- 契约哈希:对规范化形式计算 sha256:键排序、空白规范化、移除注释、保留示例顺序、忽略依赖项顺序。
impl、tests、invariants和status均不纳入计算,因此移动文件永远不会导致缓存失效,重写不变量无需重新验证,确认推断出的契约也不会导致任何内容失效。不变量是文档,而非机器义务;真正的检查是测试,其源代码包含在验证密钥中。 - 实现哈希:对实现的规范化 AST 计算 sha256,因此重新格式化和编辑注释都不会破坏缓存。文档字符串也会被移除。
- 验证密钥:
(契约哈希, 实现哈希, 测试源代码哈希, 工具链标识, 传递依赖契约哈希)。Hashloom 会缓存验证结果,并以此为键:闭包中的任何契约、实现、测试自身的源代码或工具链标识发生变化,都会强制重新运行。标识包括工具链版本(python 3.11.7、go 1.21.5、node <v> ts <v>、java 21.0.3、dotnet 9.0.303);如果项目在根目录提交了依赖源文件(uv.lock、go.sum、package-lock.json、pom.xml等),还会包含该文件的deps <file>=<hash>摘要——因此,绝不会信任依赖声明集合不同的环境所产生的通过结果,也绝不会把 3.11 的通过结果用于 3.13。粒度是已提交声明的依赖集合(绝不包含 OS/架构——CI 中的通过结果仍适用于所有平台);与自身锁文件不一致的 venv 不在密钥范围内,这也是共享缓存撤销机制存在的原因之一。失败结果永远不会从缓存中提供。对于 Python,测试源代码哈希还会覆盖每个测试的夹具闭包,即测试请求的夹具(参数、usefixtures、字面量getfixturevalue)、作用域内的自动使用夹具以及夹具所依赖的夹具;这些夹具会沿测试模块和 conftest 链静态解析(最近的定义优先)。因此,仅编辑 conftest 中的夹具,就会使恰好依赖它的测试失效;静态遍历无法解析的夹具用法会退化为对整个链计算哈希,多算也不漏算。需要注意两点。缓存的通过结果假设测试具有确定性,因此,依赖墙上时钟、网络或随机性的通过结果,可能在使其通过的条件消失后仍然有效。此外,测试导入并调用的普通辅助函数(以及非 Python 测试辅助代码)仍不在哈希范围内——只有夹具图会纳入计算(参见 ISSUES.md)。
MCP 工具(全部接口)
| 工具 | 功能 |
|---|---|
get_contract | 约 300 个 token 的上下文包:契约 + 哈希 + 单行依赖签名 + 调用方列表 |
put_contract | 验证并写入 contracts/<name>.yaml,返回新哈希、变更内容的语义差异,以及所有失效的依赖项 |
get_dependents | 查询影响范围,可直接或传递查询;返回名称 + 哈希,并标记推断出的(未经审核)契约 |
verify | 每个单元返回 cached-pass / pass / fail,并提供顶层 ok 门控位;radius=true 会将每个名称扩展至其完整影响范围;仅在缓存未命中时运行测试;失败时返回不超过 40 个 token 的断言摘要,绝不返回回溯信息;标记闭包中的推断契约(严格来源模式下会拒绝) |
status | 脏契约、过期验证、缓存命中率、已解析的验证解释器、累计 token 计数器 |
每个工具都会返回结构化错误——{"error": {"code": "unknown_dep", "message": "'Regoin' not found — nearest: 'Region'"}}——绝不返回堆栈跟踪。
verify 解释器
verify 使用项目自己的 Python 运行测试,解析顺序如下:
hashloom serve --python PATH → .hashloom/config.json({"python": "..."})→
自动检测的 <project>/.venv → 运行 hashloom 的解释器。因此,全局安装的
hashloom 无须安装到项目的虚拟环境中,也能针对该环境验证项目;hashloom status
会显示解析出的解释器。
.hashloom/config.json 还接受 verify_timeout(每次 pytest 运行的秒数,
默认 300),供运行时间超过默认值的测试套件使用;pycache_trust
(默认 true);设为 pycache_trust: false — 或传入 --no-pycache-trust —
可在每次 verify 运行前清除项目的 __pycache__,确保过时的 .pyc 永远不会覆盖当前源码;
以及 strict_provenance(默认 false),设为该选项后,若某单元的闭包包含推断出的契约,
verify 就会拒绝验证该单元。
不止 Python
impl 的文件扩展名决定所用的语言适配器 — 每种适配器都提供规范化 AST 哈希器和测试运行器, 因此每种语言都遵循相同的外观与语义哈希规则:
- Go(
.go):通过标准库go/ast计算哈希,运行go test -json。工具链的 解析方式与解释器相同:使用.hashloom/config.json中的{"go": "..."},否则使用 PATH 中的go。 - TypeScript(
.ts/.tsx/.mts/.cts):通过目标项目自己的typescript编译器 API 计算哈希;根据package.json自动检测测试运行器 (vitest / jest,否则使用 Node 内置的node:test)。需要 Node= 22.6;配置项为
{"node": "..."}。 - Java(
.java):通过单文件javac树辅助程序计算哈希(仅需 JDK,无 依赖),并根据构建清单自动检测测试运行器 —pom.xml使用 Maven,build.gradle/build.gradle.kts使用 Gradle;若已提交mvnw/gradlew包装器,则优先于 PATH 中的二进制文件。需要 JDK >= 11,以及 Maven 或 Gradle; 配置项为{"java": "..."}。 - C#(
.cs):通过 Roslyn 令牌流辅助程序计算哈希;hashloom 会针对每个 SDK 版本, 使用该 SDK 自带的csc,基于其捆绑的Microsoft.CodeAnalysis编译该程序 (无需包,也无需网络);在根项目/解决方案上运行带有FullyQualifiedName~筛选器的dotnet test(xUnit、NUnit 和 MSTest 均可使用)。Microsoft.Testing.Platform 项目 (xunit v3)也能运行,但有一点需要注意:dotnet test在此类项目中会忽略筛选器,因此每次 verify 都会运行该项目的整个测试套件 — 这是一种保守做法(无关测试失败会阻止验证; 测试全通过仍能覆盖该契约的测试)。需要 .NET SDK >= 8;配置项为{"dotnet": "..."}。
Python 仍是默认语言;项目可以自由混用不同语言。
团队共享验证缓存
默认情况下,缓存位于本地 .hashloom/store.db。将缓存指向共享后端后,一次通过的 verify 即可服务整个团队 —
CI 验证某个单元一次后,每位团队成员的 Agent 都能获得 cached-pass:
// .hashloom/config.json
{"shared": {"url": "https://cache.internal:8770", "token": "..."}}
使用 python -m hashloom.cache_server 在任意位置运行后端(基于 SQLite 存储的轻量级
Bearer 令牌 HTTP 服务;它是一个运行中的进程,不是 CLI 命令)。权限按用途区分:可为服务器设置可选的
--publish-token,只有持有该令牌的客户端才能写入通过结果(CI 发布结果,只有读取令牌的笔记本电脑只消费结果;和之前一样,单个令牌仍同时授予两种权限)。只读客户端可以设置 "publish": false,完全跳过发布请求。服务器会并发处理请求;对同一验证键的重复发布不会产生任何效果(以首次写入为准)。只发布通过结果 —
失败不会越过边界 — 且上述“工具链包含在键中”的规则可确保共享的通过结果在不同机器上仍然有效。如果无法访问共享存储,verify 会静默退回本地缓存。
命令行
hashloom init · hashloom index · hashloom serve · hashloom status · hashloom verify。.hashloom/ 下的 sqlite 存储是派生状态:随时可以删除,hashloom index 会从 contracts/ 重新构建。它也不会提供过时的答案——如果磁盘上的 contracts/ 与存储内容不一致(执行 git pull 后未重新索引),verify 会以结构化的 stale_store 错误拒绝受影响的单元,而不是返回基于旧哈希的验证结果,直到你运行 hashloom index。
hashloom verify <name>… 可在命令行运行与 MCP 工具相同的缓存验证;除非每个单元都通过,否则会以非零状态码退出(失败、名称未知或单元无法验证都会阻止通过)——可将它加入 CI 或提交前钩子。--radius 会将每个名称扩展为该名称及其所有传递依赖项,因此一条命令即可覆盖某项变更的全部影响范围:hashloom verify --radius Sale。
试用示例项目
cd examples/sales
hashloom init && hashloom index && hashloom serve   # then point your agent at it
20 个契约、25 个测试,依赖链最多深入六层。 每个示例目录都附有自己的 README,其中包含对应语言的运行说明。
另外还有四种语言的对应示例,每个示例都使用相同的
init && index 流程:
- Go —
examples/go-ledger:围绕一个小型复式记账账本构建的 8 个契约。hashloom verify --radius Entry会在底层运行go test,覆盖全部影响范围。需要 Go 工具链。 - TypeScript —
examples/ts-cart:围绕一个购物车构建的 8 个契约。先运行npm install安装其typescript;验证通过 Node 内置的node:test运行。需要 Node >= 22.6。 - Java —
examples/java-payroll:围绕每周工资计算构建的 11 个契约,分为三层——记录、Class.method限定名、参数化方括号表,以及带点分隔节点 ID 的@Nested测试类;结构类似 Spring 服务层,但不依赖任何框架。hashloom verify --radius TimeSheet会在底层运行 Maven。需要 JDK >= 17 和 Maven。 - C# —
examples/csharp-invoices:围绕一次账单计算构建的 11 个契约,采用 Java 示例的三层结构,但使用 C# 惯用写法——整体哈希的记录、Class.Method限定名、[InlineData]方括号表,以及带点分隔节点 ID 的嵌套测试类(运行时的Outer+Inner写法)。hashloom verify --radius DiscountCents会在底层运行dotnet test。 需要 .NET SDK >= 8。
开发
uv sync
uv run pytest             # full suite; hash stability is the load-bearing suite
uv run python bench/benchmark.py
integrations/ 存放仅用于仓库的引导工具——一个从
graphify 知识图谱起草
status: inferred 契约的导入器(操作步骤请参阅
sales 示例),以及一个
GitHub spec-kit 扩展
(integrations/speckit-hashloom/),
可将缓存与门禁流程接入 /speckit.implement——为每个即将实现的功能起草
边界契约,并以 verify --radius 作为完成标准。这里只包含工具,不属于产品接口:其中没有任何内容会新增 MCP 工具或 CLI 命令。
刻意保持精简:5 个 MCP 工具、5 个 CLI 命令,契约采用纯 YAML。此 README 中未提及的所有内容都是一个问题。
许可证
Apache 2.0
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。