
关于 dbt MCP Server
dbt MCP Server 为 AI Agent 提供工具,用于操作 dbt Core、dbt Fusion 和 dbt Platform 项目。其工具涵盖 SQL、语义指标、项目发现、CLI 操作、任务管理、代码生成与文档。
主要功能
- 01执行 SQL 并查询语义指标
- 02检查模型、来源和血缘
- 03运行 dbt CLI 命令与测试
- 04管理 Platform 任务和运行记录
- 05生成模型与来源文件
- 06搜索并获取 dbt 文档
适用场景
- 01探索项目模型及其依赖
- 02结合项目上下文从自然语言生成 SQL
- 03检查模型健康状态和任务运行错误
- 04生成暂存模型及 YAML 文件
MCP 相关
向 MCP 客户端提供 dbt 项目、SQL、CLI、Semantic Layer、Platform 管理、代码生成和文档工具。它也为兼容客户端发布实验性的 MCP Bundle。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
我们还没有获取到这个服务的安装包或远程地址,请按项目 README 中的说明安装。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
dbt MCP 服务
此 MCP(模型上下文协议)服务提供了各种用于与 dbt 交互的工具。你可以使用此 MCP 服务,为 AI Agent 提供 dbt Core、dbt Fusion 和 dbt Platform 项目的上下文。
阅读我们的文档以了解更多信息。这篇博客文章详细介绍了 dbt MCP 服务的功能。
实验性 MCP Bundle
我们会在每次发布时提供一个实验性的 Model Context Protocol Bundle(dbt-mcp.mcpb),以便支持 MCPB 的客户端无需额外设置即可导入此服务。请从最新版本的资源中下载此 Bundle,并按照 Anthropic 的 mcpb CLI 文档安装或检查它。
反馈
如果你有意见或疑问,请创建 GitHub Issue,或加入社区 Slack 的 #tools-dbt-mcp 频道与我们交流。
架构
dbt MCP 服务的架构允许你的 Agent 连接到各种工具。
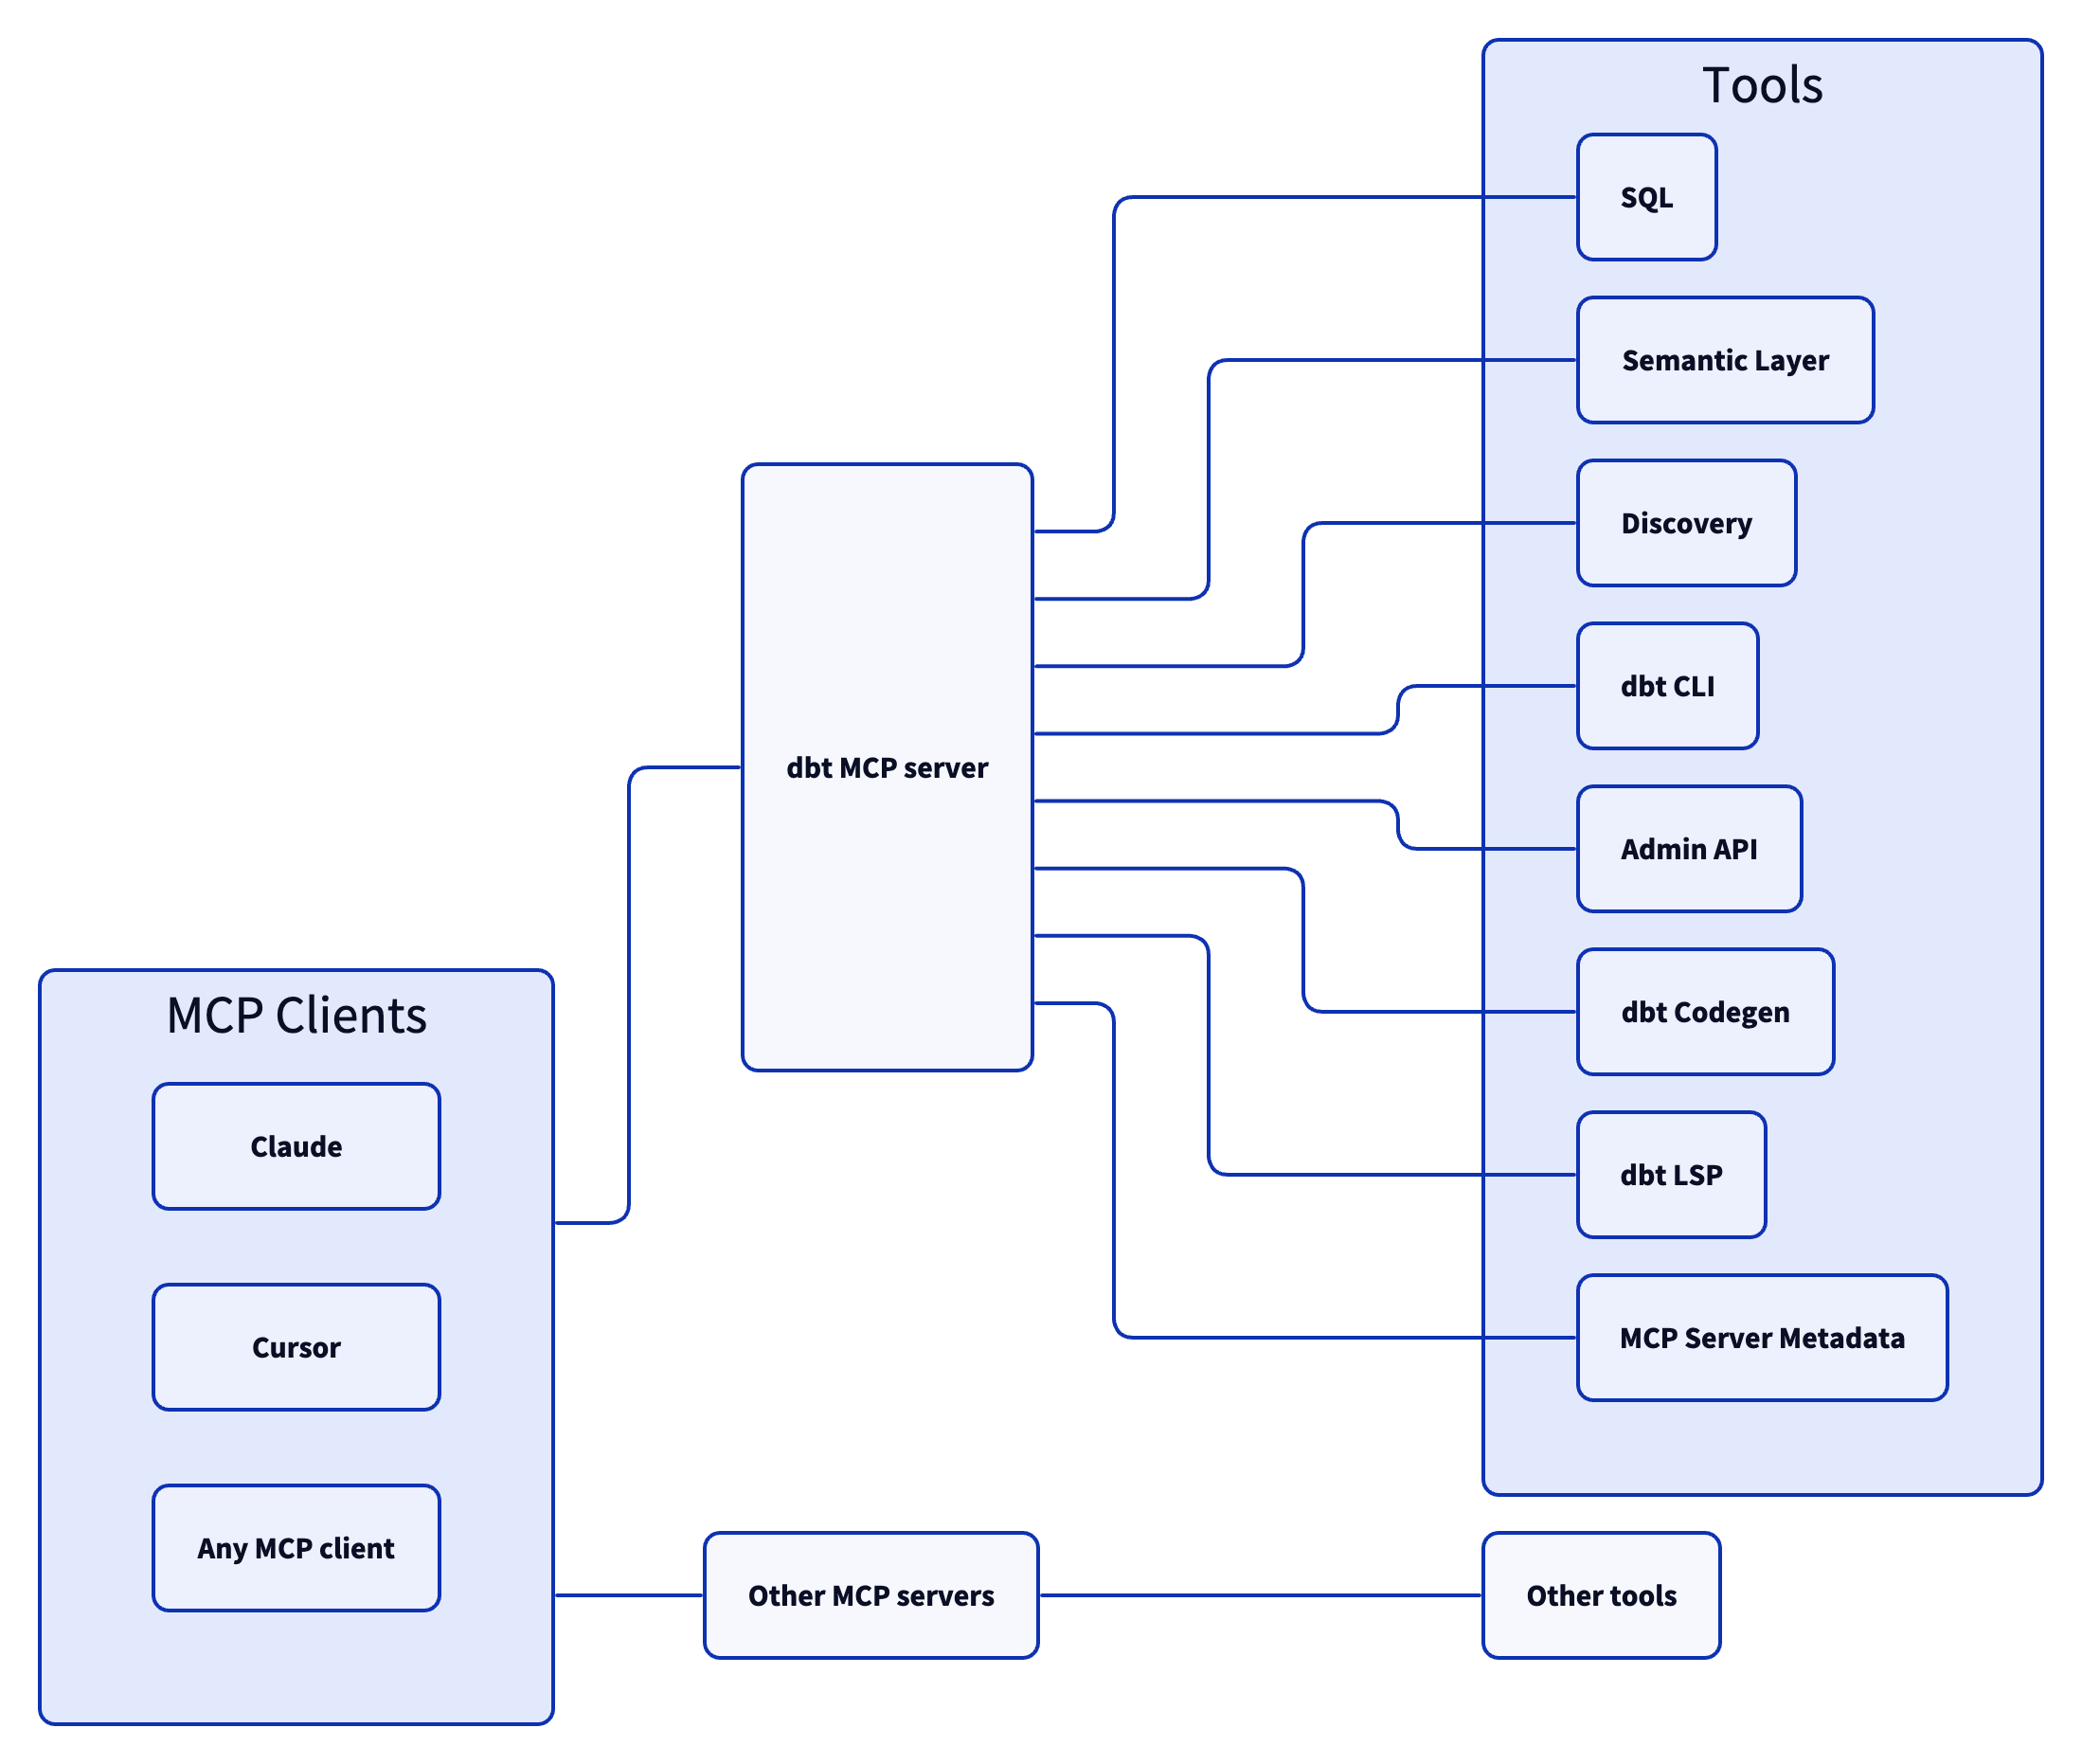
工具
SQL
用于在 dbt Platform 基础设施上执行和生成 SQL 的工具。
execute_sql:在 dbt Platform 基础设施上执行 SQL,并支持 Semantic Layer。text_to_sql:使用项目上下文,将自然语言转换为 SQL。
Semantic Layer
如需进一步了解 dbt Semantic Layer,请点击此处。
get_dimension_values:获取某个维度的不同取值;可选择限定到特定指标。get_dimensions:获取指定指标的维度。get_entities:获取指定指标的实体。get_metrics_compiled_sql:返回指标编译后的 SQL,但不执行查询。list_metrics:检索所有已定义的指标。list_saved_queries:检索所有已保存的查询。query_metrics:执行指标查询,并支持筛选和分组选项。
发现
如需详细了解 dbt Discovery API,请点击此处。
get_all_macros:获取宏;可选择按 package 筛选,或仅返回 package 名称。get_all_models:获取所有模型的名称和描述。get_all_sources:获取所有数据源及其新鲜度状态;可选择按数据源名称筛选。get_exposure_details:(已弃用 — 请改用get_node_details)get_exposures:获取所有 exposure(下游仪表板、应用或分析)。get_lineage:获取有界血缘图,并可按类型、深度和方向筛选。get_macro_details:(已弃用 — 请改用get_node_details)get_mart_models:获取所有集市模型。get_model_children:(已弃用 — 请改用get_lineage)get_model_details:(已弃用 — 请改用get_node_details)get_model_health:获取健康状况信号:运行状态、测试结果和上游数据源的新鲜度。get_model_parents:(已弃用 — 请改用get_lineage)get_model_performance:获取模型的执行历史;可选择包含测试结果。get_node_details:获取任意 dbt 资源类型(模型、数据源、exposure、测试、seed、snapshot、宏、semantic_model)的完整详情。get_related_models:使用语义搜索查找相似模型。get_seed_details:(已弃用 — 请改用get_node_details)get_semantic_model_details:(已弃用 — 请改用get_node_details)get_snapshot_details:(已弃用 — 请改用get_node_details)get_source_details:(已弃用 — 请改用get_node_details)get_test_details:(已弃用 — 请改用get_node_details)search:[Alpha] 搜索 dbt 项目中的资源(通常不开放使用)。search_public_mesh_models:跨项目查找公开的 dbt Mesh 模型,并确认生产方身份,以便构建经过验证的跨项目 ref(仅适用于多项目配置)。
dbt CLI
通过 MCP 工具让客户端使用 dbt 命令,可能会修改数据模型、数据源和数据仓库对象。仅当你信任该客户端并了解潜在影响时,才继续操作。
build:按 DAG 顺序执行模型、测试、快照和 seed。clone:将指定 state 中选定的节点克隆到目标 schema。compile:从模型、测试和分析生成可执行 SQL;可用于验证 Jinja 逻辑。docs:为 dbt 项目生成文档。get_lineage_dev:从本地 manifest.json 获取血缘,并可按类型和深度筛选。get_node_details_dev:从本地 manifest.json 获取节点详情(模型、seed、快照、数据源)。list:按类型列出 dbt 项目中的资源,并支持选择器。parse:解析并验证项目文件,检查语法是否正确。run:执行模型,将其物化到数据库中。show:对数据库执行 SQL 并返回结果。test:运行测试,验证数据和模型的完整性。
管理 API
如需进一步了解 dbt 管理 API,请点击此处。
cancel_job_run:取消正在运行的作业。get_job_details:获取作业配置,包括触发器、计划和 dbt 命令。get_job_run_artifacts:下载作业运行的指定工件;对于较大的工件,会返回提示信息,建议使用 jq_filter 重试;支持使用 jq 过滤以提取目标内容。get_job_run_details:获取运行详情,包括状态、时间、步骤和工件。get_job_run_error:获取作业运行的错误和/或警告详情;可选择包含警告,或仅显示警告。list_job_run_artifacts:列出作业运行的可用工件。list_jobs:列出 dbt Platform 账户中的作业;可选择按项目或环境筛选。list_jobs_runs:列出作业运行;可选择按作业、状态筛选,或按字段排序。list_projects:列出 dbt Platform 账户中的所有项目。retry_job_run:重试失败的作业运行。trigger_job_run:触发作业运行;可选择覆盖 git 分支、架构或其他设置。
dbt Codegen
这些工具有助于自动生成 dbt 项目文件中的样板代码。
generate_model_yaml:生成包含列的模型 YAML;可选择继承上游描述。generate_source:通过检查数据库架构生成源 YAML;可选择包含列。generate_staging_model:根据源表生成暂存模型 SQL。
dbt LSP
一组利用 Fusion 引擎进行高级 SQL 编译和列级沿袭分析的工具。
fusion.compile_sql:通过 dbt Platform 在项目上下文中编译 SQL。fusion.get_column_lineage:通过 dbt Platform 追踪列级沿袭。get_column_lineage:在本地追踪列级沿袭(需要通过 dbt Labs VSCE 使用 dbt-lsp)。
产品文档
用于搜索和获取 docs.getdbt.com 官方 dbt 文档内容的工具。
get_product_doc_pages:按路径或 URL 获取一个或多个 docs.getdbt.com 页面中的完整 Markdown 内容。search_product_docs:在 docs.getdbt.com 中搜索与查询匹配的页面;按相关性返回标题、URL 和描述。使用 get_product_doc_pages 获取完整内容。
MCP 服务元数据
这些工具提供 MCP 服务本身的信息。
get_mcp_server_branch:返回正在运行的 dbt MCP 服务的当前 git 分支。get_mcp_server_version:返回 dbt MCP 服务的当前版本。
示例
通常,你会将 dbt MCP 服务连接到 Claude 或 Cursor 等 Agent 产品。不过,如果你有兴趣创建自己的 Agent,请查看示例目录以了解如何开始。
依赖项
依赖项固定为特定版本,不会自动更新。只有与安全相关的依赖项更新才会通过自动化拉取请求提交。
贡献
阅读 CONTRIBUTING.md,了解如何参与贡献!
请参阅工具输入和解析后的上下文,了解选择器声明和上下文映射器契约。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。