关于 Engram
Engram 是面向 AI Agent 的本地持久记忆系统,适合需要跨会话保存和检索信息的用户。它基于 SQLite 离线运行,并在写入时自动检测敏感信息。
主要功能
- 01本地 SQLite 持久记忆
- 02语义与全文混合检索
- 03写入时自动检测密钥
- 04记忆反馈、冲突检测与去重
- 05可选本地 LLM 信息提取
- 06提供 MCP、REST 与仪表盘
适用场景
- 01跨会话保存项目决策与偏好
- 02检索 Agent 先前保存的事实
- 03检查冲突或清理重复记忆
- 04让多个 AI 客户端共享记忆
MCP 相关
Engram 通过 stdio MCP 服务向 AI Agent 提供记忆存储、检索、删除、反馈、上下文生成和状态查询工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
 Engram
为 AI Agent 提供持久记忆。进程内运行。无需基础设施。
让你的 AI Agent 拥有一位与你共事多年的同事般的记忆——无需云服务、API 密钥或 Docker。
⭐ 觉得有用?在 GitHub 上点个 Star ——这是帮助更多人发现 Engram 的最简单方式。





npm install -g @hbarefoot/engram
engram start
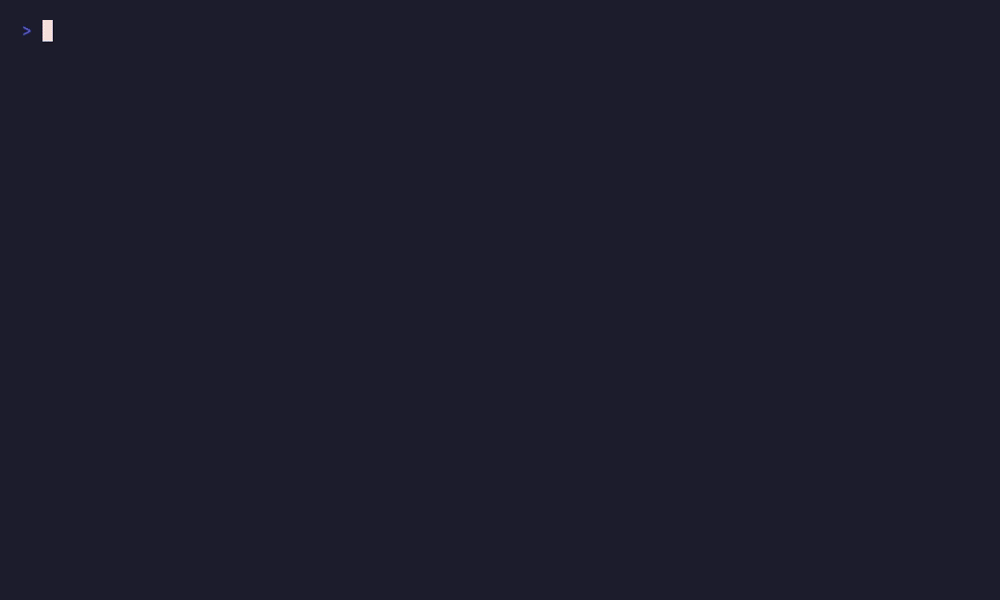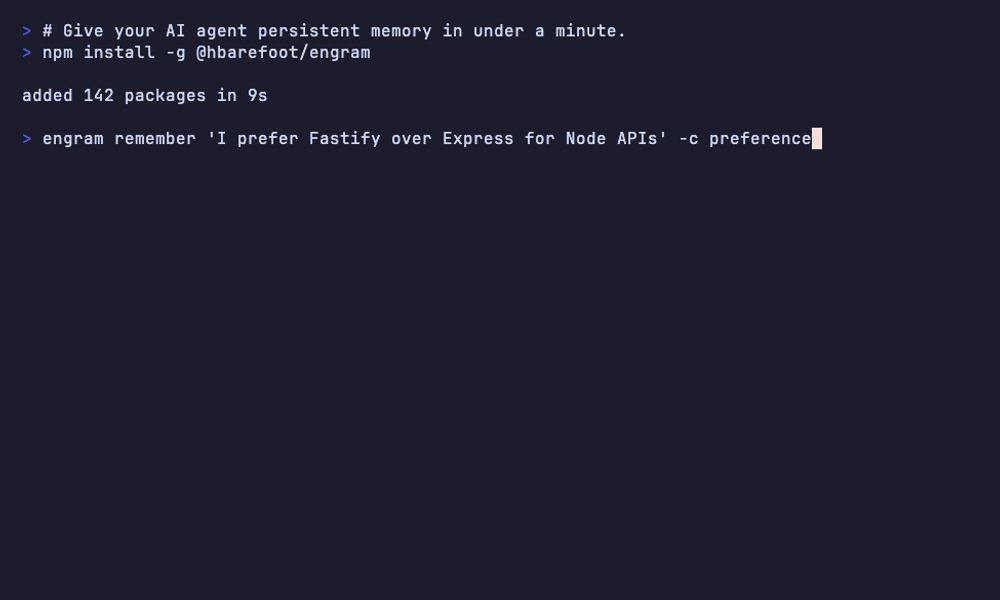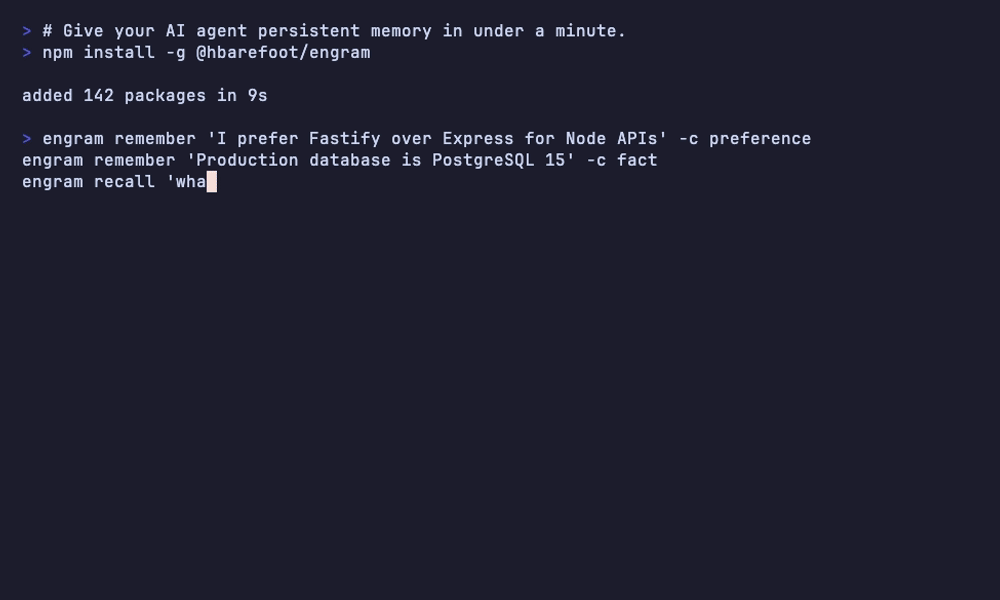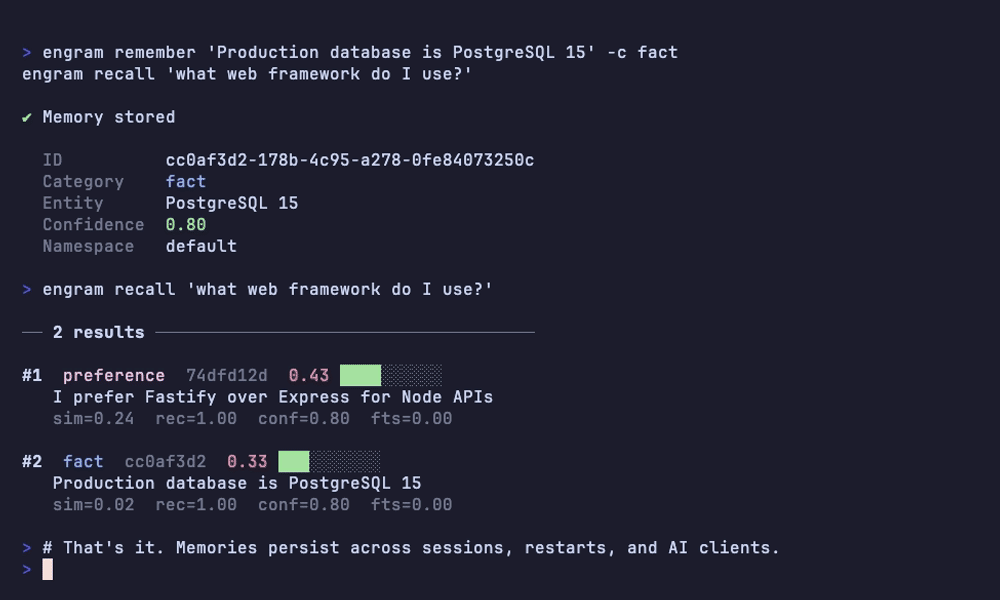
你的 AI Agent 现在拥有了长期记忆。两分钟即可开始,无需配置,无需云服务。
- 🧠 进程内运行——在 Agent 的技术栈内部运行。无需部署独立服务,没有 IPC 开销,也无需派生进程。
- 📴 离线运行——本地 SQLite + 内置嵌入模型(约 23 MB)。无需 API 密钥,数据不会离开你的设备。
- 🔌 原生支持 MCP——与 Claude Desktop、Claude Code、Cursor、Windsurf 和 Cline 深度集成 Model Context Protocol。
- 🔐 默认安全——每次写入时自动检测机密信息。在 API 密钥、私钥、连接字符串和 JWT 写入数据库前将其拦截。
本地优先的优势,用数据说话
Engram 在 Agent 的进程内部运行——无需部署服务、无需账户,数据也不会离开你的设备。这种设计的优势可以量化:
| 指标 | Engram | |
|---|---|---|
| 冷启动 → 首次回忆 | 低于 200 ms | 从导入到首次回答,包含模型加载时间(M 系列;取决于硬件) |
| 热启动回忆(p50,1k 条记忆) | 约 4 ms | 模型载入内存后的查询延迟中位数 |
| 软件包下载 | 约 571 KB | npm 软件包(解压后为 1.3 MB) |
| 嵌入模型 | 约 23 MB | all-MiniLM-L6-v2,仅获取一次,缓存于 ~/.engram/models |
| 外部服务 | 0 | 无数据库、消息代理或云账户 |
| 离线可用 | ✅ | 默认运行路径下不会发起任何网络调用 |
在 Apple M4 Pro 上,以 1,000 条预置记忆进行测量——运行 npm run bench 即可复现。这些数据衡量的是占用空间和延迟,并非准确率声明:Engram 并不试图在记忆基准测试中超越 Mem0 或 Zep。它的目标是提供可靠的回忆能力,同时不带来任何运维负担。
可选的准确率提升——仍然 100% 本地运行。 如果你已经在运行本地模型,可选用 LLM 层来改进事实提取:使用推荐的 henrybarefoot1987/engram-extract 模型(qwen3:1.7b),实体提取准确率可从 45.8%(基于规则)提升至 95.8%——提升 50 个百分点——且不会有任何数据离开你的设备。
支持 Engram
Engram 免费且采用 MIT 许可证,并且永远如此。 没有付费墙,没有按层级锁定的功能,也没有遥测。所有功能都包含在开源软件包中。赞助纯粹是为了资助持续开发,而不是解锁任何功能。

如果 Engram 为你节省了时间,可以通过 Polar 赞助:
| 级别 | 价格 / 月 | 适用对象 |
|---|---|---|
| 🌱 支持者 | $5 | 希望项目持续推进的个人。 |
| ⚡ 高级用户 | $25 | 日常依赖 Engram 的重度用户。 |
| 👥 团队 | $100 | 在多个项目中统一采用 Engram 的团队。 |
| 🏢 企业 | $499 | 问题优先响应 + 专属集成协助。 |
关于企业版。 Engram 采用 MIT 许可证,因此已允许商业使用——你无需购买许可证即可在工作中使用它。企业级别提供问题的优先响应,以及将 Engram 接入你们技术栈的专属协助。对于政策禁止依赖采用 MIT 许可证的软件的组织,可按需提供可选的商业许可证覆盖方案。(Engram 由一名独立开发者维护,因此优先响应仅尽力而为,并非合同约定的 SLA。)
为什么选择 Engram?
大多数 Agent 记忆产品都是与 Agent 一起运行的服务——Postgres、Docker、云账户、API 密钥。Engram 则嵌入在 Agent 的进程中:这是一个专注、稳定的 npm 包,并提供实用的防护措施。
| Engram | Lodis | Mem0 / OpenMemory | Zep | Letta | |
|---|---|---|---|---|---|
| 成熟度 | v1.9.x,稳定 | v0.5.x,早期 | 成熟 / SaaS | v0.x | v0.x |
| 运行所需基础设施 | 无(npm 包) | 无(npx 包) | 云账户 或 多容器 Docker | Docker + Postgres + Graphiti | Docker + Postgres |
| 安装占用 | ~23 MB | ~22 MB | 数百 MB 的容器(可自托管) | 数百 MB | 数百 MB |
| 可离线运行 | ✅ | ✅ | ❌ 云端 / ✅ 可自托管 | ❌ 外部嵌入服务提供方 | ❌ 外部 LLM 服务提供方 |
| 原生支持 MCP | ✅ 主要方式 | ✅ 主要方式 | 🟡 OpenMemory 附带 MCP 服务 | ❌ REST/SDK | ❌ REST/SDK |
| 支持与 MCP 并行的 REST API | ✅ | ❌ 仅 MCP | ✅ 云端 | ✅ | ✅ |
| 功能范围 | 6 个工具、5 个类别 | 40 个工具、14 种实体类型 + 4 个持久性层级 + 时间性取代 | 不一 | 不一 | 不一 |
| 自动检测密钥 | ✅ 每次写入时都会拦截 | 🟡 可选工具 memory_scrub | 🟡 非核心功能 | 🟡 非核心功能 | 🟡 非核心功能 |
| Agent 自动发现 | ✅ 控制面板集成向导 | ❌ 手动配置 | ❌ | ❌ | ❌ |
| 桌面应用 | ✅ macOS Tauri 菜单栏应用 | ❌ | ❌ | ❌ | ❌ |
| 由 LLM 驱动的提取 | ✅ 可选,在设备端运行(Ollama;默认基于规则) | ❌ 读写不使用 LLM | ✅ 内置 | ✅ 内置 | ✅ 内置 |
| 反馈 / 矛盾处理工作流 | ✅ 并排显示的冲突解决界面 + 反馈循环 | 🟡 以编程方式提供纠正 / 确认 / 取代工具 | 🟡 无内置反馈功能 | 🟡 | 🟡 |
来源: @sunriselabs/lodis、Sunrise-Labs-Dot-AI/engrams、mem0.ai、github.com/getzep/zep、github.com/letta-ai/letta。完整对比请参阅 docs/competitive-intel.md。Engram 提供可选的设备端 LLM 提取(v1.9+):将 llm.* 指向本地模型——推荐使用 henrybarefoot1987/engram-extract(Qwen3-1.7B,Apache-2.0),也可使用任何 Ollama / OpenAI 兼容端点——以提升类别 / 实体提取能力(在我们的基准测试中,使用 engram-extract(qwen3:1.7b)时,实体识别准确率相比规则提升 50 个百分点——从 45.8% 提升至 95.8%),且仍完全在本地运行,并且默认关闭(零配置路径仍基于规则运行,无需联网,也无需基础设施)。Mem0/Zep/Letta 通过云端模型实现 LLM 提取;Lodis 的读写不使用 LLM,但功能范围更广——我们如实列出。
简而言之——各自适用的场景。 如果你想要一层专注、稳定、优先本地运行的记忆层,并具备实用的防护措施(密钥检测、Agent 自动发现、桌面应用)、简洁的 5 类心智模型,以及可选的设备端 LLM 提取功能,那么请选择 Engram。如果你想要具备知识图谱风格的记忆,并支持 14 种实体类型和时间性取代,那么请选择 Lodis。如果你想要内置云端 LLM 提取功能,且不介意运行相应的基础设施,那么请选择 Mem0/Zep/Letta。
快速入门
1. 安装
npm install -g @hbarefoot/engram
2. 启动服务
engram start             # MCP + REST + Dashboard on localhost:3838
engram start --mcp-only  # MCP server only, stdio mode (for agent integration)
3. 连接 AI Agent
Claude Code:
claude mcp add engram -- engram start --mcp-only
Claude Desktop — 添加到 ~/Library/Application Support/Claude/claude_desktop_config.json:
{
  "mcpServers": {
    "engram": {
      "command": "engram",
      "args": ["start", "--mcp-only"]
    }
  }
}
Cline / Cursor / Windsurf — 将相同的 mcpServers 代码块添加到编辑器的 MCP 配置中。内置控制面板 http://localhost:3838 中的集成向导可自动检测已安装的 Agent,并为你生成配置。
4. 使用
You:    "Remember that our API uses JWT tokens with 24-hour expiry."
Claude: (stores via engram_remember)

You:    (next day) "What authentication approach are we using?"
Claude: (recalls via engram_recall) — "JWT tokens, 24-hour expiry."
记忆会在不同会话、机器重启后,以及共享同一 Engram 实例的不同 AI 客户端之间持续保留。
会随着时间推移而改进的记忆
大多数记忆系统都是只追加的存储:写入一次,永久检索,听天由命。Engram 会学习。
- 反馈循环(
engram_feedback)——当 Agent 回忆起一条记忆时,你或 Agent 可以投票评价它是否有帮助。记忆会累积[-1, 1]范围内的评分;持续被评为无帮助的记忆,其置信度会自动降低。 - 矛盾检测——当两条记忆相互冲突(“偏好 Fastify”与“改用 Express”)时,整合引擎会将其标记出来。仪表板的 冲突 选项卡会并排显示这些记忆,并提供四种处理操作:保留 A、保留 B、两者都保留或忽略。
- 插入时去重——相同的记忆(余弦相似度 ≥0.95)会被拒绝。近似重复的记忆(0.92–0.95)会将新内容合并到现有记录中。无需手动清理,存储库也能保持整洁。
- 衰减——未被回忆的记忆会随时间推移而失去置信度,不再污染未来的结果。
使用 Engram 的时间越长,它的回忆能力就越强。
MCP 工具
Engram 通过 stdio 向 AI Agent 提供 6 个工具:
| 工具 | 描述 |
|---|---|
engram_remember | 存储一条记忆,并附带类别、实体、置信度、命名空间和标签。自动运行机密信息检测。 |
engram_recall | 混合语义搜索与 FTS5 搜索。支持 category、namespace、threshold 和 time_filter。 |
engram_forget | 按 ID 删除指定记忆。 |
engram_feedback | 投票评价记忆是否有帮助。驱动上述反馈循环。 |
engram_context | 生成预格式化的上下文块(markdown / xml / json / plain),并设置令牌预算,以便注入系统提示词。 |
engram_status | 健康检查:记忆数量、模型状态和配置。 |
记忆类别
- fact ——关于设置、架构或配置的客观事实。
- preference ——用户的喜好、厌恶和风格选择。
- pattern ——反复出现的工作流和习惯。
- decision ——作出的选择及其背后的理由。
- outcome ——已采取行动的结果。
教你的 Agent 使用 Engram
连接 MCP 服务后,Agent 就能使用记忆工具,但还不具备善用这些工具的判断力。随附的 engram-memory 技能正是这一判断层:它会教 Agent 在会话开始时回忆记忆,在过程中存储持久的决策、纠正和结果,并在结束时写入结果,无需每次都另行指示。
engram skill install                     # → ~/.claude/skills/engram-memory/
engram skill install --project           # → ./.claude/skills/  (commit it for your team)
engram skill install --platform agents   # → ~/.agents/skills/  (cross-framework)
适用于 Claude Code、Claude Desktop、Cowork,或任何读取 Agent Skills 规范(.agents/skills)的框架。该技能随软件包一同提供,因此会随 Engram 一起进行版本管理;运行 engram skill install 即可获取更新,运行 engram skill uninstall 可将其彻底移除。
CLI 参考
engram start                       # Start MCP + REST + dashboard
engram start --mcp-only            # MCP server only (stdio mode)
engram start --port 3838           # Custom REST port

engram remember "<content>"        # Store a memory   (-c category -e entity -n namespace --confidence)
engram recall "<query>"            # Search memories  (-l limit -c category -n namespace --threshold)
engram forget <id>                 # Delete by ID
engram list                        # List memories    (-l limit --offset -c category -n namespace)
engram status                      # Health check

engram consolidate                 # Deduplicate, detect contradictions, decay
                                   # (--no-duplicates / --no-contradictions / --no-decay / --cleanup-stale)
engram conflicts                   # List unresolved contradictions
engram export-context              # Export curated context block
                                   # (-o file -f markdown|claude|txt|json -c categories --min-confidence ...)
engram import                      # Import from local sources
                                   # (-s cursorrules|claude|package|git|ssh|shell|obsidian|env --dry-run)

engram skill install               # Install the engram-memory agent skill
                                   # (--project → ./.claude, --platform agents → ~/.agents)
engram skill uninstall             # Remove the engram-memory skill
运行 engram --help 查看完整的标志列表。
REST API
REST API 默认运行在 http://localhost:3838。
| 方法 | 端点 | 描述 |
|---|---|---|
| GET | /health | 存活检查 |
| GET | /api/status | 系统状态和统计数据 |
| GET | /api/installation-info | 检测到的 Agent、运行时和安装位置 |
| POST | /api/memories | 创建记忆 |
| GET | /api/memories | 分页列出并筛选 |
| POST | /api/memories/search | 语义搜索 |
| GET | /api/memories/:id | 读取单条记忆 |
| DELETE | /api/memories/:id | 按 ID 删除 |
| POST | /api/memories/bulk-delete | 按 ID 列表批量删除 |
| POST | /api/consolidate | 运行整合流水线 |
| GET | /api/conflicts | 基于旧版标签的冲突视图 |
| GET | /api/contradictions | 未解决的矛盾 |
| POST | /api/contradictions/:id/resolve | 解决矛盾(keep_first / keep_second / keep_both / dismiss) |
| GET | /api/contradictions/count | 未解决矛盾数(用于徽标) |
| GET | /api/analytics/overview | 记忆健康状况仪表板数据 |
| GET | /api/analytics/stale | 最近未被召回的记忆 |
| GET | /api/analytics/never-recalled | 从未被任何查询返回的记忆 |
| GET | /api/analytics/duplicates | 检测到的近似重复项 |
| GET | /api/analytics/trends | 随时间变化的创建/召回趋势 |
| POST | /api/export/static | 将上下文块导出为静态文件 |
| GET | /api/import/sources | 列出可导入的本地来源 |
| POST | /api/import/scan | 两阶段导入:预览提取出的记忆 |
| POST | /api/import/commit | 两阶段导入:提交选中的记忆 |
Web 仪表板
内置的 React 仪表板位于 http://localhost:3838:
- 仪表板 — 记忆统计、近期活动、健康度仪表。
- 记忆 — 浏览、筛选、行内编辑、批量删除。
- 搜索 — 语义搜索及评分明细。
- 统计数据 — 按类别、命名空间和时间绘制的图表。
- 健康状况 — 可一键清理过时、从未召回和低反馈的记忆。
- 冲突 — 并排解决矛盾。
- Agent — 集成向导,可自动检测已安装的 AI 客户端并写入其 MCP 配置(附带带时间戳的备份)。
- 导入 — 用于导入 cursorrules、.claude 文件、package.json、git 配置、SSH 配置、Shell 历史记录、Obsidian 和 .env 的向导。
工作原理
- 存储:
engram_remember会先对内容进行密钥检测,然后使用 all-MiniLM-L6-v2 在本地生成嵌入(约 23 MB,仅使用 CPU;下载一次后缓存到~/.engram/models/)。嵌入和元数据存储在~/.engram/memory.db中的 SQLite 数据库里。 - 召回:
engram_recall会为查询生成嵌入,通过 FTS5 和命名空间内的嵌入获取候选项,并按(similarity × 0.45) + (recency × 0.15) + (confidence × 0.15) + (access × 0.05) + (feedback × 0.10) + fts_boost评分。随后返回排名靠前的结果并更新其访问统计数据。 - 去重:插入时,会拒绝相同的记忆(相似度 ≥ 0.95);近似重复项(0.92–0.95)则会将新内容合并到现有行中。
- 学习:
engram_feedback会调整记忆的feedback_score,并在收到 5 次或更多投票后提高或降低置信度评分。 - 保护:每次写入都会经过基于模式的密钥检测(OpenAI/Stripe/AWS/GitHub/Slack/Google 密钥、私钥、连接字符串、JWT、高熵字符串)。检测到密钥后,要么拒绝该记忆,要么对密钥部分进行脱敏。
配置
Engram 将所有内容存储在 ~/.engram/ 下:
~/.engram/
├── memory.db          # SQLite database (memories + embeddings + FTS5 index)
├── config.json        # Server configuration
└── models/            # Cached embedding model
默认配置开箱即用。若要自定义:
{
  "port": 3838,
  "dataDir": "~/.engram",
  "defaults": {
    "namespace": "default",
    "recallLimit": 5,
    "confidenceThreshold": 0.3,
    "tokenBudget": 500,
    "maxRecallResults": 20
  },
  "embedding": {
    "provider": "local",
    "model": "Xenova/all-MiniLM-L6-v2"
  },
  "consolidation": {
    "enabled": true,
    "intervalHours": 24,
    "duplicateThreshold": 0.92,
    "decayEnabled": true
  },
  "security": {
    "secretDetection": true,
    "auditLog": false
  }
}
llm.* 配置块用于支持下文介绍的可选本地 AI 增强功能。默认关闭
(llm.provider: null);零配置路径使用基于规则的提取,不会调用大模型。
可选:本地 AI 增强(Ollama)
Engram 完全离线运行,无需任何 AI 依赖。如果你想进一步提高准确性,而且已经在运行本地模型,可以选择性启用“第 1 层”——它始终 100% 运行在你的设备上。
- 免费、可选加入,默认关闭。 除非你启用,否则一切保持不变。
- 本地优先。 使用你自己的 Ollama(默认),或任何兼容 OpenAI 的本地服务(LM Studio、llama.cpp)。没有云服务、没有 API 密钥、没有遥测——你的记忆内容绝不会离开设备。
- 稳定可靠。 每次调用都有超时限制;如果模型响应缓慢、无法访问或返回无效内容,就会回退到内置的规则处理流程。即使模型不可用,Engram 也不会崩溃。
启用后可改善:新记忆的 category/entity/confidence 更准确,并通过 LLM 确认步骤减少错误的矛盾标记。
推荐模型:henrybarefoot1987/engram-extract。 这一层的两项任务是分类而非生成,因此,小型模型配合受限解码(强制模型输出有效 JSON)并关闭思考后,速度快(不到一秒)、发热低且准确。拉取该模型(或根据 Modelfile 在本地构建):
ollama pull henrybarefoot1987/engram-extract
# …or build from source:
ollama create henrybarefoot1987/engram-extract -f models/engram-extract.Modelfile
然后将模型设置为 henrybarefoot1987/engram-extract。这只是推荐,并非限制——任何 Ollama 或兼容 OpenAI 的模型都可以使用。有关基础模型、许可,以及如何选择能在你的硬件上胜过规则处理的最小模型,请参阅 docs/llm/recommended-model.md。
来源说明。
henrybarefoot1987/engram-extract基于 Qwen3-1.7B 构建(© Alibaba Cloud,Apache-2.0)。 Engram 仅添加了提取提示词和受限输出配置;基础模型的权重、许可和声明均保持不变。
启用(桌面应用): Preferences → AI Enhancement → 开启开关,选择模型,点击 Test
connection,然后点击 Save。同一选项卡会显示实时状态徽章、活动统计数据(增强与回退提取次数、过滤的矛盾数量、平均延迟)和最近事件列表,方便你查看该层是否确实在工作。通过程序调用时,GET /api/llm/status 和
GET /api/llm/stats 会提供相同的数据(全部在本地运行——无遥测)。
启用(配置文件) — ~/.engram/config.json:
{
  "llm": {
    "provider": "ollama",
    "endpoint": "http://localhost:11434",
    "model": "llama3.2:3b",
    "apiKey": null
  }
}
首先运行:ollama pull llama3.2:3b。将 "provider": null 设为关闭(默认状态)。
对于兼容 OpenAI 的本地服务,使用 "provider": "openai-compatible" 并将 endpoint
指向该服务(例如 http://localhost:1234);仅在设置了 apiKey 时才会发送该密钥。
隐私说明: 只有当
endpoint为本地地址(localhost/127.0.0.1)时,“记忆数据不会离开你的设备”才完全属实。如果你将其指向非本地主机,记忆内容会发送到该地址进行分类——在这种情况下,桌面应用的 AI Enhancement 选项卡会显示明确警告。如果模型无法访问,断路器会暂停该层,Engram 会回退到基于规则的提取,不会增加延迟。
高级用法
沙盒评估
将 Engram 的数据目录重定向到临时位置,这样就不会触及 ~/.engram/memory.db。适用于初次评估、CI 运行,或使用全新数据库测试桌面端 sidecar:
# Via CLI flag (highest priority)
engram start --data-dir /tmp/engram-eval

# Or via env var
ENGRAM_DATA_DIR=/tmp/engram-eval engram start

# Works on every Engram command that touches the DB:
ENGRAM_DATA_DIR=/tmp/engram-eval engram remember "test memory" -c fact
ENGRAM_DATA_DIR=/tmp/engram-eval engram recall "test"
ENGRAM_DATA_DIR=/tmp/engram-eval engram status
覆盖优先级:--data-dir 标志 > ENGRAM_DATA_DIR 环境变量 > ~/.engram/config.json 中的 dataDir > 默认值(~/.engram)。
命名空间隔离
engram remember "Uses Next.js 14 app router" -n my-saas
engram remember "WordPress multisite + Redis" -n client-site

engram recall "what framework?" -n my-saas
时间查询
可通过 MCP 和 REST 按时间范围筛选。Agent 将 time_filter 对象传递给 engram_recall:
{
  "query": "deployment changes",
  "time_filter": { "after": "last week" }
}
{
  "query": "API decisions",
  "time_filter": { "after": "2026-01-01", "before": "2026-06-01" }
}
支持的形式:after / before(ISO 日期或 "3 days ago" 这样的相对字符串),或 period 简写(today、yesterday、this_week、last_week、this_month、last_month、this_year、last_year)。
导出文档上下文
engram export-context -f markdown -n my-project -o PROJECT_CONTEXT.md
engram export-context -f claude -o CLAUDE.md
程序化用法
Engram 也可以作为库在你的 Node.js 应用中使用:
import {
  loadConfig,
  getDatabasePath,
  getModelsPath,
  initDatabase,
  createMemory,
  recallMemories
} from '@hbarefoot/engram';

const config = loadConfig();
const db = initDatabase(getDatabasePath(config));

createMemory(db, {
  content: 'User prefers Fastify over Express',
  category: 'preference',
  confidence: 0.9
});

const results = await recallMemories(
  db,
  'preferred web framework',
  { limit: 5 },
  getModelsPath(config)
);
贡献
请参阅 CONTRIBUTING.md,了解开发环境配置、版本管理政策(npm 与桌面应用同步升级版本)以及发布检查清单。项目的许可和可持续发展立场见 BUSINESS_MODEL.md——简而言之:纯开源,永久采用 MIT 许可证,不设付费墙。
git clone https://github.com/HBarefoot/engram.git
cd engram
npm install
npm run dev
如果 Engram 对你有帮助,欢迎通过以下方式支持:
- ⭐ 给仓库加星 — 这是最有力的信号,表明值得继续做下去。
- 🐛 提交 issue — 无论是 bug、功能请求,还是“我们在 <company> 用 Engram 做 <thing>”的故事,都欢迎分享。
- 💬 发起讨论 — 设计问题、集成想法、“我该如何……”等话题都欢迎。
- 💜 支持 Engram — 通过 Polar 赞助,为持续开发提供资金。所有功能都不设等级限制;赞助款将直接用于支持项目持续发布。
反馈
正在使用 Engram?告诉我哪些方面好用、哪些不好用——可以发起讨论、提交反馈,或通过命令行运行 engram feedback。永不收集遥测数据——Engram 绝不会主动向外发送数据,因此我收到的反馈只有你主动选择发送的内容。
在 Glama 上查找 Engram
Engram 已列入 Glama MCP 目录和 MCP 官方注册表,标识为 io.github.HBarefoot/engram。

许可证
MIT © 2026 HBarefoot
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。