关于 Voice Coach
Voice Coach 是面向歌唱者、英语学习者和演讲者的本地 MCP 服务。它在电脑上测量音高、发音和表达表现,并通过配套技能引导练习、记录进展。
主要功能
- 01逐音符音高与旋律分析
- 02英语音素级发音评分
- 03语速、停顿、填充词和声音指标
- 04麦克风录音与音频质量警告
- 05引导式练习与进度记录
适用场景
- 01按调性或 MIDI 旋律练唱
- 02找出反复出现的英语发音问题
- 03检查演讲语速和填充词
- 04跟踪多次辅导练习的变化
MCP 相关
该 MCP 服务提供录音、音高与语音分析、英语发音评估以及进度读取和记录工具。它还提供歌唱、发音和演讲练习提示词。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx voice-coach-mcpVOICE_COACH_DIRFolder for recordings, analysis details and progress.md (default ~/VoiceCoach).VOICE_COACH_WHISPER_MODELWhisper model for transcription and speech metrics (default small).本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
7收录的工具列表 · 更新于 5 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| name | any | 否 | |
| seconds | number | 是 |
详细介绍
voice-coach-mcp
让 Claude 拥有耳朵。一个本地 MCP 服务,可以听你唱歌、说话和朗读, 测量所听到的内容,并让 Claude 指导你的声音表现。


Claude 无法处理音频。此服务会通过麦克风录音,在你的电脑上分析音频, 并返回简洁的测量结果,供 Claude 转化为具体指导:
| 模式 | 测量内容 |
|---|---|
| 🎤 唱歌 | 每个音符的音高准确度(音分)、偏低/偏高倾向、音高漂移、稳定性和颤音。可与十二平均律、调性或 MIDI 旋律对比,并识别错误、漏唱和晚唱的音符。 |
| 🗣️ 英语发音 | 对你说出的内容与预期朗读内容进行音素级比较,提供逐词评分和常见混淆(θ → s、v → b、iː → ɪ…)。 |
| 🎙️ 公开演讲 | 每分钟词数、长停顿、填充词(英语和西班牙语)、音高单调程度和音量变化,并提供带时间戳的转录文本。 |
内置的 skill 可让 Claude 充当教练:按热身 → 练习 → 分析 → 反馈的流程开展训练, 每次录制只给出一个具体的改进重点,并在多次训练中持续记录进度。Claude 会使用你的语言回复。
- 本地且私密:音频绝不会离开你的电脑(除非你选择使用 Azure 后端)。
- 免费:使用开源模型(faster-whisper、wav2vec2),无需 API 密钥。
- 工具负责测量,Claude 负责解读:每条响应都是简洁的 JSON(≤ 2 KB),包含
confidence和warnings,因此 Claude 不会根据质量不佳的音频提供指导。
安装
你需要 uv;如需发音分析,还需要 espeak-ng:
brew install uv espeak-ng ffmpeg # macOS (ffmpeg is optional: m4a/aac input)
在 Linux 上:先安装 uv,然后运行 sudo apt install espeak-ng ffmpeg libportaudio2。在 macOS
上进行发音分析需要 Apple Silicon 和 macOS 14 或更高版本(这是 PyTorch 的要求)。
Claude Code(插件:服务 + skill)
claude plugin marketplace add FabianIMV/voice-coach-mcp
claude plugin install voice-coach@voice-coach
或者,在会话中运行:/plugin install voice-coach --marketplace FabianIMV/voice-coach-mcp。
首次启动时会通过 uv 安装 Python 依赖,这可能需要一两分钟(模型会在稍后首次使用时下载)。
如果安装后 /mcp 立即显示 voice-coach 失败,请等安装完成后从 /mcp 重新连接。
Claude Desktop(扩展)
从最新版本
下载 voice-coach.mcpb 并双击(或将其拖入 Claude Desktop)。如需使用教练 skill,还要下载
voice-coach-skill.zip,并在 Settings → Capabilities → Skills 中上传。
任意 MCP 客户端(手动配置)
claude mcp add voice-coach --scope user -- uvx --from "voice-coach-mcp[speech,pronunciation]" voice-coach-mcp
对于 Claude Desktop 的 claude_desktop_config.json,请使用绝对路径(Desktop 不会继承
shell 的 PATH;运行 which uvx 可查看路径):
{
  "mcpServers": {
    "voice-coach": {
      "command": "/opt/homebrew/bin/uvx",
      "args": ["--from", "voice-coach-mcp[speech,pronunciation]", "voice-coach-mcp"]
    }
  }
}
可选:运行一次 uvx --from "voice-coach-mcp[speech,pronunciation]" voice-coach-mcp download-models,
这样首次调用时就不必等待模型下载(Whisper 约 480 MB,音素模型约 1.3 GB)。
麦克风权限(macOS)
macOS 会将麦克风权限授予启动服务的应用:Claude Desktop,或运行 Claude Code 的终端(Terminal、iTerm、Ghostty、VS Code……)。如果权限被拒绝,macOS 会返回静音而不是错误,record_audio 会报告 no_microphone_permission。请在系统设置 → 隐私与安全性 → 麦克风中修复权限,然后重启该应用。
使用方法
直接对 Claude 说:
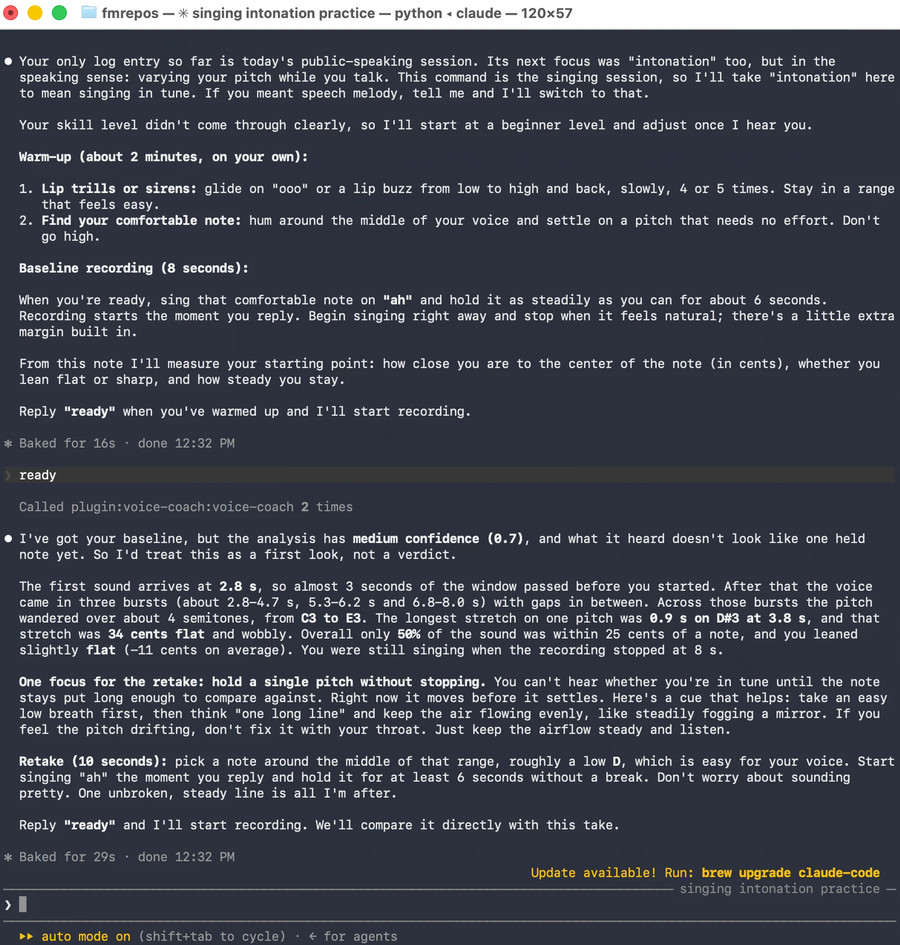
- “我想练习唱歌时唱准音高。我是初学者。”
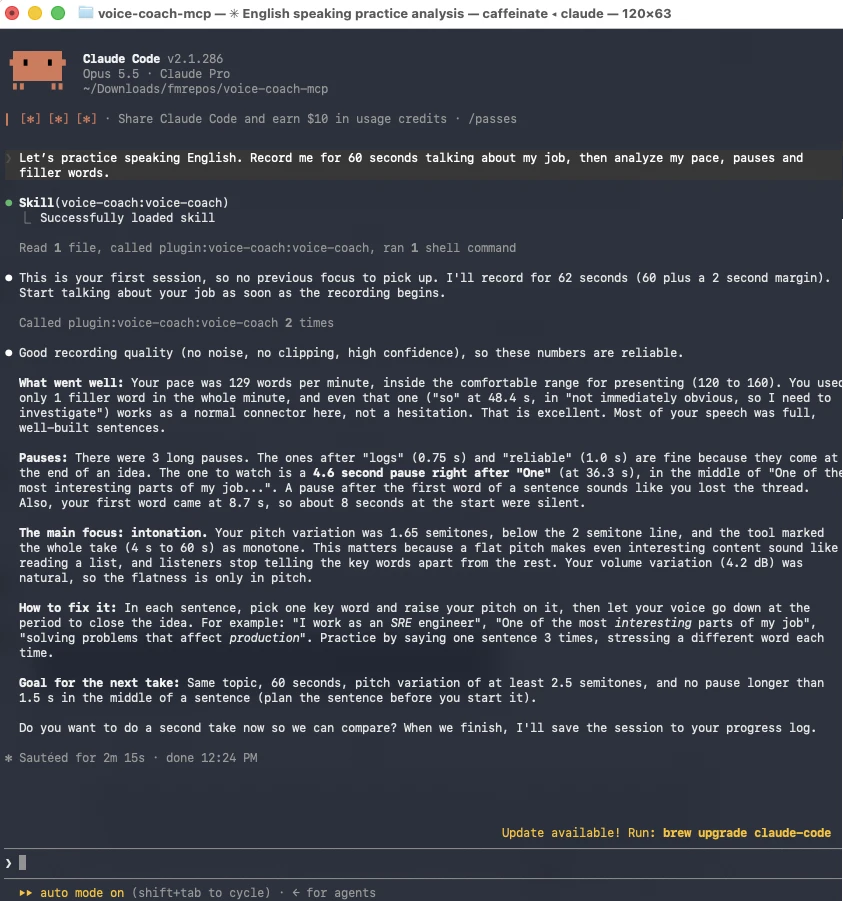
- “录下我介绍项目的 30 秒讲话,并告诉我用了多少个填充词。”
- “帮我练习发 ‘th’ 的音。给我一些句子朗读,并为我的发音打分。”
- “将这段语音备忘录与 melody.mid 进行分析。”(wav/mp3/m4a 路径均可)。
- “我练得怎么样了?”(Claude 会读取你的进度日志)。
Claude Code 中的真实练习会话:一段关于工作的 60 秒讲话,以及单个持续音的唱歌基线测试。
也可以通过 MCP 提示词进行引导式练习:singing_session、pronunciation_session
和 speaking_session(在 Claude Code 中:/mcp__voice-coach__singing_session)。
工具
| 工具 | 用途 |
|---|---|
record_audio(seconds, name?) | 将 16 kHz 单声道 WAV 录制到 ~/VoiceCoach/recordings/,并报告电平、削波和噪声情况。 |
analyze_pitch(audio, reference_midi?, key?, midi_track?) | 按音符评估音准,与平均律、调性(“A minor”、“G major”……)或 MIDI 旋律进行比较。 |
transcribe(audio, language?) | 在本地转录,并提供分段和单词时间戳。 |
speech_metrics(audio, language, pause_threshold_s=0.7) | 语速、长停顿、填充词、音高单调度和音量变化。 |
assess_pronunciation(audio, expected_text, language="en-US") | 提供英语音素级发音评分和错误。 |
read_progress(entries=5) / log_progress(entry) | 读取并追加记录到 ~/VoiceCoach/progress.md。 |
音频可以是路径,也可以是 record_audio 返回的名称。结果过长时,系统会返回最相关的项目,并将其余内容保存到音频文件旁边(full_details)。
示例:在带有已知偏差的合成 C 大调音阶上使用 analyze_pitch
{"audio":"examples/audio/c_major_scale.wav","duration_s":7.36,"mode":"equal_temperament",
 "summary":{"notes":8,"range":"C4–C5","pct_within_25_cents":75.0,"mean_deviation_cents":-7.8,
   "mean_abs_deviation_cents":13.6,"tendency":"centered","drift_cents":-1.0,
   "stability":{"stable":7,"vibrato":1,"unstable":0}},
 "notes":[{"t":0.4,"dur":0.62,"note":"C4","cents":0,"stability":"stable"},
   {"t":1.84,"dur":0.62,"note":"E4","cents":-30,"stability":"stable"},
   {"t":4.72,"dur":0.62,"note":"B4","cents":-42,"stability":"stable"},
   {"t":5.44,"dur":1.43,"note":"C5","cents":-2,"stability":"vibrato","vibrato_hz":5.5,"vibrato_pp_cents":84}, "…"],
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
使用 MIDI 参考时,服务会检测到旋律低了一个八度(octave_shift: -1)、晚了 1 秒开始(start_offset_ms: 1003),并且有一个音晚了 134 ms。
示例:朗读 “I sink the berry best sings…” 来练习 assess_pronunciation,目标文本为 “I think the very best things in life are free”
{"backend":"wav2vec2-local",
 "summary":{"overall_score":90,"words":10,"words_with_errors":3,
   "errors":{"substitution":3,"deletion":0,"insertion":0},
   "frequent_confusions":[{"expected":"θ","detected":"s","count":2},{"expected":"v","detected":"b","count":1}]},
 "words":[{"word":"think","score":75,"t":0.56,"expected":"θ ɪ ŋ k","detected":"s ɪ ŋ k",
     "errors":[{"type":"substitution","expected":"θ","detected":"s"}]},
   {"word":"very","score":75,"t":0.96,"expected":"v ɛ ɹ i","detected":"b ɛ ɹ i",
     "errors":[{"type":"substitution","expected":"v","detected":"b"}]}, "…"],
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
示例:在插入了停顿和填充词的短篇合成讲话上使用 speech_metrics
{"language":"en",
 "pace":{"words":36,"speaking_time_s":14.9,"words_per_minute":145,"wpm_excluding_long_pauses":165},
 "pauses":{"threshold_s":0.7,"count":2,"total_s":1.9,"max_s":1.03,"per_minute":8.1,
   "items":[{"t":4.42,"dur":1.03,"after":"speaking"},{"t":12.1,"dur":0.83,"after":"normal"}]},
 "fillers":{"total":6,"per_minute":24.2,"by_type":{"um":1,"so":1,"uh":1,"you know":1,"like":1,"i mean":1}},
 "pitch":{"median_f0_hz":101,"std_semitones":1.53,"monotone":true,"monotone_stretches":[{"t":0.0,"end":12.0}]},
 "volume":{"mean_dbfs":-21.2,"std_between_words_db":2.4,"low_variation":true},
 "confidence":{"value":1.0,"level":"high"},"warnings":[]}
合成语音非常平淡,因此结果为 monotone: true。其中还包含一个西班牙语示例。
所有示例输出都是服务通过 stdio 返回的真实响应,使用合成音频通过
examples/generate_examples.py 重新生成;请参阅
examples/outputs/。
工作原理
- 音高:pYIN(librosa)会找到有声帧;随后使用抛物线插值,根据每帧的谐波峰值进行细化(从 C2 到 C6 的精度约为 1 音分)。音符会在静音、能量下降和持续音高变化处拆分;颤音不会拆分音符。提供 MIDI 参考时,会通过互相关找到八度和偏移量,使用 Needleman–Wunsch 对齐音符,并拟合节奏线
t_sung = a·t_ref + b,以评估每个起音。 - 语音:faster-whisper 会转录语音并提供单词时间戳(初始提示词会保留填充词)。由于 Whisper 会将单词结尾延伸到静音部分,因此停顿时长根据音频能量测量。模棱两可的填充词(“like”“so”)只有在逗号或停顿隔开时才会计入。
- 发音:phonemizer + espeak-ng 会给出预期的 IPA 音素;
facebook/wav2vec2-lv-60-espeak-cv-ft音素模型会识别实际说出的内容;两者通过编辑距离进行对齐。常见的美式英语变体(闪音、弱读 schwa、连读 r、声门塞音)不会计为错误。 - 质量优先:削波、背景噪声、静音和缺少麦克风权限都会作为警告报告,并降低置信度。
已知限制:一次只能处理一个人声(伴奏会降低音高检测效果);两个以完美连音唱出的相同音符会被视为一个音符;音素模型会利用句子上下文,偶尔可能会“纠正”发音错误的单词;发音评估仅支持英语。
隐私和网络访问
插件运行、写入和下载的内容如下:
- 运行:
uv会从插件文件夹启动服务(uv run --frozen,由uv.lock锁定版本);服务使用espeak-ng获取预期音素,仅使用ffmpeg读取 m4a/aac 文件。 - 麦克风:仅在
record_audio运行期间启用,时长为 Claude 要求的秒数。 - 写入:录音和
progress.md会写入~/VoiceCoach(或VOICE_COACH_DIR);每个已分析的音频旁边都会生成一个分析详情文件<audio>.<tool>.json(如果该文件夹为只读,则写入~/VoiceCoach/analysis)。再次分析同一音频时,会替换其详情文件;不会覆盖或删除其他内容。 - 下载:首次启动时从 PyPI 下载 Python 依赖项;首次使用时从 Hugging Face 下载模型:faster-whisper 模型(默认使用
Systran/faster-whisper-small)和facebook/wav2vec2-lv-60-espeak-cv-ft。之后,模型会从本地缓存加载。 - 发送:默认不发送任何内容。没有遥测、没有账户、没有 API 密钥。只有在设置
VOICE_COACH_PRONUNCIATION_BACKEND=azure,并提供你自己的AZURE_SPEECH_KEY和AZURE_SPEECH_REGION时,assess_pronunciation才会将音频和预期文本发送到你所在区域的 Azure Speech。
配置
| 变量 | 默认值 | 用途 |
|---|---|---|
VOICE_COACH_DIR | ~/VoiceCoach | 录音、分析详情和 progress.md |
VOICE_COACH_MAX_SECONDS | 120 | record_audio 的最长时长 |
VOICE_COACH_A4_HZ | 440 | 调音参考 |
VOICE_COACH_MAX_BYTES | 2048 | 响应大小上限 |
VOICE_COACH_WHISPER_MODEL | small | tiny、base、small、medium、large-v3… |
VOICE_COACH_WHISPER_DEVICE / _COMPUTE_TYPE | cpu / int8 | CTranslate2 设置 |
VOICE_COACH_FILLERS | — | 你自己的填充词 TOML(参见 fillers.toml) |
VOICE_COACH_PRONUNCIATION_BACKEND | local | local(wav2vec2)或 azure |
VOICE_COACH_PRONUNCIATION_DEVICE | auto | auto(可用时使用 MPS)、cpu 或 mps |
AZURE_SPEECH_KEY、AZURE_SPEECH_REGION | — | 可选的 Azure Pronunciation Assessment 后端(pip install voice-coach-mcp[azure]);之后音频会发送到 Azure |
PHONEMIZER_ESPEAK_LIBRARY | 自动检测 | libespeak-ng 不在 Homebrew 默认位置时使用的路径 |
开发
git clone https://github.com/FabianIMV/voice-coach-mcp.git && cd voice-coach-mcp
uv sync --extra speech --extra pronunciation
uv run pytest                 # fast suite: synthetic audio, simulated microphone
uv run pytest -m models       # real Whisper and wav2vec2 models on synthetic speech
uv run ruff check . && uv run ruff format --check .
设计原则和发布流程请参阅 CONTRIBUTING.md。
src/voice_coach_mcp/
  server.py         MCP tools and prompts (thin layer)
  audio/            loading, recording and quality checks
  singing/          pitch tracking, music theory, MIDI reference, pitch accuracy
  speech/           transcription, speech metrics, filler lists
  pronunciation/    expected phonemes, alignment, wav2vec2 and Azure backends
  output.py         2 KB response budget and details file
  progress.py       progress log
skills/voice-coach/ coaching skill (also bundled in the Python package)
examples/           synthetic audio and real tool outputs
许可证和鸣谢
MIT © FabianIMV。基于 faster-whisper、 librosa、wav2vec2 音素识别 和官方 MCP Python SDK 构建。可选的发音扩展使用了 phonemizer 和 espeak-ng,二者均采用 GPL-3.0 许可证。示例语音由 espeak-ng 和 Piper(公有领域的 LJSpeech 语音)合成。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。