关于 FastOCR
FastOCR 是一个 MCP 服务,可通过 FastOCR API 将本地扫描版 PDF 和图像转换为文本或可搜索 PDF,适合使用 MCP 客户端处理文档的用户。它可自动识别 100 多种语言。
主要功能
- 01识别 PDF 和图像中的文字
- 02输出文本或可搜索 PDF
- 03自动识别 100 多种语言
- 04查询文档状态和页数
- 05列出或删除已存文档
- 06查看剩余页面额度
适用场景
- 01提取扫描合同中的文字
- 02读取收据图像中的文字
- 03为归档 PDF 创建可搜索副本
- 04查看最近处理的文档和页面额度
MCP 相关
stdio MCP 服务提供工具,可提交本地 PDF 和图像进行 OCR、获取结果、查看文档并管理已存文件。文件会发送到 FastOCR API。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍




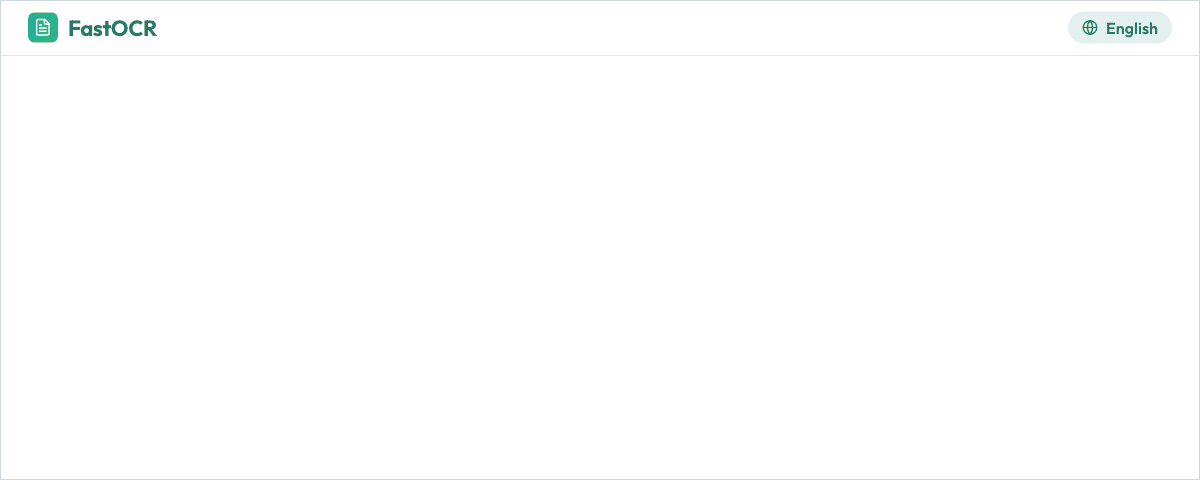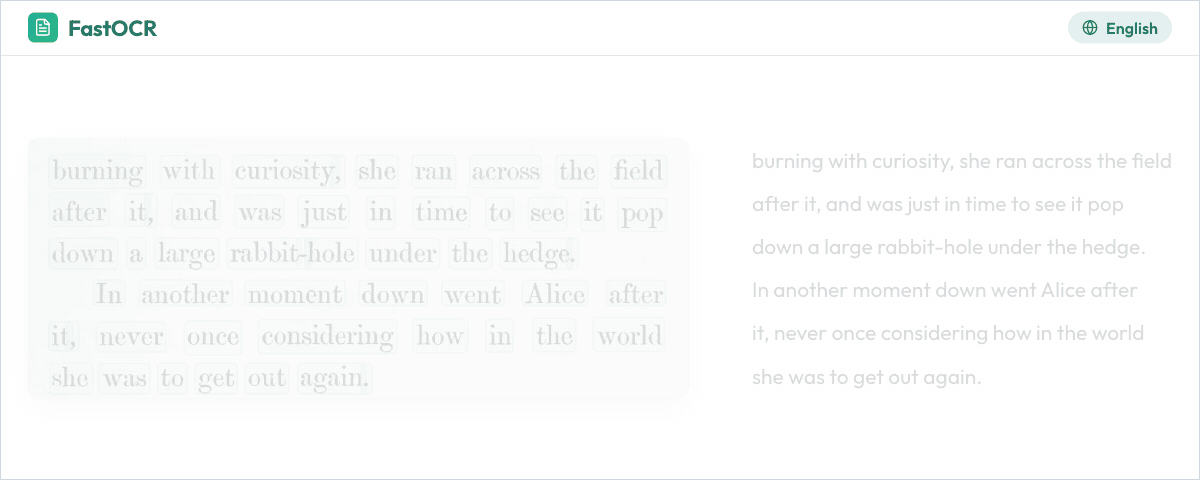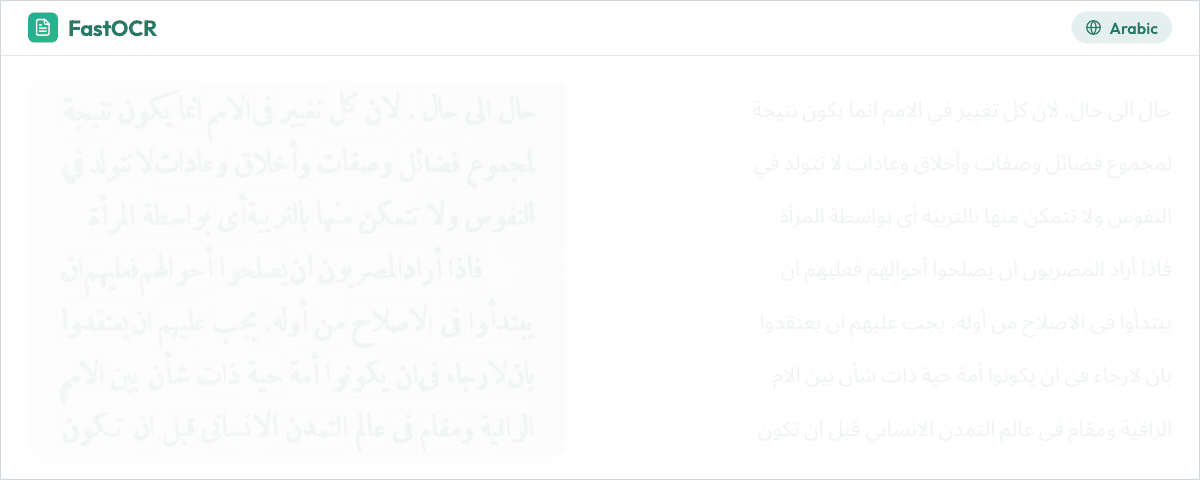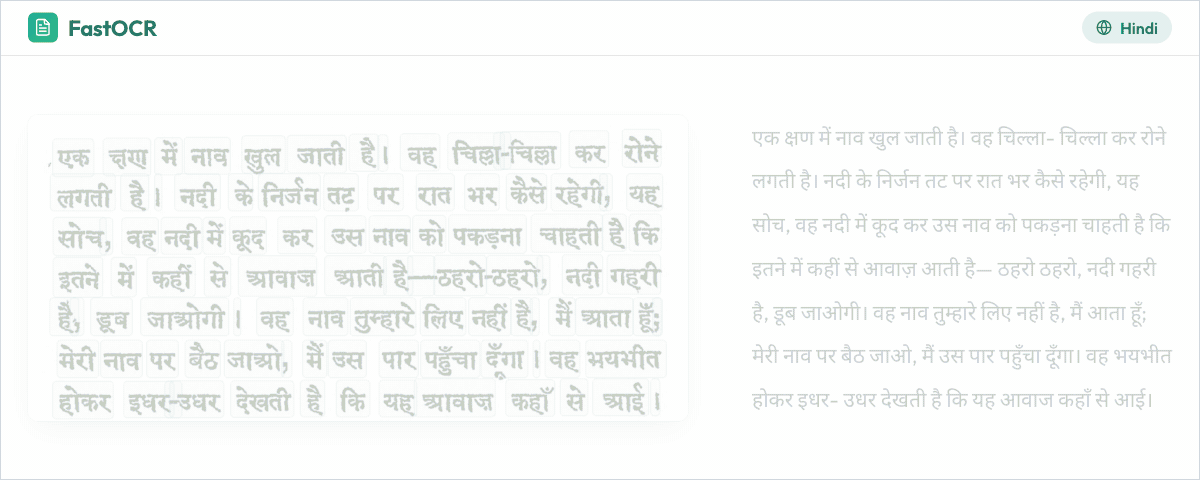
一个 MCP 服务,可让客户端通过 stdio 对本地扫描版 PDF 或图像进行 OCR;文件只会发送到 FastOCR API。
快速开始
- 在开发者控制台中创建 API 密钥。
- 将服务添加到 Claude Code:
claude mcp add fastocr -e FASTOCR_API_KEY=your_api_key -- uvx fastocr-mcp
- 提问:“对 ~/Scans/contract.pdf 进行 OCR。”
使用 uv 时无需安装任何内容;客户端会运行 uvx fastocr-mcp。更倾向于使用 pip?运行 pip install fastocr-mcp,并使用命令 fastocr-mcp。需要 Python 3.10 或更高版本。
其他客户端
每个客户端都需要使用相同的命令 uvx fastocr-mcp,并在 FASTOCR_API_KEY 中设置密钥。
Claude Desktop
将以下内容添加到 claude_desktop_config.json(Settings > Developer > Edit Config),然后重启 Claude Desktop:
{
  "mcpServers": {
    "fastocr": {
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
Cursor
将以下内容添加到 ~/.cursor/mcp.json(所有项目)或 .cursor/mcp.json(单个项目):
{
  "mcpServers": {
    "fastocr": {
      "type": "stdio",
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
VS Code
将以下内容添加到工作区中的 .vscode/mcp.json。VS Code 使用 servers,而不是 mcpServers:
{
  "servers": {
    "fastocr": {
      "type": "stdio",
      "command": "uvx",
      "args": ["fastocr-mcp"],
      "env": { "FASTOCR_API_KEY": "your_api_key" }
    }
  }
}
如果通过 pip 安装,请使用 "command": "fastocr-mcp" 和 "args": []。
示例
用自然语言向客户端提问:
- “对 ~/Downloads/scanned-contract.pdf 进行 OCR,并总结终止条款。”
- “读取 /Users/me/Desktop/receipt.jpg 中的文本。”
- “为 /Users/me/archive/1998-letters.pdf 创建可搜索副本。”
- “列出我最近的五份 FastOCR 文档。”
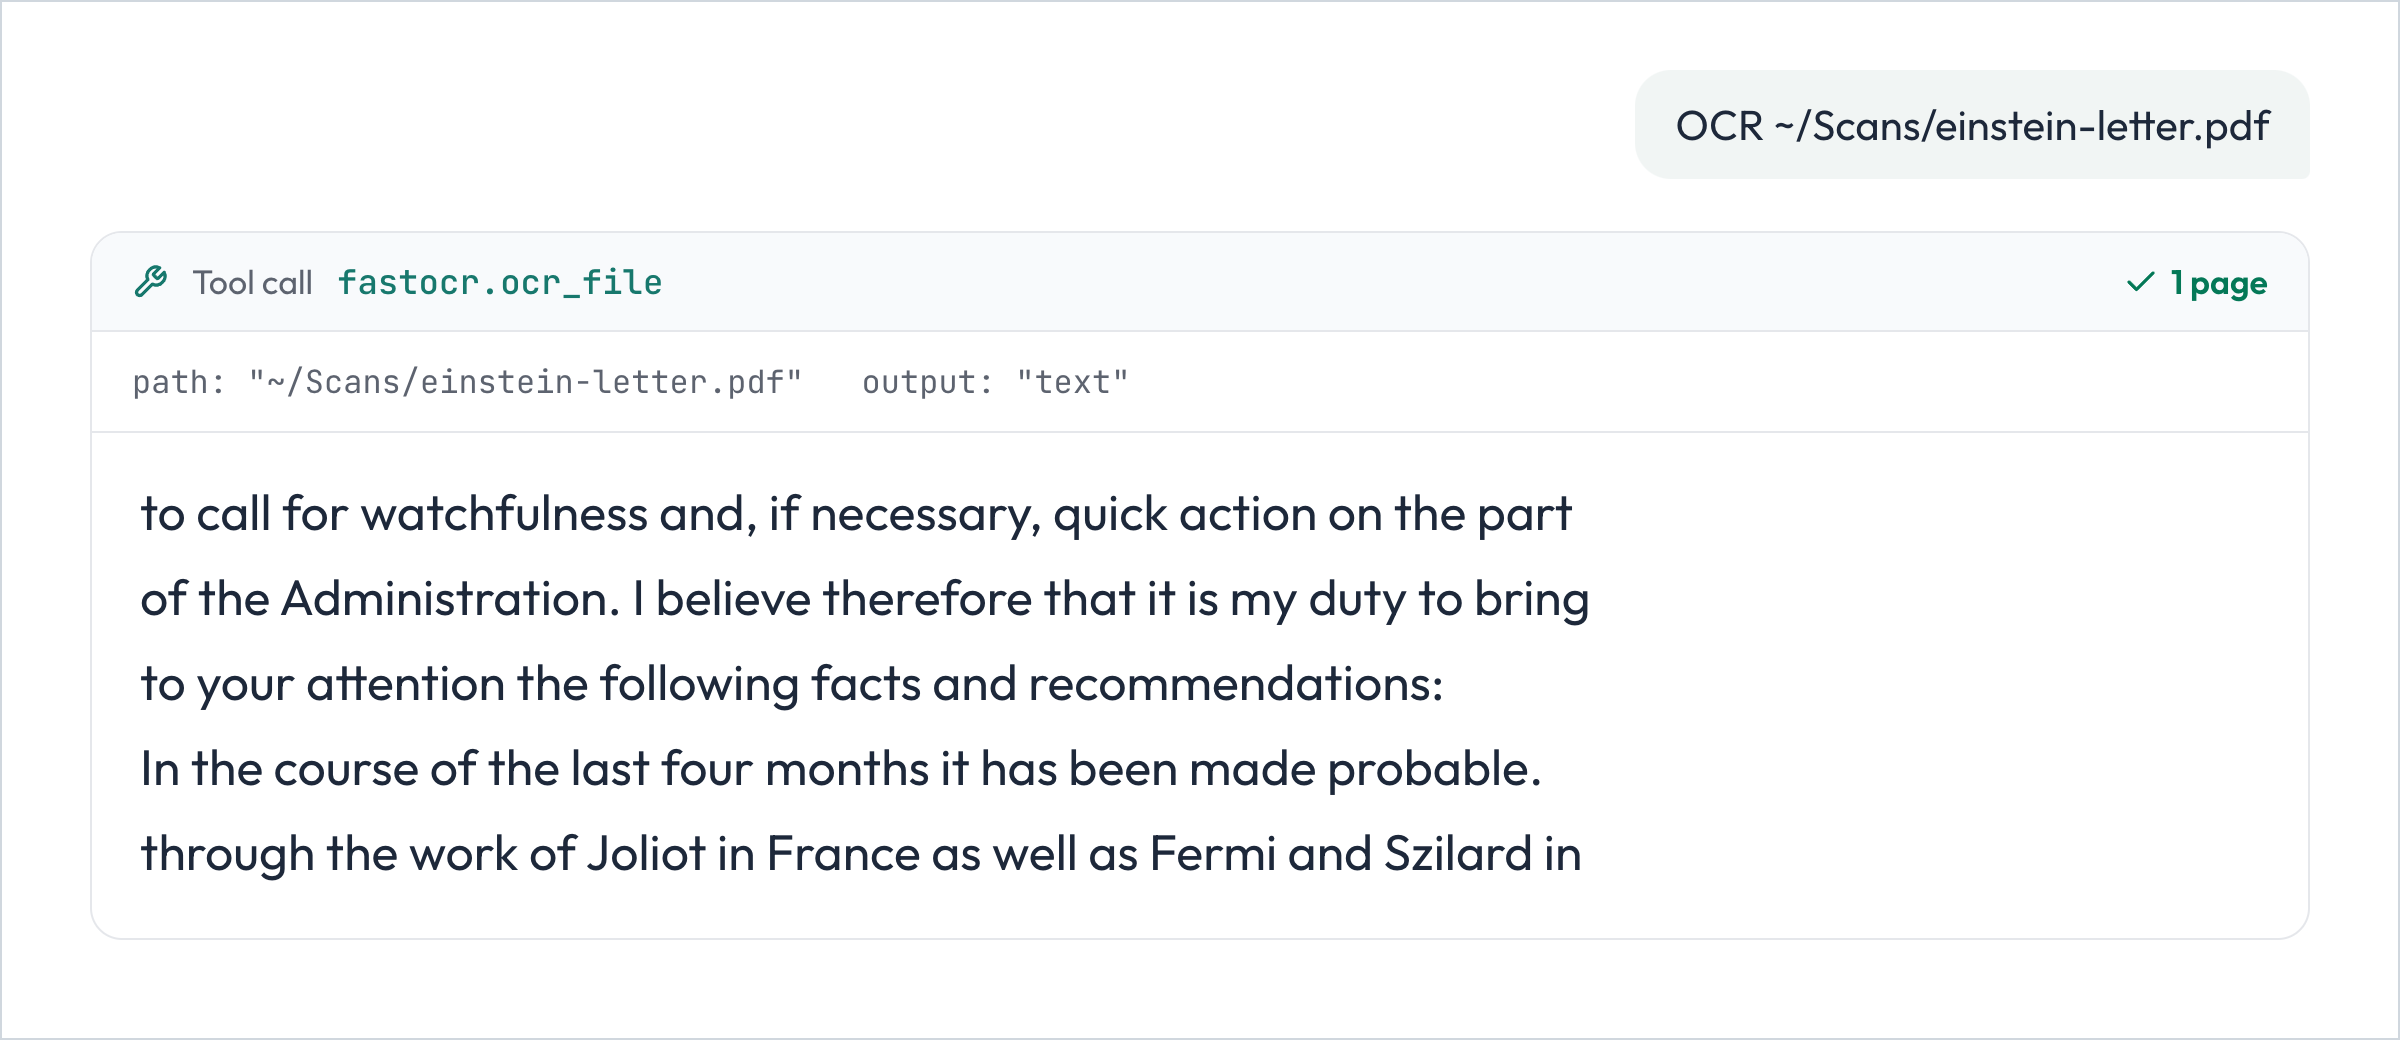
上方文本是 FastOCR 对扫描页面返回的未经编辑的输出。
工具
| 工具 | 功能 |
|---|---|
ocr_file(path, output="text", output_path=None) | 上传本地 PDF 或图像,运行 OCR 并等待最多 45 秒;较大的文档会返回其 ID,以供 get_document 使用。output="text" 会返回文本(超过 20,000 个字符的文本会被截断,完整文本会保存到 output_path,或输入文件旁的 <file>.ocr.txt)。output="pdf" 会将可搜索 PDF 保存到 output_path,或输入文件旁的 <file>.searchable.pdf。 |
ocr_pdf(path, output="text", output_path=None) | 与 ocr_file 功能相同,只是使用旧名称,以确保现有配置继续正常工作。 |
get_document(document_id, output="status", output_path=None) | 获取文档状态和页数;使用 output="text" 或 "pdf" 时,会等待最多 45 秒并获取处理完成的结果。再次获取结果不消耗页数。 |
list_documents(limit=20) | 按时间倒序列出账户中最近的文档。 |
get_balance() | 查看账户剩余页数:免费页数(每月重置)、合同页数(如有)和 Page Packs,并提供购买更多页数的链接。不消耗页数。 |
delete_document(document_id) | 删除 FastOCR 上的文档及其存储文件。本地文件不会受到影响。 |
返回内容
| 返回内容 | 获取方式 |
|---|---|
| 文档文本 | ocr_file(path),或 get_document(id, output="text") |
| 可搜索 PDF | ocr_file(path, output="pdf"),保存到输入文件旁 |
| 状态和页数 | get_document(id) |
| 最近的文档 | list_documents() |
语言和文件
- 支持 100 多种语言,可自动检测。无需设置语言。
- 支持最大 1 GiB 的 PDF 文件,以及最大 20 MiB 的 PNG、JPG、JPEG、GIF、WebP 和 BMP 图像。每张图像计为一页。
- 基于官方
fastocr-sdk和官方 MCP Python SDK 构建。
页数和定价
任何已登录的 FastOCR 账户都可以创建 API 密钥并立即开始使用。每个账户每月可获得 50 页免费额度,与网站上的 PDF 共用;一张图像计为一页。需要更多页数时,可在定价页面购买 Page Pack。网站和 API 共用 Page Pack 和页数余额;让你的 Agent 运行 get_balance 即可查看剩余页数。账户最多可同时处理 2 个文档;签订 API 合同或购买 10,000 页及以上时,最多可同时处理 10 个文档。创建第一个密钥即表示你接受 API 条款。
错误和配置
工具错误信息会告知 Agent 如何处理:密钥被拒绝、账户页数不足(buy_pages)、同时处理的文档过多(concurrency_limit)、文件缺失或文件类型不受支持。每条消息都会说明下一步该怎么做。文档处理过程中若页数用尽,则会以 buy_pages 错误结束;工具会说明原因并提供定价页面链接。错误代码见 API 文档。
| 变量 | 用途 |
|---|---|
FASTOCR_API_KEY | 必填。你的 API 密钥。 |
FASTOCR_BASE_URL | 可选。覆盖 https://api.fastocr.org。 |
支持和许可证
问题请联系:[email protected]。错误报告和功能请求:GitHub issues。Python SDK:fastocr-python。MIT 许可证;详见 LICENSE。由 FastOCR 制作。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。