关于 Groundline
Groundline 分析发动机及台架测试数据,报告中的结论关联到可复现的计算,并逐项核验数字。它面向需要可审计报告的测试数据分析人员,也可作为命令行工具或 MCP 服务运行。
主要功能
- 01将测试过程划分为不同阶段
- 02检查传感器、限值、阀门和振荡
- 03对照仿真预测分析数据
- 04在证据账本中记录计算
- 05依据证据核验结论中的数字
- 06复现报告中的计算
适用场景
- 01分析发动机热试车数据
- 02检查传感器状态和限值事件
- 03将测试过程与仿真数据比较
- 04审计并复现报告结论
MCP 相关
Groundline 向 MCP 客户端提供五种工具:`open_run`、`list_analysis_tools`、`run_analysis`、`verify` 和 `write_html_report`。MCP 客户端可规划分析,同时沿用 Groundline 的核验规则。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
5收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| run_path | string | 是 | |
| limits_path | any | 否 | |
| reference_path | any | 否 |
详细介绍
Groundline
English | 简体中文
面向发动机测试数据的可验证 AI Agent:报告中的每个数字都能追溯到可复现的计算。
在线演示:在浏览器中使用真实的静态点火证据,试试看能否让验证器放过一个错误数字。
这个名字源于 grounded(每个数字都有来源)和 redline(限值检查)。
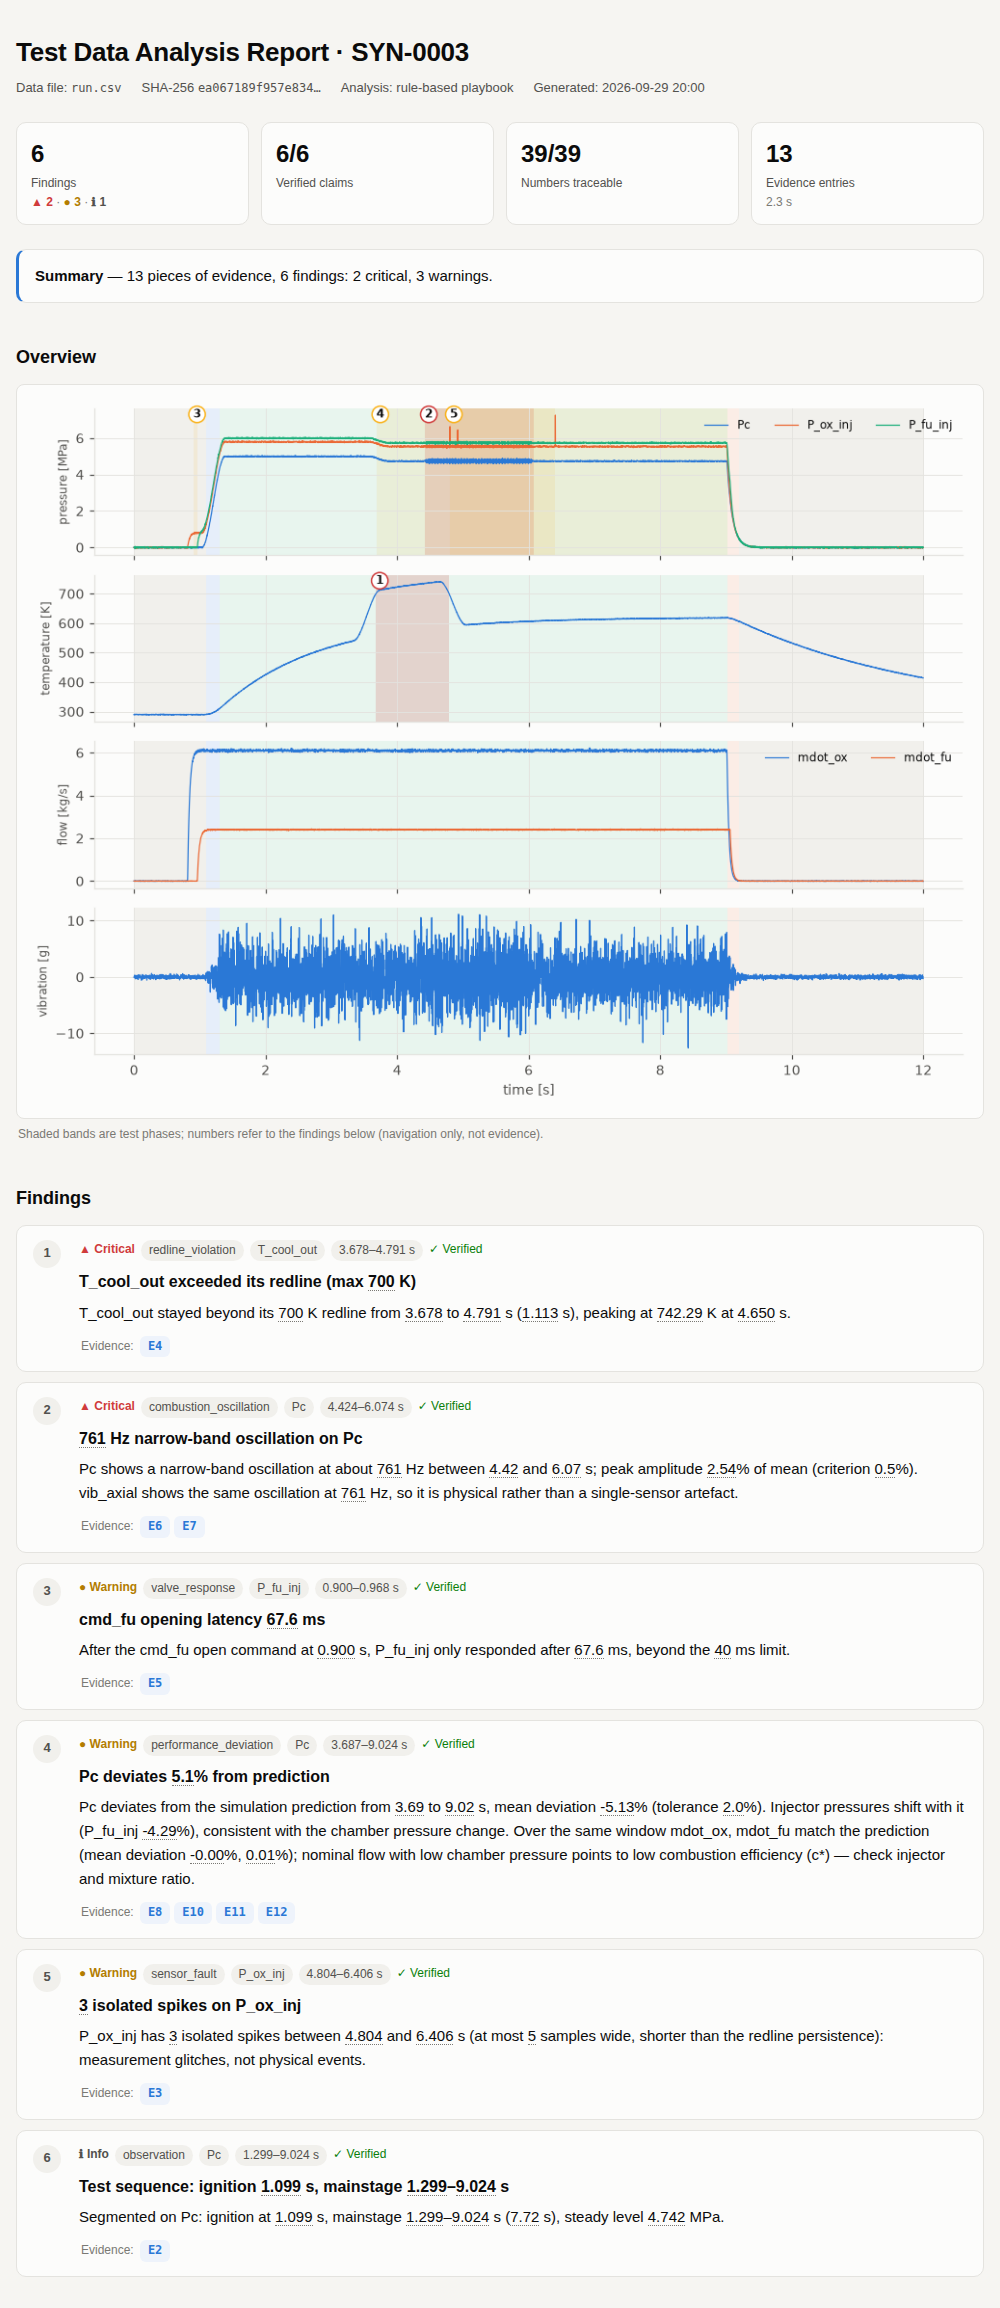
向 Groundline 提供发动机热试车(或任何台架测试)的数据,它便会将运行过程划分为不同阶段,检查传感器健康状况、限值、阀门响应和振荡,与仿真预测进行比较,并撰写分析报告。与典型的“AI 分析”不同:
- 所有数字都来自确定性工具。 大模型从不查看原始采样数据。它只决定调用哪些工具、如何深入分析,并将结果转化为易读的发现。
- 每次工具调用都会记录到证据账本中。 账本会记录参数、数据文件的 SHA-256、工具源代码的哈希值、结果和图表。发现只能引用这些条目(E1、E2、……)。
- 验证器会检查每条发现中的每个数字。 标题或陈述中的每个数字都必须能在其引用的证据中找到(允许四舍五入,以及 s↔ms、分数↔% 的换算)。找不到的数字会在报告中标出红色波浪线,LLM Agent 会收到驳回结果,并有一次修正机会。验证器还会检查数字的含义:数字后标注的单位(s、Hz、%、bar、N·s 等)必须与证据字段的单位一致;由“峰值”“持续时间”“平均值”或“冲量”等词引出的数字,必须来自具有相应角色的字段(参见语义验证)。
- 每条发现都可以复现。
groundline reproduce report.json会在原始数据上重新运行账本中的每条记录,并逐一比较结果。
状态:v0.1 原型。基准测试使用内置合成数据生成器生成的数据。公开的真实测试是示例案例:一次固体发动机静态点火(HANARO)、一次液体发动机热试车(Triton),以及四次与团队自有报告进行核对的混合动力发动机热试车(UVic MULE-1)。这些案例均不包含限值、阀门指令或仿真预测,因此目前这些检查仍只在合成数据上得到验证。
快速开始
pip install -e ".[all]"        # minimal install needs only numpy/scipy/pandas/matplotlib: pip install -e .

groundline demo                  # generate a synthetic hot-fire with anomalies and analyse it with the rule agent
open groundline_demo/report.html
groundline reproduce groundline_demo/report.json   # 13/13 evidence entries reproduced exactly
分析你自己的数据(CSV 的第一列为时间;也支持 NI TDMS):
groundline analyze path/to/run.csv --reference sim.csv --limits limits.json
limits.json 的格式请参阅 groundline synth 生成的示例:限值、限值持续时间、允许的阀门延迟、振荡阈值,以及与仿真结果偏差的容差。
原始 DAQ 导出数据很少采用 Groundline 所需的布局。groundline ingest 可根据一个小型 JSON 映射文件将其转换为所需格式,并为你生成映射草稿:
groundline ingest raw_log.csv                         # writes raw_log/map.json and lists what it guessed
groundline ingest raw_log.csv --map raw_log/map.json  # writes raw_log/run.csv + meta.json
groundline analyze raw_log/run.csv
草稿会从 Chamber Pressure (psi) 这样的表头或名称上方的单位行中读取单位(也会重新对齐错开一个单元格的单位行),查找时间列,将燃烧室压力命名为 Pc,把多个推力传感器的测量值相加得到 F_thrust,并根据单位和名称为各通道指定类型。随后,你需要在映射中设置它无法推断的信息:名称、时间窗口、统一网格(grid_hz)、允许桥接的间隔时长(max_gap_s,超过该时长后运行数据会保留 NaN,以便显示数据缺失),以及各通道的 scale / offset。下文的 Triton 和 UVic 示例均通过这种方式转换,并且与早先手动编写的转换结果完全一致。请先检查草稿,再决定是否信任它;不要将测试结果写入 description:LLM Agent 会读取该字段。
使用大模型
规则 Agent(默认)是一份固定检查清单,无需模型。使用大模型 Agent 时,模型会自行规划分析、交叉核对并撰写发现。
最简单的配置方式是在项目根目录创建 .env(该文件已列入 .gitignore,不会被提交):
cp .env.example .env      # fill in OPENAI_API_KEY; change GROUNDLINE_AGENT / GROUNDLINE_LLM_MODEL as needed
groundline config         # show the configuration in effect (keys masked)
groundline demo           # from now on every command uses the agent and model from .env
Groundline 会从当前目录开始向上查找 .env;命令行参数和 Shell 中已设置的变量优先级更高。你也可以跳过 .env,改用环境变量或参数:
# OpenAI
export OPENAI_API_KEY=sk-...
groundline analyze run.csv --agent openai --model gpt-4o-mini

# Any OpenAI-compatible endpoint: Qwen, DeepSeek, vLLM, a local Ollama ...
export GROUNDLINE_LLM_BASE_URL=http://localhost:11434/v1   # e.g. Ollama
export GROUNDLINE_LLM_MODEL=qwen2.5:32b
groundline analyze run.csv --agent openai

# Anthropic
export ANTHROPIC_API_KEY=...
groundline analyze run.csv --agent anthropic --model claude-sonnet-5-5
对大模型 Agent 进行基准测试时,除了检测率,Groundline 还会统计验证器在初稿中发现的编造数字、修正轮次后的结果以及令牌用量:
groundline eval --agent openai --model gpt-4o-mini --n 10 --lang en --out eval_openai.json
每次运行后都会写入结果文件。如果运行失败(例如超时、API 配额耗尽),使用 --resume eval_openai.json 并保持 --n、--seed 和 --suite 相同,即可保留已完成的运行,只执行剩余部分。
使用官方 OpenAI 端点时,会自动使用 Responses API(gpt-5.6-sol 等推理模型只能在该 API 中同时进行推理和调用工具);使用 GROUNDLINE_LLM_REASONING_EFFORT 设置推理力度。其他兼容 OpenAI 的服务使用 Chat Completions;使用 GROUNDLINE_OPENAI_API=responses|chat 可强制指定其中一种。默认不发送 temperature;使用 GROUNDLINE_LLM_TEMPERATURE 设置该值。使用 --agent anthropic 时,同一变量用于设置力度级别(low … max);提示词前缀会在 Agent 的各个步骤之间缓存。
测试数据通常较敏感,因此该接口专为本地部署而构建:模型只能看到工具输出的摘要,不会看到原始数据。
作为 MCP 服务
Groundline 已在 MCP Registry 中列出,名称为 io.github.fhs1220888/groundline。从注册表安装的客户端会通过 uvx groundline mcp 运行它;如需手动添加(Claude Desktop、Cursor 等):
{
  "mcpServers": {
    "groundline": { "command": "uvx", "args": ["groundline", "mcp"] }
  }
}
从本地检出目录运行 groundline mcp(或 groundline-mcp),即可通过 stdio 运行同一服务。
它提供五个工具:open_run、list_analysis_tools、run_analysis、verify 和 write_html_report。任何 MCP 客户端(Claude Desktop、Cursor 或你自己的 Agent)都可以充当规划器;验证规则保持不变。
分析工具
| 工具 | 功能 |
|---|---|
describe_data | 通道、采样率、单位、NaN 计数 |
segment_phases | 根据舱室压力的 10 % / 90 % 位置,将运行划分为测试前、启动、主阶段、关机和测试后,并记录阀门指令时间 |
check_sensor_health | NaN 间隔、信号冻结、孤立尖峰(局部稳健 σ) |
check_redlines | 使用持续时间标准和 5 ms 平滑进行红线检查;短暂异常会计为已抑制瞬态 |
measure_valve_response | 测量从阀门指令发出到响应通道开始变化的延迟,并与允许值比较 |
detect_oscillation | 滑动窗口 FFT:窄带振荡的频率、振幅(相对于均值的百分比)和起止时间 |
compare_reference | 与仿真预测结果比较:平均偏差、RMSE 和持续偏差区间 |
pulse_metrics | 测量脉冲形通道(如固体发动机推力)的峰值、作用时间、积分(总冲量)和平均值 |
check_thrust_pressure_ratio | 推力与舱室压力之比(两者均扣除基线)应与推力系数 × 喉部面积成正比;发动机燃烧期间若变化超过 50 %,则会发出标记(可能是喉部侵蚀或故障,也可能是传感器故障) |
channel_stats / plot_window | 统计信息和绘图,用于深入分析 |
groundline tools 会打印完整的参数说明。
基准测试
合成生成器可注入六种已知异常,并始终提供真实标注:燃烧振荡、冷却剂超温、传感器冻结或缺失、测量尖峰、燃料阀延迟,以及燃烧室压力偏低(c* 效率偏低)。这使得 Agent 的表现可衡量:
groundline eval --n 50 --seed 1000
规则 Agent 在 50 次随机运行中的表现:
| 异常 | n | 召回率 | 类别准确率 | 起始时间误差中位数 |
|---|---|---|---|---|
| 振荡 | 15 | 100% | 100% | 12 ms |
| 超温 | 22 | 100% | 100% | 0 ms |
| sensor_dropout | 10 | 100% | 100% | 0 ms |
| sensor_spike | 8 | 100% | 100% | 0 ms |
| valve_delay | 15 | 100% | 100% | 0 ms |
| pc_deficit | 14 | 100% | 100% | 112 ms |
总体精确率为 100%,在 4 次正常运行中没有误报;134/134 项发现均通过验证,946/946 个数字均有依据。
这六种异常类型和检测器是一起编写的,因此上表主要说明这些工具能够检测出生成器专门注入的异常。下文 LLM 结果之后还有两项基准测试,将逐步消除这一局限。
LLM Agent(gpt-5.6-sol,Responses API)在相同种子的前 14 次运行中的表现(--n 14 --seed 1000,包括 2 次正常运行和全部六种异常类型):
| 指标 | 规则 Agent | gpt-5.6-sol |
|---|---|---|
| 召回率 / 类别准确率 | 100% / 100% | 100% / 100% |
| 精确率 | 100% | 95%(1 次误报) |
| 正常运行中的误报 | 0 | 0 |
| 初稿中编造的数字 | — | 0 / 376 |
| 每次运行耗时 | 1.6 s | 22 s,约 19k 输入 / 1,400 输出 tokens |
这次误报将延迟阀门导致的冷却剂温度滞后,报告成了单独的性能偏差,而没有将其归因于阀门延迟。由于只有 14 次运行、单次测试且模型输出具有非确定性,因此这些数字只能作为粗略参考。
首次评估的精确率只有 36%:37 个“误报”中有 35 个其实是已通过的检查,例如“阀门响应在限值内”或“未检测到振荡”,模型却将其归入异常类别。在提示词中添加一条规则(“类别不是 observation,就表示发现了异常;通过的检查使用 observation”)后,精确率上升到 95%。评分方式没有改变。
使用真实模型测试来源标签
对相同的 14 次合成运行(种子 1000–1013,英文,gpt-5.6-sol,低推理力度),分别进行一次要求为每个数字标注来源字段的测试,以及一次不作此要求的测试:
| 开启标签 | 关闭标签 | |
|---|---|---|
| 召回率 / 精确率 | 100% / 91%(2 次误报) | 100% / 95%(1 次误报) |
| 正常运行中的误报 | 0 | 0 |
| 最终报告中已标注来源的数字 | 236 / 240(98%) | — |
| 初稿中的错误标签 | 0 | — |
| 初稿中未通过检查的数字 | 0 / 242 | 0 / 314 |
| tokens,14 次运行 | 277k 输入 / 18.5k 输出 | 296k 输入 / 17.5k 输出 |
| 每次运行耗时 | 21 s | 20 s |
标注没有带来可测量的成本,而且模型几乎为每个数字都正确标注了来源,因此它输出的每个数字都只会与一个字段核对(在下文的植入错误基准测试中,错置的数值在未标注时有 67% 的概率被发现,标注后则为 99.9%)。三次误报都是同一个已知错误:将延迟阀门导致的冷却剂温度滞后报告成单独的偏差;两个测试组中都有一次运行(种子 1010)出现该问题,只有开启标签的测试组还在另一次运行(种子 1001)中出现该问题。对于 14 次运行而言,这不足以构成可测量的差异。带标签的报告包含更少的数字(240 个,而非 312 个)。
在纳入这些数字之前,测试发现了我们这边的两个错误。模型输出了 E3.result.issues[0].count 这样的标签,因为它收到的工具结果会包装在 result 中;烟雾测试中 11 个标签有 6 个被拒绝。现在已接受这类路径,而且错误标签的消息会指出该数值实际匹配的字段。另一个问题是,1126.95 Hz 的振荡被报告为“1.127 kHz”时触发了标记,因为 kHz 尚未被列为已知单位;现在已将其加入。
真实测试中的 LLM Agent
在每项真实测试上各运行一次带标签的 gpt-5.6-sol。与团队报告和规则 Agent 相比:
- UVic 2024-12-12:记录结束时,燃烧室压力仍在上升,因此无法评估性能和稳定性;截止时出现多通道同步瞬态;一个热电偶失效。与团队报告一致。
- UVic 2025-01-18:燃烧室压力偏移、燃烧室热电偶失效、压力通道重复,以及 F/Pc 在主级阶段保持稳定、之后出现偏离。
- UVic 2025-02-08:指出 F/Pc 一致性检查未通过,但称其为“受传感器干扰”(燃烧室压力存在较大偏移),而没有指出喉部问题。规则 Agent 将喉部变化列为一种可能原因;两者都无法判断具体故障原因。
- UVic 2025-09-20:燃烧室压力饱和、三个热电偶失效,以及关机附近导致峰值不可信的瞬态。
- Triton:共享 DAQ 丢帧、调压器传感器饱和、关机后燃烧室压力未恢复、孤立尖峰,以及作为警告的 127 Hz 事件。
- HANARO:一次正常点火,推力通道存在非点火期间的间隙。
所有发现均已验证。为得到这些结果,我们进行了两项修正:
- 我们自己的测试中有一处泄漏。 最初的 UVic 运行使用了描述中引用各团队报告内容的元数据(“喷管喉部嵌件破裂……”),而
describe_data会将描述传递给模型;模型在 2025-02-08 的报告中因此称“与报告所述的喷管/喉部硬件故障一致”。现在,报告内容已从元数据中移除(仍保留在prepare.py和此处),上述结果来自重新运行后的干净结果。规则 Agent 从不读取描述,因此其结果未受影响。 - 两条提示词规则:第一次 Triton 运行漏报了关机后未恢复的燃烧室压力(尽管它读取的传感器健康结果中已报告此问题),并将 0.58% 的振荡评为严重:所有传感器健康问题都必须出现在报告中;只有振荡达到判定标准的两倍时,才算严重。在 14 次合成运行中,新提示词保持了 100% 的召回率和 95% 的精确率(1 个误报,即已知的冷却剂滞后错误),97% 的数字带有标签,且没有错误标签。
此前,有两次运行需要修正一项相同的验证器误报:“其最大值为 5180.25 psi”被标记到了 stuck_value 字段。现在,带标签的数值也会与同一对象中数值完全相同的同级字段匹配;卡在最大值的问题则会带有 channel_max 字段。
真实场景测试集:真实日志中的故障与干扰因素
groundline eval --suite realistic 增加了在 Triton 和 UVic 日志中发现的七种故障,每种都有真实值(所有通道上的 DAQ 丢帧、传感器饱和、关机后燃烧室压力卡在高位、低于真空值的零偏移、重复通道、失效通道、60 Hz 市电嗡声),以及不得报告的干扰因素(低于红线的启动超调、关机时的水锤、ADC 量化)。经典测试集逐种子保持不变。规则 Agent 共运行 100 次(--n 100 --seed 2000):13 种类型的召回率、精确率和类别准确率均为 100%,15 次正常运行中误报数为 0,257/257 项发现均通过验证(详情)。
构建测试集时发现了三个现已修复的问题:市电嗡声曾被报告为燃烧不稳定(现在会将点火前就已存在的谱线报告为拾取噪声);如果记录在关机后不久结束,关机后燃烧室压力卡住的问题曾未被发现;重复通道也曾导致性能偏差误报。不过,与第一个表格一样,这些故障是在修复后才编写的,因此该测试集更适合作为回归测试,而非衡量指标。
混合基准测试:真实日志中的已知异常
groundline hybrid-bench 保留真实背景,只让异常合成:它会在一次真实点火记录中注入一个大小和时间已知的异常,运行规则 Agent,再将结果与同一配置在未经修改的日志上的结果进行比较,这样日志本身的问题既不会被计为检出,也不会算作误报(如果注入落在其中一个问题上,就会被“遮蔽”)。背景:Triton 热试车,以及 UVic MULE-1 2025-01-18(HANARO 无法使用:其燃烧室压力以 10 Hz 记录,且推力通道在整个记录中都有数据缺失)。每种大小、每种背景注入 5 次,共 270 个案例(详情):
| 注入项 | 按大小统计的检出情况 | |
|---|---|---|
| Pc 上的振荡(零到峰值,占稳态 Pc 的百分比;判据 0.5%) | Triton:0.25% 0/5,0.5% 1/4,1% 5/5,2% 5/5,4% 5/5 · UVic:0.25–1% 0/15,2% 2/5,4% 4/5 | |
| Pc 高于红线(超限时间;持续时间 10 ms) | 5 ms 0/10,10 ms 0/10,20 ms 10/10,50 ms 10/10,200 ms 10/10 | |
| Pc 低于预测值(占稳态 Pc 的百分比;容差 2%) | Triton:1% 0/5,2% 0/5,3–8% 15/15 · UVic:被遮蔽(其 Pc 存在已知零偏移) | |
| 推力上的单样本尖峰(局部噪声标准差;判据 12) | 6σ 0/10,12σ 3/10,24σ 9/10,48σ 8/10 | |
| 推力通道中的间隙 | 10 ms 至 1 s:40/40 | |
| 推力通道冻结(最短 50 ms) | 20 ms 4/10,50 ms 至 1 s:30/30 |
在 270 个案例中,没有任何注入产生新的误报。 红线、偏差、间隙和冻结检查在真实噪声下的表现符合预期。振荡检测取决于发动机:对于 Triton 液体发动机,从约 0.5% 的判据起即可工作;对于燃烧较粗糙的 UVic 混合发动机,宽带燃烧噪声会掩盖低于几个百分点的谱线。为此增加的第二轮 0.5 s 窗口搜索,将 UVic 在 2–4% 时的检出率从 2/10 提高到 6/10。24σ 和 48σ 时漏检的尖峰,位于 Triton 启动压力事件中或 DAQ 数据缺失处;在这些位置,尖峰检测会有意降低灵敏度。4 个 20 ms 的“检出”是尖峰检查在阶跃恢复时触发,而不是平线检查触发。
groundline hybrid-bench --agent openai(或 anthropic)会使用 LLM Agent 对相同案例运行测试。LLM 每次的回答可能不同,因此每个案例都会与其背景下所有干净运行结果一起比较(每种注入类型一个);如果干净运行中已经存在相同类别、相同检查且时间相符的发现,即使是在另一通道上,也不计为误报。只有当发现的时间窗口超出干净运行中的发现时,才计为新发现:LLM 可能会将注入的振荡与附近的真实事件合并成一个更宽的发现。每个案例都会保存 Agent 的发现,因此无需重新运行 Agent 即可重新评分;--resume 只会重新运行失败的案例。
模型排行榜
groundline leaderboard 会在相同的合成运行数据上测试多个 Agent / 模型,并汇总到一张表中(leaderboard/LEADERBOARD.md)。模型在 JSON 文件中列出;examples/leaderboard.json 包含规则 Agent、gpt-5.6-sol,以及通过 Ollama 在本地运行的 Qwen2.5 7B / 3B(14B 需要更多内存)。已有的 groundline eval 结果可以使用 "from" 导入,无需重新运行。每次运行后都会保存结果,因此排行榜运行中断后会从停止处继续。
groundline leaderboard examples/leaderboard.json            # all models
groundline leaderboard examples/leaderboard.json --only "qwen2.5-7b (本地)"
关键列是初稿中无来源的数字:验证器在首次提交时拦截的数字,因为引用证据中没有这些数字;也就是说,这些数字原本会在没有验证器的情况下进入报告。召回率按所有运行计算:模型崩溃或未提交任何内容的运行中出现的异常,也计为漏检。
2026-09-29 的结果(--n 14 --seed 1000;本地模型通过 Ollama 在配备 16 GB 内存的 MacBook Pro 上运行,使用 16k 上下文;原始结果见 docs/results/leaderboard/):
| 模型 | 已提交报告 | 召回率(严格 / 宽松) | 精确率 | 正常运行中的误报 | 首稿中无来源的数字 | 验证后仍有错误 | 秒/次运行 |
|---|---|---|---|---|---|---|---|
| 规则 Agent | 14/14 | 100% / 100% | 100% | 0 | – | 0 | 1.3 |
| gpt-5.6-sol | 14/14 | 100% / 100% | 95% | 0 | 0 / 376 (0%) | 0 | 22 |
| Qwen2.5 7B | 11/14 | 5% / 50% | 5% | 0 | 25 / 98 (26%),另有 2 个含义错误 | 26 个数字,19 项发现 | 478 |
| Qwen2.5 3B | 13/14 | 0% / 0% | – | 0 | 1 / 1 | 1 个数字,4 项发现 | 28 |
严格召回率要求发现项的通道字段和时间窗口都匹配;宽松召回率也会统计通道缺失但类别正确且时间不冲突的发现项(模型找到了问题,但没有填写结构化字段)。
Qwen2.5 7B 运行了三次,结果差异很大(提交报告数分别为 11 / 7 / 11;按当时的评分结果,首稿中无来源的数字分别占 15% / 12% / 23%)。表格展示的是最后一次运行的结果,并使用当前验证器重新评分(26%);这是首次保存证据台账、因此能够使用新验证器重新验证的运行。
在我们审查的第二次运行中,我们逐一检查了验证器在 7B 首稿中拦下的 10 个数字,并使用相同的种子重新计算证据:
- 4 个是编造的数值:流量积分为 49.9994 kg,却写成“约 60”;最大偏差约为 10.3%,却写成 2.29%;两个时长没有来源(“0.86 s”“持续 2 s”)。
- 6 个是真实数值,但引用了错误的证据:其中 2 个(主级启动和结束时间)被用来支撑“冷却剂在整个主级期间都超过红线”这一错误说法,而实际上只在 3.95 到 5.91 s 之间超出红线。
- 没有误报:每个被拦下的数字都是真实问题。3B 的运行有一次误报:测试 ID “SYN-1013”被当作数字读取;现已修复。
在最后一次运行中,语义验证又拦下了 4 个有来源但含义错误的数字;仅检查依据的验证器会放过它们。这 4 个都是实际问题:
- “持续约 0.2 s”:0.2 是流量积分的值,不是时长。这正是“编造的数字碰巧与另一个无关数字相同”这一漏洞。
- “平均偏差 0.069%”:证据中的 0.069 是以 MPa 为单位的绝对偏差,不是百分比。
- 两个以“kg·s”为单位给出的流量积分:流量积分的单位是质量 kg。
语义验证首次用于真实输出时,又标记了 4 个数字;审查发现这是验证器自身的错误:它读取“MPa·s”和“kg/s·s”等复合单位时,只读到了第一个单位。现在会完整读取复合单位并进行约分(kg/s·s = kg)。修复后,gpt-5.6-sol 写出的 60 个数字和规则 Agent 写出的 1,884 个数字仍然没有误报。
这些结果也体现了验证器的局限:
- **修正轮次无法挽救小模型。**在最后一次运行中,7B 使用了 9 轮修正,验证后仍有 26 个问题数字。验证器的职责是标记问题(报告中的红色波浪线),而不是让模型答对。
- **无法捕捉对数据的误读。**7B 把稳定的氧化剂流量描述为“尖锐脉冲”;它引用的每个数字都真实且与对应字段匹配,因此验证器无法识别。语义验证启用之前,一个编造的“总计 11 s”也通过了验证,因为它碰巧与证据中的某个数字相差不到 1%;语义验证正是为堵住这个漏洞而设计的。
- **小模型大多是无法完成任务,而不只是编造数字。**每次 7B 运行都有多项测试无法在步数或时间限制内提交报告;3B 大多提交空报告,而什么也不说的模型自然不会编造内容。由于不同运行间差异很大且样本较少,请将这些数字视为粗略参考。 请谨慎看待这些数字。 规则 Agent 与这个合成数据生成器是一起调优的,因此满分只能说明整个流程自洽,并不代表它能处理真实数据。这个基准测试主要用于:
- 比较大模型 Agent,以及它们编造数字的频率;
- 工具变更时发现回归问题;
- 测试更复杂的场景:相互关联的异常、逼真的噪声频谱、传感器漂移,以及与真实测试数据的对比。
真实数据示例:HANARO 固体发动机静态点火
examples/hanaro_knsb/ 保存了 SNU Rocket Team HANARO 的公开 KNSB 固体发动机静态点火数据(2025 年;数据来自 snu-hanaro/static-fire-toolkit,采用 MIT License)。原始文件未经修改,保存在 raw/ 中,prepare.py 会将其转换为 Groundline 输入:
- 推力来自以不规则时间采样且存在重复时间戳的负载传感器。重复数据取平均值,信号插值到 100 Hz 网格上;距离任何原始采样点超过 25 ms 的网格点保留为 NaN,以便清楚显示丢帧。
- 公开文件不包含负载传感器的校准常数,因此根据 HANARO 自行处理的推力数据拟合直线,将电压转换为牛顿(R² = 0.9999)。
- 压力来自独立记录仪,采样频率约为 10 Hz,其时钟与推力 DAQ 不同步。时钟偏移量取压力与推力相关性最大的位移(+5.652 s,相关系数 0.9995)。
- HANARO 未公布壳体压力或推力限值,因此没有红线,也没有仿真预测。
python examples/hanaro_knsb/prepare.py        # regenerate run.csv / meta.json / limits.json
groundline analyze examples/hanaro_knsb/run.csv
规则 Agent 与 HANARO 自行处理结果的对比:
| Groundline | HANARO 处理结果 | |
|---|---|---|
| 峰值推力 | 2222.2 N | 2221.7 N |
| 总冲量 | 6362 N·s(峰值的 10% 处的作用时间为 3.91 s) 6391 N·s(峰值的 2% 处的作用时间为 4.12 s) | 6411 N·s(在其 4.35 s 时间窗口内) |
由于推力校准是根据 HANARO 的曲线拟合的,因此峰值匹配是预期结果;独立的检查项是时钟对齐、作用时间和冲量。
此外,还发现了两个测量问题,且都发生在点火之外:推力通道有 285 个数据间隙,中位间隔为 0.67 s,规律性足以表明 DAQ 周期性丢帧;点火前约 121 s 处还出现一个孤立的推力尖峰。
LLM Agent(gpt-5.6-sol)在这组数据上给出了 3 条发现,与规则 Agent 的结果一致(时序、推力性能、推力通道的间隙和尖峰)。所有 25 个数字都有依据,初稿没有编造任何数字。它还主动指出,Pc 的记录频率只有 10 Hz,无法显示振荡,因此改为检查推力通道在 5–50 Hz 频段内的情况(未发现振荡)。共发出 4 次请求,输入约 13k 个 token。
这些数据暴露出若干仅基于合成液体发动机数据建立的假设;这些问题现已修复:
- 慢速通道插值到快速网格后,振荡检测会搜索超过其奈奎斯特频率的频段,尖峰检测则会把每个真实采样点都当作尖峰。现在,工具会从
meta.json读取native_rate_hz,并按照通道自身的采样率进行判断。 - 量化且平稳的信号(例如点火前稳定的环境压力)的残差中位数为 0,因此其噪声底为 0,单步波动便会被算作尖峰。
- 点火前后都没有变化的传感器不算“冻结”;现在只会报告与点火过程重叠的平直线段。
- 数百个重复出现的丢帧现在会合并为一条发现,而不是数百条。
- 点火时推力快速上升的信号会泄漏到振荡频段的最低频段,并被报告为“5 Hz 振荡”;现在不再标记峰值位于该频段的窗口。
- 新增
pulse_metrics工具,用于计算峰值推力、作用时间和总冲量。
修复后,规则 Agent 在合成基准测试上的召回率和精确率仍为 100%,且误报数为 0。
真实数据示例:Triton 液体发动机热试车
examples/triton_lox/ 将 Triton 一台压力供给式 LOX / 燃料液体发动机的公开热试车数据(2025 年 4 月 11 日,数据来自 aidenmccollum/Triton-Hotfire-Analysis)转换为 Groundline 输入。该仓库没有许可证,因此 Groundline 不会复制这些数据:prepare.py 会下载数据(固定到某个提交),并在本地写入 run.csv,这两个文件都已加入 Git 忽略列表。这是一份约为 1.94 kHz、包含 25 个通道的 DAQ 日志:三个推力负载传感器、燃烧室、歧管、储箱和调压器压力、储箱重量以及热电偶。数据中没有红线、阀门指令或仿真预测。
python examples/triton_lox/prepare.py        # downloads the log, keeps 120-180 s, 2 kHz grid, dropouts left as NaN
groundline analyze examples/triton_lox/run.csv
分段结果与团队自己的分析窗口(日志中的 148.35–153.35 s)一致:点火时间为 148.41 s,主工作阶段为 148.43–153.16 s,推力作用时间为 148.41–153.54 s。峰值推力为 1144 lbf,作用时间内平均推力为 846 lbf,总冲量为 4344 lbf·s(将三个负载传感器的读数相加并去除基线);该次试车没有已发布的参考值可供对照。
它还发现了数据中的测量问题:
- 停机后,燃烧室压力没有回到基线:日志结束时读数约为 223 psi,而测试前为 13.8 psi(稳定值的 63%);此时推力和两个歧管压力都已恢复至环境值;
- 燃料调压器的上游压力整整一分钟都停在最大值 5180.25 psi:最可能是已达到满量程而饱和;
- 所有 24 个通道都在相同时间点丢失数据,共有 192 个间隔,最长达 42 ms:这是 DAQ 帧丢失;
- 点火时,五种传感器在 20 ms 内出现尖峰;半秒后,燃烧室压力又出现一个持续约 30 ms、达到 467 psi(+20%)的尖峰。Groundline 会将这些同时出现的尖峰报告为一个事件,但不会判断它们是物理现象还是干扰。
这是 Groundline 首次处理液体发动机数据,首次规则 Agent 运行产生了 131 条发现,其中 87 条都指向同一个卡滞传感器。它揭示的问题及相应改动如下:
- 每次短暂丢失数据都会把卡滞值分段,因此每段平线都被计为新的卡滞 → 平线中的短暂间隙不再将其分段;若值卡在通道的最大值或最小值,则标记为可能饱和;
- 所有通道共同出现的间隙按每个通道分别报告 → 作为 DAQ 数据丢失统一报告一次;
- 停机后卡在高位的燃烧室压力传感器未被发现,导致“停机”时间延伸至日志结束(而且由于卡滞值高于峰值的一半,它还会被纳入稳定值的平均计算)→ 增加未回归基线检查;尾段结束时间取曲线趋于稳定的位置;稳定值取自峰值周围的平台段;
- 起始瞬态仅凭单个 50 ms 窗口,就产生了“严重”的 59 Hz 和 134 Hz“振荡” → 振荡必须持续至少 3 个窗口;更短的峰值列为短时事件;
- 多种传感器同时出现的尖峰被称为“测量故障,并非物理事件” → 作为一个无法由单个传感器解释的事件进行报告。
改动后共有 18 条发现,均已验证(105 个数字),合成基准测试和 HANARO 结果均未改变(采用新的稳定值估算方式,以及后来加入的相对于基线的阈值后,HANARO 的点火和主工作阶段边界最多移动了 150 ms)。燃烧期间,Pc、LOX 歧管和推力中都出现了约 126 Hz 的成分;它是真实的,但幅度很小(平均约为 Pc 的 0.1%)。Groundline 将其超过默认 0.5% 标准的那段 0.15 s 时间标记为警告。
真实数据示例:UVic MULE-1 混合火箭发动机,与团队自己的报告核对
examples/uvic_mule/ 将 UVic Rocketry 的 N2O / 石蜡混合火箭发动机 MULE-1 的四次热试车(UVicRocketry/Propulsion-Test-Data)转化为 Groundline 运行记录。它是混合火箭发动机,而非液体火箭发动机,但采用类似液体发动机的氧化剂供给系统(运行罐、输送管路、阀门、喷注器),并以约 450 Hz 记录数据。它的价值在于,团队记录了每次测试中发生的情况。该仓库没有许可证,因此和 Triton 一样,prepare.py 会下载日志,但不会提交任何内容。
python examples/uvic_mule/prepare.py          # all four hot fires
groundline analyze examples/uvic_mule/2025-01-18/run.csv
| 测试 | 团队报告 | Groundline(规则 Agent) |
|---|---|---|
| 2024-12-12 | 点火器线路短路,两个阀门都断电;发动机点火后 DAQ 立即中断 | “记录在点火过程中停止”:Pc 在 317.48 s 开始上升,日志在 317.53 s 结束,因此不报告性能。T_post_comb 没有信号 |
| 2025-01-18 | “首次完全正常的热试车”;推力低约 25%,原因不明;未安装 / 已损坏燃烧室热电偶 | 两个燃烧室热电偶均无信号(−273.1 °C:传感器断路)。Pc 读数低于真空压力(中位数 −25.4 psi):零点偏移。P_n2_line 和 P_run_tank 的每个采样值都完全相同,报告未提及此事:线路或配置错误。主燃烧阶段内 F/Pc 稳定(偏差 9%),但在关机阶段偏差达 62%;此时 Pc 读数为 24–171 psi,推力仍约为 330 N |
| 2025-02-08 | 喷管喉部嵌件断裂(宽约 7 mm),内衬碎裂,燃烧不稳定,推力低 | 燃烧期间 F/Pc 变化 79%(1.54 → 2.76 N/psi):这是喉部扩大或传感器故障的特征。Pc 偏移;启动期间多个通道同时出现尖峰 |
| 2025-09-20 | 无报告 | 点火期间 Pc 饱和在 2021 psi,因此分段改用推力数据(1.16–5.67 s;作用时间 4.51 s,1268 N·s)。关机时出现持续 10 ms、大小为 2343 N 的推力尖峰,被识别为尖峰而非峰值。三个热电偶无信号 |
它无法判断:推力是否低于预期 25%(没有公开预测值)、02-08 除了“喉部变化或传感器故障”之外究竟发生了什么,或 01-18 关机阶段的不匹配究竟源自压力取压口还是燃烧。
和 Triton 一样,首次运行也暴露出一些值得吸取教训的问题:把噪声尖峰和点火时截断的日志识别为阶段;把只是拔掉的传感器误判为“饱和”;在 Pc 饱和时仍按 Pc 分段;把关机时 10 ms 的冲击误当作峰值推力;以及在子窗口振荡搜索时发生崩溃。后续改动及其通用性如下:
- 分段:阈值相对于测试前基线计算(因此不受偏移影响);从主燃烧阶段向前搜索以确定点火时刻;Pc 没有明显脉冲时改用推力;日志在点火过程中结束时添加标记;
- 传感器健康状态:整个记录只有一个读数值表示“无信号”,而非饱和;检测物理上不可能的读数(压力低于真空压力、温度低于绝对零度,持续至少 0.5 s);检测采样值完全相同的通道;
- 新增工具
check_thrust_pressure_ratio:推力与燃烧室压力的比值正比于推力系数乘以喉部面积,因此发动机燃烧期间该比值应保持稳定;该工具仅使用准稳态窗口,并判断变化是否发生在主燃烧阶段内; - 脉冲指标:基于 0.1 s 中位数定位脉冲,因此短暂冲击不会被误判为峰值。
回归测试:合成基准测试结果不变(召回率和精确率均为 100%,134/134 已验证);HANARO 的推力结果不变(2222.2 N,6362 / 6391 N·s;采用相对于基线的阈值后,点火和主燃烧阶段边界最多移动 150 ms);Triton 结果不变;由于工具结果现在包含更多字段,验证器基准测试的结果最多变化 1 个百分点。
语义验证
仅检查“数字是否出现在引用的证据中”有两个漏洞,而且上面的 7B 结果都出现了:把真实数字放在错误的位置(每个引用的数字都是真的,但含义不对),以及编造一个数字,恰好在四舍五入后与证据中无关的数字匹配。
因此,验证器现在会记住每个证据数字来自哪个字段(peak、duration_s、freq_hz……)及其单位,并结合以下信息读取句子中的每个数字:
- 数字的单位:带 s / ms 的数字只能匹配时间字段;Hz 只能匹配频率字段;% 只能匹配百分比字段;bar、K 或 N·s 等物理单位必须与工具报告的单位匹配。复合单位会整体读取并约去(kg/s·s = kg)。书写的单位也决定了量级:字段值为 0.8 s 时,可以写成 800 ms,不能写成 0.8 ms。“3 spikes”“3 个”这样的计数词必须来自计数字段或列表长度。
- 数字的角色词:由“峰值/持续时间/均值/冲量/频率/偏差/延迟”(或对应的中文词语)直接引出的数字,必须来自字段名符合该角色的字段。只有角色词紧接在数字前面时才会触发检查:“持续高于 700 K 红线”中的词语描述的是超限情况,而“峰值的 10%”表示峰值的一部分;两者都不会触发检查。范围端点(1.27–9.02 s)也不检查角色;相反,范围起点采用终点之后写出的单位(因此,1.27 也必须是时间),而且时间范围的终点不得早于起点。
- 数字的类别:归入异常类别(红线违规、振荡、传感器故障、阀门响应、性能偏差)的发现,必须引用工具确实报告了相应异常且通道相符的证据。通过的检查必须归为观察。这正是上文首次 LLM 运行准确率只有 36% 的原因;重新验证已存储的运行结果后发现,这仍是 7B 模型最常犯的错误:“阀门响应正常”和“没有明显振荡”被归为异常,普通峰值被归为性能偏差。现在有 5 条该模型的声明被标记;gpt-5.6-sol 的声明和 rule-agent 的声明均未被标记。
这仍然是确定性的字符串和字段匹配;不会要求第二个 LLM 来判断。
来源标签。 猜测数字来自哪个字段是有上限的:仅凭文本无法区分两个都表示“时间”的数字。因此,数字可以在其后紧接方括号,标出字段名(及其单位):742.3 K [E4.violations[0].peak_value]、3 spikes [len(E3.issues[0].spikes)]、3.86 [E6.events[0].t_start]–6.01 s [E6.events[0].t_end]。带标签的数字只会根据该字段进行检查(数值、单位、角色词、范围顺序);若标签指向错误字段,或对应证据未被该发现引用,则会被标记。单独的 [E4] 仍是普通引用。在 HTML 报告中,这些标签会变成指向相应证据条目的链接。LLM Agent 会被要求为每个数字添加标签(设置 GROUNDLINE_CITE_NUMBERS=0 可关闭);MCP 客户端也可以这样做。未加标签的数字仍按原有方式检查。
单位换算现在也与字段类型挂钩:s ↔ ms 仅适用于时间,分数 ↔ % 仅适用于无单位的分数。802 Hz 的频率不再会与书写为 8(×0.01)的数字“匹配”,0.5 % 的阈值也不再会与“50 %”匹配。
验证器自身的基准测试(groundline verifier-bench):从正确的 rule-agent 发现开始,每次修改一个数字,植入三种已知错误之一,并统计验证器能捕获多少:仅检查数值是否出现在引用的证据中、对未加标签文本执行完整检查,以及为每个数字添加来源标签时执行完整检查。共 100 次合成运行,中文和英文各 50 次:
| 预设错误 | 数量 | 仅依据证据 | 依据证据 + 语义 | 使用来源标签 |
|---|---|---|---|---|
| 虚构数值(变化 −30% 至 +50%) | 1372 | 89% | 98% | 100% |
| 数值真实但位置错误(来自同一证据的其他字段) | 1444 | 0% | 67% | 99.9% |
| 单位错误(s ↔ Hz、% → s,……) | 1174 | 0% | 98% | 100% |
| 未改变的正确发现(误报) | 268 | 0% | 0% | 0% |
不使用标签时,错位数值的 67% 检出率分为两种情况:替换为不同类型的字段(用峰值压力替换持续时间)时,92% 的情况可以检出;替换为同类型字段(用另一个时间替换一个时间)时,检出率为 34%,前提是句子中有表示角色的词、替换会破坏时间范围,或 s/ms 的量级不再合理。(在加入范围、量级、计数和换算规则之前,这两种情况的总体检出率分别为 45%、69% 和 13%。)这就是仅阅读文本的局限;使用来源标签后,预设的 3,990 个错误中,除两个外均被检出(剩下的两个是替换值在舍入范围内与引用字段相等)。LLM Agent 是否能可靠地为数字添加标签,目前尚未经过测量:上述基准测试运行均早于标签指令。
另请注意,角色词规则是针对规则 Agent 的句子模板编写的,因此,在这些相同模板上测得的上述误报率偏于乐观。在独立文本上,对于由 gpt-5.6-sol 撰写的两份报告(9 条发现、60 个数字,包括 HANARO 真实数据报告),新的验证器也没有产生误报;在加入范围、量级、计数和换算规则后,对存储的 gpt-5.6-sol 和 Qwen 基准测试运行重新验证(123 条 gpt-5.6-sol 声明、798 个数字),也没有改变任何 gpt-5.6-sol 判定。在 7B 草稿中,它又拦截了两个数字,且两者均有错误:持续时间“0.2 s”仅在乘以 0.01 后才与总冲量 19.4 匹配,以及一个以 MPa 为单位的平均偏差经 ×1000 缩放后被写成百分比。要更可靠地估算误报率,还需要来自不同模型的更多真实报告。
LLM 基准测试运行会将每次运行的所有发现连同其证据记录一并存储。验证器改进后,可使用 groundline reverify <results.json> 重新评分,无需重新运行模型;上述最近一次 7B 运行(docs/results/leaderboard/)便是通过这种方式重新评分的。
设计说明
- LLM 不做算术运算。 系统提示词要求发现中的每个数字都必须来自证据。要写出“偏差为 5%”,模型必须调用
compare_reference并获取该数值,而不能自行计算两个数字的差。 - 规则 Agent 也必须通过验证器。 开发期间,验证器发现规则模板中硬编码了“5 个样本”,但任何证据中都没有这一数字。修复方法是将该判定标准放入工具输出,而不是放宽验证器。
- 归因原因的发现。 如果流量与预测相符,但燃烧室压力偏低,报告会指出 c* 效率偏低;如果燃料阀延迟导致点火延迟,产生的温度滞后会归因于阀门延迟,而不是作为单独问题报告。
目录结构
src/groundline/
  synth.py           synthetic hot-fire data with ground-truth anomalies
  io.py              CSV / TDMS I/O
  session.py         Session and the evidence ledger
  tools.py           deterministic analysis tools (the only source of numbers)
  findings.py        findings and the grounding verifier
  semantics.py       semantic verification: units and role words against evidence fields
  agent.py           rule agent, LLM agent (OpenAI Responses / compatible endpoints / Anthropic)
  report.py          self-contained HTML report and report.json
  reproduce.py       evidence reproduction
  evaluate.py        benchmark and re-verification
  leaderboard.py     multi-model leaderboard
  verifier_bench.py  benchmark of the verifier itself (planted errors)
  hybrid.py          hybrid benchmark: known anomalies injected into real logs
  ingest.py          raw CSV logs to runs, from a (drafted) mapping
  mcp_server.py      MCP server
  config.py          .env loading
  cli.py             command line
路线图
- 使用更多真实液体发动机测试数据验证判定标准并校准阈值,最好包含修订标记、阀门指令和仿真预测(已包含一个公开的固体发动机示例和一个公开的液体发动机示例)
- 偏差归因:当仿真与测量结果不一致时,列出可能的原因(物理、网格、边界条件、制造、传感器)并设计检查项
- 跨运行比较和趋势分析
- LLM Agent 排行榜和验证器基准测试
- 更复杂的合成场景(耦合异常、真实噪声频谱、传感器漂移)
- 测试报告模板(导出为 Word/PDF)
许可证
MIT
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。