关于 Homestead Memory
Homestead Memory 是一款本地优先的 Python 工具,可记录 Agent 操作并管理纯 Markdown 记忆。记录通过哈希链揭示篡改,记忆完整性则由机械规则检查,而非 LLM 判断。
主要功能
- 01以哈希链记录工具决策和执行结果
- 02检测记录修改、删除、重排及写入丢失
- 03签名检查点与可独立验证的证据包
- 04检查 Markdown 记忆的完整性与投毒
- 05搜索、提问、导入和提炼记忆
适用场景
- 01查看 Agent 工具调用的可验证历史
- 02共享证据包供第三方验证
- 03检查 Markdown 记忆中的退化或无依据主张
- 04导入 Codex 会话记录
MCP 相关
README 提到该 MCP 集成可用于支持 MCP 的环境,但未说明其公开的 MCP 工具或资源。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
9收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| k | integer | 否 | 段落数量 |
| type | enum | 否 | 问题类型(默认:自动分类)temporal-reasoning | knowledge-update | multi-session | default |
| query | string | 是 |
详细介绍
homestead-memory



别再租用你的大脑。
一份可防篡改的记录,记录 AI Agent 实际做了什么,保存在本地文件中, 不信任你的人也能验证。 可防篡改,但并非无法篡改: 它能防范什么,不能防范什么。
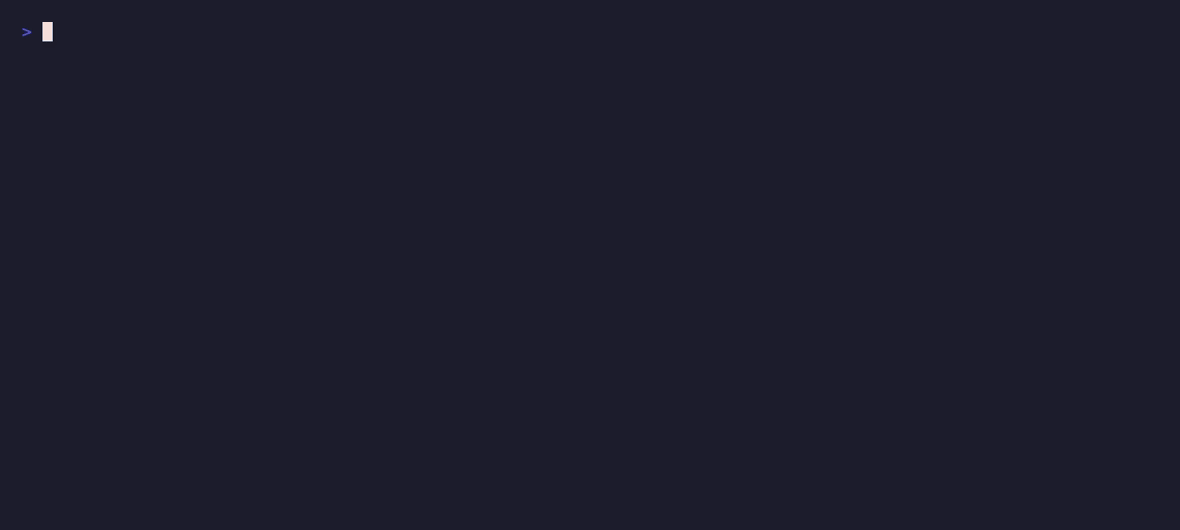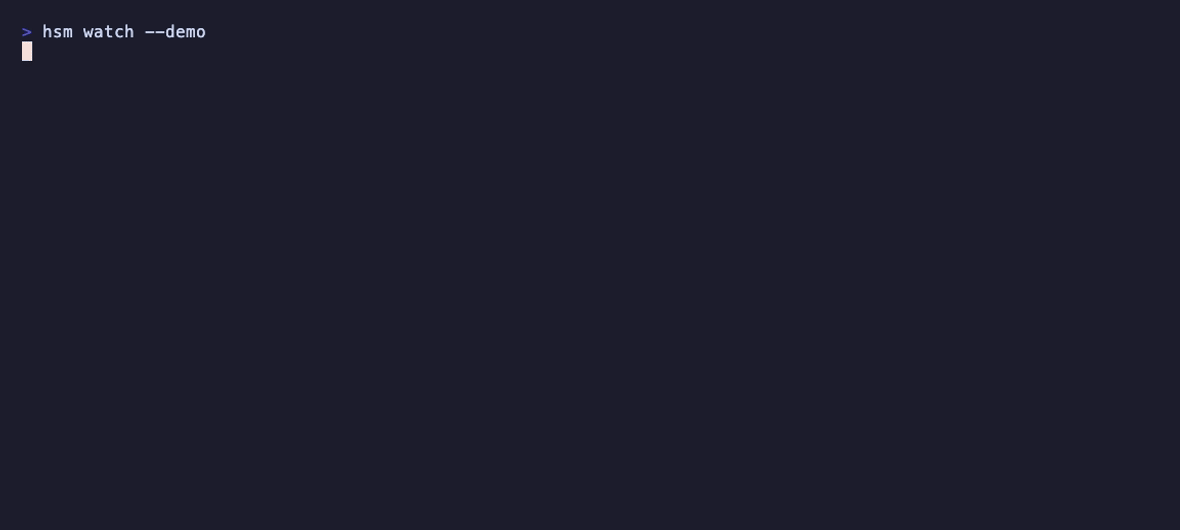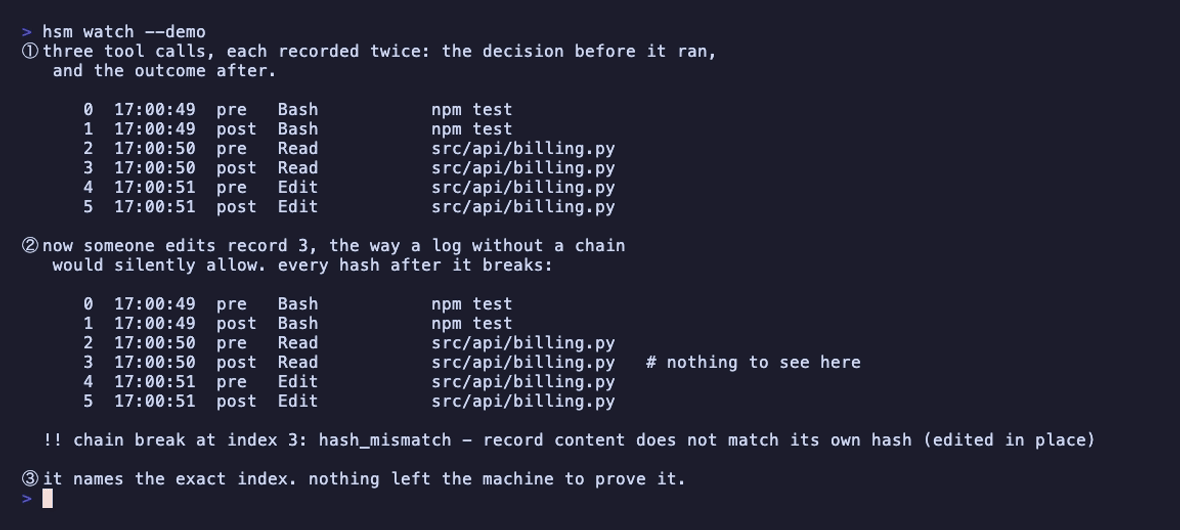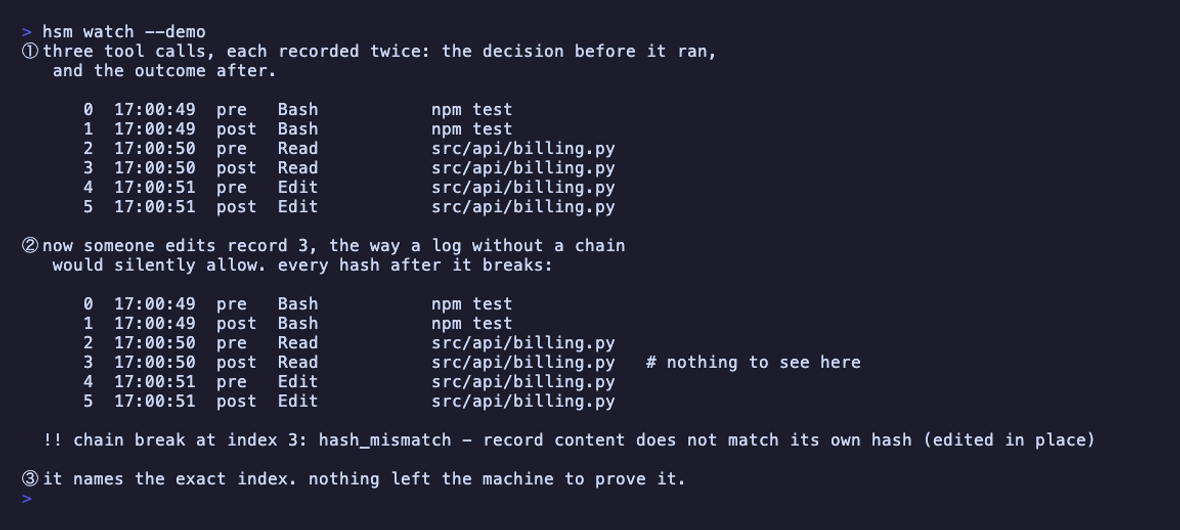
Agent 会悄无声息地失败。运行报告显示成功,工具返回 200,而你 要求的事情却没有发生。通常没有记录可以证明并非如此。这个工具会留下一份记录, 并将每条记录与前一条通过哈希链相连,因此可以亲眼看到它发现伪造记录, 实时演示:
pip install homestead-memory      # Python 3.10+, macOS / Linux / Windows

hsm watch --demo
#      0  14:02:11  Bash    npm test
#      1  14:02:19  Read    src/api/billing.py
#      2  14:02:24  Edit    src/api/billing.py
#
# ② now someone edits record 1…
#   !! chain break at index 1: hash_mismatch
#      record content does not match its own hash (edited in place)
#   exit 1  ·  gate it in CI like a test
遇到
No matching distribution found? macOS 仍将 Python 3.9 作为内置的python3,而此工具需要 Python 3.10 或更高版本。软件包没有问题。你可以使用较新的 Python,也可以完全跳过安装:uvx --from homestead-memory hsm watch --demo(uv 会为你获取合适的 Python。)
记录你自己的 Agent
hsm hook --install     # prints a Claude Code hook; you paste it, nothing is edited for you
hsm watch              # what your agent did, in order
每条记录都会与前一条记录进行哈希链式关联,因此编辑、删除或重新排序任何记录,都会破坏其后的所有哈希。hsm watch 会报告确切的出错索引,并以非零状态退出。对链进行签名后,即使整条链被重新构建,也能检测出来。
**两个阶段都会被记录,这正是它成为证据而非日志的原因。**钩子会在工具运行前捕获决策,并在运行后捕获结果。仅记录结果只能说明发生了什么,无法证明事先有人授权。正如 IETF Agent Audit Trail 草案 所言:“如果拒绝仅在执行后记录,就无法证明该拒绝得到了执行。”
hsm export --format aat # the same ledger as draft-sharif-agent-audit-trail-01
该草案明确对应《欧盟 AI 法案》第 12 条,而此工具会在保留原生格式的同时附带输出该格式,而非取而代之,因此磁盘上已有的内容不会发生变化。对于两者的差异,我们会明确说明:该草案规定使用 ECDSA P-256,AAT 导出使用该算法;原生 EvidencePack 则保留 Ed25519,这样验证器便可仅依赖标准库,接收方也无需安装任何东西。
**依赖 AAT 导出前,请先了解这一点。**该草案是一份个人 Internet-Draft,并非已采纳的标准:它没有工作组支持,且附有常见声明,称其“未经 IETF 认可”。其作者还提交了 IPR 披露 7558,完整涵盖修订版 00 和 01,并声明“向所有实施者提供合理且非歧视性的许可,可能收取版税/费用”。RAND 许可可能收取费用,因此并非免版税;而本软件包采用 MIT 许可证,并未授予你任何专利许可。我们提供此导出功能,是因为互操作性值得拥有;我们也已请作者澄清实施者需要承担什么。在得到答复之前,请将 --format aat 视为便利功能,而不是构建合规计划的依据。本机账本和 EvidencePack 不涉及此类披露,而 README 其余部分所主张的正是它们。
代价:每次工具调用约 124ms(中位数;p95 为 138ms,在 M3 Pro 上使用 4KB 工具响应测得)。从 0.4.0 起,钩子会记录两个阶段,因此每次调用都会作为全新进程运行两次:一次在工具运行前,另一次在运行后,分别约为 61ms 和 63ms。一次包含 100 次调用的会话,总耗时约增加 12 秒,分散在整个运行过程中。其中几乎全部耗时都来自 Python 解释器和导入启动,而不是记录过程本身。如果这对你的循环来说开销太大,就不要安装钩子:我们在这里列出这个数字,是为了让你能在亲自体验之前做出决定。
早期版本文档中写的是 68ms;当时只记录 PostToolUse,这个数字是准确的。记录决策阶段,才能让账本成为执行情况的证据,而不只是观察记录;代价是需要启动第二个进程。我们选择如实说明更高的数字,而不是报一个对我们更有利的数字;这也是列出其余数据的原因。
**这是一个文件,不是一个平台。**Agent 可观测性工具的功能丰富得多,而且需要部署:可自托管的工具要求生产环境至少运行数个服务,并配备约 16GB 内存。本工具只需 pip install、一行钩子配置,以及磁盘上的一个 JSONL 文件。用途不同。如果你需要仪表板、评估和跨度分析,请使用那些工具。如果你想要一份可用 grep 搜索并能验证的记录,就用这个。
类似机密的值会被删减,载荷会截断至前 200 个字符,同时保留完整原文的 SHA-256 哈希,以便证据在删减后仍然有效。这是一种缓解措施,而非保证:任何模式列表都不可能面面俱到。
hsm export --evidence # a pack anyone can verify with no install at all
该包包含记录、签名、公钥、完整性报告,以及第三方可以完整阅读并运行的标准库验证器。它还会说明自身无法证明什么,其中包括:签名只有在你事先知道应当期待哪个密钥时,才能证明来源。
它能防范什么,不能防范什么
防篡改检测,而非防篡改。两者的区别很重要,下面说清楚。
它能检测:
-
原地编辑记录。哈希将不再匹配,
hsm watch会指出索引。 -
删除或重新排序记录。此后每个哈希都会失效。
-
写入被悄悄丢弃。丢弃的写入会被记录并报告,绝不会被吞掉。
-
有人从头重建整条链,并重新计算每个哈希,前提是你运行了
hsm checkpoint、固定了预期签名者,并且对方没有你的密钥。这三点 缺一不可。如果没有固定密钥就验证检查点,那只是自我声明:它会使用旁边的 任意密钥来检查签名,因此,用攻击者自己的密钥重新签名的重建链也能通过。 如果没有固定密钥,hsm verify --deep现在会对此发出说明。hsm verify --deep --signer <your pubkey> # or the checkpoint is self-asserted -
你将 EvidencePack 交给他人后发生的任何篡改;对方无需安装任何东西,也无需 获取我们的任何内容,就能检查它。
**检查点覆盖其前缀,而非未来。**在上一个检查点之后追加的记录,可以被替换成一份
正确重新链接的伪造记录,并且仍能通过验证,因为签名无法覆盖签署时尚不存在的记录。
hsm verify 会告诉你有多少条记录尚未覆盖。请经常创建检查点,否则这段尾部会不断
变长。
它无法检测:
- **持有你签名密钥的攻击者。**密钥存放在与账本相同的机器上的
~/.config/homestead-memory/ed25519_key。任何能重写该文件的人通常也能读取 密钥、重新签署篡改后的内容并通过验证。如果这是你的威胁模型,请运行hsm checkpoint --export,将输出行发布到对方无法控制的地方,之后再通过hsm checkpoint --verify对照它检查账本。头部哈希不会泄露记录内容,因此发布它 不会泄露任何信息。 - **说谎的工具。**见下文。
- 从未进入账本的任何内容,例如你没有安装钩子的情况。
hsm checkpoint            # sign the current head
hsm checkpoint --export   # one line to publish where an attacker cannot reach
hsm checkpoint --verify   # check this ledger against a line you published earlier
hsm watch 会报告检查点覆盖了账本的多少内容,并且在检查点无法通过验证时失败。
自上一个检查点以来追加的所有内容都尚未覆盖,因此请经常创建检查点。
它记录的是你的运行框架报告的内容
钩子接收的是运行框架声称工具执行了什么。它并非独立观测。
如果工具报告成功却什么也没做,这正是本工具要检测的失效情况,因为你会得到一条 持久记录,记下这一说法,并可将其与现实进行比较。但如果工具谎报了它做了什么, 账本就会忠实地记录这条经过哈希链保护并签名的谎言。
记录能证明它没有被篡改,但不能让运行框架变得诚实。
为什么不直接用 OpenTelemetry、签名日志或 Langfuse
这些问题都问得合理,而且它们大多是不同的用途。
- OpenTelemetry 提供丰富得多的追踪能力和本工具所没有的生态系统。它并非为防篡改 检测而构建,而且跨度数据通常会离开机器。你可以同时使用两者:前者回答“详细来说 发生了什么”,本工具回答“我能否证明内容没有被编辑”。
- 对日志文件签名可以满足大部分需求;如果你已经这么做了,可能不需要本工具。 两者的区别在于逐条记录链接,因此单行被篡改时可以定位问题,而不是让整个文件失效; 另外,本工具还能生成一个接收方无需安装任何东西即可运行验证器的包。
- Langfuse、Braintrust、Phoenix 是可观测性平台,提供仪表板、评估和跨度分析, 而本工具永远不会具备这些功能。它们也需要部署。可自托管的方案将由多个服务组成、 大约需要 16 GB RAM 作为生产环境的最低配置。本工具只需一行钩子配置和一个 JSONL 文件。如果你需要仪表板,就用它们。
本工具提供的、它们不具备的那项有限功能是:生成一份第三方无需信任你、无需安装任何 东西,且数据无需离开你的机器即可验证的记录。
它读取的记忆也属于你
同一个工具拥有 Agent 读取和写入的记忆:纯 Markdown 格式,你可以阅读、
git diff,然后继续前行。它通过机械检查而非 LLM 评判器,检测自身的
腐坏、篡改和投毒,并给出 0 到 100 的评分;当检查失败时,它会以非零状态码退出,
因此可以像测试套件一样作为 CI 和 cron 的门禁。
npm install -g @tobilu/[email protected]  # optional hybrid retrieval runtime

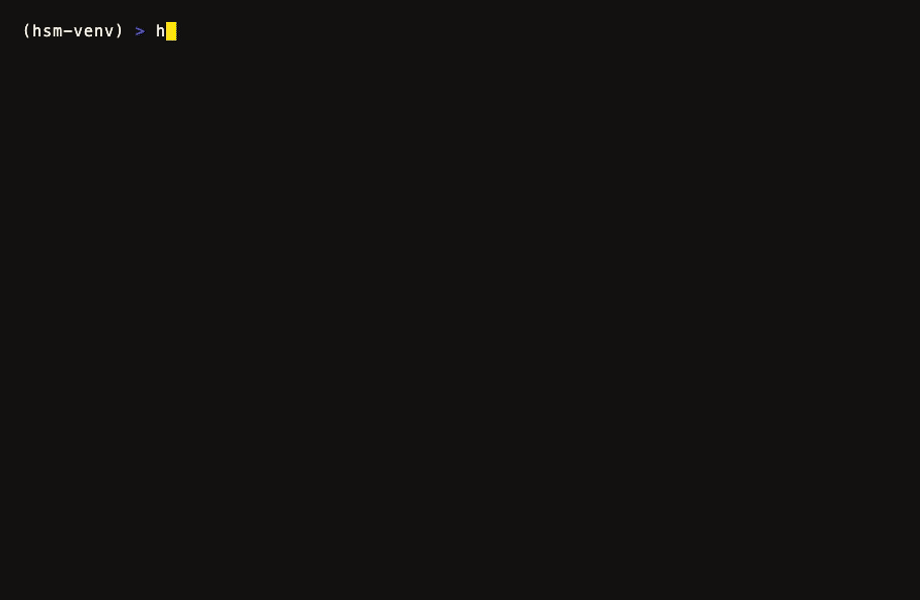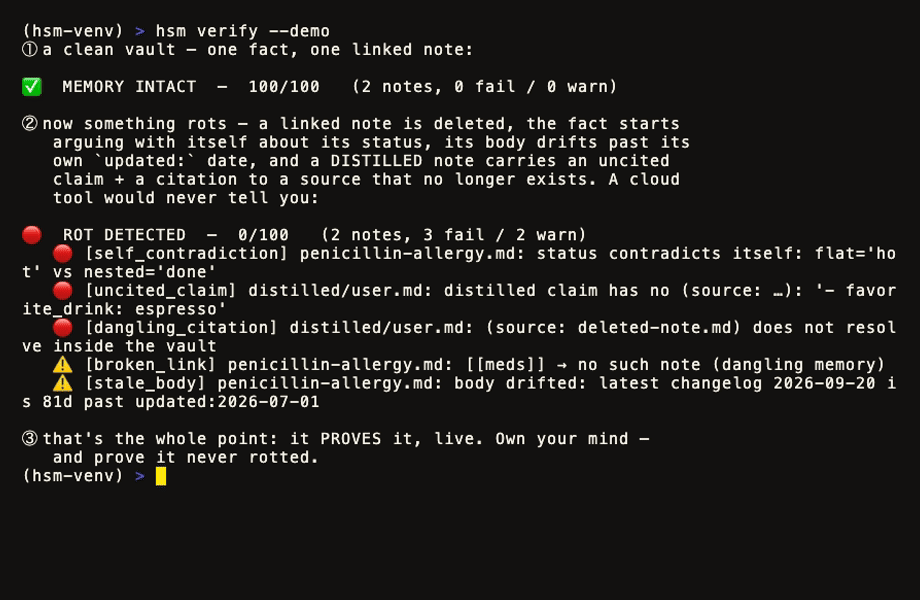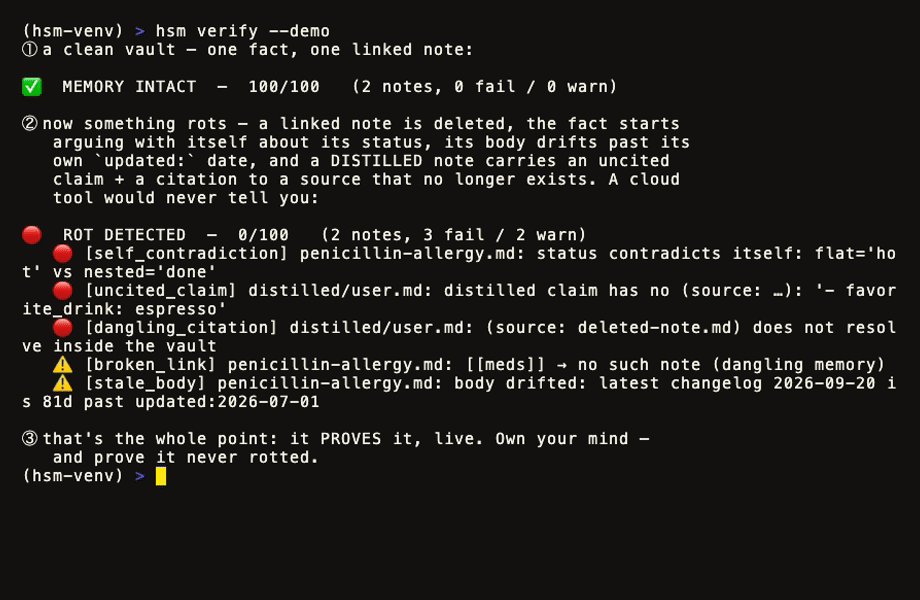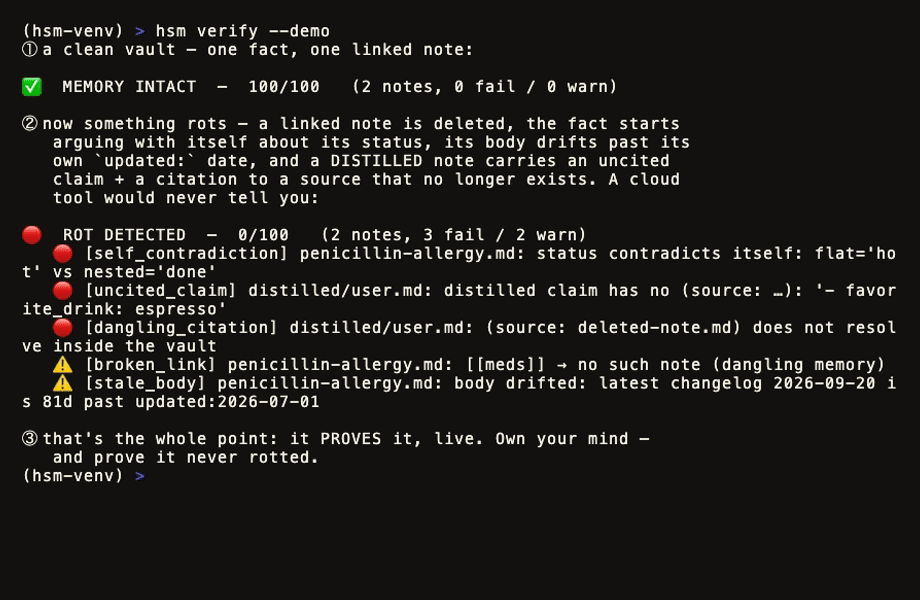
hsm verify --demo
# ① a clean vault           ✅  MEMORY INTACT — 100/100
# ② rot is planted…         🔴  ROT DETECTED —   0/100
#    🔴 [self_contradiction] the note argues with itself about its own status
#    🔴 [uncited_claim]      a distilled claim has no source citation
#    🔴 [dangling_citation]  a cited source no longer exists
#    ⚠️  [broken_link]        a reference points at a note that isn't there
这套评分标准是 RotBench,以开放规范的形式发布,因此 评分结果可复现,而非由系统自行报告。
目前只有 Claude Code 支持捕获。 下方的 MCP 集成可在任何支持 MCP 的环境中使用;
用于记录每次工具调用的钩子使用 Claude Code 的 PreToolUse 和
PostToolUse。Cursor 和 Codex 需要各自的机制,目前尚未实现。
自 0.4.1 起,Codex 通过导入而非钩子获得支持:
hsm import-session --dry-run     # newest Codex session, writes nothing
hsm import-session -n 5          # the five most recent
实测发现,Codex 的工具钩子在 codex exec 下不会触发,但其 rollout 文件会记录每次调用的输入、输出和配对 ID。导入的记录带有
meta.source=codex-rollout,且 hsm watch 会在其旁边打印 (imported),因为事后从文件读取的记录绝不能伪装成当时亲眼见证的记录。
尽管 Codex 的钩子仅支持 shell,覆盖率仍然很高:Codex 没有单独的 Read、Edit
或 Write 工具,它通过调用 shell 命令完成文件操作。对 60 个会话和 848 次
工具调用的测量显示,exec 占 94%。完整的推理过程(包括本项目最初判断错误的两个地方)见 docs/CODEX_CAPTURE.md。
快速入门(60 秒)
hsm init   ./my-vault          # scaffold or adopt any markdown folder
hsm ingest ./my-vault          # index it (hybrid BM25+vector via qmd, optional)
hsm ask    "what did I decide about X?"
hsm ask    "what did I decide about X?" ./my-vault --budget 1200 --json
hsm search "what did I decide?" ./my-vault --retrieval balanced --json
hsm qmd start                  # persistent loopback runtime; no shared global index
hsm verify ./my-vault          # the integrity gate — the whole point
hsm distill ./my-vault         # optional: build the cited, verifiable fact layer
hsm history <note> --as-of 2026-06-01   # what was true THEN (temporal layer)
hsm serve                      # local HTTP API (auth'd, loopback-only)
Python Agent 可以直接使用 SDK:
from homestead_memory import connect

memory = connect("~/my-vault", agent="my-agent")
memory.remember("user", "city", "Berlin")
memory.ask("what city is the user in?")
本地 HTTP API 的文档见 docs/openapi.yaml。
检索配置
Homestead 会将 qmd 存放在专用的缓存和配置目录中。它绝不会对 qmd 的全局索引运行维护操作。每个结构化结果都会报告 engine、
retrieval_mode、degraded、reason、elapsed_ms 和 index_age_seconds。
| 配置 | 行为 | 用途 |
|---|---|---|
fast | 仅 BM25 | 精确名称、路径和低延迟探测 |
balanced | 词法检索 + 向量检索,不使用 LLM 重排器 | 钩子和常规 Agent 上下文 |
quality | 词法检索 + 向量检索 + 重排器 | 明确要求高价值研究的查询 |
路由顺序为持久运行的 qmd MCP、专用 qmd CLI,最后是只读直接扫描。运行
hsm qmd doctor、hsm qmd refresh 和 hsm qmd status,即可检查运行时状态,且不会触碰任何其他 qmd 集合。
刷新是显式且增量式的。它会在
.hsm/refresh-state.json 下写入原子检查点,拒绝外部或不健康的 QMD 运行时,在 QMD 工作期间发出实时心跳,并且只有在嵌入完成、待处理向量数归零后,才提交保险库指纹。读取不会触发隐式刷新;如果 QMD 不可用,检索会回退到只读扫描,并报告降级后的引擎和原因。
Linux/systemd 参考部署见 deploy/reference/。
路由器中的记忆
路由器可以切换提供服务的模型,而 homestead-memory 会继续在底层使用同一个保险库。模型名称只是运行时参数;发生写入时,来源信息会以
name@model 的形式记录在 agent 字段中。
from homestead_memory import connect
from homestead_memory.adapters.openai_compat import MemoryChat

memory = connect("~/my-vault")

def remember_reply(response, memory, agent):
    memory.remember(
        "conversation",
        "last_reply",
        response.choices[0].message.content,
        source="chat",
        agent=agent,
    )

chat = MemoryChat(openai_compatible_client, memory, remember_fn=remember_reply)
chat.create(model="claude-sonnet-4.7", messages=[{"role": "user", "content": "brief me"}])
chat.create(model="glm-4.7", messages=[{"role": "user", "content": "continue"}])

memory.history("conversation")  # agents include [email protected] and [email protected]
LiteLLM 可以使用同样的模式,配合调用前注入助手和成功日志记录器:
from homestead_memory import connect
from homestead_memory.adapters.litellm_memory import MemoryLogger, inject_memory

memory = connect("~/my-vault")
messages = inject_memory([{"role": "user", "content": "brief me"}], memory)

# LiteLLM callback registration style depends on your app setup.
logger = MemoryLogger(memory, agent_name="assistant")
MCP 本身就位于框架级路由器之上。在采用 claude-code-router 风格的设置、切换后端模型时,homestead-memory 无需任何配置即可继续工作,因为记忆独立于模型。随后,history() 和 verify
会将每条记录的事实归因到写入它的确切 name@model。
集成
这些适配器面向此处列出的公开框架接口,并以当前版本为准;随着这些 API 演进,可能需要升级版本。核心部分仅依赖标准库;只需安装你所用框架对应的额外依赖。
通用工具适用于任何能够注册可调用对象或 JSON Schema 函数工具的编排器:
from homestead_memory import connect
from homestead_memory.adapters.tools import recall_tool, remember_tool, tool_specs, verify_tool

memory = connect("~/my-vault", agent="my-agent")
tools = [remember_tool(memory), recall_tool(memory), verify_tool(memory)]
specs = tool_specs(memory)  # name, description, parameters
LangGraph BaseStore(目标版本:langgraph>=0.2):
from homestead_memory import connect
from homestead_memory.adapters.langgraph_store import HomesteadStore

store = HomesteadStore(connect("~/my-vault", agent="langgraph"))
graph = builder.compile(checkpointer=checkpointer, store=store)
CrewAI 存储/记忆(目标版本:crewai>=0.70,采用 save/search/reset 存储式接口):
from homestead_memory import connect
from homestead_memory.adapters.crewai_memory import HomesteadCrewAIStorage

storage = HomesteadCrewAIStorage(connect("~/my-vault", agent="crewai"))
storage.save("Researcher found the supplier shortlist", metadata={"task": "supplier_shortlist"})
AutoGen autogen_core Memory 协议(目标版本:autogen-core>=0.4):
from autogen_core.memory import MemoryContent, MemoryMimeType
from homestead_memory import connect
from homestead_memory.adapters.autogen_memory import HomesteadAutoGenMemory

memory = HomesteadAutoGenMemory(connect("~/my-vault", agent="autogen"))
await memory.add(MemoryContent(content="Use metric units", mime_type=MemoryMimeType.TEXT))
OpenAI Agents SDK Session 协议或函数工具(目标版本:openai-agents>=0.0.1):
from homestead_memory import connect
from homestead_memory.adapters.openai_agents import HomesteadSession, function_tools

memory = connect("~/my-vault", agent="openai-agents")
session = HomesteadSession(memory, session_id="user-123")
agent_tools = function_tools(memory)
Claude Code / Desktop / Cursor(MCP:记忆工具,不捕获操作):
claude mcp add homestead-memory -- hsm mcp ~/my-vault
# tools: memory_ask · memory_search · memory_verify · memory_history ·
#        memory_ingest · memory_distill
为什么要做这个项目
“在你的设备上运行”如今只是基本要求。每种记忆工具都会在本地存储。 没有人验证。 记忆会悄然腐坏:一条笔记自相矛盾,提取出的“事实”丢失来源,正文内容偏离自身的变更日志,当前值被过时值覆盖。几周后你才会发现:你的 Agent 信心十足地告诉你,某件事在 3 月就已经不再属实。
腐坏只是被动故障。记忆还会被篡改(写入后修改事实)和投毒(不可信输入注入从未属实的“记忆”,这是一种于 2026 年命名的攻击类别)。homestead-memory 会以机械方式捕捉这三种情况。为保管库签名后,任何字节被修改都会导致签名失效。提炼出的主张必须引用可解析的来源,否则就会被丢弃。记忆基准测试衡量模型记得什么。RotBench 衡量记忆是否可信。 详见 benchmarks/ROTBENCH.md。
homestead-memory 围绕三项承诺构建:
- 以 Markdown 为核心。 人类可读的文件就是记忆。索引和投影均由此派生,可随时丢弃。你可以随时离开。这是你的文件夹。支持导入/导出 Google 的 Open Knowledge Format(
hsm export --format okf)以及 Mem0/Zep:我们采用 OKF,但加入了签名和可验证性。 - 重验证,不重信任。 完整性是一个数值(RotBench,0–100),通过机械检查计算得出,不让 LLM 给自己的作业打分。详见
benchmarks/ROTBENCH.md。 - 可审计的提取。 可选的提炼层(
docs/DISTILL_SPEC.md)会提取实体事实,并附上原文引述,由代码核验。主张要么引用真实来源,要么就会被丢弃。出现矛盾时,会追加一条变更日志(update current_crm: "Salesforce" -> "HubSpot" (source: chat-042.md)),绝不会静默覆盖。可审计的提取,才值得信任。
两大阵营(本项目的定位)
| 提取阵营(Mem0、Zep) | 原文阵营(MemPalace、本项目) | |
|---|---|---|
| 写入成本 | 每轮/每段经历都调用一次 LLM | $0(仅嵌入;提炼为可选项) |
| 信息 | 有损摘要 | 无损原始文本 |
| 可审计性 | 信任提取器 | 引用或丢弃,机械核验 |
| 完整性评分 | — | RotBench,每次运行都发布 |
真实数据(LongMemEval)
在完整的 500 题 _s 集合(包含干扰项的 48 轮会话干草堆)上测得,
采用官方的分类评审方法评分,阅读器为 glm-5.2,
独立评审器为 deepseek-v4-pro。复现方法:benchmarks/README.md。
完整运行历史(包括失败记录):benchmarks/RESULTS.md。
| 指标 | 数值 |
|---|---|
| 检索召回率@k | 85%(证据进入 top-k) |
| QA 准确率(官方方法) | 52.8% |
| 每次查询的上下文令牌数 | ~5.2k |
| RotBench | 99.4 / 100(衡量构建的基准知识库的完整性,并非对任意知识库的声明) |
请仔细阅读 RotBench 这一行:它评估的是此测试框架构建的知识库,因此描述的是本次运行,而不是保证你的知识库也能得 99 分。对真实工作知识库运行时,通常得不到这个分数,而这正说明工具发挥了作用。关于该分数衡量和不衡量的内容,请参见
benchmarks/ROTBENCH.md。
我们会和不会声称什么:召回率表现出色,且不受阅读器影响。QA 表现真实,处于中游。已发布的系统在自家测试框架上报告的分数更高(Mem0 为 94.4%,Zep 为 63.8% 独立评估)。我们选择公开测试框架、评审器和每一次失败的实验。这里的每个数字都来自你可以亲自运行的测试框架。
设计
- 跨平台。 除负责签名的
cryptography外,完全使用 Python。 CI:ubuntu / macos / windows。软件包附带的验证器仅依赖标准库,因此接收者无需安装任何东西即可验证软件包,这才是关键。 - 明确降级。 qmd 2.1+ 为可选项。MCP 故障时回退到专用 CLI;qmd 故障时回退到只读扫描。机器可读的输出会注明所用引擎和原因,而不是默默假装快速路径成功。
- 默认本地运行。 HTTP API 绑定到回环地址,并启用 bearer 身份验证和 DNS 重绑定防护;MCP 服务使用 stdio(由客户端启动)。不会向外发送数据。
- 支持时间维度。 变更日志条目可供查询历史:
hsm history note --as-of DATE。
状态
v0.5,公开开发中。路线图:ROADMAP.md。挑战我们的基准测试:
benchmarks/ROTBENCH.md。对抗性测试样例会被合并。
MIT © Kinetic Labs Inc. · 一个 FuckBigTech / HOMESTEAD 项目。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。