关于 pandas-doctor
pandas-doctor 面向希望找出 pandas 慢速写法并验证改写的 Python 开发者。它会用实际数据比较结果并测量运行时间,再决定是否建议或应用改写,同时提供命令行、Notebook、CI 和 MCP 接口。
主要功能
- 01检测常见的 pandas 慢速模式
- 02用真实输入比较改写结果
- 03测量改写前后的运行时间
- 04将已验证的改写应用到文件
- 05在命令行、Notebook 和 CI 中检查
- 06提供 MCP 检查与验证工具
适用场景
- 01查找 Python 脚本中的性能问题
- 02应用改写前验证结果
- 03在 CI 或 pre-commit 中检查 pandas 代码
- 04让 AI 助手核验其提出的代码修改
MCP 相关
pandas-doctor mcp 命令向 MCP 客户端提供 check_code、verify_rewrite 和 list_rules 工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
3收录的工具列表 · 更新于 1 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| code | string | 是 | 要扫描的 Python 源代码:脚本、模块或 notebook 单元格。 |
| filename | string | 否 | 在发现项中显示的名称;如果有实际路径,请使用该路径。 |
详细介绍
pandas-doctor


pandas-doctor 会找出代码中运行缓慢的 pandas 语句并重写,然后用你自己的数据检查结果是否完全一致。接着,它会告诉你重写后快了多少——这是实测结果,不是估算。
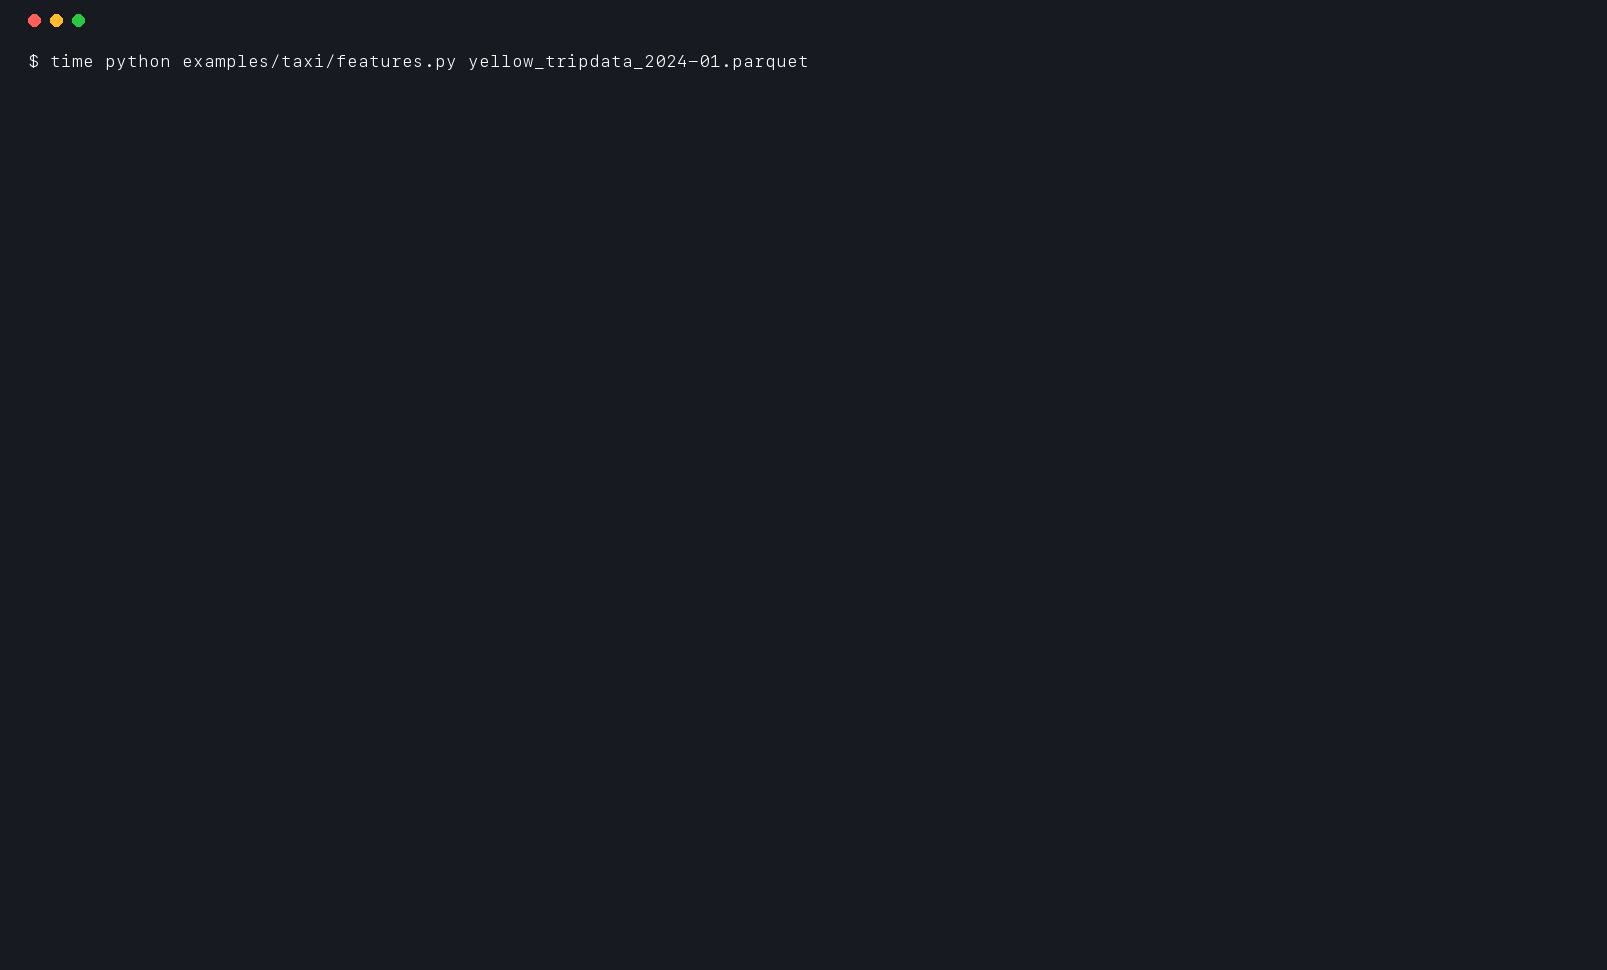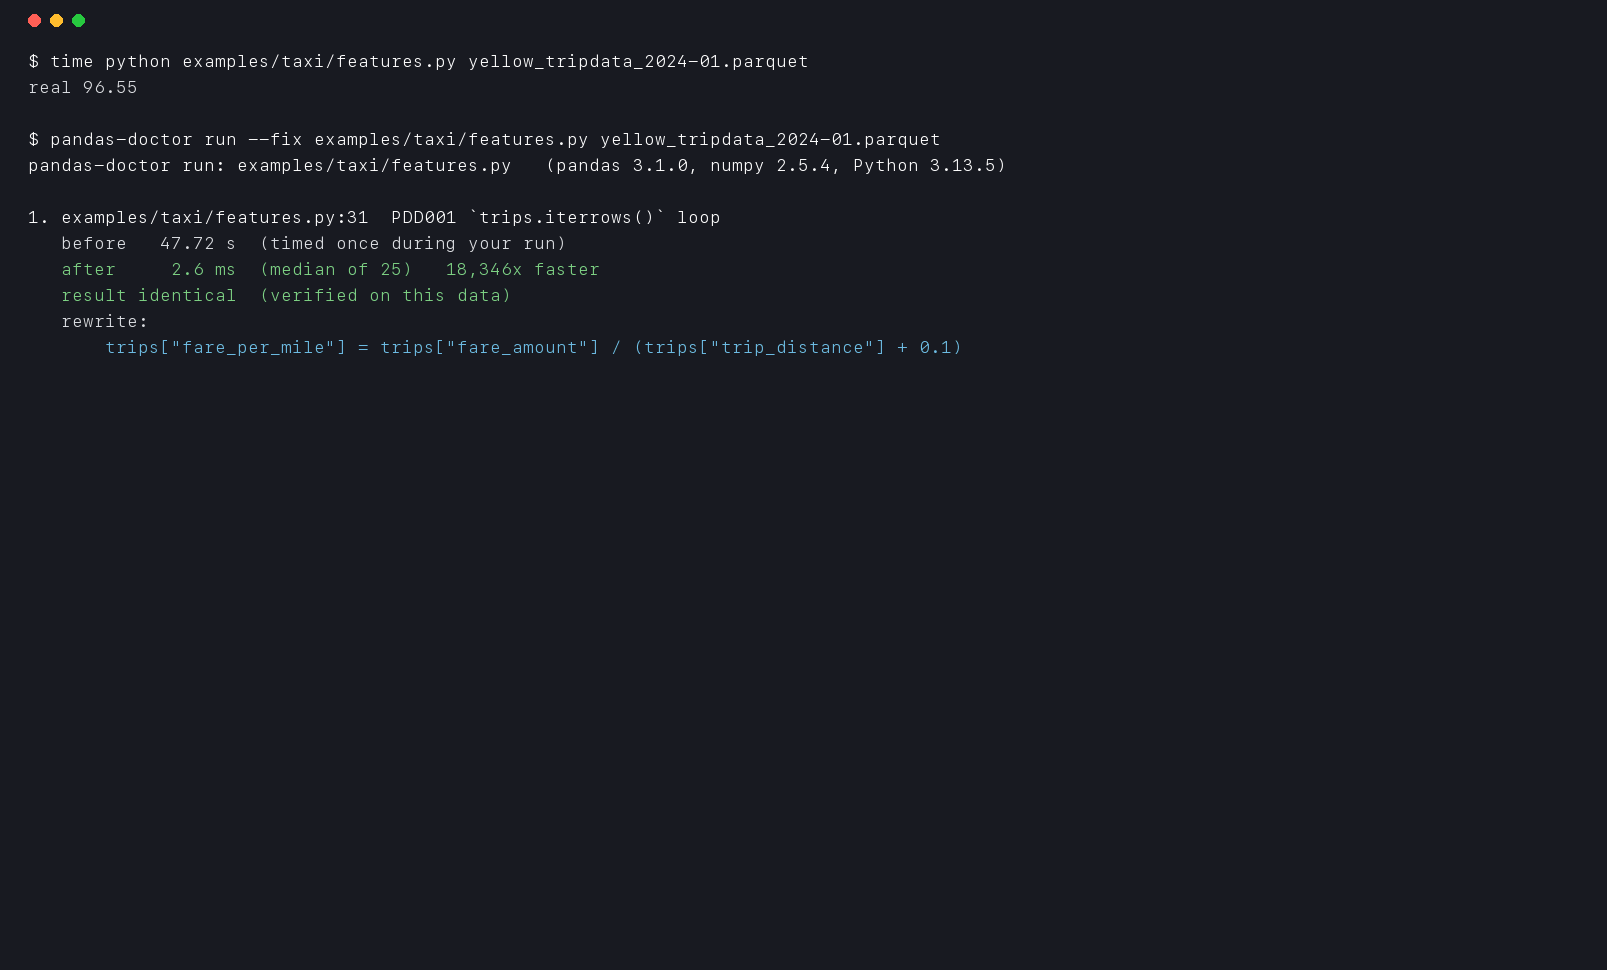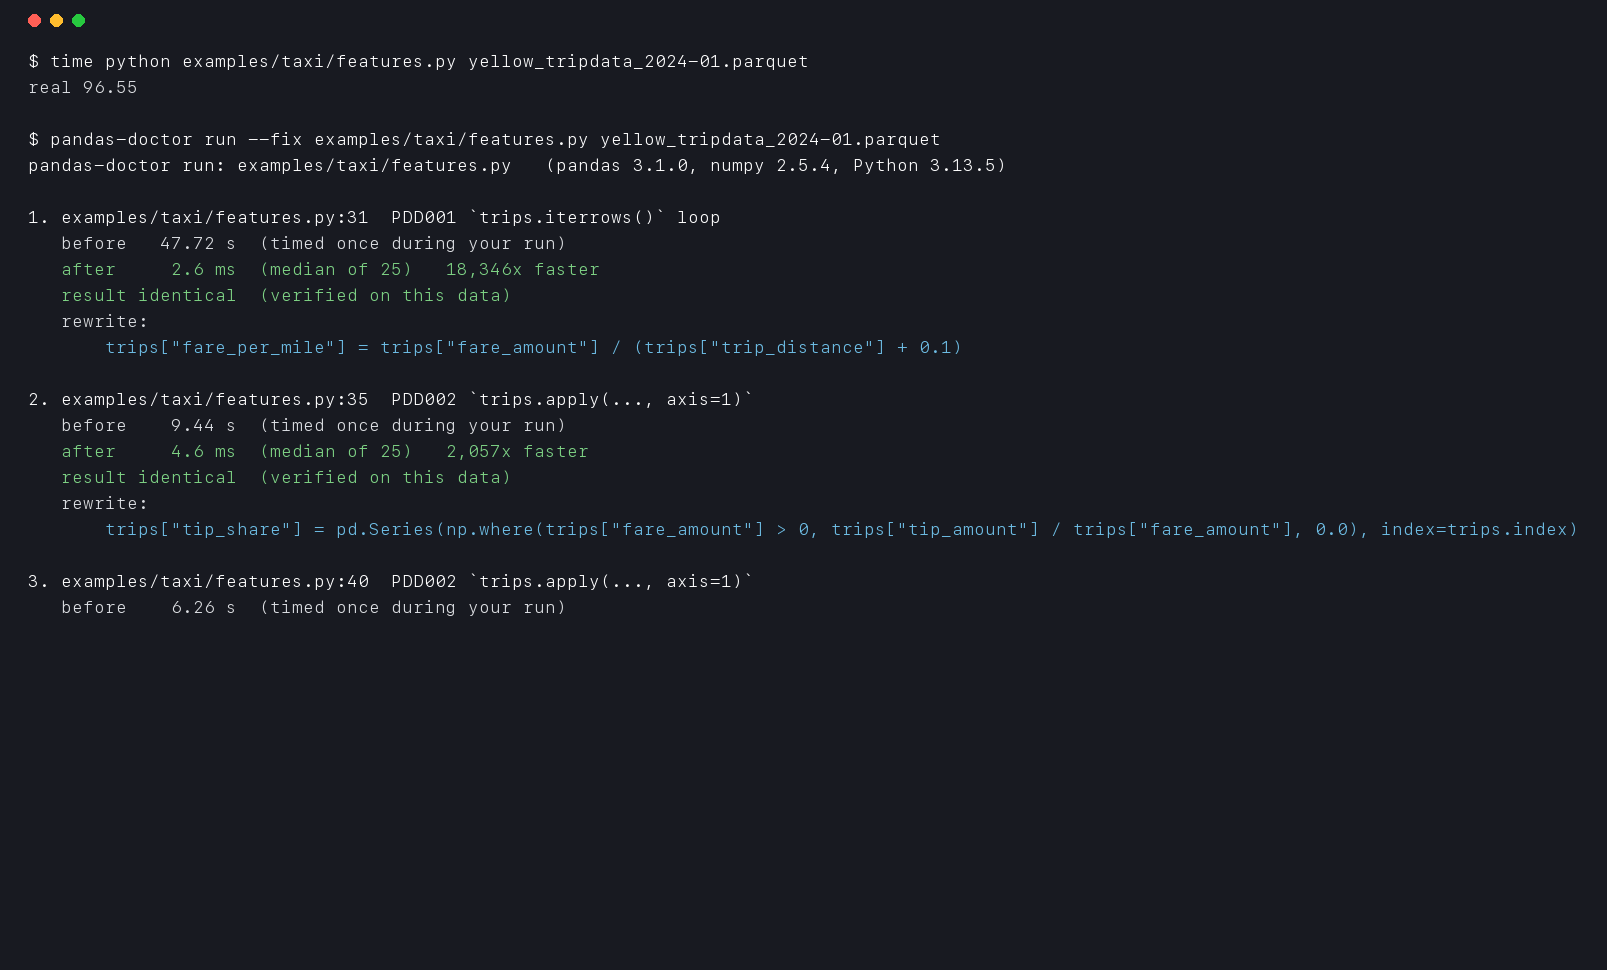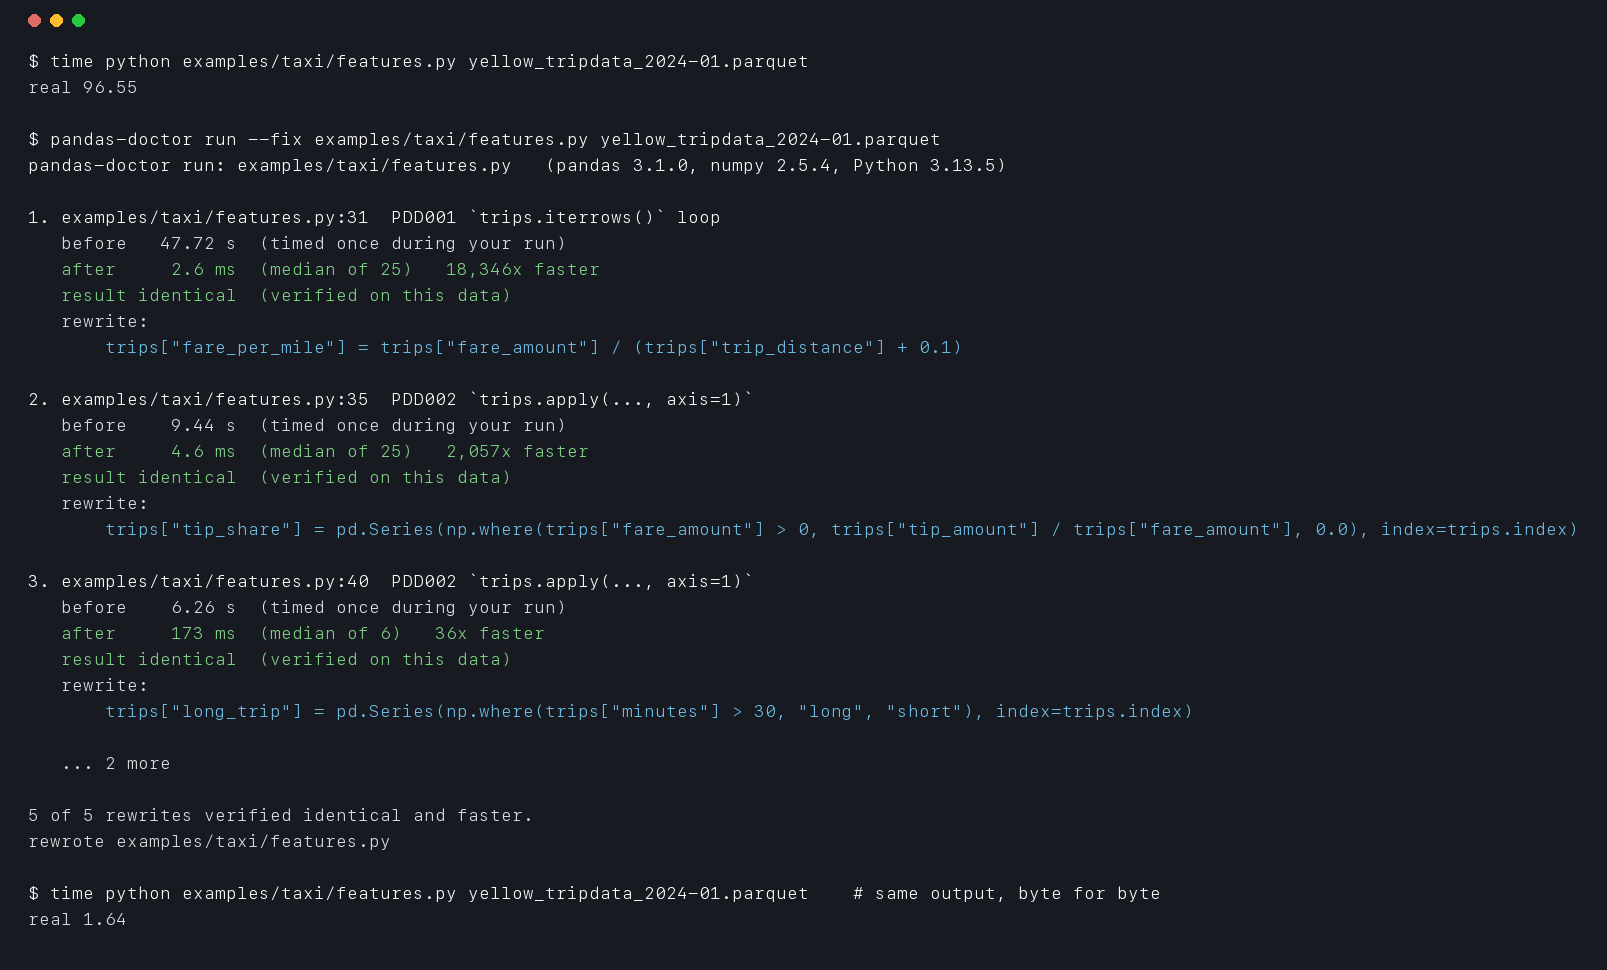
这是一次在真实数据上的实际运行:examples/taxi/features.py 处理 NYC TLC yellow taxi trips 2024 年 1 月的数据(296 万行),其中包含许多 Notebook 中常见的循环。脚本运行耗时 96.6 s(M4 Pro,pandas 3.1.0,使用 pyarrow)。pandas-doctor 使用脚本自身的数据检查了 5 处重写,结果完全相同,且运行更快。使用 --fix 后,整个脚本只需 1.64 s,并输出完全相同的结果。完整报告见 docs/taxi-run-full.txt。
无需下载任何数据,即可运行 examples/hero/features.py,这是同一脚本处理 100 万条使用固定随机种子生成的合成行程数据:优化前 27.9 s,优化后 1.01 s(报告)。
试用
pip install pandas-doctor
pandas-doctor run your_script.py
也可以先在浏览器中试用,无需安装:
run 会正常执行脚本。每当发现运行缓慢的模式时,它都会复制该代码的输入,让你的代码照常运行,然后在副本上运行重写版本并比较输出。--diff 会以补丁形式显示经过验证的重写内容,--fix 则会将其写入文件。
在 Notebook 中:
%load_ext pandas_doctor
%%doctor
for i, row in df.iterrows():
    df.at[i, "total"] = row["price"] * row["qty"]
%%doctor --rewrite 会将经过验证的版本放入下方的新单元格中。
“相同”的含义
只有满足以下条件,两个结果才算相同:
- 类型相同,精确到每个值(
numpy.float64不等于float) - dtype、索引和列都相同,包括标签和名称
- 缺失值的位置相同
- 值完全相等
每项检查最终都会得到以下四种判定之一:
| 判定 | 含义 | run 是否会应用? |
|---|---|---|
| identical | 以上各项全部匹配 | 是 |
| equal values, different scalar types | 每个值都完全相等,但有些值是 numpy 标量,而原始值是 Python 标量,或反之。报告会列出类型。 | 是,报告也会说明这一点。--strict-types 会关闭此行为。 |
| equal within tolerance | 浮点数的差异不超过 --rtol,通常是因为求和顺序不同。报告会显示最大差异。 | 仅在使用 --rtol 时 |
| different | 其他所有情况,并指出第一个差异位置 | 否 |
这比听起来更严格,也能捕获真实差异:
iterrows会将每一行作为 Series 交给你,因此当数据帧还包含浮点列时,整数列会变成浮点数。显而易见的改写会保留整数,导致 dtype 改变:different。- 在全数值数据帧中,将
row["x"] * 2收集到列表会得到 numpy 浮点数;通过.tolist()执行相同操作则会得到 Python 浮点数:equal values, different scalar types。这通常无关紧要,但有时会有影响:json.dumps无法处理numpy.int64。 - 以不同顺序求和会改变浮点数末尾的几位:equal within tolerance。
当普通改写未通过时,pandas-doctor 会尝试几个更忠实的版本:iterrows 使用的行 dtype、numpy 标量,以及相同的求和顺序。它会保留通过检查的最简版本;如果有多个同样简洁的版本,则优先选择 identical。如果没有任何版本通过,它会说明原因,并且不做任何更改。
即使改写结果相同但速度没有提升,也不会推荐。这种情况确实会发生:对于由 Python 支持的字符串,.str.lower() 可能比 .apply(lambda x: x.lower()) 更慢。
“已验证”始终表示在这份数据上验证通过。这是一项严格的检查,但不能证明对所有可能的输入都成立。
为什么不直接问 AI?
助手可以提出相同的改写建议,但无法判断这些改写在你的数据上是否会产生相同结果;正如上面的示例所示,它们往往并不会。pandas-doctor 会运行两个版本并比较结果。如果你确实使用助手,它可以调用 pandas-doctor 检查自己的修改(参见 AI 助手)。
三个命令
| 命令 | 功能 | 会运行你的代码吗? |
|---|---|---|
pandas-doctor check PATH | 查找 .py 文件和笔记本中的慢速模式,并打印建议的改写。速度快,适用于 CI 和提交前检查。 | 否 |
pandas-doctor run script.py | 运行脚本,在数据上检查每项改写,为两个版本计时,并可应用已验证的改写。 | 是,这正是它的用途 |
pandas-doctor verify | 使用你自己的改写:提供原始代码、候选代码,以及用于构建输入的设置代码。 | 仅运行这些代码片段 |
pandas-doctor verify --setup setup.py --original slow.py --candidate fast.py
除非传入 --strict-types,否则当改写结果 identical 或仅标量类型不同但值相等时,verify 会以 0 退出;--accept-tolerance 也会允许 equal within tolerance 通过。使用 --format json(以及 run --json)时,判定结果为 identical、scalar_types、within_tolerance 或 different,详细信息会显示在旁边。
检查内容
| 规则 | 慢速模式 | 重写方式 | 测量结果,100k 行 | 结果 |
|---|---|---|---|---|
| PDD001 | for i, row in df.iterrows(): ... | 列表达式、.sum()、.extend(...) | 1.13 s → 79 µs(14,239x) | 相同 |
| PDD002 | df.apply(f, axis=1),且包含列运算 | 列表达式或 np.where | 192 ms → 92 µs(2,091x) | 相同 |
| PDD003 | 在循环中使用 X = pd.concat([X, part]) | 收集各部分,再调用一次 pd.concat(不安全修复) | 65.5 ms → 2.3 ms(29x) | 相同 |
| PDD004 | s.apply(lambda x: ...)、.map(lambda ...) | .str / .dt / 算术运算 | 27.8 ms → 403 µs(69x) | 相同 |
| PDD005 | groupby(...).apply(lambda g: g[c].count()) | groupby(...)[c].count() | 4.2 ms → 479 µs(8.8x) | 相同 |
| PDD006 | 按列循环调用 astype(仅限 run) | 一次 astype 调用 | 102 ms → 111 ms(慢 1.1x) | 相同 |
| PDD007 | 遍历索引时在循环中使用 df.at[i, c] = ... | 整列赋值 | 844 ms → 64 µs(13,283x) | 相同 |
| PDD008 | 不同值较少的文本列(仅限 run) | category | 100 万行时,内存:52.8 MB → 1.0 MB | 仅提供建议 |
测量使用 benchmarks/,环境为 Apple M4 Pro、Python 3.13.5、pandas 3.1.0、numpy 2.5.4(pandas 2.2.3 和使用 pyarrow 时的完整结果见 benchmarks/results/)。每行对应一种模式示例;实际加速效果取决于你的数据和循环执行的操作。
有两项结果值得了解:
- 字符串方法的效果取决于字符串后端。 不使用 pyarrow 时,
.apply(lambda x: x.strip().lower())→.str.strip().str.lower()的耗时为 5.6 ms → 8.7 ms(慢 1.5x);安装 pyarrow 后则为 8.0 ms → 1.9 ms(4.2x)。pandas-doctor 会在建议重写前进行测量。 - groupby 求和的结果并非逐位相同。
groupby.apply(lambda g: g[c].sum())→groupby[c].sum()的耗时为 5.7 ms → 613 µs(9.3x),但 pandas 内置的求和使用补偿求和,因此结果只有在相对误差 2.2e-16 以内才匹配。pandas-doctor 会报告这一点,并且仅在使用--rtol时应用此重写。
PDD006 和 PDD008 需要数据,因此只有 run 会报告它们。只有在一次 astype 调用确实更快时才会出现 PDD006;在当前的 pandas 版本中,通常并非如此。
检查结果分为两个级别:
- warning:值得修复的慢速模式。发现此类问题时,
check会以 1 退出(使用--exit-zero可仅报告问题)。 - info:没有匹配向量化重写方式的
iterrows循环,通常是逐行绘图、打印或调用其他内容的循环。下方语料库检查发现的 99 个iterrows问题都属于此类。Info 级别的问题会列出(在 GitHub Action 中显示为通知),且不会导致check失败。
check --fix 不会自行改变行为。只有在每个部分的列和数据类型都相同时,concat 重写(PDD003)才会得到相同结果;属性测试发现了一些结果不一致的数据帧。因此,这属于不安全修复,需要使用 --unsafe-fixes;run 会在你的数据上检查此修复。
发布前,check 对 13 个公开仓库中的 8,419 个文件进行了检查(包括 pandas、statsmodels、Kaggle 课程和热门笔记本合集),以排查误报。检查结果和修复见 docs/corpus.md。它在知名教学笔记本中发现的慢速代码行,经重新测量后的结果见加速效果集锦。
在 CI 中使用
pre-commit:
- repo: https://github.com/furqan-khan07/pandas-doctor
  rev: v0.1.0
  hooks:
    - id: pandas-doctor
GitHub Action。它会为 diff 添加注释,并在 PR 上保留一条汇总评论:
- uses: furqan-khan07/[email protected]
  with:
    paths: src notebooks
该评论需要设置 permissions: pull-requests: write。check --format json 可与其他任何工具配合使用。
AI 助手
pandas-doctor mcp 通过 MCP 提供三个工具:check_code、verify_rewrite 和 list_rules。使用 pip install "pandas-doctor[mcp]" 安装,或让 uvx 获取。在 Claude Code 中:
claude mcp add pandas-doctor -- uvx --from "pandas-doctor[mcp]" pandas-doctor mcp
在 Cursor、Claude Desktop 或任何接受 mcpServers 配置的其他客户端中:
{
  "mcpServers": {
    "pandas-doctor": {
      "command": "uvx",
      "args": ["--from", "pandas-doctor[mcp]", "pandas-doctor", "mcp"]
    }
  }
}
它也已收录在 MCP Registry 中,名称为 io.github.furqan-khan07/pandas-doctor。
Claude Code 还有一个插件,其中包含一项技能,会提醒助手在声称性能提升之前先进行验证(它通过 uvx 使用 CLI;如果你添加了上面的 MCP 服务,也可以使用该服务):
/plugin marketplace add furqan-khan07/pandas-doctor
/plugin install pandas-doctor@pandas-doctor
限制
run会像执行python script.py一样运行一次脚本。对于纯计算(不涉及文件、网络或随机性)的已标记代码块,会在副本上重新运行,以获得稳定的中位数。较慢的代码块只会在运行期间计时一次,报告中会注明这一点。- 每个已标记位置只会在首次调用时检查。超过 2 GB 的输入不会被复制,因此不会检查。
- 仅支持表格中列出的代码形态的改写。其他情况只会给出提示,不会猜测。
- 不会进行网络调用,也不会收集遥测数据。
- 支持 Python 3.11+ 和 pandas 2.2+,已在 pandas 2.2 至 3.1 上测试。
参与贡献
发现误报,或发现它应该了解的慢速模式?请附上简短代码片段提交 issue。附带前后对比测试和基准测试的模式最容易被加入。
由 Furqan Khan 制作。他是 pandas 的贡献者,其 DST 绘图修复(pandas-dev/pandas#69960)已合并,并随 pandas 3.2 发布。采用 MIT 许可证。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。