关于 qikly
qikly 面向验证独立 Python 模块的开发者,将基于验收标准生成测试与代码修复分开。测试 Agent 编写测试套件,编码 Agent 则在看不到标准和测试的情况下修复代码副本。
主要功能
- 01通过变异测试评估现有测试
- 02起草验收标准任务文件
- 03依据标准生成测试
- 04针对测试修复代码副本
- 05对编码 Agent 隐藏验收标准
- 06安装 Agent Skill
适用场景
- 01检查 Python 模块测试的覆盖缺口
- 02独立验证数据转换逻辑
- 03评估编码 Agent 的实现
- 04在不改动源文件的情况下运行验收检查
MCP 相关
qikly 作为 MCP 服务运行,可让 Agent 启动运行并读取结果。其工具不会返回验收标准,因此编码 Agent 可查看失败测试和 pytest 输出,但看不到规则。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
4收录的工具列表 · 更新于 3 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| model | string | 否 | |
| task_id | string | 是 | |
| provider | string | 否 |
详细介绍
qikly




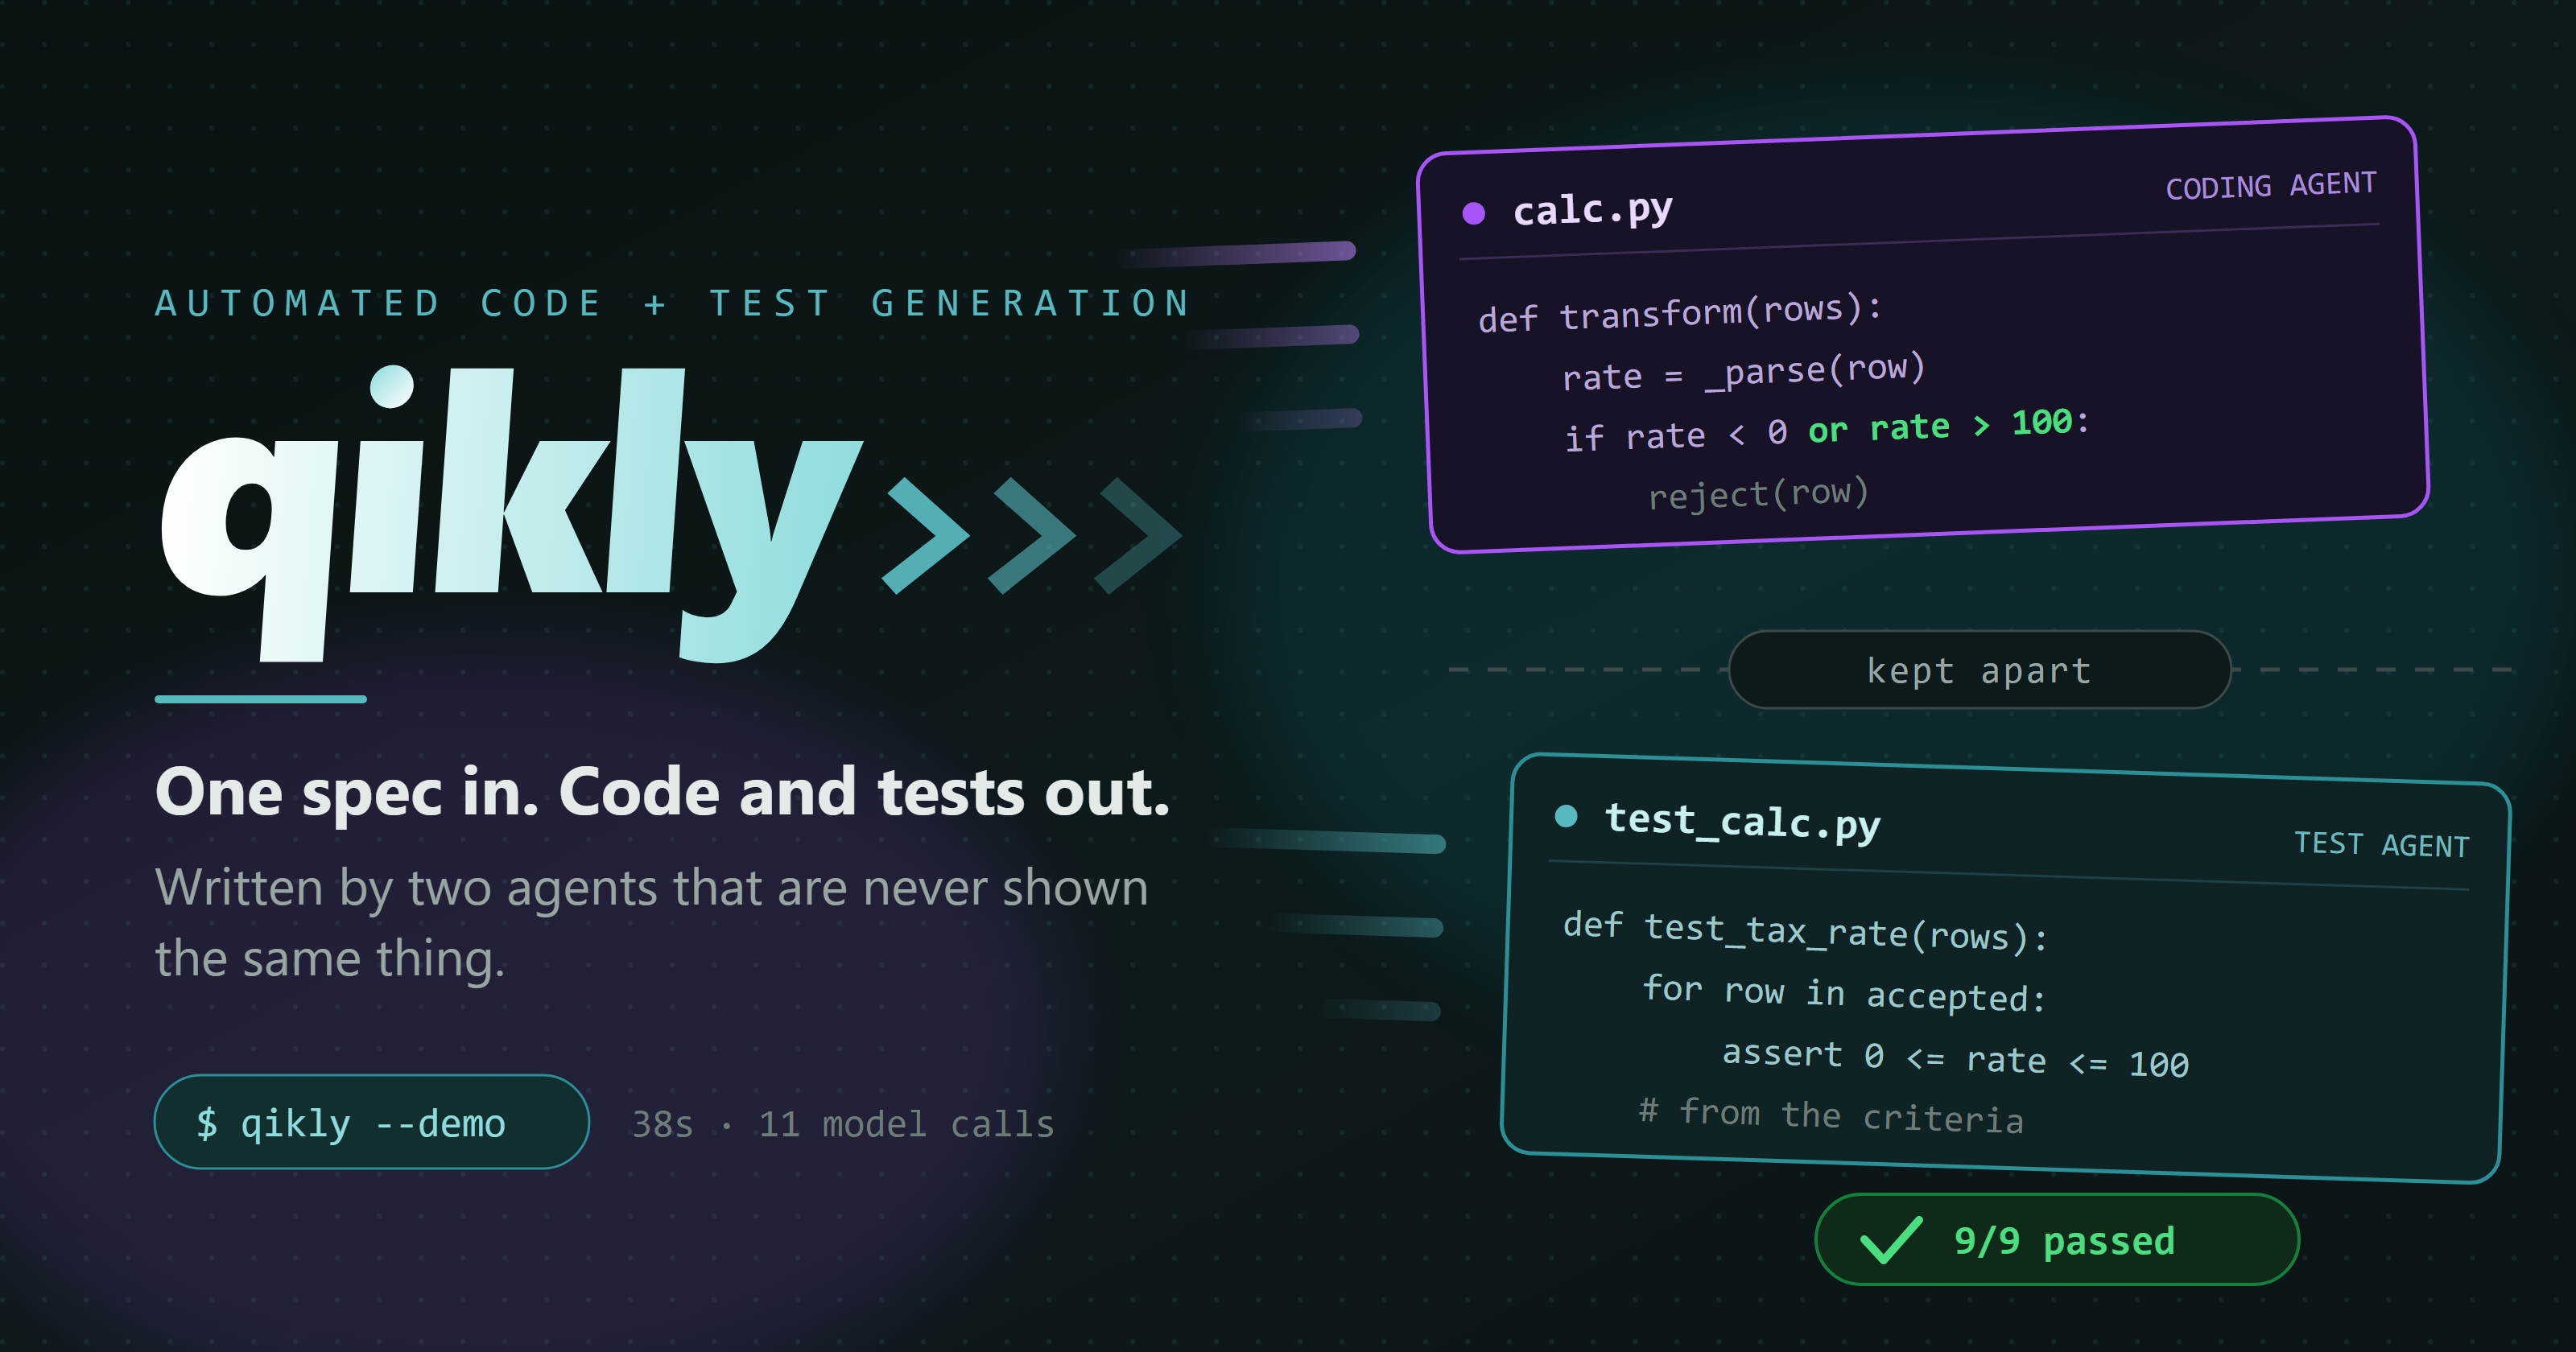
问题:你的 AI 同时编写代码和测试。你怎么知道这些测试真的有效?
一次有记录的运行。测试 Agent 构建测试套件:它根据规范的验收标准得知,速率不得超过 100。编码 Agent 从未看过验收标准,而是从一次失败的测试中发现了速率限制:随后它自行添加了 or rate > 100,因此 9 项全过,意味着代码在自动修复循环中应用修复后终于通过了测试套件。
| 开始使用 | 为什么使用 qikly? · 从这里开始 · 适用场景 · 通过编码 Agent 使用 |
| 工作原理 | 理念 · 有何不同 |
| 运行 | 四种使用方式 · 免费命令 · 演示效果 · 你自己的数据 · 测试数据 · 运行 · 运行停滞时 · 输出 · 两项免费检查 |
| 设置 | 配置 · 在 CI 中使用 · 版本检查 |
| 参考 | 功能 · 目前的适用范围 · 实际发现的问题 · 延伸阅读 |
| 社区 | 徽章 · 贡献任务 · 项目由来 · 隐私 · 许可证 |
为什么使用 qikly?
如果学生既出试卷、写答案,又参加考试,他就能及格。当一个模型同时拿到验收标准,并被要求产出实现和检查实现的测试套件时,就会发生这种情况。一切都显示通过,但绿色结果可能毫无意义。qikly 会把答案从学生手中拿走:编码 Agent 看不到验收标准。
从这里开始
开始之前,请准备好三样东西:
-
安装 qikly:
pip install --upgrade qikly。 -
设置一个 API 密钥,供步骤 2 和 3 使用:Google Gemini(免费额度,无需银行卡)、Anthropic 或 OpenAI。在你运行 qikly 的终端中:
export GEMINI_API_KEY="..." # macOS and Linux $env:GEMINI_API_KEY = "..." # Windows PowerShell获取密钥及另外两个提供商。 第 1 步无需密钥;没有密钥时,第 2 步中的每个答案都要由你来写。
-
先确认测试可以独立通过,在项目根目录运行:
python -m pytest。qikly 也会以同样的方式运行测试,因此缺少依赖包或 Python 版本不正确,也会导致第 1 步无法运行。
然后在该根目录运行以下命令。每个命令都可以针对一个模块或整个 文件夹运行,并且每一步使用相同的路径:
qikly --score my_module.py       # 1. what your tests miss         free, no key
qikly --scaffold my_module.py    # 2. the drafted spec, to check   a fraction of a cent
qikly --tasks my_module.py       # 3. the run                      a cent or so
-
**
--score为现有测试评分。**它会在代码副本中逐一植入故障,并指出 测试未发现的故障,每个故障都以一个关于未受任何检查的行为的问题来描述。 它会自行查找测试:从项目根目录开始搜索导入你代码的test_*.py和*_test.py文件。若要指定测试文件,请添加--score-tests tests/。 不会调用任何模型,也不会修改你的任何文件。 -
--scaffold起草规范文件inputs_private/config/tasks/MY_MODULE_VERIFY.yaml, 填入从代码中能读取到的所有内容,并生成一个数据文件,其中记录测试已用来调用 该代码的值。设置密钥(Google Gemini、Anthropic 或 OpenAI)后,规范 Agent 会起草只有项目所有者才能编写的部分:一行说明模块的用途,以及针对第 1 步 每个问题给出一个作为验收标准的答案。它会读取你的 README 和文档字符串, 绝不会读取代码,因此它描述的是代码应该做什么,而不是实际做什么;根据它编写的 测试可能会与代码不一致:#? What should apply_discount(100, 100) do? #? Answer below drafted by qikly from your README or docstrings: "...so a rate #? of 100 or more is rejected with ValueError". Keep it, or change it. - "apply_discount(100, 100) raises ValueError"每个答案都会注明来源:来自文档且逐字核对的引文,或在没有书面说明时由 Agent 根据模块用途判断的
CHECK。你可以直接运行草稿,也可以修改任何你不同意的答案, 可以附引文,也可以不附。文档无法确定的内容会留作 TODO:如果 qikly 运行代码 后找到了候选值,请用选项编号作答(询问某个值时写1: <value>,表示保留代码 当前行为时写keep),也可以用句子写明一个值。未填写的 TODO 会被跳过。 没有密钥时,所有答案都要由你来写,并且requirements行会标记为TODO: MODIFY THIS:。针对文件夹运行时,它会为第 1 步询问的每个模块 各写一个任务文件。以#?开头的行是给你的备注,两个 Agent 都不会读取。 该文件是唯一可信来源:修改它后,再运行第 3 步。qikly --validate my_module.py可免费检查该文件,并显示每个简短答案将转换成的验收标准。 -
--tasks运行任务,这需要 API 密钥(Google Gemini、Anthropic 或 OpenAI)。 测试 Agent 会先根据你的标准编写测试,在向它展示任何代码之前完成;另一个独立的 编码 Agent 不会看到这些测试,它会修复代码副本,直到测试通过。你的文件绝不会 被修改。完成后,它会提示你运行qikly --take-tests my_module.py,将新测试 复制到你自己的测试文件夹中的qikly_generated/下,并将测试改写为导入你的模块, 而不是 qikly 的副本,然后在你的代码上运行它们。如果有测试未通过,请将其与对应的 标准进行比较:代码或测试至少有一方存在问题。报告会注明哪些失败的测试是根据某项 标准编写的,哪些是测试编写者自行解读的,供你核查。
先尝试一个完整示例: docs/examples/
中有一个单模块项目和一个包含两个模块的文件夹,各自都附有已填写完毕的任务文件,
可供你对照。
任务以模块命名为 MY_MODULE_VERIFY,其中 _VERIFY 表示这是一个用于测试现有代码的任务。你无需输入它:每个步骤都会使用你为 --score 提供的路径,通过 --task-id 指定的任务也会按其路径查找。qikly --scaffold my_module.py --fresh 则会改为写入 MY_MODULE.yaml,这是一个由 qikly 为同一接口编写新实现的任务。
其他入口
| 如果你想 | 运行 | 成本 |
|---|---|---|
| 从头到尾观看一次实际运行,使用内置任务 | qikly --demo | 需要密钥,约半分钟,费用远低于一美分 |
| 从一个完成的示例开始,在自己的项目中使用 | qikly --example | 无需设置 |
| 亲自查看划分结果,使用内置任务 | qikly --explain CALC_TAX | 无需任何设置,也不需要 API 密钥 |
| 从零开始编写任务 | qikly --init | 无需设置 |
须知
- 在会议上试用,首选单独使用
--score。 将它指向一个模块或一个包,并提供你已有的测试。它会在代码副本中一次植入一个故障,然后用这些测试逐一测试每个故障,并列出未被发现的故障。两个标志都必不可少:一个指定要破坏什么,另一个指定什么应该发现问题。 - 它会告诉你测试能发现哪些改动。但它无法判断代码一开始是否正确,因为它是通过破坏现有代码来工作的,因此代码从未实现的行为对它来说不可见。不会调用任何模型,不会修改你的任何内容,也不会有任何代码离开你的机器。
- 它会植入所有能植入的故障:单个模块最多 60 个,文件夹最多 150 个;如果测试运行缓慢,则会抽样。
--score-mutants 48可设置数量,--score-seed 1可抽取不同样本。 --demo会在临时的demo/throwaway_<timestamp>/文件夹中运行,并且预期你会删除该文件夹。它仅供观看,不适合用于实际开发。--example和--scaffold会在你当前所在目录中创建真实项目,这两种方式才适合后续开发。- 请使用
--upgrade,而不是直接安装,因为 Skill 随软件包一同发布:如果机器上已有旧版本,执行pip install qikly会显示 "Requirement already satisfied",不会有任何更改,之后--install-skill写入的也会是旧版 Skill。 - 快速入门会带你走完相同的步骤,然后逐条介绍每个命令。
- test.qikly.com 是本页面的两分钟精简版,也适合分享给其他人。
新增:Agent Skill。
qikly --install-skill可以教会 Claude Code、Gemini CLI、Codex、Cursor 或 GitHub Copilot 如何使用 qikly。 Skill 包含什么。
适用对象: 将 AI 编码 Agent 用于处理数据的独立 Python 模块的开发者或团队,例如 ETL 步骤、合并、计算或验证例程;他们不希望在同一个 Agent 同时编写代码和测试的情况下,仅凭测试套件全绿就轻信结果。它适合在小型到中型代码仓库中一次处理一个模块:测试失败时,只会加载失败信息中提到的文件,因此运行规模小、速度快。它尤其适用于验证必须保持独立的领域,例如汽车、医疗设备、金融科技和国防:内置示例 ADAS_HEADWAY 会根据前向雷达样本检查跟车距离。参见适用场景。
适用场景
专为独立的 Python 模块而构建,用于转换数据,而非大型现有代码仓库:ETL、合并、计算、验证。对于这一层,错误答案看起来就像正确答案,只有根据规则编写的测试才能发现问题。
**目前不适用的场景:**大型现有代码仓库。PATCH 提示词只会加载 FIX 指定的文件;虽然现在会截取大型文件中的相关内容,而非加载整个文件,但仍没有跨文件索引。请参阅目前的适用场景。
在编码 Agent 中使用
qikly 作为 MCP 服务运行,因此任何 MCP 宿主中的 Agent 都可以启动一次运行并读取结果,无需离开对话。目前已在 VS Code 和 Claude Code 中进行测试。安装好 uv 后,无需安装其他内容。在 Claude Code 中:
claude mcp add qikly -- uvx --from "qikly[mcp]" qikly-mcp
在 VS Code 中,点击本页顶部的 Install qikly MCP 徽章,即可自动填写相同的命令。
**无论成功还是失败,qikly 工具都不会返回你的验收标准。**你的 Agent 可以看到哪些测试失败以及 pytest 输出,但看不到它违反了哪条规则。
docs/mcp.md 介绍了这四个工具、其他宿主、如何改用 pip 安装、服务无法启动时的处理方法,以及如何让 Agent 无法访问生成的测试。
或者将其作为 Skill,传授用法而非直接调用
qikly --install-skill
这会将 Skill 复制到当前所在目录下的 .claude/skills/qikly。Skill 是 Agent 会读取的文件夹:它会告诉 Agent 何时该使用 qikly、规格说明中的哪一行是编码人员需要了解的决策、哪些内容是需要隐去的后果、修复循环停滞意味着什么,以及哪些命令无需花费。无需服务,也无需配置。
在 Claude Code、Gemini CLI、Codex 和 Cursor 中,Skill 都能加载并被正确使用:我们在每种工具首次使用时,均选择了一个同时安装了竞品测试 Skill 的项目,并提交了一个从未提及 qikly 的请求。Agent 有其他选择,也没有任何提示,因此这个结果值得一提。
--install-skill agents、
cursor 或 gemini 会将文件写入这些工具各自文档中指定的目录;copilot 则会写入 GitHub Copilot 读取的指令文件。目前只有这一种路径尚未观察到加载结果。
**这两者并非替代关系。**MCP 服务是代码,因此可以强制执行以下规则:工具不得返回你的验收标准;如果规则发生变化,测试就会导致构建失败。Skill 是指令,因此只能提供指导,而且它也明确说明了这一点。无论是否安装 Skill,工具都会强制隐去相关内容。
docs/skill.md 介绍了其中的内容、如何确认其已加载,以及两者之间的完整区别。
这个想法
qikly 不让学生看到答案。它根据验收标准生成测试套件,然后编写实现,并根据该套件不断修复,直到所有测试通过或重试预算耗尽,同时记录每次失败、每段推理和每个差异。
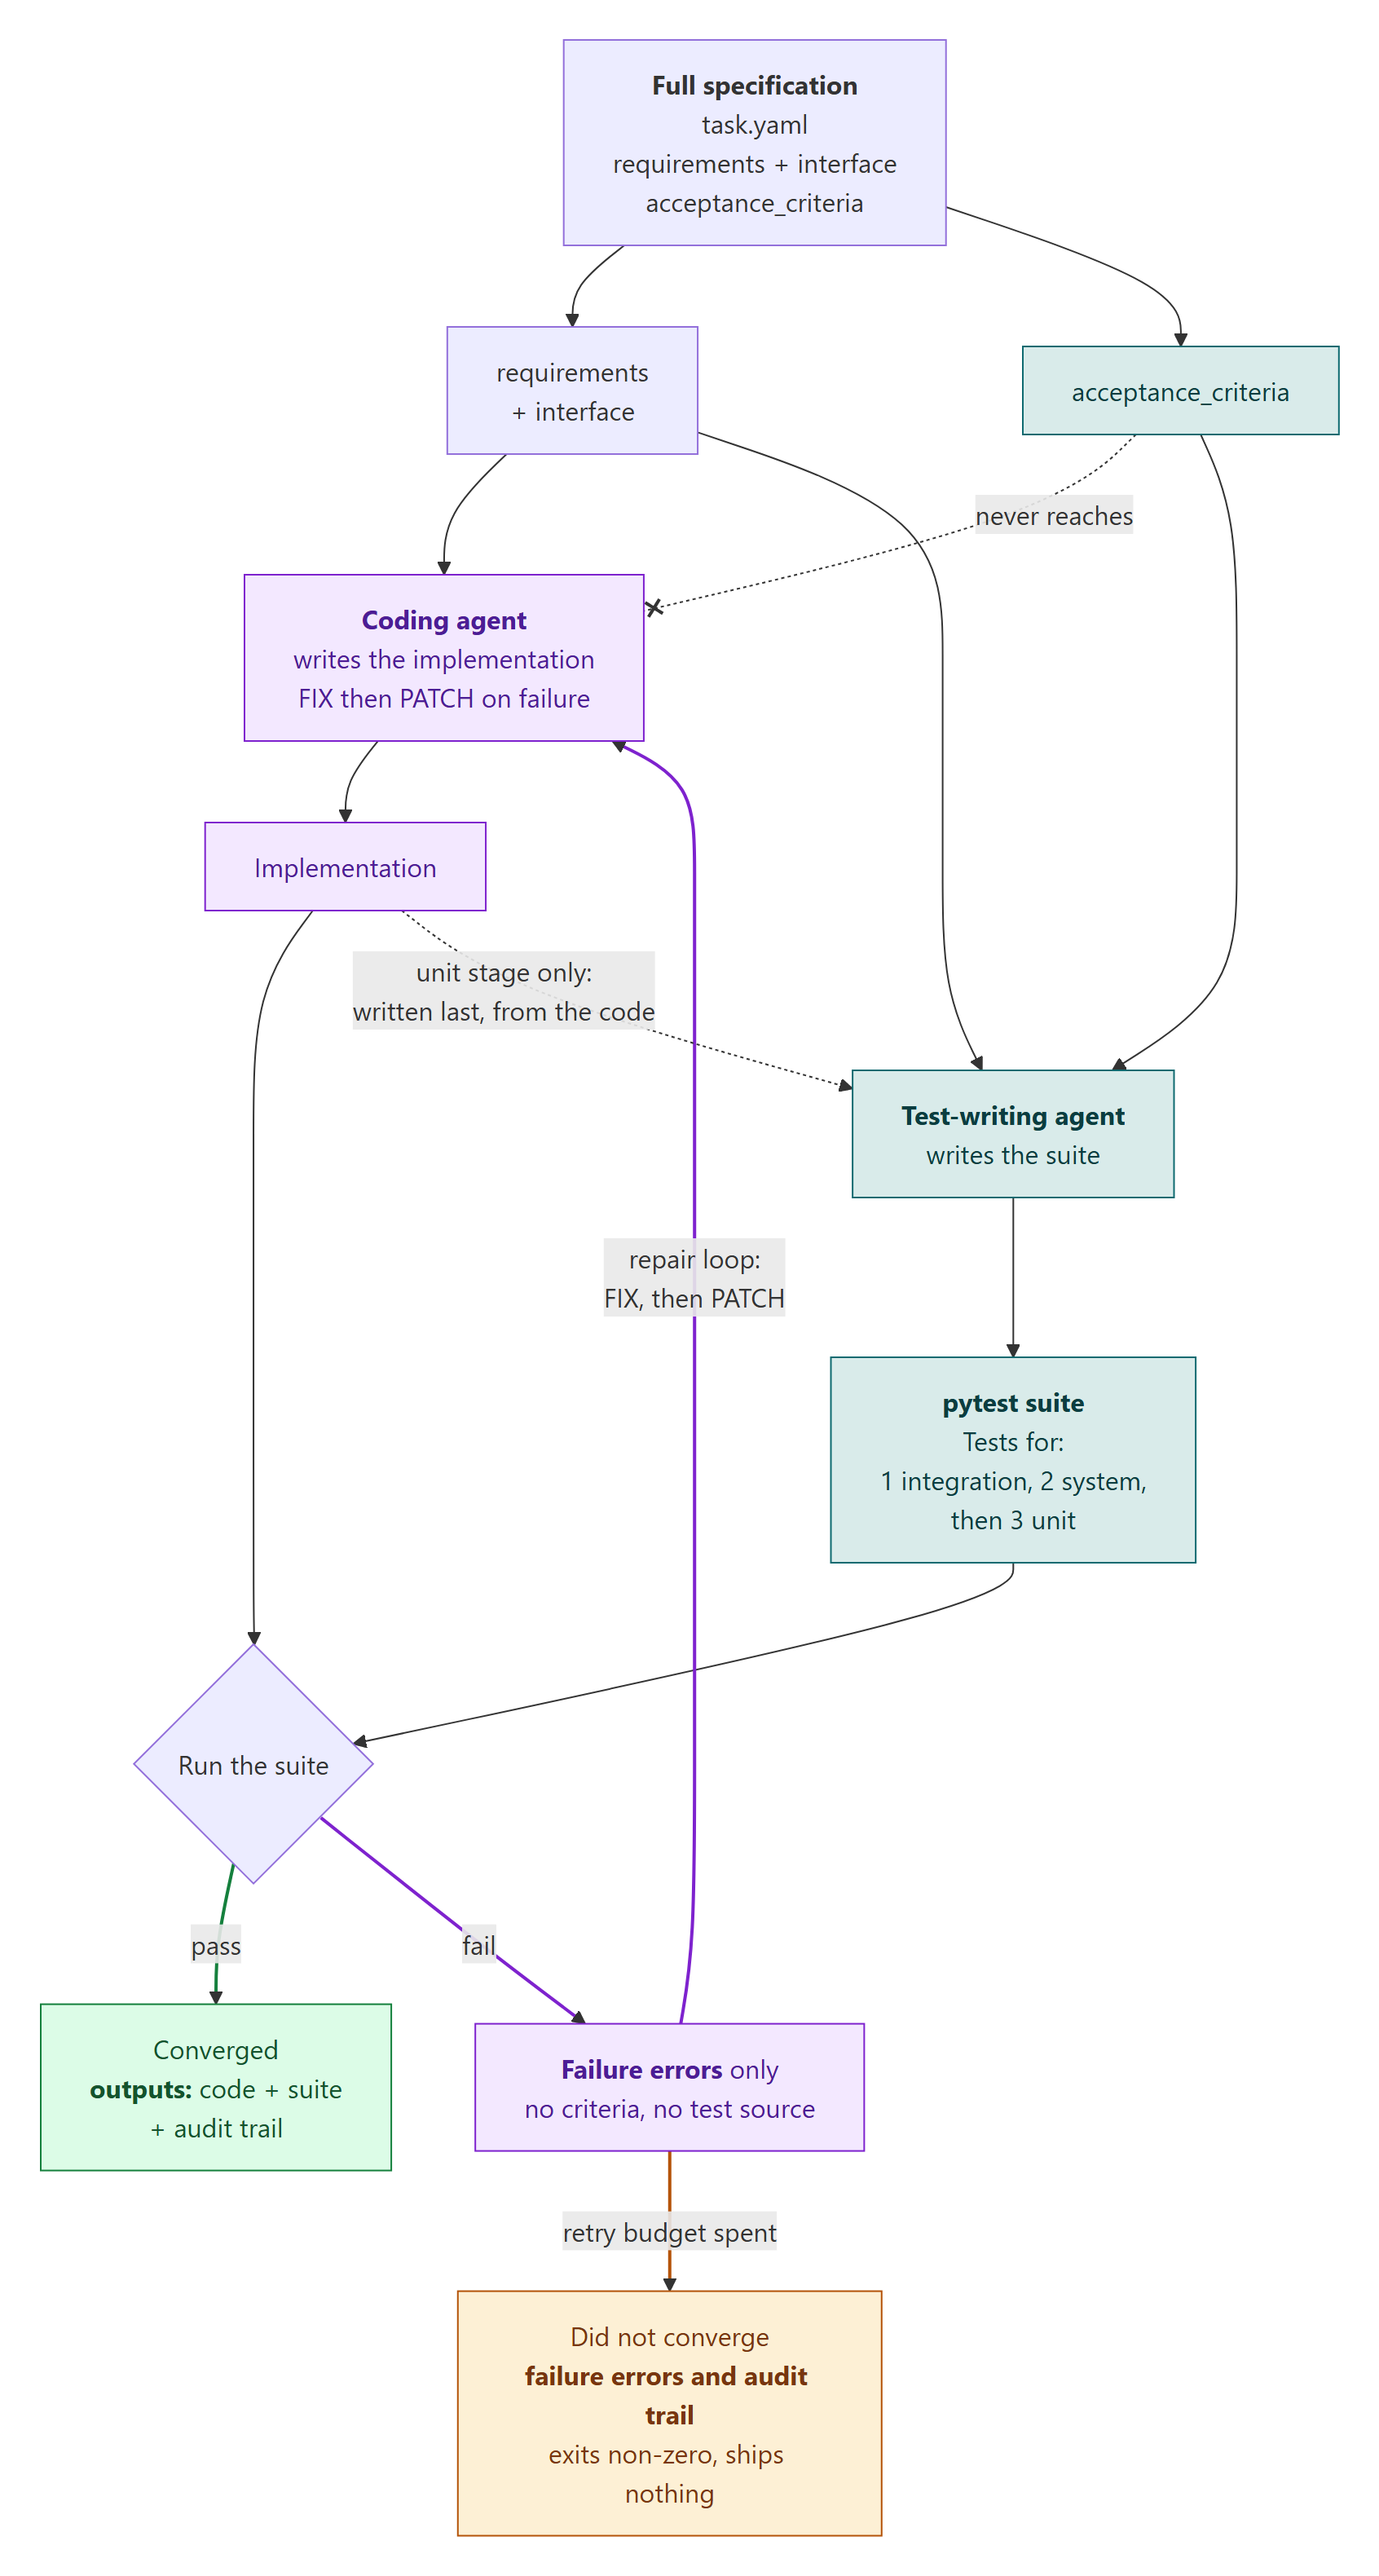
**让结果有意义的关键:**编码 Agent 永远看不到
acceptance_criteria。它拿到的是删去了该部分的规格,也就是开发者通常面对的那种含糊需求;而生成测试时则会看到完整内容。测试失败时,Agent 只能看到该测试的 pytest 输出,永远看不到验收标准。如果没有这种信息不对称,双方读取的规格完全相同,所有测试都会一次通过,这证明不了任何事。
**紫色表示编码 Agent 能看到的内容。青绿色表示编写标准时依据的内容。**两者绝不会交叉。即使运行始终未能收敛,也仍然有价值:它会以非零状态退出,列出阻塞测试,并保留同样完整的记录。紫色箭头表示修复循环,运行的大部分过程都发生在这里:测试套件失败后,只会把失败文本发给 Agent,不附带其他内容;Agent 会生成 FIX 和 PATCH,然后再次运行测试套件,直到该阶段通过或重试预算耗尽。它始终看不到标准本身,因此无法针对交给它的标准来编写代码。
tests/test_withholding.py 会在任何调用位置泄露标准时令构建失败。
一次运行分三个阶段,依次为 integration、system 和 unit:
- 首先生成集成测试和系统测试,仅依据规格,在任何代码产生之前完成。因此它们看不到实现,因为此时还不存在实现。
- 编码 Agent 编写实现,依据的是删去了验收标准的规格。
- **运行 pytest。**失败时,模型会生成一个 FIX(失败摘要、根本原因、计划以及打算修改的文件),然后生成一个 PATCH(仅包含这些文件的统一差异),并一次性完整应用。重复此过程,直到该阶段通过或预算耗尽。
- 最后生成单元测试,此时已有真实代码可供测试使用。这是唯一允许查看实现的阶段。
- 通过某个阶段后,会重新运行之前的阶段,以免后续修复悄悄破坏已经通过的内容。
每条指向 FIX 的回传箭头都只包含 pytest 错误文本,不包含其他内容,因此传回的是失败测试,而不是它们所依据的规格。单元测试最后生成,因为只有它们需要引用真实函数,所以只有这一阶段可以读取实现。每次成功后重新运行之前的阶段,可以避免后续修复悄悄破坏已经通过的内容。
测试生成过程会看到需求、输入和输出约定,以及完整的每项验收标准。它会依据这些标准编写集成测试、系统测试和单元测试。
编码 Agent 会看到同一份规格,但其中的验收标准部分已被删去,此外还会看到刚刚失败的测试的文本。这就是开发者通常面对的那种含糊需求。
获取测试套件的两种方式,以及它们各自能证明什么
| 基于代码的套件 大多数商业测试生成器,以及 qikly 自己的单元测试 | 基于规范的套件 qikly 的集成测试和系统测试 |
|---|---|
| 编写依据是当前代码 | 编写依据是你写下的验收标准 |
| 你只需提供仓库 | 你需要提供一份说明正确标准的书面声明 |
| 能捕获明天发生的行为变化 | 能捕获今天就存在的错误行为 |
| 无法捕获当前代码有误:今天的 Bug 会变成明天的断言 | 无法捕获任何没人写下来的内容 |
| 适用场景是没人写下意图,而你需要一张安全网 | 适用场景是意图已写在工单、规范页面或 Gherkin 文件中 |
两者都很有用,也分别回答不同的问题。qikly 并非完全属于其中一类:集成测试和系统测试会在任何代码存在之前,根据标准编写;单元测试阶段则会在它们通过后,最后根据代码编写;而 --refine-criteria 会读取已收敛的实现,提出初稿中遗漏的标准。所有这些环节都会有意读取代码,但没有一个能对代码提出质疑。
有何不同
测试来自标准,而非代码。 这是最重要的一点。这个领域里其他所有 AI 测试生成器,都是根据已经存在的实现编写测试,因此只能描述代码已经实现的行为。这能构建出色的回归测试套件,却无法告诉你代码有误。qikly 会在任何实现出现之前,根据验收标准编写集成测试和系统测试套件,因此标准不可能受其评判对象的影响。
信息隔离是一种你可以亲眼查看的机制。 它不是让模型忽略某个部分的提示词,也不是需要有人记住的约定。一条命令就能输出各方获得的内容及其差异,无需联网且免费:
qikly --explain <MY_TASK> # e.g. qikly --explain MERGE_SALES
11 条标准会交给测试生成器。在编码 Agent 看到同一文件之前,其中 12 行会被移除。tests/test_withholding.py 会在任何调用点泄露内容时让构建失败,包括明年由从未读过这段说明的人新增的调用点。这是代码本身的一项属性,检查只需 30 秒。
你得到的是一套可执行且可以长期保留的测试套件。 输出是 pytest 文件和 JUnit XML。你可以阅读、运行并放入 CI;六个月后,如果其中某项测试失败,失败原因也清晰可查,便于讨论。测试套件是一项持久资产,而模型的判断并非如此:判断无法针对明天的提交重新运行。
它不仅能依据标准进行检查,还能帮你编写标准。 --init 和 --scaffold 会将现有代码转成任务,--criteria-from 会从你已经写好的工单中提取标准,--generate-criteria 只根据需求起草一份初步标准,而 --check-criteria 会查找规范中任意两条无法同时满足的陈述,包括彼此矛盾的两条验收标准。
每次运行都可复现,并且会保留完整记录。 每次运行都会记录所用的提供方、模型、设置和版本,并附上每一项失败的测试、每个注明根本原因的 FIX,以及每个 PATCH 的差异。你可以准确查明某行代码为何存在:是哪条断言要求它、模型得出了什么结论,以及它改动了什么。即使运行未能收敛,记录也会保留,而这正是你最需要记录的时候。
“为什么不直接使用两个不同的模型?”
这是大多数人首先会问的问题,而且确实有一点帮助。但它没有触及根本问题,因为两个模型仍然会读取同一套标准,因此也都会按照这些标准编写内容:代码仍然是为了满足即将评判它的标准而构建的,而更换编写者并不会改变他们看到的内容。此外,这只是一种习惯,而非机制,也没有任何东西会检查这两个模型是否始终不同。
顺便说一句,两者配合得很好,因为 qikly 会为每个 Agent 角色选择提供商和模型。你可以既隐去标准,又使用两个模型。
“为什么不直接添加一个审查 Agent?”
这是同一个问题的新版本,也值得认真回答,因为独立验证步骤如今已在主流编码 Agent 中推出:第二个 Agent(通常来自不同的模型系列)会审查第一个 Agent 的产出。
这确实有帮助,但仍然无法解决这里的问题。审查者如果拿到同一份规格说明,就会读到同一套验收标准,也会以相同的方式消解同样的歧义。它能发现从这一上下文中显而易见的错误:前后不一致、明显遗漏的要求、显而易见的 Bug。但它无法发现本工具旨在处理的情况:某一行内容可以有两种解读,而代码和标准都是基于其中一种解读编写的。没有人出错,所以也看不出哪里有错。
问题从来不是没有东西在检查,而是所有检查者都已经看过答案。隐去标准才能让检查成为结构性保障,而不是又一个基于相同上下文得出的意见;而且,这一做法由测试强制执行,不必依赖某人记得一直维持这种安排。
还有第二个区别,而且它会在本次运行结束后持续发挥作用:审查者给出一个结论,而本工具会生成一套你六个月后仍然拥有的 pytest 测试集。
“失败的测试不是会泄露验收标准吗?”
它会泄露一个案例,这是有意为之。测试失败时,编码 Agent 会看到 pytest 输出的相关信息:测试名称、一直到失败行的源码、(如果有)文档字符串,以及断言错误。在案例研究中,它会看到税率为 150 时被接受了,但本不该如此。由于测试的文档字符串通常会转述编写测试时依据的规则,因此应假设测试失败后,其背后的标准实际上就已可见。
对于尚未失败的测试,它只能看到名称,除此之外一无所知。Pytest 会列出收集到的所有测试,因此 Agent 知道存在一个名为 test_tax_exempt_zero_rate 的检查,而且它通过了;但它看不到该测试的主体、文档字符串或断言。
Agent 永远不会收到规范本身。任务在生成提示词之前就会移除验收标准,也不会有任何标准文本进入 FIX 或 PATCH 提示词。
有三类信息会通过失败的测试传递出来,而屏蔽它们的代价各不相同:
| 传递的信息 | 泄露的内容 | 修复是否需要? | 默认设置 |
|---|---|---|---|
| 文档字符串中的文字 | 对标准的转述 | 是 | 显示。 使用 diagnostic_feedback: staged 缩减反馈;它从足以定位故障的最少细节开始,只有在补丁毫无改变时才提供更多信息 |
| 测试名称,包括通过的测试 | 某条规则存在,通常还能看出其主题:test_tax_exempt_zero_rate | 否 | 显示。 要屏蔽它,就需要移除 pytest 的 -v,因为报告所依据的各项测试状态正是由此而来。这是一种权衡,而非免费获得 |
# Criteria: 2 标记 | 该测试对应哪条标准,以及标准共有多少条 | 否 | 屏蔽。 标准的编号不是规则,因此这是唯一一种无需付出代价就能减少泄露的做法。traceability_markers_visible: true 可将其恢复 |
无论如何,这些标记都会保留在磁盘上的测试套件中,因此覆盖率报告以及阅读测试的任何人仍然能看到每项测试对应的标准。
这并不会破坏隔离,因为独立性取决于测试套件的编写方式,而不取决于代码作者之后能收到多少反馈。集成测试套件和系统测试套件会在任何实现出现之前,根据标准生成;编码 Agent 之后学到的任何内容,都无法改变已经写好的测试。即使修复只针对那个可见的失败投机取巧,剩余的测试套件仍会拦住它;每当后续阶段通过,前面的阶段都会重新运行。
这与开发者遇到 CI 变红时的处境相同:他们能看到哪里出错了,却看不到测试计划。在案例研究中,Agent 写出 tax_rate > 100,只是因为测试告诉它 150 不对。如果它一开始就拿到了标准,它就会直接写出上限,而测试通过也就证明不了任何东西。
设计原理,以及 acceptance_criteria 最初从何而来这一更棘手的问题:docs/design_1_case_study.md,三篇文档中的第一篇。
如何使用此项目中的工具
有四种使用方式,快速入门下方的表格说明了每种方式需要使用哪个命令:
-
验证你没有编写的代码。 通过
seed:提供实现,Agent 会根据你的验收标准编写测试套件,而且不会读取该代码。根据与代码相同的上下文生成的测试套件,只是模型在认同自己。可以是一个模块,也可以是整个包:将seed.implementation指向一个目录,该目录会以自身名称复制进来,因此from mypkg.money import to_cents的解析方式与你自己的代码树中相同,其中的每个模块也都可以修复。这一限制值得直说:qikly 无法知道所提供代码的作者看过什么。 隔离是 qikly 执行的运行的属性,而不是你交给它的文件的属性。如果编写这段代码的同一个人或模型在查看标准的情况下编写了代码,这样得到的是独立的测试套件,而不是独立的作者。不过,无论如何,它确实能提供一个并非从代码推导出来的测试套件,而代码推导式生成器完全无法做到这一点。
-
从规范开始。 还没有代码:获取第一个实现及其依据的测试套件,放在
outputs/中,绝不会放进你的源代码树。 -
使用你自己的测试。 为任意阶段提供种子,这个循环就会从生成器变成修复流程。
-
无人值守地运行目录。 任意不收敛的情况都会返回非零退出码,因此调度器或 CI 任务可以运行许多规范并保留报告。
免费命令详解
这三个命令不会调用模型、不需要 API 密钥,也完全免费。--explain 在其他使用方式中;下面会说明它及其相邻的两个命令实际会做什么。
qikly --explain MERGE_SALES   # what each side is shown, and the difference
qikly --validate              # check your task files: YAML, criteria, fixtures
qikly --explain MERGE_SALES --json
qikly --explain MERGE_SALES --html   # the same, as a page to share
最值得先运行的是 --explain。它会打印测试生成收到的验收标准,然后打印编码 Agent 收到的同一份任务文件,最后打印差异:以 MERGE_SALES 为例,全部 11 条验收标准以及它们所属的 acceptance_criteria: 键都会被移除。它使用真实运行时也会调用的同一函数来构建这些字符串,因此展示的是实际机制,而非对机制的描述。
添加 --html 后,还会生成 qikly_explain_MERGE_SALES.html:两个视图并排呈现,并突出显示所有被隐藏的行,整个内容都在一个文件中,不会从任何地方加载内容。你可以将它附在拉取请求中、放进幻灯片,或截屏后发布。
--validate 只会读取你的任务文件:检查文件是否能解析、acceptance_criteria 是否为列表而非一个长字符串、夹具路径是否有效,以及标准是否写明具体值而非形容词。它也可以作为预提交钩子使用,即 qikly-validate,特意作为免费检查提供,而非付费检查。
--demo 效果如何
以下是其他使用方式中的最后一行,完整展示。它需要提供方密钥:
export GEMINI_API_KEY=...     # PowerShell: $env:GEMINI_API_KEY = "..."
qikly --demo
需要 Python 3.10+ 和 GNU patch;在 macOS 上,请先运行 brew install gpatch。
它会在临时的 demo/throwaway_<timestamp>/ 文件夹中端到端运行一个捆绑任务,大约需要 30 秒;不会在该文件夹之外写入任何内容,并且需要你之后删除该文件夹,而不是在其中构建。
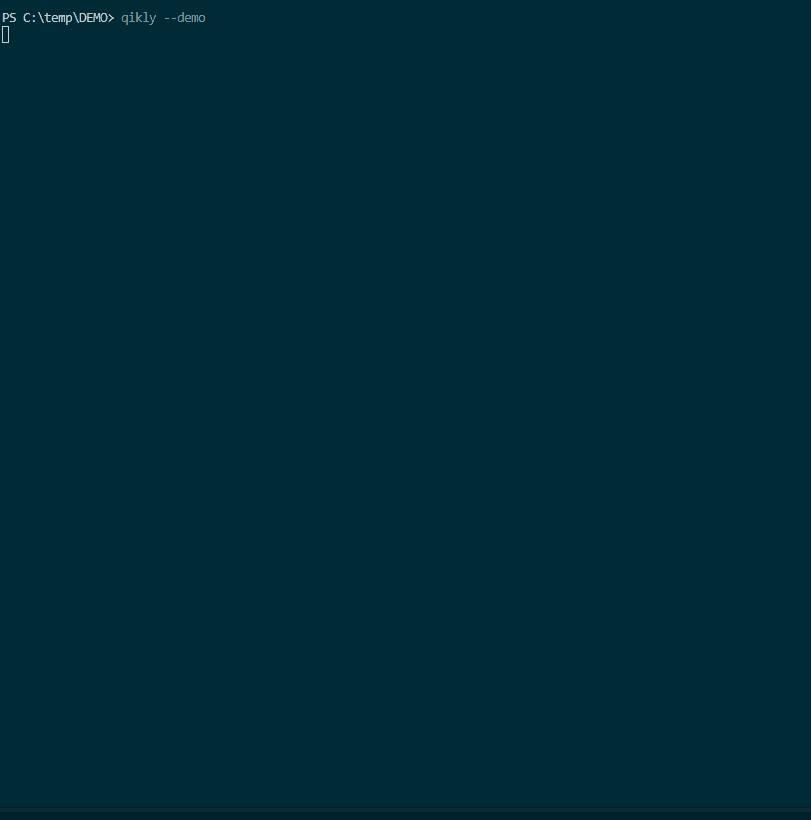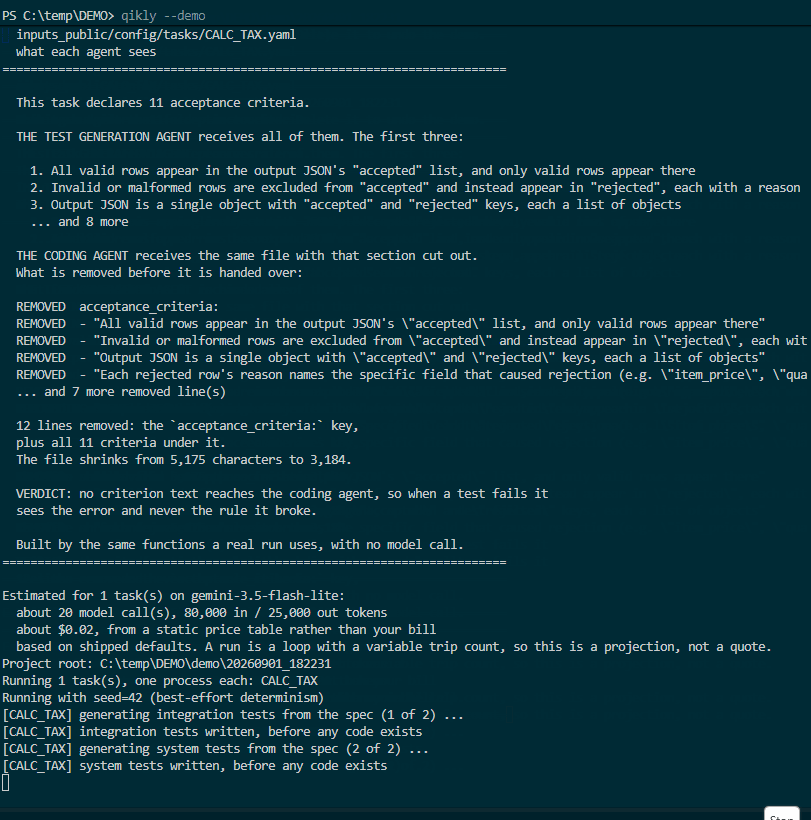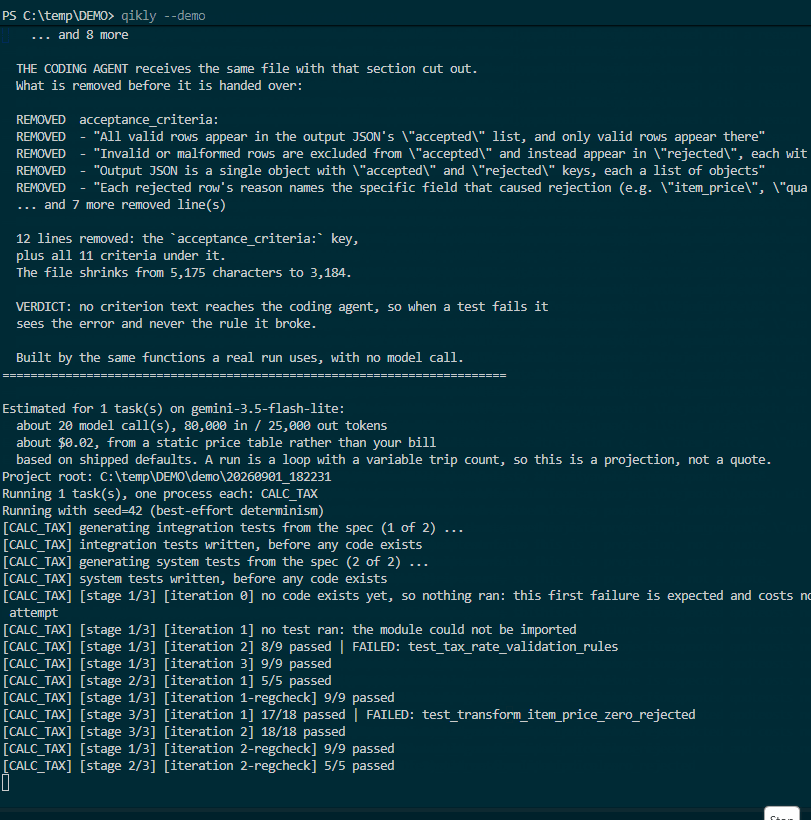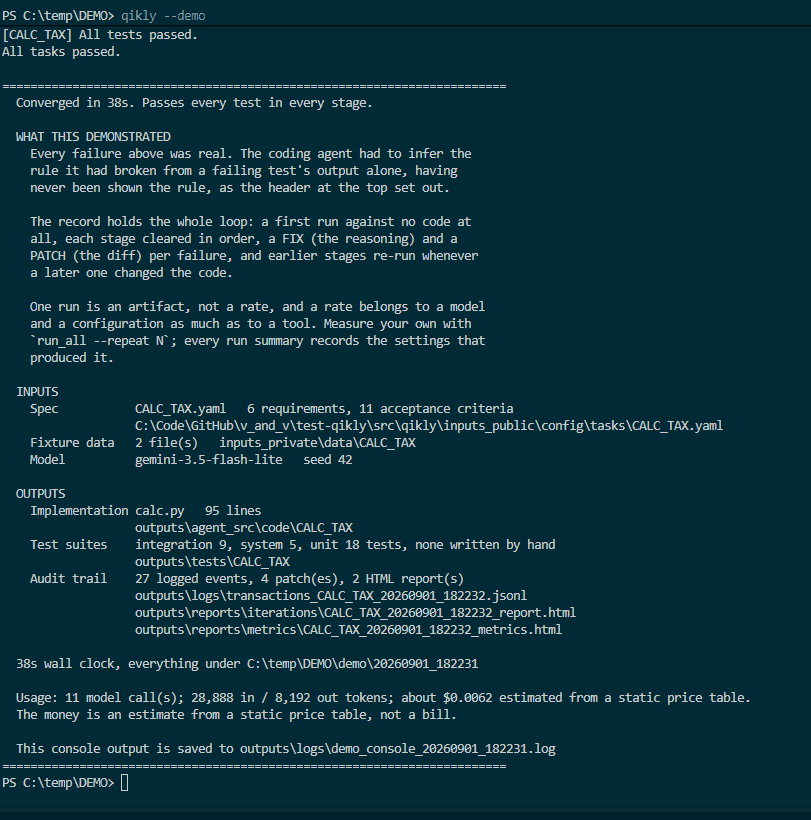
这是在 gemini-3.5-flash-lite 上进行的一次真实运行,用时 38 秒,没有加速。
试过了吗? 告诉我们结果,无论它运行成功、卡住,还是始终没能完成安装。
全部使用你自己的数据
从零开始,而不是基于现有代码:创建两个目录,放入测试数据,编写任务文件,然后运行。不会向软件包或源代码树中写入任何内容。逐字段讲解任务文件的操作指南见 docs/QUICK_START_ON_YOUR_OWN_DATA.md。
qikly --init                    # creates inputs_private/ and a starter task
qikly --tasks MY_TASK
想先看看运行效果,再开始编写?qikly --example 会添加一个可直接运行的完整示例:一个模块、脚手架为它生成的两个任务文件、示例数据,以及已填写好的 requirements 和 acceptance_criteria,每项都放在真实任务会使用的路径下。它是这里唯一会在项目根目录中创建文件的命令:my_metrics.py。完成后,你可以把所有这些文件删掉。--init 和 --example 分别对应哪种起步方式,详见下方的快速入门。
docs/QUICK_START_ON_YOUR_OWN_DATA.md 还介绍了其他内容:逐字段说明任务文件;如何正确区分 requirements 和 acceptance_criteria(一项写决策,另一项写决策带来的结果,两者之间的差距正是整个机制的关键);如何从已有工单中提取验收标准;如何为自己的实现或测试套件填充初始内容;每个文件的读取路径;以及如何在任何测试触及某项验收标准之前,为它建议所需的测试数据行。
两类来自不同来源的测试数据
准备测试数据前,值得先了解这一点,因为它决定了数据必须包含什么:
| 数据行的来源 | 使用这些数据的阶段 | |
|---|---|---|
| 生成的数据 | 编写测试的 Agent 根据你的 acceptance_criteria 编造数据,并直接写入 Python 代码 | 单元测试、集成测试 |
| 你的数据 | 你的测试数据(例如任务 inputs: 列表中指定的 CSV 文件) | 系统测试 |
编写测试的 Agent 看不到你的测试数据。它只会收到任务文件;对于单元测试,还会收到代码,仅此而已。因此,它写出
invalid_prices = ['0', '0.00', '-5.00', 'abc', '']
时,这五个值来自对某项验收标准的解读,而不是来自你文件中的数据行。
最终要验证什么,仍由你的数据决定。 只有系统测试阶段会使用真实文件运行真实流水线。因此,如果没有任何数据行触及某项验收标准,就只会用生成的数据行做简化检查,而不会沿着代码实际执行的路径进行检查。运行结果显示通过,但有一条规则从未经过端到端测试。这就是为什么随附的示例数据会特意包含一些棘手的数据行,也因此提供了一个用于查找差距的命令:
qikly --propose-fixtures --tasks MY_TASK
该命令会报告你的数据中没有任何数据行触及的验收标准,并为每项标准建议一条数据行,同时标明这条建议对应的验收标准。它会生成一个文件供你查看和复制,不会修改你的测试数据:一条数据行是否恰当,只能相对于它所对应的验收标准来判断;如果测试数据随着模型感兴趣的方向不断扩展,就会逐渐偏离你实际处理的数据。
运行
python run.py                            # every task found
python run.py --tasks ETL_ADDRESS        # one
python run.py --tasks ETL_ADDRESS,ETL_EMAIL
python run.py --demo --tasks MERGE_STOCK # isolated, any task
每个任务都在独立进程中并发运行,控制台输出会以
[task_id] 为前缀。如果有任何任务未能完全收敛,退出码就不是 0。
按设计,部分运行会陷入停滞。 大约每 10 次运行中有 8 次,代码能通过 所有集成测试和系统测试;大约每 10 次中有 6 次能通过所有测试,包括单元 测试。两者之间的差距几乎都出在单元测试阶段。
这些都是约数,因为测量进行了三次:一次运行 427 次,16 天后在相同任务和
设置下运行 140 次,以及在修正基准测试本身后运行 400 次;当时发现,10 个
任务中有 8 个的验收标准无法由任何输入行触发。三次测量的结果区间彼此吻合。
三次都使用了 gemini-3.5-flash-lite,这是为了让重复测量的成本可控而选用
的小型低价模型,因此应将这些结果视为下限。三次测量结果一致,比其中任何
一次的精确小数位都更有参考价值,因此不列出小数位。
如果运行耗尽预算,退出码就不是 0,并会列出阻碍它的测试,同时保留完整 记录。它绝不会对自身测试不通过的代码报告成功。
该工具附带 5 个领域的 13 个示例任务,详见 docs/design_3_mechanism.md。
衡量结果,而非只看产出。 单次运行只是一个结果,并不代表成功率:相同 任务使用相同种子,有时会收敛,有时则不会。要了解收敛的频率,请重复运行 并查看区间:
python -m qikly.orchestrator.run_all --repeat 10
这会生成一份汇总报告,其中包含置信区间,并按未收敛运行卡住的原因进行分组。 详情见 docs/design_3_mechanism.md。
运行未能收敛时
运行陷入停滞是正常结果,并不意味着工具损坏:运行会以非 0 退出码结束,列出 阻碍它的测试,保留完整记录,并且不会交付任何内容。
首先应尝试更强的模型;与本文件中的其他设置相比,它对收敛的影响最大,
而且只需设置一个环境变量。接下来按排查顺序:阅读时间线报告,检查是否发生
收集错误(根本没有运行任何内容),用 --trends 排除遗漏的设置,查看是否
重复出现相同补丁(这可能意味着某项标准与模型的先验判断相冲突),然后运行
--check-criteria、--validate 和 propose_fixtures。
上述每种情况的特征和修复方法: docs/TROUBLESHOOTING.md。
开始前大家常问的问题,包括在你提交 API 密钥前会运行什么,以及是否有 任何内容会离开你的设备: docs/FAQ.md。
将工具用于现有代码,包括它可能修改哪些模块,以及当缺陷位于不可修改的 模块中时,运行结果会如何说明: docs/EXISTING_CODE_AND_HELPERS.md。
输出
所有内容均按 task_id 命名空间隔离,因此并发运行不会互相冲突:
| 路径 | 内容 |
|---|---|
outputs/agent_src/code/<task_id>/ | 编码 Agent 编写的实现。每次运行开始时都会清空(备份到 old/<timestamp>/ 下)。 |
outputs/tests/<task_id>/{integration,system,unit}/ | 本次运行生成的测试文件。 |
outputs/data/<task_id>/ | 任务的实际输出产物(例如 output.json)。 |
outputs/logs/transactions_<task_id>_<run_timestamp>.jsonl | 追加写入的结构化日志,记录每次测试运行、FIX、PATCH 和应用结果:这是本次运行的事实来源。 |
outputs/logs/patches/<task_id>/<run_timestamp>/<fix_id>.diff | Agent 生成的每个补丁,无论是否应用。 |
outputs/reports/junit/<task_id>_<run_timestamp>.xml | 本次运行的 JUnit XML,每个阶段对应一个 <testsuite>。这是其他系统读取的唯一产物:可将其导入 Xray、qTest 或 TestRail,也可从 CI 发布。各阶段的文件与其并列存放,每个文件都包含该阶段的最终状态。未运行的阶段不会出现,而不会被报告为空通过。 |
outputs/reports/iterations/<task_id>_<stage>_<run_timestamp>.txt | 实时追加的逐次尝试通过/失败摘要(即输出到控制台的内容)。 |
outputs/reports/iterations/<task_id>_<run_timestamp>_report.html | 从这里开始。 本次运行的单页调试时间线。在浏览器中打开。每次调用 run.py 时都会在结束时自动生成(路径会打印到控制台),也可按需运行:python -m qikly.orchestrator.reports.report [--task ID] [--run TIMESTAMP]。提供匹配的指标报告链接;聚焦于过程叙述,不重复列出数字。 |
outputs/reports/metrics/<task_id>_<run_timestamp>_metrics.html | 以数字为先的配套报告:包含 KPI 行(迭代次数、FIX/PATCH 尝试次数、捕获的回归数、应用失败率、运行时长)、各阶段迭代图表,以及 FIX/PATCH 结果明细。提供返回匹配调试时间线的链接。与时间线报告的生成触发条件相同,也可按需运行:python -m qikly.orchestrator.reports.metrics_report [--task ID] [--run TIMESTAMP]。目前仅限单次运行;参见目前的定位。 |
outputs/reports/run_summary/<task_id>_<run_timestamp>.json | 与指标报告相同的数字,以 JSON 而非 HTML 格式保存,以便通过脚本比较不同时间的运行结果。每次调用 run.py 时都会在结束时自动写入,并保留在本地磁盘上。本项目唯一的网络请求是发送到你配置的大模型提供商,以及在未禁用时于启动时检查是否有更新版本(参见版本检查)。 |
outputs/reports/aggregate/aggregate_<timestamp>.{html,json} | 一次汇总多次运行,而非单次运行:关于报告内容及其原因,请参见一次运行所有内容。由 --repeat 写入,也可按需运行:python -m qikly.orchestrator.reports.aggregate_report [--task ID] [--last N]。只读取 run_summary/ 中的 JSON,因此不会调用大模型,可免费重复运行。 |
免费检查:测试未能衡量的内容
数据无法覆盖哪些条件。 现在,qikly --validate 会在某个条件指定的值不在任何输入行中时发出提示,因为无论代码如何运行,该条件对应的测试都会通过:
MY_TASK.yaml: criterion 2 names 0 for gap_m, and no row holds it.
`qikly --propose-fixtures --tasks MY_TASK` drafts the rows it would take.
测试套件未能发现哪些问题。 qikly --score-suite --tasks X 会逐处破坏已收敛的代码,针对每处破坏重新运行测试套件,并列出未被发现的问题。不会修改你的任何内容。请结合上方打印的可达性警告查看评分:如果没有任何数据行触及某项行为,测试套件就无法捕获该行为中的故障。
配置和大模型提供商
默认使用 Gemini;也支持 OpenAI 和 Anthropic。每次运行只能使用一个提供商。
export GEMINI_API_KEY=...
qikly --demo
docs/CONFIGURATION.md 列出了所有
环境变量、settings.yaml 键、超时设置、各提供商实际能提供的确定性程度,以及如何发现 SDK 在你不知情时发生了变化。
关于密钥、PowerShell、CI 和密钥错误时的表现,请参阅:
docs/PROVIDER_KEY_SETUP.md。
在 CI 中使用
已在 GitHub Marketplace 上架,名称为 Qikly Test Generation。
此 Action 会运行一个任务,并保留生成的内容:生成的 pytest 测试套件、 满足该测试套件的代码,以及 CI 仪表板和测试管理工具已经能够读取的 JUnit XML 文件。
- uses: actions/checkout@v5

- id: qikly
  uses: gal-a/qikly@v0
  with:
    task: CALC_TAX
  env:
    GEMINI_API_KEY: ${{ secrets.GEMINI_API_KEY }}
本仓库中有两个可用模板,建议复制到其他位置使用,而不是在此处运行:
qikly-example.yml
按需运行,而
qikly-pr-example.yml
会在拉取请求中评论结果。
配置前,有三件事值得了解。
默认情况下,它不会让构建失败。 运行未能收敛是正常结果,并不意味着流水线损坏;如果一个工具首次使用就让某人的主分支上出现红色 X,它就不会再被关注。想让它执行强制检查而非仅报告结果时,请设置
fail-on-stall: true。
每次触发都会产生费用。 两个模板都特意使用了 workflow_dispatch。了解每次运行的成本后,再改为
on: pull_request;并使用 paths: 将其限定为任务文件,避免无关提交也触发付费运行。
两种固定版本的方式,任你选择。 @v0 是一个会移动的别名,本项目会在每次发布时将其指向新版本,因此你能收到修复,而不会遇到破坏性变更。@v0.6.1 则是永不变动的精确固定版本,因此你的环境不会发生变化,但你也不会收到任何更新。模板使用 @v0,因为大多数人都希望获得修复;如果你的政策要求固定版本,请使用精确版本形式。
版本检查
启动时,CLI 会向 pypi.org 发出一次请求;如果有更新版本,就打印一行提示。设置 QIKLY_NO_VERSION_CHECK=1 可关闭此功能。
此检查绝不会改变运行结果:所有失败路径都会静默处理,超时时间为 1.5 秒,每次调用只检查一次,而不是每个任务都检查一次;它只读取你在安装软件时本就会依赖的公开 PyPI 和 GitHub 发布索引。
功能
分为三部分,因为把性质各异的内容混在一个列表里并不合适: 无论你输入什么,循环都会保证什么;你需要输入什么;以及最终会得到什么。
循环会自动完成的工作
| 工作内容 | |
|---|---|
| 隐藏验收标准 | 编码 Agent 永远不会收到这些标准。此机制由 tests/test_withholding.py 强制执行,而非通过指令实现 |
| 分阶段生成测试 | 依次进行集成测试、系统测试和单元测试。集成测试和系统测试会在任何实现代码出现之前编写,因此无法根据实现代码调整 |
| 回归复查 | 每次后续修复后,都会重新运行所有已通过的阶段,以免修复悄然破坏较早阶段 |
| 文件内检索 | 对于超过约 16k 个字符的模块,会完整提取故障报告中提到的定义,并为其他所有内容提供一行签名。此过程确定性强、基于 AST,不需要索引,也不需要额外调用模型 |
| 预置输入 | 可以提供自己的实现或任意测试阶段内容,而不是生成这些内容 |
| 独立性证据 | 对于你提供的代码,会通过 git 检查验收标准是否在实现代码的首次提交之前就已确定,并打印检查结果及其证明范围,因为一次运行无法强制执行它未参与实现的隔离措施 |
| 任意提供商 | 可按 Agent 角色选择 Gemini、OpenAI 或 Anthropic |
| 并发任务 | 每项任务都在独立进程中运行,输出以 [task_id] 为前缀 |
| 运行溯源信息 | 每份摘要都会记录模型、提供商、日期和生成设置,因为收敛率不仅取决于工具,也取决于配置 |
| 审批关卡 | --review-patches 会打印每个差异并等待输入 y/N;--dry-run 会生成所有补丁,但不应用任何补丁 |
命令
| 功能 | |
|---|---|
| 显示差异 | --explain TASK 会打印各方获得的内容及其差异。不调用模型,也不需要 API 密钥 |
| 离线验证 | --validate 免费检查任务文件:YAML 是否有效、标准是否为列表、固定数据路径是否可解析,以及标准是否命名具体值而非形容词 |
| 根据代码生成脚手架 | --scaffold FILE 读取现有模块,并编写一个用于测试该代码的任务;或者使用 --fresh,编写一个针对相同接口、可生成全新实现的任务 |
| 起草标准 | --generate-criteria 仅根据需求,为尚无标准的任务起草一版初步标准 |
| 将起草的标准与你的标准比较 | --compare-criteria TASK 仅根据你的需求起草标准,然后报告生成的标准遗漏了哪些内容,并将你的标准视为事实依据 |
| 检查矛盾 | --check-criteria 会检查是否存在某种实现,能够同时满足描述、需求和标准,以及这些标准彼此是否一致;此检查会在消耗阶段预算前进行 |
| 从工单导入标准 | --criteria-from FILE 从你粘贴到文件中的工单提取项目符号列表、“Acceptance Criteria”部分或 Gherkin 场景 |
| 导入 Jira | --criteria-from-jira PROJ-412 通过与文件导入器相同的解析器,从指定字段或问题描述中读取标准 |
| 一条命令同时处理文档和代码 | --scaffold module.py --from-doc feature.md 根据文档中的标准和模块中的接口编写任务文件。requirements 会特意留给你填写:编码 Agent 会读取它,而功能页面通常已在标准上方的正文中重述了自身标准。 |
| 固定数据建议 | 另一个 Agent 会指出哪些标准无法由任何输入行触发,并建议能触发它们的最小数据行。它绝不会修改你的数据 |
| 收敛趋势 | --trends 根据磁盘上已有的汇总结果,显示各任务随时间变化的通过率,并标记模型或设置发生变更的时段 |
| 修改提示词有帮助吗? | --compare-prompts TASK 按生成结果的提示词对该任务的运行进行分组,并打印两组结果。免费,读取磁盘上已有的数据。--repeats N 会先交替运行两组各 N 次。仅显示计数和范围;如果两组样本太少、无法得出有意义的结论,则不会进行比较 |
| 机器可读输出 | 在 --explain 和 --validate 中使用 --json |
你可以保留的内容
| 功能 | |
|---|---|
| 可执行输出 | 普通的 pytest 文件,你可以长期保留、阅读,并在运行结束后放入 CI |
| JUnit XML | outputs/reports/junit/<task>_<timestamp>.xml,Xray、qTest、TestRail、Jenkins、GitLab 和 GitHub Actions 均可读取此格式 |
| 完整审计记录 | 追加写入的日志记录每次测试运行、FIX、PATCH 和应用结果,另有 HTML 时间线和指标报告 |
| 成本预测 | 运行开始前打印;如果有历史数据,则基于你自己的历史记录,并标注为预测而非价格 |
| PR 评论 | --pr-comment 会将最新运行结果渲染为 Markdown;模板工作流会就地更新一条评论,而不是不断添加新评论 |
| Pre-commit 钩子 | qikly-validate,这项免费检查可确保钩子不会因为你输入 git commit 而向你收费 |
| GitHub Action | gal-a/[email protected],用于上传测试套件、代码和 JUnit XML |
当前适用范围
直白地说,因为适用范围比功能列表更重要。
它面向自包含的 Python 模块。 PATCH 提示词只会加载 FIX 指定的文件。超过约 16,000 个字符的文件不会再整体加载:系统会解析文件,完整重现 FIX 和失败测试所涉及的定义,其余内容则压缩为单行签名,并标记省略的范围,以确保差异仍能应用。可通过 QIKLY_MAX_FILE_CHARS 提高阈值。这并不意味着它具备仓库级能力:它没有跨文件索引,而且摘录只能缩减内容,不能限定内容大小。一个包含四百个函数的模块仍会生成四百行签名,因此 57k 个字符会缩减到 30k,虽然更小,但仍然很大。检索采用查找而非相似度搜索,因为 FIX 和失败测试已经指出了相关符号。
必须使用 GNU patch,不能使用任意一种 patch。Apple 和 BSD 附带的实现会拒绝 --fuzz,而该参数能让行号略有错误的差异仍然应用成功。现在,qikly 会在找到这类实现时提示你,而不是把它当作普通的补丁块失败;否则本轮中剩余的每次尝试都会重新生成永远无法应用的差异。
默认情况下,补丁会直接应用,无需询问。 补丁会应用到一次性目录树 outputs/agent_src/code/ 中,并生成带时间戳的备份,绝不会修改你的工作副本;而停下来询问的无人值守循环就不再是无人值守了。--review-patches 会让人工参与其中,--dry-run 则会生成所有补丁,但不应用任何补丁。被拒绝的补丁会保留并记录,因为拒绝本身就是任何测试都无法产生的证据。
预算耗尽是正常结果,不是罕见的边缘情况。 如果一次运行无法通过自身的测试套件,就会以非零状态码退出,指出阻塞测试,并且不交付任何内容。这才是值得具备的特性。四种原因中有三种是规范的问题,而非模型的问题,因此大多数停滞都可以通过编辑文本来修复:请参阅停滞分类。
两种停滞特征,含义截然相反。 完全相同的补丁反复出现,说明模型正确地不同意一条人为规则。增加重试预算无济于事:放宽判定标准,或者将决策移到 requirements 中,让 Agent 将其视为既定条件,而不是需要纠正的错误。每次尝试都生成不同的补丁,却始终无法解决同一个测试,则是普通的 bug,仅凭失败文本无法定位;首先可以尝试更强的模型。比较 outputs/logs/patches/<task>/<timestamp>/ 下的连续差异,即可判断是哪一种情况。停滞主要发生在单元测试阶段,而这也是唯一一个编写时能看到代码的阶段。
测试生成可能会漏掉你写下的某条判定标准。 正确的手写判定标准可能没有任何测试对其进行断言,因此编码 Agent 不会被迫满足它。根因是测试生成提示词要求覆盖“判定标准规定必须成立的性质”,但没有要求覆盖每一条判定标准,因此较长的列表会被抽样缩减。对提示词的修复缩小了差距,但没有完全消除差距。请将此视为仍然存在的问题;在你自己的任务中,可通过 --explain 和生成的测试套件来检查。
判定标准细化可以提高门槛,但无法发现新的标准。 审查者会根据实现实际表现作出反馈,因此擅长发现代码已经尝试实现的行为中存在的验证缺口,却无法指出需求从未要求的行为。细化判定标准能在多大程度上提高门槛,目前仍是开放问题。
每次运行只使用一个提供方,目前也没有跨运行趋势报告:指标报告仅涵盖单次运行。
qikly 实际发现的问题示例
具体发现,以及运行了什么、发现了什么、结果并未表明什么:金额按银行家舍入法取整,而标准要求四舍五入;一个无人做出决定的边界情况;一个包含七项测试的套件全部通过,却漏掉了一半预埋故障;以及三分之二无法被任何测试套件发现的预埋故障,因为数据根本没有到达这些故障。
延伸阅读
这两个参考页面适合查阅,而非从头读到尾: 使用自己的数据快速开始 和 配置与提供方。
设计文档分为三个部分,每部分都可以独立阅读。
| 内容 | |
|---|---|
| 1. 案例 | 为什么让 Agent 编写自己的测试,就像是给自己的作业打分;以及一个 CALC_TAX 修复的完整过程:编码 Agent 得到了什么、它未通过的测试、它仅凭失败结果得出的推理,以及那一行补丁。从这里开始。 |
| 2. 效果如何 | 三轮测试和 967 次运行、期间发现并修正的基准缺陷、单元测试阶段的差距、导致运行停滞的原因,以及本项目测量后又撤回的结果。 |
| 3. 构建方式 | 它与其他方案的区别、五个 Agent 及其各自可读取的内容、FIX 与 PATCH 的分离、十三个示例任务、实时观察运行、提供自己的代码或测试,以及用于生成和评估验收标准的工具。 |
在使用 qikly?展示一下
如果 qikly 为你维护的项目编写了测试,请将徽章添加到项目的 README 中。它会告诉读者,测试套件是由一个与代码隔离的 Agent 根据验收标准编写的:
[](https://test.qikly.com/?ref=badge)
贡献任务
欢迎用户贡献自己的任务。最有用的是新增一个示例任务,涵盖十三个内置任务未涉及的领域,并遵循命名规则,避免与其他任务冲突。CONTRIBUTING.md
说明了任务需要包含什么,以及提交前如何检查。每个获采纳的任务都会在变更日志中注明贡献者,作者还会获得贡献者徽章。请先提交
任务提案,
以免两个人编写相同的任务。
项目缘起
该工具强制实施的隔离,是安全关键工程中的常规做法;在测试的 V&V(验证与确认)方法中,验证工作必须独立于实现。我在通用汽车的自动驾驶汽车项目中从事相关工作,之后构建了这套工具。
由 Gal Arav 构建。
隐私
qikly 在你的机器上运行,不会收集任何信息。你的规范和代码只会发送给你配置的模型提供方,并使用你自己的密钥;唯一的其他网络请求是向两个公共索引检查版本,而
QIKLY_NO_VERSION_CHECK=1 可以关闭此检查。PRIVACY.md。
许可证
Apache License 2.0,详见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。