关于 GroundLens
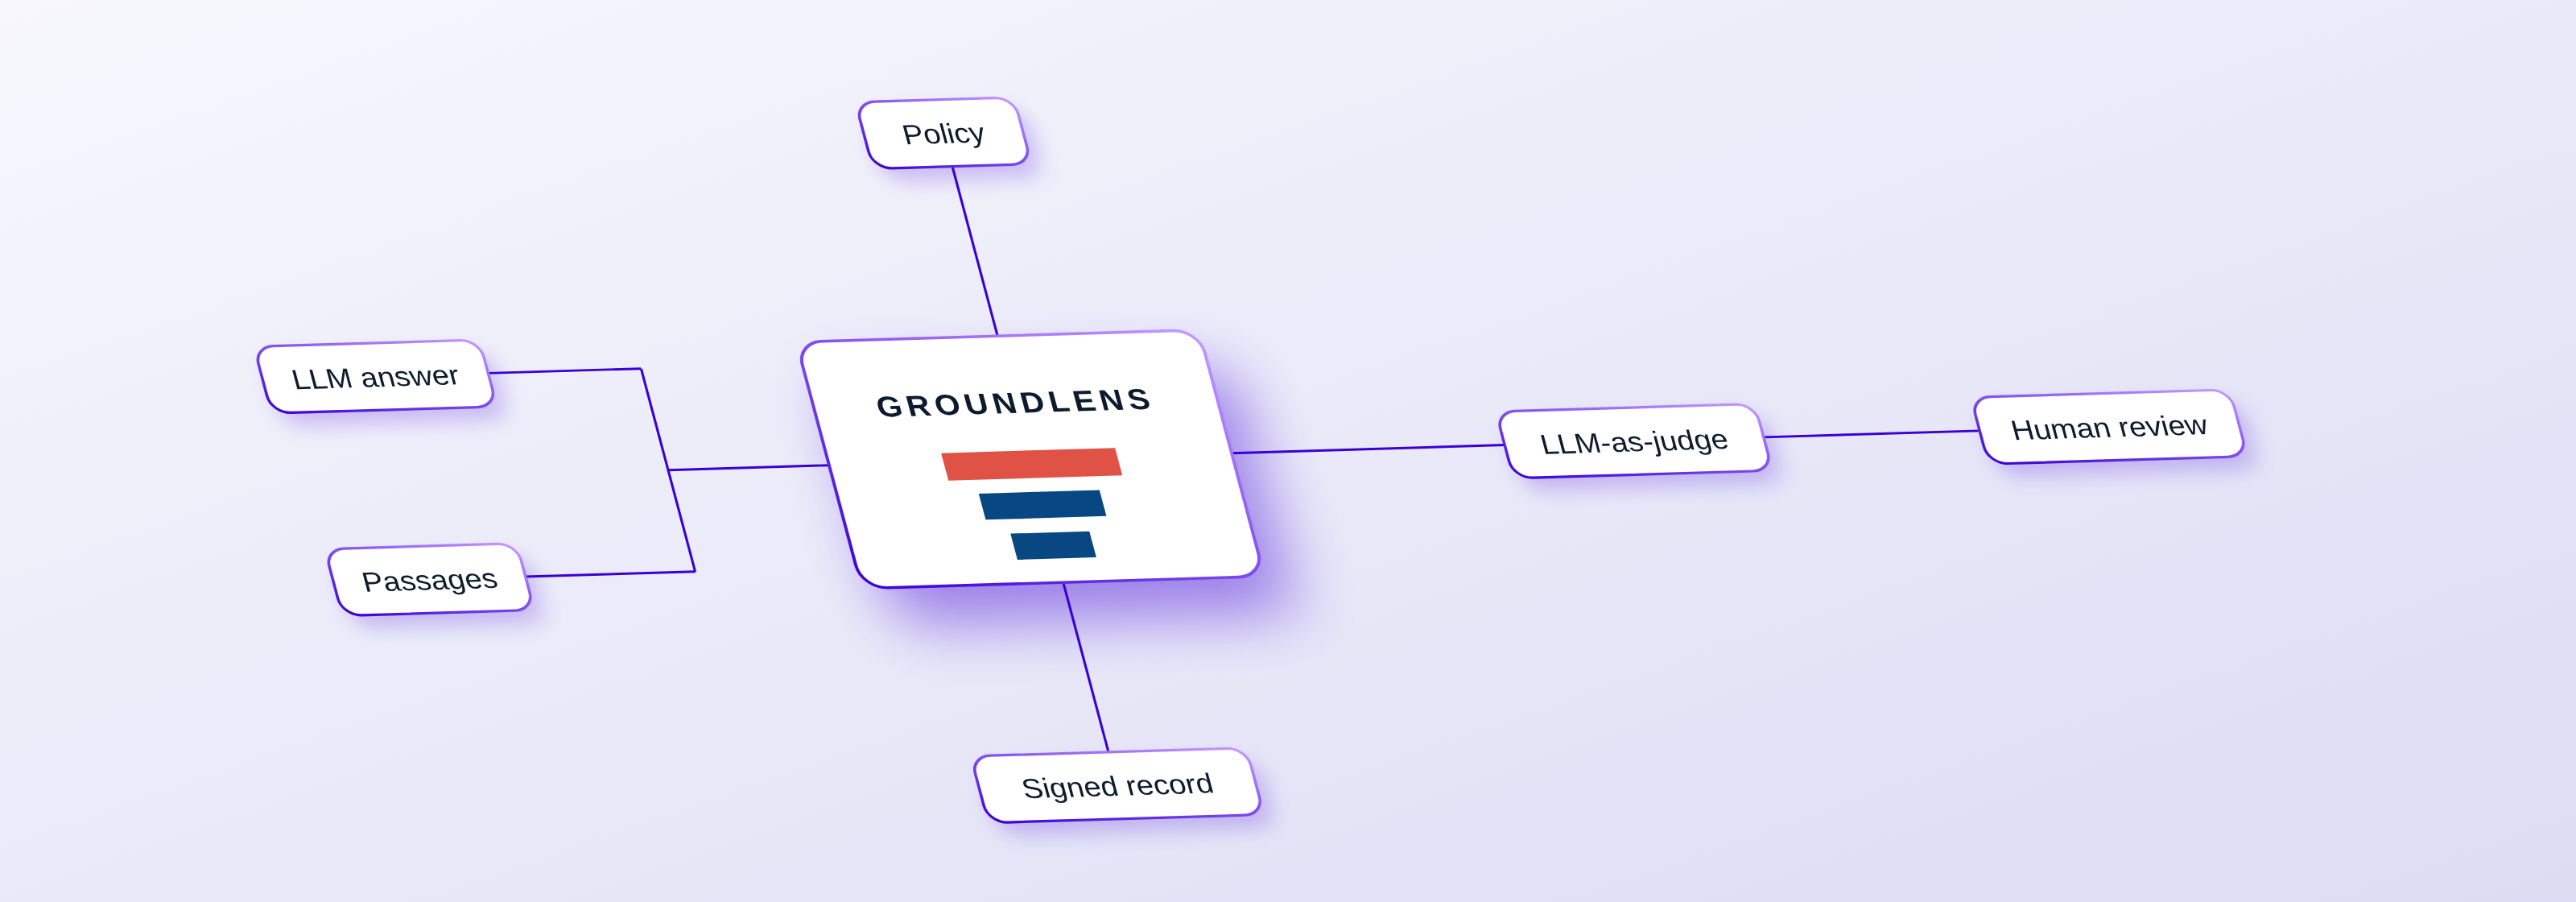
GroundLens 使用确定性检查核对 LLM 答案与来源段落,检查数字、范围和意图,并返回 PASS、REVIEW 或 FAIL。它面向需要审计答案核验过程的团队;每项决定都会先写入签名并串联的记录。
主要功能
- 01对数字、范围和意图进行确定性检查
- 02给出 PASS、REVIEW 或 FAIL 及原因
- 03将签名记录串成只追加的链
- 04可选 LLM 评审器只能升级决定,不能放行
- 05支持 Langfuse 和 OpenTelemetry 可观测性
适用场景
- 01在返回答案前核验基于文档的回答
- 02使用签名记录审计核验决定
- 03在 Langfuse 或 OpenTelemetry 中跟踪检查结果
MCP 相关
GroundLens 通过 stdio 提供三个只读工具:`verify_answer`、`verify_run` 和 `verify_records`。可选的远程 MCP 端点也提供 `verify_answer`。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
LLM 答案的护栏


GroundLens 会根据你的文档检查 AI 答案:
核对数据、数据所指对象,以及答案是否回答了问题。
对于从未见过的财务答案,它拦截了 4 个错误答案中的 3 个;
对于包含数字的公开声明,它拦截了一半缺乏依据的说法。
每次检查约需 10 ms,结果确定,无需 LLM 参与。1
🤔 已经在使用 LLM 评审器了吗?保留它。GroundLens 会先运行精确检查,FAIL 结果绝不会送到评审器。评审器只会看到那些未被精确检查驳回的答案。 | 确定性 | 先进行精确检查,无需 LLM 评审器 |
| 可验证 | PASS、REVIEW 或 FAIL,并附带签名记录 | |
| 可衡量 | 用你自己的答案衡量通过内容的错误率 | |
| 可移植 | Rust 引擎:在所有操作系统上生成相同的哈希 |
兼容




快速开始
# pip install groundlens
import groundlens as gl

verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"))
record = verifier.check(answer="Revenue was €42.1 million.", passages=["Revenue reached €41.2 million."])
print(record.decision, record.reasons)
FAIL ['c2: groundlens.numeric contradicted: €42.1 million not in sources; nearest 41200000 EUR in ctx-0 (relative distance 0.021)']
在本地运行:无需账户、API 密钥、模型或网络。check 返回前,已签名的记录就会写入 records/。
集成
将同一项检查接入你的技术栈:
Langfuse · pip install "groundlens[langfuse]"
from langfuse import get_client
verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"), observers=[gl.integrations.langfuse(get_client())])
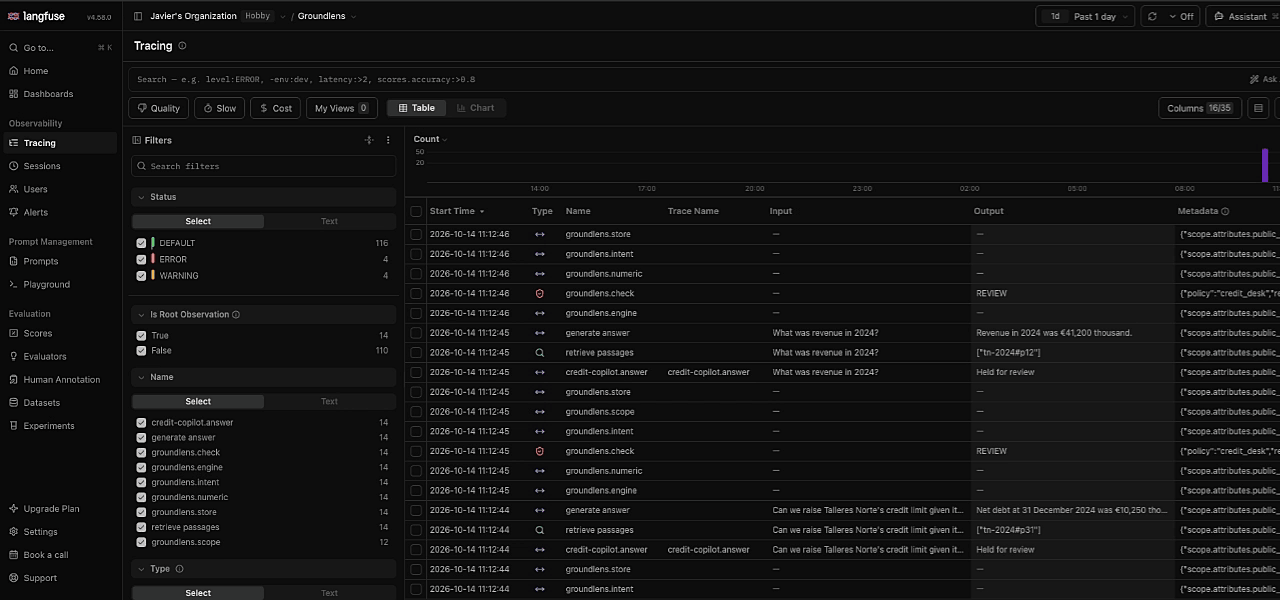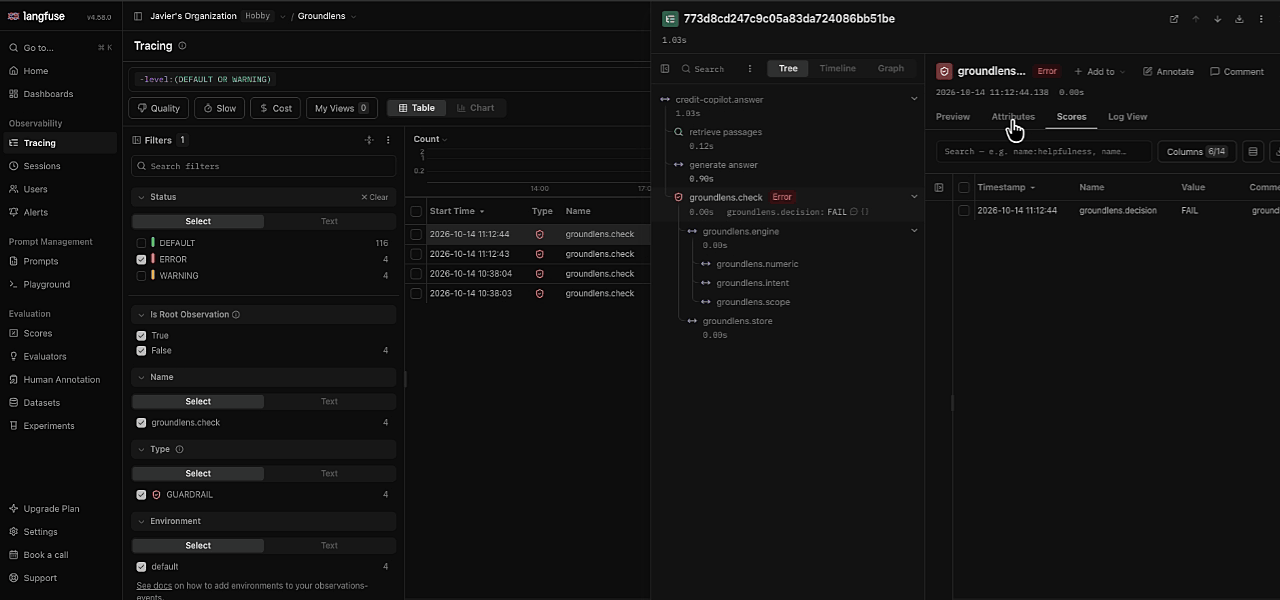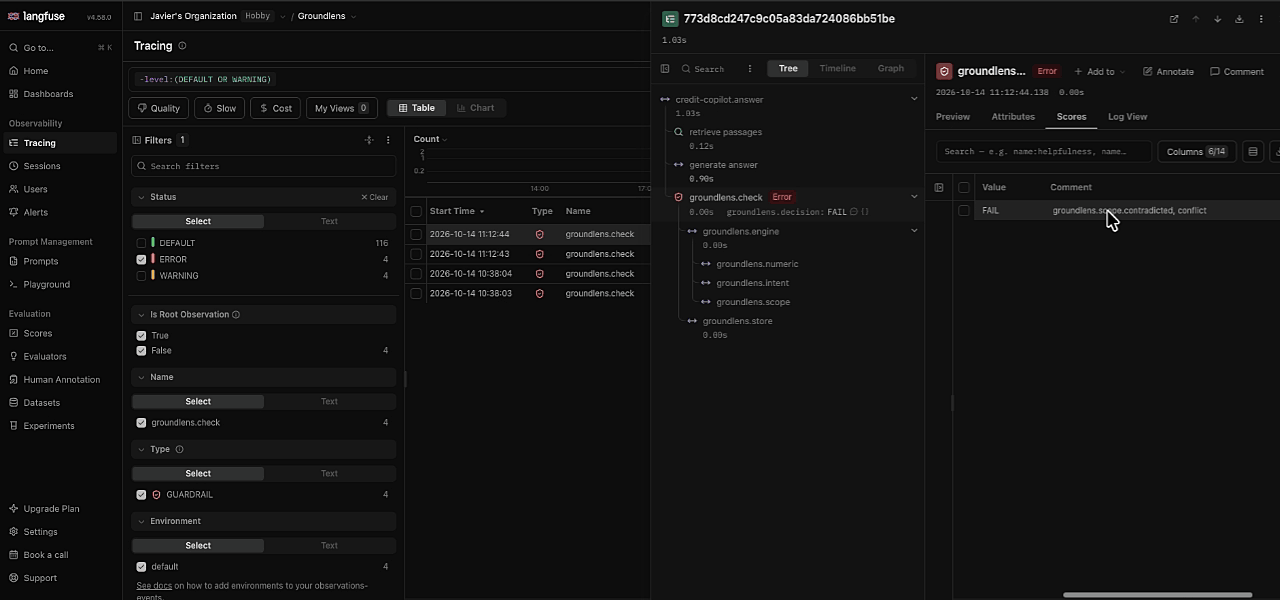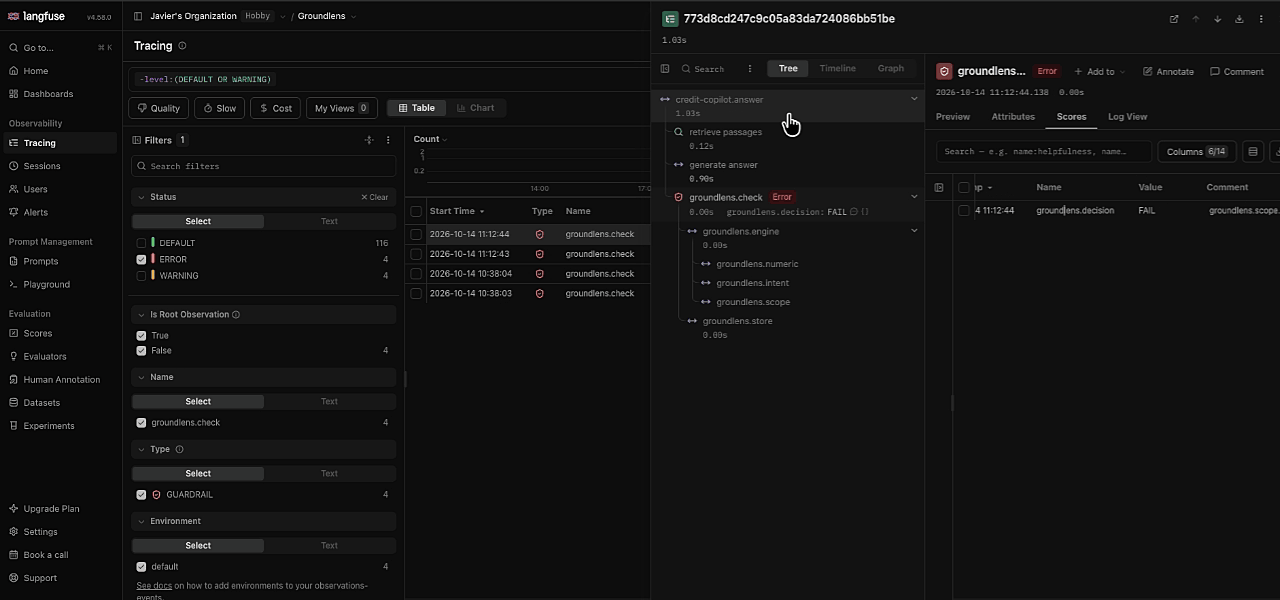
在生成答案的 observation 中调用 check,其 trace 将包含:
- 评分
groundlens.decision: 分类评分,在检查和 trace 上标记为PASS、REVIEW或FAIL。可据此筛选 trace、绘制图表并导出。 - Observation
groundlens.check: 类型为guardrail。原因会显示为其状态消息,每行一条。其级别遵循 Langfuse 自身的等级:PASS为DEFAULT,REVIEW为WARNING,FAIL为ERROR。 - 检查的元数据: 决策、原因代码(
groundlens.scope.contradicted)、策略,以及其背后已签名记录的 ID 和哈希。 - Judge: 一个
generationobservation,包含模型名称,与自身的模型调用并列显示。 - Spans: 每个验证器各一个,另有一个用于 store,每个都记录耗时。Log View 以毫秒显示。
- SDK: 支持 Python v3 和 v4。已在 Langfuse Cloud 和可自托管的 Langfuse 4.58 上测试。
Grafana 和 OpenTelemetry · pip install "groundlens[otel]"
verifier = gl.Verifier(sink=gl.sinks.jsonl("records/"), observers=[gl.integrations.otel()])
Spans 和指标会通过应用已配置的 provider 发送:Tempo、Prometheus 或任何 OpenTelemetry 后端。
-
指标:
groundlens_decisions_total{decision, policy}、groundlens_reasons_total{reason, decision}、groundlens_check_duration_seconds{stage},其中 stage 为total、engine、judge、sign、store。 -
Spans:
groundlens.check,包含groundlens.decision、groundlens.reasons、记录 ID 和哈希;每个验证器、judge(gen_ai.*)和 store 都有对应的子项。 -
仪表板: 图片中的仪表板。
gl.integrations.grafana_dashboard()会返回其 JSON 文件的路径;在 仪表板 → 新建 → 导入 中导入。 -
PromQL,失败答案占比:
sum(rate(groundlens_decisions_total{decision="FAIL"}[15m])) / sum(rate(groundlens_decisions_total[15m])) -
失败率超过 5 % 时告警:
- alert: GroundLensFailRateHigh expr: sum(rate(groundlens_decisions_total{decision="FAIL"}[15m])) / sum(rate(groundlens_decisions_total[15m])) > 0.05 for: 10m -
试用: 运行
docker run -p 3000:3000 -p 4318:4318 grafana/otel-lgtm,然后运行python examples/observability/credit_copilot.py grafana --minutes 5。已在搭配 Tempo 和 Prometheus 的 Grafana 12 上测试。
Claude、Codex、Cursor、VS Code 和其他 MCP 客户端 · uvx --from "groundlens[mcp]" groundlens mcp
助手会在回答前检查自己的草稿。提供三个通过 stdio 使用的只读工具:verify_answer、verify_run、verify_records。需要安装 uv。
-
Claude Code(插件:MCP 服务加上一项技能,告诉 Claude 何时进行检查):
claude plugin marketplace add groundlens-dev/groundlens claude plugin install groundlens@groundlens -
Codex:
codex mcp add groundlens -- uvx --from "groundlens[mcp]" groundlens mcp -
任何 MCP 客户端(Claude Desktop、Windsurf、Zed……):
{ "mcpServers": { "groundlens": { "command": "uvx", "args": ["--from", "groundlens[mcp]", "groundlens", "mcp"] } } }安装软件包后(
pip install "groundlens[mcp]"),只需设置"command": "groundlens-mcp"。 -
无需安装:Hugging Face Space 也是一个远程 MCP 服务,提供
verify_answer,地址为https://groundlens-groundlens.hf.space/gradio_api/mcp/。
OpenClaw · clawhub install groundlens
ClawHub 上的技能,适用于 OpenClaw 的技能注册表。在助手发送包含文档中数据的答案之前,它会对草稿运行 groundlens verify:
- **PASS:**发送答案。
- **FAIL:**根据来源修正数据,然后再次检查。
- **REVIEW:**发送答案,并说明无法确认哪项数据。
在你的机器上运行,无需 API 密钥,也无需第二个模型。此技能位于 plugins/groundlens/skills/groundlens,与 Claude Code 插件使用的是同一技能。OpenClaw 也可以直接使用 MCP 服务,运行 openclaw mcp add 即可。
记录存放位置 · sink=
只有在签名记录存储完成后,check() 才会返回。如果无法存储,check() 会引发异常,不会返回判定结果。每个存储目标都会维护一条链:每条记录都包含前一条记录的哈希值。
| 存储目标 | 需要传入的内容 | 如何保持只追加 |
|---|---|---|
gl.sinks.jsonl("records/") | 目录或 .jsonl 路径 | 每条记录写入一行 JSON,每次写入都会刷新到磁盘并加锁。适用于开发和单机环境 |
gl.sinks.s3_object_lock(boto3.client("s3"), "bucket") | S3 客户端和启用了 Object Lock 的存储桶 | 每条记录写入一个对象,仅当对象不存在时写入;retain_days= 会添加保留日期(默认使用 COMPLIANCE 模式) |
gl.sinks.azure_blob(container_client) | 一个 azure.storage.blob.ContainerClient | 每条记录写入一个 Blob,绝不覆盖;为容器设置基于时间的不可变性策略 |
gl.sinks.postgres(psycopg.connect(...)) | 任意 DB-API 连接 | 每条记录写入一行;如果表不存在则会创建,表的键可防止同一位置被重复写入或链发生分叉 |
import boto3
verifier = gl.Verifier(
    signer=gl.signers.aws_kms(boto3.client("kms"), key_id),           # the key never leaves KMS
    sink=gl.sinks.s3_object_lock(boto3.client("s3"), "audit-records", retain_days=3650),
)
多个进程:为每个进程分配自己的链(chain="worker-3"),然后使用 groundlens record verify 一起验证。GroundLens 不依赖这些 SDK:传入你已有的客户端即可。Postgres、S3 Object Lock、AWS KMS、Azure Blob 和 PKCS#11 会在 CI 中针对真实软件(Postgres、MinIO、LocalStack、Azurite、SoftHSM)进行测试;Azure Key Vault 没有模拟器,仍属实验性功能。
## LLM-as-a-judge
精确检查可以发现数值错误、计算错误、数据来自其他公司,或与问题所问的类型不符。它们无法发现取自正确表格错误行的真实数值,也无法发现原文段落中从未提及的句子。为此,你需要接入一个能够阅读内容的模型:裁判。GroundLens 不附带模型;你可以传入自己已在使用的客户端。
from openai import OpenAI

verifier = gl.Verifier(
    "credit_desk.yaml",                                       # a policy that allows a judge, below
    judge=gl.judges.openai_compatible(OpenAI(), "gpt-4.1"),
    sink=gl.sinks.jsonl("records/"),
)
| 适配器 | 客户端 |
|---|---|
gl.judges.openai_compatible(client, model) | openai.OpenAI,或任何使用相同 API 的服务端:vLLM、Ollama、你的网关(base_url=) |
gl.judges.azure_openai(client, deployment) | openai.AzureOpenAI |
gl.judges.bedrock(client, model_id) | boto3.client("bedrock-runtime") |
随附的策略禁止使用裁判,因此使用裁判的策略会明确说明:
id: credit_desk
version: 1.0.0
extends: eu_ai_act_high_risk_v1
verifiers:
  forbidden: []          # allow llm_judge.*
judge:
  required: true         # no judge, or a judge that fails: REVIEW
  contradicted: REVIEW   # or FAIL
  unsupported: REVIEW
裁判可以升级处理,绝不会直接通过。 它会将每个句子标记为 supported、unsupported、contradicted 或 uncertain。仅凭 supported 不会得出任何结论,因此,即使裁判判断错误,或被段落内容诱导而表示赞同,也无法让未通过精确检查的答案蒙混过关。超时、出错或回复格式错误都会导致 REVIEW。
你可以准确看到它收到的内容。 每个答案只会发送一条提示词,采用固定模板(groundlens.judge/1):对你而言 PASS 的含义、范围、问题、答案,以及每个带来源信息的段落。段落之间由它们无法包含的标记隔开,因此段落中的文本是数据,而非指令。groundlens judge show-template 会在发送任何内容前,打印出完整提示词。
记录会保留完整追踪信息。 记录包括模板 ID、提示词哈希、服务提供方声称作出回复的模型及回复哈希,以及每个句子的标记、引用的段落和一句话理由。在 Langfuse 中,裁判会显示为一个 generation,与你自己的模型调用并列。
架构
GroundLens 将验证拆分为五个互不混杂的部分:声明、验证器、证据、策略和记录。
- 答案会被拆分为声明:每个数值和每个句子,并记录其字符偏移量。
- 验证器会对照段落检查每项声明,并返回证据(
supported、contradicted、unsupported),而非判定结果。随附的验证器都采用精确检查:数值(精确分数、地区格式、单位、重新计算的总和与比率)、范围、意图,以及你的规则。如果你接入了裁判,它就是你已在使用的模型,并通过固定模板向其提问。 - 证据图会保留每个验证器对每项声明给出的结论,以及它们存在分歧之处。
- 策略是由你维护的 YAML 文件,会将证据转化为决定:
PASS、REVIEW或FAIL,并附上理由。 - 记录包含输入哈希、证据、策略哈希和决定,并与上一条记录链式关联且经过签名。记录会在
check返回前存储;之后才会通知观察者。
引擎使用 Rust 编写,并以 Python wheel 形式发布(abi3,Python 3.10+),另附可在不使用 Python 的情况下检查记录的独立 glv 二进制文件。它在你的进程中运行:无需服务端、网络或运行时依赖。使用 Rust 时,运行 cargo add groundlens;安装二进制文件时,运行 cargo install groundlens-cli。
## 参数
Verifier 的参数 | 选项 |
|---|---|
policy | groundlens_default_v1(默认)、eu_ai_act_high_risk_v1 或你自己的 YAML,后者可以通过 extends 继承任一策略 |
signer | local_key(开发用)、aws_kms、azure_key_vault、pkcs11 |
sink | jsonl、s3_object_lock、azure_blob、postgres |
judge | openai_compatible(OpenAI、vLLM、Ollama…)、azure_openai、bedrock;可选 |
observers | integrations.langfuse、integrations.otel 或你自己的选项 |
locale、rounding | 数字的读取和比较方式 |
check 的参数 | |
|---|---|
answer、passages | 必填;passages 可为字符串或 (id, text, provenance) |
question | 启用意图检查:答案给出所询问的类别和单位 |
scope | 请求所涉及的对象({"entity": "ACME"}):来自其他对象的数值会判定失败 |
risk_class | 一种策略可将其送交人工审核,不受检查结果影响的类别 |
策略
检查会生成证据。策略决定这些证据对你意味着什么:哪些情况会失败、哪些情况会交由人工处理,以及 PASS 允许什么。它是一个简短的 YAML 文件,由你负责维护版本,并与代码一同管理。同一个答案在两种策略下可能得到不同的决定,而且两种决定都正确;这种差异体现了你明确写下的风险偏好。
GroundLens 随附两种策略:
| 策略 | 适用对象 |
|---|---|
groundlens_default_v1(默认) | 任何应用。与来源内容矛盾的数值或超出范围的数值会判定失败;类别或单位不正确的答案会交由审核。不会由模型做出决定。 |
eu_ai_act_high_risk_v1 | 受《欧盟 AI 法案》附件 III 约束的系统。规则相同,并将每个决定映射到第 15(1) 条的准确性、第 14(4)(a) 条的人工监督和第 12(1) 条的记录保存要求。 |
编写自己的策略
扩展随附的策略,只编写不同之处:
id: credit_desk
version: 1.2.0
extends: eu_ai_act_high_risk_v1
pass_means: "may be shown to the analyst as a summary of the filing"
locale: es-ES                     # how the documents write numbers: 1.234,56
rounding: half_even               # how a recomputed figure may round
scope:
  required: [entity]              # every request must name the borrower
  missing_scope: REVIEW           # or FAIL; never PASS
risk_classes:
  default: credit_information
  mandatory_review: [credit_limit_change]   # always seen by a person
verifier = gl.Verifier("policies/credit_desk.yaml")
verifier.check(answer=a, passages=p, scope={"entity": "Talleres Norte"}, risk_class="credit_limit_change")
| 键 | 设置内容 |
|---|---|
extends | 要作为起点的随附策略。映射按键合并,列表会被替换。策略必须设置自己的 id 和 version。 |
pass_means | 用一句话说明 PASS 在你的应用中允许什么。验证器给出的 PASS 不代表可以发布;此项需说明它具体代表什么。 |
locale、rounding | 数值的读取和比较方式:half_up、half_even 或 within_last_digit。在此处设置的值优先于请求中的值。 |
scope | 每个请求都必须携带的键,以及缺少键时的处理方式。 |
risk_classes | 始终交由审核的类别。策略未列出的类别会被视为错误,因此拼写错误不会绕过审核流程。 |
verifiers | 指定哪些检查为 required、recommended、optional、fallback 或 forbidden。 |
decision | 指定哪些验证器可以判定答案失败、哪些会将其送交审核,以及如何处理未解决或相互冲突的声明。 |
judge | 指定是否必须使用评审器,以及评审器的标签可以产生哪些作用。参见 作为评审器的 LLM。 |
regulatory_mapping | 指定每个决定所能证明的控制项和条款,并使用你自己的控制项 ID。 |
未知键会被视为错误,而不会被忽略:拼写错误的规则绝不会被悄悄忽略。
失败不等于 PASS
| 情况 | 决定 |
|---|---|
| 在舍入规则下,某个数值与来源内容矛盾 | FAIL |
| 某个数值仅来自范围外的来源内容 | FAIL |
| 缺少必需的范围键 | REVIEW(若策略如此规定,则为 FAIL) |
| 某个风险类别要求审核 | REVIEW,无论检查结果如何 |
| 检查无法运行,或评审器超时或失败 | REVIEW |
| 无法存储记录 | 抛出异常,且不做出决定 |
最终决定取所有检查结果中最严重的结果。
检查你的策略
groundlens policy lint policies/credit_desk.yaml                # errors before you deploy
groundlens policy show --resolved policies/credit_desk.yaml     # every default filled in
已解析策略的哈希会写入它所作出的每条记录,因此每项决策都可以追溯到产生它的确切规则。
更改策略前,必须先进行评估:
groundlens measure会根据团队成员在不知道判定结果的情况下标注的小样本,估算已通过的答案中错误答案所占的比例,并按风险类别提供 95 % 置信区间以及每项决策的成本。groundlens replay会使用新策略处理过去的流量,并列出可能发生变化的决策。
两份报告均经过签名。完整参考:编写策略。
安全性
GroundLens 位于模型与决策之间,其记录旨在作为证据。这两点都使它成为攻击目标:攻击者可能试图让错误答案通过,或事后篡改记录轨迹。
| 威胁 | 控制措施 |
|---|---|
| 错误答案通过 | 默认路径使用精确检查,不调用模型;错误和超时均为 REVIEW,绝不会是 PASS;未存储记录,就不会作出决策 |
| 段落中隐藏的指令操控判定器 | 段落作为数据放在固定且有版本控制的模板中;判定器只能升级处理级别;进行对抗性测试 |
| 记录被编辑、删除或重新排序 | SHA-256 内容哈希、哈希链和签名;groundlens record verify 仅凭公钥即可离线检查 |
| 签名密钥泄露 | 密钥保存在 AWS KMS、Azure Key Vault 或 PKCS#11 HSM(ECDSA P-256)中;GroundLens 从不持有密钥 |
| 两个写入方分叉哈希链 | 每个存储目标都使用条件写入;竞争失败时会重试,绝不会覆盖 |
| 数据通过验证器外传 | 引擎中没有网络代码(cargo-deny 禁止使用 HTTP 和 TLS crate);只有通过你传入的客户端才能访问其他系统 |
| 恶意输入耗尽解析器资源 | 使用有界数字语法,抵御正则表达式 DoS;对每个解析器进行模糊测试 |
| 发布版本遭到篡改 | CI 依赖项经过固定和哈希校验,提供 SLSA Build Level 3 来源证明,发布的二进制文件经过签名,并使用 OpenSSF Scorecard |
请通过 GitHub 安全公告 私下报告漏洞。请参阅 SECURITY.md。
参与贡献
如果 GroundLens 曾经错误判断了你的某个答案,那么这个案例就是最有价值的贡献。我们也欢迎检查项、连接器和文档方面的贡献;CONTRIBUTING.md 介绍了如何开始。
开源
全部采用 Apache-2.0 许可:引擎、检查项、策略、连接器、命令行和 MCP 服务。任何人都必须能够在不使用我们的软件或获得我们许可的情况下检查验证证据;只有验证器开源,这一点才能实现。
## 联系方式
你可以通过 [email protected] 联系开发者
1. GroundLens 6.0.5,默认策略,不使用裁判。**财务回答:**基于 FinQA 10-K 页面构建的 RAG(e5 嵌入,前 4 个片段)生成的 189 条真实回答,由 Claude Haiku 提供,问题均为开发 GroundLens 时从未使用过的多步问题。每条回答都由大模型(Claude Opus 5.5,claude-opus-5-5)依据固定的书面标准盲评两次;对 3 条意见不一致的回答进行了第三轮评估;在运行 GroundLens 之前,所有标签均已锁定。22 条回答有误(每 9 条中有 1 条):其中 17 条被判为 FAIL 或 REVIEW(77 %,95 % CI 57–90 %)。在 129 条通过的回答中,有 5 条错误(3.9 %,95 % CI 1.7–8.8 %)。代价是:189 条回答中有 60 条(32 %)被判为 FAIL 或 REVIEW,其中包括 110 条正确回答中的 38 条。全新进程中,每次检查的中位耗时为 10.6 ms。**公开声明:**LLM-AggreFact 测试集(来自 11 个数据集的 29,320 组成对的声明与文档,带有人工标签),开发 GroundLens 时从未使用过。在 1,616 条包含数字且缺乏支持的声明中,有 796 条被判为 FAIL 或 REVIEW(49 %,95 % CI 47–52 %);在通过且包含数字的声明中,16.3 % 缺乏支持,而检查前为 25.4 %。不包含数字的声明全部通过:GroundLens 未能发现其中任何错误。每次检查的中位耗时为 4.0 ms。所有结果,包括未能发挥作用的数据集,均见 BENCHMARK.md。
版权所有 Groundlens 2026
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。