关于 lm
Houtini LM 是一个 MCP 服务,可让 Claude 或其他 MCP 客户端将边界清晰的任务交给本地 LLM、OpenAI 模型、LiteLLM 路由或 OpenRouter 等 OpenAI 兼容端点。它面向希望降低令牌成本、并获得第二模型审查代码的开发者。Claude 仍负责规划与判断,并检查返回结果。
主要功能
- 01将样板代码、审查等任务委派给其他模型
- 02源文件不进入 Claude 上下文窗口
- 03支持本地模型、OpenAI、LiteLLM 与 OpenRouter
- 04按模型自动调整输出上限与思考模式
- 05通过 discover 与 list_models 查看端点状态
- 06对 LiteLLM 别名解析真实模型与上下文窗口
适用场景
- 01把代码审查和第二意见交给另一模型
- 02生成测试桩、文档字符串或提交信息
- 03在本地 GPU 上处理私有代码的草稿工作
MCP 相关
Houtini LM 本身是 MCP 服务,向 Claude Code、Claude Desktop 或 Cursor 等 MCP 客户端提供委派任务的工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y @houtini/lmHOUTINI_LM_ENDPOINT_URLBase URL of the OpenAI-compatible API endpoint (e.g. http://localhost:1234, https://openrouter.ai/api). Legacy alias: LM_STUDIO_URL.HOUTINI_LM_API_KEY密钥Bearer token for API authentication (no auth if blank). Legacy aliases: LM_STUDIO_PASSWORD, LM_PASSWORD, OPENROUTER_API_KEY.HOUTINI_LM_MODELModel identifier to use for requests (auto-detected if not set). Legacy alias: LM_STUDIO_MODEL.HOUTINI_LM_PROVIDEROptional provider override: 'openrouter' forces OpenRouter-specific handling (attribution headers, reasoning.exclude, no inference serialisation). Auto-detected from the endpoint URL when possible.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
8收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| seed | integer | 否 | 确定性采样种子——相同的种子和提示词 → 可复现的输出。适用于测试。 |
| stop | string|array | 否 | 停止序列——生成内容中出现该序列时即停止(最多 4 个)。 |
| model | string | 否 | 可选:固定到特定的模型 ID(例如,OpenRouter 上的 "nvidia/nemotron-3-nano-30b-a3b:free",LM Studio 上的 "qwen.qwen3-coder-30b-a3b-instruct")。设置后会覆盖自动路由。适用于模型众多、自动路由选择效果不佳的提供商。 |
| top_k | integer | 否 | 仅从排名前 K 的 Token 中采样(例如 40)。0/省略 = 禁用。 |
| top_p | number | 否 | 核采样,范围为 0–1(例如 0.9)。值越低,输出越聚焦。可替代 temperature。 |
| system | string | 否 | 本地 LLM 的人设。请具体描述:用 "Senior TypeScript dev",而不是 "helpful assistant"。 |
| message | string | 是 | 任务。请明确说明预期的输出格式。提供完整代码/上下文,切勿截断。 |
| max_tokens | number | 否 | 响应 Token 预算。请省略此项——省略时,服务器会检查实时模型的上下文窗口并分配其 25%(例如,128k 上下文模型约为 32,000 个 Token),这适用于几乎所有调用。256/512/1024 之类的小上限会严重限制推理模型(隐藏思考会在可见输出前耗尽预算),因此低于 4,096 的值会被忽略,并应用动态预算。仅在需要提高上限以生成超长输出时设置此项。 |
| json_schema | object | 否 | 强制生成结构化 JSON 输出。提供 JSON Schema 对象后,响应将保证是符合该 Schema 的有效 JSON。示例:{"name":"result","schema":{"type":"object","properties":{"answer":{"type":"string"}},"required":["answer"]}} |
| temperature | number | 否 | 事实/代码任务使用 0.1,分析任务使用 0.3(默认值),创意任务使用 0.7。代码任务请保持在 0.5 以下。 |
| repeat_penalty | number | 否 | 重复惩罚,范围为 0–2(1 = 关闭,约 1.1 为常用值)。 |
| presence_penalty | number | 否 | OpenAI 风格的存在惩罚,范围为 -2 到 2。 |
| frequency_penalty | number | 否 | OpenAI 风格的频率惩罚,范围为 -2 至 2。 |
详细介绍
Houtini LM (@houtini/lm) - 将工作从 Claude Code 分流到本地大模型、OpenAI GPT-5/6、路由器或更便宜的云端模型



Houtini LM 是一个 MCP 服务,可让 Claude(或任何 MCP 客户端)将范围明确的工作交给其他模型处理——例如运行在你 GPU 上的本地大模型、OpenAI 最新的 GPT 模型、LiteLLM 路由器、OpenRouter 或廉价的云端 API——同时你可以继续使用自己喜欢的 AI 平台。它能降低你的令牌费用,还能随时让你用第二个模型审查代码。
快速导航
新内容 | 为何使用 | 安装 | 它如何处理不同的模型 | 哪些工作适合交给它 | 工具 | 阅读页脚 | 配置 | 兼容的端点 | 手册
我开发它,是因为我常常让 Claude Code 在夜间运行大型重构任务,令牌费用高得让人难以承受。这些开销中很大一部分都花在了范围明确的任务上,而任何不错的模型都能轻松胜任——比如生成样板代码、代码审查、提交消息、格式转换,以及那些不需要 Claude 的推理能力或工具访问权限的工作。
因此,Claude 继续担当架构师,负责规划、多文件修改和判断;houtini-lm 则把起草工作交给你正在运行的模型。它可以是你桌下 GPU 主机上的 Qwen、直接来自 OpenAI 的 GPT-5 或 GPT-6、LiteLLM 路由器后面的模型、OpenRouter 提供的 300 多种模型之一,或每百万令牌只需几分钱的 DeepSeek。Claude 会对所有返回结果进行质量检查。
如果你想了解更详细的经过,我写了一篇完整介绍,讲述开发它的原因以及日常使用方式。
3.3 版新内容
如今,houtini-lm 支持的远不止本地 GPU。将它直接指向 OpenAI,无需经过任何路由器即可使用 GPT-5、GPT-6 和 o 系列推理模型。这些模型会拒绝所有开放模型都接受的参数(max_tokens、temperature),因此 houtini-lm 只向它们发送 max_completion_tokens;当端点未报告模型的输出上限时,它会从模型自身的错误信息中获取该上限,并将图像、语音和审核模型排除在列表之外。将它指向 LiteLLM 路由器时,它会读取每个别名背后对应的实际模型,以及该模型真正的上下文窗口和输出上限,因此可以正确配置和分析由本地模型与托管模型组成的混合模型集群。现在由你决定是否启用思考模式(auto、off 或 on);此外,还有一份根据实际部署编写的 Docker 指南,并且手册为每项工作都提供了单独的页面。更新日志中有详细信息。
为什么使用 houtini-lm?
先说结论,再深入介绍:你可以继续使用自己喜欢的 AI 平台,同时不必为那些无需前沿模型的工作支付前沿价格。
最显而易见的好处是省钱。当 Claude 使用 code_task_files 委派代码审查时,houtini-lm 进程会读取源文件并直接将其发送给另一个模型,因此这些文件根本不会进入 Claude 的上下文窗口。Claude 只需发送简短的工具调用,再读取简短的答复。我用真实的 TypeScript 源文件做了基准测试:
| 任务 | Claude 直接读取 | 委派处理 | 节省 |
|---|---|---|---|
| 代码审查(1,352 行) | 14,466 个 token | 769 个 token | 95% |
| 架构审查(2,022 行) | 20,014 个 token | 983 个 token | 95% |
| 外部代码库审查(581 行) | 5,344 个 token | 741 个 token | 86% |
| 代码说明(833 行) | 8,678 个 token | 744 个 token | 91% |
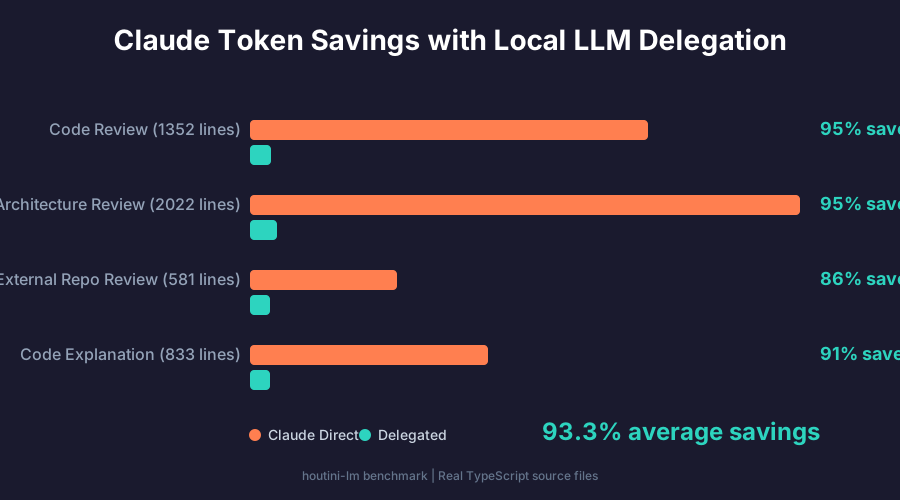
整个会话平均节省 93.3%。公平地说,像问一个单行问题或写一条提交信息这样的小任务,节省并不多,因为工具调用的开销(约 250 个 token)和答复差不多长。任何需要读取文件的任务——这也是实际编码会话中的大多数工作——都能立即抵消这点开销。你可以通过 LM_STUDIO_URL=http://your-server:1234 node scripts/benchmark.mjs,用自己的配置运行相同的基准测试。
不那么显而易见的好处是获得第二种意见。不同的模型会以不同的盲点审视你的代码,而请它帮忙几乎不花什么成本。恰好,这个代码库的 3.3.0 版本就是个不错的例子:我让 Claude 通过我的 LiteLLM 路由器,将这个版本自己的 14,000-token 差异交给 gpt-6-astra 审查。它发现了三个真实 bug——路由器探测把临时的 429 缓存成永久的“不是路由器”、输出上限被覆盖,以及模型列表缓存中的竞态——这三个问题都在版本发布前修复了。三个新增测试文件中有两个也是用同样的方式起草的,然后在提交前由 Claude 审查。
代码审查最能体现这种做法的价值,因为审查正是范围明确、阅读量大而写作量小的工作,较便宜的模型很擅长处理。从这里开始,能做的事情还在不断增加:测试桩、文档字符串、提交信息、变更日志草稿、格式转换、模拟数据、类型定义、RAG 流水线的嵌入向量、快速检查正则表达式、在 Claude 确定方案前构思三种做法,等等。
代价是耗时。本地推理通常比前沿模型慢 3 到 30 倍,因此委派更适合范围明确、自成一体的任务,而不是所有工作。本地模型能保护你的代码隐私,且每个 token 都无需付费;云端模型价格低廉;两者都不会占用你的 Claude 配额或触及其速率限制。
工作原理
Claude Code, Claude Desktop, Cursor... (orchestrator)
   |
   |-- Reasoning, planning, architecture, tool use --> your main AI platform
   |
   +-- Bounded grunt work --> houtini-lm --HTTP/SSE--> any OpenAI-compatible endpoint
       . Code review & second opinions       LM Studio, Ollama, vLLM, SGLang, llama.cpp
       . Test stubs & boilerplate            LiteLLM routers
       . Commit messages & docs              OpenRouter (300+ models)
       . Format conversion & mock data       DeepSeek, Groq, Cerebras, OpenAI...
       . Embeddings for RAG pipelines
Claude 负责规划,另一个模型负责起草,而 Claude 会检查所有返回的内容。
安装
你需要 Node 22.5 或更高版本,以及一个兼容 OpenAI 的端点:LM Studio、Ollama、vLLM、SGLang、LiteLLM 路由器,或 OpenAI、DeepSeek、Groq 等服务的云 API 密钥。在 Claude Code 中,如果 LM Studio 在同一台机器上运行,只需一条命令:
claude mcp add houtini-lm -- npx -y @houtini/lm
就是这么简单。LM Studio 默认监听 localhost:1234,houtini-lm 会优先查找这个地址,因此 Claude 可以立即开始委派任务。若要连接其他地址,请设置 URL(如果端点需要密钥,也请设置密钥):
claude mcp add houtini-lm \
  -e HOUTINI_LM_ENDPOINT_URL=http://192.168.1.50:1234 \
  -e HOUTINI_LM_API_KEY=your-key-if-needed \
  -- npx -y @houtini/lm
OpenAI 的使用方式也相同。请指定你想用的模型,因为 OpenAI 列出了数十个模型,而它们在路由中的评分都一样:
claude mcp add houtini-lm \
  -e HOUTINI_LM_ENDPOINT_URL=https://api.openai.com \
  -e HOUTINI_LM_API_KEY=sk-... \
  -e HOUTINI_LM_MODEL=gpt-5.2 \
  -e HOUTINI_LM_SERIALISE=0 \
  -- npx -y @houtini/lm
安装 houtini-lm 介绍了所有连接方式:另一台机器上的 GPU、OpenAI 和其他云 API、OpenRouter、LiteLLM 路由器、Claude Desktop 和其他 MCP 客户端,还介绍了如何检查是否配置成功以及如何更新。如果你更愿意在容器中运行,在 Docker 中运行 houtini-lm 介绍了普通的 docker run -i 方式,以及如何通过 Docker 的 MCP Gateway 在 HTTP 上提供服务。如果你刚开始接触本地模型,可以从入门指南开始,了解哪些模型适用于 16、32、64、96 或 128 GB 的 VRAM。
要检查所有设置是否就绪,请让 Claude 运行 houtini-lm 的 discover 工具。它会告诉你版本、找到的端点、当前启用的模型,以及上下文窗口的大小。
houtini-lm 如何处理不同模型
开源大模型各不相同。它们在上下文窗口、输出上限、提示词模板、回答前是否会进行思考,以及会报告多少思考内容等方面都存在差异,因此 houtini-lm 的许多代码都用于判断它连接的是哪种模型,并据此进行调整。houtini-lm 如何处理不同模型 中有完整说明,下面是简要介绍。
启动时,houtini-lm 会向你的服务查询它拥有的所有模型,包括已加载和已下载的模型,并在 HuggingFace 上查询每个模型的架构、许可证和聊天模板,再将所有信息缓存到 SQLite 中,让后续启动即刻完成。对于我熟悉的系列(Qwen、Nemotron、Granite、LLaMA、GLM、GPT-OSS、DeepSeek、Gemma、Kimi 和 OpenAI 托管的 GPT 模型),我们提供了精心整理的配置;每个系列都有自己的温度、输出约束和思考块处理方式,而 OpenAI 托管的推理模型(GPT-5/6、o 系列)只会收到它们接受的参数。运行 list_models 即可查看完整信息:
Loaded models (ready to use):

  nvidia/nemotron-3-nano
    type: llm, arch: nemotron_h_moe, quant: Q4_K_M, format: gguf
    context: 200,082 (max 1,048,576), by: nvidia
    Capabilities: tool_use
    NVIDIA Nemotron: compact reasoning model optimised for step-by-step logic
    Best for: analysis tasks, code bug-finding, math/science questions
    HuggingFace: text-generation, 1.7M downloads, MIT licence

Available models (downloaded, not loaded):

  qwen3-coder-30b-a3b-instruct
    type: llm, arch: qwen3moe, quant: BF16, context: 262,144
    Qwen3 Coder: code-specialised model with agentic capabilities
    Best for: code generation, code review, test stubs, refactoring
    HuggingFace: text-generation, 12.9K downloads, Apache-2.0
输出预算取决于每次调用实际使用的模型。如果不设置 max_tokens,调用将使用该模型上下文窗口的 25%,但不会超过其声明的输出上限,也不会超过提示词所占空间之外的剩余容量,因此托管模型不会收到它会拒绝的请求。我们还设有最低值,因为 MCP 客户端经常会传入 256 这样很小的上限,导致推理模型在思考过程中被截断;因此,低于 4,096 的值都会被忽略,除非你将 HOUTINI_LM_MIN_TOKENS=0。
是否启用思考由你通过 HOUTINI_LM_THINKING 决定。默认值 auto 会为检测到支持该开关的模型(Qwen3、Gemma 4、Nemotron、DeepSeek R1、GLM-4、gpt-oss)关闭思考;这种设置适合由 Claude 负责推理、另一个模型负责起草。off 会在每次调用中强制关闭思考;当后端使用了名称检测无法识别的思考模型时,就需要这样设置。on 会强制启用思考,这在排查 Bug 或检查论证时很有用,但会增加耗时和 Token 消耗。无论你选择哪种设置,houtini-lm 都会为思考模型扩大输出预算,并从回答中移除任何 <think> 块,避免推理内容导致回复为空。
有多个可用模型时,houtini-lm 会根据任务类型为每个模型评分,并选择最合适的模型;它只会建议使用更好的模型,而不会自动切换,因为加载模型需要几分钟。模型目录较大时,所有未知模型的评分都相同,因此会选中列表中排在最前面的模型;你可以通过 HOUTINI_LM_MODEL 固定一个模型,或在单次调用中传入 model。
将它指向 LiteLLM 路由器后,它还会读取 /model/info,以识别每个别名背后的真实模型(我的 local 别名对应 qwen3.6-27b),并获取托管模型的真实上下文窗口和输出上限。之后,每个别名都会按照其实际对应的模型进行配置和预算计算;路由器列出的几十种 TTS、图像和视频模型会被过滤掉;遇到速率限制错误时会进行带退避的重试。默认情况下,调用会逐个排队,因为单个 GPU 一次只能处理一个请求;OpenRouter 不使用队列,而对于 OpenAI、路由器或 vLLM 这类批处理后端,你可以通过 HOUTINI_LM_SERIALISE=0 关闭排队。
适合交接的任务
最佳候选任务范围明确、定义清晰,且有清楚的输入和输出:
| 任务 | 为什么适合交给另一个模型 |
|---|---|
| 代码审查 | 粘贴完整源码(或传入路径),请它查找 Bug |
| 对计划征求第二意见 | 不会承诺任何事情,成本几乎为零 |
| 生成测试框架 | 输入源码,输出测试 |
| 解释函数 | 总结不需要访问工具 |
| 起草提交消息 | 输入差异,输出消息 |
| 转换格式 | JSON 转 YAML,snake_case 转 camelCase |
| 生成模拟数据 | 输入架构,输出数据 |
| 编写类型定义 | 输入源码,输出类型 |
| 结构化 JSON 输出 | 受语法约束,生成结果必然有效 |
| 文本嵌入 | 语义搜索、RAG 工作流 |
任何需要跨代码库推理、访问工具或多步编排的任务都留给 Claude:架构决策、读写文件、运行测试并解读结果、多文件重构计划,以及任何需要调用其他工具的事情。工具描述旨在引导 Claude 在大型任务开始时就规划委派,而不是等到它碰巧想起来才使用。
工具
一共有八个工具。完整的参数参考见工具详解。
| 工具 | 用途 |
|---|---|
chat | 主力工具。发送任务,获取答案。 |
custom_prompt | 将系统提示词、上下文和指令分开保存;在本地模型上,这种方式的表现始终胜过把所有内容塞进一条消息。我有个周末用同一批审查任务分别测试了这两种方式,三部分的版本每轮都胜出。 |
code_task | 使用针对代码调优的系统提示词和按模型系列设置的温度进行代码分析。 |
code_task_files | 类似 code_task,但 houtini-lm 会自行从磁盘读取文件,因此源码不会经过 Claude 的上下文。无法读取的文件会直接在结果中报告,而不会导致调用失败;预检估算器则会拒绝那些根据实测数据判断会超时的输入。 |
embed | 通过 /v1/embeddings 生成文本嵌入(Nomic Embed 是个可靠的选择)。 |
discover | 健康检查:端点、当前模型、上下文窗口、输出上限,以及完成实际调用后测得的速度。 |
list_models | 服务器上的所有模型,包括已加载和已下载的模型,以及对应的配置档案。 |
stats | 会话和累计的卸载统计数据及各模型的性能,不含模型目录。 |
推理工具(chat、custom_prompt、code_task、code_task_files)都接受可选的 model,用于指定调用所用的模型;还接受 max_tokens 和采样控制参数(temperature、seed、stop、top_p、top_k、repeat_penalty、frequency_penalty、presence_penalty)。chat 和 custom_prompt 还接受 json_schema,强制答案符合 JSON Schema;在 LM Studio 上,这是基于语法的采样,因此无需指望模型记得补上右括号:
{
  "json_schema": {
    "name": "code_review",
    "schema": {
      "type": "object",
      "properties": {
        "issues": {
          "type": "array",
          "items": {
            "type": "object",
            "properties": {
              "line": { "type": "number" },
              "severity": { "type": "string" },
              "description": { "type": "string" }
            },
            "required": ["line", "severity", "description"]
          }
        }
      },
      "required": ["issues"]
    }
  }
}
如果你通过自己的脚本而不是 Claude 来调用 houtini-lm,请设置 HOUTINI_LM_STRUCTURED=1,这样每个推理结果还会包含一个 structuredContent 块(包含答案、模型、令牌数、耗时和质量标记),可供按 JSON 读取。Claude Code 用户则应保持关闭,因为存在该块时,它只会向模型显示这一块(详情见工具页面)。
阅读页脚
每个响应末尾都会附上根据 SSE 流本身计算出的页脚:
---
Model: nvidia/nemotron-3-nano | 279→303 tokens (12 reasoning / 291 visible) | TTFT: 485ms, 58.0 tok/s, 5.2s
📊 First measured call on nvidia/nemotron-3-nano: 58.0 tok/s, 485ms to first token - use this to gauge whether to delegate longer tasks.
💰 Offloaded - this session: 4,283 tokens / 7 calls · lifetime: 147,432 tokens / 213 calls
首次调用行会在每个模型的每个会话中出现一次,它来自真实任务,而非合成预热基准。💰 行会在每次调用时更新,统计另一个模型处理的令牌数(包括其提示词和补全内容,以及推理内容);这些是 Claude 没有执行的工作,并不代表节省了多少 Claude 令牌;上面的基准才是更准确的衡量方式。当模型报告推理令牌时,令牌数会拆分为推理和可见令牌,这样你就能看出思考型模型在隐藏推理上花费了多少预算。
出现问题时,质量行会说明情况:TRUNCATED 表示结果不完整(连接停滞时会返回已收到的内容,而不是超时错误),hit-max-tokens 表示预算耗尽,think-blocks-stripped 表示推理内容已移除,tokens-estimated 表示服务端未报告用量。输出正常时则不会显示质量行。
每个模型的速度和令牌数会保存在 ~/.houtini-lm/model-cache.db 中,因此 discover 会显示你从新会话首次调用测得的 tok/s 和首令牌时间,而 stats 会显示累计总数。这些数据专属于你的工作站,因为委派决策应该根据你的硬件,而非他人的基准来制定。实际使用中,Claude 在会话运行得越久,委派的任务就越多;转交的令牌数达到约 5,000 后,它就会开始寻找更多任务来分派。
获得理想结果
如今,Qwen、Llama、Nemotron 和 GLM 在编码基准测试中表现出色,而结果好坏几乎总是取决于提示词,而非模型。我花了不少时间研究这个问题,简而言之,可以这样做:发送完整代码,因为本地模型在输入被截断时会自行编造细节,所以应发送整个函数,而不是中间带有 ... 的代码片段。明确指定输出格式(例如“返回一个 JSON 数组”),因为较小的模型需要这样的指示。为模型设定具体角色(“重视内存安全的资深 Rust 开发者”明显比“乐于助人的助手”效果更好),既要说明要做什么,也要说明不要做什么;生成代码时,还要提供函数体周围的导入项、类型和签名。
较长的任务也应分块处理。大多数 MCP 客户端会在大约 60 秒后将工具调用判定为超时;虽然 houtini-lm 会在每个流式数据块到达时发送进度通知,以重置计时器,但并非所有客户端或网关都会转发这些通知。每次生成约 500–900 个令牌的调用都能轻松在时限内完成。委派的技巧会深入介绍更多内容,包括我在修复时使用的逐字回显模式。
检查安装情况
npm run shakedown
scripts/shakedown.mjs 会端到端运行八个工具中的七个(stats 除外),并输出一张表格,列出每次调用的真实 TTFT、tok/s、令牌数和推理拆分情况。在性能不错的设备上,运行时间不到一分钟:
Summary

   7/7 steps passed on LM Studio, model=nvidia/nemotron-3-nano

| Tool              | OK  | TTFT (ms) | tok/s  | Tokens in→out        | Reasoning | Notes
| chat              | ✅  |      891  |   36.9 | 48→104               |        —  | answered
| custom_prompt     | ✅  |      872  |   43.9 | 170→333              |        —  | 5 valid items
| code_task         | ✅  |      857  |   41.6 | 180→189              |        —  | tests generated
| code_task_files   | ✅  |   11028   |   39.5 | 6891→3000            |        —  | cross-referenced
| embed             | ✅  |      —    |     —  | —                    |        —  | 768-dim vector

   Tokens offloaded: 10,915 (prompt: 7,289, completion: 3,626, reasoning: 0)
如果你更想进行质量审查,而非查看延迟数据,可以将 SHAKEDOWN.md 粘贴到一个已连接 houtini-lm 的 Claude 会话中;Claude 会执行相同步骤,并根据输出和速度为你撰写报告。
配置
大多数配置只需设置前两到三个变量。完整列表(包括文件访问和排队控制)见配置。
| 变量 | 默认值 | 作用 |
|---|---|---|
HOUTINI_LM_ENDPOINT_URL | http://localhost:1234 | OpenAI 兼容 API 的基础 URL,不含 /v1。 |
HOUTINI_LM_API_KEY | (none) | 用于通过身份验证的端点的 Bearer 令牌。 |
HOUTINI_LM_MODEL | (auto-detect) | 调用时使用的模型,除非调用指定了模型。对于路由器和大型目录,请固定指定模型。 |
HOUTINI_LM_FALLBACK_MODELS | (none) | 仅适用于 OpenRouter。以逗号分隔的模型 ID 列表,当主模型出错时按顺序尝试,例如遇到速率限制、服务停机、审核拒绝或上下文溢出。费用按实际处理请求的模型计算,页脚会报告该模型。 |
HOUTINI_LM_THINKING | auto | auto、off 或 on——见思考:auto、off 还是 on。 |
HOUTINI_LM_SERIALISE | 1 | 对于 OpenAI 等云 API、位于云端模型前的路由器,以及原生支持批处理的后端(vLLM、SGLang),请设为 0。 |
HOUTINI_LM_MIN_TOKENS | 4096 | 调用方提供的 max_tokens 下限。设为 0 可接受任意值。 |
兼容的端点
任何支持 OpenAI /v1/chat/completions API 的服务都能使用:
| 名称 | URL | 说明 |
|---|---|---|
| LM Studio | http://localhost:1234 | 默认配置,无需设置;通过其 v0 API 提供丰富的元数据。设置指南 |
| Ollama | http://localhost:11434 | 通过 Ollama 的 delta.reasoning 通道处理思考模型(qwen3、deepseek-r1)。设置指南 |
| vLLM | http://localhost:8000 | 原生 OpenAI API。设置指南 |
| SGLang | http://localhost:30000 | 适合处理重复上下文。见入门指南 |
| LiteLLM 路由器 | http://localhost:4000 | 自动检测:解析别名、读取实际限制、过滤非聊天模型,并对 429 响应进行退避处理 |
| llama.cpp | http://localhost:8080 | 服务端模式 |
| OpenAI | https://api.openai.com | GPT-5、GPT-6 和 o 系列仅会收到其支持的参数;图像、语音和审核模型不会列入列表。请固定指定模型 |
| OpenRouter | https://openrouter.ai/api | 支持 300 多个模型,可自动检测,并允许并行请求 |
| DeepSeek | https://api.deepseek.com | 每个令牌的费用非常低 |
| Groq | https://api.groq.com/openai | 速度快 |
| Cerebras | https://api.cerebras.ai | 速度非常快 |
| 任何 OpenAI 兼容 API | 任意 URL | 设置 URL 和 API 密钥 |
手册
本 README 是概览,详细内容请参阅以下页面:
| 页面 | 内容 |
|---|---|
| 安装 houtini-lm | 所有安装方式:本地、远程 GPU、云端、OpenRouter、LiteLLM、Claude Desktop、其他客户端以及更新 |
| 在 Docker 中运行 houtini-lm | 使用 docker run -i,或通过 Docker 的 MCP Gateway 在 HTTP 上提供服务,并介绍我们测试中发现的陷阱 |
| houtini-lm 如何处理不同模型 | 模型发现、配置档案、思考(自动、关闭或开启)、输出预算、路由、LiteLLM 路由器,以及拒绝参数的模型 |
| 配置 | 所有环境变量、单次调用设置,以及状态的存放位置 |
| 深入了解工具 | 全部八种工具:参数、如何读取页脚、max_tokens 下限 |
| 委派的技巧 | 委派哪些任务以及如何说明要求、逐字回显模式、微型分块、推理模型预算 |
| 故障排除 | 空响应、超时、上下文长度导致的 400 错误、排队和路由器问题的症状 > 原因 > 解决方法 |
| 快速入门 | 从零开始使用本地模型:LM Studio 或 Docker、小型模型擅长什么,以及哪些模型适合你的 VRAM |
| LM Studio、Ollama 和 vLLM 设置 | 后端指南,每份都介绍可能导致静默失败的陷阱 |
| 全面测试 | 端到端检查,可作为脚本运行,也可作为提示词交给 Claude |
| 开发者指南 | 架构、贡献方式、发布流程 |
开发
git clone https://github.com/houtini-ai/houtini-lm.git
cd houtini-lm
npm install
npm test             # build + unit tests
npm run shakedown    # end-to-end self-test against a live endpoint
DEVELOPER.md 介绍了架构、推理模型流水线、后端检测、SQLite 性能缓存,以及如何添加新工具或后端。如果你发现 houtini-lm 对某个模型系列的处理不佳,请提交 issue 并附上 discover 的输出,我会看看。
祝你顺利,也欢迎告诉我使用情况!
许可证
Apache-2.0
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。