关于 seo-audit-console
SEO Audit Console 是供 SEO 顾问和企业营销人员在 Claude 中使用的 MCP 服务。它结合 Google Search Console 数据与网站抓取结果,按潜在流量影响排列问题,并提供修复建议。
主要功能
- 01合并 Search Console 数据与网站抓取
- 02按流量机会排列审计问题
- 03生成技术 SEO 修复建议
- 04查看仪表板并导出 HTML 报告
- 05添加可选的竞品与反向链接数据
适用场景
- 01按潜在点击量确定技术问题优先级
- 02调查有展示但点击较少的页面
- 03为客户准备 SEO 审计报告
- 04比较竞品并研究反向链接
MCP 相关
它作为 MCP 服务连接 Claude Desktop 或 Claude Code,将 SEO 审计、网站抓取、Search Console、仪表板和报告流程提供为工具。DataForSEO 与 Majestic 功能属于可选层级。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y @houtini/seo-audit-consoleGOOGLE_APPLICATION_CREDENTIALS密钥Path to the Google service-account JSON key with Search Console access.SAC_DATA_DIRDirectory for per-property SQLite databases and reports. Defaults to ~/Documents/seo-audit-console.DATAFORSEO_USERNAMEDataForSEO API username (optional, enables SERP/keyword/domain/market/recon checks).DATAFORSEO_PASSWORD密钥DataForSEO API password (optional).DATAFORSEO_CACHE_DAYSTTL for the DataForSEO response cache, in days. Default 20.MAJESTIC_API_KEY密钥Majestic API key (optional). Enriches link_intersect with Trust Flow + Topical Trust Flow and re-sorts prospects by real authority.MAJESTIC_CACHE_DAYSTTL for the Majestic response cache, in days. Default 30.CRUX_API_KEY密钥Chrome UX Report API key (optional, free Google Cloud key). Switches on sync_crux: real-user Core Web Vitals (LCP, INP, CLS) and the crux-field-* checks.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
SEO Console——面向 Claude 的技术/内容/研究/机会 SEO 审计 MCP 服务
可通过对话进行的技术 SEO 审计——基于你自己的 Search Console 数据和对网站的实时抓取,并在 Claude 中运行。



二十年来,我接手的技术 SEO 审计几乎全是爬虫的看法,而爬虫看到的永远只有一半情况。它会告诉你网站说了什么,却无法告诉你 Google 对此做了什么:你为哪些查询排名、哪些页面获得了展示,以及点击落在哪里。
这个工具补上了另一半。SEO Audit Console 在 Claude 中运行,提取你的 Google Search Console 历史数据,恰当地抓取网站,并将二者结合起来,让每项发现都体现出可能影响的流量。它包含 111 项检查,按修复后可能挽回的点击量排序,而不是按检查听起来有多吓人;它还会为你编写修复方案:301 规则、JSON-LD、内部链接。核心审计只需你自己的 Search Console;等你的问题延伸到竞争对手和链接建设时,再接入 DataForSEO 和 Majestic。你的数据会保留在自己的机器上。
由 Houtini 打造。 我们为数字营销中的繁琐工作构建自动化工具——数据收集、抓取、整合和检查——让团队把时间花在思考、策略和需要人来完成的客户工作上。这个插件正是将这一理念应用于技术 SEO 审计的成果。
刚接触 MCP,或不确定从何开始? 入门指南 将带你从一台全新的机器(没有 Node、没有 Git,也从未听说过服务账号)开始,完成首次审计——每一步都有截图,包括大家最容易漏掉的那一步。说真的,只需十分钟。
you  › run an SEO audit on mysite.com

     ⣾ search console  1.8M rows synced (19s - incremental)
     ⣾ crawl           868 pages · HTTP/2 · robots-polite · 8 parallel
     ⣾ link graph      internal PageRank · click depth · in-degree
     ✓ 143 checks · 220 findings · ranked by expected clicks per dev-hour

     #1  CTR far below position-expected     /pricing                   XL
     #2  Page losing clicks (trend)          site-wide                  XL
     #3  Keyword cannibalisation             "project management app"   L
     #4  Robots-blocked page earning traffic /category/guides           L

you  › generate the fix for #1 ▍
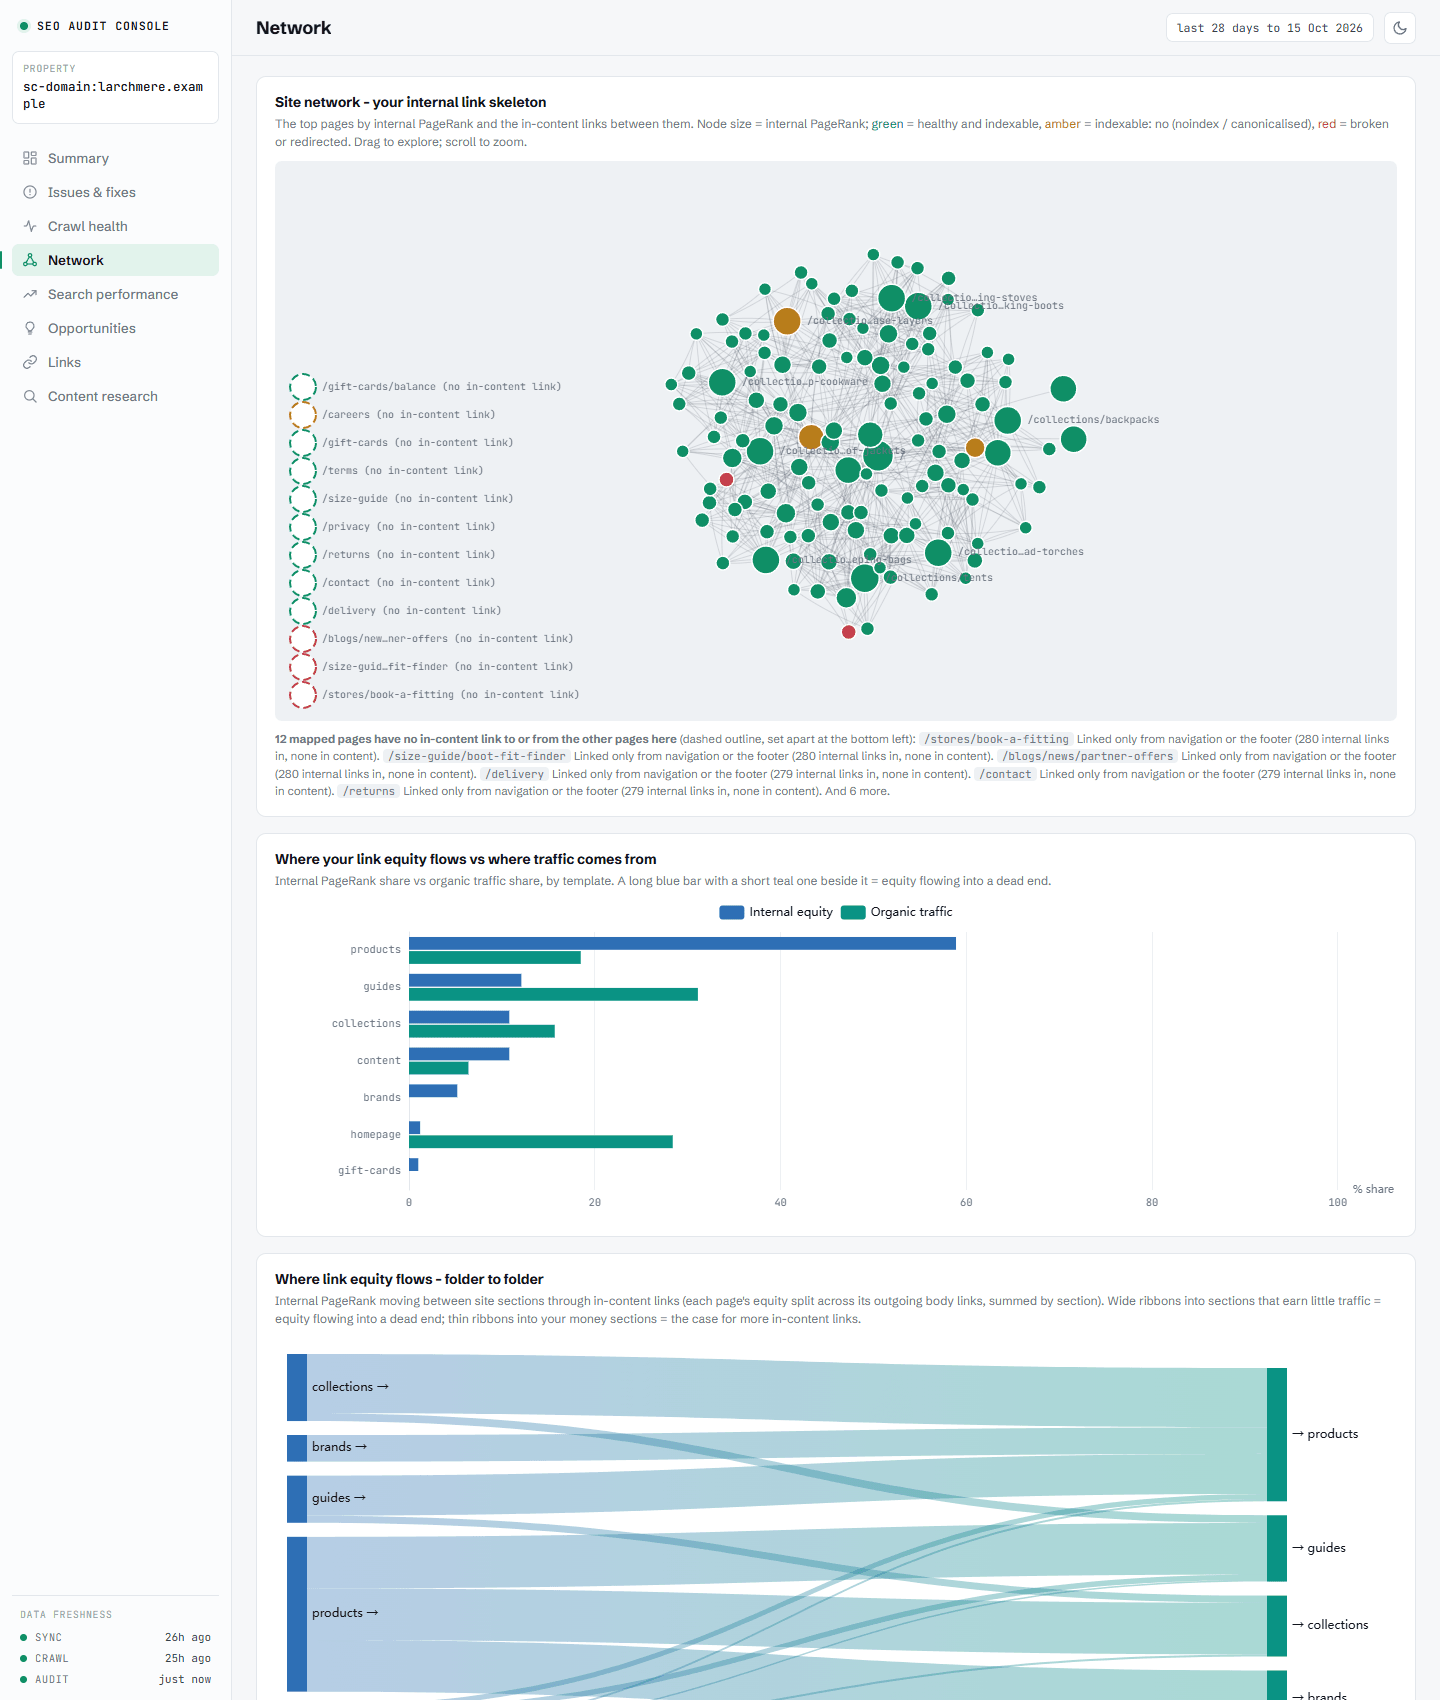
快速开始
它已发布到 npm,因此无需克隆或构建。你需要 Node.js 20 或更高版本,以及一个你拥有的 Search Console 资源。
Claude Desktop - 将以下内容添加到 claude_desktop_config.json,然后重启 Claude:
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "npx",
      "args": ["-y", "@houtini/seo-audit-console"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "DATAFORSEO_USERNAME": "",
        "DATAFORSEO_PASSWORD": "",
        "MAJESTIC_API_KEY": "",
        "CRUX_API_KEY": ""
      }
    }
  }
}
第一行是必需的。其余内容为可选项:在引号之间粘贴密钥,或留空以关闭该层级。DataForSEO 和 Majestic 是付费层级;CRUX_API_KEY 是来自免费 Google API 密钥的字段 Core Web Vitals,该密钥需限制为 Chrome UX Report API。留空表示关闭。诸如 your-key-here、<your key> 或 changeme 这样的模板文本也会被视为空值,服务日志会用一行说明(例如 MAJESTIC_API_KEY looks like a placeholder; Majestic tier disabled.),因此,如果某个你原本希望启用的层级仍处于关闭状态,不妨查看日志。
Claude Code - 只需一条命令(如果使用 DATAFORSEO_USERNAME=… 等其他变量,也用同样的方式添加 --env DATAFORSEO_USERNAME=…):
claude mcp add seo-audit-console --env GOOGLE_APPLICATION_CREDENTIALS=C:/path/to/service-account.json -- npx -y @houtini/seo-audit-console
仅设置 GOOGLE_APPLICATION_CREDENTIALS 就能完成全部核心审计。最容易遗漏的一步:JSON 密钥属于 Google Cloud 服务账号,该账号的邮箱必须在 Search Console 中作为用户添加到你的资源,否则工具就无法查看你的任何数据。入门指南配有截图,介绍了整个流程,还介绍了一键安装 Claude Desktop 扩展和从源代码构建的方式。
然后向 Claude 提问:“列出资源”、“刷新 mysite.com”、“运行 SEO 审计”。
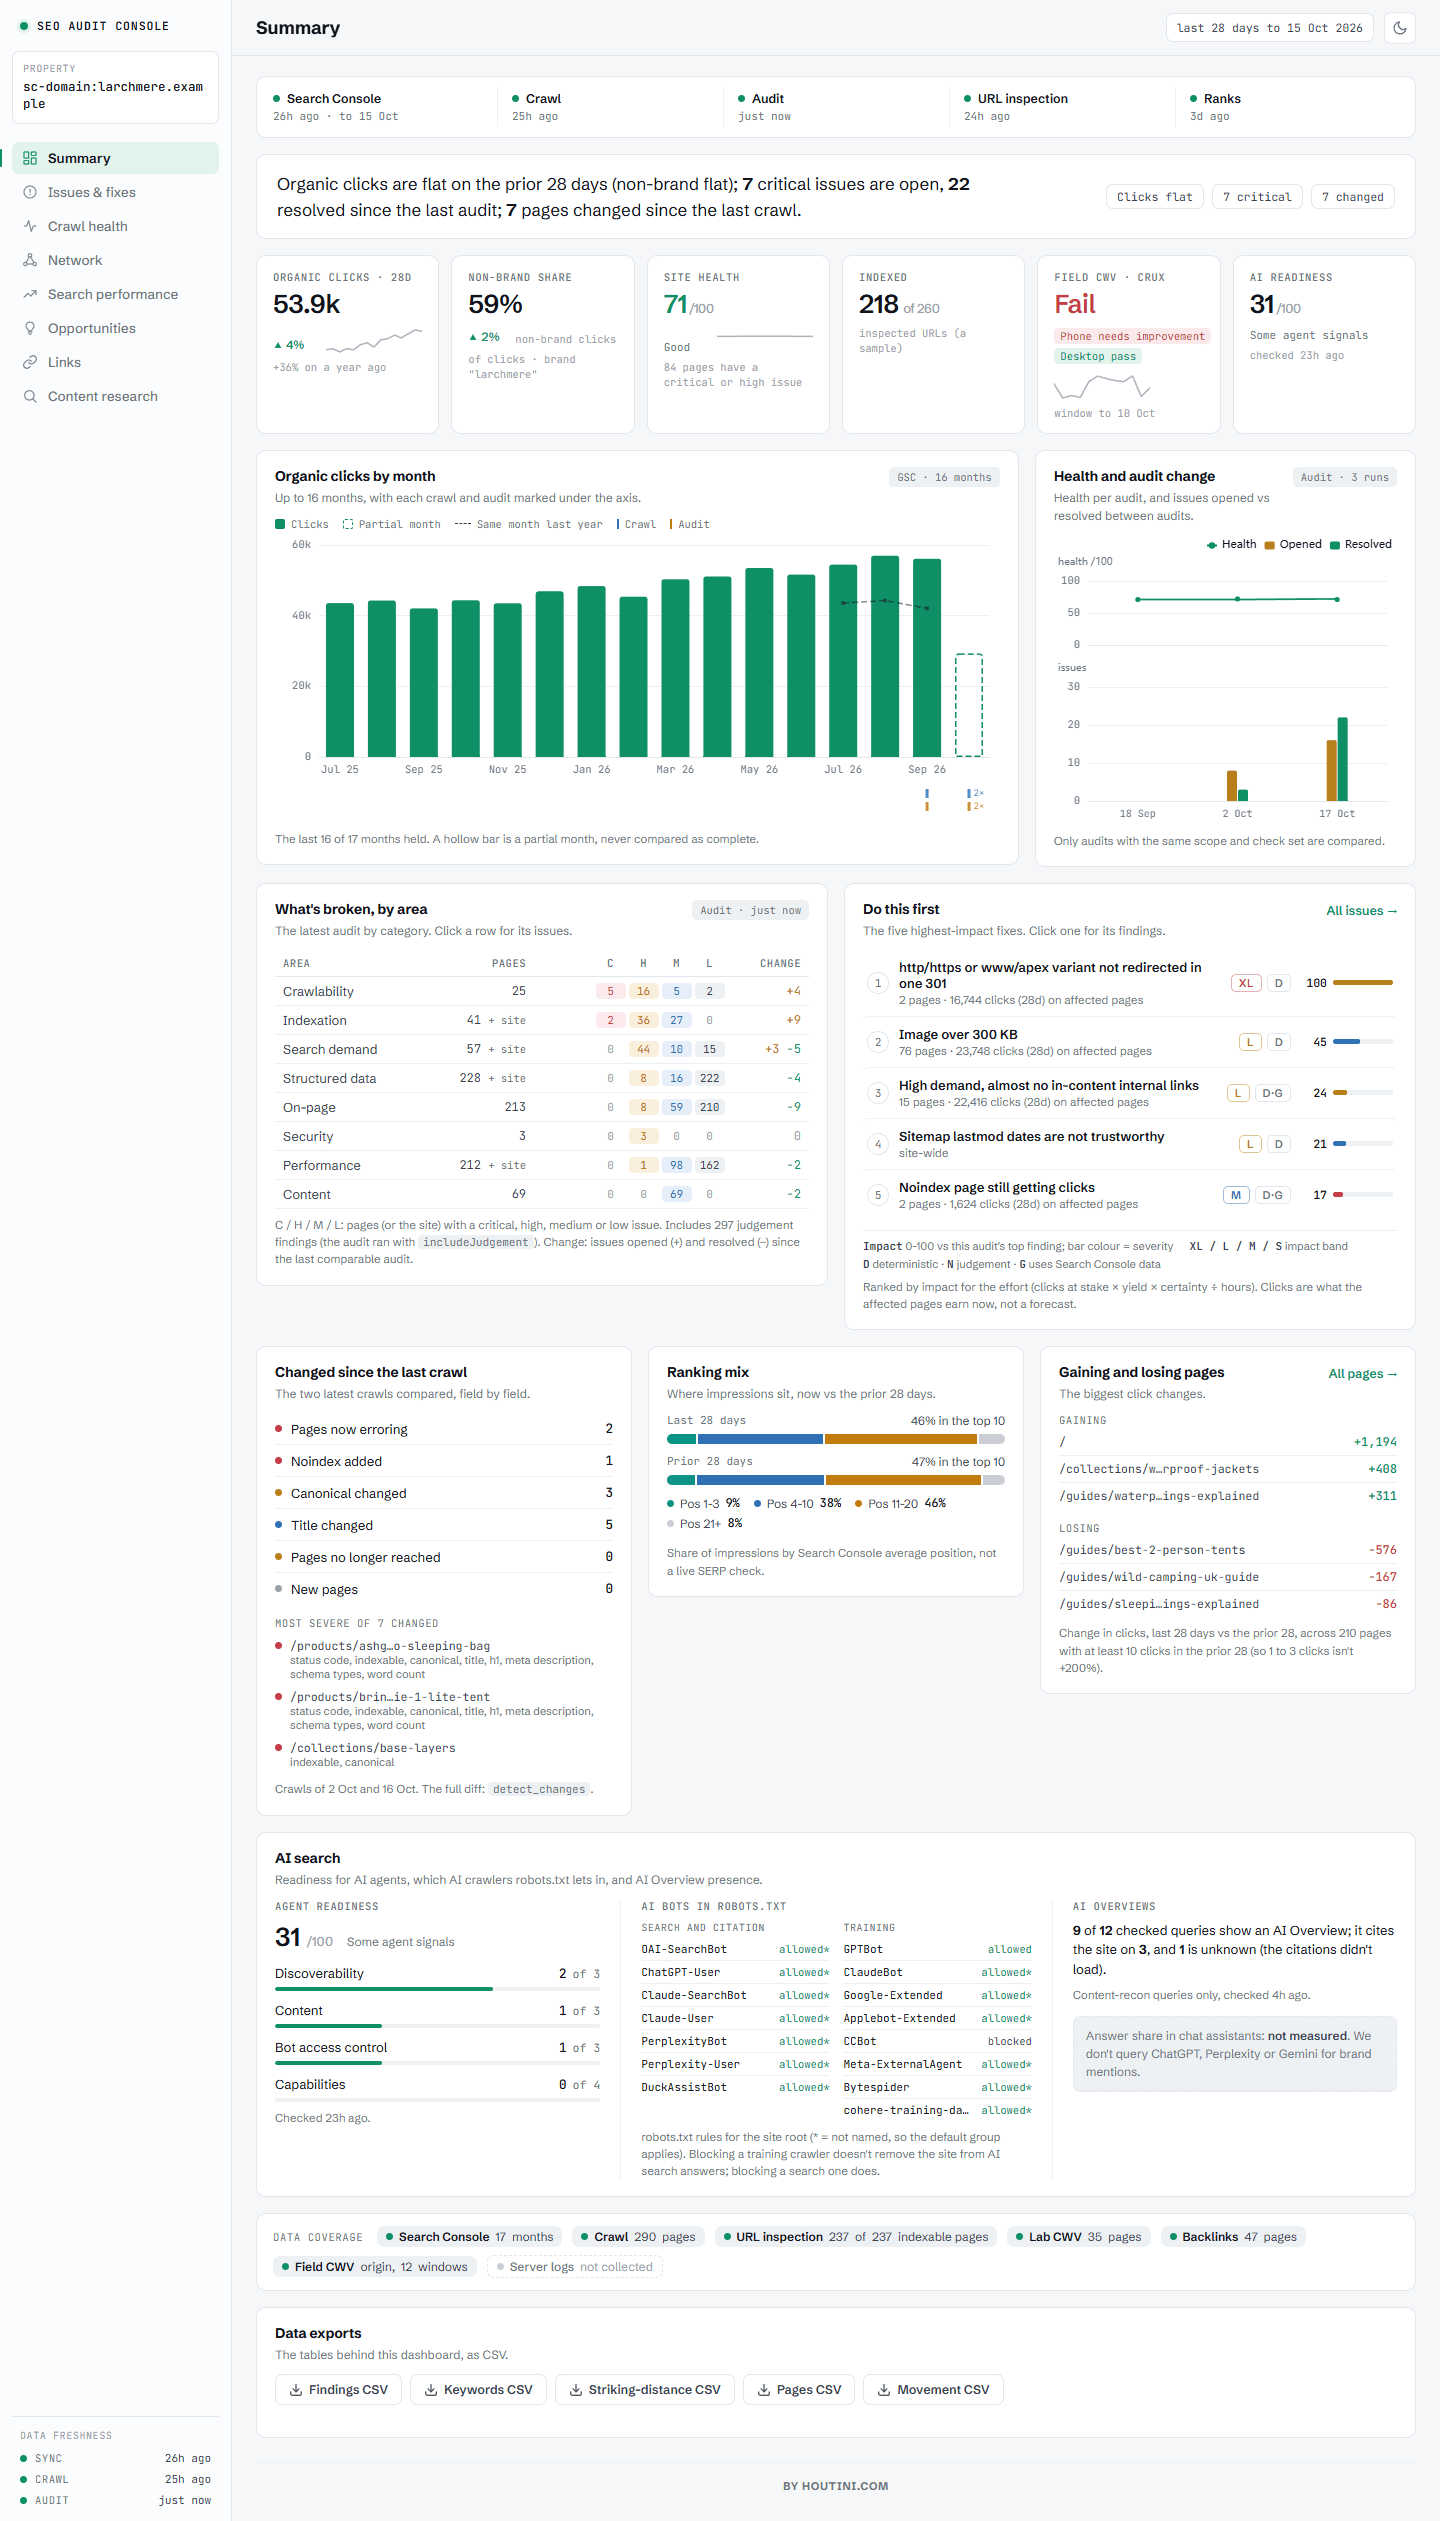
打开仪表板
刷新或审计某个资源后,有三种方式可以查看:
| 你的需求 | 向 Claude 提问 | 你会看到 |
|---|---|---|
| 在聊天中快速查看 | “显示 mysite.com 的仪表板” | 在对话中绘制的仪表板(get_dashboard) |
| 在浏览器中查看完整仪表板 | “打开 mysite.com 的仪表板” | 一个链接,例如 http://127.0.0.1:53817/dashboard?siteUrl=…(open_dashboard)。点击即可。它会实时读取本地数据库,因此每次刷新后都要重新加载 |
| 获取可发送给客户的内容 | “导出 mysite.com 的报告” | 一个独立的 HTML 文件(export_report) |
通常无需特意提问:刷新、爬取、同步或审计完成后,回复会说明仪表板已更新,并附上浏览器链接。该链接仅在你的机器上有效(只会响应 127.0.0.1),且端口会在每次服务启动时变化,因此请使用最新回复中的链接。添加 &theme=dark 可启用深色模式,添加 &redact=1 可模糊数字以便截图。
在 Docker 或 Docker MCP 网关中运行? 浏览器链接指向容器内的端口,因此浏览器无法访问。请在同一数据卷上,将仪表板作为单独的小型容器运行,并使用固定端口:
docker run -d --name seo-audit-dashboard --restart unless-stopped -p 127.0.0.1:8788:8788 -e SAC_DATA_DIR=/data -e SAC_DASHBOARD_BIND=0.0.0.0 -e SAC_DASHBOARD_PORT=8788 -v seo-audit-data:/data node:22-slim npx -y -p @houtini/seo-audit-console seo-audit-dashboard
然后打开 http://127.0.0.1:8788/dashboard?siteUrl=sc-domain:mysite.com。请使用 MCP 服务写入的卷名称。在 Windows 的 Git Bash 中,请在命令前加上 MSYS_NO_PATHCONV=1,避免 /data 被改写为 Windows 路径。更多内容请参阅 dashboard.md。
手册
这份 README 讲述项目故事并提供快速入门。详细内容请见手册:
| 页面 | 内容 |
|---|---|
| 入门指南 | 安装、GSC 服务账号设置(以及大家都会漏掉的那一步)、Claude Desktop 和 Claude Code 配置、首次审计、故障排查 |
| 工具参考 | 每个工具的功能、输入、关联方式以及示例提示词 |
| 检查项注册表 | 全部 143 项检查、每项的检测内容、D/N 标签和修复方法 |
| 组合分析 | 关联键、数据粒度,以及 14 个用于跨数据提问的配方 |
| 竞争分析 | 竞争分析工作流、DataForSEO 设置、包含 Majestic Trust Flow 层级的链接交集分析,以及实际成本 |
| SEO Recon | 页面表现下滑的原因:实时 SERP + AI Overview 引用判定、竞争对手差异,以及可跟踪的待办清单 |
| DataForSEO 函数 | 按 API 模块分组的所有 DataForSEO 支持工具——Keywords、SERP、Labs、Backlinks、OnPage——每项都附有端点和成本 |
| Majestic 函数 | 可选的 Trust Flow 层级——它能提供什么,以及 link_intersect 和 pull_backlinks 如何使用它 |
| 资产组合 | 一页查看你负责的所有域名(自有 + 关注):实测与估算、Domain Rank、AI 提及、需关注项、域名概览,以及带报价和预算上限的刷新任务 |
| 仪表板与报告 | 八个标签页、每张图表展示的内容、浏览器仪表板(以及适用于 Docker 的独立版本),还有可分享的导出内容 |
二十年来,变化竟如此之少
我在 2006 年为客户撰写的技术审计,从结构上看,和如今大多数代理商仍在出售的审计如出一辙。爬虫运行、模板填充,一份 60 页的 PDF 随即生成。它按严重程度列出爬虫能找到的所有问题,却不知道哪些发现能带来收益,哪些只是表面问题。
真正改变的是我们能做到的事。Google 会为每个网站所有者提供完整的搜索现状记录——哪些查询、哪些页面、多少次展示、排名如何。爬取结果告诉你网站写了什么;Search Console 告诉你 Google 对此做了什么。根据我的经验,这两组数据之间的差距,几乎藏着所有可挽回的流量。
所以我打造了这个项目。SEO Audit Console 是一个 Model Context Protocol 服务,可将你的 Search Console 历史数据 与 对网站的第一方爬取结果(以及你需要时的 DataForSEO)合并为一份内容:一份有优先级、有证据支撑的审计报告,你可以在 Claude Desktop 中深入查询。它会提供可直接粘贴的修复方案。每项发现都能追溯到真实数据点。
这一切都基于一个理念:
爬取结果代表意图。Search Console 代表现实。两者的偏差之处,就是收益所在。
普通爬虫会告诉你某个页面返回 404。有用,但仅此而已。本工具会告诉你,这个 404 正在耗掉首页 15% 的内部 PageRank,该页面过去每月能带来 10,000 次点击,并且会写好用于修复的 301 规则。它还能找到一个排名第 3、展示量达 150,000 次但点击率只有 0.2% 的页面——重写标题可能带来数千次点击——并将其排在那些表面问题之上。爬虫卖给你的是严重程度;真正能改变数据的,是收益。
适合哪些人?
想要自动完成采集和检查、从而保留思考时间的 SEO 顾问。被告知一项普通审计要花四位数费用的企业内部营销人员。以及任何刚接触这项工作、想了解优质审计会检查哪些内容的人——因为每项发现都会展示其证据,这款工具也兼具教学功能。
关于在哪里运行的说明。Claude Desktop 是最简单的起点,但在我看来,Claude Code 是这款工具的最佳使用环境——因为它能形成闭环。在聊天客户端中,审计会给你一条 301 规则,让你粘贴到某处。而在 Claude Code 中,同一个会话可以访问你的网站代码仓库、终端和 git:审计发现问题、编写修复方案、将其应用到代码库、提交更改,然后重新抓取以验证结果。从发现问题到修复上线,全程只需一次对话。
你不需要学习如何使用界面。只要在 Claude 中输入 “对 mysite.com 运行 SEO 审计”,它就会开始运行。忘了有哪些功能?询问 “运行 seo_audit_help”,即可获得完整功能菜单和示例提示词。
这种方法有效吗?
有效。将抓取结果与 GSC 数据合并并非新鲜事,而是行之有效的方法。在一个站点上,以 Search Console 中的 URL 作为抓取起点,使 GSC 已知页面的覆盖率从 29% 提高到 70%——每一个新增页面,都是常规抓取悄然漏掉的页面;其中有几个页面正在获得流量,却完全没有内部链接指向它们。在同一站点上,增量同步将数据刷新时间从 33 分钟缩短到 19 秒,这就是“每季度审计一次”和“想审计时随时审计”的区别。
审计检查内容
run_audit 会对合并后的数据执行 143 项检查,并返回按优先级排序的列表——不是罗列所有问题,而是按优先级排列,并为每项发现附上相关流量。以下简要介绍各类别:
| 类别 | 检查内容 |
|---|---|
| 可抓取性与索引 | 无效链接、重定向规范性(重定向链、循环、传递权重的临时重定向、重定向到不可索引页面或首页、仍有流量的页面下线却未设置重定向)、不存在却返回 200 的 URL(软 404 配置),以及 http/https 或 www/根域名版本未通过单个 301 重定向合并的情况;孤立页面、索引膨胀、蜘蛛陷阱、仍有流量但被 robots 屏蔽的页面、将索引权交给其他主机的 canonical、Google 会忽略的 hreflang(代码无效、缺少自引用、语言区域重复、与 canonical 冲突),以及每个 URL 不可索引的 原因 |
| 页面内容与结构化数据 | 标题、元描述、H1、alt 文本;还包括本地验证器,覆盖约 30 种富媒体搜索结果类型,仅检查必填字段,因此不会对 Google 忽略的属性发出提醒。对于网店:从 200 变为 404 的产品页,以及缺少商品详情展示所需信息的 Product 标记 |
| 页面体积与资源 | 抓取时每个页面加载的内容:返回错误的 CSS、JavaScript 和字体文件;<head> 中阻塞渲染的脚本和样式表;没有缓存时长的静态文件;无效图片;超过 300 KB 的图片,以及用 WebP 可以减小体积的 JPEG/PNG 图片(按浏览器实际接收的图片测量)。真实用户的 Core Web Vitals 数据来自 CrUX |
| 趋势(GSC 随时间变化) | 点击量下降的页面、排名下滑、消失的查询、值得加倍投入的上升页面,以及逐年衰退的过时内容 |
| 合并数据后发现的问题 | 关键词蚕食、排名临界页、幽灵页面、流量指向失效 URL、浪费在无点击页面上的内部权重,以及缺少你已有排名查询词的标题 |
| AI 搜索就绪度 | 有排名但从未提及的短语、文案未在单段中回答的查询,以及不适合切分以供检索的内容 |
| 无障碍 | 直接从 HTML 读取的 axe-core 确定性规则子集——缺少无障碍名称的链接和按钮、未标注的表单字段、禁用双指缩放、正值 tabindex、重复 id——以及 alt 文本、标题顺序和缺失的 lang |
| JavaScript 渲染与重复内容 | 按需运行:响应与渲染(render_pages)会在无头 Chromium 中抓取每个页面,并标记仅在 JavaScript 执行后才出现的内容和链接,以及 JavaScript 所做的更改(canonical、标题、noindex 的增删、被移除的服务器端渲染副本);语义近重复检测(find_duplicates)则会找出内容相同的页面——两者都在本地运行,不产生 API 费用 |
每项检查都标记为 D(确定性——以字节为准)或 N(判断性——默认关闭;要求查看 “判断性发现” 即可查看)。我认为,错误发现比没有发现更糟,因此启发式检查必须先征得许可。完整检查项注册表请参阅手册。
如果你熟悉经典桌面 SEO 爬虫,仪表板的“抓取健康状况”选项卡会让你倍感熟悉——响应代码、索引原因、抓取深度、体积最大的图片、服务器错误和慢速页面,都以清晰的统计栏呈现。诊断内容相同,但每项旁边都会显示同一 URL 对应的 Search Console 数据。逐个选项卡的介绍请参阅 dashboard.md。
爬取:完整说明
审计通常会在爬取这一步出错,因此值得了解这款爬虫的不同之处。我职业生涯中花了不少时间收拾那些自欺欺人的爬虫留下的烂摊子。这是一款真正的 SEO 爬虫,只不过它旁边恰好有你的 Search Console 历史数据。
它通过三种方式发现页面。 跟踪链接、读取 XML 站点地图,以及——最重要的是——直接从 GSC 数据中获取 Google 已经为其带来流量的每个 URL。覆盖范围不再取决于你的站点地图是否如实反映情况。这也正是抓出幽灵页面的办法:如果 Google 给某个 URL 排了名,但你自己的网站结构却无法访问它,该 URL 仍会被爬取,这种不一致就会成为一项审计发现。
它记录的是原因,而不只是结果。 对每个不可编入索引的 URL,它都会记录原因——404、noindex、X-Robots 标头、规范化到其他页面、被 robots 屏蔽、非 HTML。“此页面不会获得排名”是事实;“此页面不会获得排名,因为某个插件设置了一个没人记得的 X-Robots 标头”才是修复线索。
它不会被蒙骗。 离开你网站的重定向(Shopify OAuth 流程,我说的就是你)会被记录为站外重定向,绝不会作为页面存储。它始终使用 GET,而不是 HEAD,因为 HEAD 请求返回的状态可能与实际请求不同;但对于图像、PDF 和资源,它会放弃读取响应正文,因此只记录状态和大小,不下载字节。
它速度快,但不会失礼。 在你的源站支持时使用 HTTP/2,协商 gzip 和 brotli,并复用 keep-alive 连接。它的速度来自效率,而不是对你的服务器狂轰滥炸。它会正确遵循 robots.txt(根据规范,特定 Bot 的分组会取代 *,很多商业爬虫都会在这里出错),并跳过无用内容:站内搜索、分面筛选组合、登录流程。这是一款用于爬取自有网站的爬虫。做个好访客才是重点。
主机要求时,它会放慢速度。 遇到 429(或带有 Retry-After 的 503)时,爬取并发数会减半,等待 Retry-After 指定的时间,然后将该 URL 放回队列末尾再尝试两次;收到正常响应后则会增加工作线程。它会根据标头识别 Shopify 商店,并从较低的并发数开始。结束时仍受速率限制的 URL 会以受速率限制的状态存储,不会被当作损坏页面;爬取状态会告知你有多少个此类 URL。
它会测试仅靠爬取无法发现的情况。 每次爬取结束时,最多会对网站进行五项探测:两个不可能存在的 URL(网站会返回 404,还是返回 200 并形成软 404?),以及首页和深层页面的 http/https 与 www/裸域名变体(它们是否会 301 重定向到规范主机,还是会分流?)。它还会记录每个页面加载的内容——样式表、脚本、字体、图像,以及它们来自第一方还是第三方、位于 head 还是 body——但不会下载这些资源;headResources:true 会额外执行一次仅获取标头的检查,以记录它们的状态、大小和缓存情况。
它会说明哪些内容没有测量。 如果某项检查的数据从未采集过——例如 headResources 爬取之前的资源检查、render_pages 之前的渲染检查、sync_crux 之前的字段 Core Web Vitals 检查——审计会将其列为未采集,并注明负责采集的步骤。空表格绝不会被误认为一切正常。
爬取完成后,它会计算出真实的链接图谱:对导航和页脚链接降低权重的站内 PageRank、仅统计正文链接的首页点击深度,以及每个页面的入链数。这个图谱为孤立页面、权重流失和内部链接不足页面的检查提供支持,也用于工具建议内部链接时的链接供体排名。
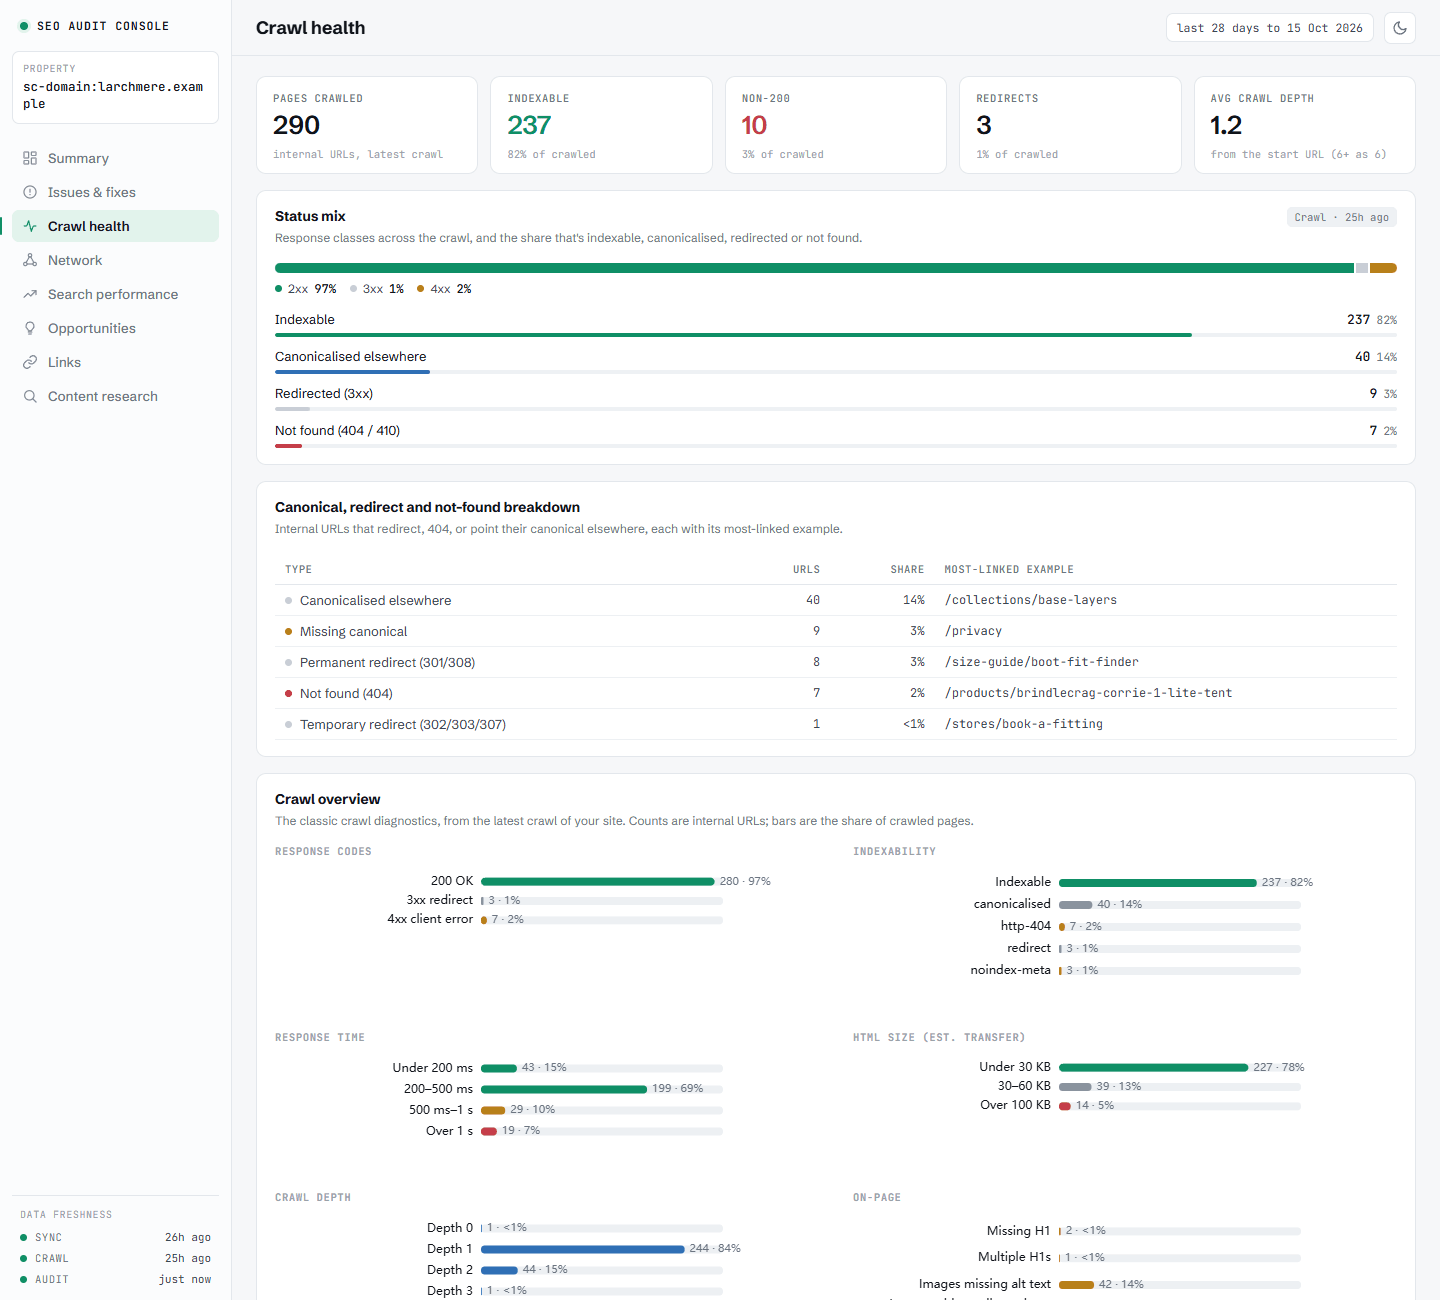
工作流简介
这些都是真正的操作流程,也是我实际使用的流程;每个流程只需一个提示词。详细版本以及背后的处理过程,可在链接到的手册页面中查看。
- 你的首次审计。 “Refresh sc-domain:mysite.com”,然后 “Run an SEO audit on mysite.com”。对于中型网站,花 20 分钟完成审计,排名前五的问题通常比其余 85 个加起来更值得关注。接着说 “generate the fix for #1”。→ getting-started.md
- 全站关键词优化。 问题不是“我应该瞄准哪些关键词?”,而是“我的文案在哪些地方没能说明我已经排名的内容?” “Score the passages on mysite.com” 会用一个小型本地相关性模型分析每个排名页面;“draft the missing content for /page” 会用你网站自己的语气撰写修复内容,并以事实为依据,避免凭空编造。→ tools.md
- 关键词蚕食。 “Show me the cannibalisation findings with evidence”——阈值经过调整,不会把偶然的长尾关键词重叠也算进去,因此合并还是区分,可以依据数据做出判断。→ checks.md
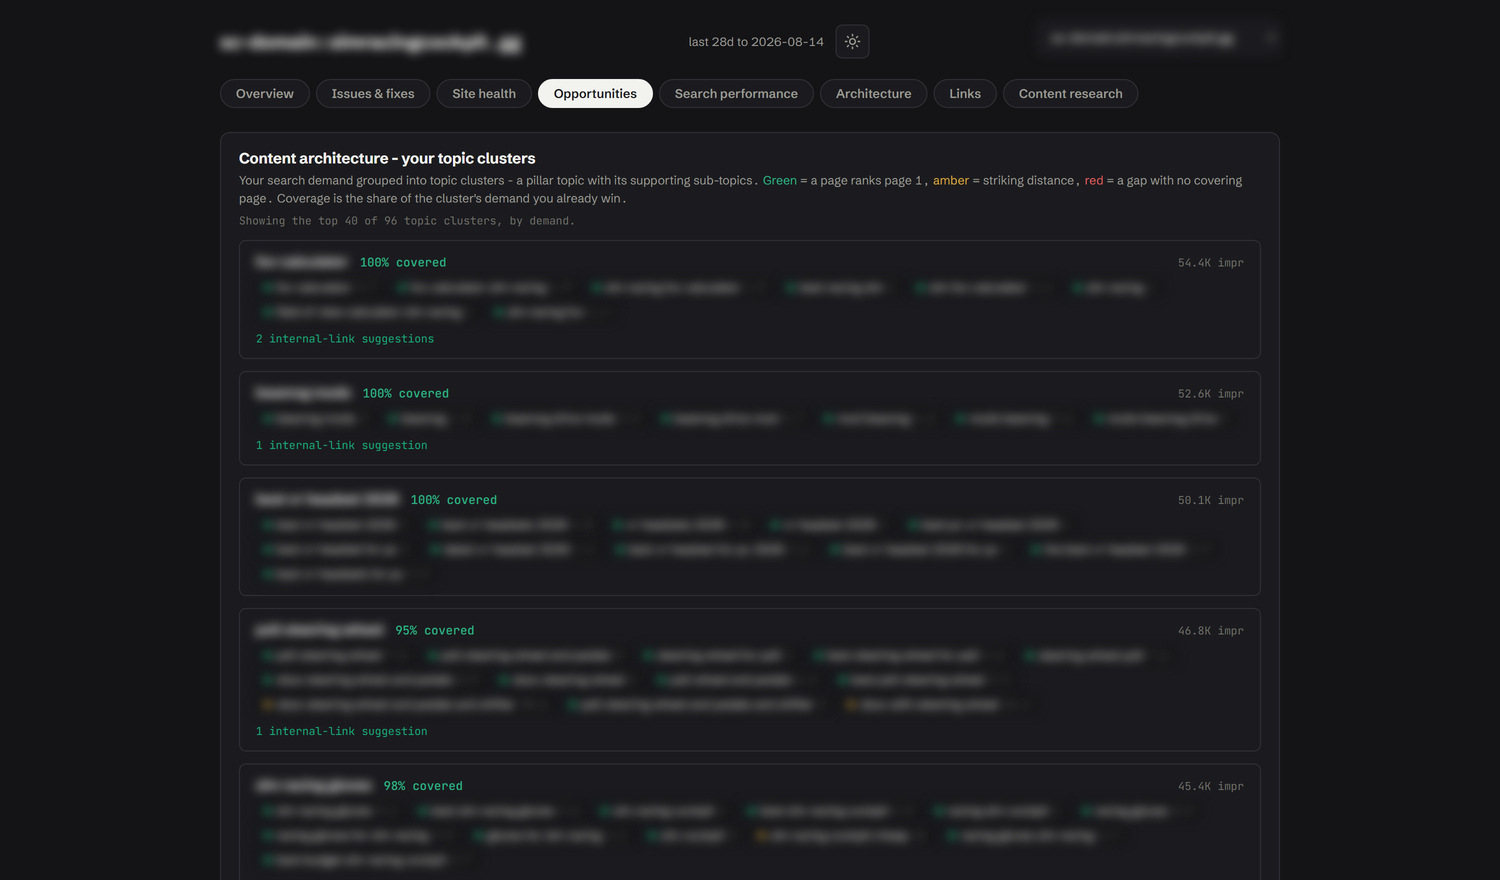
- 内容计划。 “Suggest new pages for mysite.com” 会挖掘 Google 已经展示给你的需求;“what topics should mysite.com cover?” 会梳理尚未覆盖的需求。两者结合,就是一份季度计划。→ competitive.md
- 模板策略。 “List the page templates”——大型网站不是由 50,000 个页面组成,而是由十几个反复使用的模板组成;修复一个模板,就能修正整个页面组。→ tools.md
- 监控与迁移。 “Detect changes on mysite.com” 会按严重程度比较最近两次爬取结果。迁移期间,这决定了你能否在周二发现误加的 noindex,还是三周后在董事会上解释流量图表。我就曾经吃过这个亏。→ tools.md
- AI 搜索就绪度。 “Check agent readiness for mysite.com”——网络正悄然迎来第二类受众,而几乎没有 SEO 工具会检查这方面的情况。→ tools.md
- 自定义问题。 四个数据集共用三个连接键,最有价值的分析往往是你自己组合出来的——“which pages lost clicks after being cited in AI Overviews?” 在这里用一条提示词就能完成,其他地方却没有这项功能。→ composition.md
- 报告。 在聊天中说 “Show me the dashboard”,在浏览器中查看实时版本时说 “serve the dashboard”,或者说 “export the report”,将报告导出为一个可发送给客户的独立 HTML 文件。→ dashboard.md
- 内容机会报告。 如果你以写作为生,这就是你的第一页:“Content opportunities for mysite.com” 会返回接下来该写什么(你已经获得展示但没有页面胜出的需求)、该更新什么(正在流失点击的页面)、该重写哪些摘要(排名不错但点击不足),以及该强化哪些主题集群(排名第 4 至第 20 位,只需再推一把就能带来收益)。每一行都能追溯到你自己的 Search Console 数据,不会虚构关键词点子;而 “draft the brief for row 1” 可以将其中任一项转化为有事实依据的大纲。→ competitive.md
- 市场规模与优先级排序。 “Size the market: mysite.com vs rival1.com and rival2.com”——只需对每个域名调用一次缓存数据,就能获得关键词全集、每月总需求量,以及各主题集群的声量份额。这份有助于开启客户沟通的分析报告,过去需要付费的 SEO 套件才能提供。→ competitive.md
- 内容侦察——为什么这个页面表现下滑? “Run content recon on mysite.com” 会选取展示次数最高且排名在第 3 至第 15 位的页面(稍加推动就可能提升的页面),抓取每个页面对应的 Google 实时 SERP,并查看 AI Overview 是否引用了你。结论才是关键:排名靠前但未被引用,说明数据准确性或新鲜度存在问题,而不是需要重写。它会通过免费的浏览器配置文件抓取可访问的竞争对手(Reddit 则通过其自有 JSON 接口抓取),列出排名靠前、值得观看的视频,并将内容差距写入可追踪的待办事项面板,供你添加注释并再次衡量。→ recon.md
- 外链挖掘:按真实权威度排序。 “Link intersect for mysite.com vs rival1.com, rival2.com” 会返回链接到竞争对手但未链接到你的网站域名——这就是外联名单,按优先跟进顺序排列,并过滤掉垃圾网站。添加 Majestic 密钥后,结果会按 Trust Flow 重新排序,并显示每个潜在对象的 Topical Trust Flow,这样目录网站会被筛掉,留下的才是真正与你的主题相关的权威网站。→ Majestic, below
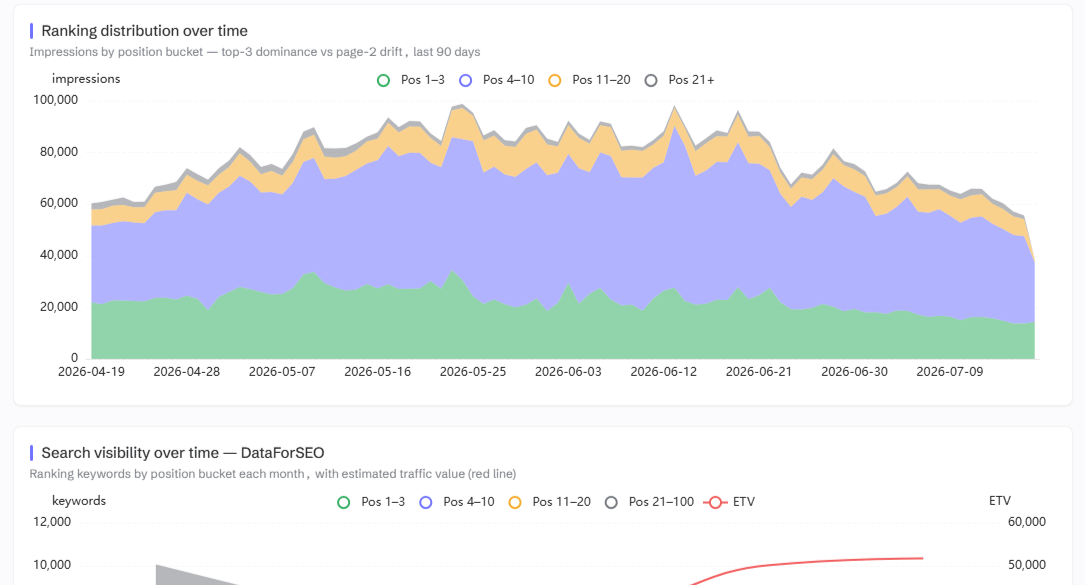
DataForSEO 能提供什么(以及费用)
以上所有功能只需使用你的 Search Console 数据即可实现。但 GSC 只能描述你已经出现过的搜索。当你开始问“这个市场有多大?”或“竞争对手有哪些排名关键词是我没有的?”时,就需要第三方数据——也就是 DataForSEO:一个按需付费的 API,提供搜索量、实时排名、竞争对手数据和 Lighthouse 运行结果。无需订阅;每次调用的费用从几分之一美分到几美分不等,缓存 20 天,且只有在你提出请求时才会运行。我自己的使用费用每月几美元。
它解锁了竞争分析层:任何域名的自然搜索可见度概览、任何网站的热门页面和排名关键词(包括其中哪些会显示 AI 概览)、内容差距、主题差距、搜索意图、实验室 Core Web Vitals 和反向链接。它还支持 内容侦察——recon_targets 会获取排名下滑页面对应的实时 Google SERP,判断 AI 概览是否引用了你,并告诉你落后的原因。完整工作流和设置说明:competitive.md。
它还为 资产组合 提供支持:一张表格汇总你拥有的网站和关注的域名。自然搜索关键词和流量、引用域名、Domain Rank 和 AI 提及(Google AI 概览 + ChatGPT)与实测的 Search Console 点击量和审核健康状况并列显示;此外还有“需要关注”标签页和逐域名概览。每个数据都注明是实测还是估算;刷新前会先报出费用,确认后才会产生费用(每周档位下的 8 个域名,实时运行费用为 $0.22)。详情:portfolio.md。
DataForSEO 解锁的另一项功能值得单独介绍,因为链接工作还依赖一项可选的辅助服务。
链接交集与 Majestic Trust Flow 层级
链接建设是唯一一项潜在对象名单 本身就是策略 的工作,因此,link_intersect 会依据证据而非猜测来构建名单。对你的竞争对手集合(不包括你自己)发起一次 DataForSEO domain_intersection 调用,就能返回所有链接到他们、却没有链接到你的域名,并按潜在对象汇总信息:链接到它的竞争对手数量、链接是否为跟随链接、最高垃圾分数以及锚文本组合。若不输入竞争对手集合,而是只指定一家公司,它就会回答另一个经典问题:X 公司有哪些我们没有的链接?
这样你就有了一份名单。但它还没有优先级排序,而这正是链接挖掘一直出问题的地方。DataForSEO 按域名排名排序,这是一项链接数量指标,所以目录站、聚合站和新闻稿转载站会直接排到最前面——从技术上看权威性很高,却不值得联系。我认识的每位链接建设者都曾在这份名单上浪费一周时间。
设置 MAJESTIC_API_KEY,排序结果就会变得有理有据。 Majestic 在如今大多数 SEO 工具出现之前,就已开始抓取并评估网络链接图谱;它的两项旗舰指标正好能解决这个问题:
- Trust Flow(0-100)——编辑权威性,由一组可信网站传播而来。它衡量的是哪些网站为某个域名 背书,而不是该域名积累了多少链接。这正是目录站的克星:测试中,DataForSEO 排名 227 的域名,Trust Flow 得分为 0。单纯的数量指标根本看不出这一点。
- Topical Trust Flow——这类权威性 涉及什么主题,以排名靠前的主题表示。Trust Flow 为 45 的域名,若其首要主题是
Recreation/Autos,而你销售汽车零件,那它就是很好的链接对象;若主题是Health/Nutrition,那联系它就是白费工夫。这就是强势链接与相关链接的区别,也是让外联名单经得起客户检验的那一列。
设置密钥后,每个符合条件的潜在对象都会得到补充信息,表格会新增 Trust Flow 列和每个域名的首要主题,整个名单也会按 Trust Flow 重新排序:
you  › link intersect for mysite.com vs rival1.com, rival2.com

     Prospect domain     Links to  Trust Flow  Link    Spam  Backlinks  Top topic
     enthusiast-mag.com  2/2       54          follow  2     31         Recreation/Autos
     club-forum.org      2/2       41          follow  0     12         Recreation/Autos
     free-link-list.net  2/2       0           follow  28    904        –
(输出格式示意,名称为虚构。)还是那三个潜在对象,底层仍是相同的 DataForSEO 数据——注意哪个对象的反向链接最多。按 DataForSEO 的方式排序时,你会最先联系那个目录站。
link_intersect 需要 DataForSEO 的 Backlinks 订阅,该订阅与他们的 SERP/Keywords/Labs API 分开;若尚未激活,工具会用通俗易懂的语言说明,而不是抛出一串代码。
该层级会谨慎使用你的配额:补充信息时每次调用最多处理 100 个域名(每个大约消耗 1 个单位),并受 enrichLimit 限制(默认值为 100——如果符合条件的潜在对象多于实际补充信息的数量,响应会说明这一点并告知你提高该值,而不会给你一份只评分了一部分的名单);请求会串行处理,每个响应都会通过 MAJESTIC_CACHE_DAYS 缓存 30 天。两周内问同一个问题两次,第二次无需付费。
这是可选项,而且确实是可选项:即使没有密钥,link_intersect 仍会运行,并仍按跟随链接优先、域名信任度其次的方式排序。Majestic 能把“这里有 100 个域名”变成“这里有 20 个值得联系的对象,以及原因”。请前往他们的方案与定价页面获取密钥;完整工作流见 competitive.md。
Trust Flow 和 Topical Trust Flow 是 Majestic(Majestic-12 Ltd)的商标。该层级只会在你运行
link_intersect或pull_backlinks时使用你自己的密钥调用 Majestic API(后者会为你自己的反向链接页面添加 Trust Flow,供仪表板的 Trapped authority 报告使用);工具中的其他功能都不会触及它。
简要安装说明
分为三个步骤——上面的快速入门是简版,包含注意事项的完整指南请参阅 getting-started.md:
- **获取程序:**最快的方式是使用 npx——将 MCP 配置指向
npx -y @houtini/seo-audit-console,无需构建。或者克隆此仓库,运行npm install和npm run build来获取源代码。无论采用哪种方式,都需要 Node ≥ 20。 - **连接 Search Console:**创建 Google Cloud 服务账号,下载其 JSON 密钥,然后——这是大家最容易漏掉的一步——在 Search Console 中将服务账号的邮箱添加为你资源的用户。想看配图指南?从头开始设置涵盖了完整流程。
- 将 MCP 客户端指向它,并设置
GOOGLE_APPLICATION_CREDENTIALS:已发布的程序包使用npx -y @houtini/seo-audit-console;如果从源代码构建,则使用node /path/to/seo-audit-console/dist/index.js。可在 Claude Desktop 和 Claude Code 中使用;只需设置这一个环境变量。
以下列出了服务读取的所有环境变量。第一项为必填,其余均为可选:填写你需要的变量,其余留空字符串(或删除即可)。空值会关闭对应服务;残留的模板文本(例如 your-key-here)也会关闭服务(服务日志中会有一行说明)。
{
  "mcpServers": {
    "seo-audit-console": {
      "command": "npx",
      "args": ["-y", "@houtini/seo-audit-console"],
      "env": {
        "GOOGLE_APPLICATION_CREDENTIALS": "C:/path/to/service-account.json",
        "SAC_DATA_DIR": "",
        "DATAFORSEO_USERNAME": "",
        "DATAFORSEO_PASSWORD": "",
        "DATAFORSEO_CACHE_DAYS": "20",
        "MAJESTIC_API_KEY": "",
        "MAJESTIC_CACHE_DAYS": "30",
        "CRUX_API_KEY": ""
      }
    }
  }
}
如果是从源代码构建的,请将两行启动配置替换为 "command": "node" 和 "args": ["C:/path/to/seo-audit-console/dist/index.js"];env 配置块保持不变。
GOOGLE_APPLICATION_CREDENTIALS 可启用完整的核心审计。DataForSEO 可添加市场层数据,MAJESTIC_API_KEY 可为 link_intersect 添加 Trust Flow 重新排序,CRUX_API_KEY(可选:用于字段 Core Web Vitals;这是一个免费的 Google API 密钥,需限制为 Chrome UX Report API)可添加真实用户的 LCP、INP 和 CLS 数据。环境变量逐项说明(包括你大概用不到的高级选项,如重排设备、Majestic 沙盒主机,以及仪表板服务器的绑定地址、端口和自动启动):getting-started.md。
接下来:发送 "list properties" 确认连接,然后发送 "refresh",再发送 "run an SEO audit"。
升级到 0.16.0
0.16.0 更改了 Search Console 行的存储方式。segments:true 同步拉取的设备和国家行现在存储在独立的表(search_analytics_segments)中,而 search_analytics 只保存所有国家的汇总数据,因此不会重复计算同一天的数据。无需手动操作,但请注意,升级后首次同步会如何处理同时包含这两种数据结构的数据库:
- 首先备份数据库,备份文件位于同一目录,名称为
<database>.bak-<date-time>。备份是完整副本,因此 5 GB 的数据库会产生一个 5 GB 的.bak文件。 - 启动前检查可用磁盘空间:需要容纳备份、额外半个数据库大小的空间,以及 256 MB。空间不足时,迁移会暂缓:同步仍会按旧布局运行(汇总数据仍然正确,因为视图每天只统计一次),回复会显示 "storage migration deferred: needs N GB free",不会移动任何数据;有足够空间后,后续同步会执行迁移。
- 然后分批按天移动数据行。在一个 5.5 GB 的数据库上,整个过程(包括备份)不到三分半钟。如果过程中断,下次同步会从停止处继续,期间数据仍可正确读取。
- **之后回收空间。**数据库文件会保持原有大小,直到进行压缩:发送 "vacuum the mysite.com database"(使用
data_storage,并通过prune搭配vacuum)。在 5.5 GB 的测试数据库上,压缩后大小降至 4.4 GB。确认数据无误后,请自行删除.bak文件;程序不会替你删除。
如果数据库始终只包含一种数据结构(大多数数据库都是如此:同步时未使用 segments),首次打开时会将其标记为已迁移,不备份也不移动数据。其余发布内容请参阅变更日志。
Docker 和 Docker MCP gateway
爬取、同步和刷新会作为后台作业运行:工具会立即返回作业 ID,并在你轮询 check_crawl_status 的同时继续执行。正常运行时(使用 npx,或从 Claude Desktop 运行 node dist/index.js),服务进程会长期运行并自行处理这些工作。以下内容均不适用。
Docker MCP gateway 则有所不同,主要体现在两方面。
- 启动。 Gateway 会在工作容器中运行服务。如果目录条目未设置
longLived: true,每次工具调用都会启动一个新的工作容器;设置后,则每个客户端连接启动一个工作容器。使用npx从node:22-slim启动的工作容器必须先安装软件包才能响应,这需要 60-90 秒,超过了 Claude Code 等待工具调用的时长。因此,每次调用都会超时,包括seo_audit_help。解决方法是使用预装了软件包的镜像,并设置longLived: true(见下文第 1 步)。 - 作业。 Gateway 会随意替换工作容器:断开连接时、重新创建路由器时,以及清理空闲容器时都是如此。在工作容器中运行的作业也会随之终止。解决方法是将工作移出工作容器,交给一个长期运行的作业运行器容器处理,Gateway 不会触碰该容器(见下文第 2 步和第 3 步)。
2026 年 10 月在某个 Gateway(0.16.2)上测得的数据:
| 目录条目 | 新连接上的首次调用 | 后续调用 |
|---|---|---|
node:22-slim + npx,未设置 longLived | 88-108 s | 88-108 s(每次调用) |
node:22-slim + npx,设置了 longLived: true | 75-80 s | 即时 |
预构建镜像,未设置 longLived | 2 s | 2 s |
预构建镜像,设置了 longLived: true | 2 s | 即时 |
1. 构建镜像,并在目录条目中指定该镜像。 固定版本号,让镜像和运行器使用相同的发行版本:
FROM node:22-slim
RUN npm install -g @houtini/[email protected]
ENTRYPOINT ["seo-audit-console"]
在包含该文件的文件夹中运行 docker build -t seo-audit-console:0.17.0 .。然后,在目录条目中设置 image: seo-audit-console:0.17.0,删除 command: 行(镜像的入口点会启动服务),并添加 longLived: true。Gateway 使用 --pull never 运行本地镜像,因此会找到你构建的镜像。每次发布新版本时都要重新构建镜像,并更改目录条目中的标签。
运行器负责另外两项工作:
- 使用
SAC_JOB_RUNNER=external启动的 MCP 服务,只会将每个作业加入数据目录中的_jobs.db队列,并读取其状态; - 运行器(与 MCP 服务位于同一 npm 软件包中,名称为
seo-audit-runner)会认领排队的作业、运行作业,并将进度写回同一个数据库。
工作容器因此可以随时销毁:即使在爬取过程中重新创建路由器,爬取仍会在运行器中继续。
2. 启动运行器:使用你在第 1 步中构建的镜像,将其挂载到同一个数据卷,并使用与 Gateway 目录条目相同的凭据:
docker run -d --init --name seo-audit-runner --restart unless-stopped \
  -v mcp-sac-data:/data -v mcp-sac-creds:/creds:ro \
  -e SAC_DATA_DIR=/data -e GOOGLE_APPLICATION_CREDENTIALS=/creds/gsc.json \
  -e DATAFORSEO_USERNAME -e DATAFORSEO_PASSWORD -e MAJESTIC_API_KEY -e CRUX_API_KEY \
  --entrypoint seo-audit-runner seo-audit-console:0.17.0
四个没有值的 -e NAME 标志会从你的 Shell 传入这些变量,因此密钥不会出现在命令行中;不需要的变量可以省略。在 Git Bash 中使用 Windows 时,请在命令前加上 MSYS_NO_PATHCONV=1,否则 MSYS 会将 /data 和 /creds 改写为 Windows 路径(PowerShell 无需设置)。--init 会让 docker stop 以干净的 SIGTERM 信号通知运行器。运行 docker logs seo-audit-runner 可查看运行器启动情况以及它认领的每个作业。(如果不使用镜像,也可以运行 node:22-slim npx -y -p @houtini/[email protected] seo-audit-runner:运行器是一个长期运行的容器,因此 npx 只会在首次启动时安装一次。)
3. 将 Gateway 切换为排队模式。 在此服务的目录条目环境变量中添加 SAC_JOB_RUNNER=external。保留 longLived: true。 运行器可确保工作容器被替换后作业仍能继续;longLived 则可让工作容器在调用之间保持就绪。两者解决的问题不同,可以配合使用(已测试:通过设置了 longLived 的工作容器排队的同步作业,由运行器认领并完成)。
你将看到的情况。 作业会显示 queued: waiting for the job runner,直到运行器接手;之后会像以前一样显示 running。如果作业排队超过一分钟,且没有运行器签入,状态会说明这一点,并打印上方的 docker run 命令。大约两分钟后,如果仍没有运行器心跳,状态会变为 queued (no runner),且不再阻止 data_storage 清理或修复;作业会继续显示在列表中,直到按通常规则在一天后清理。默认情况下,一个运行器一次运行一个作业;设置 SAC_RUNNER_CONCURRENCY 可同时运行更多作业,但同一属性的两个作业绝不会同时运行。更新方法: 为新版本构建镜像(步骤 1,使用新的标签),修改目录条目中的标签,重启网关,并使用新镜像重新创建运行器(运行 docker rm -f seo-audit-runner,然后再次运行 docker run 命令)。运行器和网关应使用相同版本。运行器停止时仍在运行的作业会记录为 interrupted,因此需要重新运行。
如果网关中继续使用 npx, 每个新工作进程都会先安装软件包,因此每个客户端连接的首次调用都可能超时(设置 longLived: true 后,后续调用会很快)。服务可以检测到这种情况:如果它是在容器内由 npx 启动的,就会记录一条指向此处的警告;可以在网关的 docker logs 中查看。
升级后,请重启 MCP 客户端。 客户端只会在连接时读取一次工具列表,之后便会保留该列表。在重启 Claude Desktop 或 Claude Code 之前(Windows 上需从系统托盘完全退出并重启),新版本中添加的工具(例如 sync_crux)都不会显示,即使服务中已有这些工具。
不使用运行器时, 较早的选项仍然有效:在目录条目中设置 longLived: true(或在网关中使用 --long-lived),也可以直接运行 docker run -i --rm 并挂载卷;这会为整个会话运行一个长期存活的 stdio 进程。无论采用哪种方式,都应为数据目录和凭据挂载命名卷(例如 -v seo-audit-data:/data -e SAC_DATA_DIR=/data 和 -v seo-audit-creds:/creds:ro -e GOOGLE_APPLICATION_CREDENTIALS=/creds/service-account.json),这样重启后审计记录和作业列表仍会保留。
服务本身没有已发布的镜像。步骤 1 中的镜像会安装已发布的 npm 软件包;如果要运行本仓库的自有构建版本,请使用其中的 Dockerfile(docker build -t seo-audit-console .),其入口点是 node dist/index.js,即 stdio 服务。
每个作业都会记录在数据目录中的 _jobs.db 里。如果运行作业的进程在作业完成前退出,该作业会显示为 interrupted,并附带原因,而不会消失;已完成作业的结果在重启后仍可读取。
网关不会发布服务容器的端口,因此服务在作业结束后启动的浏览器仪表板无法从你的计算机访问。服务会检测到自己处于容器内,且仪表板端口未发布(没有设置 SAC_DASHBOARD_BIND=0.0.0.0 和 SAC_DASHBOARD_PORT),并以启动独立仪表板的命令代替链接显示。get_dashboard 仍会在聊天中呈现仪表板;如果要在浏览器标签页中查看,可以将独立仪表板 seo-audit-dashboard 作为第二个容器运行在同一个数据卷上,并发布一个端口。命令见 dashboard.md。
工具一览
一句话概述——每个工具的完整说明、输入和提示词示例都在工具参考中。
| 工具 | 功能 |
|---|---|
refresh_property | 同步 GSC、抓取、检查、排名历史和 CrUX 现场数据,一个任务完成 |
sync_gsc · start_crawl · inspect_urls · track_ranks · sync_crux | 单独运行其中一项(sync_crux:来自 Chrome UX Report 的真实用户 Core Web Vitals 数据,使用 CRUX_API_KEY 即可免费获取) |
check_sync_status · check_crawl_status | 查看长时间运行任务的进度 |
run_audit · query_audit · list_checks | 评分审计 · 查看带证据的单项检查 · 检查目录 |
query_data | 对原始数据表进行只读查询——获取数据库中的聚合结果,而非行数据 |
open_dashboard | 网站的实时浏览器仪表板链接;同步和抓取完成后会自动提供此链接 |
probe_urls · triage_404s | 实时测试任意 URL(重定向、规范 URL、缓存、大小写/斜杠/主机变体)· 将 404 列表整理为重定向映射 |
fix_finding | 可直接粘贴的修复方案(JSON-LD / 301 / 内部链接) |
detect_changes | 对比最近两次抓取的变化 |
check_agent_readiness | 0-100 分的 AI Agent 就绪度评分,并提供可直接复制粘贴的修复方案 |
list_templates · suggest_pages | 模板集群 · 根据真实需求提出新页面创意 |
score_passages · draft_content | 本地相关性评分 · 有依据的写作简报 |
find_duplicates · render_pages | 语义近似重复页面(本地模型)· 在无头 Chromium 中对比响应与渲染结果(可选 Playwright) |
resolve_entities | Wikidata 实体及其间的链接缺口 |
keyword_volume · related_terms · search_intent | DataForSEO 关键词数据 |
youtube_discovery · news_discovery · topic_trend · trend_categories | 内容研究:某主题中排名靠前的视频(可搭配转录工具)·近期新闻报道/时效性 · 关键词、整个类别或类别内某个词条的 Google Trends 随时间变化的热度(上升/下降/季节性,以及爆发式增长的主题和查询)·免费查询 Trends 类别代码 |
competitors_domain · page_intersection · topic_gaps | 竞争对手 · 内容差距 · 主题差距 |
domain_visibility · top_pages · ranked_keywords | 任意域名的自然搜索概览、热门页面和排名关键词(另可使用 aioOnly 筛选显示 AI Overview 的关键词) |
page_lighthouse · pull_backlinks | 实验室 CWV · 含实时状态的反向链接概况 |
link_intersect | 竞争对手拥有而你没有的链接——按优先级排序的外联名单(优先显示已关注链接,并按域名信任度排序;可选择按 Majestic Trust Flow 重新排序,以减少目录噪声) |
market_sizing · serp_features | 与指定竞争对手比较的声量份额 · 按搜索量统计 AI Overview/摘要/视频曝光 |
keyword_list · content_opportunities | 对关键词列表进行聚类(自有/薄弱/缺失)· 内容营销人员报告 |
recon_targets · save_recon_todo · recon_todos | **内容侦察:**分析页面表现下滑的原因(实时 SERP + AI Overview)→ 添加到可跟踪、可批注的待办看板 |
portfolio · refresh_portfolio · schedule_portfolio_refresh · get_portfolio | **资产组合:**在一个表格中查看你负责的所有域名(自有 + 关注),并对比实测值与估算值 · 刷新数据(先报价)· 在每月预算上限内安排刷新 · 在聊天中查看 |
get_dashboard · serve_dashboard · export_report | 聊天内仪表板 · 在本地浏览器标签页中查看同一仪表板 · 可分享的 HTML |
get_dashboard_data · get_portfolio_data · get_domain_overview | 内部工具:仪表板组件通过这些工具获取数据;请勿直接使用 |
composition_cookbook | 数据接口图谱及定制分析配方 |
data_storage | 按网站统计磁盘用量和行数、需确认后执行的清理,以及包含索引修复的完整性检查 |
normalize_url · data_location · list_properties · seo_audit_help | 实用工具和帮助菜单 |
底层工作原理
- 关联键(
url_key)。 GSC 的page和抓取的url都会规范化为同一个键——强制使用 HTTPS,统一 www 和 apex,去除跟踪参数,等等。所有数据都按这个键关联。这其实就是整个诀窍。 - 每个资源对应一个 SQLite 数据库(WAL、预处理语句)。你的数据会保留在自己的设备上。
- 只评分一次,按收益排序。
(expected clicks × yield × certainty) / effort。使用覆盖索引,因此即使 GSC 表增长到数百万行,审计依然快速。 - 谨慎保护历史数据。 在新数据开始到达之前,抓取和同步都不会销毁之前的快照——即使抓取过程中网站中断,也不会丢失数据。
- 仅处理自有网站,修复采用试运行模式。 它会抓取你控制的网站,生成器只会返回产物,不会写入你的网站。这是我绝不会逾越的底线。
隐私与数据
你的 Search Console 数据和抓取结果保存在 SAC_DATA_DIR 下的本地 SQLite 文件中。页面评分模型也在本地运行。除非是你主动触发的 API 调用,否则不会有任何数据离开你的设备——这些调用会发送给 Google(你自己的 GSC;如果你设置了 CRUX_API_KEY,还会调用 Chrome UX Report,并发送你的来源和首页 URL)、以及你配置的 DataForSEO 和 Majestic(link_intersect 会发送潜在客户的域名;pull_backlinks 会发送你自己带有反向链接的页面 URL)。这些服务都由你提供密钥,按需调用,并在本地缓存,因此不会重复调用。内容侦察会直接请求竞争对手的公开页面,中间不经过任何服务。抓取也会以一种方式访问你自己网站之外的内容:每次抓取后,它都会检查你页面上的出站链接(对每个链接 URL 发送 HEAD 请求或范围 GET 请求;checkExternal:false 可关闭此功能)。免费的附加功能也会从公开来源获取数据:本地模型会从 Hugging Face 下载一次,resolve_entities 会查询 Wikidata,news_discovery 会读取 Google News 订阅源。没有遥测。完全没有。
后续计划
我接下来要开发的一些功能,大致按顺序排列:
- 按模板提供结构化数据机会。 不是说“你没有 schema”(大多数现代商店都有不少),而是指出“这个模板可以获得评论星级或 FAQ 富媒体结果,但目前还没有。”
- 逐页内容评分卡。 专用表格列出文案中遗漏的所有排名词组,而不仅仅是排名最高的查询。
- 进一步提升 Agent 就绪度。 提供 WebMCP 建议(你的网站可以向 Agent 开放哪些工具操作)和 Agent 商务协议。
- 可打印的报告。 一份正式的 A4 文档,可以交给客户,而不是幻灯片。
- 源代码级解析器检查。 这是大多数工具不会触及的层面:可能悄然破坏
<head>解析的元素,以及被提升到正文中并遭到忽略的指令。(现在已支持原始内容与渲染内容的差异检查——参见上文的 JavaScript 渲染部分。)
遇到了希望工具能发现的特殊边缘情况?告诉我——合并 GSC 与抓取检查功能正是这样开发出来的。
关于 Houtini
Houtini 的存在只有一个原因:减少你的团队浪费在繁琐工作上的时间。导出 Search Console 数据、运行抓取、交叉核对电子表格、重新检查自上个月以来的变化——这些工作都不需要人来做,却占用了团队本应投入策略、客户和业绩增长工作的时间。因此,我们只专注于自动化这一层。SEO Audit Console 是一系列遵循相同理念构建的工具之一——如果机器能够收集、合并和检查数据,就应该交给机器来做。
如有疑问、许可相关问题,或想要自动化的工作:[email protected]
致谢
SEO Audit Console 基于若干第三方服务构建——除你自己的 Search Console 访问权限外,其他服务均为可选,且仅在使用你提供的密钥时调用:
- Google Search Console——你自己的搜索表现历史记录(唯一必需的凭据)。
- DataForSEO——SERP、关键词、Labs 和反向链接数据:关键词搜索量、竞争对手的覆盖情况、排名历史记录,以及
link_intersect域名交集。按需付费,可选。 - Majestic——为
link_intersect丰富数据层提供 Trust Flow 和 Topical Trust Flow,根据真实的编辑权威性重新排序链接潜在对象。Trust Flow 和 Topical Trust Flow 是 Majestic(Majestic-12 Ltd)的商标。可选;可在其套餐页面获取密钥。
本项目使用 better-sqlite3、cheerio、Apache ECharts 和本地 ms-marco cross-encoder(通过 Transformers.js)构建,用于在设备上对段落进行评分——此过程不会有数据离开你的设备。
贡献
欢迎提交问题和 PR。检查项注册表(src/audit/checks.ts)易于扩展——每项检查都会对联结后的数据进行纯读取,并返回包含证据的发现,因此添加检查相对独立。端到端冒烟测试(npm run smoke)和各功能探测(npm run probe:*)可帮助你确保代码质量。提交 PR 即表示你同意,根据项目的 LICENSE(Apache-2.0)对你的贡献进行许可。
许可证
Apache License 2.0。 可免费使用、修改和再分发,包括用于商业用途——完整条款见 LICENSE。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。