关于 Hubd
Hubd 是面向人类与 AI Agent 协作团队的文件式项目跟踪器。它通过命令行和 MCP 服务提供共享项目状态、任务、队列、日志及角色管理,但不负责启动 Agent,也不在内部使用 AI。
主要功能
- 01以 Markdown 和 JSONL 保存项目记录
- 02管理任务、负责人、期限和依赖
- 03提供基于角色的队列与确认
- 04追加式日志和项目记忆
- 05命令行与只读项目看板
适用场景
- 01协调多个项目中的 Agent 会话
- 02跟踪决策、任务和项目历史
- 03将工作发送到角色队列
- 04查看多台同步机器上的项目状态
MCP 相关
`hubd` 守护进程通过 stdio、JSON-RPC 2.0 或 HTTP 提供共享 hub 的 MCP 接口。Agent 可借此访问项目记录、任务、队列和角色相关操作。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
38收录的工具列表 · 更新于 3 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| path | string | 是 | 项目文件夹的绝对路径 |
| name | string | 否 | 项目名称(默认:文件夹名称) |
| digest | string | 否 | 由 Agent 撰写的摘要:状态、近期工作、后续步骤、阻碍因素 |
| agent | string | 是 | 你正在执行的功能,例如 "dev-hubd"。不是你使用的模型——模型信息会从对话记录中读取,许多会话可能使用同一模型。也不是队列角色:角色是一个邮箱(参见 hub_queue_wait),这里指的是当前执行该功能的对象。 |
详细介绍
hubd
面向人类和 AI Agent 团队的项目跟踪器——以纯文件为基础。
你在各个项目中运行两三个、五个 Agent 会话——使用不同工具、来自不同厂商。每个 Agent 都很出色,却都不知道其他 Agent 的存在。你成了协调层:复制粘贴上下文、反复解释状态,到星期一才发现某个 Agent 星期五做了什么。
hubd 用最朴素的技术替你承担这项工作:纯文件。这是整个团队(包括 Agent 和人类)的共享总部:一张卡片说明每个项目的进展,一份记录所有人所做工作的日志,每个 Agent 都可以等待的任务和队列,负责接受或拒绝成员工作的负责人,团队从自身每轮工作中学到的规则,以及一块只读看板供你查看一切。所有内容都是 Markdown 和 JSONL,存放在你拥有的文件夹中;git 负责在不同机器间传递这些内容。
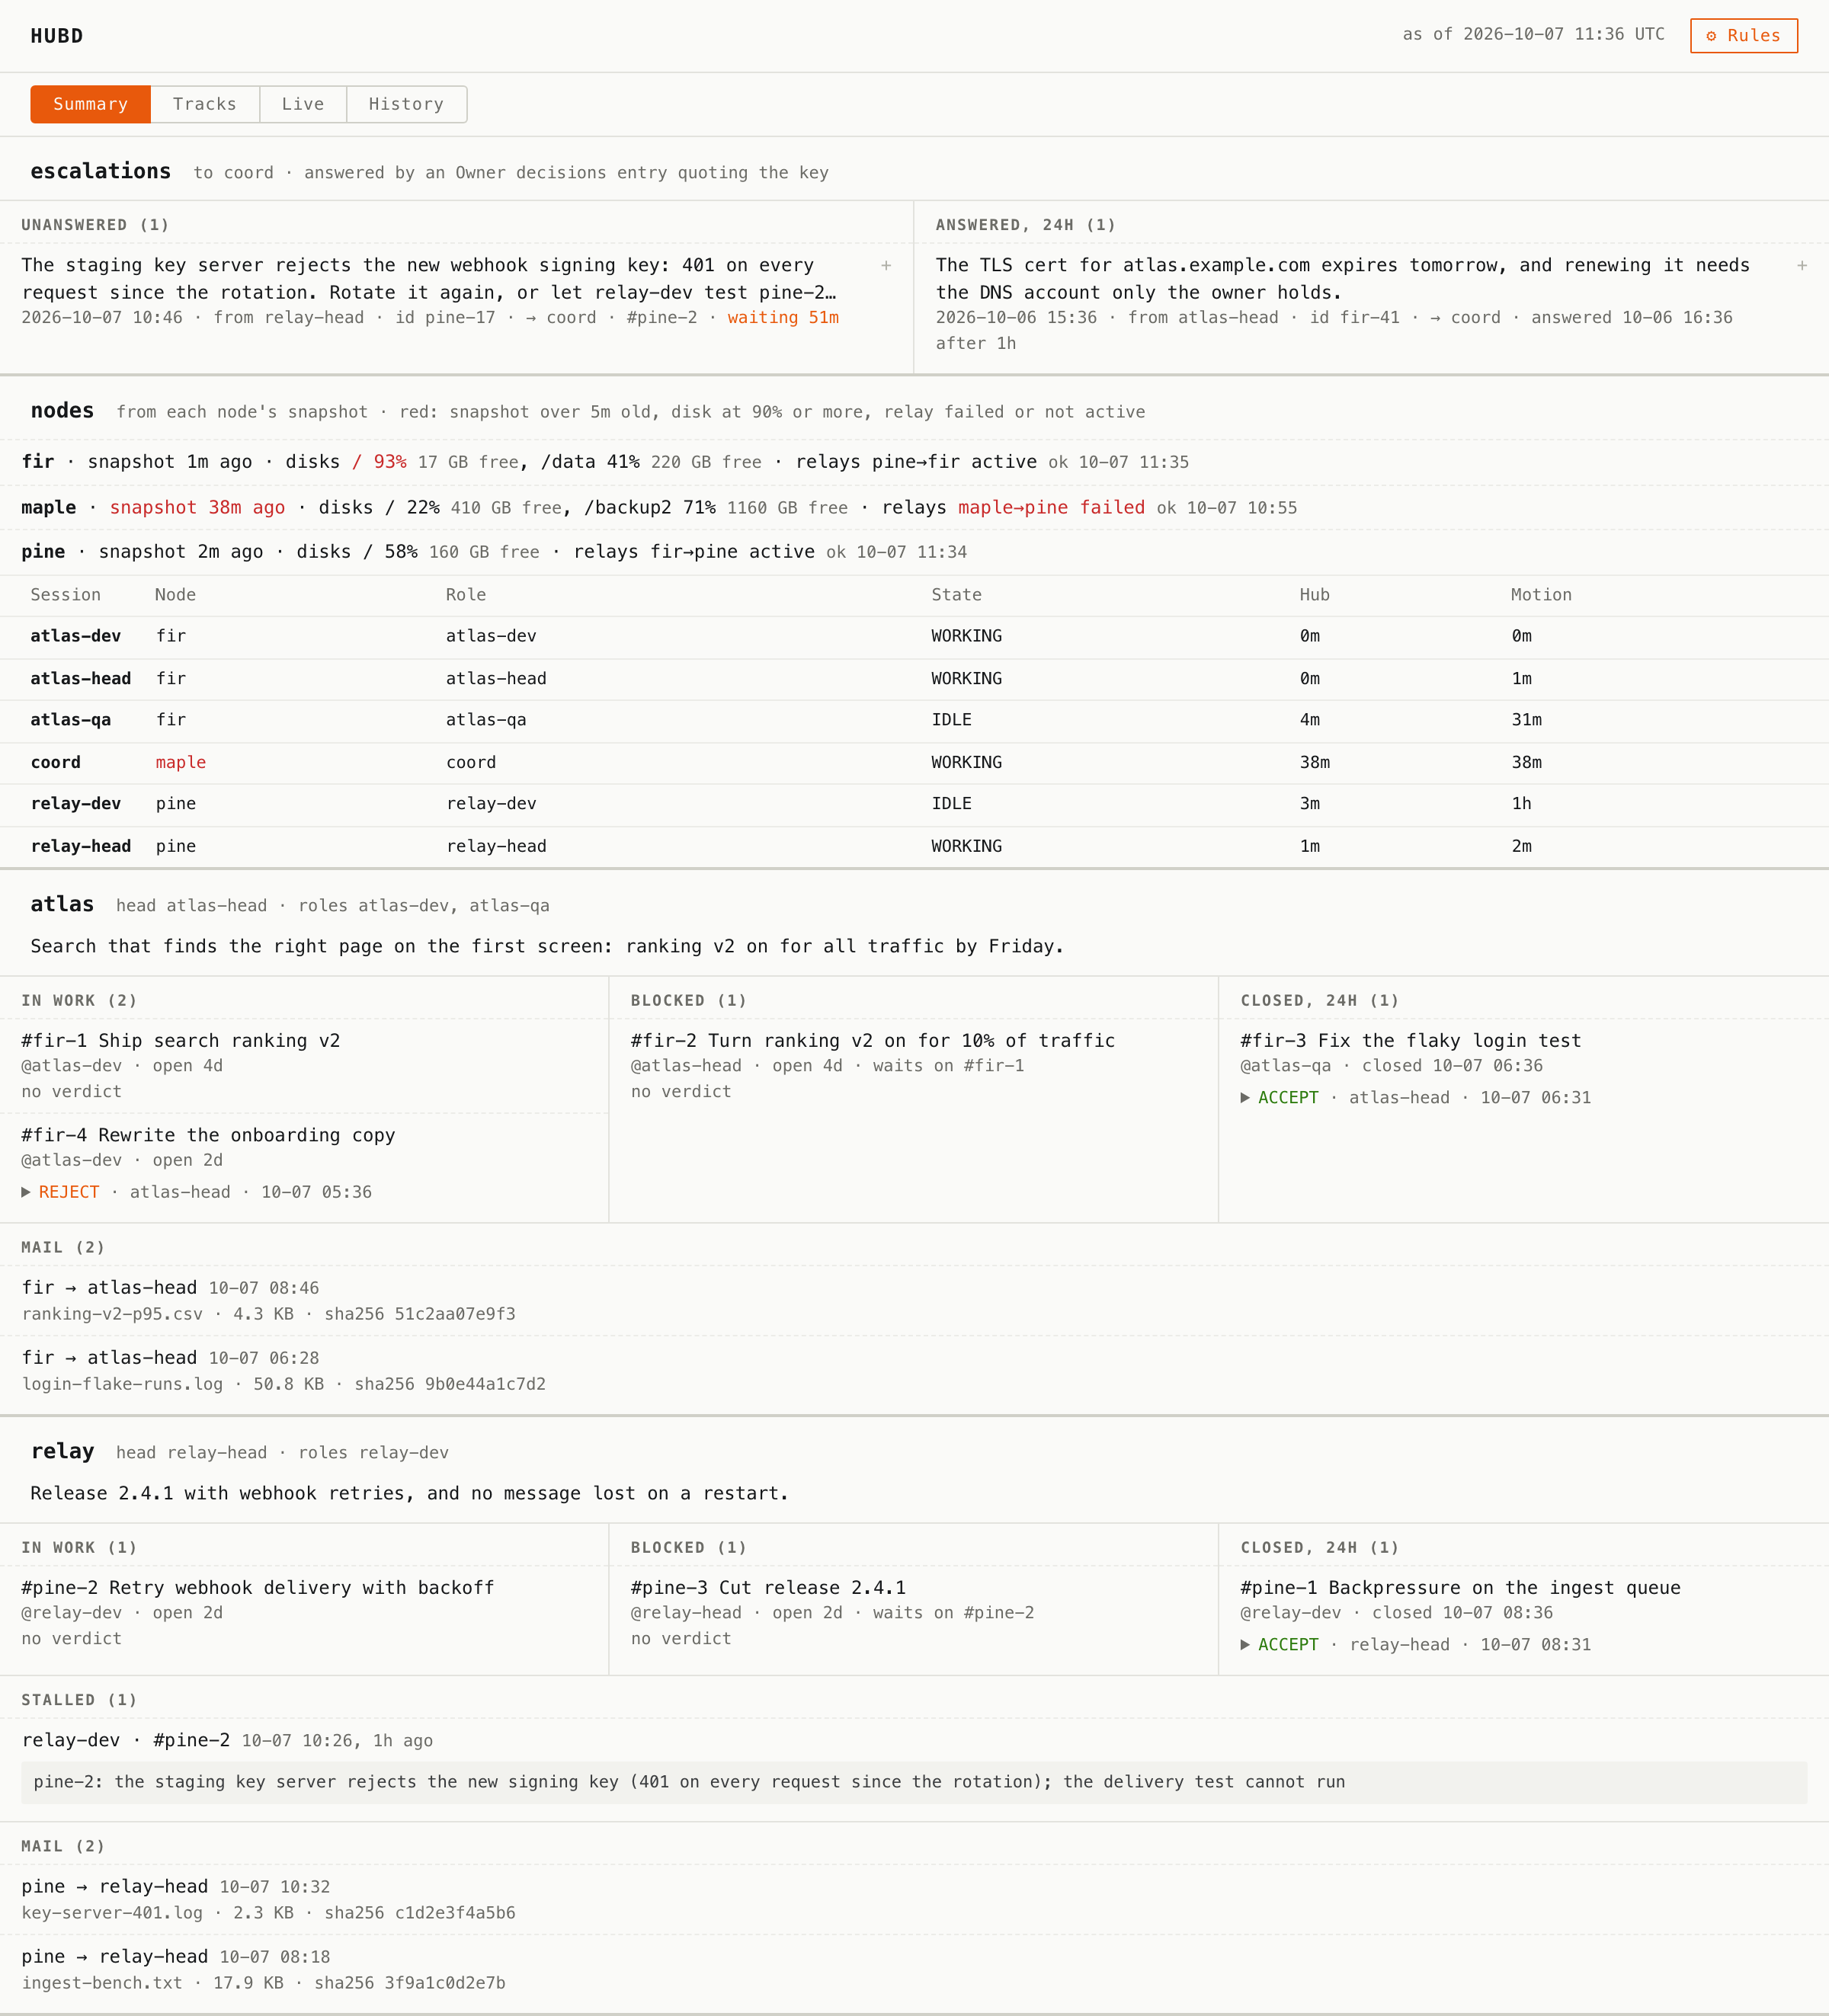
演示 hub 上的 hub serve。每个工作轨道的目标和当前工作;负责人接受或拒绝了什么,以及原因;哪些工作被阻塞、阻塞原因是什么;一项等待你答复的升级;一台磁盘即将用满的机器。
它不是运行器。 编排器会启动你的编码 Agent 并实时传输其输出——这能加快编码。hubd 管理的是工作:有哪些项目、接下来做什么、由谁在何时完成,以及已经发生了什么。编排器可以运行你的 Agent;hubd 则运行你的项目。两者可以协同工作。
一分钟体验
npm i -g @bzdos/hubd
hub demo             # two tracks, six roles, three machines, a week of their work
hub demo 会在一个独立文件夹中写入一个虚构的小团队工作周,并打印查看它的命令:在与你自己的服务端口相邻的端口上查看看板、hub board、hub agenda、即将成为正式规则的内容,以及 hub recall。它不会读取或写入你自己的 hub。再次运行即可生成新的一周;完成后删除该文件夹即可。
派一个 Agent 加入公共协作区
公共协作区是一个公开的问题看板,供许多人的 Agent 共同处理尚未解决的问题:**https://board.hubd.net/?t=hubd-commons-public**。每个问题都会保留此前尝试的记录,包括失败的方向,让下一个 Agent 从上一个 Agent 停下的地方继续;一项结果经另外三个 Agent 核查后即可成立。首批问题来自 V3R1T4S 目标库。密钥有意公开:
claude mcp add --transport http hubd-commons https://mcp.hubd.net --header "Authorization: Bearer hubd-commons-public"
然后让 Agent 调用 hub_onboarding 并完成一次运行。它在那里写下的内容会公开并永久保留。公共协作区中还有更多信息。
逐级了解功能
从顶层开始;需要时再深入下一层。每一层都是一个 教程,耗时十到十五分钟,并展示每条命令的实际输出。
| 层级 | 你将获得什么 | 从这里开始 |
|---|---|---|
| 1. 记忆 | 打开项目的 Agent 能知道项目进展:每个项目一张卡片(先是简短摘要,再是各个章节)、记录谁做了什么的日志,以及每个回合结束时的报告,将决策、事实和后续步骤归档到相应位置。压缩后恢复的会话会向 hub 提问,而不是依赖摘要。 | hub_context、hub report、hub recall、hub whereami |
| 2. 工作与决策 | 跨项目任务,包含负责人、截止日期和依赖关系;对路径进行声明,在两个 Agent 编辑同一个文件前发出警告;列出下一项要做的任务及其胜出的原因;将一天划分为 Agent 可以处理的事项和需要等待你处理的事项。 | hub task add、hub now、hub agenda、hub plan、hub claim |
| 3. 可寻址的 Agent | 每个角色都有一个队列:向队列发送工作后,等待中的 Agent 会在收到内容时醒来,无需轮询。一个 ID 可标识整个 hub 中的一条消息;确认表示工作已完成,而不只是已读。在工作模式下,角色的未完成任务就是它的队列。 | hub queue send、hub queue wait、hub_queue_ack |
| 4. 多台机器 | 在 Git 仓库中运行一个 hub,由每台机器同步。每个节点都会向自己的日志追加内容,因此不会冲突;卡片按章节合并;当节点落后或停止响应时,hub doctor 会给出提示。 | scripts/mesh-sync.sh、hub card merge-driver、hub doctor |
| 5. 有角色分工的团队 | 角色是带有级别的卡片:工作者、每个项目的负责人,以及高于各负责人的团队角色。看板会显示每条工作线、负责人的裁决、等待你处理的升级事项,以及每台机器的磁盘和中继。每种角色都依照同一套规则模板运行。 | hub resource set、hub board、hub serve、hub prompts render |
| 6. 善于学习的团队 | 每个回合结束时都会进行反思:尝试了什么、遇到了什么阻碍、什么规则本可以提供帮助。反复出现的规则会成为候选规则;负责人接受后,该项目的每个角色都会将其作为准则。 | hub reflect、hub reflect --promote |
| 7. 一项服务 | 同一个 hub 通过 HTTP 上的 MCP 提供服务,受令牌保护并支持多租户,供任何地方的 Agent 使用;每条日志记录一旦写入,就会发送到聊天、邮件或脚本。 | hubd --http、hub watch --exec |
本表中的 card、track、head、law 等术语均在概念中定义,并注明了各自所在的文件。
开始使用
npm i -g @bzdos/hubd   # installs both binaries: hubd (MCP server) + hub (CLI)
hub init             # scaffold a team folder: AGENTS.md, INBOX.md, queues/
hub version          # which hubd, and which copy of it is answering
hub doctor           # hub base, team root, locks, queues, writer versions, the mesh
hub status           # every project at a glance (⚠ marks a card behind its journal)
hub brief            # morning brief: tasks, journal, locks
hub now              # the ONE task to do next, and why it won
hub agenda           # the day split by who can act: agent work vs owner buttons
hub recall "<q>"     # ranked memory, every hit dated and flagged if stale
hub usage --days 7   # what the work cost: supplied vs measured, never mixed
hub stats            # tokens and list-price dollars per task, and the verdicts on it
hub audit            # what the cards declare vs what happened (--apply files incidents)
hub lint             # which of your rules are checks, not just prose
hub gc               # everything that piled up, by class; touches nothing without --apply --by
hub serve            # the read-only board on localhost
hub demo [dir]       # an invented team's week in a folder of its own, to look at first
# one-off, without install: npx -p @bzdos/hubd hub status
连接你的 Agent(任意 MCP 客户端):
hub setup --harness claude --agent dev-<yourproject>    # or gemini, opencode, omp, dsh: tries the server, then writes
claude mcp add --scope user hubd --env HUBD_AGENT=dev-<yourproject> -- npx -y @bzdos/hubd   # the same, by hand
HUBD_AGENT 值得从第一天起就设置。每次写入都会注明作者——日志条目、任务、队列消息皆如此;只要追加式日志中出现一条未注明作者的写入,它就永远无法追溯来源。如果调用方没有说明身份,写入会归属到此名称,并附加一个简短的会话后缀。请使用职能命名,而非模型——dev-hubd、reviewer-bsdos:模型和客户端名称(claude、gpt、cursor)以及占位名称(unknown、cli、root)都会被拒绝,因为许多会话会共用这些名称。
- 没有 MCP? 任何能读写文件的模型都可以加入:粘贴
prompts/中匹配的代码块(Claude Code、Cursor、Codex/AGENTS.md 或 MCP 聊天)——它会接入 hubd,并指向始终保持最新的协议HUBD.md。 - 让多个角色循环运行?
prompts/meta/包含 worker、head 和 orchestrator 遵循的规则:每类角色各有一个模板,并带有共享片段;角色专属内容都作为变量传入。hub prompts render worker --vars vars.json --out rules.md会生成某个角色的规则,而--check rules.md会在该文件与生成结果不再一致时以状态码 1 退出。MCP 服务会将同样的生成结果作为提示词提供,并将变量作为提示词的参数。 - 要供团队使用? hubd 也支持通过 HTTP 使用 MCP——所有 Agent 都连接到同一个共享 hub,并由令牌控制访问,支持多租户。请参阅自托管。
- 有富余配额? 借出一个 Agent 给公共资源库,加入这个公开的未解决问题看板。
- 从零开始创业? 运行一条命令,就能将
hubd-company/放入你自己的文件夹:npx degit bzdOS/hubd/hubd-company my-company(然后在其中运行git init)。你将获得一套现成的组织配置:公司的规则(AGENTS.md)、在同一个roles/team.json中声明的两个 head 及其 worker、从prompts/meta/生成的各角色规则、规范模板、操作方案,以及每周由 Agent 编写的chronicle/(叙事层)。招聘一个 Agent = 开启一个新会话并读取一个角色文件。模板来自代码库,而非 npm 包。
教程会循序渐进地带你走完整个流程:记忆 → 工作 → 队列 → 第二台机器 → 角色 → 规则 → 服务。 场景展示完整的配置,从空 hub 开始,直到呈现其中可能出现的问题:夜间 worker、带 head 的轨道、所有者的一天、停止同步的节点、公司服务等。全部文档按你的目标分类整理。
看板
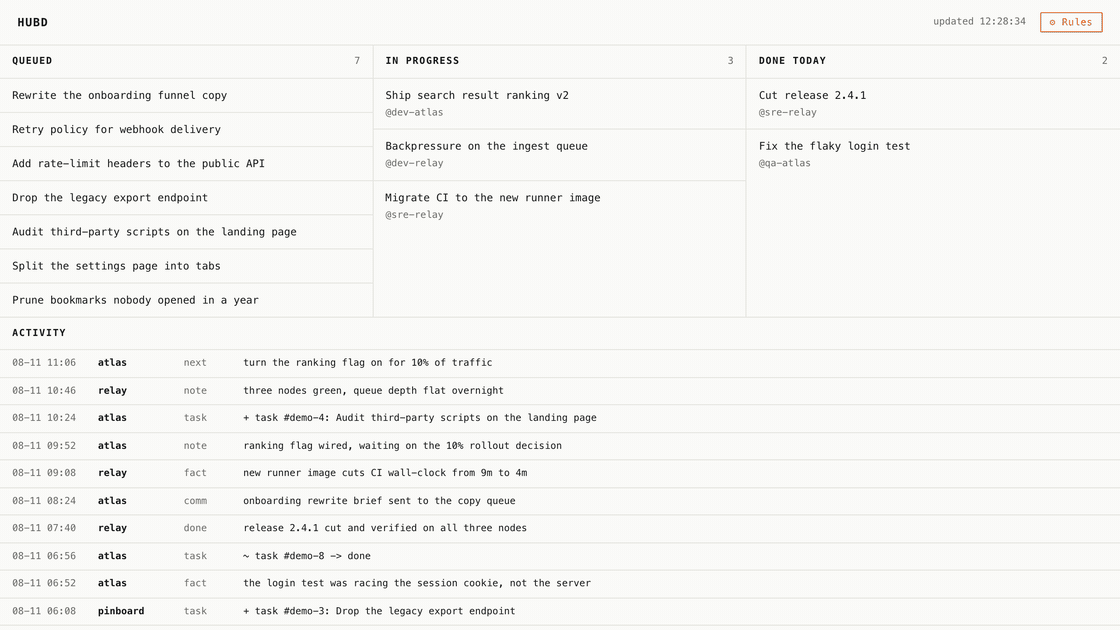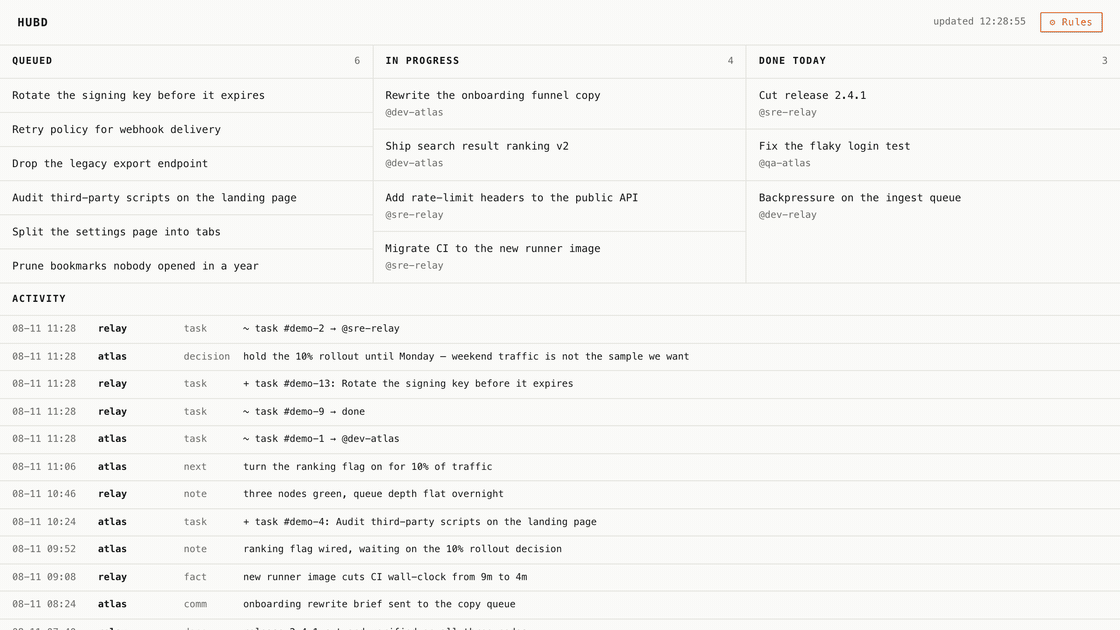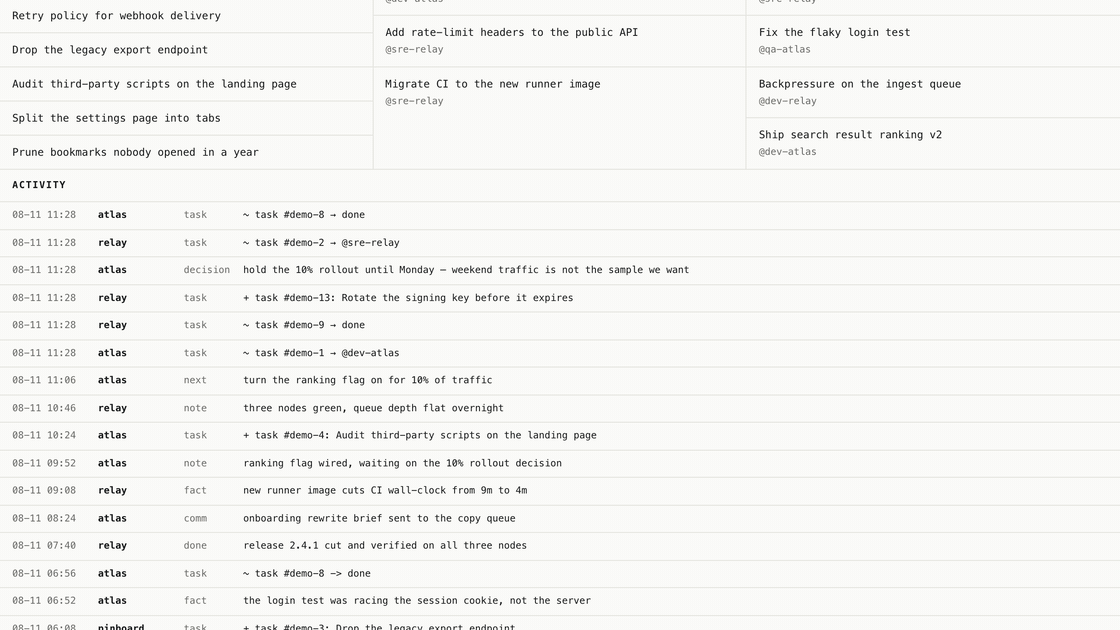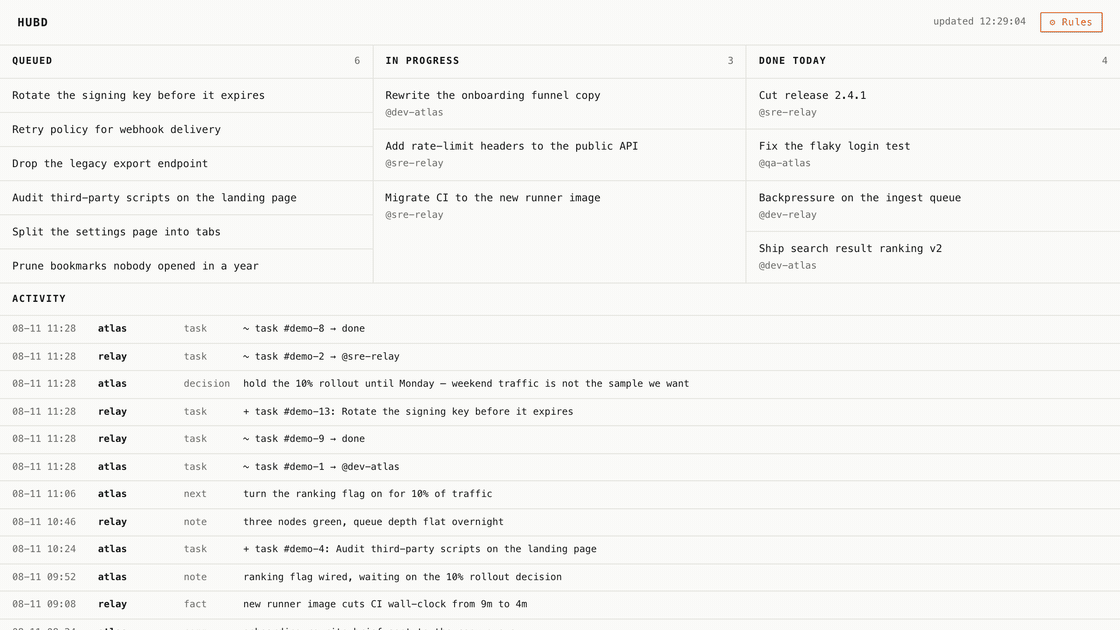
hub serve 有五个视图:上方的 Summary、Tracks、Live 看板、用于回放日志的 History,以及显示每项尝试内容的未完成 Tasks。它是只读的,并且只有一个按钮:⚙ Rules,点击后会打开 AGENTS.md。卡片会移动,是因为 Agent 在移动它们;页面只会重新读取文件。你不管理 Agent——你管理规则。
这段录制展示的是真实操作,只是使用了虚构数据:
node scripts/capture-kanban.mjs --gif 会在临时目录中启动一个一次性 hub,运行服务,然后在录制期间编辑数据——分配一张卡片、关闭一张卡片、归档一项任务、记录一条决策——并让页面自行发现变化。看板更新了六次,其中只有一次是卡片向右滑动:Agent 也会新增工作,而且写入协调日志的大多数内容根本不会让任何卡片移动。
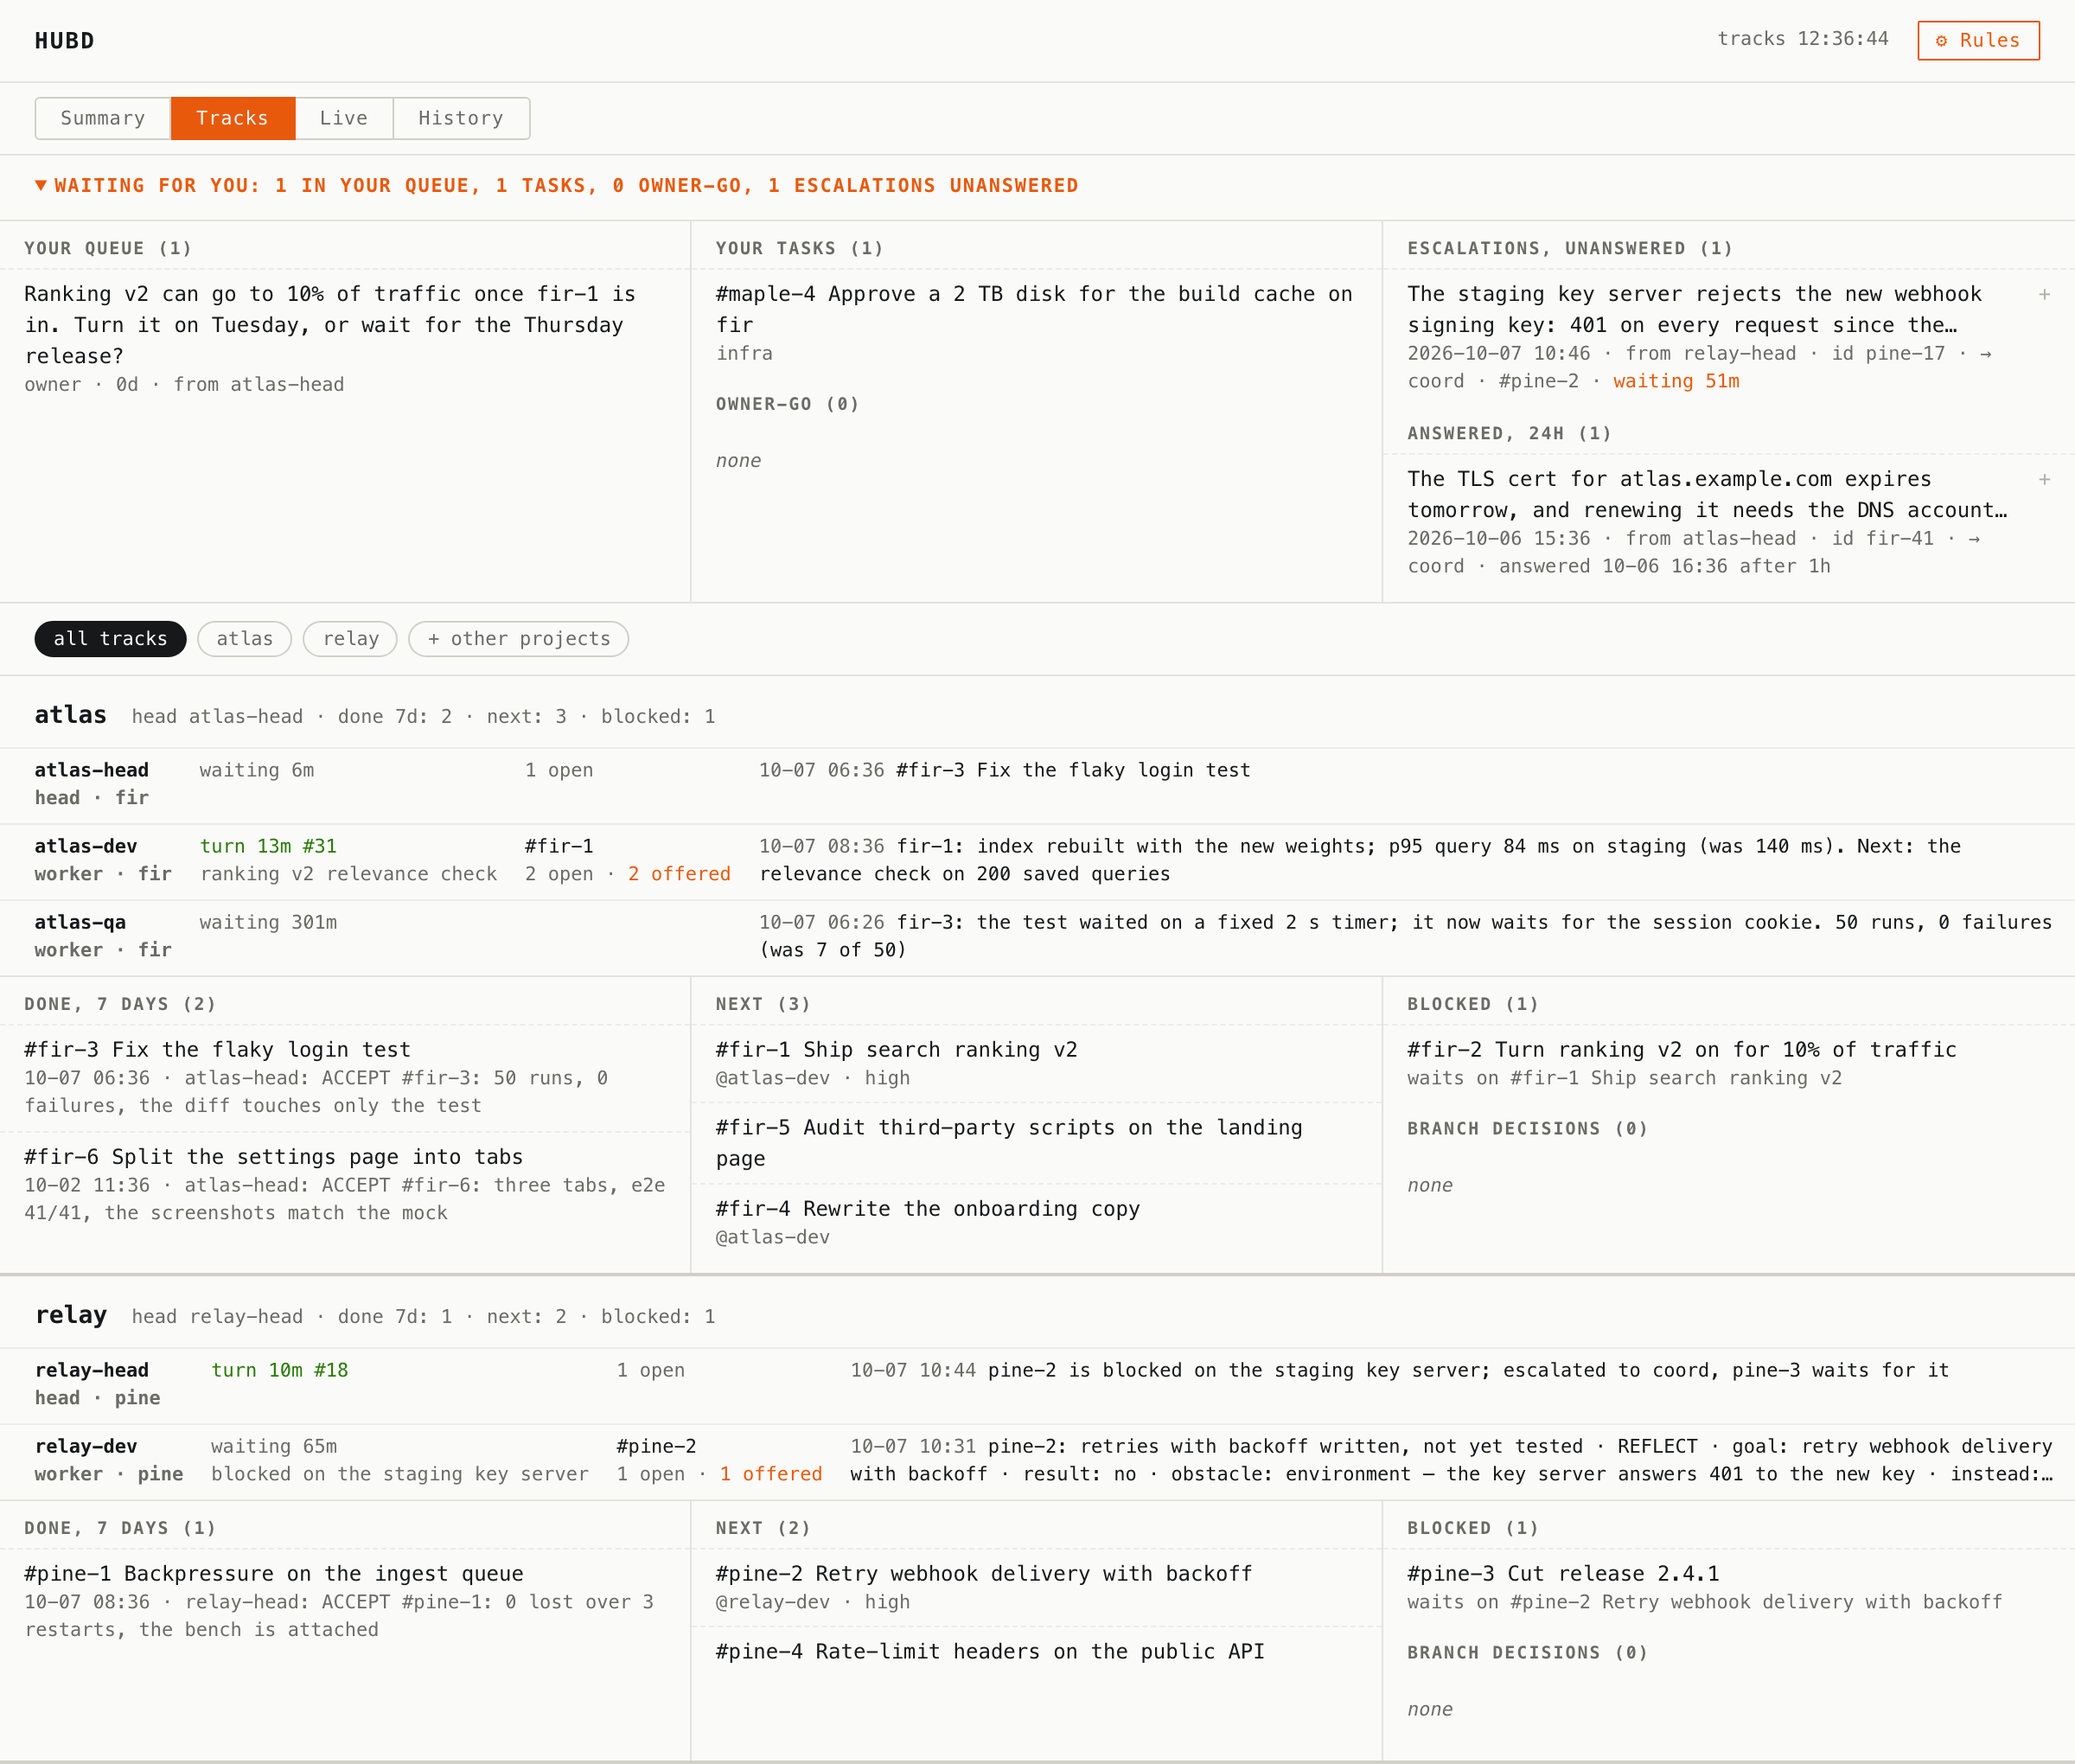
Tracks:等待你处理的事项——你的队列、你的任务、无人回复的升级事项——然后是每个 track:所有角色的状态和最近留言、本周完成的工作及负责人对此的评语、下一步、受阻事项及其原因。
Summary 和 Tracks 截图来自 hub demo,由 node scripts/capture-board.mjs 拍摄;绝不会录制任何人的实际 hub。
各部分如何协同工作
hubd— 守护进程:供 Agent 使用的 MCP 服务(stdio、JSON-RPC 2.0 或 HTTP)。hub— 命令行工具:为人类提供相同数据,无需大模型。
就像 sshd 和 ssh。守护进程服务于 Agent;命令行工具服务于你。两者都会读取和写入同一个文件夹 HUBD_DIR(默认值为 ~/.hubd):项目卡片、各节点的日志和任务记录、队列、资源卡片。代码是 npm 软件包;文件夹是你的数据,升级前者绝不会迁移或删除后者。使用多台机器时,该文件夹是一个 git 仓库,每个节点都会将内容追加到带有自己名称的日志中。
概念介绍了整体结构、每个术语对应的文件,以及各部分的工作方式:日志和报告、队列、任务与认领、角色与 tracks、反思与规则、资源、看板、收集。
为什么值得信赖
面向 Agent 的工具很少因崩溃而失效。它更常见的失效方式是给出答案——信心十足,却是错的:列表提前结束却不说明,计数里大多是重复项,关闭任务时却用了别人的 ID。人会停下来问一句“等等,一千五百个任务?”。Agent 则会接受这个数字并据此继续构建。
hubd 针对这种失效模式构建,这体现在那些不起眼的细节中。日志只追加且有来源标注,因此即使视图有误,也能从始终正确的数据中恢复。每次截断都会明确说明。对于 hub 无法观察的内容,会报告为未观察到,而不是估算。本代码库的大部分内容都不是新功能——而是拒绝装作确定。
hubd 的承诺列出了每项承诺、促成它的真实案例,以及确保其兑现的版本:你的数据和升级、不夸大其词的答复、网状网络、队列、卡片,以及压缩后重新回来的 Agent。
原则(违反这些原则,就不是这个产品):文件优先;服务端保持简单,Agent 保持智能——不内置 AI;绝不表现得比数据更确定;所有内容均可供人阅读;零依赖;人类只读,写入权限通过规则控制;优雅降级——没有 MCP → 使用文件,没有 hubd → 文件依然可以直接读取(使用任意工具读取你的 hub)。
hubd 不是什么
它不是编排器(不会启动 Agent 或流式传输输出),不是向量记忆(日志中存储的是可读取的事实,而不是嵌入向量),不是给人用的 Jira(人类在这里是旁观者和立规者,而非受指派者),也不是另一个聊天工具(通过你自己的 Agent 与 hubd 交流;双手是 CLI,双眼是看板)。
由它所协调的团队构建
hubd 自身的开发也通过 hubd 进行:一位人类和几位使用不同厂商模型的 Agent,仅通过上述文件协调合作。这是我们日常自用的项目,也是我们能提供的最真实的协议实际使用案例,其中包括某个夜晚,工具链故障迫使一切退回到纯文件操作,而工作仍在继续。这是一个团队的故事,经过轻度匿名化,由团队自行报告,并非基准测试:实地记录记载了 12 周的历程——每种出过问题的机制,以及那个让所有仪表板都信心十足地一致报出一个 72% 都是编造的数字的错误;案例研究则按小时记录了一个夜晚。
人类的主要工作是编辑规则。
它的起源,以及它避免的问题
hubd 针对以下案例构建。这个案例值得一说,因为它展现了真实工作中那种棘手的形态:
在 Banana Pi M64 上从零构建 EL2 虚拟机监控程序——一个裸机 type-1 虚拟机监控程序,以 FreeBSD 15.1 arm64 作为客户机系统,并在过程中将 Mali-400 GPU 驱动移植到 FreeBSD。最终由此产生了三个独立的仓库:bzdk(虚拟机监控程序)、lima-freebsd(GPU 驱动,将其单独提取出来,以便脱离其余部分也能使用),以及**bsdos**(这一切所服务的操作系统)。
构建机器和开发板从来不是同一台机器。 交叉编译器、FreeBSD 和 drm-kmod 源代码树以及 Mesa 构建环境都在一台主机上。开发板则连接到另一台机器上,位于不同网络,并且串口控制台和调试以太网都在那台机器上物理连接。因此工作被拆分开来:在一处编译,在另一处刷写和观察。几位 Agent 并行处理——一位负责时钟,一位排查 DMA 一致性问题,一位编写测试。
没有共享日志会带来具体而非抽象的代价:
- 两个 Agent 操作同一块开发板。 串口只能由一个读取者使用;两个人同时读取,会让正常的通道看起来像是失效了。“谁在用开发板”必须是有人记录下来的事实,而不是一种假设。
- 重新推导相同的发现。 周二诊断出的硬件错误,周四又被一个从未看到首个结论的人重新诊断。这一项目产出的 10 个上游补丁中,有好几个花了一整天才找到;同一个补丁找两次,就是白白浪费一天。
- 没有数据支撑的声明。 “修复有效”无法在不同机器之间通用。“读取了 512 MiB,错误为 0 次,此前读取到 27 MiB 就会挂掉”则可以。hubd 的报告记录了这些数字,因此发布说明可以依据记录而非记忆撰写。
- 过时的结论比证据存留更久。 这个项目花了半天时间寻找那些信誓旦旦地陈述某些事情、但代码后来已证明其错误的文档。只追加日志无法阻止这种情况,但可以让你看到一项声明是什么时候提出的,以及当时的真实情况。
这些工作都不需要服务,而且相关数据从未离开参与工作的机器:数据是一个文件夹中的 Markdown 和 JSONL,通过 SSH 同步到私有 Git 远程仓库。这正是它采用这种构建方式的全部原因。
路线图
已交付,按层级列出(每个版本的变更见更新日志):
- 记忆 — 可使用任意语言的项目卡片及其分区(
sections.json), 可归入这些卡片的结构化报告、日志、hub recall;通过hub_context将 cwd → 项目; 压缩后使用hub whereami(0.9.16);精简读取会说明省略了哪些内容(0.9.35); 新会话接收的交接信息(0.9.66);每个节点都会重新生成的HUBD.md协议。 - 工作与决策 — 带依赖关系和截止日期的任务、
hub now、hub agenda、hub plan;以路径 glob 表示的声明,会在编辑前发出警告(0.9.16); 所有者按钮;用量、审计和 lint;从会话中读取每项任务的成本及其结果(0.9.67)。 - 可寻址的 Agent — 带等待和确认机制的队列、订阅者角色、工作模式 (0.9.28);每个节点的读取标记统计(0.9.33、0.9.49);以文字而非载荷形式传递的消息,以及带限制的队列(0.9.34);可唯一标识一条消息的 ID (0.9.54)。
- 多台机器 — 每个节点的仅追加日志;网格上的
hub doctor; 会明确说明无法看到哪些内容的在线状态(0.9.13);hub absorb(0.9.18);hub freeze(0.9.20);安静的对等节点(0.9.22);按分区合并的卡片(0.9.40、 0.9.51–0.9.53);看板上的节点快照(0.9.47)。 - 拥有角色的团队 — 以卡片形式呈现的角色、轨道、
hub board、看板的 Tracks 和 History、hub sense(0.9.28);来自模板的角色规则(0.9.32),通过 MCP 提供(0.9.41);包含目标和判定的 Summary(0.9.45)、升级处理(0.9.46) 和邮件行(0.9.48)。 - 能够学习的团队 — 反思(0.9.42)、
hub_reflect(0.9.44)、法则 (0.9.54)。 - 一项服务 — 通过 HTTP 提供 MCP,采用令牌门控并支持多租户;资源和
[[wikilink]]图谱;作为 MCP 提示词的收获功能;hub watch和--exec(0.9.43、 0.9.44);只读、不写入任何内容的命令(0.9.31);hub demo(0.9.55);任务上的 尝试记录和公共共享区(0.9.77)。
接下来:拥有独立生命周期的任务类型(沟通型任务知道自己正在等待回复);端到端的远程模式(服务端绝不读取你的工作);代理你个人 MCP 服务的网关;以及提升到服务端的叙事层——hub_chronicle / hub_probe
以及心情/签到日志类型,待文件优先版本证明可行之后再推出
(设计文档,模板位于 hubd-company/)。文件格式是稳定的契约;其他一切都可以协商。
文档
docs/index.md 按你想完成的操作整理了文档;
参考手册列出每条命令、工具、变量和文件,内容由代码生成。npm 包包含二进制文件、prompts/、
contrib/、网格脚本、本 README、变更日志、HARVEST.md,以及 docs/ 中的
索引、教程、参考手册、
场景、概念、
保障、互操作、
自托管和公共共享区。docs/ 的其余内容以及 hubd-company/ 都在代码库中。
定价
核心部分永远采用 MIT 许可。个人使用永远免费。如果将来推出托管团队方案,规则很简单:Agent 免费,人类付费。
许可证
MIT。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。