关于 Stratigraph
Stratigraph 是面向大型 Java、Kotlin 和 Angular 代码库的本地分析及 Spring Boot 升级命令行工具。它生成带引用的架构与历史图谱,并以现有测试判断升级变更。
主要功能
- 01带引用的依赖与架构图谱
- 02基于 JPA 和迁移文件的 ER 图
- 03端点关联与历史热点分析
- 04用于 CI 质量门禁的运行差异
- 05由测试判定的 Spring Boot 升级
- 0613 个只读 MCP 分析工具
适用场景
- 01梳理旧版单体应用的依赖
- 02查找数据库表和 HTTP 端点
- 03审查拉取请求新增的循环依赖
- 04升级 Spring Boot 并检查测试
MCP 相关
`stratigraph mcp` 命令会启动 MCP 服务,提供 13 个只读代码结构查询工具,包括 `what_breaks_if`、`who_knows` 和 `where_is_table_written`。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
stratigraph
在升级 Spring Boot 时,以测试结果作为评判标准;为大型 Java、Spring 和 Angular 代码库绘制地图,并为每项结论提供引用。




网站: https://imashishsharma.github.io/stratigraph/ · 开源,可在本地运行
🔁 升级 Spring Boot(2.7 → 3.5、3.x → 4.0)、Maven 或 Gradle
npx stratigraph upgrade plan --to 3.5               # read-only: what will break, with file:line citations
npx stratigraph upgrade run  --to 3.5 --ai claude-code
OpenRewrite 的 recipe 能完成大部分升级工作。升级 Agent 会处理剩下的问题,适用于 Maven 和 Gradle 构建。
- 测试结果说了算。 在修改代码之前,它会记录每项测试的结果。只有当构建取得更大进展,且没有任何通过的测试变为失败时,才会保留修改。禁用或删除测试会被直接拒绝。
- 分层、可审查的提交会放在独立分支上:包括 recipe、确切已知的修复,以及 Claude Code 提供的 AI 修复(可选择启用)。为通过测试而修改的应用代码会被标记,以供审查。
- 它知道何时该停下。 授权规则或 HTTP 契约绝不会由它替你决定。它会在
upgrade-report.md中列出这些问题,并附上证据和选项。
| 基准测试(详情) | 仅使用 OpenRewrite | stratigraph |
|---|---|---|
| 10 个公开的 Spring Boot 应用:所有先前通过的测试仍通过,无需人工编辑 | 0 / 10 | 5 / 10(另有 2 个因需要做出实际决策而停止) |
| 它从未处理过的 9 个应用(详情) | — | 8 / 9 |
| Gradle:realworld-example-app、JHipster 7.9(详情) | — | 68/68 一致;JHipster 在 1 个错误处停止(需要 JHipster 8) |
| 每个应用耗时和 AI 成本 | — | 1–14 分钟,$0–2.54 |
🗺️ 为无人记得的代码库绘制地图
npx stratigraph scan . # extract, mine git history, analyse, write the report: one command
- 架构: 可部署单元、包及其依赖关系、循环依赖,以及涵盖全部四个层级的 C4 图。
- 数据模型: 根据 JPA 以及 Liquibase/Flyway 绘制 ER 图,并展示两者之间的偏差。
- HTTP API 和风险: 端点、Angular → Spring 调用关系、按近期变更量 × 复杂度识别的热点,以及知识孤岛。
- 每项结论都引用文件和行号或提交。 每个视图都会说明其依据的代码量;依据不足时则不会显示。
- MCP 服务(
stratigraph mcp):提供 13 个只读工具,例如what_breaks_if、who_knows和where_is_table_written,可供 Claude Code、Cursor 或任何 MCP 客户端使用。
在 20 个公开代码仓库上以人工标注的真实情况为基准进行测量:实体和表的召回率为 100%,端点召回率为 99%,已解析的 DI 边为 95%(评分卡)。
地层学是考古学家解读遗址的方式:逐层分析,根据上下层的关系推断事件发生的顺序。stratigraph 对大型代码库做的也是同一件事——读取源代码和 Git 历史,还原代码库如何演变成现在的样子。
面向 10 万行代码以上、没人记得当初为何如此构建的单体应用和多模块构建项目。首先支持 Java、Kotlin 和 Angular。它可以分析无法编译、从未安装过 node_modules,或采用 Ant 时代之后就无人使用的目录布局的代码库——因为恰恰是这些代码库,没人记得了。
代码库地图详解
- 事实图谱 — 包、类、方法、端点、DI 边、路由、O/R 映射——全部存储在本地 SQLite 文件中,每条记录都会注明来源文件和行号、提交 SHA,或读取该记录的构建文件。
- 可据以行动的历史信息 — 按变更频率 × 复杂度排序的热点、历史记录只有一个贡献者的文件,以及反复同时变更、但代码中毫无关联的文件。
- 四个层级的 C4 图、从 O/R 映射中读取的 ER 模型、HTTP 接口,以及按优先级排列的问题列表——可输出为 Structurizr DSL、Mermaid,或独立 HTML 页面:无需脚本、网络或 CDN。
- 两次运行之间的差异,因此 CI 可以因拉取请求新增的循环依赖而失败,同时忽略早已存在的六百个循环依赖——这是遗留单体应用今天唯一能启用的质量门禁。
- MCP 服务,让在代码库中工作的 Agent 可以提出结构性问题,而不必用 grep 搜索答案。
- 可选的、由模型生成的包集群名称和描述——通过代码强制执行引用检查,拒绝任何提及模型未见内容的句子。
六十秒上手
npm install -g stratigraph      # or run every command through: npx stratigraph

cd ~/work                       # the fact store lands here, not in the repo
stratigraph init    --repo ../some-monolith   # create the fact store
stratigraph extract --repo ../some-monolith   # parse the source into facts
stratigraph history --repo ../some-monolith   # mine git: churn, coupling, authors
stratigraph analyze --repo ../some-monolith --no-llm  # cycles, clusters, hotspots
stratigraph report  --repo ../some-monolith --out ./arch
open ./arch/index.html
开箱即可进行 TypeScript 和 Angular 分析——提取器包含在此软件包中,可使用你现有的 Node 运行。Java 和 Kotlin 需要 JDK 17+,以及多执行一条命令:stratigraph fetch-extractor。该命令会下载提取器 jar,并根据固定在此软件包中的校验和进行验证。以上所有操作都不需要 API 密钥:--no-llm 就能生成完整的结构报告,模型只会在此基础上补充文字说明。
stratigraph doctor # says which of these your machine can do right now
目录
塑造一切的规则
静态分析产出事实。LLM 负责解读。LLM 绝不编造事实。
每个节点和边都来自解析器、git log 或构建文件。
生成报告中的每项声明都带有来源引用——文件及行号、提交 sha,或事实表中的行。当模型想要断言某件无法引用的事时,正确的输出是“未找到证据”。
这一点由架构强制保证,而不只是依赖提示词:解读存放在与事实不同的表中,边标记为 fact 或 inferred,而引用行带有 CHECK 约束,确保它指向真实存在的内容。请参阅 ADR-0002。
整个流水线可以使用 --no-llm 运行,仍能生成有用的报告。
在真实仓库上测得
质量通过测量得出,而非凭空宣称(ADR-0035)。
stratigraph bench 会在 20 个公开仓库上运行完整流水线。每个仓库都固定到 bench/corpus.yaml 中的一个提交,并将输出与未使用该工具标注的真实结果进行评分。这些真实结果来自各仓库的源代码、构建文件、迁移文件和 git log,位于 bench/truth/。以下所有数字均来自 bench/scorecard.md,其中逐一列出了每个遗漏项。
| 指标 | 目标 | 2.0 |
|---|---|---|
| 热点前 20 名中的非源代码文件(锁文件、清单、测试、生成文件) | 0 | 0 |
| 热点前 10 名与资深工程师标注列表的重合度 | ≥ 60% | 66%(92/138) |
| JPA 实体召回率(含物理表名) | ≥ 90% | 100%(146/146) |
| 表召回率 | ≥ 90% | 100%(274/274) |
| HTTP 端点召回率 | ≥ 95% | 99%(519/520) |
| 已解析的注入边 | ≥ 85% | 95%(215/226) |
| 识别为容器的可部署项 / 属于可部署项的容器 | 100% | 100%(67/67) / 100%(67/67) |
| 与标签匹配的文件角色 | ≥ 95% | 96%(535/557) |
| 未附带覆盖范围说明的已渲染视图 | 0 | 0 |
| 流水线成功完成的仓库数 | 20/20 | 20/20 |
该语料库涵盖 Spring Boot 单体应用和微服务(petclinic 及其 Kotlin、REST、legacy-XML 和 Angular 变体,Maven、Gradle 和 OAuth2 版本的 JHipster,eladmin、piggymetrics、killbill、initializr、OpenMRS、nacos、Spring Cloud Gateway、Spring Boot Admin)、包含 4,000 个 Java 文件的 Apache Dubbo,以及两个大型 TypeScript 工作区(包含 6,400 个文件的 bitwarden/clients、analog)。标签的准确性取决于标注质量:若发现遗漏其实是标签与固定提交中的源代码相矛盾,就会更正标签,并将证据记录在真实结果文件中。
亲自运行:
stratigraph bench --fetch     # clones the corpus into ~/.cache/stratigraph/corpus
stratigraph bench --private ../your-repo   # aggregates only, nothing that names a file
安装
npm install -g stratigraph
需要 Node 18.18 或更高版本。在分析 Java 之前,无需其他依赖——Java 提取器需要可用的 JDK 17+,并会明确告知你这一点,而不是直接崩溃。stratigraph doctor 会如实列出你的机器能够执行的操作:
$ stratigraph doctor
ok   stratigraph     v1.4.0, fact-store schema v1
ok   node            v20.11.1 on darwin-arm64
ok   git             git version 2.50.1
warn java            1.8.0_432 from JAVA_HOME is below JDK 17; the Java extractor
                     will not run (this limits the analyser, not the code it can analyse)
warn jvm extractor   jar not found — see the README for the two commands that build it
ok   ts extractor    dist/extractors/typescript/main.js (built, no JDK required)
ok   config          defaults (no stratigraph.config.json found)
warn model           claude-opus-5, but no credential found
--   database        .stratigraph/my-repo.db does not exist yet — run `stratigraph init`
上述每个 warn 都不会妨碍工具运行:这台机器仍可分析任何 TypeScript 或 Angular 仓库、挖掘任何 git 历史,并生成完整的结构报告。stratigraph fetch-extractor 可以消除第二条警告;第一条需要 JDK 17+,工具会在其安装位置自动查找,而无需你导出 JAVA_HOME。
如果你希望完全无需考虑工具链,可以使用内置了 JDK、git 和提取器的镜像:
docker run --rm -v "$PWD:/repo:ro" -v "$PWD/out:/work" \
  ghcr.io/imashishsharma/stratigraph doctor
设置 API 密钥
仅当你想要集群名称和 ADR 候选项时才需要。 所有结构分析——依赖图、循环、集群、热点、耦合以及意图与结构之间的发现——都无需密钥或任何配置即可运行。完全跳过本节,并使用 analyze --no-llm。
任选一项。它们按以下顺序尝试:
stratigraph config set-key sk-ant-... # writes ~/.config/stratigraph/config.json, chmod 600
export ANTHROPIC_API_KEY=sk-ant-... # this shell; put it in ~/.zshrc to keep it
echo 'ANTHROPIC_API_KEY=sk-ant-...' >> .env # this directory; gitignore it
ant auth login # no key at all, if you use the Anthropic CLI
Claude Pro 或 Max 订阅不包含 API 额度。 这些订阅适用于 Claude.ai 和 Claude Code;此工具调用
api.anthropic.com,费用与控制台分开结算。来自没有 API 余额的账户的密钥可以通过身份验证,但随后会报错 "Your credit balance is too low"。ant auth login也无法改变这一点——OAuth 令牌包含user:inference范围,但组织仍需有额度。只有解读部分会受影响;所有结构分析仍会照常运行。
然后进行确认——它会显示密钥的来源,绝不会显示密钥本身:
$ stratigraph doctor
ok   model        claude-opus-5, credential from ~/.config/stratigraph/config.json
不确定实际使用的是哪一项?stratigraph config 会列出所有可能影响运行的文件,无论这些文件是否存在,并指出最终采用了哪一个:
$ stratigraph config
Files that configure a run, weakest first. Later ones win.

found   /home/me/.config/stratigraph/config.json    you, every repository
absent  /home/me/work/stratigraph.config.json       this project, committed  (no key here)
absent  /home/me/work/stratigraph.config.local.json this project, your machine
absent  /home/me/work/.env                          environment, e.g. ANTHROPIC_API_KEY

model        claude-opus-5
credential   /home/me/.config/stratigraph/config.json
切勿将密钥放入 stratigraph.config.json。 此文件需要提交到版本控制,而工具会拒绝加载包含密钥的文件——等有人发现时,就只能轮换密钥,而不能简单删除。完整参考文档(包括项目级设置和 apiKeyFile)请参阅配置。
使用方法
stratigraph init    --repo ../some-monolith   # create the fact store
stratigraph extract --repo ../some-monolith   # run every applicable extractor into it
stratigraph history --repo ../some-monolith   # mine git: churn, complexity, authors
stratigraph analyze --repo ../some-monolith   # cycles, clusters, coupling, hotspots, ownership
stratigraph report  --repo ../some-monolith --out ./arch   # C4 diagrams, HTML, ranked findings
stratigraph diff    --repo ../some-monolith   # what changed since the previous run
stratigraph mcp     --repo ../some-monolith   # serve it all to an agent over MCP
stratigraph prune   --repo ../some-monolith --keep 2   # drop old runs, reclaim the space
analyze --no-llm 会生成完整报告,只是不包含文字解读:集群、不匹配、循环、耦合、热点和所有权信息都由算法得出。模型只会在此基础上补充名称和解读,绝不会取代这些内容。
history 会关联到 extract 开启的运行,因此两部分共用一个 run_id——这样 analyze 才能准确指出哪些共同变更的文件之间没有依赖关系。任一部分都可以单独运行:在没有 JDK 的机器上,init + history + analyze 仍会生成完整的历史报告;如果某些部分无法填充,analyze 会说明原因,而不会直接省略这些部分。
analyze 会将每个循环打印为一条路径,并列出证明每一步的边:
1. [high] com.example.web → com.example.service → com.example.repo → com.example.web
   com.example.web → com.example.service
     imports  web.OrderController → service.OrderService  [src/web/OrderController.java:9]
   ...
每一步都会指出文件和行号,因为无法核查的依赖循环不值得报告。循环会作为带有引用的发现保存,这些引用指向产生循环的边;循环绝不会被当作事实——请参阅 ADR-0008。
extract 会运行仓库所需的所有提取器,并根据磁盘上的内容自动检测;然后将它们全部写入同一次运行——只有这样,才能关联 Angular 服务及其调用的 Spring 端点,因为节点按 run_id 划分作用域。--lang java|ts|all 可覆盖检测结果。若缺少 JDK,工具会跳过 Java 部分并继续运行,而不会使命令失败。
stratigraph extract --emit 会将原始 NDJSON 写入标准输出,而不是存储;stratigraph ingest --from facts.ndjson 则会重放已捕获的数据流。
Angular,以及它可能调用的端点
TypeScript 提取器会输出组件、可注入服务、NgModule、DI 边、带有延迟加载边界的路由,以及仅存在于模板中的组件间边。目录会成为 package 节点,因此循环检测、聚类和所有 MCP 查询都无需改动即可用于 Angular — app/admin/metrics 中的包循环读起来与 com.example.web 中的完全一样;如果创建该边的是模板,还会引用模板中的行号作为证据。
然后,analyze 会将 Angular HTTP 调用与 Spring 端点匹配:
1 cross-stack HTTP call(s) — INFERRED, not observed:

  GET /api/orders/{}  ->  GET /api/orders/{id}
    web/src/app/core/order.service:OrderService#findOne()
      web/src/app/core/order.service.ts:15

  Matched by URL pattern against a declared endpoint. Nothing in either file
  says these are connected; check the cited lines before relying on one.
这些边的 confidence 都会存储为 'inferred',并从包图中排除,因此不会仅凭字符串匹配拼出循环。只匹配字面量和模板字面量 URL;计算得出的 URL 会生成诊断信息,但不会生成边;如果某个 URL 与两个端点的匹配程度相同,则会生成一条同时列出两者的诊断信息,而不是掷硬币来决定
(ADR-0018)。在真实的 JHipster 单体项目中,这种诚实显而易见:其 Angular 服务会动态构造每个 URL,因此 6 个候选调用分别与 8 个端点匹配程度相同 — 本次运行会记录 6 条列出全部 8 个端点的诊断信息,而不是 6 条猜测出来的边。
它还会报告那些无法结束的订阅 — 没有 takeUntil、没有保留的 Subscription,且类上没有 ngOnDestroy。这三个条件必须同时满足,因此如果检测不到清理逻辑,就会保持沉默,而不是妄加指责。
历史,以及没人记录下来的耦合
值得关注的输出是第二部分:那些反复一起变更、但代码中没有任何联系的文件。静态图从构建方式上就无法看到这一点。
Files that change together with no dependency between them (top 20):

1. src/main/java/com/example/order/OrderService.java
   src/main/resources/db/migration/V12__order_status.sql
   31 shared commits — strength 0.86, 9.4x chance (36 and 41 commits respectively)
每一对文件都会作为一条发现项存储,并引用产生该发现项的提交 SHA,因此任何分歧都可以通过 git show 来解决。不会静默过滤任何内容:报告会说明检查了多少个提交、多少个提交范围过大而无法配对,以及每个阈值筛掉了多少对 — 如果某个部分为空,报告就会说明检查过哪些内容,避免让人误以为仓库没有问题。
有三项因素决定这些输出反映的是信号还是噪声,而且都记录在 ADR-0011 中:排除合并提交;不参与配对触及超过 50 个文件的提交(否则一次全仓库重新格式化就会让所有相关文件产生耦合);一对文件必须比随机情况下更频繁地共同变更,而不能只是变更多。
第四项因素决定报告的严重程度。gradle-wrapper.jar 和 gradlew.bat 在 11 次提交中的 11 次同时变更 — 完美的共同变更评分,实际意味着某个工具会同时重新生成这两个文件。只有在原本能够观察到这两个文件之间的依赖关系时,才会根据共同变更的强度为这对文件评级:本次运行有静态图,而且提取器会解析这两个文件。否则评级为 low,因为发现项的详细信息已经说明无论如何都无法观察到依赖关系;如果证据明确否认这一点,发现项就不应被评为高严重程度。在 petclinic 上,这意味着高严重程度发现项从 23 条降到 7 条 — 也意味着 --fail-on high 门禁不会在每个带有构建封装器的仓库上都触发,而是变成值得启用的门禁
(ADR-0028)。
会追踪重命名,因此 3 年前移动过的文件仍会有一段完整的历史,而非被拆成两半。git log --follow 无法做到这一点 — 它只接受一个路径规格 — 因此挖掘器会扫描整个仓库一次,并自行解析重命名链
(ADR-0009)。
此外还有:按变更频率 × 复杂度排序的热点,以及历史记录集中在某一个人身上的文件。复杂度是缩进总量 — 这是一个代理指标,明确说明了它的定位;之所以选择它,是因为它不需要解析器,因此也能为那些经常出现在耦合对中的 XML、SQL 和 properties 文件评分。
stratigraph history --repo ../some-monolith --since '3 years ago'
stratigraph analyze --repo ../some-monolith --top 40
集群,以及名不副实的包
analyze 会基于一张由两层信息构成的图,将包归入不同社区:提取器检测到的依赖边,以及历史分析器测量出的共同变更。历史信息可以将包移入它实际所属的组,这正是将两者结合起来的意义。
3 package clusters (modularity 0.412, coupling weight 1):

1. Order handling (com.example.shop.order) — 7 packages
   Serves the order lifecycle and persists it.
     com.example.shop.order.api
     ...
之所以打印 coupling weight,是因为它决定了结果:值为 0 时,分组完全基于结构;提高该值后,历史信息就能盖过导入关系。使用 --coupling-weight 0 再运行一次,看看哪些内容会移动。算法采用 Louvain,并移除了所有随机因素,因此相同的事实总会得到相同的集群——如果分区在不同运行间发生变化,那么基于它构建的所有发现都将无法证伪(ADR-0012)。
下一个发现才是这个里程碑的价值所在:
1. [high] shop.billing.report is named under shop.billing but clusters with shop.admin
   All of the 3 packages named under shop.billing sit in shop.billing:
   shop.billing.invoice, shop.billing.ledger, shop.billing.payment.
   This one sits in shop.admin instead.
   connected to shop.admin.role: imports shop.billing.report.A → shop.admin.role.A
     (src/shop/billing/report/A.java:201)
包名对应一个路径,因此共享其父路径的包就是它声明的邻域;“名字与这三个并列,集群却和那三个归为一组”是算术结果——而不是模型对 report 听起来像什么的看法。模型之后可以描述这两项职责看起来分别是什么;但它永远不会判定两者存在不匹配
(ADR-0014)。
解释,以及防止凭空捏造的机制
模型只会编写名称、描述和 ADR 候选项,而这些内容遵循由代码而非提示词强制执行的契约。
每个集群都会被整理成一份带编号的证据列表,其中包含包、带有文件和行号的边、带有变更量的文件,以及提交;每一项都带有仅在当前证据包内有效的不透明 ID(e12,而非数据库的边 ID)。模型若猜测数据库 ID,就会对应到一条真实记录,因此这种猜测无法被安全拒绝。若模型在包含 12 项的证据包中猜测 e99,则不会对应到任何内容。
以下四条规则会直接拒绝响应:
- 引用的 ID 不在证据包中;
- 某项声明没有引用任何内容;
- 散文中的任何标识符、路径或提交 SHA 都不在证据包中——这一条能抓出引用真实证据、却在句子中谈论不存在的类的情况;
- ADR 候选项的证据无法解析。
被拒绝的响应会附上违规信息重试一次,然后丢弃。任何被拒绝的内容都不会存储;每次放弃都会留下一条 diagnostic 记录——因为没人能描述的集群,不应该看起来像是没人试过描述它
(ADR-0013)。
Interpretation by claude-opus-5 — 12 of 14 clusters described.
  Names and descriptions above this line are inference, not observation.
  2 description(s) failed the citation check and were discarded — see the diagnostic table.
这项检查无法做到的是验证证据是否支持该句子。模型可以引用 7 条真实的导入关系,却从中得出错误结论。这正是上述不匹配声明保持算法判定的原因,也是所有模型编写的内容都会存储 authored_by = 'model'、回答的模型 ID,以及标明哪些行属于推断的报告的原因。
没有凭据,或使用 --no-llm 时,analyze 会用一行说明情况,并原样打印结构报告。
实际会展示给别人看的报告
stratigraph report --repo ../some-monolith --out ./arch
arch/index.html                 self-contained: no script, no network, no CDN
arch/workspace.dsl              Structurizr, all three views, with provenance
arch/c4-context.mmd             Mermaid, level 1
arch/c4-container.mmd           level 2
arch/c4-component-<module>.mmd  level 3, one per container
arch/c4-code-<package>.mmd      level 4, one class diagram per package
arch/data-model.mmd             the ER model, from the declared O/R mappings
arch/findings.md                the ranked list, for pasting into an issue
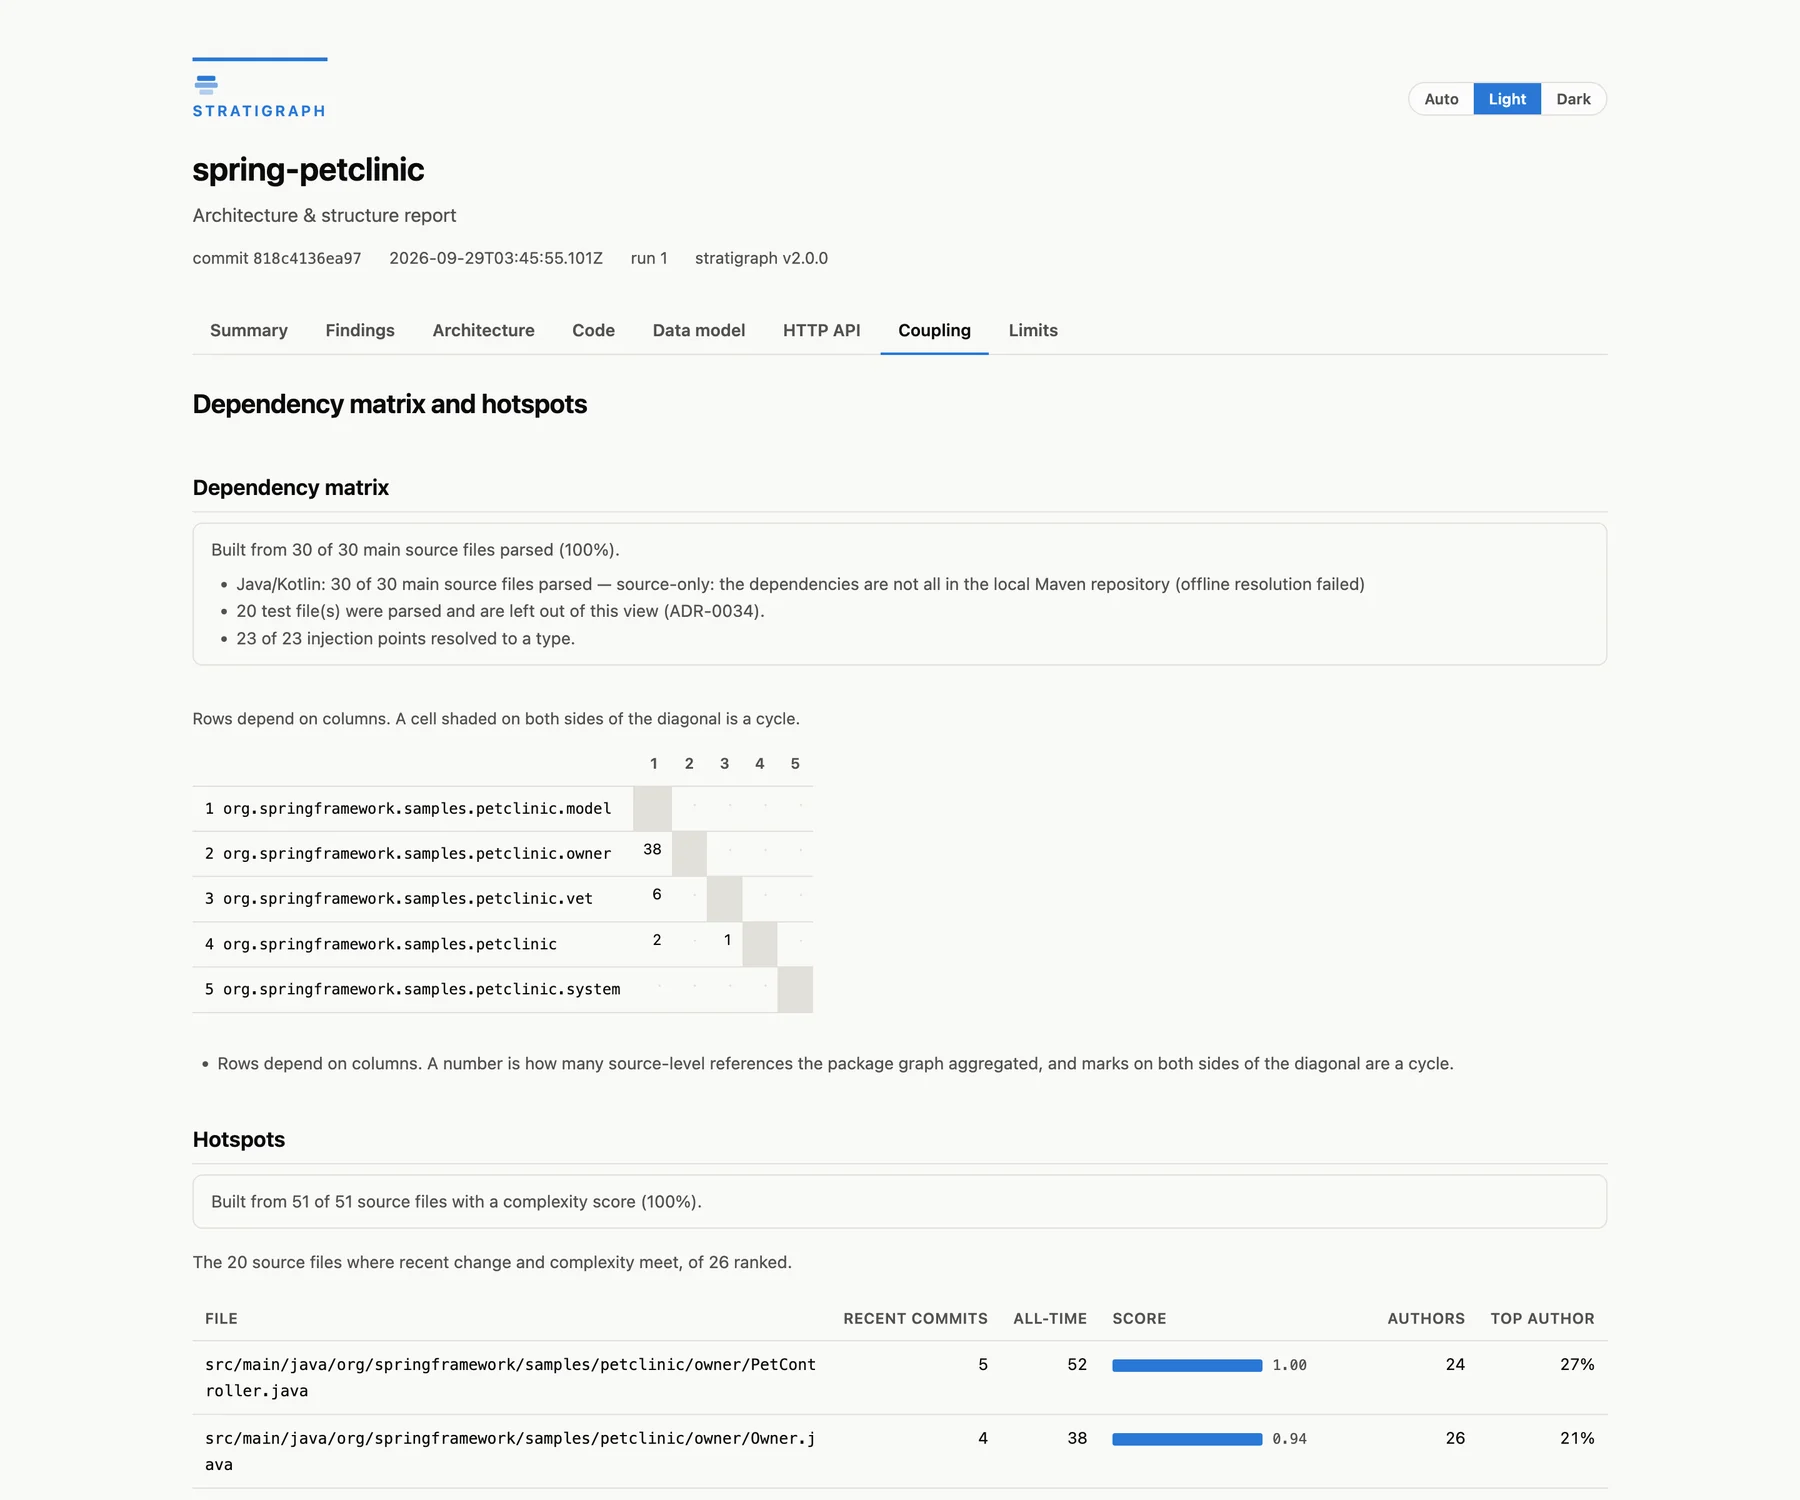
HTML 页面还包含以上所有内容,以及 HTTP 层、包依赖矩阵和按排名排列的热点——并附有目录,以及一个汇总重要数据的面板,方便你在阅读其余内容前先了解概况。
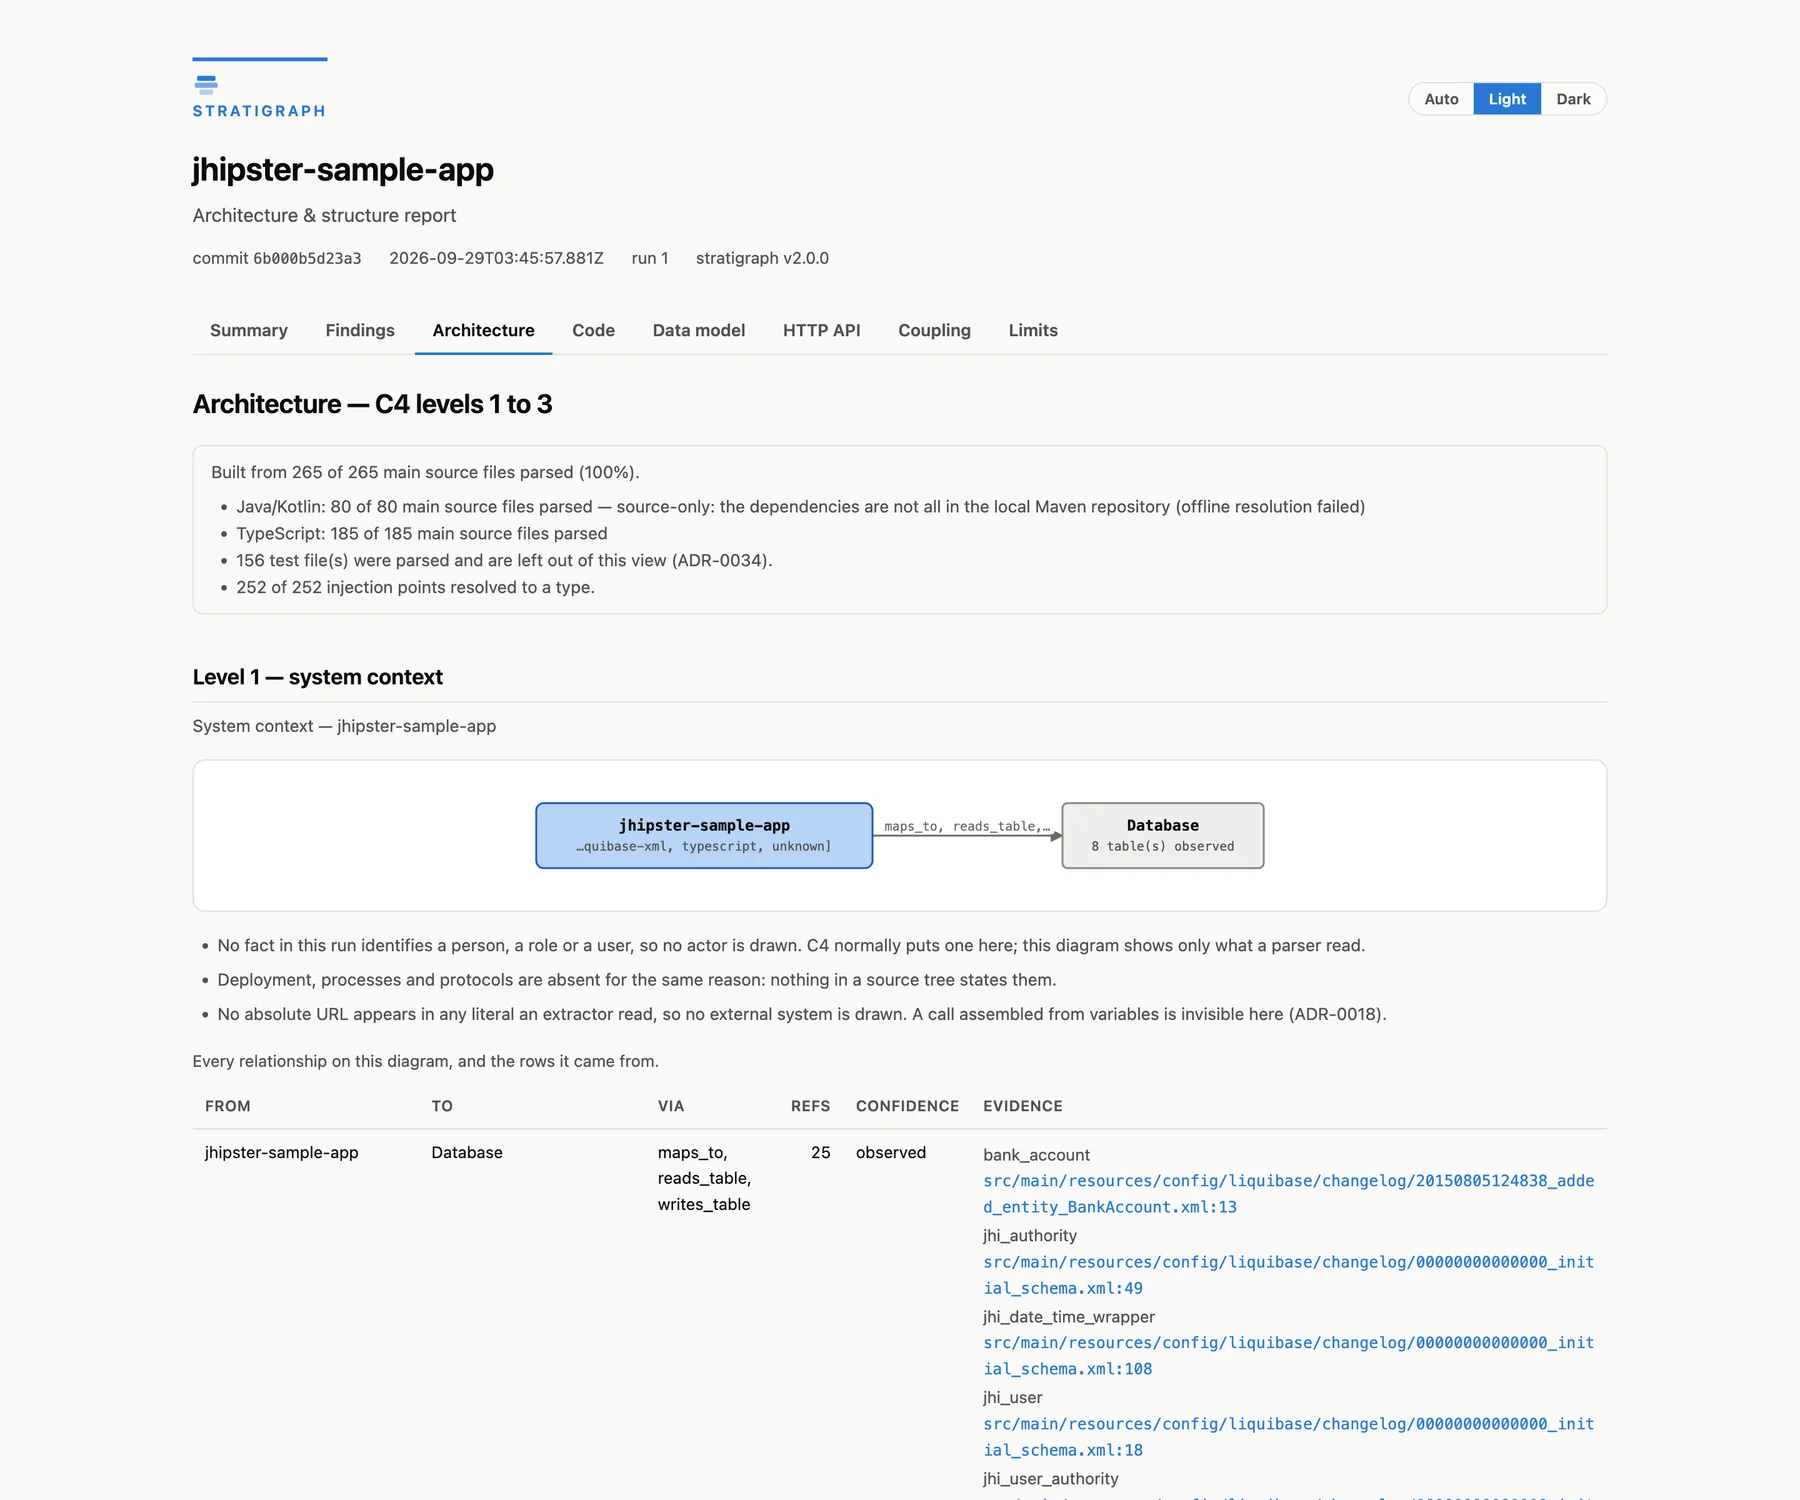
C4 是事实图的投影,而不是一种新模型。 容器是可部署单元——其模块构建文件应用了 Spring Boot 插件、打包为 WAR 或声明为 Angular/Nx 应用,或者持有一个 @SpringBootApplication 类——并引用相应的证据;聚合器 POM、BOM 和库都不是容器,而库的包会绘制在每个使用它的容器中(ADR-0040)。组件是一个包——在 Angular 工作区中,是项目、NgModule 或延迟加载路由边界,而不是目录(ADR-0042);数据存储之所以存在,是因为读取到了 @Table 映射;外部系统之所以存在,是因为提取器从字面量中读取了绝对 URL。C4 所需的信息若没有事实提供,图中就不会绘制相应方框,并会在页面上说明:
本次运行没有任何事实能识别人员、角色或用户,因此不会绘制参与者。C4 通常会在这里放置一个参与者;这张图只展示解析器读取到的内容。
你见过的每张 C4 图,左上角都有一个小人。在这里画一个只需四行代码,也不会有人质疑——但这会让架构图中出现一个从未由解析器生成的方框(ADR-0019)。
HTML 会自行渲染 SVG,而不是捆绑渲染器或调用无头浏览器,因此一个 40 KB 的页面可以从文件共享中打开、通过电子邮件发送后仍可正常使用,而且在禁用脚本时也能正常工作。布局精确到像素且具有确定性——同一次运行会生成相同的字节,这使得夹具测试可以断言整个 SVG,而不只是检查其中是否包含 <rect>(ADR-0020)。
发现项按严重程度、观察结果优先于推断、证据数量、规则名称,最后按 ID 排序——仅对已存储的列进行算术运算,结果全面且可复现。不使用加权评分,因为由报告层臆造的常量属于无人能质疑的主观判断。schema 自 M0 起一直承载的承诺,终于在此兑现:没有引用来源的发现项不会发布,它会从所有计数中排除,并打印被排除的数量(ADR-0021)。
Level 4 为每个包绘制一张类图——包是源代码明确声明的内容,而集群是算法作出的决定;读者最接近代码的层级,不适合引入代码中并不存在的分组。方框会标明声明的构造型、字段和方法;泛化、实现和关联则按 UML 的绘制方式呈现。
数据模型从 O/R 映射中读取。 实体就是表,其列来自映射类的字段,包括继承的字段——JPA 会将映射超类链映射到子类的表中,所以如果不包含这些字段,owners 就没有主键——基数则来自 JPA 注解,而不是字段是否为复数形式。
最后这一点需要修改提取器,值得记录。List<Pet> 的完全限定名称(fqn)会擦除为 java.util.List,而且必须如此,否则仅类型参数不同的两个重载会变成两个节点。但这也会抹去唯一能说明集合所包含内容的信息:在 petclinic 中,四个实体关联中有三个基数可读,但目标不可读。 提取器现在会在擦除后的类型旁记录类型参数,不会更改任何 fqn;现在四个关系都能正确生成(ADR-0022)。如果关联的目标仍不可读,就会在该关联自己的表中列出原因,绝不会连到一个看似合理的目标。
在 spring-petclinic 上运行
——49 个 Java 源文件、1,040 次提交——会生成 6 张表及 4 个关系、6 张类图、17 个端点和 44 条发现;每一条都附有 file:line 或提交 sha,并且都会在行内说明自身的局限:
mvnw和mvnw.cmd会一起变更——涉及其中任一文件的 11 次提交中,11 次都同时涉及两个文件,是独立文件预期共享次数的 65.1 倍。没有提取器会解析mvnw或mvnw.cmd,因此无论如何都无法观察到它们之间的依赖关系。这是无法核实原因的共同变更,并不能证明代码中不存在耦合。
从 Agent 提出问题
stratigraph mcp 通过 stdio 使用 MCP 提供事实存储,因此在代码库中工作的 Agent 可以提出结构性问题,而不必用 grep 搜索答案。
claude mcp add stratigraph -- stratigraph mcp --repo ../some-monolith
共 13 个工具,全部为只读:
| 工具 | 可回答的问题 |
|---|---|
describe_run | 此存储包含什么,以及——更重要的是——不包含什么 |
find_node | 将已知名称解析为其他工具所需的准确 fqn |
query_dependencies | 某个包或类型依赖什么,以及哪些内容依赖它 |
find_callers | 所有已观察到的对某个方法或类型的调用或注入 |
describe_module | 一个包的完整信息:类型、端点、表、变更频率、集群 |
list_endpoints | HTTP 接口,以及处理每条路由的方法 |
find_hotspots | 变更频率 × 复杂度,或历史记录集中于某个人的文件 |
trace_to_table | 映射到某张表的类型,以及哪些内容会到达这些类型 |
check_cycle | 两个包是否相互依赖,以及相关边 |
what_breaks_if | 哪些内容直接或间接依赖某个符号,以及相关边 |
who_knows | 谁修改过某个文件或包,以及相关知识的集中程度 |
where_is_table_written | 写入和读取某张表的代码,并为每次访问提供引用 |
explain_hotspot | 某个文件为何被列为热点:其提交、作者和复杂度 |
**服务只进行读取。**它以只读方式打开数据库,绝不会启动提取器:过期存储会被报告为过期,而不会悄悄重建,因为工具调用不是启动 JVM 扫描 4,000 个文件的好时机。每个回答结束时都会列出自本次运行读取文件以来磁盘上发生变更的文件。例如,在另一个终端中运行 stratigraph scan 后,较新的运行完成时,服务会切换到该运行;切换后的第一个回答会说明这一点,并列出两个运行。这样,交互记录就能显示答案从何处开始不再一致。使用 --run <id> 可将整个会话固定在某次运行上
(ADR-0046)。
每个结果都附有文件和行号、fqn 或 sha。模型编写的任何内容都会带上 authoredBy: "model" 标签返回,绝不会混入结构性答案。每个可能返回空结果的工具都会说明空结果属于哪种情况——found 表示“此次运行中没有这个名称”,covered 表示“此次运行无法回答这个问题”——因为对 Agent 来说,无论哪种情况,空数组看起来都像是在说“没有这样的内容”
(ADR-0015)。
在无法获得仓库上下文的情况下,针对 dubbo 提出的五个结构性问题都得到了正确回答——包含双方引用的循环依赖、某个方法唯一的调用位置、bus factor 文件,以及包摘要;每个答案都根据其引用行进行了人工核验。其中一个数字与 git log --follow 不一致,但事实证明工具给出的数字是正确的;此次运行记录在 ADR 中。
保持内容更新
修改代码后,再次运行 stratigraph scan。输入未发生变化的提取器会被跳过,并重放其已存储的事实。输入包括提取器可能读取的每个文件,无论该文件是否受版本控制,还包括提取器本身。如果 HEAD 未移动,也会复用上次挖掘的历史记录。两者都是精确复用,而非近似复用。重放的流与提取器原本会输出的内容逐字节一致,运行记录会注明 facts reused from run N。在 nacos(5,600 个文件)中,仅修改 TypeScript 后,刷新耗时约 15 秒,而非约 78 秒。
限制:Java 提取器会一次性解析整个程序,因此任何 .java 或 .kt 文件发生变化,都会触发对整个程序的重新解析。在 extract、history 或 scan 命令中使用 --no-reuse 可关闭复用。
JVM 提取器 — Java 和 Kotlin
运行时需要 JDK 17+;它可以解析任何年代的源代码,包括 Java 8。 它解析源代码集,从不运行或解析你的构建 (ADR-0006),因此即使仓库无法编译、没有构建文件,或采用早已无人使用的 Ant 布局,也能正常工作。纯核心 Java 即使完全没有框架,也能获得完整的结构化输出——包括包图、循环依赖等。
Kotlin 由同一个提取器在同一次运行中读取。 关键就在于此:Kotlin 会出现在 Java 仓库内部——例如带有 Kotlin 测试模块的 Spring Boot 服务,或逐个包迁移的团队。两次独立分析无法将 Kotlin 服务与它调用的 Java 仓库关联起来,因为节点按 run_id 隔离。一次运行,一张图。
因此,所有基于事实图构建的功能都能处理 Kotlin,无需专门识别它。在一个包含四个文件的 Kotlin 样例中:
node  class     com.example.shop.service.OrderService
edge  annotated_with  OrderService -> org.springframework.stereotype.Service
edge  injects         OrderService -> repo.OrderRepository
node  endpoint  GET /api/orders/{id}
edge  handles         OrderController#byId(long) -> GET /api/orders/{id}
edge  maps_to         domain.Order -> orders
——构造器注入、HTTP 接口,以及从 @Entity 和 @Id 读取出的 ER 模型(含 Long id PK)。--lang kotlin、kt 和 jvm 都指向这个提取器;只要有 .kt 文件,无需任何标志即可选择它。build.gradle.kts 会被读取为模块的标识,而不会被当作源文件。
J 模型无法表达的内容,会映射为最接近的 Java 形式,或完全不表示:扩展函数会显示为方法,而协程和 object 声明目前没有独立的表示形式。不会进行任何猜测
(ADR-0029)。
依赖混合语言仓库前,有一点界限值得了解。 两种语言由不同的解析器解析,彼此无法看到对方的源代码。因此,Kotlin 类注入 Java 类可以解析——这来自导入和声明的类型;但 Kotlin 中对 Java 方法的 调用 无法解析:
edge  injects  com.example.NewService -> com.example.LegacyRepository   ✓
info: 1 call site(s) could not be resolved to a declaring type and were
      not recorded as edges
要解决这个问题,就必须编译 Java 部分并将类路径交给 Kotlin 解析器,而这正是此提取器不会做的事。因此,这里会保留缺失项并附上诊断信息,绝不会猜测依赖边。
npm 包不附带 jar——它包含 22 MB 的 JVM 字节码,而大多数安装根本不会分析任何 Java 代码。只需一条命令即可下载:
stratigraph fetch-extractor
它会根据写入 npm 包的 SHA-256 校验;写入操作由构建并附加 jar 的同一个发布任务完成,因此摘要不会与它所描述的文件来自同一处。如果不匹配,就不会写入任何内容,并会提示错误。没有跳过校验的标志。jar 会按版本缓存在 ~/.cache/stratigraph/ 下——以版本为键,因此安装较旧的 stratigraph 不会悄悄运行较新的提取器——之后每条命令都能在此找到它,无需任何标志。
这是工具中唯一会访问网络的部分,而且它是一个独立命令,不是 extract 代你执行的操作。 提取和历史挖掘完全在本地进行;多一行命令,换来这一点,值得
(ADR-0004)。
--dry-run 会打印 URL、目标路径和固定摘要,但不会下载。对于隔离网络的机器,可以在其他地方获取 jar,再放入缓存——STRATIGRAPH_CACHE_HOME 可将缓存指向任意位置:
STRATIGRAPH_CACHE_HOME=/mnt/share/stratigraph stratigraph extract --repo ../monolith
自行构建仍然可行,而且优先于下载的 jar,因为刚运行过 maven 的开发者通常希望使用刚构建的 jar:
git clone https://github.com/imashishsharma/stratigraph
cd stratigraph/extractors/java && ./mvnw package
你也可以通过 --extractor-jar <path>、配置文件中的 java.jar 或 STRATIGRAPH_JAVA_JAR 指定 jar。stratigraph doctor 会报告找到的 jar 来源,以及它的构建时间。
或者跳过工具链问题
镜像自带 JDK 17、git 和提取器,因此主机上的任何配置都无关紧要:
docker run --rm -v "$PWD:/repo:ro" -v "$PWD/out:/work" \
  ghcr.io/imashishsharma/stratigraph extract --repo /repo
仓库以只读方式挂载,事实存储写入 /work,绝不会写入正在分析的仓库内部——这与 CLI 遵循的规则相同。
通配符导入会被拒绝,之后才会被认可。 对单个文件的源码而言,import org.springframework.web.bind.annotation.*; 下的 @GetMapping 确实存在歧义——仓库可以声明自己的 GetMapping——因此提取器不会猜测。自 v1.4 起,解析结果改为通过验证后才予以认可(ADR-0023):如果已知注解表将该名称归入唯一导入的通配符包,且解析的源码集中没有任何类型声明使用该名称,就会解析该名称。以这种方式解析的事实会标记 resolution: "wildcard-import",因此始终可以与单类型导入区分开来;每条仍被拒绝的记录都会指出未满足的条件——存在竞争的通配符导入,或存在遮蔽声明及其所在文件。对于 JHipster 生成的控制器,这意味着端点数量从 2 个变成 41 个。
对于没有类路径就无法识别的内容,会明确说明,而不是猜测:带有元注解的自定义构造型、从第三方超类型继承的成员、注解处理器生成的内容,以及在 XML 中定义的 Bean 装配。这些情况都会产生诊断信息,并且不生成事实,绝不会产生错误的边。
TypeScript 提取器
无需 JDK 或下载——它随此软件包提供,并作为独立进程在当前正在运行的 Node 上执行,因此即使某个解析器因超大工作区耗尽内存,也只会导致一个提取器退出,而不会拖垮整个分析过程。
它会解析源码集,但绝不会安装项目或对其进行类型检查(ADR-0016),因此不会使用 @angular/compiler-cli:NgtscProgram 需要已安装的 node_modules、可解析的 tsconfig.json,以及能够编译的项目;而这款工具所面向的仓库往往三者皆无。tsconfig.json 会作为普通 JSON 读取,只提取 compilerOptions.paths,不读取其他内容——这些别名很重要,因为在 Nx 工作区中,跨项目导入只能通过它们来编写。
对于无法识别的内容,会明确说明,而不是猜测:你未安装的包中声明的内容(会创建一个 is_stub 节点,并以引入它的导入语句命名)、模板类型检查,以及通过工厂或 InjectionToken 进行的 DI。每种情况都会产生诊断信息,并且不生成事实,绝不会产生错误的边。
事实存储默认位于当前目录下的 .stratigraph/<repo-name>.db,绝不会位于正在分析的仓库内部。
保持事实存储精简
每次 extract、history 和 ingest 都会开启一次运行,而一次运行会保存它读取的提交对应的整份图副本。这让你可以将上一季度的结构与今天的结构并存,也意味着按计划分析的存储会无限增长。
$ stratigraph prune --repo ../some-monolith --keep 2
run 1    2026-08-12T22:00:06.038Z      343 nodes      205 commits  delete
run 2    2026-08-12T22:03:23.143Z      343 nodes        0 commits  delete
run 3    2026-08-12T22:03:25.010Z      343 nodes        0 commits  delete
run 4    2026-08-13T03:25:56.552Z      343 nodes        0 commits  keep
run 5    2026-08-13T03:25:58.507Z      343 nodes        0 commits  keep
3 run(s) deleted. 2.1 MB -> 792.0 KB (1.3 MB reclaimed).
每次运行都会列出其包含的内容,以及即将对其执行的操作,因为破坏性命令如果只报告总数,你就无法发现它是否选错了两个运行。--dry-run 会准确打印该表格,不会写入任何内容。--keep 默认为 3,且必须至少为 1;如果你不想保留任何运行,请删除该文件。
释放的空间会真正归还,而不是留在 SQLite 的空闲列表中:删除操作会级联到每张表,然后对存储执行 vacuum,并将预写日志合并回去,因此磁盘上的文件会变小。
对于一件事来说,按最近程度排序并不是合适的维度,而且系统会明确提示。 history 会关联到 extract 开启的那次运行,因此连续执行两次不带参数的 extract,会导致最新的运行没有提交,而所有挖掘出的历史都留在较早的一次运行中。此时按最近程度清理就会删除它,而重新挖掘大型代码库需要几分钟而不是几秒钟——因此系统会在这种情况发生前发出警告:
warning: every run being deleted carries the git history and none of the kept
runs has any. After this the store has no commits, and hotspots, churn and
co-change all become unavailable until you run `stratigraph history` again.
不会自动清理任何内容。一个会悄无声息地丢弃你正准备拿来比较的运行的工具,比文件太大更糟糕。
升级 Spring Boot
stratigraph upgrade 会升级 Maven 或 Gradle 项目的 Spring Boot 版本:2.7 →
3.5,或 3.x → 4.0。它会运行 OpenRewrite 的升级配方,然后处理配方留下的
问题。凡是真正需要由你做出选择的事项,它都不会擅自决定
(ADR-0047)。
stratigraph upgrade plan --to 3.5          # read-only: versions, JDKs, and where trouble is expected, cited
stratigraph upgrade run --to 3.5           # recipe + known fixes + verification, on a new branch
stratigraph upgrade run --to 3.5 --ai claude-code   # ...and let Claude Code attempt the rest
run 的执行内容:
-
基线。 它会创建一个新分支,然后按项目当前状态构建并运行测试。结果会作为参照:之后,“失败”表示之前通过,现在失败。升级前就已失败的测试(例如需要 Docker 的测试)不属于升级的问题,报告会注明这一点。
-
配方。 配方会作为一次单独的提交,方便你独立审阅。
-
循环处理。 它会构建项目、读取每个失败,并将其归类:
- 机械性问题:存在已知修复方案(例如类被移动、缺少
-parameters、格式化程序、Flyway 模块被拆分……); - 判断性问题:需要有人阅读代码才能确定修复方案;
- 决策性问题:任何修复都会改变行为,需要由你选择,例如授权规则或 HTTP 契约。
已知修复会优先执行。使用
--ai claude-code时,Claude Code CLI 接着会尝试处理判断性问题。它不会处理决策性问题。只有在重新构建后失败数减少且没有新增失败测试时,才会保留更改。禁用或删除测试的更改会被直接拒绝。 - 机械性问题:存在已知修复方案(例如类被移动、缺少
-
报告。
upgrade-report.md会提交到该分支。报告会展示:- 状态;
- 与基线结果比较的每项测试;
- 各层的提交(配方、已知修复、AI);
- 哪些测试文件发生了更改;
- 对于所有未解决的问题,列出证据、已尝试的方案,以及决策性问题的可选方案。
这种方式的原因:在 10 个公开应用上,仅使用 OpenRewrite,0/10 能实现构建通过。它留下了 44 个问题,其中 9 个是配方本身引入的。详见 bench/upgrade-gap/。
配方版本。 默认情况下,运行会使用 rewrite-spring 6.37.1 和
rewrite-maven-plugin 6.46.1。这是 Maven Central 上的最后一个版本:OpenRewrite 现在会将新版本发布到需通过身份验证的
Code Genome Project。
要使用更新的配方,请将该仓库及其凭据添加到你的
~/.m2/settings.xml(分别作为仓库和插件仓库),然后传入
--rewrite-spring <version> --rewrite-plugin <version>。报告会记录实际运行的版本。
与 stratigraph 的其他功能不同,upgrade 会构建你的项目,因此 Maven
会下载新版本。它也会创建提交,但只会提交到自己的分支,且绝不会推送。未使用 --ai 时,不会有任何源代码离开本机。使用该选项时,Claude Code CLI 会在你自己的账户下读取源代码。
在流水线中使用:JSON 和质量门禁
--format json 是全局选项。每条会生成结果的命令都会在 stdout 上输出一个文档;进度信息保留在 stderr 上,因此管道中只会传递该文档:
$ stratigraph analyze --repo ../monolith --no-llm --format json | jq '.findings.bySeverity'
{
  "high": 9,
  "medium": 35,
  "low": 10
}
每个文档都包含 format: 1。只有可能导致解析器出错的更改才会递增该数字,因此使用方可以声明自己支持哪种结构。
了解该结构中以下三点很有帮助;它们的设计原因与工具其他部分相同:
run.coverage和run.gaps会与发现项一同传递。 空的findings.items与干净的仓库在其他方面完全相同 (ADR-0026)。findings.shown和findings.truncated会说明项目列表是否因--top而被截断,而计数反映的是整次运行的结果。总数对不上的原因应由文档说明,而不应留给读者自行发现。findings.unpublishable会统计因缺少引用而被暂不公开的发现项,而不是将它们悄悄丢弃 (ADR-0021)。
让构建失败
在 analyze 或 report 中使用 --fail-on <severity>,当任何可发布的问题达到该严重级别时,退出码为 3:
$ stratigraph analyze --repo . --no-llm --fail-on high
error: 9 finding(s) at or above `high` (9 high). Run `stratigraph report` for the evidence behind each one.
$ echo $?
3
是 3,而不是 1。 流水线必须能够区分“此构建有 9 个高严重级别的问题”和“工具无法运行”——把分析器故障误读为代码库干净,正是整个项目旨在避免的 CI 版本错误。退出码分别为 0 表示成功、1 表示意外错误、2 表示报告了错误、3 表示触发了门禁。
门禁只统计报告实际发布的内容:没有引用的问题不会导致构建失败,因为报告本身拒绝展示这类问题。而且,文档会在非零退出码之前写入——即使门禁失败,流水线仍能拿到导致失败的问题。
只针对恶化的情况失败
--fail-on 对本工具旨在处理的代码库有个问题:一个无人记得的、拥有 10 万行代码的单体代码库,在第一天就有数百个问题,因此从第一个提交开始就失败的门禁,一周后就会从流水线中删除。
stratigraph diff 会比较两次运行的结果,而 --fail-on-new 会根据差异触发门禁:
$ stratigraph diff --repo ../monolith --fail-on-new high
run 41 (a3f19c2e04, 2026-08-06T09:14:02Z) -> run 47 (7b02de1188, 2026-08-13T09:02:55Z)

Findings
  new           3  2 high, 1 medium
  resolved      1  1 high
  unchanged   612

New since the earlier run:
  [high] Package cycle: com.shop.web ⇄ com.shop.billing
  ...

error: 2 new finding(s) at or above `high` since run 41 (2 high). Findings that
were already there do not count.
即使某个代码库连续一年每次提交都会触发 --fail-on,它今天仍然可以启用这个门禁。 两种门禁回答的是不同问题——“这个代码库是否符合要求”和“这次更改是否让情况变糟”——而单体代码库从第一天起就只能回答第二个问题。
两次运行间的问题会根据规则和标题进行匹配;每条规则都会根据涉及的实体确定性地生成标题。循环则按其包集合匹配,因为标题会描述穿过组件的最短路径,而无关边的出现会让这条路径发生变化——循环相同,描述却不同。对未更改的代码库进行两次分析,差异为空;在 spring-petclinic 上,44 个问题中有 0 个新增、0 个已解决,耗时 0.13 秒。
它无法识别的是问题措辞改变、但问题本身未变的情况:重命名包会将旧问题报告为已解决,并将新问题报告为新增。这是有意为之的取舍——模糊匹配可能会把真正的新循环误判为仅换了名字的旧循环,而门禁悄无声息地不触发,比报告重命名问题更糟 (ADR-0027)。
在已有技术债的代码库上运行的流水线
- uses: actions/checkout@v4
  with: { fetch-depth: 0 }        # a shallow clone understates every history metric

# The base commit, so there is something to compare against.
- run: |
    git checkout -q ${{ github.event.pull_request.base.sha }}
    npx stratigraph init    --repo .
    npx stratigraph extract --repo .
    npx stratigraph history --repo .
    npx stratigraph analyze --repo . --no-llm

# Then this one. Both land in the same store as consecutive runs.
- run: |
    git checkout -q ${{ github.sha }}
    npx stratigraph extract --repo .
    npx stratigraph history --repo .
    npx stratigraph analyze --repo . --no-llm

- run: npx stratigraph diff --repo . --fail-on-new high --format json > diff.json

- if: always()
  run: npx stratigraph report --repo . --out ./arch
- if: always()
  uses: actions/upload-artifact@v4
  with: { name: architecture, path: ./arch }
如果克隆是浅克隆,history 会在文档中报告 "shallow": true,这样流水线就能发现缺少 fetch-depth: 0,而不是默默比较被低估的数字。
在两次运行之间保留存储(缓存 .stratigraph/),并按计划运行 stratigraph prune --keep 10;如果每个作业都使用独立存储,上面的基线分析就是 diff 获得第二次运行结果的来源。
配置
不需要配置文件。stratigraph analyze --no-llm 完全不需要配置文件,下面的每个值也都有可用的默认值。只有需要更改某项设置时才创建文件——常见情况请参阅设置 API 密钥。
stratigraph config                      # what is in play right now
stratigraph init --write-config         # scaffold stratigraph.config.json
init --write-config 会明确写入默认值,因此配置文件列出的是可以更改的选项,而不是替你做出的决定。它绝不会覆盖现有文件。
文件放在哪里
有 4 个位置,都要先创建才会存在,并按优先级从低到高合并:
| 文件 | 范围 | 是否提交? | 是否允许包含密钥? |
|---|---|---|---|
~/.config/stratigraph/config.json | 你分析的每个仓库 | 否 — 在所有仓库之外 | 是 |
stratigraph.config.json | 一个项目,该项目的所有成员 | 是 | 否 |
stratigraph.config.local.json | 一个项目,你的机器 | 否 — 将其加入 .gitignore | 是 |
.env | 环境变量 | 否 — 将其加入 .gitignore | 是 |
项目文件和 .env 会先在工作目录中查找,然后在待分析的仓库中查找——因此,运行 cd ~/work && stratigraph analyze --repo ../monolith 时,会读取 ~/work/stratigraph.config.json,然后再回退到
../monolith/stratigraph.config.json。--config <path> 会覆盖查找路径。
在 Windows 上,用户文件位于 %APPDATA%\stratigraph\config.json。
XDG_CONFIG_HOME 和 STRATIGRAPH_CONFIG_HOME 均受支持。
优先级从高到低:CLI 标志 → 本地 → 项目 → 用户 → 默认值。 项目中固定设置的 "model": "claude-opus-5" 会优先于你的个人默认值;你的 .local.json 会优先于项目设置。已导出的变量始终优先于 .env,因此已提交的 .env 无法覆盖 CI 中设置的密钥。
未知键会报错,而不是被忽略。显式设置为 null 表示“使用默认值”,因此脚手架生成的文件可以列出所有选项。
凭据详解
| 位置 | 方式 |
|---|---|
llm.apiKey | 内联设置。允许在用户文件和 *.local.json 中使用;在 stratigraph.config.json 中会被拒绝 |
llm.apiKeyFile | 存放密钥的文件路径。~ 会展开;相对路径以配置文件为基准解析 |
llm.apiKeyEnv | 要读取的环境变量 — 默认为 ANTHROPIC_API_KEY,因此团队可以指定 WORK_ANTHROPIC_KEY |
.env | 设置该变量(前提是它尚未导出) |
| — | ANTHROPIC_AUTH_TOKEN,或来自 ant auth login 的配置 |
如果配置的 apiKeyFile 无法读取,就会报错,而不会悄悄回退到其他现有凭据:静默使用与你指定凭据不同的密钥,可能会让错误的账户承担费用。
如果没有凭据,analyze 会打印一行提示,说明这一点并给出可修复此问题的 3 条命令;结构报告不会改变。
可设置的内容
完整的配置结构见随软件包提供的
stratigraph.config.example.json。以下 3 项最值得了解:
llm.model— 默认为claude-opus-5。可通过--model <id>按次运行覆盖。每一行记录都会注明实际作答的模型。interpret.couplingWeight— 该值决定聚类方式,因此analyze会打印所用的值。0表示仅按结构聚类。interpret.maxClusters— 限制发送给模型的聚类数量,避免大型仓库导致费用失控。
llm.sendSource 默认关闭,开启时会明确记录日志。提取和历史挖掘完全在本地进行;只有解读层会调用模型 API,且除非你选择加入,否则只会发送结构元数据。
架构
五层,严格单向。各层不会向上依赖; 呈现器绝不会调用提取器。
extractors ──NDJSON──▶ fact store ──▶ history miner ──▶ interpreters ──▶ presenters
 (Java: JVM)            (SQLite)        (git log)      (clustering + LLM)   (MCP server,
 (TS: compiler API)                                                          Structurizr,
                                                                             Mermaid, SVG,
                                                                             HTML, Markdown)
呈现器读取存储,不推导任何内容。stratigraph report 以只读方式打开数据库,它绘制的每张图都是对 extract、history 和 analyze 已写入行数据的投影——因此,报告不会与生成它的 analyze 运行结果相矛盾,同一次运行的两份报告也会逐字节完全相同。
提取器是独立进程,会在 stdout 上输出以换行符分隔的 JSON。核心不会链接到任何解析器,因此仅适用于 JVM 的 Java 解析器和仅适用于 Node 的 Angular 解析器可以共存,而不会彼此影响核心
(ADR-0001、
ADR-0003)。TypeScript 提取器和核心一样使用 Node,因此构建会强制执行这条边界,而不是依赖约定:它在自己的 rootDir 下编译,从 src/ 导入内容会导致编译失败。
开发
npm install
npm test           # vitest
npm run typecheck
npm run build
npm run stratigraph -- doctor      # run the CLI from source

cd extractors/java && ./mvnw verify # the extractor and its golden tests
TypeScript 测试套件不需要 JDK——核心使用会输出预设 NDJSON 的模拟提取器进行测试,因为协议就是完整的契约。提取器自身的测试套件会断言每个测试样例输出的精确事实,而 CI 会运行一个让真实 jar 与真实事实存储配合工作的任务。
它只在一项测试中需要 git;该测试会构建自己的仓库,并使用固定的日期和作者。历史记录的其他所有测试都基于 fixtures/git-log/ 中捕获的 git log,或基于预置的行数据,因此三操作系统矩阵不依赖任何未安装的二进制文件。
贡献
CONTRIBUTING.md 列出了约定,而且这些约定比大多数项目都严格:没有测试样例测试的解析器更改不会被合并,每个不明显的决策都需要 ADR,并且任何内容都不得陈述无法引用依据的事实。
目前最有帮助的贡献不是代码。 请在我从未见过的仓库上运行它,并告诉我它哪里出错了——错误的边、遗漏的端点、产生噪声的发现。自信但错误的依赖关系图正是本项目旨在避免的问题,因此,本不该出现的事实与缺失的事实一样,都值得报告。我们有专门用于此类报告的问题模板。
安全问题请通过 SECURITY.md 提交,切勿公开创建问题。 CHANGELOG.md 说明了发生了哪些更改以及原因。
约定:
- 事实层的所有内容都先写测试。没有测试样例测试的解析器更改不会提交。
fixtures/中的测试样例都很小、由人工编写,并会断言精确的事实输出。唯一例外是fixtures/git-log/,它是从真实 git 中捕获的——它断言的是 git 的输出;凭记忆编造这种输出,会导致解析器处理一种实际上无人生成的格式。- 不做推测性抽象:先有两个具体实现,再引入接口。
- 每个不明显的决策都需要在
docs/adr/中记录 ADR。
许可
Apache-2.0。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。