关于 Infrawise
Infrawise 静态分析代码、云基础设施和数据库架构,为 AI 编码 Agent 提供具体的基础设施上下文。它面向使用 AWS 和数据库、需要基础设施感知分析与建议的开发团队。
主要功能
- 01分析代码、基础设施和架构
- 02关联函数、数据表与服务
- 03检测全表扫描和缺失索引
- 04建议数据库索引定义
- 05检查 AWS 服务及其关系
- 06缓存分析并刷新变更文件
适用场景
- 01检查函数的数据库访问模式
- 02查找高风险扫描和缺失索引
- 03修改代码前审查 AWS 资源
- 04在 CI 中按严重级别阈值检查
MCP 相关
Infrawise 通过 MCP 工具提供基础设施快照和分析,包括架构、服务关系、问题发现及索引建议。它支持用于编辑器集成的 stdio 和 HTTP 端点。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
Infrawise
你的 AI 编码助手终于了解你的基础设施了。


Infrawise 为 AI 编码助手提供确定性的基础设施感知能力。
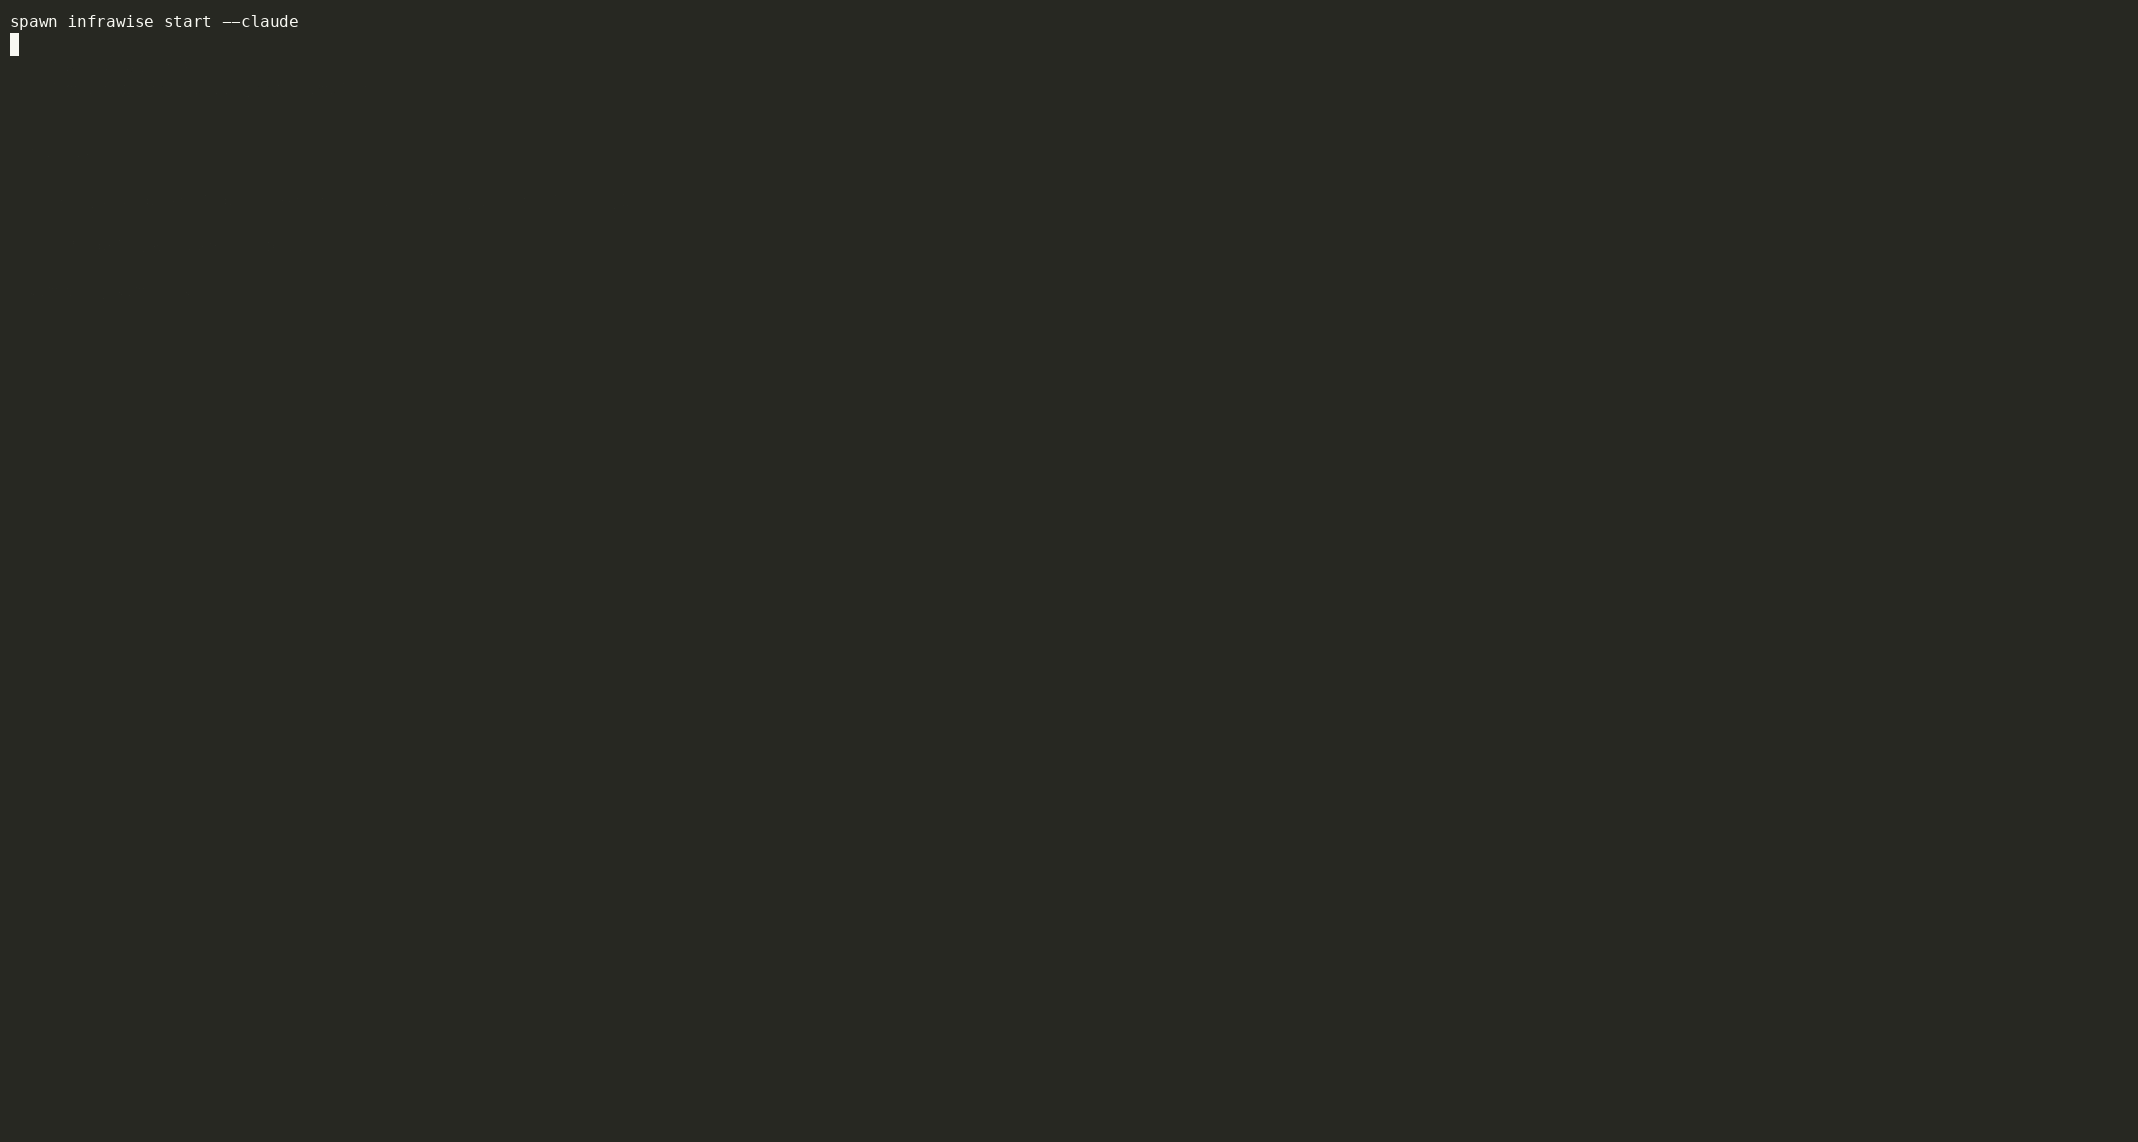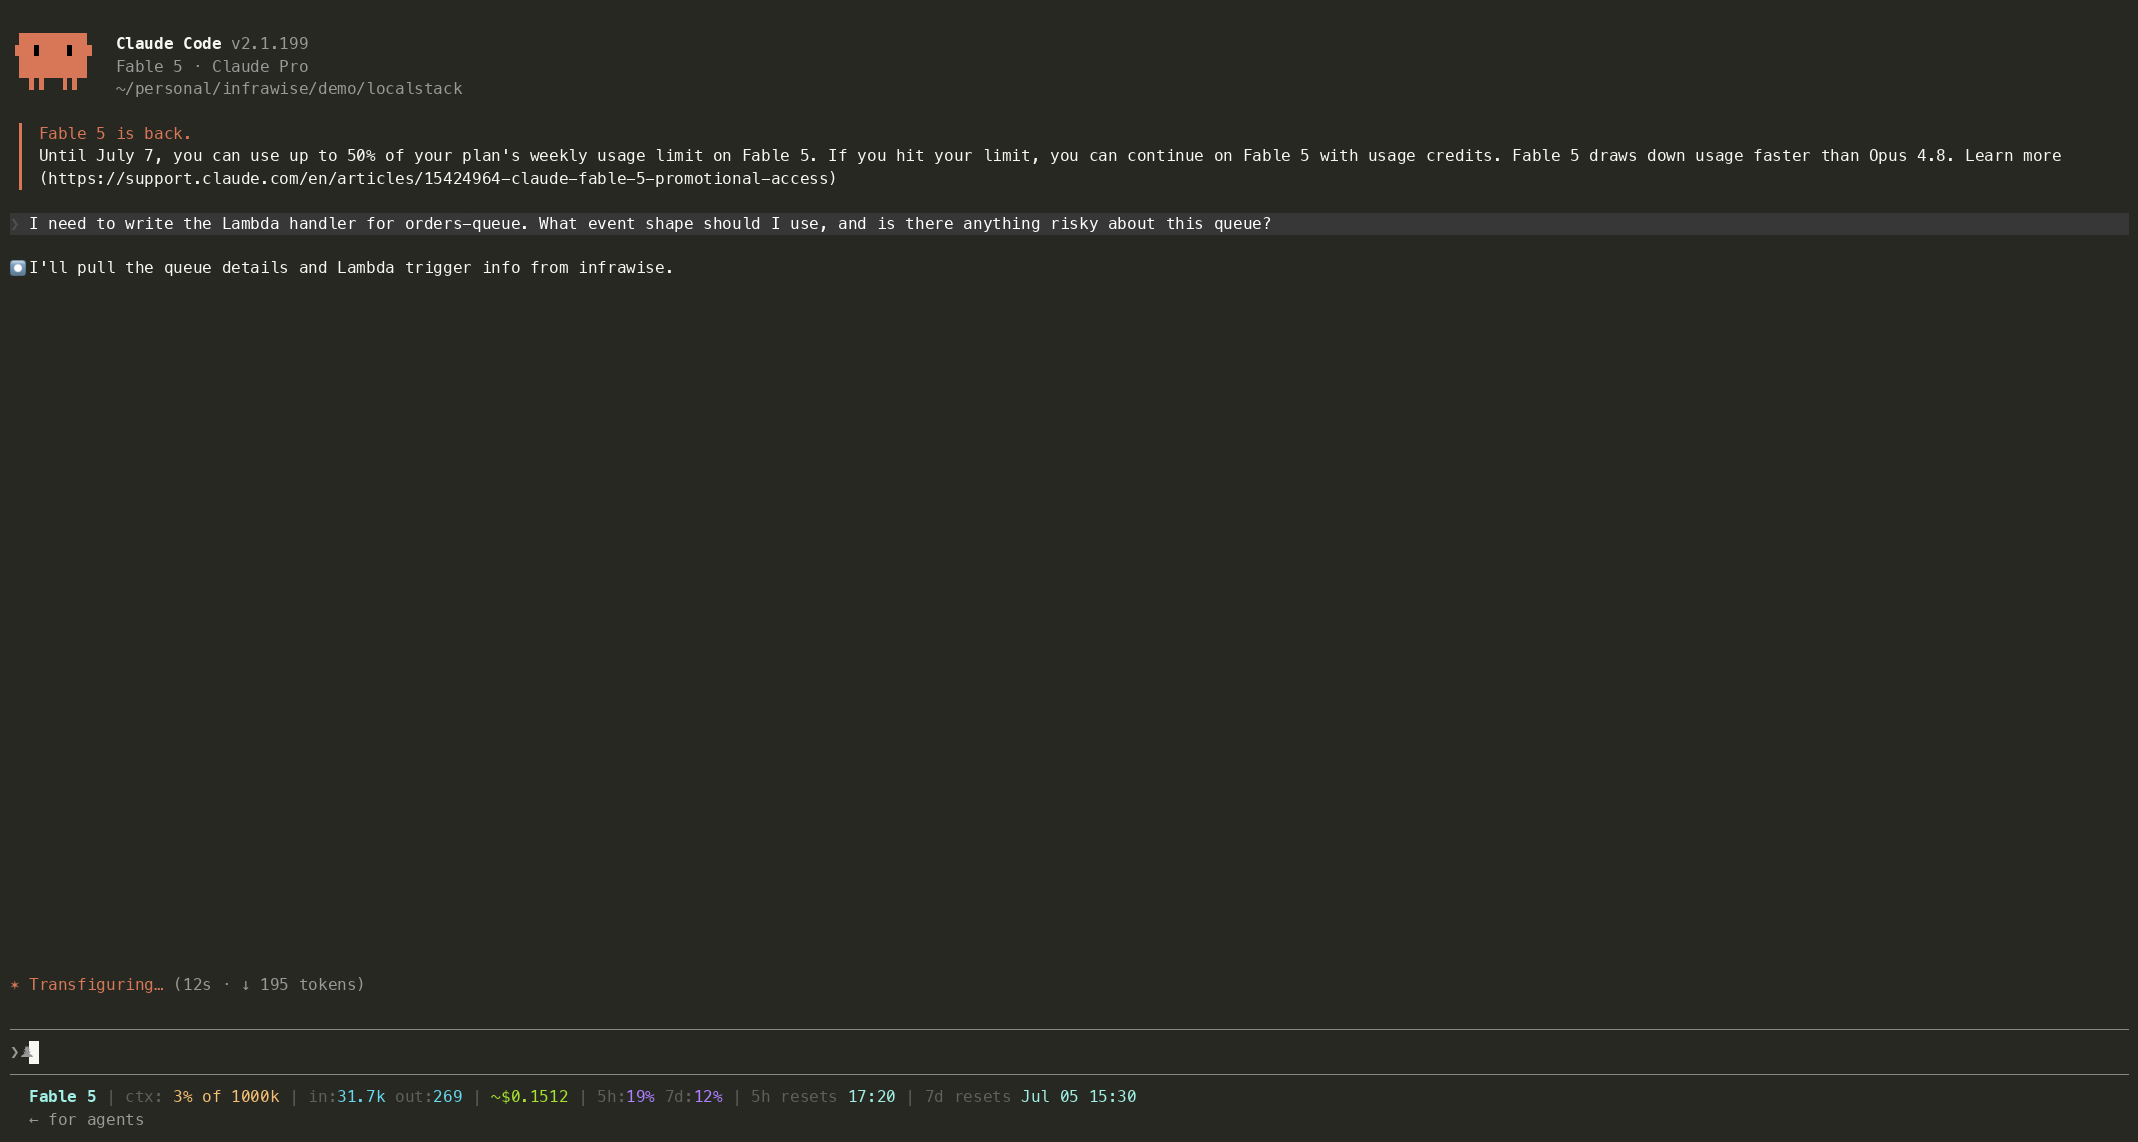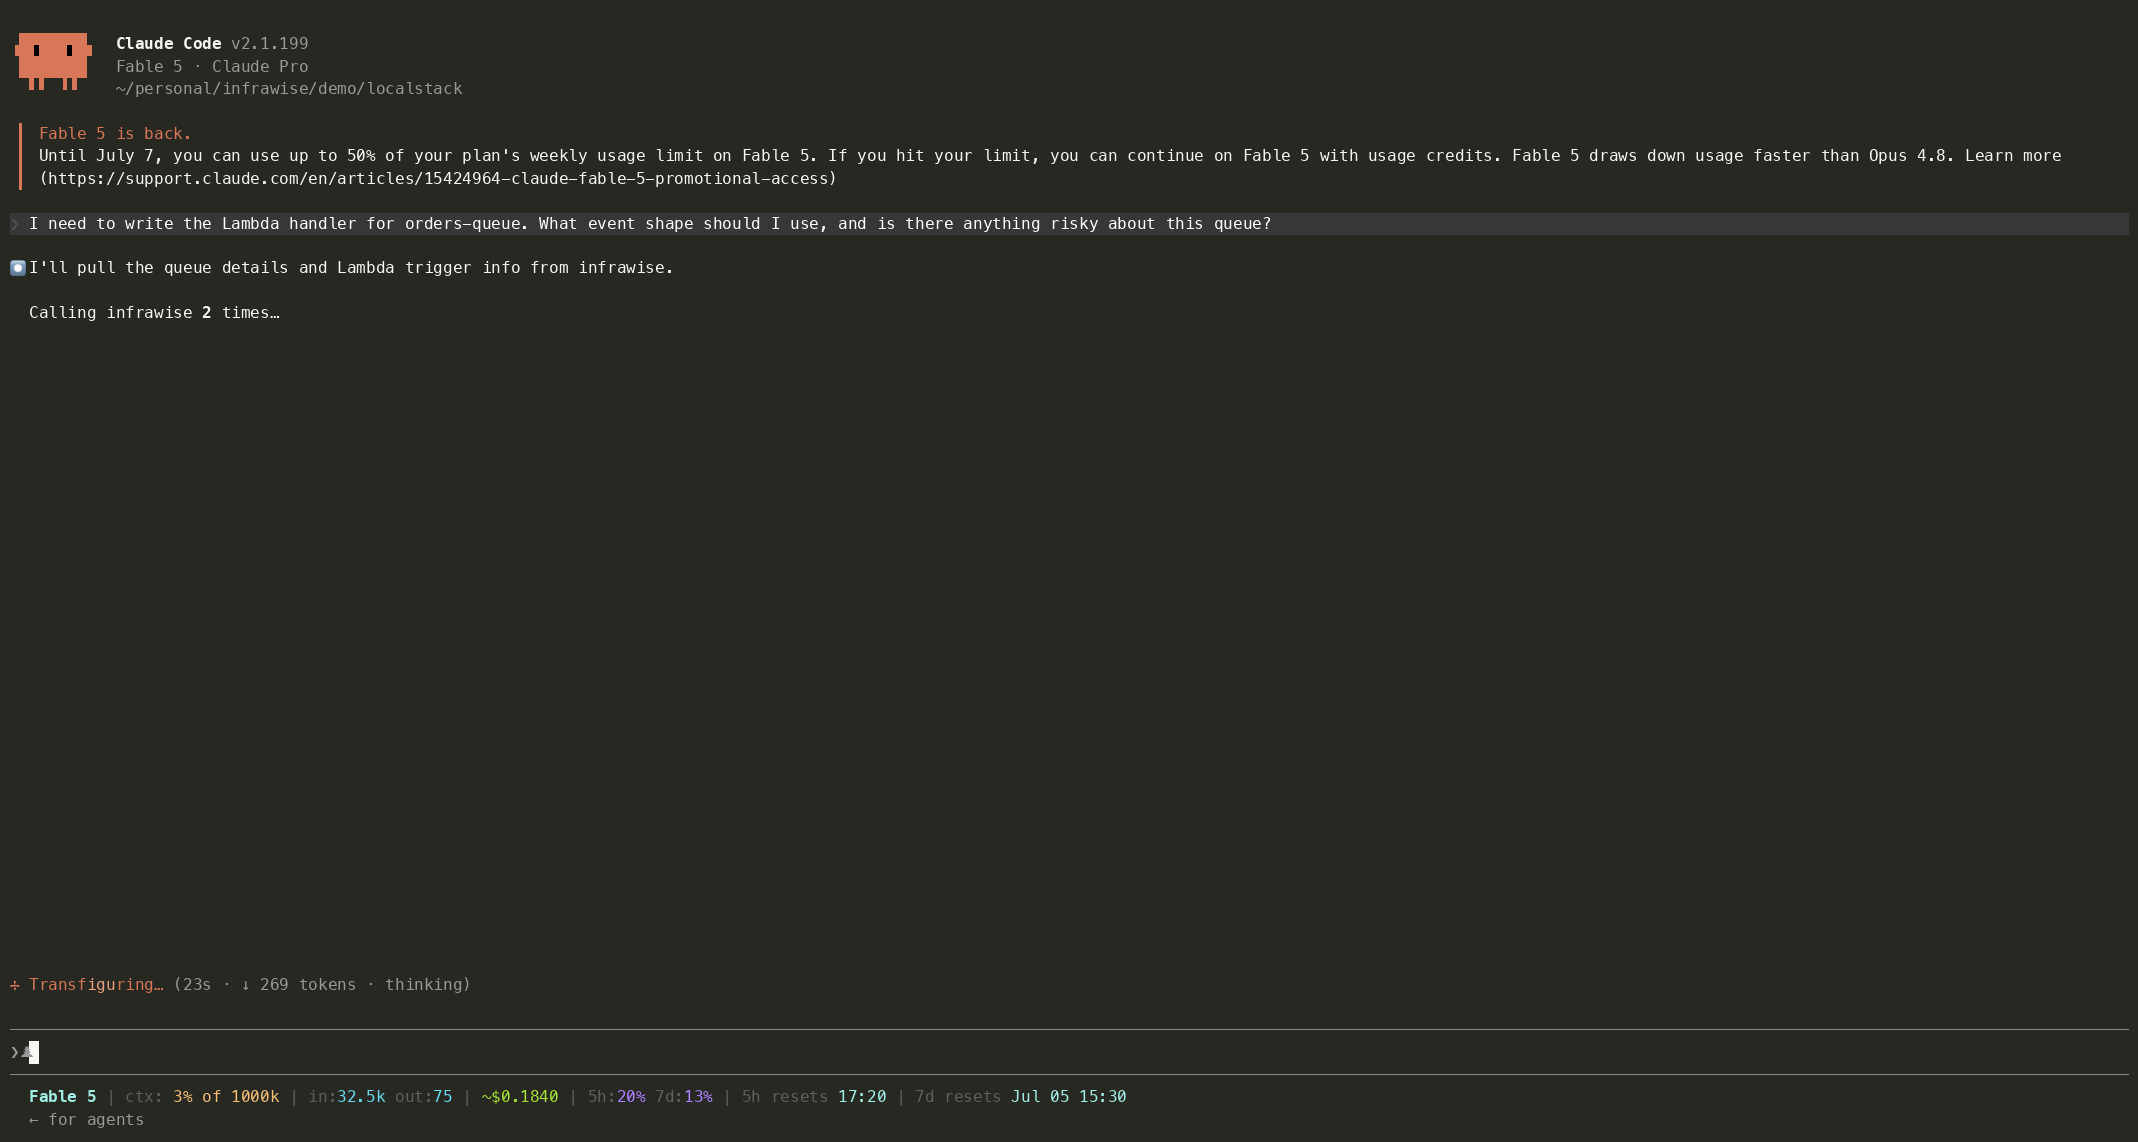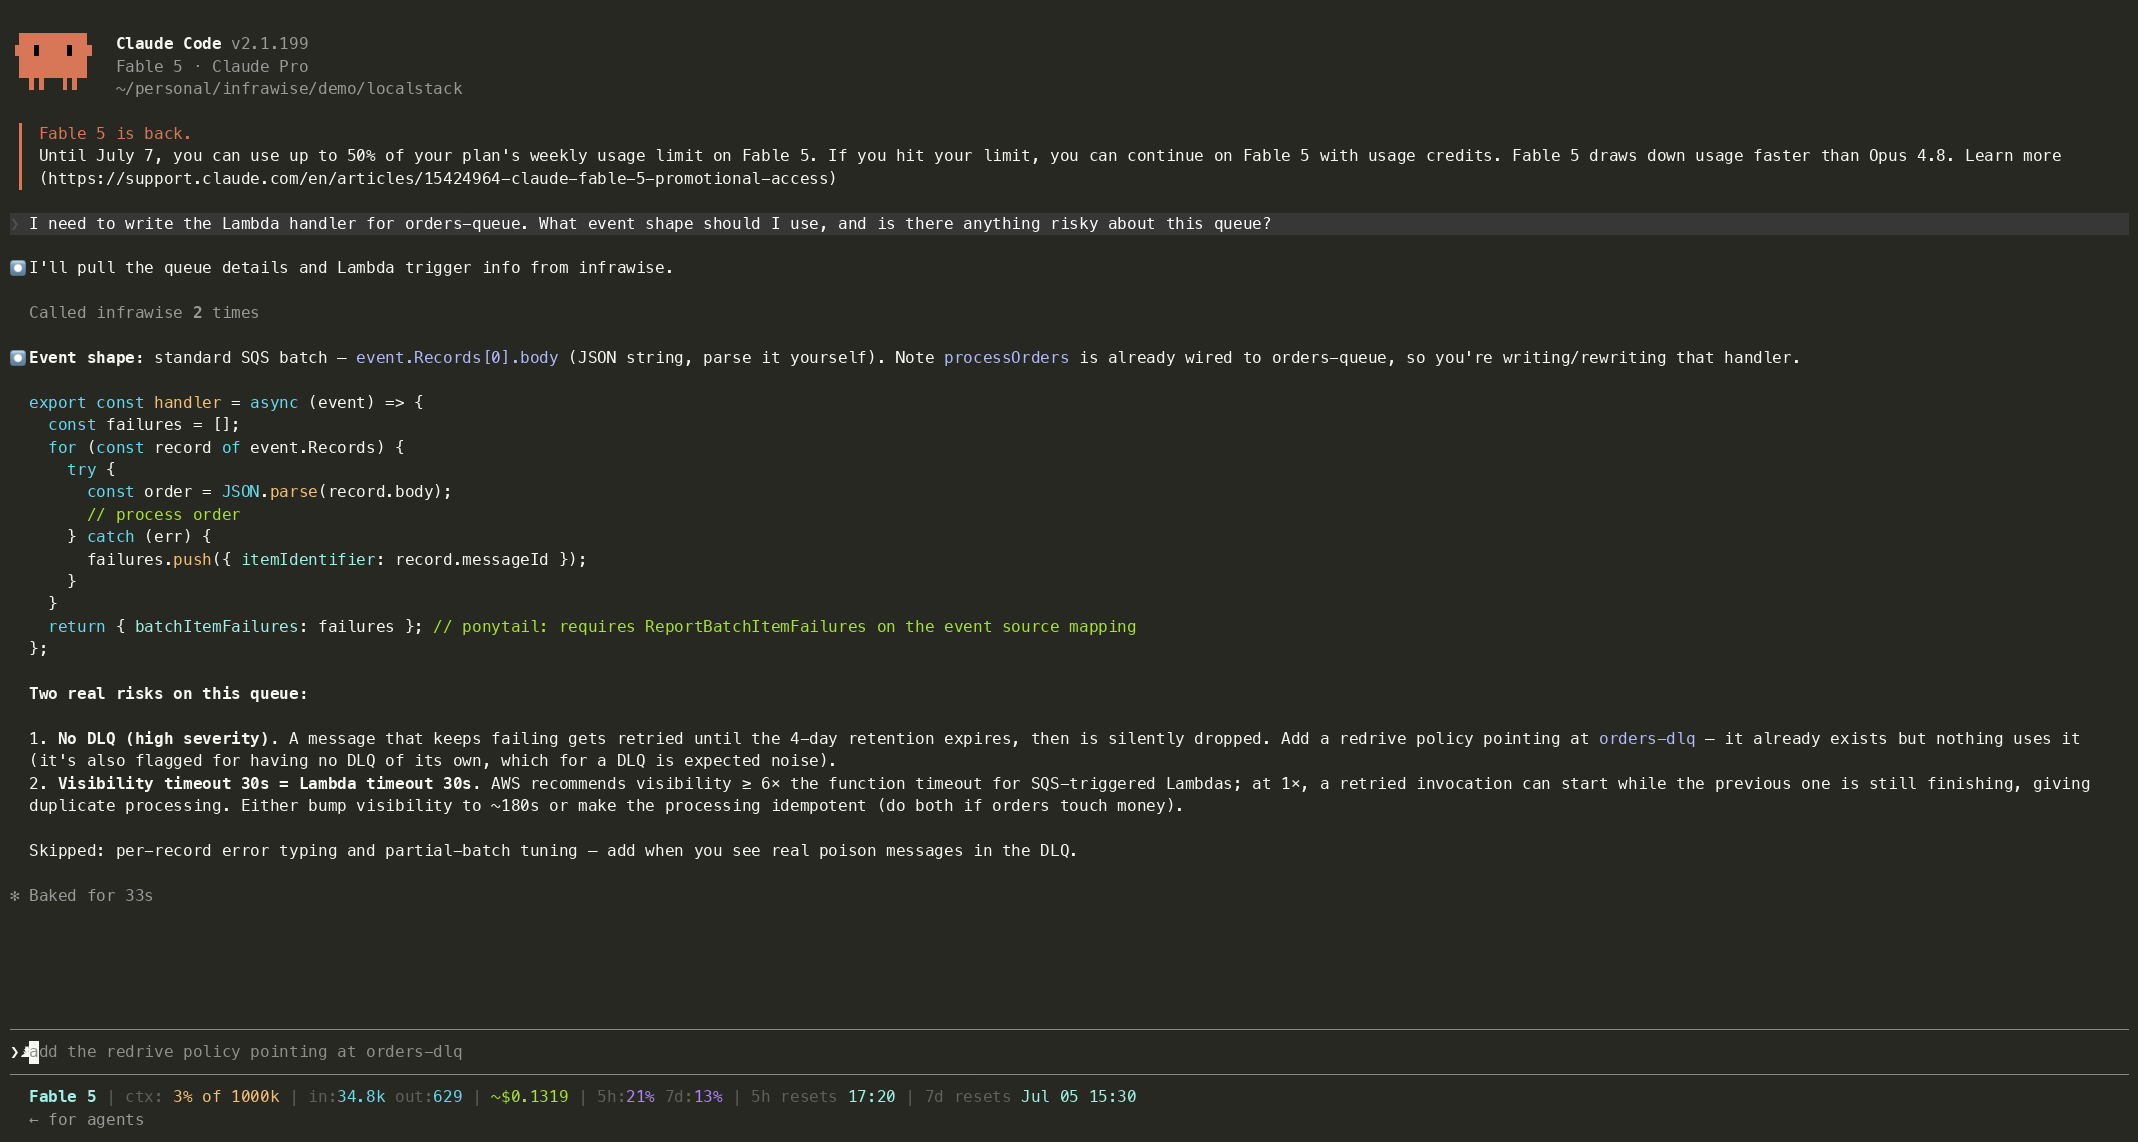
它会对你的代码库、云基础设施和数据库架构进行静态分析,然后通过 MCP 提供这些上下文,让 Claude Code 等工具能够了解你的实际表、索引、查询模式和服务关系,而不是仅凭源文件猜测。
为什么要构建它
新手开发者不会写出错误代码。Claude Code 会写出错误代码,而他们会把它发布上线。Infrawise 是阻止 Claude Code 生成的代码引发生产事故的唯一屏障。
AI 编码助手可以读取你的源文件,却无法确定地了解你的基础设施。它们不知道有哪些 GSI、表如何分区、哪些函数已经触发了扫描,也不知道哪里缺少索引。因此它们只能猜测。
Infrawise 用具备基础设施感知能力的上下文取代猜测。
没有 Infrawise 时,AI 助手可能会:
- 建议对包含 50M 行的 Orders 表使用
.scan() - 建议在
status上添加你已经拥有的 GSI - 在你需要降低查询成本时编写
SELECT * - 没有注意到已有 5 个函数在反复访问同一个分区键
使用 Infrawise 后,它可以了解:
- 你的准确表架构、分区键、排序键和 GSI
- 哪些函数会查询哪些表,以及具体如何查询
- 哪些模式已被标记为高严重性
- 适用于你表的准确
CREATE INDEXSQL 或 GSI 配置,而非泛泛的建议
Infrawise 不是什么
Infrawise 不是 AI Agent 框架、基础设施配置工具、可观测性平台或云管理仪表板。
它是一个用于 AI 辅助开发的确定性基础设施智能层。
安装
需要 Node.js 22 或更高版本(node --version)。
npm install -g infrawise
或无需安装即可使用:
npx infrawise start --claude
快速开始
cd your-project
infrawise start --claude
就这么简单。Infrawise 将会:
- 探测你的环境并生成
infrawise.yaml(仅首次运行时——只有在你有多个 AWS 配置文件时,才会询问要使用哪个) - 扫描你的 AWS 服务、数据库和代码库
- 写入
.mcp.json,以便编辑器在此后每次启动时自动连接 - 打开 Claude Code,并准备好全部 22 个 MCP 工具
此后每次运行:
claude # no infrawise command needed — editor manages the connection
分析结果会缓存 24 小时。infrawise serve --stdio(由编辑器自动启动)会连接并列出工具,不会加载快照或运行分析。首次调用基础设施工具时会加载缓存;如果缓存不存在或已过期,该调用会等待新的分析完成。并发调用会共享这次初始分析。打开编辑器前运行 infrawise start,即可预先准备缓存,避免首次调用等待。快照加载后会启动文件监视。HTTP serve 仍会在监听前加载快照。
首次代码刷新后,服务会将 TypeScript 项目保留在内存中,只扫描发生变更的文件及其传递导入方。Python 文件保存时,只扫描发生变更的 Python 文件。新增和删除的文件会更新快照;保存操作会合并处理,间隔为两秒;刷新期间的编辑会排队等待。更改 tsconfig*.json 会重建扫描器。为保留跨资源发现的问题,IaC 提取、图构建和分析器仍会针对完整快照运行;云元数据则会继续缓存。无需任何配置或 CLI 标志。
Findings (3 total)

1. [HIGH] Full table scan detected on DynamoDB table "Orders"
   listAllOrders() scans without any filter — reads every item in the table.
   Recommendation: Replace Scan with Query using a partition key or add a GSI.

2. [MEDIUM] PostgreSQL table "users" has no index on column "email"
   No matching leading-column index was observed for "email"; verify with EXPLAIN.
   Recommendation: CREATE INDEX CONCURRENTLY idx_users_email ON users(email);

3. [MEDIUM] DynamoDB table "Sessions" accessed by 6 distinct code paths
   High access concentration may create hot partition issues at scale.
与 AI 编码助手搭配使用
Claude Code(推荐)
infrawise start --claude
此命令会将 .mcp.json 写入项目根目录(并与其中已配置的 MCP 服务合并),然后打开 Claude Code。Claude Code 每次启动时都会自动读取 .mcp.json,并管理 infrawise serve --stdio 进程——无需启动服务,也无需配置端口。
Infrawise 也可以作为 Claude Code 插件安装。它会注册同一个 MCP 服务,但项目中仍需有 infrawise.yaml,此文件可通过 infrawise start 创建:
/plugin marketplace add Sidd27/infrawise
/plugin install infrawise@infrawise
Cursor
infrawise start --cursor
此命令会写入 .cursor/mcp.json(并与任何现有 MCP 服务合并),然后打开 Cursor。Cursor 的 MCP 面板中可以使用全部 22 个 infrawise 工具。
VS Code
infrawise start --vscode
此命令会写入 .vscode/mcp.json(并与任何现有 MCP 服务合并),然后打开 VS Code。Copilot Agent 模式可通过 MCP 服务面板使用这些工具。
任意编辑器(无标志)
infrawise start
此命令会写入 .mcp.json(并与任何现有 MCP 服务合并),然后退出。打开你喜欢的编辑器,并将 infrawise serve --stdio --config /path/to/infrawise.yaml 指定为 MCP 服务命令。
HTTP 传输(替代方式)
如果你的编辑器或工作流需要 HTTP MCP 端点,而不是 stdio:
infrawise serve # starts server at http://localhost:3000/mcp
在编辑器的 MCP 配置中添加:
{
  "mcpServers": {
    "infrawise": {
      "url": "http://localhost:3000/mcp"
    }
  }
}
MCP 工具
每个工具都标记为只读(readOnlyHint: true,openWorldHint: false),因此支持这些注释的 MCP 客户端无需确认提示即可调用这些工具。
| 工具 | 提供内容 |
|---|---|
get_infra_overview | 完整快照——服务、数量、高严重性发现、configured 标记(数据时效和每个来源的状态通过每个响应中的 dataHealth 块提供) |
get_graph_summary | 完整基础设施图——所有节点、边和发现 |
get_table_schema | 指定表/集合的列级架构——类型、主键、外键、索引、DynamoDB 键/计费模式、成本信号(不含行数据) |
analyze_function | 特定函数中的问题——扫描、缺失索引、N+1、触发事件形态、缺失的 IAM 权限;将每个同名文件作为单独匹配项返回,或通过可选的 file 输入绑定到其中一个文件;列出被拒绝链接的 Lambda 及原因(unresolvedLambdas) |
suggest_gsi | 为 DynamoDB 表和属性提供精确的 GSI 配置;如果现有索引已覆盖,则改为指出该索引 |
postgres_index_suggestions | 针对实际表的精确 CREATE INDEX SQL |
suggest_mongo_index | 针对 MongoDB 集合和字段的精确 createIndex 命令 |
mysql_index_suggestions | 针对 MySQL 表的精确 ALTER TABLE ADD INDEX SQL |
get_queue_details | SQS 队列——DLQ 状态、加密、FIFO 类型、可见性超时、消息数量 |
get_api_routes | API Gateway API(REST、HTTP、WebSocket)——路由、HTTP 方法、路径和 Lambda 集成 |
get_topic_details | SNS 主题——订阅数量、协议和筛选策略(每个订阅所需的消息属性) |
get_secrets_overview | Secrets Manager——名称、轮换状态,以及从代码推断出的密钥名称(不包含值) |
get_parameter_overview | SSM Parameter Store——名称、类型、层级(不包含值) |
get_lambda_overview | Lambda 函数——运行时、内存、超时、执行角色 ARN、触发器(SQS/SNS/DynamoDB/Kinesis/MSK/EventBridge/S3)、环境变量键名、成本信号,以及 Lambda 无法链接到其源代码的原因(unresolvedLink) |
get_eventbridge_details | EventBridge 规则——名称、状态、计划/事件模式、目标函数 |
get_s3_overview | S3 存储桶——版本控制、加密、公共访问、事件通知 |
get_log_errors | CloudWatch 日志组名称和保留期(仅元数据;不含消息正文) |
get_stack_outputs | 从本地 IaC 文件解析出的堆栈输出和跨堆栈导出,并为孤立的 cdk.out 模板标注过时标记 |
get_cognito_overview | Cognito 用户池——MFA 配置、应用客户端身份验证流程、OAuth 设置、令牌有效期(不包含密钥) |
get_stream_details | Kinesis 流(分片、保留期、容量模式)和 MSK 集群(状态、Kafka 版本、代理) |
get_cache_overview | ElastiCache 集群——引擎、传输中/静态加密、复制组、故障转移、成本信号(不读取数据) |
get_cloudfront_overview | CloudFront 分配——各行为的路径模式、源站(S3 或自定义,解析出的 API Gateway 名称)、缓存策略、查看器协议策略 |
每个响应都会携带一个结构固定的 dataHealth 块,包含读取基础设施的时间和距今时长、该回答所依赖的各个数据源状态、此后是否对 cdk.out 执行过合成,以及用于刷新的命令。每个键始终存在,因此无需根据字段缺失来推断——无法区分空结果和读取失败时,“没有队列需要配置 DLQ”看起来就和“SQS 从未列出”一样。 |
Infrawise 只报告,不做裁决。对于需要反映特定时间点的提问,可传入 maxAgeSeconds;回答会告知数据是否符合要求(仅供参考——数据仍会返回,并标明状态)。运行中的服务会在每次工具调用时重新检查缓存,因此打开的会话在下次提问时就能获取最新的 infrawise analyze 结果,无需重启。infrawise analyze 和 infrawise check 会打印相同的数据源警告;只要有任何数据源未能读取,就不会将该次运行标记为干净。
数据时效只是基础设施漂移的替代指标,并非漂移本身——一份三天前采集的快照,如果账户未发生变化,依然准确;而一份五分钟前、在执行 terraform apply 之前采集的快照则不准确。Infrawise 如何处理数据陈旧问题介绍了这种替代指标何时会误导,以及该如何处理;数据新鲜度参考则提供逐字段表格和 freshness 配置键。
CLI 参考
| 命令 | 功能 |
|---|---|
infrawise start | 主要命令 — 探测环境、生成配置、分析并写入编辑器 MCP 配置 |
infrawise start --claude | 与上述相同,然后打开 Claude Code |
infrawise start --cursor | 与上述相同,然后打开 Cursor |
infrawise start --vscode | 与上述相同,然后打开 VS Code(合并到 .vscode/mcp.json) |
infrawise start --interactive | 运行引导式设置向导,而非自动发现 |
infrawise start --rediscover | 删除 infrawise.yaml + .infrawise/,然后重新探测和分析 |
infrawise analyze | 强制完整重新扫描,并显示提取进度和根据过往运行估算的耗时——适用于基础设施发生重大变化之后 |
infrawise check | CI 门禁 — 执行分析,并在发现达到阈值严重级别时以非零状态码退出 |
infrawise serve | 启动 MCP 服务 — 默认使用 HTTP;编辑器集成可使用 --stdio |
infrawise doctor | 诊断应急工具 — 验证 AWS/DB 访问、配置和仓库扫描 |
infrawise analyze 选项
| 标志 | 说明 |
|---|---|
-c, --config <path> | infrawise.yaml 的路径(默认:infrawise.yaml) |
-r, --repo <path> | 要扫描的仓库(默认:当前目录) |
--no-cache | 跳过读取和写入缓存 |
-o, --output <path> | 将发现结果保存为 Markdown 报告,例如 report.md |
--severity <level> | 仅显示达到或高于此级别的发现结果:high | medium | low |
# Export a shareable findings report
infrawise analyze --output report.md

# Only show high-severity issues
infrawise analyze --severity high

# High-severity issues only, saved to a file
infrawise analyze --severity high --output report.md
infrawise check 选项(CI/CD)
check 会运行一次全新的分析;如果存在阻塞性发现,则返回非零退出代码,因此无需 AI 编辑器即可将其用于门控流水线。
| 标志 | 说明 |
|---|---|
-c, --config <path> | infrawise.yaml 的路径(默认:infrawise.yaml) |
-r, --repo <path> | 要扫描的仓库(默认:当前目录) |
--fail-on <level> | 导致构建失败的严重程度:high(默认)| medium | low |
--allow-incomplete | 明确允许在数据源读取失败或未完整读取时仍然成功 |
# Block a deploy if any high-severity finding exists (exit 1)
infrawise check

# Stricter gate — fail on medium and above
infrawise check --fail-on medium
infrawise serve 选项
| 标志 | 说明 |
|---|---|
-c, --config <path> | infrawise.yaml 的路径(默认:infrawise.yaml) |
--stdio | 使用标准输入输出传输(供编辑器通过 .mcp.json 使用),而非 HTTP |
-p, --port <number> | 监听端口,仅适用于 HTTP(默认:3000) |
配置
infrawise.yaml 由 infrawise start 生成(或使用 infrawise start --interactive 启动交互式向导),并存放在仓库根目录。每项服务都必须显式设置为 enabled: true;infrawise 绝不会连接配置中未列出的服务。
连接字符串支持 ${ENV_VAR} 替换,因此无需将密码提交到仓库:
postgres:
  enabled: true
  connectionString: postgresql://infrawise_ro:${DB_PASSWORD}@host:5432/mydb
完整示例:
project: payments-service

aws:
  profile: default # AWS profile from ~/.aws/credentials
  region: ap-south-1

dynamodb:
  enabled: true
  includeTables: # omit to include all tables
    - Orders
    - Users

postgres:
  enabled: true
  connectionString: postgresql://infrawise_ro:${DB_PASSWORD}@host:5432/mydb

mysql:
  enabled: false
  connectionString: ''

mongodb:
  enabled: false
  connectionString: ''

sqs:
  enabled: true

sns:
  enabled: true

ssm:
  enabled: true
  paths: [] # filter by prefix e.g. ["/myapp/prod"]

secretsManager:
  enabled: true

lambda:
  enabled: true
  includeFunctions: # omit to include all functions
    - myFunction
    - anotherFunction

eventbridge:
  enabled: true

rds:
  enabled: false

s3:
  enabled: false

apiGateway:
  enabled: false

cognito:
  enabled: false

kinesis:
  enabled: false

msk:
  enabled: false

elasticache:
  enabled: false

cloudfront:
  enabled: false

runtimeSignals:
  enabled: false # Lambda throttles/errors + queue age via CloudWatch metrics
  windowHours: 24

cloudwatchLogs:
  enabled: false
  logGroupPrefixes: []
  windowHours: 24

analysis:
  hotPartitionThreshold: 5
  hotPartitionThresholds:
    high-traffic-table: 12

freshness:
  suggestRefreshAfterHours: 6 # when MCP responses start hinting to re-analyze
AWS 设置
Infrawise 为只读。DynamoDB 所需的最低 IAM 策略:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["dynamodb:ListTables", "dynamodb:DescribeTable"],
      "Resource": "*"
    }
  ]
}
如需了解适用于所有受支持服务的完整策略、如何将其范围限制为仅启用的服务,以及如何使用会话策略获取临时范围受限的凭证,请参阅 AWS 设置指南。
对于 SSO 配置文件,请在运行 infrawise 前登录:
aws sso login --profile myprofile
PostgreSQL 设置(可选)
为 infrawise 创建一个只读用户:
CREATE USER infrawise_ro WITH PASSWORD 'yourpassword';
GRANT CONNECT ON DATABASE yourdb TO infrawise_ro;
GRANT USAGE ON SCHEMA public TO infrawise_ro;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO infrawise_ro;
对于 Amazon RDS:在安全组中允许从你机器的 IP 地址入站访问 5432 端口。
分析能力
Infrawise 有两个分析层:
基础设施分析(所有语言)
通过 AWS API、数据库架构检查和 IaC 文件进行分析——不依赖应用代码:
| 服务 | 检查内容 |
|---|---|
| DynamoDB 架构 | 表、GSI、分区键、计费模式、成本信号(预置容量) |
| PostgreSQL / MySQL 架构 | 表、索引、列类型 |
| MongoDB 架构 | 集合、索引 |
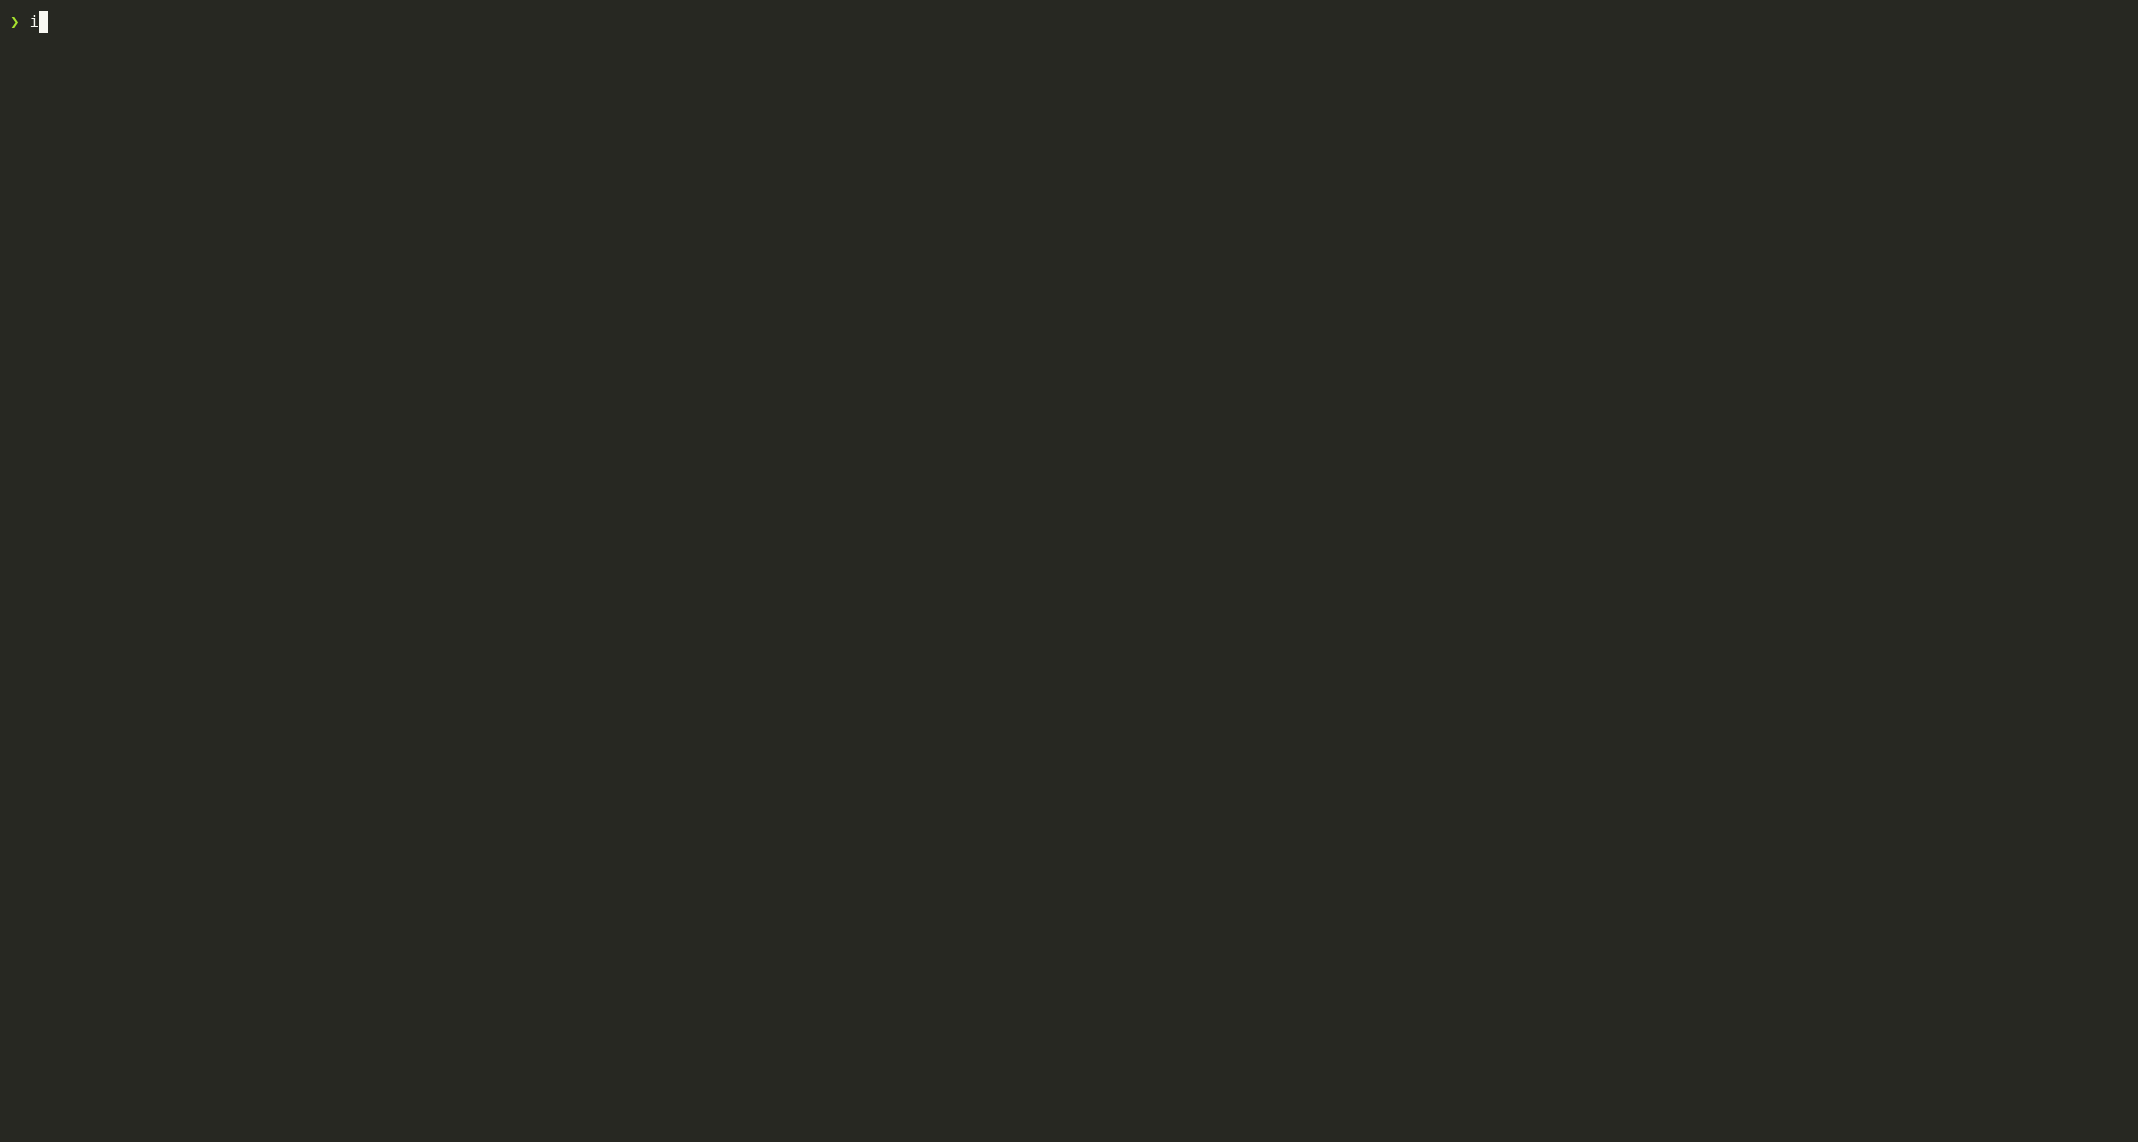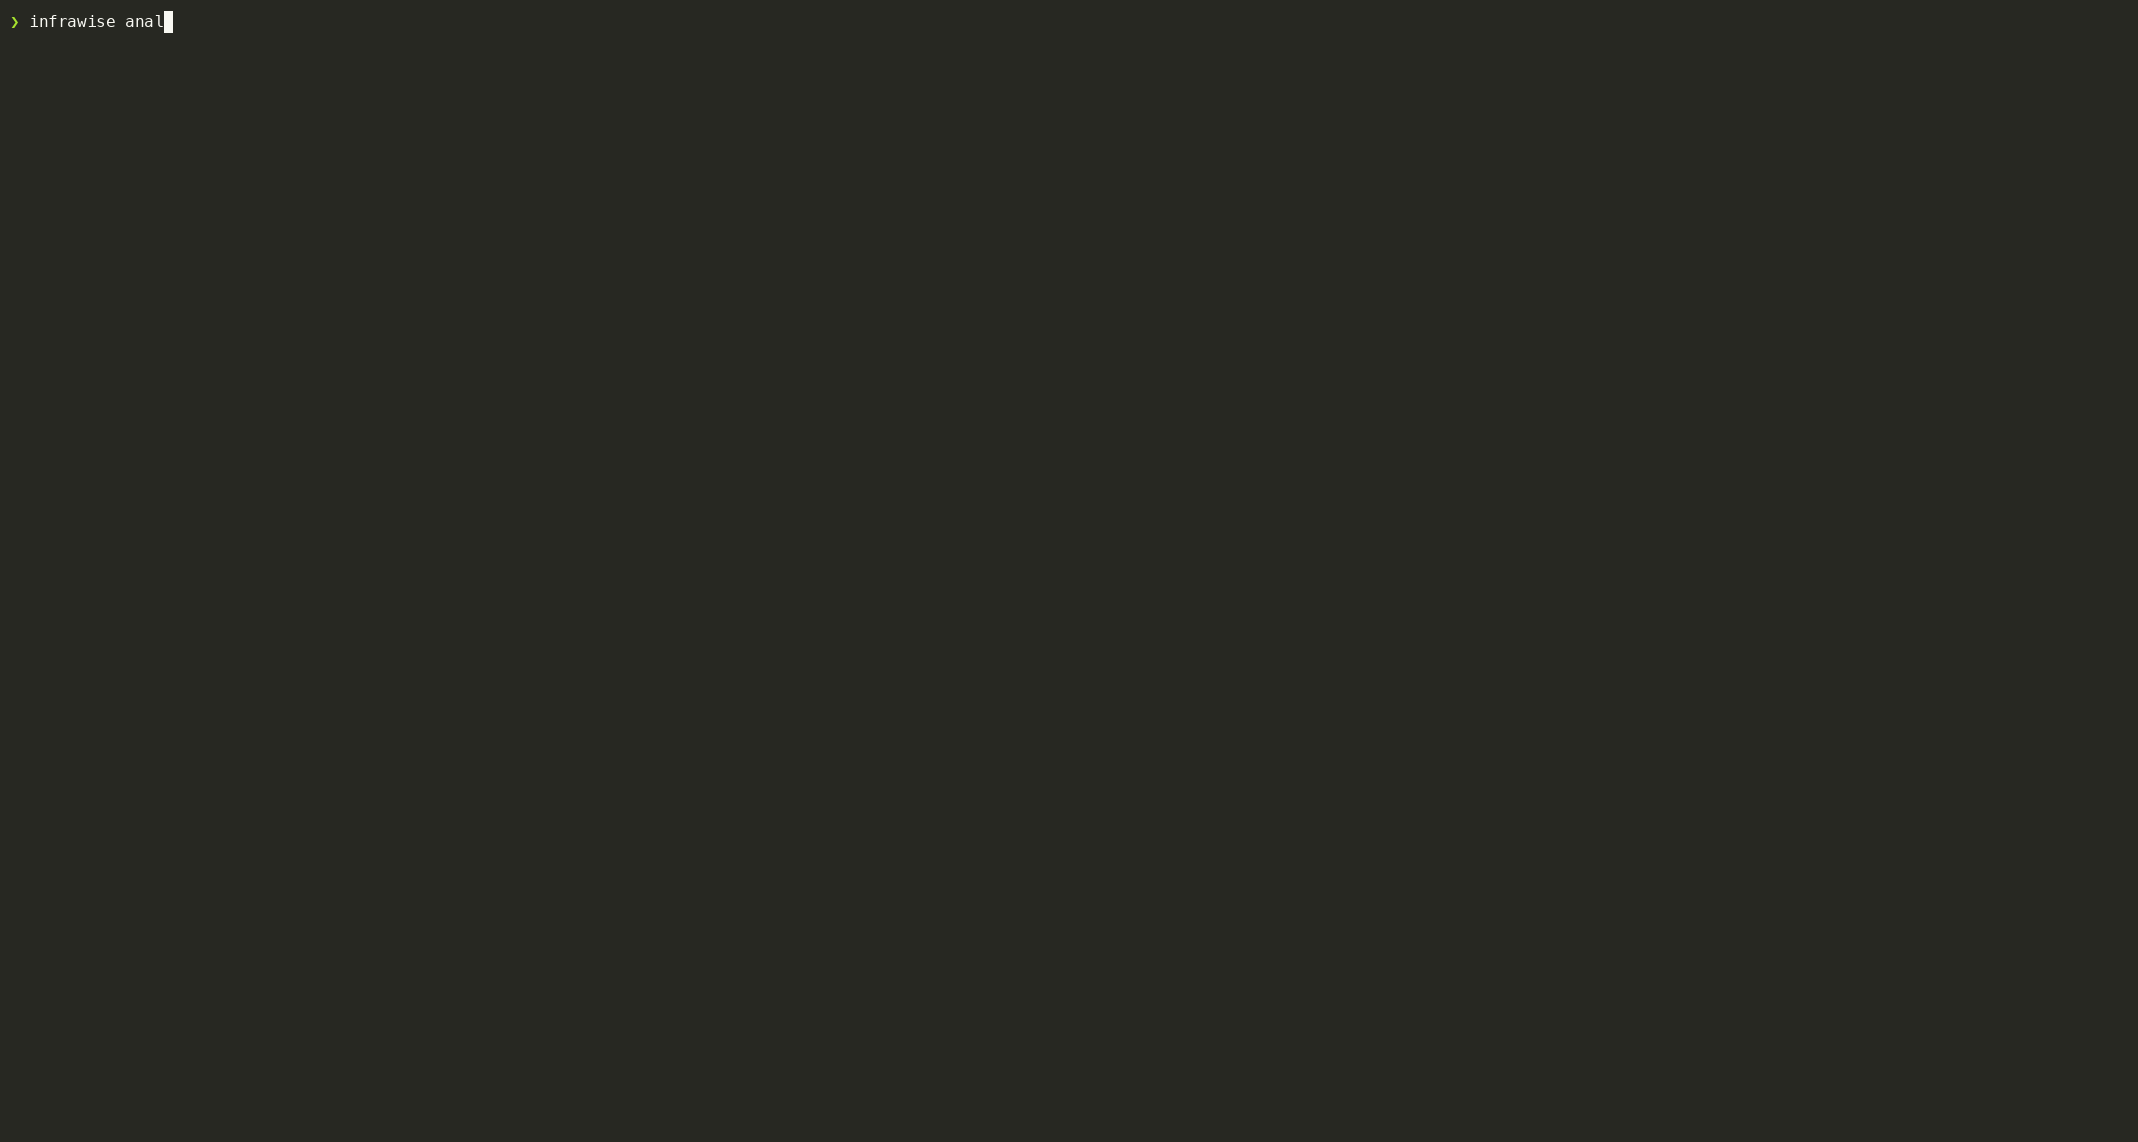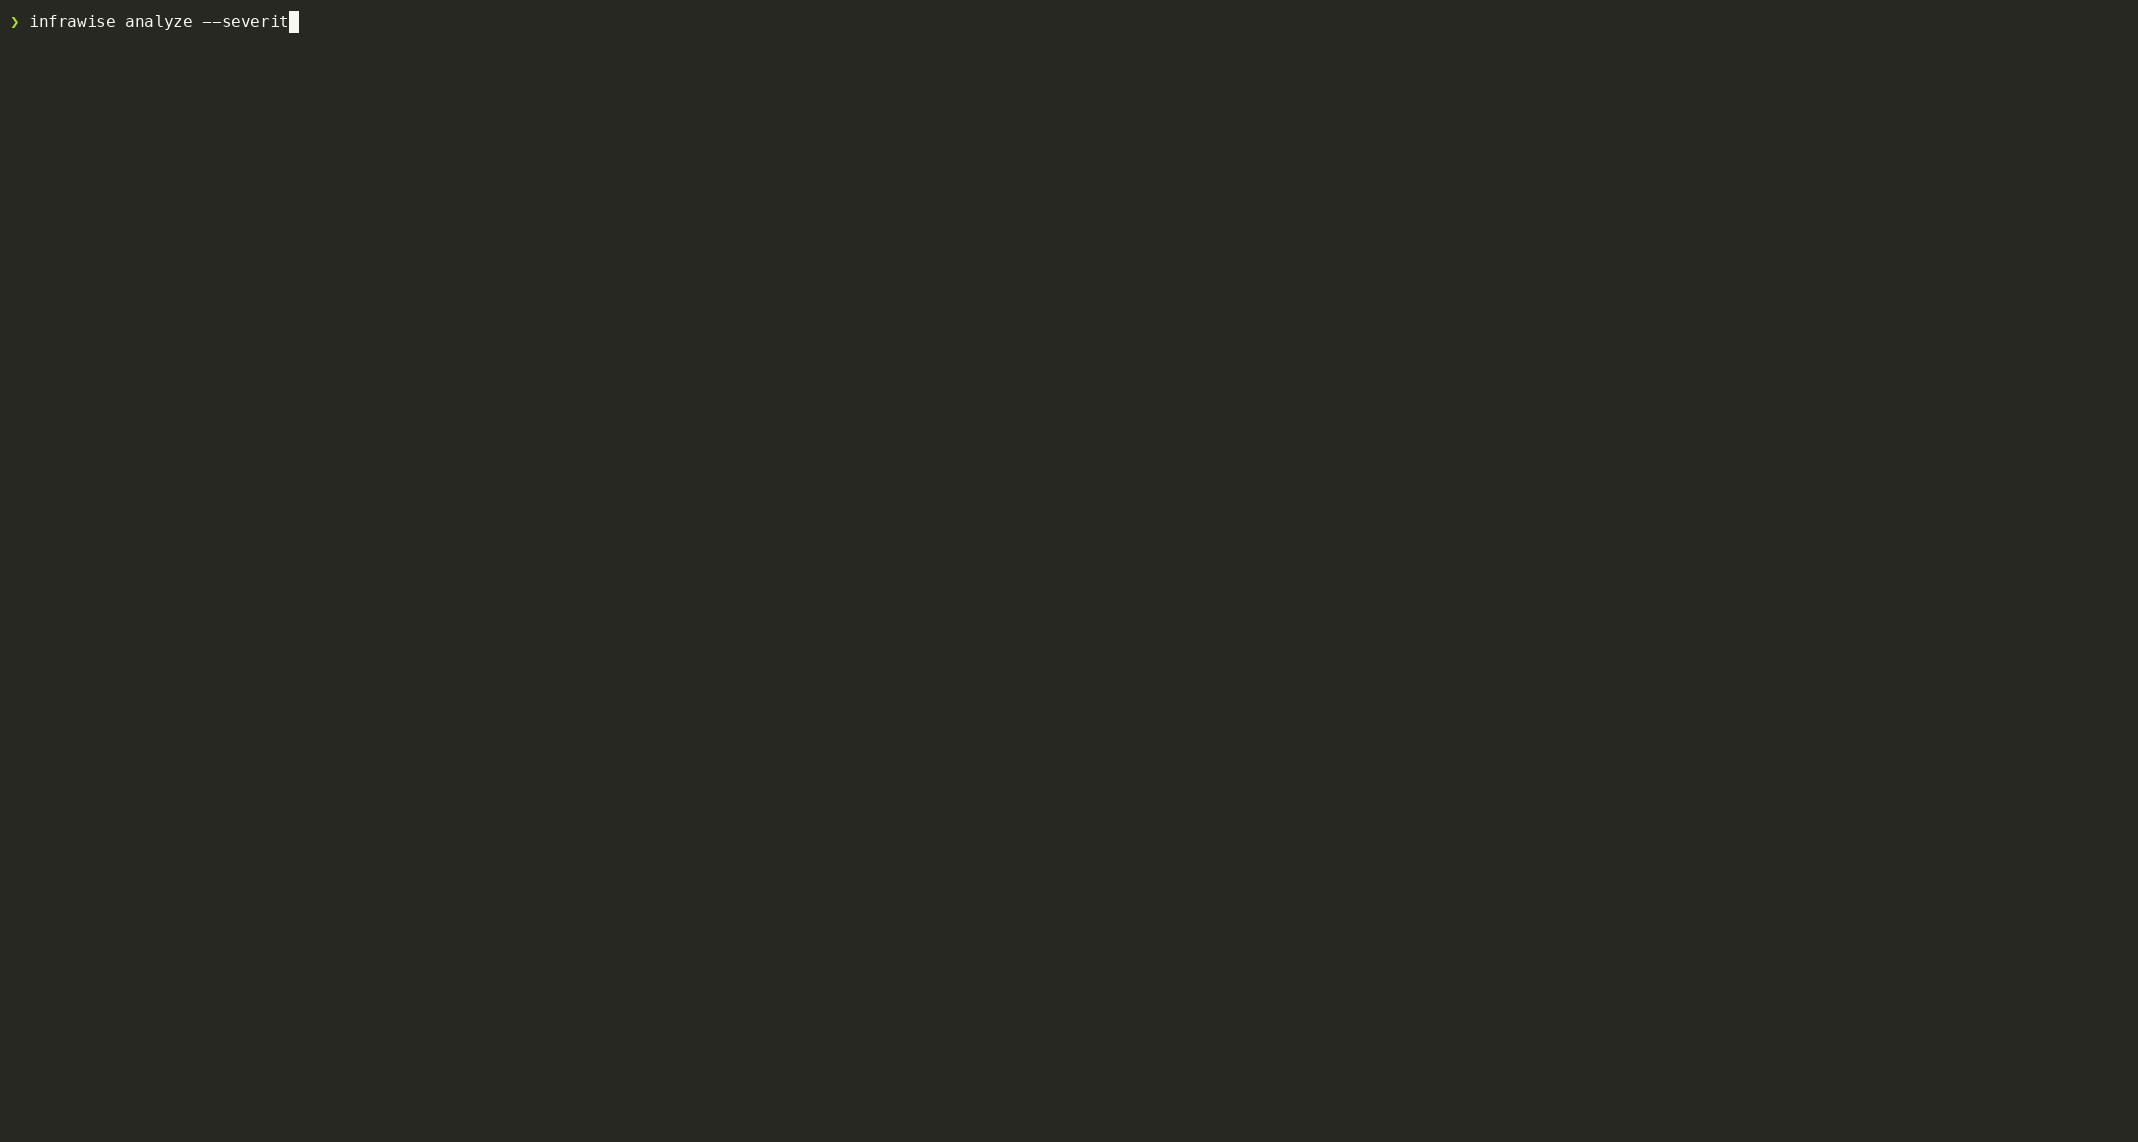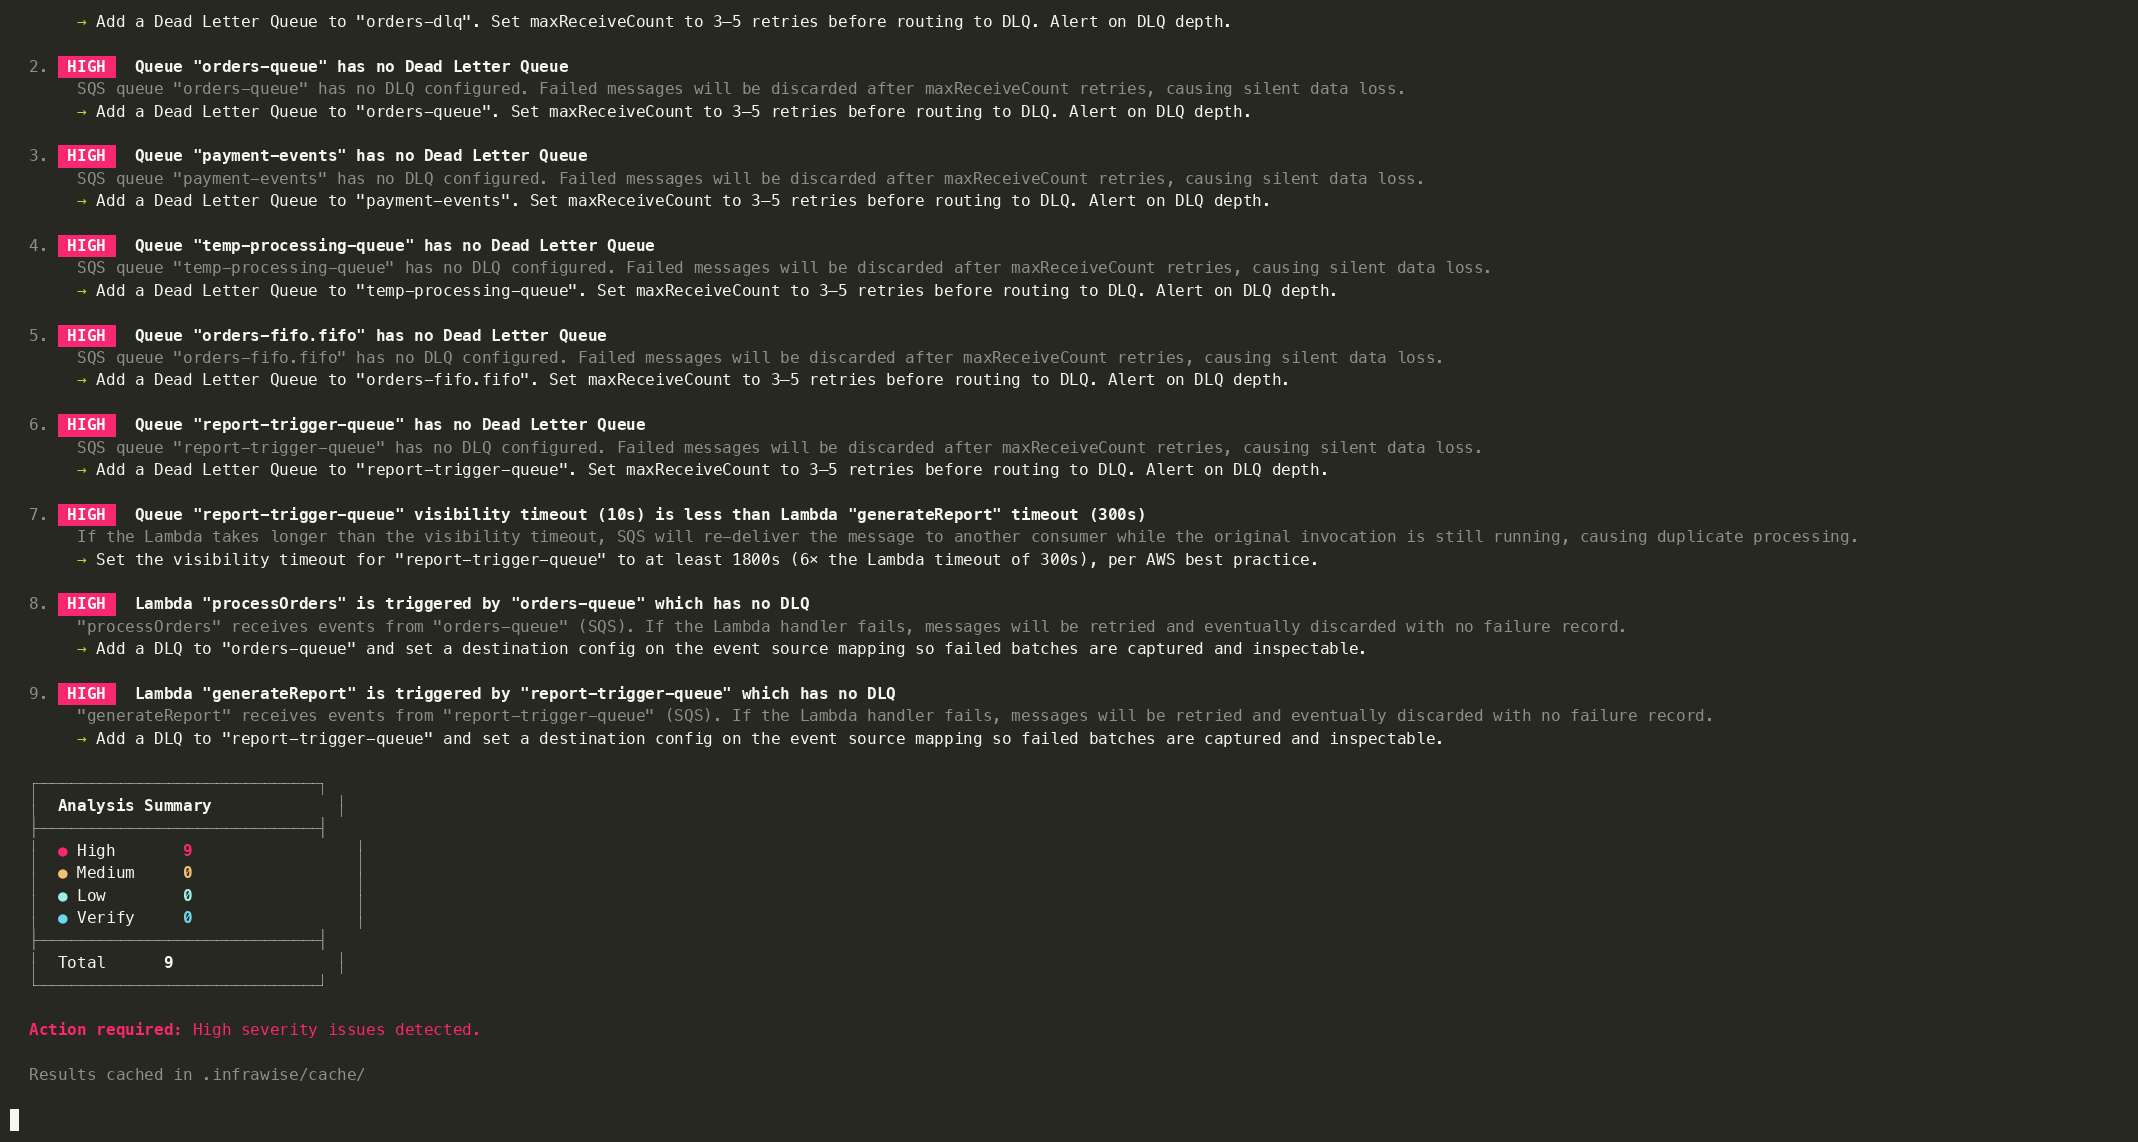
| SQS | 缺少 DLQ、未加密的队列、积压量过大、FIFO 检测、可见性超时短于消费者 Lambda 超时(高)或短于 AWS 建议值的 6 倍(中) |
| SNS | 订阅筛选策略——每个订阅所需的消息属性 |
| Apache Kafka (kafkajs) | 从代码中提取生产者/消费者主题映射——适用于任何代理(自托管、Confluent、Redpanda、MSK);不同于 MSK Lambda 触发器 |
| Secrets Manager | 缺少密钥轮换 |
| Lambda | 默认内存(128 MB)、超时过长、触发器(SQS/SNS/DynamoDB/Kinesis/MSK/EventBridge/S3)、触发源缺少 DLQ、成本信号(内存较高且没有限流迹象) |
| S3 | 公有访问阻止设置(验证)、缺少版本控制、缺少加密 |
| EventBridge | 规则、计划、事件模式、目标 Lambda 函数 |
| API Gateway | REST、HTTP 和 WebSocket API——路由、方法、Lambda 集成 |
| RDS | 可公开访问、无备份、未加密、无删除保护、单可用区、成本信号(非生产环境特征的实例却使用多可用区) |
| CloudWatch Logs | 未设置保留策略的日志组 |
| Cognito | 用户池和应用客户端配置——身份验证流程、OAuth 设置、令牌有效期、客户端密钥是否存在 |
| Kinesis / MSK | 流(分片、保留期、容量模式)和 MSK 集群(状态、Kafka 版本、代理) |
| ElastiCache | 缺少传输中加密、没有复制功能的单节点集群、成本信号(节点超过 3 个) |
| CloudFront | 通过明文 HTTP 提供流量的行为(allow-all 查看器协议策略) |
| 运行时信号(可选启用) | 来自 CloudWatch 指标的 Lambda 限流/错误和队列中过期的消息 |
| Terraform / CloudFormation / CDK | IaC 与已部署状态的漂移;堆栈输出和跨堆栈导出 |
代码关联分析(TypeScript / JavaScript / Python)
使用 ts-morph 进行 AST 分析,以检测哪些函数调用了哪些表,以及如何调用:
Python 仓库使用内置的 stdlib-ast 扫描器进行扫描(需要在 PATH 中找到 python3;否则会发出警告并跳过):扫描 boto3 客户端和 dynamodb.Table() 资源、cursor.execute SQL、pymongo 集合,以及 kafka-python/confluent-kafka 生产者和消费者。语言检测会自动进行——仅当存在匹配文件时,才会运行 TypeScript 和 Python 扫描。
| 分析器 | 严重性 | 检测内容 |
|---|---|---|
| 全表扫描(DynamoDB) | 高 | 不带筛选条件的 .scan() 调用 |
| 缺少 GSI | 中 | 查询未配置匹配 GSI 的属性 |
| 热分区 | 中 | 5 条或更多不同代码路径访问同一张表 |
| 缺少索引(PostgreSQL) | 中 | 查询未配置索引的表 |
| N+1 查询 | 高 | ORM 循环产生的重复查询模式 |
| 大型 SELECT | 低 | 使用 SELECT * |
| 缺少 MySQL 索引 | 中 | 查询未配置索引的 MySQL 表 |
| MySQL 全表扫描 | 高 | MySQL 查询中的全表扫描模式 |
| 缺少 Mongo 索引 | 中 | 查询未配置二级索引的集合 |
| 集合扫描 | 高 | 不带筛选条件的 find() 调用 |
| 管道:消费者中的扫描 | 高 / 验证 | 事件触发的 Lambda 处理程序中存在全表扫描(IaC 可证明 Lambda 与代码之间的关联时为高,按名称匹配时为验证) |
| 管道:重复访问表 | 中 / 验证 | 同一服务管道中的 2 个或更多函数读取同一张表 |
| 管道:缺少 DLQ 跳转 | 中 | 没有 Dead Letter Queue 的中间管道队列(同时具有生产者和消费者) |
使用其他语言的项目仍可充分利用基础设施级分析器——目前,代码关联(函数到表的映射、N+1 模式)支持 TypeScript、JavaScript 和 Python。
扫描器支持:用于 DynamoDB 的 AWS SDK v3/v2、用于 PostgreSQL 的 pg/Prisma/Knex、用于 MySQL 的 mysql2/Knex、用于 MongoDB 的 driver/Mongoose、用于 SQS/SNS/SSM/Secrets/Lambda 的 AWS SDK v3,以及用于 Kafka 主题的 kafkajs(生产者/消费者)。
工作原理
- Infrawise 扫描你的仓库和基础设施元数据
- 图引擎映射服务、架构、索引和查询模式
- 基于规则的分析器检测基础设施和查询反模式
- 生成的上下文通过 MCP 提供
- AI 编码助手在生成代码时查询此上下文
确定性分析
Infrawise 不会使用大模型分析你的基础设施。所有提取和分析均为确定性操作:AST 解析、架构内省、基于规则的分析器和图关联。大模型仅通过 MCP 使用生成的上下文。
安全性
- 只读 — 从不写入 AWS 或你的数据库,也不执行 DDL
- 本地优先 — 所有操作都在你的计算机上运行,不会向外部服务发送任何内容
- 无遥测 — 不收集任何数据
- 凭据 — 使用你现有的 AWS 凭据链,Infrawise 从不存储凭据
🔒 安全与项目命名说明
你可能会看到某些供应链安全扫描器将此软件包标记为“欺骗性命名”。这是由自动化工具因前缀“infra”而触发的误报。本项目完全安全、独立,且与任何商业商标均无关联。
架构概览

源码布局
src/
  types.ts      Shared type definitions
  core/         Config (Zod + YAML), logger (Pino), local cache
  graph/        Graph engine — nodes, edges, builder
  adapters/
    aws/        DynamoDB, S3, Lambda, SQS/SNS/SSM/Secrets/EventBridge/RDS/APIGateway, CloudWatch
    db/         PostgreSQL, MySQL, MongoDB
    iac/        Terraform, CDK, CloudFormation (local file parsing)
  analyzers/    39 rule-based analyzers
  context/      Repository scanner (ts-morph AST + Python stdlib-ast subprocess)
  server/       Fastify MCP server (@modelcontextprotocol/sdk, Streamable HTTP)
  cli/          CLI commands (Commander.js)
当前限制
- 代码级关联支持 TypeScript、JavaScript 和 Python(Python 需要将 python3 添加到 PATH)
- 动态构造的查询可能无法始终通过静态分析解析
- 尚未实现运行时追踪
- 静态扫描会覆盖已识别的模式;提取的操作和图的大小仍会影响内存使用
路线图
功能路线图记录在 Infrawise v1 项目看板中。欢迎提交功能请求并点赞。
演示
两个演示会在 Docker 中本地模拟真实 AWS API,并运行 infrawise,零成本且无需真实 AWS 账户。
demo/floci/使用 Floci,这是一个采用 MIT 许可证的模拟器,覆盖 infrawise 支持的所有服务,包括 CloudFront、API Gateway v2、RDS、Cognito、Kinesis、ElastiCache 和 MSK。无需身份验证令牌,也无需注册。从这里开始。demo/localstack/使用 LocalStack 社区版,覆盖核心服务。
两者都监听端口 4566,因此请一次只运行一个。
贡献
请参阅 CONTRIBUTING.md 获取完整指南,其中包括如何添加新的服务适配器和分析器,以及 PR 检查清单。
发布
发布前,请运行 pnpm check:docs——如果 README.md/AGENTS.md/llms.txt 中的版本或 MCP 工具列表与 src/server/index.ts 不一致,该命令会报错。
pnpm release patch    # 0.1.2 → 0.1.3  (bug fixes)
pnpm release minor    # 0.1.2 → 0.2.0  (new features, backwards compatible)
pnpm release major    # 0.1.2 → 1.0.0  (breaking changes)
pnpm release 1.5.0    # explicit version
更新 package.json,提交更改,创建标签并推送,然后根据提交消息创建 GitHub 草稿版发布说明。随后在 GitHub 上发布该草稿,以触发 npm 发布。
许可证
MIT
分析置信度与刷新策略
check 在检查完成且未达到严重性阈值时返回退出码 0,在发现阻断性问题时返回退出码 1,在提取不完整或分析器失败时返回退出码 2。失败和部分成功的数据源默认会阻断;只有在没有阻断性问题时,--allow-incomplete 才会显式允许检查成功。--severity 只筛选 analyze 报告输出,不会改变 CI 策略。
关系型架构包含有序索引 columns、method、partial 和 valid 元数据。SQL 分析会将支持的筛选列与索引的前导列进行比较;无关的主键不会再掩盖缺失的访问路径。发现结果是静态警告,并非实际观察到的查询计划。部分索引、表达式索引和不受支持的谓词需要使用 EXPLAIN 手动验证。谓词元数据不会保留查询值。
每个响应都包含 dataHealth.codeCoverage:已识别的操作计数、未解析的引用计数、不受支持的 SQL 计数和局限性。这些计数仅描述已识别的模式。包装器、动态名称和不受支持的结构可能会被遗漏。get_graph_summary 会列出已识别但尚未解析的引用;不存在某条边并不能证明运行时没有访问。
get_log_errors 现在仅返回保留元数据:errorCount: null、topErrorPatterns: []、errorsObserved: false。兼容性名称并不表示会抽样错误。不会请求日志消息正文。旧缓存会失效,因此不会提供此前抽样的模式。
如需在初始快照加载后进行可选的后台刷新:
freshness:
  suggestRefreshAfterHours: 6
  refreshIntervalMinutes: 15
refreshIntervalMinutes 为可选项,范围为 1 到 1440 分钟,并会在工具请求之间对云端、数据库和代码执行完整分析。刷新操作会与数据源刷新串行执行,可能产生 API/数据库成本;如果配置发生变化,刷新计划会停止,直至重启。运行期间,该设置会限制快照的陈旧程度,但不会即时检测部署。若要精确对应部署边界,请在部署后运行 infrawise analyze --config infrawise.yaml;已运行的 MCP 会话会在下次调用时看到刷新的缓存。
如需改进助手的使用效果,请遵循助手工作流。使用 pnpm eval:assistant traces.json 评估真实的编辑器运行情况;请参阅评估说明。使用 pnpm benchmark 执行可重复的性能和结果等效性检查;请参阅基准测试方法。合成对照并非对模型质量的测量评分。
analyze_function 返回 found: false,表示该函数未出现在已识别的图中,并不能证明其不存在于源代码中。在断言其不存在之前,请检查数据源健康状况、包装器和动态引用。会话刷新失败时,会显示在 dataHealth.codeCoverage.refreshError 中,同时保留之前的图。
运行时指标读取不完整时,会记录在数据源健康状况中,并默认阻断 check;不会将其解释为零活动。
验证命令:pnpm test:demo 会测试预置的本地数据库、索引元数据、覆盖率和 CI 退出码;pnpm test:demo --background 还会验证定时刷新。请先启动并填充数据库演示所需数据。
大型代码库内存占用
TS/JS 扫描使用惰性异步生成器,并按顺序分批处理,每批最多包含 32 个文件或 512 KiB 源代码(更大的受支持文件会单独扫描)。每批处理结束后都会释放其 AST;监视会话保留的是提取出的操作和依赖路径,而不是整个项目的编译器 AST。不会加载导入的依赖类型和标准库声明。扫描会遵循配置的源文件选择,并在解析前排除依赖文件夹、声明文件和常见的生成输出目录(dist、build、.next、.nuxt、.output、coverage)。
超过 2 MiB 的源文件会被报告为代码覆盖率不完整,其路径会显示在源代码健康状况中,同时仍会扫描可读取的文件。除非明确指定 --allow-incomplete,否则 check 会以 2 退出,表示分析不完整。内存占用仍会随提取出的操作和基础设施图规模增长;这并不意味着代码库大小不受限制。常规扫描无需设置更大的 Node 堆内存。运行 pnpm test:memory,即可对 256 MiB 堆内存进行可重复的回归测试,其中包括完整扫描、增量编辑、共享导入更新以及实际的 analyze CLI。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。