关于 Postgram
Postgram 是供个人或小型可信团队自托管的知识与生产力后端,供人和 AI Agent 共享管理记忆、文档、任务及关系数据。它结合混合检索、知识图谱和 Markdown 文件夹同步,并将短期会话上下文与持久记忆分开。
主要功能
- 01存储带类型的记忆、人物、项目和任务
- 02结合全文与向量的混合搜索
- 03通过关系边构建知识图谱
- 04区分会话上下文与持久记忆
- 05同步本地 Markdown 文档
- 06提供浏览器界面、REST API 和 CLI
适用场景
- 01跨多个 Agent 查找共享的项目资料
- 02搜索文档、人物、任务和记忆
- 03管理 GTD 风格任务与看板
- 04整理旧会话上下文并提炼持久记忆
MCP 相关
Postgram 通过 Streamable HTTP MCP 端点向 Agent 提供工具访问同一数据集。MCP 工具包含会话上下文整理功能;远程 MCP 客户端接入需配置 HTTPS 和 OAuth。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
docker run -i --rm -e DATABASE_URL -e OPENAI_API_KEY -e EMBEDDING_PROVIDER -e EMBEDDING_BASE_URL -e ADMIN_MFA_SECRET_KEY -e ADMIN_SETTINGS_ENCRYPTION_KEY ghcr.io/ivo-toby/postgram@sha256:29b61fb302bd52862b8eba43305ee2aa4fc072d5f9188652f1fe6324f49d5391DATABASE_URL密钥PostgreSQL connection URL for a database with the pgvector extension enabled.OPENAI_API_KEY密钥Required only when OpenAI is selected for embeddings or extraction.EMBEDDING_PROVIDEREmbedding provider: openai or ollama.EMBEDDING_BASE_URLOllama embedding endpoint when EMBEDDING_PROVIDER is ollama.ADMIN_MFA_SECRET_KEY密钥Stable random value of at least 32 characters used to protect admin MFA seeds.ADMIN_SETTINGS_ENCRYPTION_KEY密钥Stable 32-byte base64url key used to encrypt provider secrets saved in the admin UI.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
ghcr.io/ivo-toby/postgram@sha256:29b61fb302bd52862b8eba43305ee2aa4fc072d5f9188652f1fe6324f49d5391Streamable HTTP工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍

Postgram
面向人类和 AI Agent 的可自托管效率与知识后端。
网站 · 快速入门 · MCP 指南 · REST API · 演示
Postgram 将你和各个 Agent 工作所需的数据集中保存在一个可检查的位置: 笔记、文档、任务、人员、项目、交互、决策以及 Agent 记忆。人类使用浏览器 UI 和命令行;Agent 则通过 MCP、 REST 或命令行访问同一知识库。
它不只是一个 Agent 记忆层。Postgram 会保留带类型的源对象,支持 GTD 风格的任务管理和 Markdown 文件夹同步,将全文和向量检索与知识图谱相结合,并将短期 Agent 工作上下文与持久记忆分开。
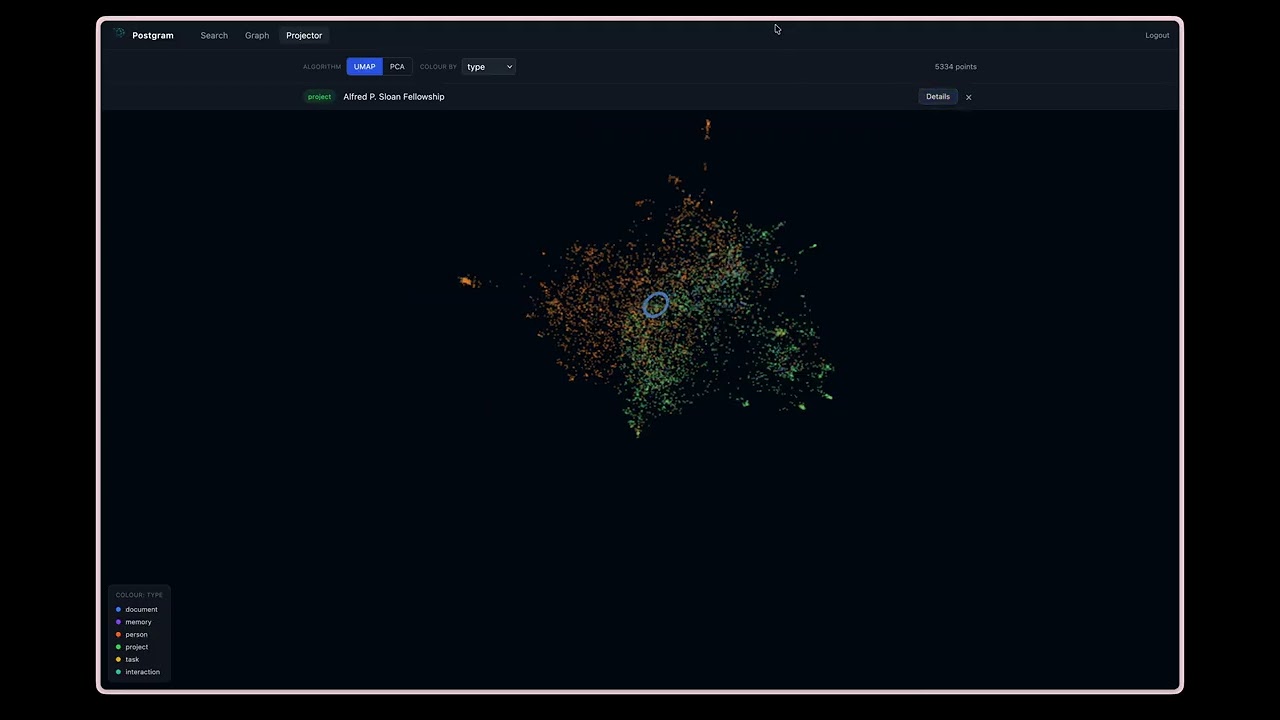
观看演示 |

搜索记忆、文档、人员、项目和任务 |
为什么选择 Postgram
- 在各类工具间共用一个私有知识库。 让不同的 Agent 和设备访问相同的数据, 无需将数据绑定到某个编辑器或托管记忆服务提供商。
- 可检查源数据。 存储带类型的实体,而不是不透明的聊天摘要, 然后自行搜索、编辑、关联、归档或删除。
- 先搜索,再扩展图谱。 混合检索可找到相关实体; 边摘要会提示 Agent 是否值得继续查阅相关的图谱上下文。
- 工作上下文不是持久记忆。 会话上下文有独立的范围 和生命周期;整理时可以将其归档,或提炼所选上下文并纳入 持久记忆。
- 由操作者掌控。 自行选择 PostgreSQL 的运行位置、允许使用哪些嵌入和 信息提取提供商、谁可以获得 API 密钥,以及保留哪些内容。
Postgram 面向个人或小型可信团队,适用于本地或单虚拟机部署。它不是托管服务或多租户 SaaS 平台。知识提取为可选功能,且提供的 Docker Compose 配置默认将原始 API 和 UI 端口绑定到回环地址。
快速开始(Docker Compose)
你需要 Git、Docker 和 Docker Compose。只有本地开发或安装 pgm CLI 时才需要 Node.js 22+;只有加密 CLI 备份才需要 gpg。
-
克隆 Postgram:
git clone https://github.com/ivo-toby/postgram.git cd postgram -
首次启动前选择一种嵌入路径。若使用本地默认方案,请在 Docker 主机上安装并启动 Ollama,然后拉取 Postgram 的默认嵌入模型:
ollama pull bge-m3若改用托管的 OpenAI 嵌入服务,请在启动 Compose 前创建一个包含有效密钥的
.env文件:OPENAI_API_KEY=<your-openai-key> -
启动服务栈:
docker compose up -d --build首次运行会为 PostgreSQL 和安装密钥创建持久化 Docker 卷。使用默认 Compose 路径时无需
.env文件。 -
读取一次性引导令牌:
docker compose logs mcp-server \
  | grep 'Bootstrap token:' \
  | tail -n 1
明文只会出现在首次启动时生成的原始日志中。请在重建 API 容器或丢弃这些日志前保存令牌。
-
打开 http://127.0.0.1:3000/admin,粘贴令牌,创建第一个管理员,注册 MFA,并按照引导流程操作。
-
在管理员的 Config 选项卡中确认已选提供方。如果添加或更改暂存设置,请保存、验证并应用;当 Admin 提示需要重启时,重启
mcp-server:docker compose restart mcp-server当 Ollama 在 Docker 主机上运行时,其基础 URL 为
http://host.docker.internal:11434。可选的 LLM 关系提取默认处于禁用状态,可使用 OpenAI、Anthropic、Ollama 或兼容 OpenAI 的端点。首次启动后更改嵌入提供方、模型或维度属于迁移工作,不能通过简单的配置应用完成。 -
检查运行状况,然后在管理员的 Overview 选项卡中创建 API 密钥。对于下面的冒烟测试,请授予
read和write权限、memory实体类型以及personal可见性:curl -fsS http://127.0.0.1:3100/health响应应包含
"status":"ok"和"postgres":"connected"。 -
安装 CLI,并验证已通过身份验证的写入和搜索。丰富处理是异步的,因此请等待
pgm queue报告没有待处理任务后再搜索:npm install -g @ivotoby/postgram-cli export PGM_API_URL=http://127.0.0.1:3100 export PGM_API_KEY='<plaintext-api-key>' pgm store "Postgram quick start is working" \ --type memory \ --visibility personal \ --tags quickstart pgm queue pgm search "quick start"
如果无法访问嵌入服务,Postgram 仍会启动并接受写入,但在提供方恢复可用之前,丰富处理和搜索会失败。更完整的操作流程请参阅完整快速开始指南和故障排查指南。
若要让 ChatGPT、Claude 或其他远程 MCP 客户端访问,请将 Postgram 部署在 HTTPS 后方,启用 OAuth,并按照 MCP 集成指南操作。不要将回环开发端口直接公开到互联网。
功能介绍
Postgram 提供:
- 用于存储类型化实体的持久化存储:
memory、person、project、task、interaction、document - 支持异步丰富处理的关键词与向量混合搜索
- 知识图谱,包含实体间带类型的有向边
- 由 LLM 驱动的关系提取(OpenAI、Anthropic 或 Ollama)
- 通过清单比较,从本地 Markdown 仓库同步文档
- 面向知识工作的浏览器界面和受控管理界面
- 对嵌入实体进行 UMAP 和 PCA 投影
- GTD 风格的收集、任务整理和看板视图
- 具有作用域限制的 API 密钥身份验证和可见性限制
- 用于应用和自动化访问的 REST API
- 用于 Agent 原生工具访问的 Streamable HTTP MCP 端点
- 面向用户和 Agent 的 CLI(
pgm) - 容器内管理 CLI(
pgm-admin) - Talon SQLite 迁移工具
- 加密备份支持
- 对会修改数据和特权操作进行审计日志记录
工作原理
Postgram 是一款基于服务层构建的 TypeScript Node.js 应用。
主要组件:
- PostgreSQL +
pgvector,用于持久化和向量搜索 - Hono,用于 HTTP 服务
- 基于 Streamable HTTP 的 MCP,提供面向 Agent 的工具访问能力
- 使用 Commander 构建的 CLI/管理 CLI
- 后台增强工作进程,用于分块、生成嵌入和提取 LLM 信息
高级工作流程:
- 客户端存储或更新实体
- 立即写入实体
- 异步执行增强:分块、生成嵌入,以及可选的 LLM 信息提取
- 在后台生成分块和嵌入
- 根据提取的关系创建边(如果启用了信息提取)
- 搜索查询使用关键词与向量混合检索和倒数排名融合,并可选择扩展图谱
主要功能
1. 类型化知识存储
存储结构化知识对象,包括:
type(memory、person、project、task、interaction、document)contenttagsvisibility(personal、work、shared)status- 任意 JSON 元数据
记忆角色
Postgram 支持 memory 实体的两种角色:
durable_memory:未来的 Agent 应当信赖的长期记忆,例如决策、偏好、约束、根本原因和已完成工作的摘要。session_context:用于恢复近期对话的工作上下文。会话上下文的范围限定为调用它的客户端,会以嵌入形式存储以便语义检索,并跳过图谱提取。
对于“我们在这个对话线程中聊到哪里了?”,请使用会话上下文。对于“未来的 Agent 应当记住哪些事实?”,请使用持久记忆。
CLI 用户可以使用 pgm memory session-context 写入会话上下文,并使用
pgm search --memory-role session_context 搜索。
运维人员可以使用 pgm-admin memory groom 清理过时的会话上下文。
使用 --client-id <client-id> 可针对单个客户端,使用 --all-clients 可批量处理
所有会话上下文范围。--all-clients 会保留各个客户端范围的独立性;
它只是运维批处理,不会跨客户端合并内容。
--older-than <duration> 默认值为 7d,可接受 30m、4h、
7d 或 0d 等值。--dry-run 可预览符合条件的记忆,而不会调用 LLM。
清理操作默认不限制候选项数量;如果要限制处理批次,请传入 --limit <n>。
--mode archive --yes 会直接归档符合条件的工作上下文。
--mode promote --yes 会使用已配置的提取 LLM,判断是否应提升每条
会话上下文记忆;提升后的记忆会提炼为新的 durable_memory 实体,源上下文会被归档,
并通过 metadata.promoted_to 和 promoted_to 边记录来源关系。
经过身份验证的用户和 Agent 只能自行清理自己客户端范围内的 会话上下文:
pgm memory groom --dry-run --older-than 7d
pgm memory groom --older-than 14d --topic postgram --tag session-context --yes
常规 CLI 会根据 PGM_API_KEY 推导范围;不接受
--client-id、--all-clients 或提升模式。归档操作需要 --yes。
可选筛选条件包括 --topic、--session-id 和可重复使用的 --tag。
MCP 客户端可以使用 groom_session_context 工具,并采用相同的自助范围:
{
  "mode": "dry_run",
  "older_than": "7d",
  "topic": "postgram",
  "session_id": "optional-session-id",
  "tags": ["session-context"]
}
MCP 的 mode 可设为 dry_run 或 archive;提升操作仍仅限管理员使用。
对于定期维护,请在可访问 Postgram 容器的主机上运行清理操作。此 cron 示例每三天 凌晨 03:17 评估所有客户端范围内符合条件的会话上下文,并将 JSON 输出追加到日志。 该包装器会检测到 cron 不提供 TTY,并以非交互方式运行:
17 3 */3 * * cd /path/to/postgram && ./bin/pgm-admin --json memory groom --all-clients --older-than 7d --mode promote --yes >> /var/log/postgram-memory-groom.log 2>&1
如果要在不使用 LLM 辅助提升的情况下归档符合条件的工作上下文,请改用
--mode archive --yes。请先使用 --dry-run 运行相同命令,
以确认符合条件的集合。
运维人员还可以检查持久记忆的质量,而不会修改持久声明本身:
./bin/pgm-admin memory groom-durable --dry-run --older-than 30d
./bin/pgm-admin memory groom-durable --mode mark --yes --older-than 30d
持久记忆清理会选取活跃的 durable_memory 行,包括没有 metadata.memory_role 的旧版记忆
行,并将其分类为 keep、needs_grooming、archive 或 superseded。标记模式会将结果、
原因、审核时间戳以及任何 LLM 建议写入 metadata.durable_grooming。
它不会重写内容、变更状态、归档行或合并重复项。
若要实际清理已标记的行,请应用清理标签:
./bin/pgm-admin memory apply-durable-grooming --dry-run
./bin/pgm-admin memory apply-durable-grooming --yes
应用模式默认值为 auto:needs_grooming 记忆会根据存储的建议或已配置的提取 LLM
进行重写,而 archive 和 superseded 记忆会被归档。重写会清除过时的分块并重新加入
嵌入增强队列。可搭配 --status、--topic、--tag、--visibility 或 --limit,
使用 --mode rewrite 或 --mode archive 缩小批次范围。
2. 异步增强
包含内容的实体会先持久化,之后再进行增强。每个实体都会跟踪 enrichment_status:
pending、completed 或 failed。失败的实体最多重试 3 次,重试间隔为 5 分钟。
3. 混合搜索
搜索会检索向量邻居和匹配查询词素的文本块,然后对文本块去重,并使用倒数排名融合(RRF)进行排序:
1 / (60 + vector_rank) + 1 / (60 + keyword_rank)。缺失的分支贡献为零。关键词检索会将查询拆分为空格分隔的词项。每个词项的 simple 词素采用 AND 组合,非空词项之间采用 OR 组合,从而保留 ABC-1234 这类复合标识符;因此,长查询可能会匹配到只包含一个完整词项的文本块。对于多词项查询,会省略英语词典向量为空的词项(独立的英语停用词);即使单个词项的向量为空,也会保留该词项。匹配和排序仍使用 PostgreSQL 的 simple 配置。范围较广的搜索通过 HNSW 索引选择候选项;经过筛选的小型集合使用精确距离排序;如果 HNSW 的候选扫描无法达到目标数量,则会回退到精确排序。经过多词项英语停用词过滤后,关键词解析最多保留前 24 个不同的非空词项查询,而嵌入使用完整的原始查询文本。
关键词候选项生成首先对所有保留词项执行完整的合取探测,最多获取 200 个经过授权的 GIN 命中项。如果达到上限,则这些命中项构成关键词候选池,并跳过其他所有探测;如果只保留了一个词项,则会重复使用这次探测。否则,系统会执行最多返回 201 个命中项的授权 OR 探测,以判断完整并集是否能纳入 200 个文本块的候选池。并集不超过 200 个文本块时,会完整使用该并集,不再按词项扫描;并集命中 201 项时,则会回退到独立的逐词项探测,并使用现有的稀有度/复合项选择逻辑生成 200 个文本块的候选池。在此回退过程中,完整合取命中项仍排在前面。只有完整 AND 查询会对词素去重;词法 OR 评分保持不变。若有授权命中项超过某次有上限的探测所设上限,则其无序集合可能会变化。因此,ts_rank_cd 和关键词排名在这个有界候选池中均为近似值,向量排名也会受到候选项检索范围的限制。
如果完整合取未填满候选池,而 OR 探测达到上限,那么符合条件的部分匹配项(例如六个常见词项中匹配五个)仍可能被排除在有界探测集合之外。这是当前可接受的限制;评估结果可能会促使后续加入交集探测。
threshold 是介于 0 到 1 之间的余弦相似度下限。若候选项的向量相似度达到该下限,或其文本块匹配了至少一半保留的不同关键词词项(向上取整),则该候选项通过筛选。单词项查询(包括 ABC-1234 这类复合标识符)要求匹配唯一保留的词项。只要达到向量下限或满足此覆盖规则,部分关键词候选项仍符合条件。返回的
score 是相对 RRF 排序值,不是概率或百分比;
similarity 仍是原始余弦值。可选的近期性乘数采用真实的 30 天半衰期。在两个分支中均排名第一的候选项,在应用近期性乘数之前得分约为 0.03279。最终得分相同时,依次优先选择关键词排名较低、向量排名较低的候选项,然后按稳定标识符排序。搜索要求嵌入提供方可访问;如果该提供方不可用,写入仍会成功,但在其恢复之前,增强和搜索会失败。结果包括:
- 按排名排列的结果及相对 RRF 得分
- 余弦相似度值
- 经近期性调整的 RRF 得分
- 匹配的文本块内容
- 可选的 1 跳图邻居(
expand_graph参数)
迁移 017 会在 to_tsvector('simple', chunks.content) 上添加表达式 GIN 索引。迁移运行期间,普通事务型 CREATE INDEX 会保持读取可用,但对 chunks 的写入会一直等待到迁移提交。该操作不会重写表堆。迁移运行器无法使用 CREATE INDEX CONCURRENTLY,因此请妥善安排启动时间。
实体之间可以通过带类型的有向边连接:
- 关系类型:
involves、assigned_to、part_of、blocked_by、mentioned_in、related_to,也可以是任何自定义类型 - 边带有置信度分数(手动创建时为 1.0,提取的边由大模型分配)
- 可通过
expand遍历图谱,深度可配置(1–3 跳) - 通过
UNIQUE(source_id, target_id, relation)防止边重复 - 边可以通过
link/unlink手动创建,也可以由大模型提取流程自动创建

5. 大模型提取
启用后,增强工作器会使用大模型从实体内容中提取关系。提取出的实体名称会与现有实体匹配,并自动创建边。
支持的提供方:
| 提供方 | 默认模型 | 所需环境变量 |
|---|---|---|
| OpenAI | gpt-4o-mini | OPENAI_API_KEY |
| Anthropic | claude-haiku-4-5-20251001 | ANTHROPIC_API_KEY |
| Ollama | llama3.2 | OLLAMA_BASE_URL(默认值:http://localhost:11434) |
这些是配置默认值,并非模型质量建议。图谱提取是一项受约束的结构化输出任务;在大规模回填之前,请先在自己的语料库上验证生成的边,尤其是在使用小型本地模型时。

6. 文档同步
将本地目录中的 Markdown 文件同步到 postgram:
pgm sync ~/Documents/personal-notes
pgm sync ~/Documents/cf-notes --repo cf-notes --quiet
CLI 会遍历目录中的 .md 文件,计算 SHA-256 哈希,并向服务端发送完整清单。服务端会与已存储的状态进行差异比较,并创建、更新或归档文档实体。支持 --dry-run 和 cron 调度。
7. 访问控制
API 密钥可以按以下条件限制:
- 权限范围:
read、write、delete、sync - 允许的实体类型
- 允许的可见性级别
8. 任务管理
任务是一级实体,并提供以下便捷操作:
- 创建(包含 GTD 上下文和截止日期)
- 列出(按状态和上下文筛选)
- 更新
- 完成(包含完成时间戳)
9. 多种接口
同一服务层通过以下接口提供:
- REST API
- Streamable HTTP MCP 端点
pgmCLIpgm-adminCLI(./bin/pgm-admin)- 适用于 Chrome 和
Firefox 的浏览器扩展——一键网页剪藏工具,
可通过 REST API 捕获当前页面或文本选区。
使用
npm run -w @ivotoby/postgram-browser-extension-chrome package构建(Firefox 版本使用对应命令);从各自软件包的 README 安装未打包扩展。
仓库布局
src/
  auth/            API key validation and auth middleware
  cli/             CLI for humans/agents and admin CLI
  db/              Pool and migrations
  migrate-talon/   Talon import path
  services/        Business logic (entities, search, edges, sync, extraction)
  transport/       REST and MCP adapters
  types/           Shared types
  util/            Errors, audit, logging

ui/                User-facing web UI and Admin UI
cli/               Published @ivotoby/postgram-cli package
docker/            Container entrypoint and secret bootstrap scripts
bin/               Local operator wrappers

packages/
  browser-extension-chrome/   Chromium web clipper (MV3)
  browser-extension-firefox/  Firefox web clipper (MV3)

tests/
  contract/        REST and MCP contract tests
  integration/     Service and CLI integration tests
  unit/            Pure logic tests
要求
- 推荐部署方式需要 Docker 和 Docker Compose
pgmCLI 或本地开发需要 Node.js 22+- 需要可访问的 OpenAI 或 Ollama 嵌入提供方,以支持增强和搜索
可选:
- OpenAI API 密钥(用于 OpenAI 嵌入或提取)
- Anthropic API 密钥(用于大模型提取)
- Ollama(用于本地嵌入或大模型提取)
gpg(用于加密 CLI 备份)
Docker 设置详情
1. 启动 Docker Compose
docker compose up -d --build
默认的 Compose 路径无需手动编辑 .env。首次运行时,它会创建一个持久化的 postgram_secrets Docker 卷,其中包含:
- 应用容器使用的 Postgres 密码
- 用于加密管理员 TOTP 密钥种子的
ADMIN_MFA_SECRET_KEY - 用于数据库中提供方密钥的
ADMIN_SETTINGS_ENCRYPTION_KEY
如果现有 Docker 安装已在 .env 中设置 POSTGRES_PASSWORD,则此变更后的首次启动会将旧密码复制到 postgram_secrets/postgres-password,而不是生成不同的数据库密码。首次升级启动时,请保留旧的 .env 值。
默认情况下,API 绑定到 127.0.0.1:3100,UI 绑定到 127.0.0.1:3000。同时运行多个本地堆栈时,可使用 POSTGRAM_API_PORT=<port> 或 UI_PORT=<port> 作为 shell 覆盖值。
要通过 Compose 使用现有 Postgres 集群,请在 Compose 覆盖文件中的 mcp-server 上设置 POSTGRES_HOST、POSTGRES_PORT、POSTGRES_DB 和 POSTGRES_USER,并移除 postgres 依赖项,如操作员示例所示。如果外部集群要求使用密码进行身份验证,请在 .env 中设置 POSTGRES_PASSWORD;如果使用无需密码的本地身份验证,请将 POSTGRES_PASSWORD= 留空。也可以通过设置 DATABASE_URL 完全绕过拆分设置。
对于嵌入,如果存在 OPENAI_API_KEY,Compose 会保留 OpenAI 默认设置。如果未提供 OpenAI 密钥,也未显式设置 EMBEDDING_PROVIDER,容器入口点会选择本地 Ollama 嵌入,以便在配置提供方密钥之前启动全新的堆栈。
2. 完成首次管理员设置
首次启动时,API 容器会打印清晰的一次性初始化横幅,其中包含令牌:
Postgram first admin setup
Bootstrap token: ...
Open http://127.0.0.1:3000/admin and paste this token.
如果控制台内容已滚动,请从受信任的本地操作员渠道读取同一个一次性初始化令牌:
docker compose logs mcp-server | grep 'Bootstrap token:' | tail -n 1
然后打开 http://127.0.0.1:3000/admin,创建第一个管理员用户并完成 MFA 注册。初始化令牌仅以哈希形式存储在 Postgres 中,有效期为 24 小时,并会在创建第一个管理员后失效。如果更改了 Postgres 目标,请复制最新的初始化令牌日志行;较早的日志行可能属于先前的数据库,系统会拒绝这些令牌。
通过已启用的 MFA 登录后,Admin 仪表板会打开引导式入门流程,直到流程完成或被主动跳过。指南会以清晰易懂的操作员用语说明设置流程:
- 初始化、管理员登录和 MFA 确认分别提供哪些保护
- 提供方设置、嵌入维度、提取模型和仅写入的提供方密钥如何协同工作
- 何时验证并应用已保存的提供方配置
- 为什么要在切换前安排备份和恢复
- 维护试运行、重新提取、重新嵌入和边修剪的工作方式
入门进度在服务器端存储于 Postgres。只要保留现有的 pgdata 卷,刷新浏览器、关闭标签页、退出后重新登录或重启 Docker 容器,都会从最近保存的步骤继续。跳过或完成入门流程后,仍可从仪表板访问 Onboarding 标签页。
进行本地 Docker 测试时,请保留数据库卷:
docker compose up -d --build
docker compose restart mcp-server postgram-ui
测试入门流程的恢复行为时,请勿使用 docker compose down -v。该命令会移除命名卷,包括 pgdata Postgres 卷,并会连同数据库一起重置服务器端的入门状态。
3. 检查运行状况
curl http://127.0.0.1:3100/health
预期结果:
status: "ok"postgres: "connected"
4. 配置提供商并创建 API 密钥
对于受支持的标准操作流程,请在浏览器中使用 Admin 仪表盘:
- Onboarding 选项卡:继续、跳过或完成以 Docker 为先的设置指南。
- Config 选项卡:保存提供商设置和仅写入的提供商密钥。
- Overview 选项卡:创建 Postgram API 密钥,检查运行状况、队列、统计信息、配置/模型/作业状态和审计记录。
- Maintenance 选项卡:运行安全的试运行预览,并在执行任何破坏性应用操作前轮询作业状态。
- Backup 选项卡:下载 gzip 压缩的 v2 存档,其中包含仅数据的 PostgreSQL 自定义转储以及经过脱敏的运行时配置。恢复过程特意分阶段进行:服务器会拒绝旧版 v1/完整架构存档,只接受
pg_restore --list中经批准的 Postgram 表数据条目,使用捆绑的迁移创建可信架构,并将已接受的数据恢复到新的数据库名称中。切换前会运行运行状况检查,并须经操作员批准。如果恢复的数据库出现问题,可通过还原之前的POSTGRES_DB或DATABASE_URL设置并重启mcp-server/postgram-ui来回滚;在此紧急恢复流程中,旧数据库保持不变。
正常的 Docker 设置和维护在启动/引导后不应需要 pgm-admin。下文仍介绍 pgm-admin CLI,用于紧急恢复、嵌入迁移、原始 SQL 检查以及高级操作员作业。
Docker 密钥备份与故障行为
请将 postgram_secrets Docker 卷与数据库备份分开备份。数据库备份包含加密的提供商密钥和加密的 TOTP 因子;其中不包含解密它们所需的安装密钥。
丢失或替换 ADMIN_MFA_SECRET_KEY 会导致现有 TOTP 因子无法通过验证。丢失或替换 ADMIN_SETTINGS_ENCRYPTION_KEY 会导致已存储的提供商密钥无法解密。使用错误的设置密钥时,提供商配置读取结果仍会经过脱敏,提供商应用操作/运行时密钥使用会以安全失败方式拒绝,操作员必须恢复原始密钥,或在有意轮换/恢复流程后重新保存提供商密钥。
对于 Docker Compose,只有在 postgram_secrets 卷为空时才会生成缺失的密钥文件。已持久化的密钥文件无效时,容器会在服务器绑定端口前启动失败。可选的环境变量覆盖仍然有效,但请将这些值保存在数据库备份和浏览器存储之外。
环境变量
服务
| 变量 | 必填 | 默认值 | 描述 |
|---|---|---|---|
DATABASE_URL | 非 Compose | Docker 密钥文件 + Postgres 环境变量 | 完整的 Postgres 连接字符串。未设置时,Compose 会使用生成的 Postgres 密码密钥构造该字符串。 |
POSTGRES_HOST | 否 | postgres | 未设置 DATABASE_URL 时使用的 Compose Postgres 主机。对于现有集群,可覆盖为 host.docker.internal 或其他主机名。 |
POSTGRES_PORT | 否 | 5432 | 未设置 DATABASE_URL 时使用的 Compose Postgres 端口。 |
POSTGRES_DB | 否 | postgram | 未设置 DATABASE_URL 时使用的 Compose Postgres 数据库。 |
POSTGRES_USER | 否 | postgram | 未设置 DATABASE_URL 时使用的 Compose Postgres 用户。 |
POSTGRES_PASSWORD | 否 | Docker 密钥文件 | 未设置 DATABASE_URL 时使用的 Compose Postgres 密码。对于外部主机,显式设置为空值会构造无密码 URL。 |
ADMIN_MFA_SECRET_KEY | 管理员设置期间 | Docker 密钥文件 | 用于加密管理员 TOTP 种子的稳定密钥,长度至少为 32 个字符。未设置时,Compose 会生成该密钥并将其持久化到 postgram_secrets 中。 |
OPENAI_API_KEY | 有条件必填 | 当 EMBEDDING_PROVIDER=openai 或(EXTRACTION_ENABLED=true 且 EXTRACTION_PROVIDER=openai)时必填。否则为可选。 | |
ADMIN_SETTINGS_ENCRYPTION_KEY | 保存管理员管理的密钥时 | Docker 密钥文件 | 用于加密数据库中存储的提供方密钥的 32 字节 base64url 安装密钥。未设置时,Compose 会生成该密钥并将其持久化到 postgram_secrets 中。请勿将其存放在数据库备份中。 |
PORT | 否 | 3100 | HTTP/MCP 服务端口 |
POSTGRAM_API_PORT | 否 | 3100 | API/后端的 Docker Compose 主机端口。容器监听端口保持为 3100。 |
UI_PORT | 否 | 3000 | UI 的 Docker Compose 主机端口。 |
OAUTH_ENABLED | 否 | false | 为原生远程 MCP 连接器启用 OAuth 授权码、PKCE 和动态客户端注册路由。 |
PUBLIC_BASE_URL | 有条件必填 | OAuth 元数据和回调 URL 的公共 HTTPS 源站。OAUTH_ENABLED=true 时必填。示例:https://postgram.example.com。 | |
LOG_LEVEL | 否 | info | pino 日志级别 |
ENRICHMENT_POLL_INTERVAL_MS | 否 | 1000 | 丰富处理工作器轮询间隔 |
嵌入
| 变量 | 必填 | 默认值 | 描述 |
|---|---|---|---|
EMBEDDING_PROVIDER | 否 | openai(Compose 自动选择) | openai 或 ollama。如果存在 OPENAI_API_KEY,Compose 会保留 OpenAI;否则除非显式设置,否则会选择 Ollama。 |
EMBEDDING_MODEL | 否 | 取决于提供方 | 默认值:text-embedding-3-small(openai,1536 维)、bge-m3(ollama,1024 维) |
EMBEDDING_DIMENSIONS | 否 | 取决于提供方 | 必须与当前启用的 embedding_models 行匹配。运行 ./bin/pgm-admin embeddings migrate --target-dimensions <N> --yes 进行更改。 |
EMBEDDING_BASE_URL | 提供方为 ollama 时 | 回退至 OLLAMA_BASE_URL | 嵌入主机。与 LLM 提取主机相互独立,因此嵌入和推理可以面向不同的机器。 |
EMBEDDING_API_KEY | 否 | EMBEDDING_BASE_URL 的可选 bearer 令牌。 | |
EMBEDDING_TIMEOUT_MS | 否 | 15000 | 单次嵌入提供方调用的硬超时。限制单次卡住的调用可以延迟请求的时长。 |
QUERY_EMBEDDING_CACHE_SIZE | 否 | 512 | 在进程内缓存、并置于 Postgres 后端缓存前的查询嵌入。 |
QUERY_EMBEDDING_CACHE_SECRET | 否 | 使用 HMAC 对查询摘要进行密钥化。若不设置,摘要将是未加密的 sha256,数据库读取者可以通过字典测试确认某个猜测的查询是否运行过。如果你认为查询文本比实体内容更敏感,请设置此项;它必须存放在数据库之外才有意义。更改此项会使现有缓存行失效。 | |
QUERY_EMBEDDING_CACHE_RETENTION_DAYS | 否 | 30 | 清理持久化查询嵌入的存留时长。每小时执行的清理还会为每个客户端仅保留最新的 2,000 条记录。 |
当 Postgram 在 Docker 中运行,而 Ollama 直接运行在 Docker 主机上时,请将 http://host.docker.internal:11434 用作 EMBEDDING_BASE_URL;容器内的 localhost 指向 Postgram 容器,而非主机。
有关全新安装 Ollama 和从 OpenAI 迁移的操作说明,请参阅 specs/002-local-embeddings/quickstart.md。
LLM 提取
| 变量 | 必需 | 默认值 | 描述 |
|---|---|---|---|
EXTRACTION_ENABLED | 否 | false | 启用大模型关系提取 |
EXTRACTION_MEMORY_MODE | 否 | embed_only | 控制 type=memory 的图谱提取:embed_only 通过嵌入让所有记忆都可搜索,不进行图谱/实体提取;extract_durable 仅提取 durable_memory;extract_all 同时提取持久记忆和会话上下文记忆。 |
EXTRACTION_PROVIDER | 否 | openai | 大模型提供商:openai、anthropic、ollama 或 openai-compatible |
EXTRACTION_MODEL | 否 | 每个提供商各异 | 模型名称(默认值:OpenAI 为 gpt-4o-mini,Anthropic 为 claude-haiku-4-5-20251001,Ollama 为 llama3.2,OpenAI-compatible 为 gpt-4o-mini) |
EXTRACTION_BASE_URL | 当 provider=openai-compatible 时 | OpenAI-compatible 聊天补全 API 的基础 URL,包含任何 /v1 路径。Postgram 会追加 /chat/completions。示例:http://host.docker.internal:8000/v1。 | |
EXTRACTION_API_KEY | 否 | EXTRACTION_BASE_URL 的可选 bearer token。 | |
EXTRACTION_AUTO_CREATE_ENTITIES | 否 | false | 为 true 时,提取过程会为尚不存在的引用目标创建占位实体(例如,文档中提到的人物会自动创建为 person 实体)。标记为 auto-created;元数据会记录来源文档。 |
EXTRACTION_AUTO_CREATE_TYPES | 否 | person,project,interaction | 符合自动创建条件的实体类型的逗号分隔列表。默认有意排除 document、task、memory,以保留这些由用户撰写的内容。 |
EXTRACTION_AUTO_CREATE_MIN_CONFIDENCE | 否 | 0.7 | 自动创建实体所需的最低单次提取置信度(0–1)。调高可减少噪声,调低可生成更密集的图谱。 |
ANTHROPIC_API_KEY | 当 provider=anthropic 时 | Anthropic API 密钥 | |
OLLAMA_BASE_URL | 否 | http://localhost:11434 | Ollama 服务 URL |
EXTRACTION_REASONING_EFFORT | 否 | 未设置 | minimal | low | medium | high。对于推理模型(o-series、gpt-5、gpt-oss),会作为 reasoning_effort 转发给 OpenAI 和 Ollama。设置后,会覆盖 EXTRACTION_DISABLE_THINKING=true 传给 OpenAI 的隐式 minimal。 |
LLM_REQUEST_TIMEOUT_MS | 否 | 120000 | 每次大模型调用的硬性超时时间上限,单位为毫秒。运行较慢的本地模型(例如 gpt-oss:120b-cloud)时,可调高此值。 |
EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED | 否 | false | 启用语义邻居关联(见下文)。 |
EXTRACTION_SEMANTIC_NEIGHBORS_MAX | 否 | 10 | 每个实体最多创建的邻居边数。 |
EXTRACTION_SEMANTIC_NEIGHBORS_MIN_SIMILARITY | 否 | 0.65 | 实体符合邻居条件所需的最低余弦相似度(0–1)。调高可减少噪声;如果发现的邻居太少,则调低。合适的值取决于嵌入模型的相似度分布——调参前,使用 ./bin/pgm-admin link-neighbors --all --dry-run 检查实际分数。 |
语义邻居关联:LLM 提取阶段只会找到在源内容中被明确提及的实体。对于主题相关但未被点名的实体,它不会识别——例如关于同一计划的每周启动会议、介绍同一策略的 wiki 页面,或关于同一项目的决策备忘录。当 EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED=true 时,LLM 提取完成后会运行第二个阶段:查询知识库,找出其存储块嵌入与源实体自身嵌入余弦相似的实体,并使用 related_to 将它们关联起来。无需额外调用 LLM 或嵌入 API——源实体的块已由提取前运行的丰富步骤存储。此阶段创建的边带有 source = 'semantic-neighbor',因此可以与 LLM 提取的边区分开来。为避免较弱的 related_to 边遮盖同一对实体之间类型更强的边,此阶段会排除已由 LLM 阶段关联的实体。 |
回填和维护邻居边:./bin/pgm-admin link-neighbors 命令会直接运行语义邻居阶段——不调用 LLM,也不使用提取队列,只对已存储的块计算余弦相似度。可用它回填现有图谱,也可在添加新实体后将其作为定期维护任务运行。
# Backfill all enriched entities (safe to re-run — edges are upserted).
./bin/pgm-admin link-neighbors --all

# Only documents:
./bin/pgm-admin link-neighbors --type document

# Single entity:
./bin/pgm-admin link-neighbors --id <uuid>

# Preview what would be linked and at what similarity — no edges created:
./bin/pgm-admin link-neighbors --id <uuid> --dry-run
./bin/pgm-admin link-neighbors --all --dry-run

# Tune the similarity threshold or edge cap:
./bin/pgm-admin link-neighbors --all --min-similarity 0.75 --max-neighbors 5

# Process in bounded batches (oldest-first):
./bin/pgm-admin link-neighbors --all --limit 500
使用 --dry-run 可在提交边之前查看实际余弦相似度分数——尤其适合为新的嵌入模型调整 --min-similarity。输出会显示每个实体及其候选邻居的原始相似度分数。
如果还想同时重新运行 LLM 提取(例如,在启用
EXTRACTION_SEMANTIC_NEIGHBORS_ENABLED=true 后),请改用 reextract——工作进程会同时运行 LLM 阶段和邻居阶段:
./bin/pgm-admin reextract --all
注意:reextract 中的 --clean-edges 只会移除 source='llm-extraction' 的边,不会处理 semantic-neighbor 边。如需彻底清理:
DELETE FROM edges WHERE source = 'semantic-neighbor';
安排为定期维护任务:由于 link-neighbors 开销低(不调用 LLM)且具有幂等性(边会执行 upsert,而不会重复创建),很适合作为每周运行的 cron 任务,在添加新实体后保持邻居图谱更新。以下示例 cron 条目会在每周日 02:00 运行:
0 2 * * 0 cd /path/to/postgram && ./bin/pgm-admin link-neighbors --all
或者使用 Docker Compose:
./bin/pgm-admin link-neighbors --all
自动创建的实体:当 EXTRACTION_AUTO_CREATE_ENTITIES=true 时,文档首次提及的实体会被插入,content = 提取出的名称,tags 包含 auto-created,且 metadata.auto_created_by = 'llm-extraction';metadata.source_entity_id 则指向导致实体创建的文档。它们会进入常规嵌入队列,因此可以被搜索,但会被刻意排除在提取队列之外——它们只有一个孤立的名称,没有上下文;如果向 LLM 询问“Alice 与什么有关?”,只会导致它在循环中自由联想并新建空实体。查看或清理它们:
pgm list --tags auto-created --type person
# or wholesale prune:
docker compose exec postgres psql -U postgram -d postgram -c \
  "DELETE FROM entities WHERE 'auto-created' = ANY(tags);"
CLI
| 变量 | 必需 | 描述 |
|---|---|---|
PGM_API_URL | 是 | 服务 URL |
PGM_API_KEY | 是 | 用于身份验证的 API 密钥 |
管理 CLI
| 变量 | 必需 | 描述 |
|---|---|---|
DATABASE_URL | 是 | 用于管理操作的直接 DB 连接 |
备份
| 变量 | 必需 | 描述 |
|---|---|---|
DATABASE_URL 或 PGM_DATABASE_URL | 是 | 数据库连接 |
PGM_BACKUP_PASSPHRASE | 使用 --encrypt 时 | GPG 加密密码短语 |
运行服务
预构建 Docker 镜像
从 GitHub Container Registry 拉取:
docker pull ghcr.io/ivo-toby/postgram:latest
镜像支持多架构(linux/amd64、linux/arm64)。可用标签:
latest—main的最新构建main— 与latest相同,显式分支名称sha-<short>— 固定到特定提交
此仓库中的 docker-compose.yml 默认在本地构建;若要改用预构建镜像,请将
mcp-server 服务的 build: . 替换为 image: ghcr.io/ivo-toby/postgram:latest。
本地开发
npm run dev
以生产环境风格在本地运行:
npm run build
npm start
服务提供以下接口:
- REST API:
http://127.0.0.1:3100/api - MCP 端点:
http://127.0.0.1:3100/mcp - 健康检查端点:
http://127.0.0.1:3100/health
身份验证
在 http://127.0.0.1:3000/admin 的管理面板中创建 API 密钥。
明文密钥只会在浏览器中显示一次,关闭页面或重新加载后便无法找回。
导出密钥以供 CLI 使用:
export PGM_API_URL=http://127.0.0.1:3100
export PGM_API_KEY='<plaintext-key>'
REST API 概览
实体端点
POST /api/entities— 存储实体GET /api/entities/:id— 检索实体PATCH /api/entities/:id— 更新实体DELETE /api/entities/:id— 软删除实体GET /api/entities— 列出实体
搜索
POST /api/search— 使用 RRF 分数进行关键词与向量混合搜索(支持expand_graph和include_content)
为保持向后兼容,REST 搜索默认保留完整实体内容。传入 include_content: false,即可返回匹配的文本块,而不对完整结果和图邻居内容进行填充或序列化。其他 REST 路由仍会返回原有的完整 JSON 响应。紧凑 JSON 和 TOON 仍是 MCP 与 CLI 的传输层便利功能。
任务
POST /api/tasks— 创建任务GET /api/tasks— 列出任务PATCH /api/tasks/:id— 更新任务POST /api/tasks/:id/complete— 完成任务
文档同步
POST /api/sync/diff— 将本地清单与服务端进行差异比较;返回需要上传和删除的路径POST /api/sync/upload— 上传一批文件内容POST /api/sync/finalize— 归档孤立项并恢复过期的匹配项POST /api/sync— 单次推送(保留供 MCP 和小规模同步使用)GET /api/sync/status/:repo— 获取同步状态
pgm sync 使用三阶段协议(diff → 批量 upload → finalize),
因此大型仓库不会发送单个超大请求。每批上传最多约 50 个文件或约 4 MB,
以先达到的限制为准。
知识图谱
POST /api/edges— 创建边DELETE /api/edges/:id— 删除边GET /api/entities/:id/edges— 列出实体的边GET /api/entities/:id/graph— 扩展图谱邻域
队列 / 富化
-
GET /api/queue— 富化与提取队列状态。 传入?include_failures=true(可选添加&failure_limit=N,默认值为 20, 最大值为 100),还可获取最近失败的实体及其 错误消息,例如:{ "embedding": { "pending": 0, "completed": 120, "failed": 0, "retry_eligible": 0, "oldest_pending_secs": null }, "extraction": { "pending": 2, "completed": 98, "failed": 3 }, "failures": [ { "id": "…", "type": "document", "kind": "extraction", "error": "llm context exceeded", "path": "notes/long.md", "updatedAt": "2026-04-22T10:12:33Z" } ] }
所有 /api/* 路由都需要 Authorization: Bearer <api-key>。
MCP 概览
MCP 通过 Streamable HTTP 提供,地址为:
http://127.0.0.1:3100/mcp
公开的工具:
store、recall、search、update、delete、queuestore_session_context、groom_session_contexttask_create、task_list、task_update、task_completesync_push、sync_statuslink、unlink、expand
MCP 工具的行为刻意与 REST 接口保持一致,但默认采用紧凑、便于 Agent 使用的响应,避免输出过多令牌:
- 写入确认(
store、store_session_context、update、任务写入、link)返回紧凑的 ID、状态和版本,而不是回显完整元数据和时间戳 search、task_list和expand默认返回紧凑的行或图数据;紧凑搜索结果包含匹配的分块,而非完整结果或相邻内容,并可能包含edges.count和edges.relations,作为开销较低的遍历辅助信息- 传入
full_response: true可获取完整的 REST 形式响应,包括完整的实体内容 - 对列表类工具(
search、task_list、expand)传入toon: true,可从 MCP 层获取紧凑的 TOON 文本
搜索是发现步骤:检查紧凑 ID、相对 RRF 分数和匹配的分块,然后仅对需要完整内容的选定实体调用 recall。搜索分数是用于排序的数值,并非百分比;如果调用方需要向量信号,可在完整响应中获取余弦 similarity。紧凑的 edges 摘要仅包含计数和关系标签,不包含相邻实体的内容。当用户需要了解原因、来源、决策、依赖关系、阻碍因素、所有权、参与情况、讨论参与者、关联上下文或基于图的消歧时,请使用 expand_graph 或 expand。对于匹配分块中已有的直接事实,请避免展开。
底层 API 仍使用 JSON;仅 MCP/CLI 处理程序会进行紧凑化和 TOON 转换。
原生远程连接器(ChatGPT 和 Claude)
本地 MCP 客户端可使用静态 Bearer API 密钥连接。具有自定义连接器/开发者模式访问权限的 ChatGPT 账号,以及 Claude 的 Connectors 界面,可通过 OAuth 连接到公开的 Postgram 端点,而无需在客户端设置中存储静态 API 密钥标头:
OAUTH_ENABLED=true
PUBLIC_BASE_URL=https://postgram.example.com
将 ${PUBLIC_BASE_URL}/mcp 添加为 ChatGPT 或 Claude 中的连接器 URL。客户端会发现 /.well-known/oauth-protected-resource/mcp,通过 /oauth/register 注册,打开 /oauth/authorize,并从 /oauth/token 获取 OAuth 令牌。该端点必须可通过公共 HTTPS 访问。
授权页面会要求输入现有的 Postgram API 密钥一次。由该授权签发的令牌会继承 API 密钥的作用域、client_id、允许的实体类型和允许的可见性。如果源 API 密钥被撤销,由此派生的 OAuth 访问令牌和刷新令牌将停止工作。现有的 Authorization: Bearer <api-key> 客户端和 /mcp?apiKey=... 均可继续正常使用,无需更改。
CLI(pgm)
从 npm 安装
npm install -g @ivotoby/postgram-cli
然后配置一次:
export PGM_API_URL=http://<postgram-host>:3100
export PGM_API_KEY=<your-api-key>
# or persist them in ~/.pgmrc as JSON: { "api_url": "...", "api_key": "..." }
从源代码运行(用于开发)
在仓库根目录中直接调用 TypeScript 入口点,无需构建步骤,并且会立即使用本地更改:
npx tsx cli/src/pgm.ts <command>
# e.g.
npx tsx cli/src/pgm.ts sync ~/Documents/personal-notes --repo personal-notes
实体命令
pgm store "decided to use pgvector" --type memory --tags decisions
pgm search "database decisions"
pgm search "database decisions" --type memory          # filter by entity type
pgm search "who worked on embeddings" --expand-graph   # include graph neighbours
pgm search "database decisions" --json                 # matched chunks for agents
pgm search "database decisions" --json --full-response # complete legacy search response
pgm search "database decisions" --limit 5 --toon       # compact discovery output
pgm recall <selected-entity-id>                         # complete selected content
pgm list --json                                        # compact JSON rows
pgm list --json --full-response                        # full API-shaped rows
pgm list --toon                                        # compact TOON rows
pgm expand <id> --json                                 # compact graph JSON
pgm expand <id> --toon                                 # compact TOON graph
pgm recall <id>
pgm list --type memory
pgm update <id> --content "updated text" --version 1
pgm delete <id>
任务命令
pgm task add "set up monitoring" --context @focus-work --status next
pgm task list --status next
pgm task update <id> --status waiting --version 1
pgm task complete <id> --version 2
文档同步
pgm sync ~/Documents/personal-notes
pgm sync ~/Documents/cf-notes --repo cf-notes --dry-run
pgm sync ~/Documents/personal-notes --quiet  # for cron
知识图谱
pgm link <source-id> <target-id> --relation involves
pgm expand <entity-id> --depth 2
pgm unlink <edge-id>
备份
pgm backup --encrypt --output /tmp/postgram-backups/
管理员 CLI(pgm-admin)
受支持的 Docker 顺利使用流程是通过浏览器中的 Admin 仪表板进行引导配置、提供方配置、API 密钥创建、状态检查和安全的维护试运行。pgm-admin 仍可用于紧急恢复、嵌入迁移、原始 SQL 检查和高级运维任务。
简单的 CLI 使用方式是调用仓库中提供的 bin/pgm-admin 包装脚本。容器运行时,它会通过 docker exec 运行 pgm-admin;容器未运行时,则会改用 docker compose run --rm(适用于首次启动迁移,或启动维度检查阻止启动的情况):
./bin/pgm-admin <command> [args...]
对于 cron 或其他非交互式自动化任务,请调用 Docker 时使用 -T,以免尝试分配 TTY:
docker compose exec -T mcp-server /app/docker-entrypoint.sh pgm-admin <command>
示例:
./bin/pgm-admin key create --name local --scopes read,write,delete --visibility personal,work,shared
./bin/pgm-admin stats
./bin/pgm-admin embeddings migrate --target-dimensions 1024 --dry-run
docker compose stop mcp-server
./bin/pgm-admin embeddings migrate --target-dimensions 1024 --yes
docker compose up -d mcp-server
如果在 Admin 中更改了嵌入服务提供方、模型或维度,请先保存、验证并应用目标设置,再运行该迁移流程。
只要 mcp-server 正在运行,封装脚本就会拒绝 --yes,以免正在运行的 enrichment worker 使用先前内存中的服务提供方处理重新嵌入队列。
服务运行时可以安全地执行试运行。
日常使用的 Shell 别名(添加到 Docker 主机上的 ~/.bashrc 或 ~/.zshrc):
alias pgm-admin='/path/to/postgram/bin/pgm-admin'
# then just: pgm-admin stats
如果服务或容器名称不同,可通过环境变量覆盖:
PGM_SERVICE=mcp-server PGM_CONTAINER=my-postgram-mcp-server-1 ./bin/pgm-admin stats
不使用封装脚本的直接等效命令(供参考):
docker compose exec -T mcp-server /app/docker-entrypoint.sh pgm-admin <command>
# or, when the container is down:
docker compose run --rm mcp-server pgm-admin <command>
对于在已运行的容器中执行的命令,必须使用该入口点。它会重建 DATABASE_URL 等由 Docker 管理的值;这些值会导出给服务器进程,但不会出现在普通的 docker compose exec 环境中。
主要命令:
-
key create、key list、key revoke -
audit— 查询审计日志 -
model list、model set-active -
reembed --all— 将实体标记为需要重新嵌入(可选使用--type <type>;与--model <id>搭配时,会在同一事务中切换当前嵌入模型) -
reextract --all— 将extraction_status = 'pending'并清除任何 已存储的extraction_error,以便 worker 重试抽取(例如,切换到更好的大模型之后)。主要标志:--type <type>— 限定到特定实体类型--only-failed— 仅将之前抽取失败的实体重新加入队列--no-edges-only— 仅将没有 LLM 抽取边的实体重新加入队列; 适用于定向维护,不会重新处理已正确建立关联的实体(与--type document搭配,可找出那些未报错但未生成任何边的大型文档)--clean-edges— 重新加入队列之前,删除范围内实体已有的source='llm-extraction'边,从而彻底重新处理,而不是在旧边旁追加新边--limit <n>— 限制加入队列的实体数量(按最早优先)
用户创建的边(
source != 'llm-extraction')不会被触及。 -
improve-graph— 将实体加入重新抽取队列,可选使用存储在行中的每次运行模型/服务提供方覆盖值。worker 会使用该覆盖值,而不是环境变量配置的默认值,并在成功后将其清除。默认情况下保留现有边(不清除);新一轮生成的重叠边会覆盖其置信度。主要标志:--all、--type <type>、--id <uuid>— 限定要加入队列的范围--model <name>— 例如claude-sonnet-4-6;按行存储--provider <name>—openai | anthropic | ollama | openai-compatible;按行存储--no-edges-only— 仅将没有 LLM 抽取边的实体加入队列--clean-edges— 加入队列前清除现有的 LLM 边--limit <n>— 限制队列大小
针对图谱缺失项、无需为整个图谱付费的典型维护操作:
./bin/pgm-admin improve-graph --type document --no-edges-only --provider ollama --model <model> -
prune-edges --below <threshold>— 删除confidence低于阈值的边。默认范围限定为source='llm-extraction';传入--source any可包含所有来源,或传入--source <name>指定某个来源。支持使用--relation <name>和--dry-run安全预览。 -
validate-edges— 执行一次由 LLM 担任裁判的质量检查。对于每条source='llm-extraction'的边(可通过--source配置),询问已配置的提取 LLM,判断源内容是否支持该关系;删除被判定为无效或低于--min-confidence(默认值为0.4)的边。此命令会在边的元数据中记录last_validated_at,并跳过在--skip-validated-days(默认值为7)天内已验证的边,可作为维护 cron 任务运行,无需重复处理。标志:--limit <n>(默认值为 100)、--force、--dry-run。需要设置EXTRACTION_ENABLED=true以及常用的EXTRACTION_PROVIDER/EXTRACTION_MODEL环境变量;每条边约需调用一次 LLM。 -
sql "<statement>"— 对数据库执行原始 SQL 语句。接受位置参数,也可从标准输入读取多行查询。SELECT 结果以制表符分隔的形式打印(或使用--json输出为 JSON);DML 命令会打印受影响的行数。./bin/pgm-admin sql "SELECT id, type, extraction_status FROM entities LIMIT 5" ./bin/pgm-admin sql --json "SELECT COUNT(*) FROM edges WHERE source = 'llm-extraction'" # pipe multi-line SQL from a file cat fix.sql | ./bin/pgm-admin sql -
stats— 实体数量、分块数量、数据库大小 -
embeddings migrate— 切换嵌入维度(参见specs/002-local-embeddings/quickstart.md)
图谱维护
随着 LLM 提取将实体相互关联,知识图谱会逐渐扩展。偶尔会出现边缺失的情况(例如更换提供方后、达到 max_tokens 限制时,或模型发生故障时),也可能需要刷新。管理 CLI 提供了相关工具,无需重新处理整个图谱即可完成这些操作。
查找缺失项
已完成提取但未生成任何边的实体,是静默失败的主要信号:
./bin/pgm-admin sql "
  SELECT id, char_length(content) AS chars, created_at
  FROM entities
  WHERE type = 'document'
    AND extraction_status = 'completed'
    AND NOT EXISTS (
      SELECT 1 FROM edges WHERE source_id = id AND source = 'llm-extraction'
    )
  ORDER BY chars DESC
  LIMIT 20
"
定向重新提取(不清空)
仅将没有边的实体重新加入队列。其他实体上的现有边不会受到影响:
# Using the default extraction model
./bin/pgm-admin reextract --type document --no-edges-only

# Using a local Ollama model (zero API cost)
./bin/pgm-admin improve-graph --type document --no-edges-only --provider ollama --model <model>
全量重新提取
需要重新处理所有内容时(例如切换到更好的模型后):
# Wipe and redo — gives a clean slate
./bin/pgm-admin reextract --all --clean-edges

# Or scope to documents only
./bin/pgm-admin reextract --type document --clean-edges
置信度清理
删除旧版或较弱模型遗留的低置信度边:
./bin/pgm-admin prune-edges --below 0.5 --dry-run   # preview
./bin/pgm-admin prune-edges --below 0.5             # apply
边验证
执行一次由 LLM 担任裁判的检查,删除源内容不支持的边:
./bin/pgm-admin validate-edges --dry-run --limit 200
./bin/pgm-admin validate-edges --limit 200
监控队列进度
pgm queue                              # via pgm CLI
./bin/pgm-admin sql "SELECT extraction_status, COUNT(*) FROM entities GROUP BY 1"
Talon 迁移
docker compose cp /path/to/talon.sqlite mcp-server:/tmp/talon.sqlite

docker compose exec -T mcp-server \
  node dist/migrate-talon/index.js /tmp/talon.sqlite \
  --api-base-url http://127.0.0.1:3100 \
  --api-key "$PGM_API_KEY"
实用标志:--dry-run、--thread <id>、--batch-size <n>、--skip-embeddings
测试
npm test            # all tests
npm run lint        # eslint
npm run build       # typecheck
npm run test:coverage
npm run benchmark:search -- --assert  # 5k-entity/6k-chunk latency gate
npm run benchmark:quality -- --assert # synthetic search relevance gate
搜索基准测试会报告六种配置的 p50/p95 延迟:
cold_unique_queries(每个查询都会产生一次提供方往返调用)、
memory_cache_hit、database_cache_hit(进程内缓存为空,因此只有持久化缓存可以提供结果)、long_keyword_query(有界分块 GIN 关键词分支)、pasted_query(包含 300 个不同输入词项,其中保留 24 个),以及
underfilled_hnsw_fallback(强制在范围较窄的带标签测试数据上使用 HNSW,随后执行精确回退);同时还会报告每种配置调用嵌入提供方的次数,以及混合 SQL 的 EXPLAIN (ANALYZE, BUFFERS) 摘要。它使用固定延迟模拟嵌入提供方,因此测量的是 SQL 耗时和缓存命中率;无法反映真实的提供方延迟。
使用以下命令,获取实际长关键词测试数据和 HNSW 严格迭代扫描设置的完整计划:
npm run benchmark:search -- --explain-output /tmp/search-plans.json
质量基准测试会针对公开合成语料库,按类别报告 nDCG@5、MRR 和 recall@10。若要运行私有分级标签,请将
SEARCH_QUALITY_LABELS 设为本地 JSONL 文件,传入 --private 以使用默认忽略路径 benchmarks/fixtures/private-search-quality.labels.jsonl,并配置明确的 DATABASE_URL。此模式只会读取已配置的数据库和标签文件;不会为数据库填充数据、重置数据库或修改数据库。
对于限定范围的记忆,请传入 --client-id <client>,或将 SEARCH_QUALITY_CLIENT_ID 设为实际客户端身份;私有模式会强制使用只读数据库访问,并根据当前身份验证已配置的嵌入提供方、模型和维度。
公开和私有标签的基准测试默认使用精确策略。因此,公开基线和 --assert 门禁运行衡量的是相关性,不受 ANN 近似的影响。传入 --strategy auto 或 --strategy hnsw 可检查近似检索效果。请勿将私有标签纳入版本控制。
定向测试套件:
npx vitest run tests/unit/
npx vitest run tests/integration/
npx vitest run tests/contract/
当前状态
Postgram 由一位维护者积极开发,并在个人部署中日常使用。实体存储、任务管理、Markdown 同步、混合搜索、知识图谱遍历、记忆生命周期、OAuth、面向用户的 Web UI 以及受保护的 Admin UI 均已实现。本项目有意针对个人和小团队的可自托管场景进行优化,而非面向多租户规模。
说明与限制
- Postgram 针对个人和小团队规模进行了优化
- 非 Compose 部署默认使用 OpenAI 嵌入;Compose 在检测到密钥时会选择 OpenAI,否则会选择本地 Ollama。搜索要求所选提供方可访问。
- LLM 提取为可选功能,默认禁用
- 备份加密需要
gpg
Claude Code 技能
用于从你自己的 Agent 调用 pgm 的可移植 Claude Code 技能位于
skill/postgram/SKILL.md。将 skill/postgram/
目录复制到你自己项目的 .claude/skills/(或用户级
~/.claude/skills/),Agent 就会知道何时调用 pgm store、
pgm search、pgm link 等命令。它假设 CLI 已加入 PATH,且已设置
PGM_API_URL 和 PGM_API_KEY。本仓库有意不将技能文件放在
.claude/ 下,以便你自行决定存放位置。
优化你的全局 CLAUDE.md
要让 Postgram 在多个会话中发挥最大作用,请在全局 ~/.claude/CLAUDE.md 中添加 Postgram 专用指引。可直接使用的模板位于
templates/CLAUDE.md — 其中涵盖何时搜索(使用类型筛选器)、如何检查精简的 edges.count/edges.relations、何时使用 expand_graph、何时存储、何时建立链接,以及通用原则。将相关部分复制到自己的 CLAUDE.md 中,Claude 就会主动使用 MCP 工具来持久化和召回知识,无需你提出要求。其默认检索流程是先搜索精简的匹配片段,再仅召回需要完整内容的选定实体。
对于应避免广泛知识处理行为的编码 Agent,请使用
templates/AGENTS.coding.md 或 templates/CLAUDE.coding.md。它会将 Postgram 的使用范围限定为会话上下文记忆和持久开发记忆。
发布与 CI
CLI 软件包会在每次合并到 main 时发布到 npm,名称为
@ivotoby/postgram-cli,
由 semantic-release v25 和限定作用域为 cli 的 conventional commits 驱动(例如 feat(cli): ...)。
未限定为 CLI 作用域的提交不会提升 CLI 版本。工作流:
.github/workflows/release-cli.yml。
发布时使用存储为仓库机密 NPM_TOKEN 的 npm Automation token。发布时会传入 --provenance 标志,因此每次发布都会获得 Sigstore 签名的来源证明。
首次设置:
- 在 npmjs.com 上:头像 → Access Tokens → Generate New Token → Automation
- GitHub 仓库:Settings → Secrets and variables → Actions → New repository secret
→ 名称为
NPM_TOKEN,值为步骤 1 中的令牌 - 后续发布会由工作流自动完成。
服务端的 Docker 镜像会在每次合并到 main 时以及推送 semver 标签时发布到
ghcr.io/ivo-toby/postgram(多架构 amd64 + arm64)。工作流:
.github/workflows/docker.yml。使用内置的
GITHUB_TOKEN;无需额外机密,但必须启用仓库的 packages:write
权限。
官方 MCP 注册表
Postgram 已以 io.github.ivo-toby/postgram 的名称发布到
官方 MCP 注册表。注册表元数据位于 server.json,其中描述了公开的 GHCR
镜像及其 Streamable HTTP 端点。
注册表版本有意采用手动发布。更改 server.json 后,等待 main 上的
docker-publish 工作流完成,然后运行
publish-mcp-registry 工作流。该工作流会验证官方发布方下载内容,将当前的多架构 main 镜像固定到其摘要,验证元数据,通过 GitHub OIDC 进行身份验证,然后发布。发布元数据更新前,请提高 server.json 中顶层的 version;注册表会将每个已发布版本视为不可变版本。
许可
Postgram 采用经过审慎设计的多重许可结构:
- 服务端、Admin CLI 和浏览器 UI 根据 GNU Affero General Public License v3.0 only 授权。
- 已发布的
pgmCLI、skill/和templates/下的可移植 Agent 集成,以及packages/browser-extension-chrome/和packages/browser-extension-firefox/下的浏览器扩展,均根据 MIT License 授权。 docs/中的文档正文和本 README 根据 Creative Commons Attribution 4.0 International 授权。- 代码和文档许可不授予将 Postgram 名称、徽标或其他品牌标识用作商标的权利。请参阅 商标政策。
AGPL 允许商业使用。其网络 Copyleft 条款要求修改过 Postgram 服务的运营者,向通过网络与该修改版服务交互的用户提供相应源代码。有关确切的路径边界和实际示例,请参阅
LICENSING.md。
欢迎按照 CONTRIBUTING.md 中的流程贡献代码。贡献者必须先接受
Postgram 贡献者许可协议,
贡献才能合并。
相关文档
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。