关于 MarkIndex
MarkIndex 按文档结构为大型 Markdown 文档库建立索引,并为 Agent 提供只读检索。它结合中英混合 BM25 搜索和带行号的原文,支持可追溯的证据检索,无需嵌入或向量数据库。
主要功能
- 01从 Markdown 构建章节树
- 02在 SQLite 中增量索引文件
- 03使用中英混合 BM25 搜索
- 04浏览文档、大纲和原文
- 05返回带行号的原始文本
- 06将工具响应分页并控制大小
适用场景
- 01搜索大型 Markdown 手册集合
- 02定位法律或指南中的相关章节
- 03检索带行号引用的段落
- 04让 Agent 结构化访问本地文档
MCP 相关
MarkIndex 提供 MCP 服务,包含五个只读工具,用于浏览文档、查看结构和内容以及搜索索引文本。先建立索引,再针对所选文档库运行服务。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
MarkIndex


面向 Agent,对大型 Markdown 文档库进行无向量、结构优先的检索。
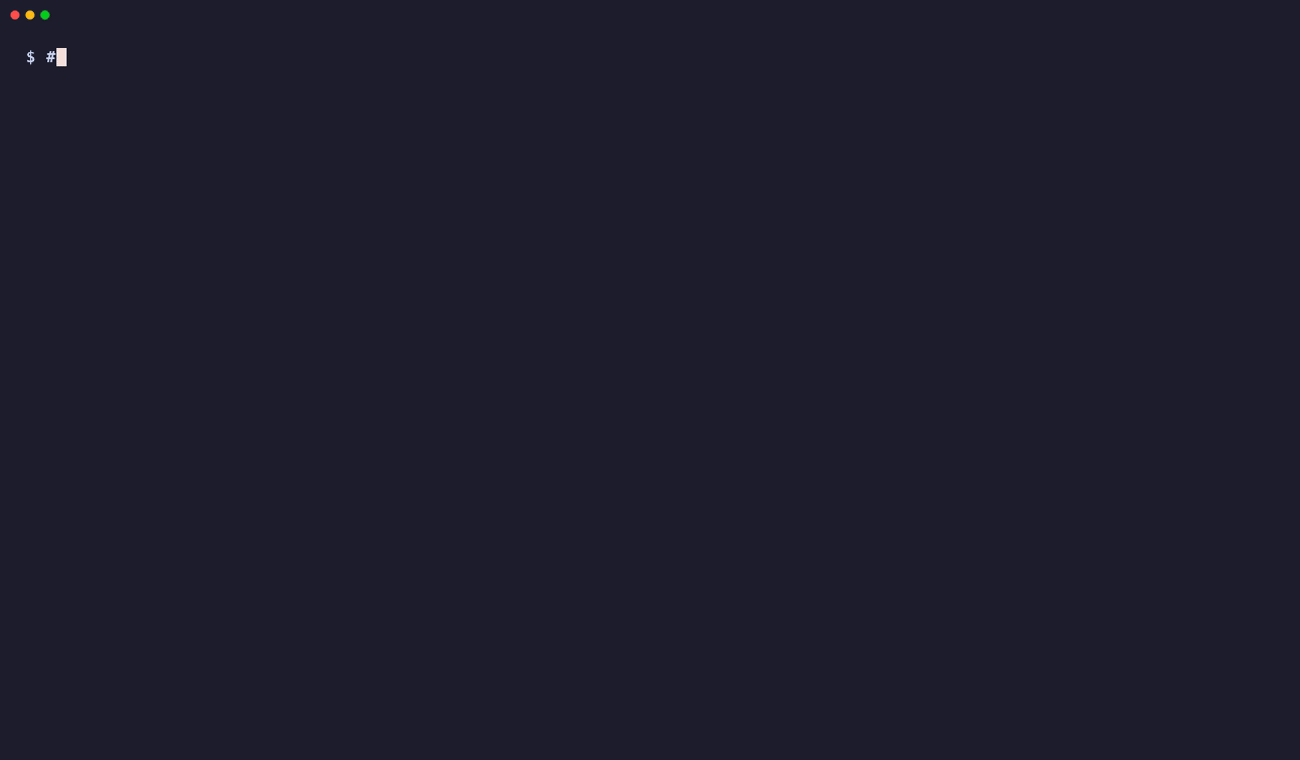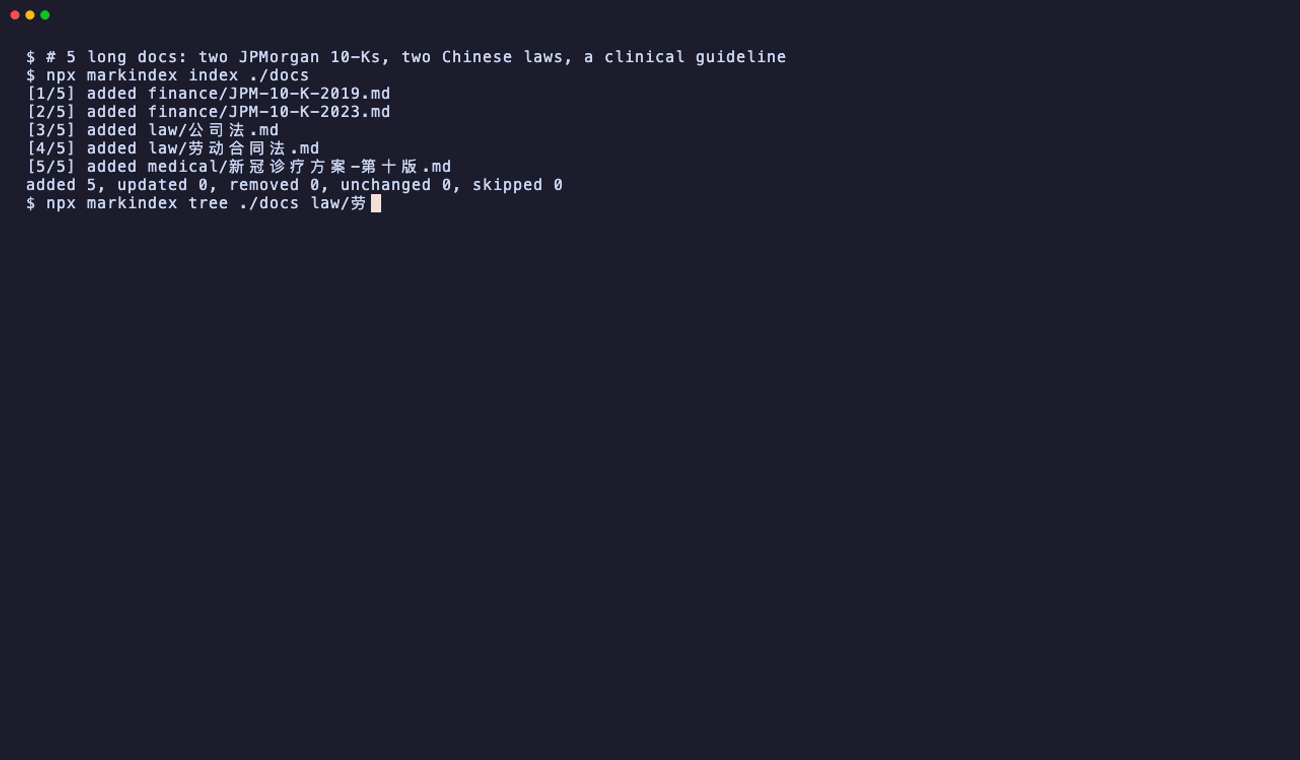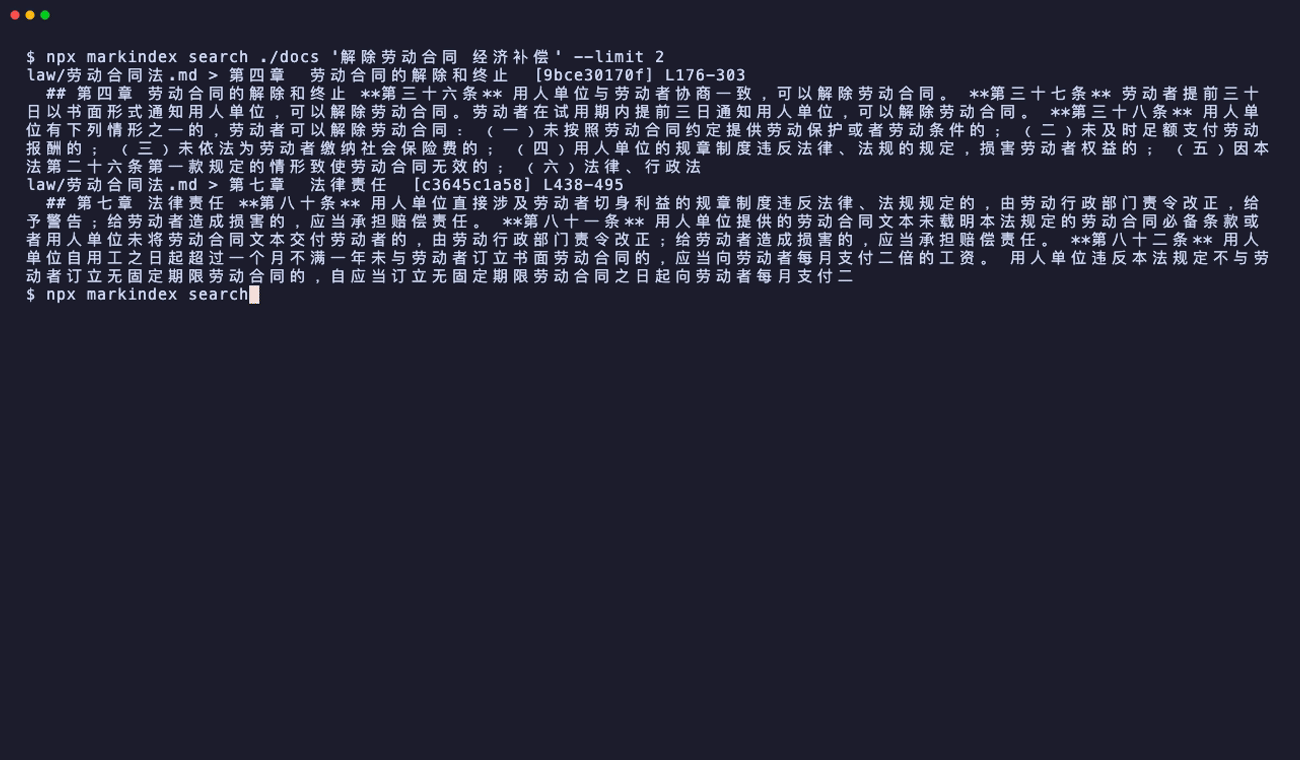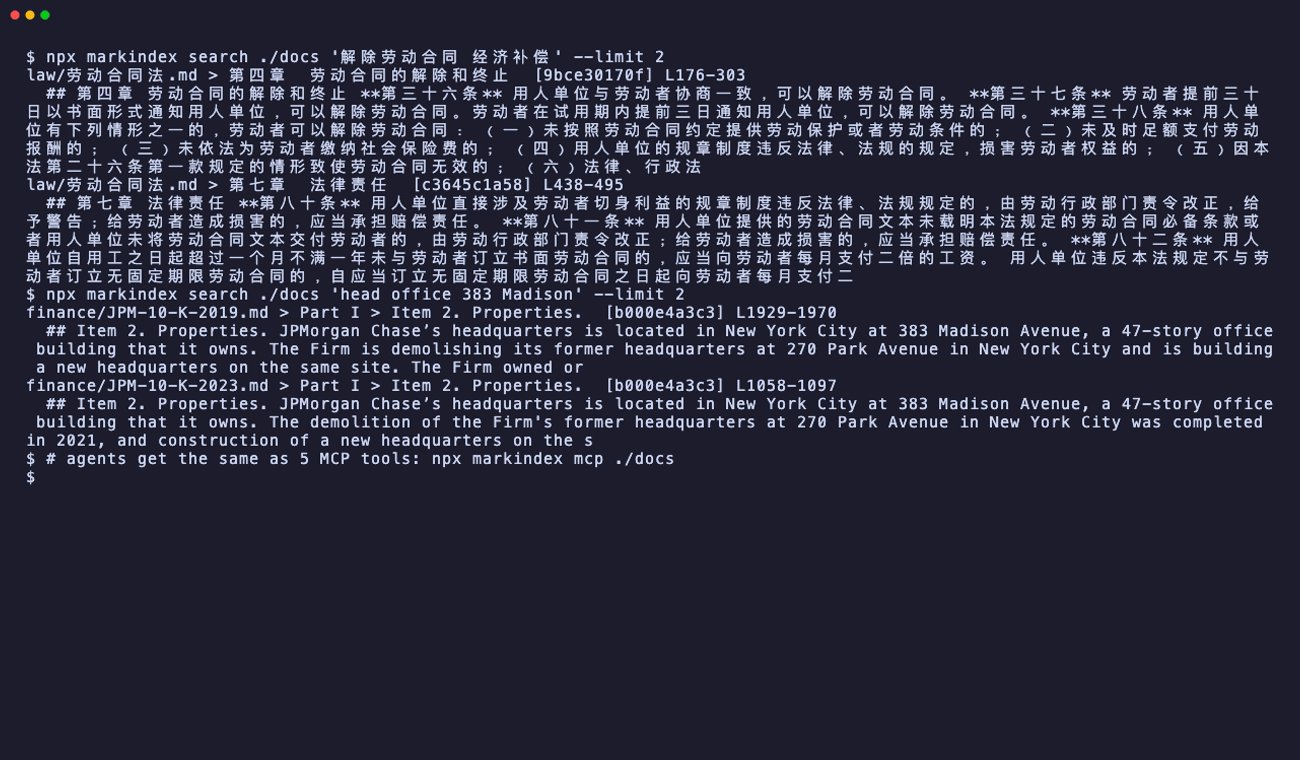
MarkIndex 会将每个 Markdown 文件解析为由其各个章节组成的树,将这些树、原始行以及中英混合 BM25 索引存储在一个 SQLite 文件中,并向 Agent 提供五个只读工具,以遍历“文库 → 文件夹 → 文档 → 章节”并读取带行号的原文。无需嵌入、向量数据库或猜测如何分块:文档自身的结构就是索引,每条证据都可以引用为 [doc_path, L<start>-<end>]。
MarkIndex 的灵感来自 VectifyAI/PageIndex,是一个专注于 Markdown 的独立、非官方 TypeScript 实现。它与 VectifyAI 无关,也未获其认可。
中文说明:README.zh-CN.md
为什么
- 结构优先,而非分块优先。 长篇专业文档(申报文件、指南、法律、手册)已经由作者组织好。沿着纲要导航可以保留上下文,让答案更易解释和引用;任意分块加向量相似度会将章节拆开。
- 确定性索引,不依赖大模型。 解析(使用 mdast,而非正则表达式)、构建树以及按 token 成本优化树的过程都不会调用模型;相同输入始终会生成相同的树。大模型是可选的,仅用于节点摘要、文档描述和内置的
retrieve()循环。 - 妥善处理 Markdown。 Setext 标题、首个标题前的前言、没有任何标题的文档、front matter、代码围栏中的
#、跳级标题、BOM / CRLF——每个源行都恰好属于一个节点,超大的章节则会在块边界处分割为chunk节点。 - 适用于中文的关键词回退方案。 基于
Intl.Segmenter分词(中文、英文和混合文本,以及C++、ISO-27001、v2.1这类标识符)执行 BM25,并在第二轮使用三元子串索引。 - 有预算限制的工具响应。 工具不会抛出异常;它们会返回包含
next_steps指引的 JSON 封装,响应长度不超过 95 000 个字符,并对大型纲要和章节进行分页。
安装
npm install markindex          # library + CLI (Node.js >= 22.12)
npx markindex --help
从源码安装:
git clone https://github.com/jackjin1997/markindex.git && cd markindex
npm install && npm run build
node dist/cli.js --help          # or `npm link` to get a `markindex` command
可选,仅用于大模型功能(摘要、retrieve()、Agent 模式评估):安装所需的 AI SDK 提供商,例如 npm install @ai-sdk/anthropic,并设置其 API 密钥(ANTHROPIC_API_KEY,……)。使用 npx 且未在本地安装时,请将提供商放入同一临时环境:
npx -p markindex -p @ai-sdk/anthropic markindex index ./docs --summary-model anthropic:claude-sonnet-5-5
CLI
# Build or incrementally update the index (stored in <root>/.markindex/index.db)
markindex index ./docs
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5 --estimate   # cost estimate, no LLM calls
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5             # with node summaries
markindex index ./docs --summary-model anthropic:claude-sonnet-5-5 --summary-rpm 50 --summary-tpm 40000   # rate-limited
markindex index ./docs --json                                                   # machine-readable report
markindex index ./docs --no-setext                                              # converter output with `---` page breaks
markindex index ./docs --ignore 'drafts/' --ignore '*.tmp.md'                   # extra ignore patterns (repeatable)

# Inspect one document's section tree
markindex tree ./docs guides/setup.md --depth 3

# Keyword search (BM25 + trigram fallback)
markindex search ./docs "离职 补偿"
markindex search ./docs "ISO-27001 audit" --folder policies --limit 5 --json

# Serve the library to agents over MCP (stdio, read-only)
markindex mcp ./docs
markindex mcp ./docs --reindex-on-start

# Measure retrieval quality on your own documents (see "Evaluation")
markindex eval ./docs --questions questions.jsonl --mode bm25 --out report.json
markindex eval ./docs --questions questions.jsonl --mode agent --model anthropic:claude-sonnet-5-5 --out report.json
markindex eval ./docs --questions questions.jsonl --mode agent --model anthropic:claude-sonnet-5-5 --rpm 50 --tpm 40000
速率限制。 调用始终受并发数限制(eval 使用 --concurrency;摘要为 8),并受 AI SDK 重试机制限制;该机制已会遵循 429 / 5xx 响应中的 retry-after / retry-after-ms(最长 60 s)。若要遵守服务提供商的配额,请添加客户端限流:index 使用 --summary-rpm / --summary-tpm,eval(agent 模式)使用 --rpm / --tpm。rpm 限制任意滑动 60 s 时间窗口内的请求数,tpm 限制其中的预估输入令牌数;每次运行的所有文档(index)或所有问题(eval)共享这两个限制,等待中的调用按顺序处理。输入令牌数根据提示词文本估算(每个 CJK 字符约为 1 个令牌,其他字符每 4 个约为 1 个令牌),因此请在实际配额下方留出余量;输出令牌和工具定义不计入。单个请求即使超过 tpm,仍会独自通过。在库中,可将 rateLimit: { requestsPerMinute, inputTokensPerMinute } 传给 summarizeDocument / indexLibrary({ summary }) 或 retrieve();重复使用同一对象即可共享一份配额。
--summary-model / --model 接受 <provider>:<model>;MarkIndex 会动态导入 @ai-sdk/<provider>,因此只需安装你所用的服务提供商。每条命令都接受 --db <file>,用于指定不同的索引文件。请将索引放在本地磁盘上:写入器锁使用硬链接,SQLite 以 WAL 模式运行,这两者在 exFAT、SMB / NFS 共享或其他网络卷上都无法可靠运行。如果文档存放在这些位置,请将其留在原处,并将 --db 指向本地路径(例如 --db ~/.cache/markindex/docs.db)。
索引采用增量方式:按内容哈希比较文件,只重建新增或更改的文档(每个文档一个事务),删除的文件会被移除,摘要按节点内容哈希缓存。扫描的文件为 .md 和 .markdown(不包括 .mdx)。以下文件会被忽略:匹配库自身 .gitignore 文件的路径(根目录下任意层级均适用;不会读取全局 git 排除项和 .git/info/exclude)、根目录下的可选 .markindexignore 文件(语法相同,用于设置不想放入 .gitignore 的规则),以及 --ignore <pattern> 选项(gitignore 语法,相对于根目录,可重复指定;库 API 中为 ignore: string[];mcp --reindex-on-start 也接受此选项;开头的 ./ 会被去掉,开头的 / 会像 gitignore 中那样锚定到根目录,并且不接受绝对文件系统路径或 ../)。这些来源只会添加排除规则:.markindexignore 或 --ignore 中的 ! 规则不能重新纳入被 .gitignore 排除的路径。变为忽略状态的文档会在下次运行时从索引中移除。
会跳过 .git 和 .markindex 等点目录,且不会跟随符号链接。同一时间只允许一个写入器运行(第二个 index 会立即失败);MCP 服务等读取器不会被阻塞。如果索引由较旧版本的 MarkIndex 构建,或使用了不同的树参数,下次运行 index 时会重建所有文档(输出中显示 full rebuild: …,报告中显示 rebuilt);缓存的摘要会被复用。
PDF / HTML 转换器产生的分页符。 转换器通常会在页面最后一段之后输出单独一行 ---。CommonMark 会将其解析为 setext 标题,因此整段文字会变成二级标题。index 在遇到文本跨多行或超过 120 个字符的 setext h2 标题时会发出警告(stdout 中显示 warning <path>: …,JSON 报告中包含 warnings)。对于这类文档库,请传入 --no-setext(mcp --reindex-on-start 也支持此选项;库 API 中为 setext: false):此时 --- 会被视为主题分隔线,=== 会被视为普通文本。此设置会存储在索引中:后续运行时即使不带该标志(index、mcp --reindex-on-start、Library.index()),也会继续沿用;传入 --setext(setext: true)可重新启用。更改此设置会重建索引。
库的用法
import { openLibrary } from 'markindex'

// Index (or update) a folder, then open it read-only for agents.
const writer = openLibrary({ root: './docs', readonly: false })
await writer.index() // { added, updated, removed, unchanged, skipped, summaryErrors, warnings }
writer.close()

const lib = openLibrary({ root: './docs' })
const envelope = await lib.callTool('search_documents', { query: 'termination notice period' })
console.log(JSON.parse(envelope)) // { success: true, data: { results: [...] }, next_steps: {...} }
使用 Vercel AI SDK(由你的 Agent 调用工具)
import { generateText, stepCountIs } from 'ai'
import { anthropic } from '@ai-sdk/anthropic'
import { AGENT_INSTRUCTIONS, createAiSdkTools, openLibrary } from 'markindex'

const lib = openLibrary({ root: './docs' })
const { text } = await generateText({
  model: anthropic('claude-sonnet-5-5'),
  system: AGENT_INSTRUCTIONS, // browse first, read structure, cite [doc_path, L<start>-<end>]
  tools: createAiSdkTools(lib),
  stopWhen: stepCountIs(15),
  prompt: 'What notice period applies when an employee resigns?',
})
内置证据检索
retrieve() 会在模型循环中运行相同的工具,并仅返回证据(按行范围从索引中重新读取的原始文本——绝不是模型生成的文本),以及用量和停止原因:
import { anthropic } from '@ai-sdk/anthropic'
import { openLibrary, retrieve } from 'markindex'

const lib = openLibrary({ root: './docs' })
const { evidence, usage, stopReason } = await retrieve(lib, 'What notice period applies when an employee resigns?', {
  model: anthropic('claude-sonnet-5-5'),
  maxSteps: 12,
  maxInputTokens: 200_000,
  rateLimit: { requestsPerMinute: 50, inputTokensPerMinute: 40_000 }, // optional, client-side
})
for (const e of evidence) console.log(`${e.docPath} L${e.startLine}-${e.endLine}`, e.titlePath.join(' > '))
同时也导出了更底层的构建模块:parseMarkdown、buildTree、optimizeTree、openStore、
indexLibrary、searchNodes、summarizeDocument、estimateSummaryCost、TOOL_CONTRACT、createMcpServer。
MCP 设置
先构建索引(npx markindex index /path/to/docs),然后注册服务。MarkIndex 也已列入
官方 MCP Registry,标识为 io.github.jackjin1997/markindex,因此支持注册表的
客户端可以从那里安装(它们会以 npx markindex mcp <docs_dir> --reindex-on-start 启动)。
Claude Code
claude mcp add markindex -- npx markindex mcp /path/to/docs
Cursor(~/.cursor/mcp.json 或项目中的 .cursor/mcp.json)
{
  "mcpServers": {
    "markindex": {
      "command": "npx",
      "args": ["markindex", "mcp", "/path/to/docs"]
    }
  }
}
该服务会将 AGENT_INSTRUCTIONS 作为 MCP 指令发送,并将所有工具标记为只读。
工具
| 工具 | 功能 |
|---|---|
browse_documents | 列出一个文件夹中的子文件夹和文档(路径、标题、描述、令牌数),支持分页。默认的发现工具。 |
get_document | 获取单个文档的元数据、前置元数据、大小和 read_structure_first(超过 15 000 个令牌时为 true)。 |
get_document_structure | 获取章节大纲(节点 ID、标题、行范围、令牌数、摘要——不含正文),可指定 depth 层级(默认 2),也可仅查看一个节点的子树;支持通过 part 分页。 |
get_node_content | 获取 1-20 个节点的原始 Markdown,包含行号(123│ …);长节点支持分页。 |
search_documents | 对标题、合并后的子标题、摘要和文本进行 BM25 关键词搜索,并提供三元组回退;可按 folder 或 doc_path 限定范围。浏览陷入停滞时的升级途径。 |
所有工具都会以 JSON 字符串返回 { success: true, data, next_steps } 或 { success: false, error, code, details, next_steps },
且绝不会抛出异常——未知文档路径会返回相似名称建议,过期的节点 ID 会附带“重新获取结构”的提示。对于与架构不匹配的参数(类型错误、未知字段、字符串超过
1 024 个字符),lib.callTool 会返回 INVALID_INPUT 封装结果;不过,通过 MCP 和 AI SDK 调用时,传输层会在工具运行前
根据相同的架构校验参数,因此此类错误会以传输层自身的错误返回(MCP 工具错误 / AI SDK 无效工具输入错误),而非 JSON 封装结果。
安全与信任
- 只读,限定于指定知识库。 工具只会读取你指定的知识库索引;绝不会读取其中以外的文件、写入内容或获取 URL。路径和节点 ID 会在索引中查找,而不是在磁盘上查找。
- 文档是不可信输入。 工具输出的是原始文档文本,LLM 摘要 / 描述也由这些文本生成。文档可能包含旨在引导 Agent 的文本(提示词注入)。请将工具返回的所有内容都视为数据,而非指令——尤其是在知识库包含第三方或用户提供的文件,且 Agent 也拥有可执行操作的工具(发送、写入、执行)时。
- 摘要和
retrieve()会将文档文本发送给你配置的模型提供商;仅建立索引不会发起网络调用。
设计说明
- 树结构。 顶层 mdast 标题定义各个章节;首个标题之前的文本是一个
preface节点;没有标题的文档是一个根节点。节点 ID 是由祖先标题链和同级序号生成的短哈希,因此只要大纲不变,ID 就保持稳定。 - 树优化。 合并/展开流程移植自 PageIndex 的
tree_optimize.py成本模型,并以 token 替代页面:当整体读取子树的成本不高于经由该子树进行路由的成本时(S(v) <= tree_cost(v),路由成本R = 150个 token),就将子树合并到其父节点;被合并的标题会作为keyItems保留;自身文本超过MAX_NODE_TOKENS(8 000)的节点,则会在 Markdown 块边界处确定性地拆分为chunk子节点。成本模型归功于 PageIndex。 - 搜索。 只索引节点自身的文本(不包括子树),避免父节点和子节点重复计数。标题权重为 10×,合并的标题为 5×,摘要为 2×,正文为 1×。
- 工具契约。 一个 zod 契约(名称、描述、架构)供 AI SDK 适配器、MCP 服务和
retrieve()共用;描述和 Agent 指令改编自 PageIndex 的agent_tools.py(将页面改为行范围),并由快照测试固定。 - Token。 计数为近似值(CJK 字符 = 1 个 token,其他字符 / 4);可以注入真正的分词器。默认值位于
src/config.ts。
评估
markindex eval 用于衡量检索是否命中了正确章节:提供一个知识库文件夹和一个包含标准位置(文档路径 + 行范围,或标题路径)的 JSONL 问题文件,它会针对 BM25 基线和 LLM Agent 报告整体及各语言的命中率、token 成本、步数和证据大小/精确率(--max-evidence-lines <n> 还会要求命中内容最多为 n 行)。问题文件格式、命中规则、开发语料库(329 份公开文档,约 38 M 个 token,包括英文申报文件和指南,以及中文法律文件和百科文章)、基线结果和规模基准测试,详见 eval/README.md。
主要结果(n = 30,Claude Code sonnet 限定使用五个 MarkIndex MCP 工具): 30/30 个问题都找到了标准段落(排名第 1 的比例为 93.3%),平均引用 15 行,其中 88.6% 的引用行位于标准范围内;相比之下,同一批问题中,BM25 top-5 的命中率为 73.3%,引用 209 行(精确率为 12.8%),每个问题平均约需 3 轮 Agent 交互(详情及注意事项)。
开发
npm install
npm test            # vitest
npm run typecheck
npm run build
npx tsx eval/fetch-corpus.ts   # download the evaluation corpus (eval/corpus, not committed)
npx tsx eval/bench.ts          # scale benchmark
npx tsx eval/claude-code-eval.ts --root eval/corpus --questions eval/questions.jsonl --per-lang 10 --out cc.json
                               # agent eval with Claude Code over MCP (spends Claude usage; eval/README.md §7)
发布
发布通过 npm Trusted Publishing(OIDC,无需 npm token;附带来源证明)推送到 npm,流程由 .github/workflows/publish.yml 执行。更新 package.json 中的 version,将 CHANGELOG.md 里的 [Unreleased] 说明移至新版本下,然后推送并创建带有 v<version> 标签的 GitHub Release;工作流会检查标签是否与 package.json 一致,运行类型检查和测试,然后构建并发布。
许可证
MIT。PageIndex 也采用 MIT 许可证;MarkIndex 不含任何 PageIndex 代码,但移植了其树成本模型,并改编了其 Agent 工具描述、指令和提示词,在此致谢——版权及许可证声明请参阅 THIRD_PARTY_NOTICES.md。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。