关于 MIMRY
MIMRY 是本地命令行工具和 MCP 服务,帮助编码 Agent 找到任务相关的文件与代码行。它无需 LLM 即可构建确定性的仓库索引,并将索引保存在本机。
主要功能
- 01按任务描述排列文件
- 02定位相关代码行范围
- 03构建符号与依赖图
- 04索引代码和文档
- 05本地增量索引
适用场景
- 01修改前查找待检查代码
- 02缩小 Agent 所需的仓库上下文
- 03定位相关定义与调用方
MCP 相关
其 MCP 服务将 MIMRY 的查找功能作为工具提供给 Agent 和 MCP 客户端。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
9收录的工具列表 · 更新于 1 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| root | any | 否 | |
| verify | boolean | 否 |
详细介绍

找出编码任务会涉及的文件,让你的 Agent 少读一些内容。
在脚本化检索基准测试中,找到任务需要修改的代码所需的令牌减少了 71%。


如果 MIMRY 帮你的 Agent 节省了令牌,请给它点个星标。
MIMRY 是一款命令行工具,可告知 AI 编码 Agent,为完成某项任务需要读取哪些文件以及文件中的哪些行。 它会将代码仓库解析为符号和依赖关系图,在你的机器上保存索引,并根据用日常语言描述的任务为相关文件排序。 索引具有确定性:在 Windows、Linux 和 macOS 上,相同的代码会生成相同的依赖关系图、排序结果和上下文包,而且构建索引时不会用到大模型。 Agent 可通过 shell 或 MIMRY MCP 服务调用它。
安装
uv tool install mimry
需要在 Windows、Linux 或 macOS 上使用 Python 3.11 或更高版本。
pipx install mimry 也可以使用。
在禁止使用系统 pip 的发行版上,请参阅不使用 uv。
首次建立索引时,会下载所需的 tree-sitter 语法文件;每位用户只需下载一次,并会将其保存在缓存中。
说明
如需升级,请运行
mimry upgrade。 在 Windows 上,如果 MIMRY 服务正在运行,mimry upgrade会拒绝执行;运行mimry upgrade --stop-servers可先停止这些服务。
不使用 uv
推荐使用 uv 安装 MIMRY,但并非必需。 MIMRY 需要在独立环境中使用 Python 3.11 或更高版本。 pipx 和 venv 使用 PATH 中的 Python 3,该版本必须为 3.11 或更高版本。
- pipx: 在 Arch 上使用
sudo pacman -S python-pipx安装 pipx;在 Debian 和 Ubuntu 上使用sudo apt install pipx安装,然后运行pipx install mimry。 - 普通虚拟环境: 在 Debian 和 Ubuntu 上,先使用
sudo apt install python3-venv安装python3-venv。 运行python3 -m venv ~/.local/share/mimry-venv,然后运行~/.local/share/mimry-venv/bin/pip install mimry。 使用mkdir -p ~/.local/bin,然后运行ln -s ~/.local/share/mimry-venv/bin/mimry ~/.local/bin/mimry,将命令添加到 PATH。
在禁止使用系统 pip 的发行版上,直接运行 pip install mimry 会失败,并显示 externally-managed-environment。
这类发行版包括 Arch、CachyOS、Debian 12 及更高版本,以及 Ubuntu 23.04 及更高版本,因此需要使用上述其中一种方法。
请勿使用 --break-system-packages。
在 Arch 上,sudo pacman -S uv 也可以使用。
AUR 软件包即将推出,详情请见 #64。
mimry upgrade 使用与安装 MIMRY 时相同的工具,因此请以相同方式运行它。
Docker
镜像 ghcr.io/jbacalso24/mimry 已内置所有 tree-sitter 语法,因此索引时无需联网。
标签包括 latest、完整版本号(如 1.2.3)和次版本系列(如 1.2)。
将你的仓库挂载到 /repo,并将索引保存在名为 /cache 的卷中。
如果不使用该卷,每个容器启动时都会没有索引。
在 Linux 上,添加 --user "$(id -u):$(id -g)",这样 MIMRY 在仓库中写入的 .mimry/ 文件夹就归你所有。
docker run --rm -v "$PWD:/repo" -v mimry-cache:/cache ghcr.io/jbacalso24/mimry init
docker run --rm -v "$PWD:/repo" -v mimry-cache:/cache ghcr.io/jbacalso24/mimry index
docker run --rm -v "$PWD:/repo" -v mimry-cache:/cache ghcr.io/jbacalso24/mimry find "<query>"
对于 Agent,使用相同的挂载,通过 stdio 运行 MCP 服务:
docker run -i --rm -v "$PWD:/repo" -v mimry-cache:/cache ghcr.io/jbacalso24/mimry mcp
在 MCP 客户端配置中,使用仓库的绝对路径,因为 $PWD 不会在那里展开:
{
  "mcpServers": {
    "mimry": {
      "command": "docker",
      "args": ["run", "-i", "--rm", "-v", "/absolute/path/to/repo:/repo", "-v", "mimry-cache:/cache", "ghcr.io/jbacalso24/mimry", "mcp"]
    }
  }
}
Claude Code 插件
在 Claude Code 中,该插件只需一步即可为 Agent 提供 MIMRY 技能、钩子和 MCP 服务。
你只需要确保 PATH 中有 uv。
/plugin marketplace add jbacalso24/mimry
/plugin install mimry@mimry
它会取代 mimry install --platform claude-code,因此二者选其一即可。
其他 Agent:npx skills
它只会安装技能;要使用 MCP 服务和钩子,请运行 mimry install --platform <name>(参见支持的 Agent)。
npx skills add jbacalso24/mimry
嵌入(可选)
find 还可以按含义匹配,因此,即使任务用不同的措辞描述某种行为,也能找到以其他名称命名它的文件。
安装额外组件并下载模型前,此功能处于关闭状态:
uv tool install "mimry[embed]"
mimry embed download
mimry embed download 会从 Hugging Face 下载一个 64 MB、采用 MIT 许可证的模型(minishlab/potion-code-16M),并进行校验,然后将其保存在 MIMRY 的缓存中。此操作只需执行一次。
此后,每次搜索都会在本地运行,不会发起网络请求。
该功能适用于较长的任务描述(包含 20 个或更多不同的词),使 SWE-bench Verified Acc@10 从 81.4% 提升到 83.2%;短查询的排名则保持不变。
设置 MIMRY_EMBED=0 可关闭此信号,运行 mimry embed status 可查看它是否已就绪。
快速开始
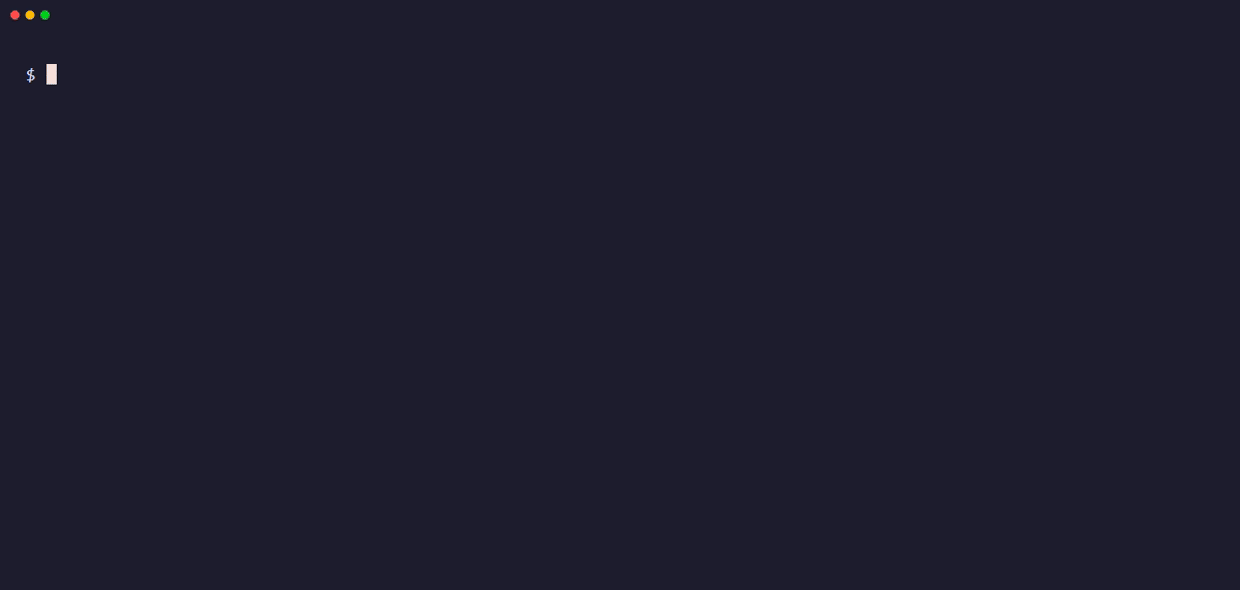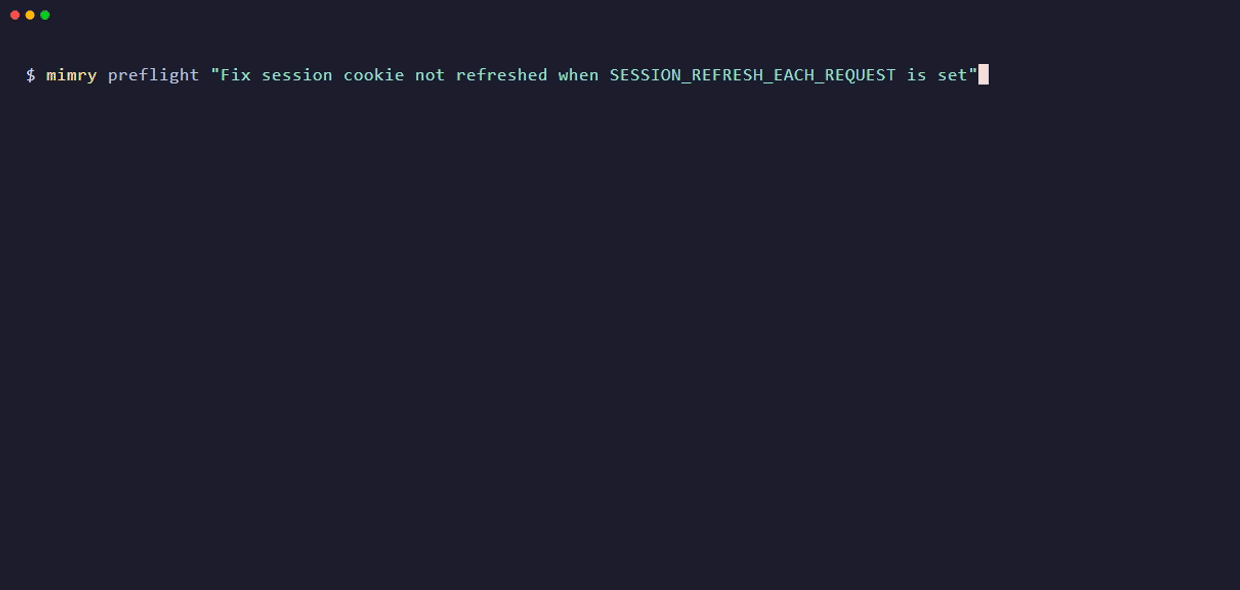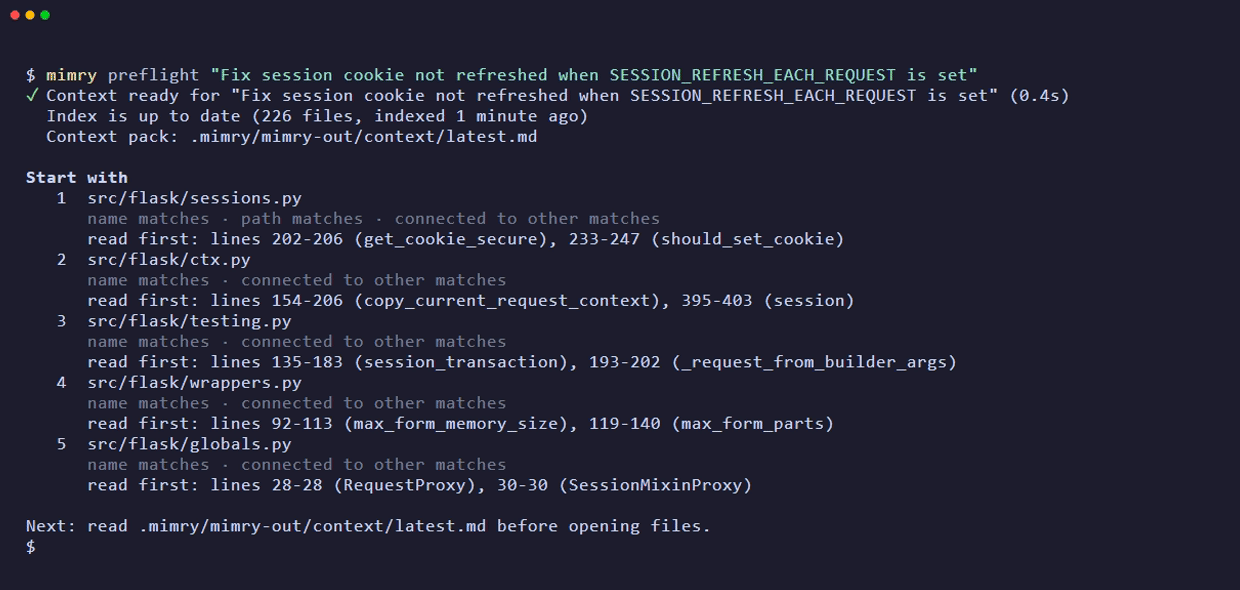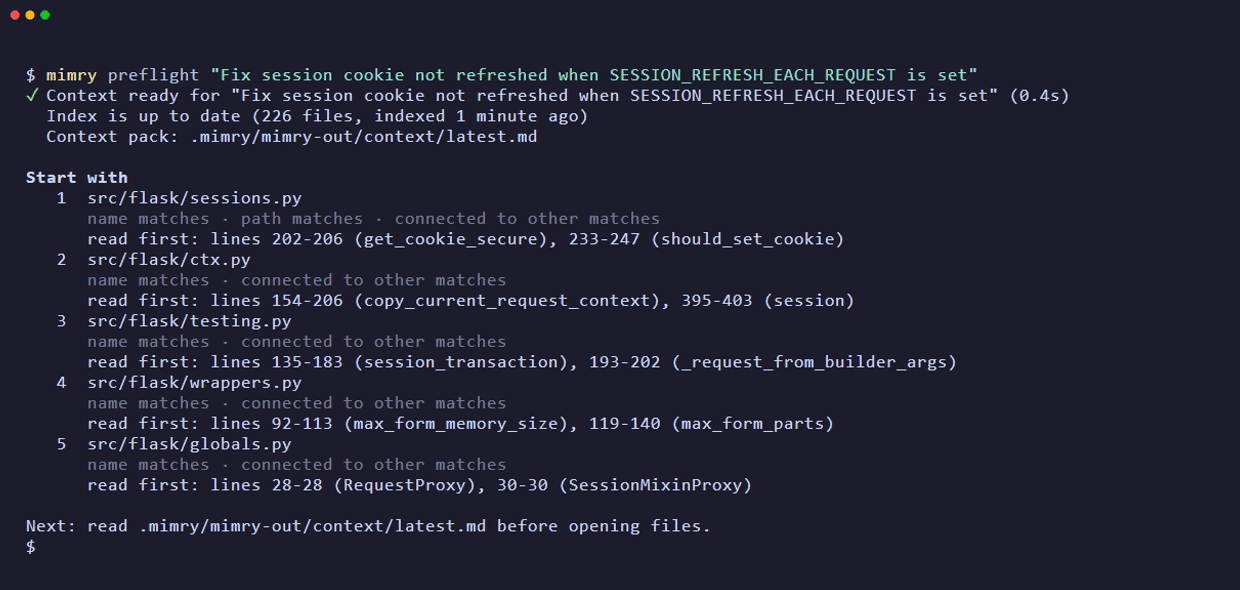
在仓库中运行 mimry preflight 并提供任务描述。
首次运行时会构建索引。
mimry preflight "Fix session cookie not refreshed when SESSION_REFRESH_EACH_REQUEST is set"
Flask 仓库中的输出:
Start with
   1  src/flask/sessions.py
      name matches · path matches · connected to other matches
      read first: lines 202-206 (get_cookie_secure), 233-247 (should_set_cookie)
   2  src/flask/ctx.py
      name matches · connected to other matches
      read first: lines 154-206 (copy_current_request_context), 395-403 (session)
   3  src/flask/testing.py
      name matches · connected to other matches
      read first: lines 135-183 (session_transaction), 193-202 (_request_from_builder_args)
同样的结果也会写入 .mimry/mimry-out/context/latest.md,作为 Agent 的上下文包,其中包含匹配的符号、相关文件和项目的测试命令。
要让 Agent 自动使用 MIMRY,请为该 Agent 安装 MIMRY:
mimry install --platform claude-code
提示
添加
--always-on --hooks,让 Agent 无需提示就会使用 MIMRY:--always-on会将规则添加到 Agent 总是读取的文件中;--hooks则会在 Agent 开始对仓库进行广泛搜索时建议使用mimry find(每个会话最多三次),在 grep 搜索已知符号时返回其定义和调用方,并在 Agent 完整读取大型文件时生成概要。会话开始和每次文件编辑后,钩子还会在后台刷新索引;上下文压缩后,也会恢复 Agent 正在处理的文件。
为每项任务指定文件(选择启用)
--prompt-hook 会在 Claude Code 中与 --hooks 一起添加提示词钩子。
提交任务时,该钩子会根据索引为任务排名,并添加一条简短说明,列出 MIMRY 排名靠前的文件及要阅读的行。
该说明不超过 800 个字符;对于斜杠命令、少于五个词的提示词、不提及代码的聊天提示词、同一会话中重复的提示词、索引文件超过 3000 个的仓库或图谱超过 8 MB 的仓库,钩子不会输出内容。
提示词中包含标识符、源文件名或出现在索引文件路径中的词时,即视为提及代码。
除非添加该选项,否则此功能处于关闭状态:
mimry install --platform claude-code --project --hooks --prompt-hook
在小型仓库中,每次提示词会增加约半秒耗时,其中大部分用于加载搜索代码。
在 Claude Code 启动时的环境中设置 MIMRY_PROMPT_HOOK=0,即可关闭此功能,而无需移除它。
再次运行 mimry install --platform claude-code --project --hooks 且不带 --prompt-hook,即可将其移除。
安装 --hooks 还会添加一个 Stop 钩子。
一轮对话结束时,它会关闭该轮的反馈窗口并写入会话反馈,因此记录不必等到你下次运行命令才保存。
查看 MIMRY 节省的 tokens
mimry stats 会显示 MIMRY 在本次会话和整个仓库中节省的 tokens。
它会将对 MIMRY 在会话中提及的文件进行范围读取(带有 offset 或 limit 的读取)时,计为该文件剩余部分的 tokens。
钩子从索引中找到的搜索结果计为一次搜索,不计为 tokens。
tokens 按字符数 / 4 估算,因此每个数字都是近似值,并非精确值。
如要在 Claude Code 的状态栏中显示本次会话的总计,请在 Claude Code 设置中添加以下内容:
{"statusLine": {"type": "command", "command": "mimry stats --statusline"}}
功能
| 功能 | 说明 |
|---|---|
| 排序查找 | 根据名称、路径、内容、符号和图匹配为文件排序,并说明每个文件排名靠前的原因 |
| 行范围 | 指出每个文件中应优先读取的函数、类或章节 |
| 代码图 | 使用 tree-sitter 解析 41 种语言:代码的符号、导入、调用和继承,以及标记、样式和数据文件中供 Agent 搜索的名称 |
| 确定性 | 相同代码在任何机器上都会生成相同的符号、图、排名和上下文包;CI 会使用已提交的黄金值检查每次更改(方法) |
| 文档 | 与代码一起索引 Markdown、文本、PDF、Word、Excel 和 PowerPoint 文件 |
| 增量索引 | 只重新读取更改过的文件,并在主要查找结果返回前刷新索引 |
| 反馈 | 对于类似任务,将记录为有用的文件排得更靠前 |
| MCP 服务 | 将每项查找都作为 MCP 工具公开 |
| 本地运行 | 无需大模型、API 密钥或遥测,代码也会保留在你的机器上 |
支持的语言
MIMRY 使用 tree-sitter 解析以下语言。 编程语言提供符号、导入、调用和继承;标记、样式和数据格式则提供 Agent 搜索时使用的名称,详见下表之后的说明。
| 语言 | 扩展名 |
|---|---|
| Python | .py |
| JavaScript | .cjs、.js、.jsx、.mjs |
| TypeScript | .cts、.mts、.ts、.tsx |
| Go | .go |
| Rust | .rs |
| C# | .cs |
| Java | .java |
| PHP | .php |
| C | .c、.h |
| C++ | .cc、.cpp、.cxx、.hh、.hpp、.hxx |
| Ruby | .rb |
| Kotlin | .kt、.kts |
| Scala | .sc、.scala |
| Groovy | .gradle、.groovy、.gvy |
| Swift | .swift |
| Bash | .bash、.sh |
| PowerShell | .ps1、.psm1 |
| Lua | .lua |
| Perl | .pl、.pm |
| Dart | .dart |
| Objective-C | .m |
| Zig | .zig |
| Elixir | .ex、.exs |
| Haskell | .hs |
| OCaml | .ml、.mli |
| R | .r |
| Julia | .jl |
| Solidity | .sol |
| Fortran | .f03、.f08、.f90、.f95 |
| Pascal | .dpr、.lpr、.pas、.pp |
| CSS | .css |
| SCSS | .scss |
| HTML | .htm、.html |
| Vue | .vue |
| Svelte | .svelte |
| SQL | .sql |
| JSON | .json、.jsonc |
| YAML | .yaml、.yml |
| TOML | .toml |
| XML | .csproj、.fsproj、.nuspec、.plist、.props、.resx、.targets、.vbproj、.xaml、.xml、.xsd |
| Terraform (HCL) | .hcl、.tf、.tfvars |
Fortran 仅按自由格式读取。固定格式的 .f 和 .for 文件无法使用 MIMRY 所用的语法解析,因此不会生成符号或边。
.pp 和 .m 文件会优先检查,因为大多数 .pp 文件都是 Puppet 文件,大多数 .m 文件都是 MATLAB 文件。
只有包含 unit、program 或 library 行的 .pp 文件才会被视为 Pascal;只有包含 @interface、@implementation、@protocol 或 #import 行的 .m 文件才会被视为 Objective-C。
其他 .pp 或 .m 文件都会作为可搜索文本编入索引,不生成符号。
标记和样式语言会提供 Agent 搜索时使用的内容。
CSS 和 SCSS 会提供类选择器和 id 选择器、自定义属性、关键帧、Sass mixin、函数、占位符和变量,并将 @import、@use 和 @forward 作为导入。
HTML 会提供每个元素的 id,以及它加载的本地样式表和脚本。
Vue 和 Svelte 会提供每个组件(以其文件名命名),并对其 <script> 和 <style> 块执行 JavaScript 或 TypeScript、以及 CSS 或 SCSS 的处理流程,因此行号与文件中的行号一致。
MIMRY 还会为 Markdown(标题、链接、frontmatter)、纯文本、PDF、Word、Excel 和 PowerPoint 文件建立索引。结果会指出匹配的页面、章节、工作表或幻灯片。
有些文件除了文本内容,还会提取更多结构信息:
- SQL:
.sql文件会提供其中的架构对象及其涉及的表,见下文。Python 字符串字面量会保留其中的CREATE TABLE名称,Alembic 迁移会保留其修订沿袭关系。 - Groovy 和 Gradle:
.groovy、.gradle和.gvy文件会提供其中的类、接口、trait、枚举、方法和函数,以及 Gradle 构建中的task条目,见下文。 - 清单文件:
package.json、pyproject.toml、tsconfig.json、vite.config.*、next.config.*、app.json、app.config.*、.env.example、CLAUDE.md、AGENTS.md和README.md会提供其中的命令、框架、入口点和环境变量名称,但绝不包含变量值。
数据格式会以 Agent 查找时使用的名称建立索引。
JSON、YAML 和 TOML 会提取到第二层的键,并按路径命名,例如 services.web 或 tool.ruff.line-length;TOML 还会提取每个表头。
作为 Kubernetes 对象的 YAML 文档还会提供 <kind>/<name> 资源,例如 Deployment/web。
XML 会提取每个带有 id 或 name 属性的元素;Maven pom.xml 会提供其 groupId:artifactId。
MSBuild 项目文件和 props 文件会提取每个 PropertyGroup 中的属性及每个 Target 名称,并将每个 ProjectReference 作为导入项;plist 会提取其顶层 dict 的键,XAML 则会提取每个 x:Name 和 x:Key。
Terraform 会按引用名称提取每个 resource、data、module、variable、output、provider 和 locals 条目,例如 aws_s3_bucket.b、data.aws_iam_policy_document.p、module.bucket、var.region 和 local.name。
var.region 引用会找到同一文件夹中的变量,模块的本地 source 会链接到其文件夹。
值不会作为符号,因此,存储为值的机密绝不会被索引。
锁定文件和超过 256 KiB 的文件不会提取符号;清单文件则使用上文所述的专用适配器。
每个数据文件也会作为文本建立索引,因此 mimry find 可以匹配其内容。
SQL 文件会按源文件中的写法为每个架构对象命名,例如 public.users:表、视图、物化视图、索引、序列、架构和类型,以及函数、过程和触发器。
读取或写入表的视图、函数、触发器或索引会与该表建立调用边;外键的 REFERENCES 目标也会建立调用边。
普通查询或 ALTER TABLE 不属于任何对象,因此不会添加边。
解析器无法识别的语句只会影响自身,周围的对象仍会保留。
使用 BEGIN ... END 主体编写的触发器会提供其名称和表,但不会读取其主体。
超过 256 KiB 的文件不会提取符号,因此大型转储仍可通过文本搜索。
Groovy 和 Gradle 文件会按源文件中的写法为每个类、接口、trait、枚举、方法和顶层 def 函数命名。
Spock 特性方法会保留其字符串作为名称,例如 adds two numbers。
Gradle 的 task name 或 tasks.register("name") 会提供一个 task;plugins {} 和 dependencies {} 条目不会作为符号。
Groovy 类的 import 会精确链接到声明该类的文件;诸如 a.b.* 的通配符导入会链接到包 a.b 中的每个文件。
诸如 import static a.b.C.* 的静态通配符导入会链接到类 C 的文件。
方法主体中的调用,以及类型的 extends 和 implements 子句,会生成调用边和继承边;无括号的 name arg 调用仅在其属于同一文件中的方法时才计入。
解析器无法读取的文件片段只会影响自身,因此带注解的类型(例如 @Service(Book))仍会保留其方法。
闭包赋值字段和 << 等运算符方法不会作为符号。
其他扩展名可以映射到 mimry.toml 中受支持的语言,见配置。
支持的 Agent
mimry install --platform <name> 会安装一项技能,教 Agent 何时使用 MIMRY,并在 Agent 支持的情况下注册 MCP 服务。
| Agent | 平台名称 | 技能 | MCP 服务 |
|---|---|---|---|
| Claude Code | claude-code | ✅ | ✅ |
| Codex | codex | ✅ | ✅ |
| GitHub Copilot CLI | copilot | ✅ | ✅ |
| VS Code 中的 GitHub Copilot | vscode | ✅ | ✅ |
| Gemini CLI | gemini | ✅ | ✅ |
| OpenCode | opencode | ✅ | ✅ |
| Kiro | kiro | ✅ | ✅ |
| Cursor | cursor | ✅ | ✅ |
| Amp | amp | ✅ | ✅ |
| Devin | devin | ✅ | ✅ |
| Factory Droid | droid | ✅ | ✅ |
| Kimi | kimi | ✅ | ✅ |
| Kilo Code | kilo | ✅ | 手动设置 |
| Antigravity、CodeBuddy、Hermes、OpenClaw、Trae | 参见 mimry install --list-platforms | ✅ | 手动设置 |
| Trae CN | trae-cn | ✅ | 手动设置 |
| Aider、Pi Agent | 参见 mimry install --list-platforms | ✅ | 无 |
| Agent Skills | agents | ✅ | 无 |
| Windsurf | windsurf | ✅ | 手动设置 |
| Cline | cline | ✅ | 手动设置 |
| Roo Code | roo | ✅ | 手动设置 |
| Zed | zed | ✅ | ✅;如果设置文件包含注释,则会打印配置供粘贴 |
| JetBrains Junie | junie | ✅ | ✅ |
| Grok Build | grok | ✅ | 暂不支持 |
✅ 表示 mimry install 会完成设置;手动设置表示需要自行添加 MCP 服务。
无表示该 Agent 不支持 MCP,因此仅靠技能即可满足需求。
暂不支持表示 mimry install 目前还不会为该 Agent 注册 MCP 服务。
请参阅 docs/agents.md,了解各 Agent 的文件存放位置,以及 MCP 服务的注册方式。
| 选项 | 说明 |
|---|---|
--project | 仅安装到当前仓库,而不是为每个仓库都安装 |
--always-on | 在 Agent 每次都会读取的文件(例如 AGENTS.md)中添加一段简短规则 |
--hooks | 当 Agent 开始广泛搜索仓库时,建议使用 mimry find,每个会话最多三次;当 Agent 搜索已知符号时,返回其定义和调用方;当 Agent 完整读取大型文件时,概述该文件;在查找后记录其读取和编辑的文件作为反馈(设置 MIMRY_SESSION_FEEDBACK=0 可关闭此功能);并在会话开始和每次文件编辑后于后台刷新索引。在 Claude Code 中,还会在上下文压缩后恢复其正在处理的文件,并在每轮结束时关闭该轮的反馈窗口(Stop hook)。对于 Codex,项目钩子会在你通过 /hooks 信任它们后运行。 |
--prompt-hook | 在 Claude Code 中与 --hooks 搭配使用时,还会在每个已提交任务的说明中列出 MIMRY 排名靠前的文件;说明长度少于 800 个字符(可选启用;设置 MIMRY_PROMPT_HOOK=0 可关闭此功能)。 |
--no-mcp | 安装技能,但不注册 MCP 服务 |
--no-global-gitignore | 不将 .mimry/ 添加到 Git 的全局忽略文件中 |
MCP 服务手动设置
claude mcp add --scope user mimry -- mimry-mcp   # Claude Code
codex mcp add mimry -- mimry-mcp                 # Codex
其他 MCP 客户端:
{
  "mcpServers": {
    "mimry": { "command": "mimry-mcp" }
  }
}
uvx mimry mcp 无需安装即可运行该服务。
默认情况下,该服务会列出 9 个核心工具:mimry_status、mimry_preflight、mimry_find、mimry_related、mimry_symbol、mimry_path、mimry_impact、mimry_why 和 mimry_feedback。
其他工具默认关闭,以保持工具列表精简;如需使用,请通过 CLI 调用,除非你明确要求启用它们。
在服务的环境中设置 MIMRY_MCP_TOOLS=all 可列出全部 24 个工具;也可以提供逗号分隔的工具名称列表,例如 MIMRY_MCP_TOOLS=mimry_find,mimry_path。
不对应工具的命令(例如 mimry callers、mimry callees、mimry bench、mimry doctor、mimry report 和 mimry install)仅支持 CLI。
名称无法识别时,会向 stderr 打印一行信息,并回退到核心工具。
MIMRY 已在 MCP Registry 中登记,名称为 io.github.jbacalso24/mimry。
mimry preflight "<task>"            # list the files and lines to read first, and write a context pack
mimry find "<query>"                # rank files for a query
mimry symbol <name>                 # find where a function, class or heading is defined
mimry callers <name>                # list the functions that call a function, from the graph
mimry callees <name>                # list the functions a function calls, from the graph
mimry related "<query>"             # list files connected through imports and calls
mimry explain "<task>"              # show the key files and symbols, and how they connect
mimry why <file> --query "<task>"   # explain why a file ranked
mimry feedback ...                  # record which files helped
mimry status                        # check whether the index is current
mimry doctor                        # diagnose the install and the index
所有命令和选项请参阅 docs/commands.md。 遇到异常时,请参阅 docs/troubleshooting.md。
配置
仓库根目录中的 mimry.toml 用于控制要索引的文件。
请将其提交,以便团队中的每个人都使用相同的索引。
[index]
include = ["src/**", "docs/**"]            # index only these paths
exclude = ["**/fixtures/**", "legacy/**"]  # never index these paths
max_file_bytes = 2_000_000                 # size limit per file (default 1 MB)

[index.languages]
".inc" = "php"                             # parse .inc files as PHP
".h" = "cpp"                               # parse .h headers as C++ instead of C
MIMRY 始终会跳过任何深度下名为 build、bin、obj、dist、target、node_modules 和 vendor 的文件夹,以及缓存和虚拟环境。
include 不会将这些文件夹重新纳入索引,因此 build/ 中的 MSBuild 项目和 props 文件(例如 build/Common.props)不会获得符号。
基准测试
这些数据来自脚本化检索基准测试,并非完整的 Agent 会话。
两个脚本化 Agent 会获得相同的任务文本和 10 次文件读取预算:一个从 mimry preflight 开始,另一个从 grep 开始。
两者都遵循固定规则,基准测试会统计它读完拉取请求中所有变更文件之前读取的 token 数量。
由模型驱动的 Agent 会以不同方式选择读取内容,因此这些数据衡量的是检索效果,不代表你在自己的会话中一定能节省这么多。
在 6 个开源项目的 44 个已合并拉取请求上使用 MIMRY 0.8.4 进行测量,并在每次发布时对这组数据重新运行:
| Agent 读取文件的方式 | 使用 MIMRY 节省的 token | 定位到的任务数,MIMRY / grep |
|---|---|---|
| 首先由 MIMRY 指定的行范围 | 71.2% | 32 / 28 |
| 整个文件 | 50.8% | 33 / 28 |
grep -n,然后读取每个匹配项前后各 100 行 | 48.6% | 31 / 27 |
有关测试方法、各项目结果和复现步骤,请参阅 benchmarks/tokens。
在 SWE-bench Verified 的 500 个问题上,对问题文本运行一次 mimry find,即可将修复所变更的所有文件排在前 10 位(占 81.4% 的问题)、前 5 位(占 71.8%),或排在首位(占 44.8%)。
使用可选的嵌入后,这些比例分别为 83.2%、75.6% 和 48.0%。
有关协议和各仓库的结果,请参阅 benchmarks/localization。
要在自己的仓库的已合并拉取请求上测量 MIMRY,请运行 mimry bench;请参阅对仓库进行基准测试。
一项任务,从头到尾
这是 holdout2 运行中的任务 fastapi/typer#1820,以下是脚本化 Agent 读取到的任务内容:“使用 xdg-open 启动 URL 时遵循 wait=False”。
修复变更了 typer/main.py。
该任务节省了 75.3%,这是此次运行中的中位数,因此属于典型任务,而非最佳结果。
不使用 MIMRY
Agent 对 respect、wait、false、launching、urls、xdg 和 open 运行了 7 次关键词搜索,耗费 1,927 个 token。
接着,它从头开始读取 typer/main.py,每次读取最多为基准测试设定的 2,000 行限制,耗费 13,491 个 token。
总计:15,418 个 token。
使用 MIMRY
mimry preflight "Respect wait=False when launching URLs with xdg-open" 耗费 1,876 个 token。
随后,Agent 按上下文包中的顺序读取 6 个行范围,耗费 1,937 个 token:
| 文件 | 读取的行 | Token 数 |
|---|---|---|
tests/test_launch.py | 44-52, 119-134 | 184 |
docs_src/launch/tutorial001_py310.py | 6-9 | 28 |
docs_src/launch/tutorial002_py310.py | 10-20 | 105 |
typer/_click/utils.py | 111-136, 333-368 | 536 |
typer/_click/_termui_impl.py | 306-309, 345-414 | 476 |
typer/main.py(修复变更的文件) | 1474-1482, 1932-2009 | 608 |
总计:3,813 个 token。
MIMRY 打开了 6 个文件,而非 1 个文件,但仍少读了 75.3% 的 token:3,813 对比 15,418。
这些数据来自 results.holdout2.ranges.0.4.1.json,是在 token 基准测试运行 38884765315 中使用 MIMRY 0.4.1 测得的。
要复现这些结果,请参阅运行方法。
工作原理
- 索引。 MIMRY 会将每个文件解析为符号,以及表示导入、调用和继承关系的边,并将索引存储在仓库之外的用户缓存目录中。
- 排序。 MIMRY 会根据文件名、路径、内容、符号和图谱来匹配任务;对于无法解析的导入项,则直接舍弃,不会猜测。
- 刷新。 与 Git 类似,MIMRY 会比较文件元数据,并且只重新读取发生变化的文件。
详情请参阅 docs/how-it-works.md。
隐私
索引和搜索均在本地运行。
凭据文件会被跳过。
在代码文件中,如果看起来像秘密的值出现在赋值语句(例如 password = "..." 或 cfg["password"] = "...")、比较语句(例如 if token == "...")、注释或 URL 的密码或凭据查询参数中,则会在该值进入索引前将其隐藏。
如果无法妥善隐藏文件中的秘密内容,则会跳过该文件。
反馈文本也会经过隐藏处理。
.gitignore 中列出的未跟踪文件不会被索引。
贡献
欢迎提交错误报告和拉取请求。 设置和检查方法请参阅 CONTRIBUTING.md。 MIMRY 目前处于公开 Alpha 阶段,其接口在 1.0 版本发布前可能会发生变化。
感谢所有贡献者:
许可证
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。