关于 yandex-search
这是一个 Yandex 搜索抓取工具,可按需返回自然搜索结果、广告、知识图谱卡片、图片和视频等结构化数据。它支持本地化设置、地区定位和时间筛选,适用于搜索与 SEO 工作流。
主要功能
- 01提取指定类型的搜索结果
- 02按域名、语言和地区定位
- 03按相关性或日期排序
- 04按时间范围筛选
- 05控制安全搜索和拼写纠正
- 06并行获取多个页面
适用场景
- 01研究地区市场的搜索结果
- 02监测品牌和竞争对手
- 03查看某主题的近期结果
- 04收集指定广告或图片结果
MCP 相关
它通过 Apify MCP 服务将 Yandex Search API 作为 MCP 工具提供。客户端可使用 OAuth 或 Apify API 令牌认证。
配置
远程服务无需本地安装。选择你使用的客户端,复制配置或使用一键安装。
https://mcp.apify.com/?tools=johnvc/Scrape-Yandexclaude mcp add --transport http johnisanerd-yandex-search https://mcp.apify.com/?tools=johnvc/Scrape-Yandex{"mcpServers":{"johnisanerd-yandex-search":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/Scrape-Yandex"}}}在 Cursor 中打开{"servers":{"johnisanerd-yandex-search":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/Scrape-Yandex"}}}在 VS Code 中打开{"mcpServers":{"johnisanerd-yandex-search":{"type":"http","url":"https://mcp.apify.com/?tools=johnvc/Scrape-Yandex"}}}{"mcpServers":{"johnisanerd-yandex-search":{"serverUrl":"https://mcp.apify.com/?tools=johnvc/Scrape-Yandex"}}}命令在终端中运行;JSON 粘贴到对应客户端的 MCP 配置后重启。需要授权的服务会在首次连接时提示登录。
工具
详细介绍
English | Русский
🔎 Yandex API:以清晰的 JSON 返回结构化 Yandex 搜索结果
使用 Yandex API 最高效、可靠且对开发者最友好的方式。
Actor 页面: apify.com/johnvc/Scrape-Yandex 输入架构: apify.com/johnvc/Scrape-Yandex/input-schema
Yandex API 会根据任意查询执行 Yandex 搜索,并返回清晰、结构化的 JSON。你可以按需选择结果类型(自然搜索结果、付费广告、知识图谱实体卡片、内嵌图片面板、内嵌视频面板);每种选定的类型都会作为独立条目返回,并带有 item_type 标签和每页元数据。它支持 6 个 Yandex 域名、19 种语言,以及覆盖 123,000 多个地点的区域定位,还支持排序/时效筛选和快速并行分页。
视频演示
快速开始
前提条件
- Python 3.11 或更高版本
- Apify 账户和 API 密钥(在此获取免费密钥)
-
克隆代码库
git clone https://github.com/johnisanerd/Apify-Yandex-Search-Scraper.git cd Apify-Yandex-Search-Scraper -
使用 UV 安装依赖项
# Install UV if you do not have it: curl -LsSf https://astral.sh/uv/install.sh | sh # Install project dependencies: uv sync -
配置 API 密钥
cp .env.example .env # Edit .env and add your Apify API key # Get your free API key at: https://apify.com?fpr=9n7kx3 -
运行示例
uv run python yandex-scraper.py
替代方式:直接设置 API 密钥
export APIFY_API_TOKEN="your_api_key_here"
uv run python yandex-scraper.py
为什么使用这个 Yandex API?
完整覆盖搜索结果页。 一次调用即可将整个 Yandex 搜索结果页作为结构化数据返回:自然搜索结果、付费广告、知识图谱实体卡片、内嵌图片面板和内嵌视频面板。你可以获取整个页面,而不仅仅是自然搜索链接。
专为俄语地区和独联体市场打造。 可定位 6 个 Yandex 域名(yandex.com、yandex.ru、yandex.by、yandex.kz、yandex.uz、yandex.com.tr)、19 种语言,以及 123,000 多个区域 ID 中的任意一个。这让它适用于俄罗斯、东欧、中亚及其他地区的 SEO、竞争情报和品牌监测。
费用可预测,按使用量付费。 费用按运行次数和处理页数计算,无月租费。你只需为实际执行的搜索付费,还可以通过页面数量上限直接控制成本。
清晰、一致的 JSON。 每一页都是结构相同的结构化数据集条目,因此只需解析一次结果,即可在不同查询、域名和语言间重复使用代码。
易于自动化。 只需几行 Python 代码即可调用,也可以将其加载为 MCP 工具,让 Claude 和 Cursor 等助手按需为你执行 Yandex 搜索。
功能
核心能力
- 关键词搜索:在 Yandex 上搜索并完整提取搜索结果页
- 按需选择结果类型:可分别启用或停用自然搜索结果、广告、知识图谱、内嵌图片和内嵌视频;每种选定的类型都会作为带有
item_type标签的独立条目返回 - 域名本地化:支持 6 个 Yandex 域名
- 语言定位:支持 19 种语言
- 区域定位:支持 123,000 多个地点 ID(
lr参数) - 排序和时效筛选:支持
sort_mode(按相关性或日期)和period(全部、一天、最近两周、一个月) - 安全搜索和拼写纠正控制,以及快速并行多页分页
数据质量
- 结构化自然搜索结果:包含标题、链接、摘要、排名、显示链接、日期和附加链接
- 丰富的结果区块:广告、知识图谱、内嵌图片、内嵌视频,均包含
result_count - 每页元数据:包含域名、语言、地区和分页详情
- 每次查询的 JSON 结构一致
- 按页计费:让大型搜索的费用保持透明
使用示例
基础示例
针对一个关键词进行单页搜索。这是体验 API 最便宜的方式。
{
  "text": "machine learning",
  "yandex_domain": "yandex.com",
  "max_pages": 1
}
高级示例
使用俄语域名和俄语语言进行搜索,设置区域 ID、增加每页结果数,并搜索两页。
{
  "text": "машинное обучение",
  "yandex_domain": "yandex.ru",
  "lang": "ru",
  "lr": 225,
  "groups_on_page": 20,
  "family_mode": 1,
  "max_pages": 2
}
按需选择:收集广告和知识图谱
只启用你想要的结果类型。这里关闭了自然搜索结果,只返回广告和知识图谱,每种类型各自作为一条数据项。
{
  "text": "best running shoes",
  "include_organic_results": false,
  "include_ads": true,
  "include_knowledge_graph": true,
  "max_pages": 1
}
最新结果:按日期排序,限定最近两周
使用 sort_mode 和 period 筛选近期内容。它们适用于每种已选的结果类型。
{
  "text": "ai news",
  "yandex_domain": "yandex.ru",
  "lang": "ru",
  "sort_mode": "date",
  "period": "last_two_weeks",
  "max_pages": 1
}
输入参数
| 参数 | 类型 | 必填 | 默认值 | 描述 |
|---|---|---|---|---|
text | string | 是 | - | 搜索查询。支持 Yandex 运算符,例如 site:wikipedia.org python。 |
include_organic_results | boolean | 否 | true | 返回自然搜索结果(item_type 为 organic)。 |
include_ads | boolean | 否 | false | 存在付费广告时返回广告(item_type 为 ads)。 |
include_knowledge_graph | boolean | 否 | false | 存在知识图谱卡片时返回该卡片(item_type 为 knowledge_graph)。 |
include_inline_images | boolean | 否 | false | 返回内嵌图片条(item_type 为 inline_images)。 |
include_inline_videos | boolean | 否 | false | 返回内嵌视频轮播(item_type 为 inline_videos)。 |
yandex_domain | string | 否 | yandex.com | Yandex 域名,例如 yandex.ru、yandex.com.tr、yandex.kz(支持 6 个域名)。 |
lang | string | 否 | en | 语言代码,例如 ru、en、tr、de(支持 19 种语言);未指定时为 null。 |
lr | integer | 否 | (域名默认值) | 地区 ID,例如 225 = 俄罗斯,84 = 美国,149 = 白俄罗斯。共有 123,000 多个 ID;完整列表请参阅 Actor 页面。 |
max_pages | integer | 否 | 2 | 要获取的最大页数(0 = 不限)。适用于每种已选的结果类型。 |
sort_mode | string | 否 | relevance | 结果排序方式:relevance 或 date(最新优先)。 |
period | string | 否 | all | 时间范围:all、day、last_two_weeks、month。 |
groups_on_page | integer | 否 | 10 | 每页结果数(1 至 20)。 |
family_mode | integer | 否 | 1 | 安全搜索:0 = 关闭,1 = 中等,2 = 严格。 |
fix_typo | boolean | 否 | true | 自动更正查询中的拼写错误。 |
output_file | string | 否 | (无) | 用于保存结果的可选文件名;若省略则自动生成。 |
输出格式
页面上存在的每种已选结果类型都会作为独立的数据集项返回,并标有 item_type(organic、ads、knowledge_graph、inline_images 或 inline_videos)和 result_count。下方展示了查询 Apple 的一个代表性 organic 项目;为便于阅读,此处省略了部分数组和字段。
{
  "item_type": "organic",
  "result_count": 10,
  "text": "Apple",
  "yandex_domain": "yandex.com",
  "lang": "en",
  "lr": "84",
  "page_number": 1,
  "search_domain": "yandex.com",
  "search_domain_description": "United States",
  "search_language": "en",
  "search_language_description": "English",
  "search_location": "84",
  "total_results_found": 10,
  "pages_processed": 1,
  "total_pages": 1,
  "max_pages_set": 1,
  "results_per_page": 10,
  "pagination_limit_reached": true,
  "pagination_stopped_by_limit": true,
  "organic_results": [
    {
      "position": 1,
      "title": "Apple",
      "link": "https://www.apple.com/",
      "displayed_link": "apple.com",
      "snippet": "Apple Payments Services LLC, a subsidiary of Apple Inc., is a service provider of Goldman Sachs Bank USA for Apple Card and Savings accounts."
    },
    {
      "position": 3,
      "title": "Apple Inc. - Wikipedia",
      "link": "https://en.m.wikipedia.org/wiki/Apple_Inc.",
      "displayed_link": "en.m.wikipedia.org",
      "snippet": "Apple Inc. is an American multinational corporation and technology company headquartered in Cupertino, California, in Silicon Valley."
    }
  ],
  "ads_results": [],
  "knowledge_graph": [
    {
      "title": "Apple Inc.",
      "description": "American multinational technology company headquartered in Cupertino, California.",
      "source": { "name": "en.wikipedia.org" }
    }
  ],
  "inline_images": [],
  "inline_videos": []
}
用作 MCP 工具
你可以将 Yandex API 加载为 MCP 工具,让助手代你调用。MCP 服务 URL 会预先加载这一个 Actor:
https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex
如果出现浏览器认证提示,请使用 OAuth 进行认证;也可以使用你的 Apify API 令牌(与 Python 示例中使用的 APIFY_API_TOKEN 相同)。请在 https://console.apify.com/settings/integrations 获取令牌,并在 https://apify.com?fpr=9n7kx3 免费注册 Apify 账户。
在 Claude Cowork Desktop 中安装
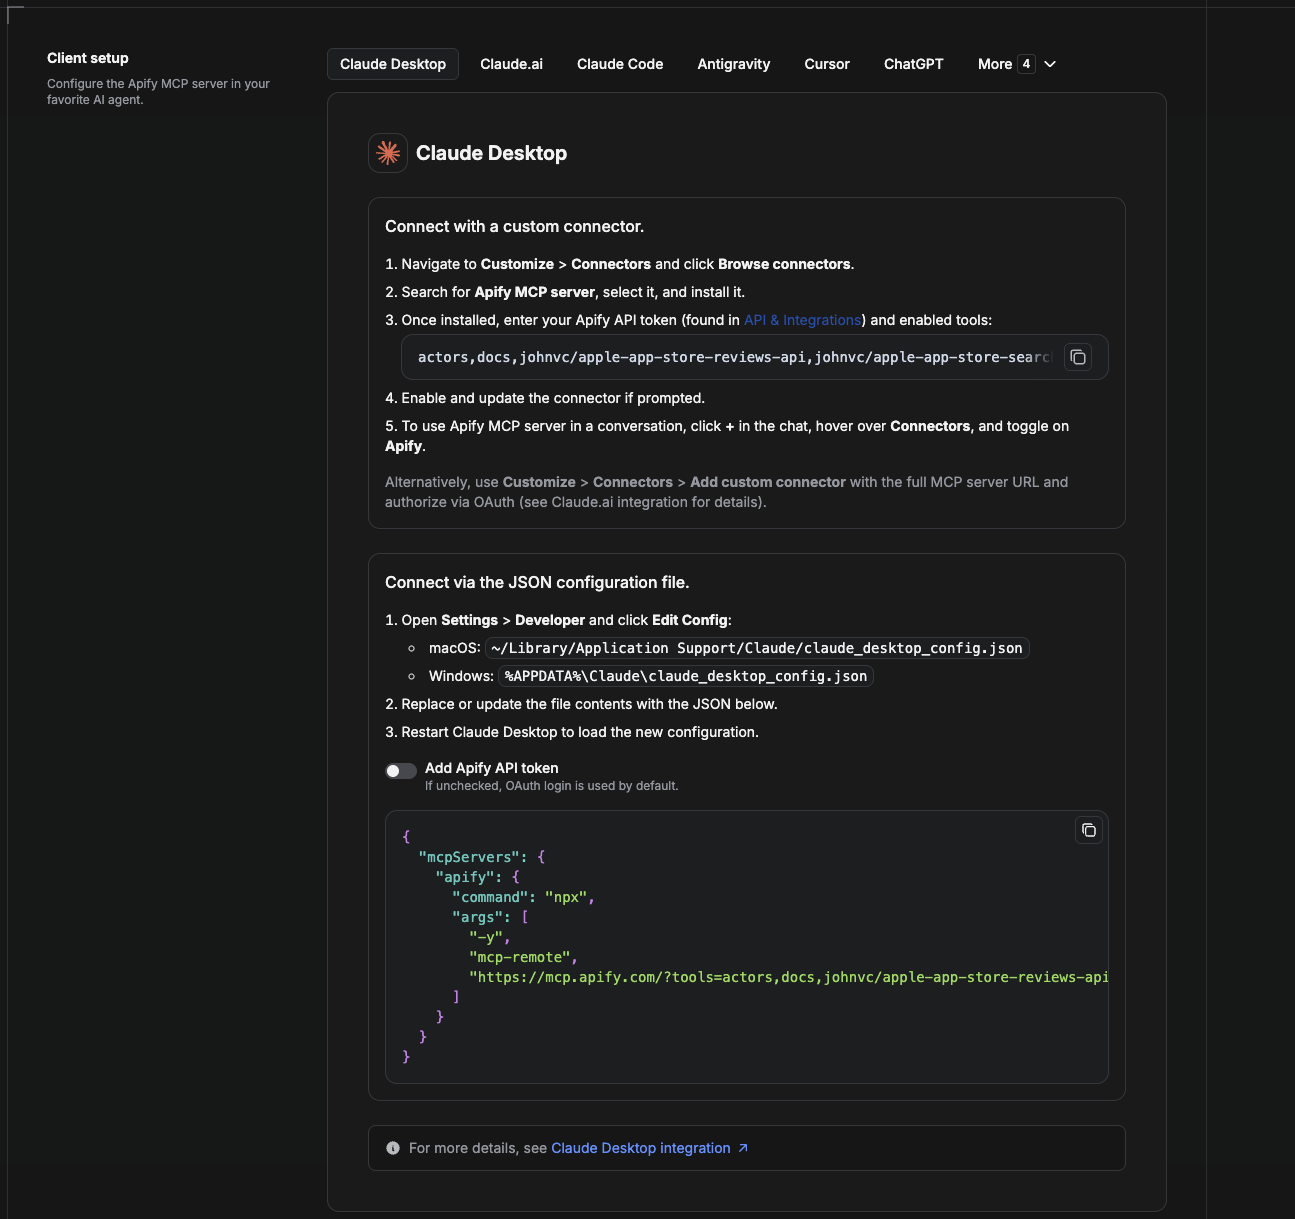
Cowork 是桌面应用的自动化模式。若要将 Yandex API 作为工具提供给它,请将 Apify MCP 服务添加为连接器。
- 打开 Claude 桌面应用,然后前往 Settings → Connectors(或者前往 Settings → Developer → Edit Config,直接编辑
claude_desktop_config.json)。- macOS:
~/Library/Application Support/Claude/claude_desktop_config.json - Windows:
%APPDATA%\Claude\claude_desktop_config.json
- macOS:
- 添加 Apify MCP 服务,并且只预加载此 Actor:
{
  "mcpServers": {
    "apify": {
      "command": "npx",
      "args": [
        "-y",
        "mcp-remote",
        "https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex"
      ]
    }
  }
}
- 重启应用。Cowork 首次调用该工具时,请在浏览器中完成 OAuth 提示,或者在连接器设置中添加 Apify API 令牌以跳过 OAuth。
- 在 Cowork 聊天中,确认工具可用,然后让它运行 Yandex API。
下载桌面应用并开始免费试用:https://claude.ai/referral/uIlpa7nPLg 更多帮助:https://docs.apify.com/platform/integrations/claude-desktop
在 Claude Code 中安装
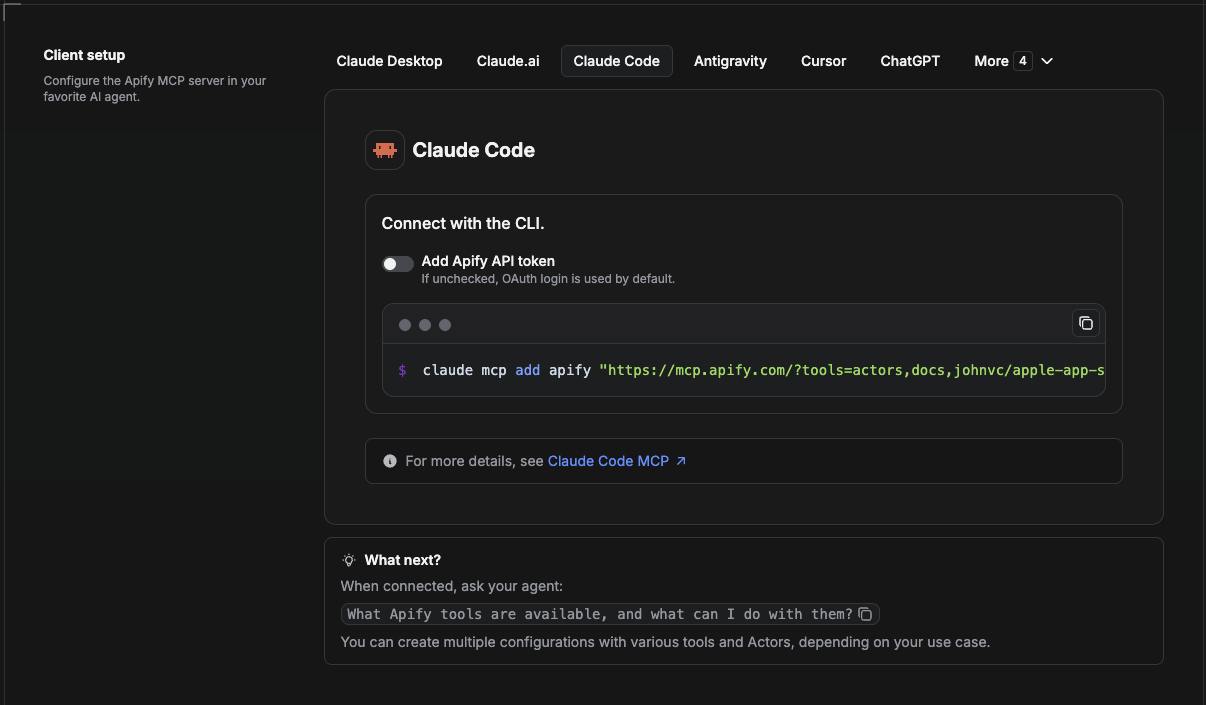
Claude Code 是命令行工具。使用一条命令添加 Actor 的 MCP 服务:
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex"
若要使用令牌而非浏览器 OAuth:
claude mcp add --transport http apify \
  "https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex" \
  --header "Authorization: Bearer YOUR_APIFY_TOKEN"
然后使用 claude mcp list 验证,或者在会话中运行 /mcp。让 Claude Code 调用 Yandex API。
免费试用 Claude Code:https://claude.ai/referral/uIlpa7nPLg Claude Code MCP 文档:https://code.claude.com/docs/en/mcp
在 Claude(网站)中安装
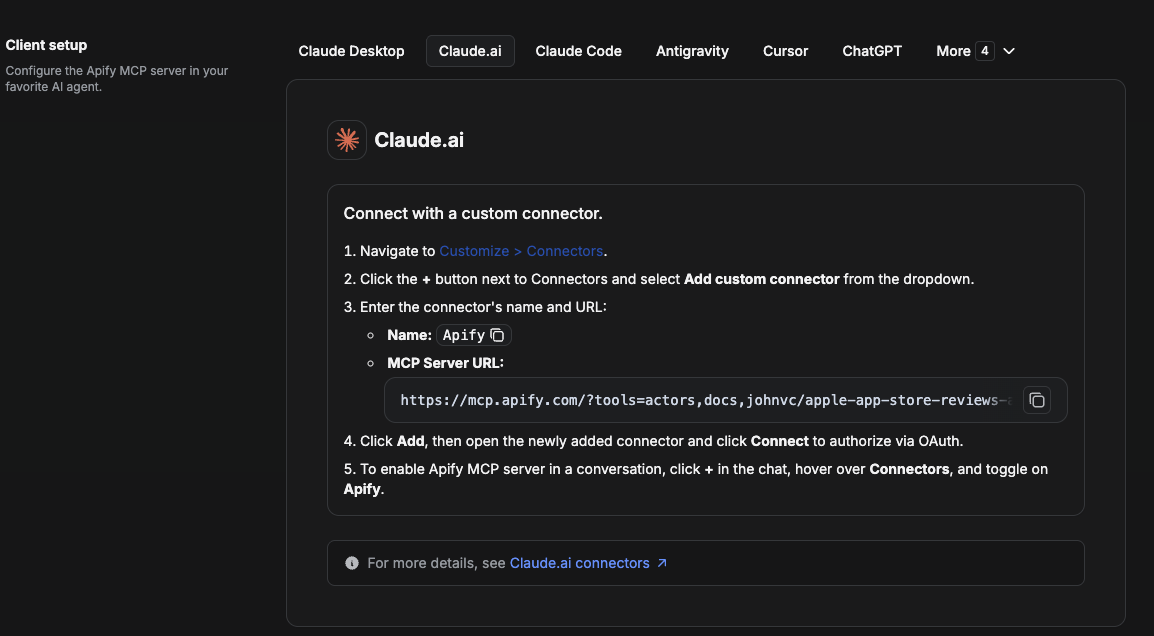
在 claude.ai 上,将 Apify 添加为连接器,然后仅启用此 Actor 的工具。
- 前往 Settings → Connectors → Browse connectors,搜索 Apify MCP server。安装它(如果出现提示,则启用或更新)。
- 连接时,使用 Apify API 令牌进行身份验证,并启用工具
johnvc/Scrape-Yandex。 - 在任意聊天中,打开 + → Connectors 并启用 Apify。
- 或者,选择 Add custom connector,粘贴完整的 MCP URL
https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex,并在出现提示时使用 OAuth。 - 让 Claude 运行 Yandex API。
在网页上打开 Claude:https://claude.ai/referral/uIlpa7nPLg
在 Cursor 中安装
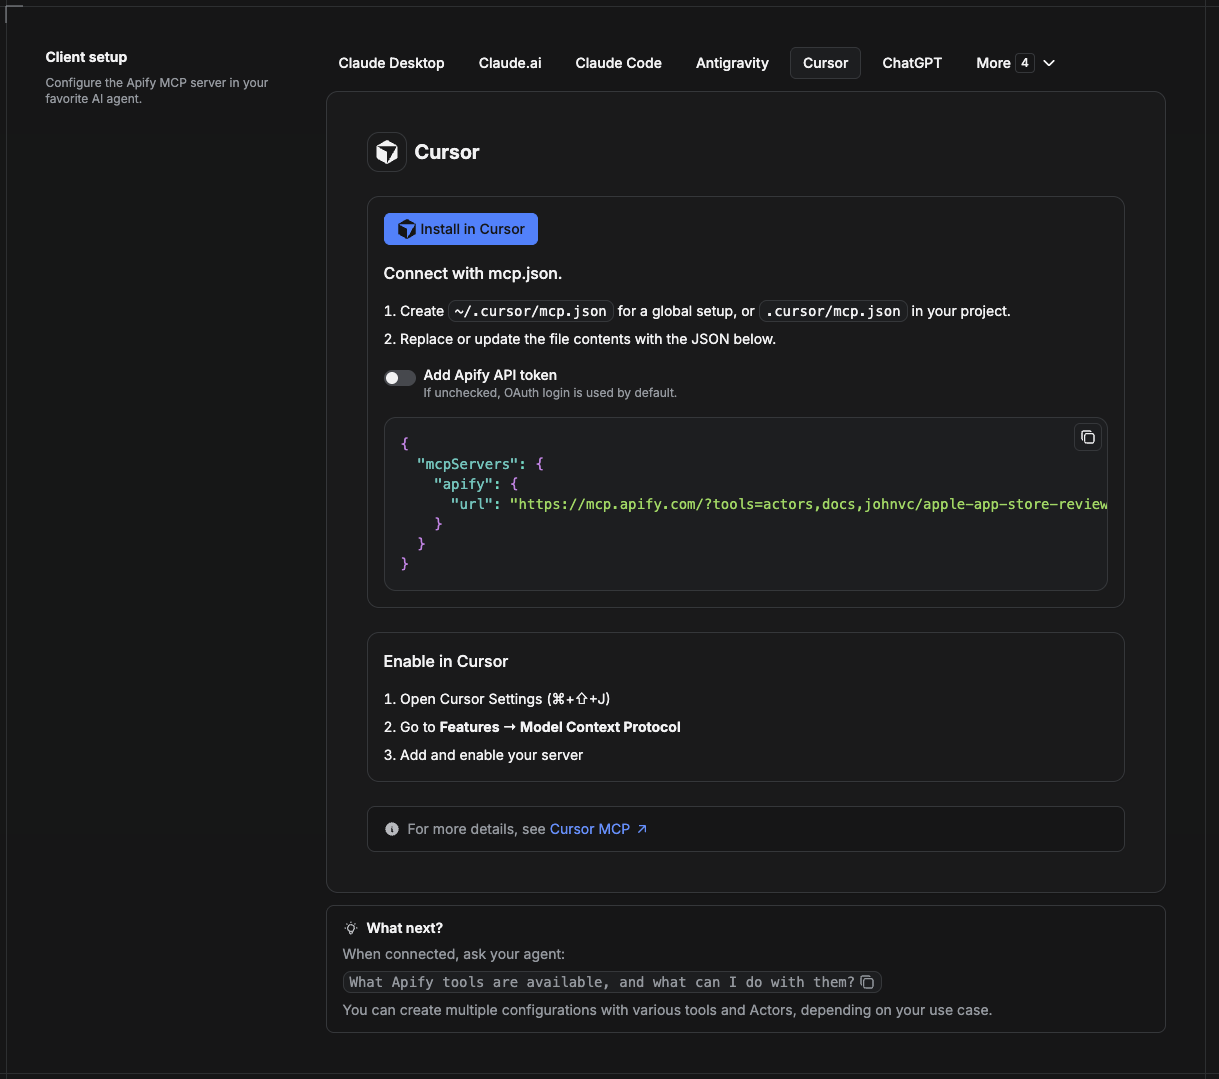
Cursor 会从项目文件 .cursor/mcp.json 中读取 MCP 服务。
- 在项目中创建
.cursor/mcp.json:
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex"
    }
  }
}
- 如果更倾向于使用令牌身份验证而非浏览器 OAuth,请添加一个标头:
{
  "mcpServers": {
    "apify": {
      "url": "https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex",
      "headers": { "Authorization": "Bearer YOUR_APIFY_TOKEN" }
    }
  }
}
- 打开 Cursor → Settings → MCP,确认 apify 服务已连接(显示绿点)。
- 在 Composer 或 Chat 中,让 Cursor 调用 Yandex API。
刚开始使用 Cursor?在这里获取:https://cursor.com/referral?code=XQP4VBLI3NNX
在 ChatGPT 中安装
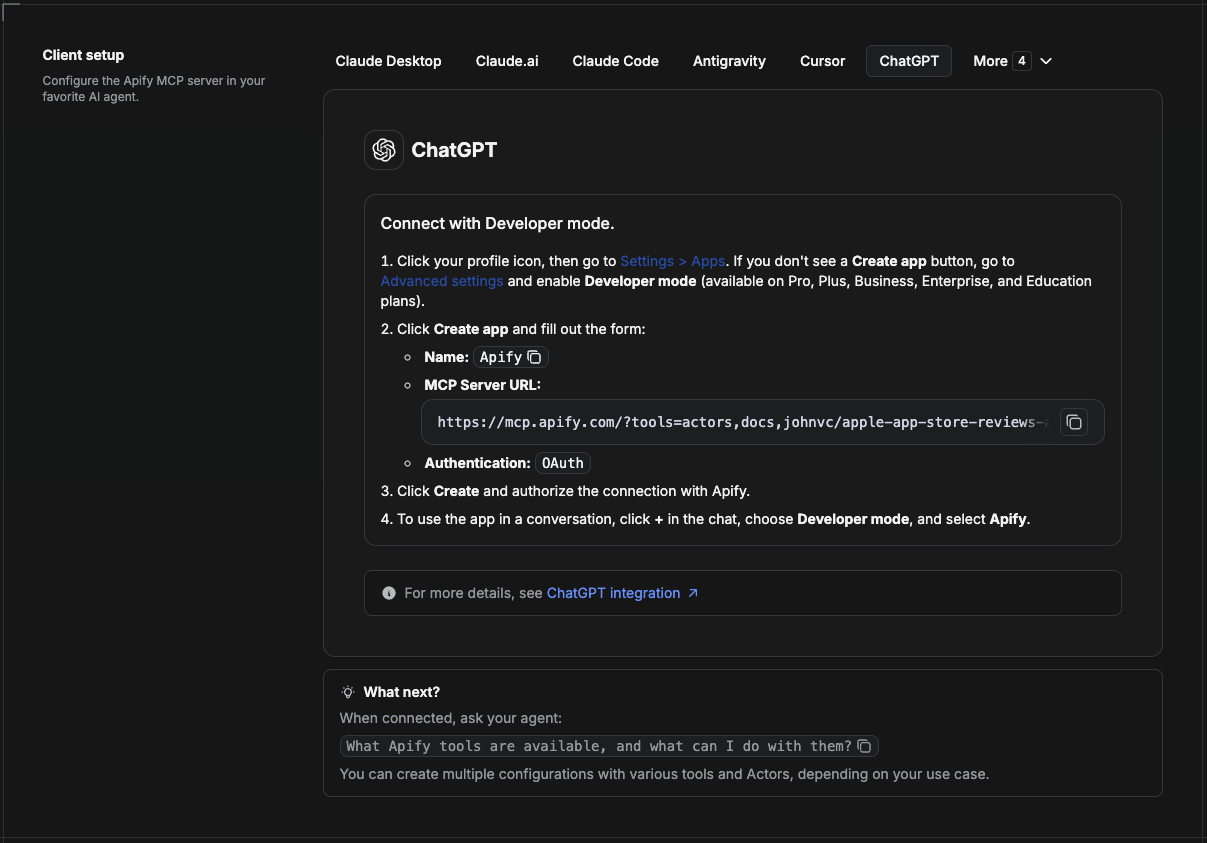
ChatGPT 通过开发者模式连接到 Apify MCP 服务(ChatGPT Pro、Plus、Business、Enterprise 和 Education 套餐均可使用)。
- 点击个人资料图标,然后前往 Settings > Apps。如果看不到 Create app 按钮,请打开 Advanced settings 并启用 Developer mode。
- 点击 Create app 并填写表单:
- Name: Apify
- MCP Server URL:
https://mcp.apify.com/?tools=actors,docs,johnvc/Scrape-Yandex - Authentication: OAuth
- 点击 Create,并通过 Apify 授权连接。
- 要在对话中使用此应用,请点击聊天中的 +,选择 Developer mode,然后选择 Apify。
更多帮助:https://docs.apify.com/platform/integrations/mcp
使用 Yandex API,为搜索和 SEO 工作流提供可靠、结构化的结果。
🤖 向 AI 助手询问此 Actor
在你选择的 AI 工具中打开一条关于 Yandex Search API 的即用提示词:
- 💬 ChatGPT
- 🧠 Claude
- 🔍 Perplexity
- 🅒 Copilot
最后更新:2026.10.27
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。