关于 wikimoth
wikimoth 面向 Claude 和 Agent,从纯 Markdown 的 [[wikilink]] 笔记中确定性地检索关联信息。检索无需调用 LLM,并可通过 MCP 提供回忆与记忆维护功能。
主要功能
- 01跨 [[wikilink]] 笔记多跳检索
- 02确定且可审计的笔记链
- 03精简上下文令牌用量
- 04捕获 Claude Code 会话
- 05记忆检查、去重与冲突检测
- 06本地笔记浏览器和 MCP 工具
适用场景
- 01查找分散在关联笔记中的答案
- 02为 Agent 提供筛选后的记忆上下文
- 03将 Claude Code 会话记录为链接笔记
- 04检查过时、重复或冲突的记忆
MCP 相关
MCP 服务向客户端提供确定性回忆和状态工具,也提供记忆维护工具,包括冲突、格式问题、重复项和渐淡笔记检查。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
npx -y wikimoth-mcpWIKIMOTH_VAULTAbsolute path to the [[wikilink]] markdown vault to serve (the folder wikimoth install captures into).WIKIMOTH_PYTHONOptional: pin the exact Python interpreter that has wikimoth installed.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
7收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| as_of | string | 否 | 时间回溯:显示知识库在此 ISO 日期(YYYY-MM-DD)时的有效状态 |
| query | string | 是 | 要从记忆中检索的问题或主题 |
| top_k | integer | 否 | 要返回的笔记块最大数量(默认 8) |
| show_superseded | boolean | 否 | 包含已被取代的笔记正文(默认 false,即隐藏正文但保留关系) |
详细介绍
WikiMoth
串联线索。每次都用同样的方式。
wikimoth.com · pip install wikimoth


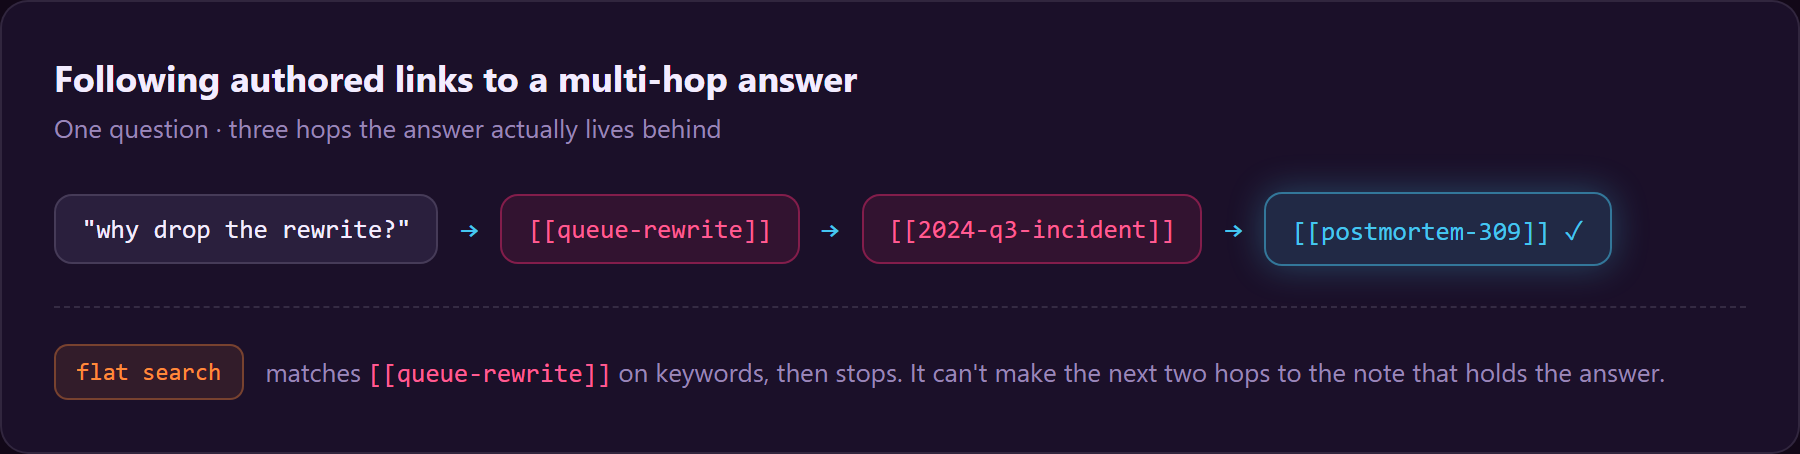
为 Claude 和 Agent 提供确定性、极省 token、可审计的记忆。 将 WikiMoth 指向一个包含 [[wikilink]] 笔记的文件夹(Obsidian 库,或 Claude 自己的记忆文件夹),它就会沿着已编写的链接找到普通搜索无法触及的答案,展示完整的笔记链,并让读取者消耗的 token 比粘贴整个库少约 99%。纯 Markdown,无需 GPU、向量数据库,检索流程中也不需要大模型。
pip install wikimoth
wikimoth demo         # instant multi-hop recall over a bundled demo vault (no setup)
已经有一个 [[wikilink]] 库(Obsidian 库或笔记文件夹)?将 WikiMoth 指向它,只需一条命令即可查看完整的线索串联视图,无需捕获,也无需等待:
wikimoth serve --vault /path/to/your/vault      # browse + "what memory fed this answer"
wikimoth recall --vault /path/to/your/vault "a connect-the-dots question"
想让它从 Claude Code 会话中构建记忆? 安装捕获钩子;你运行并关闭的每个会话都会写入一个 [[wikilink]] 库:
wikimoth install      # capture: turn your Claude Code sessions into a [[wikilink]] vault
wikimoth serve        # once you have captured sessions, browse them
为什么不让 Claude 自行管理上下文?
我们对此进行了实际基准测试。一个浏览笔记文件夹并自行精简上下文的 Agent,也能得出相同的答案,包括多跳问题(我们的测试中为 12/12)。只是代价更高:每个问题需要与模型往返 4 至 6 次,计费 token 大约多 10 倍,因为每一步都会重新发送不断增长的对话记录。WikiMoth 只需一次确定性遍历,检索相同的笔记链,流程中不调用模型,并展示答案背后的确切笔记。
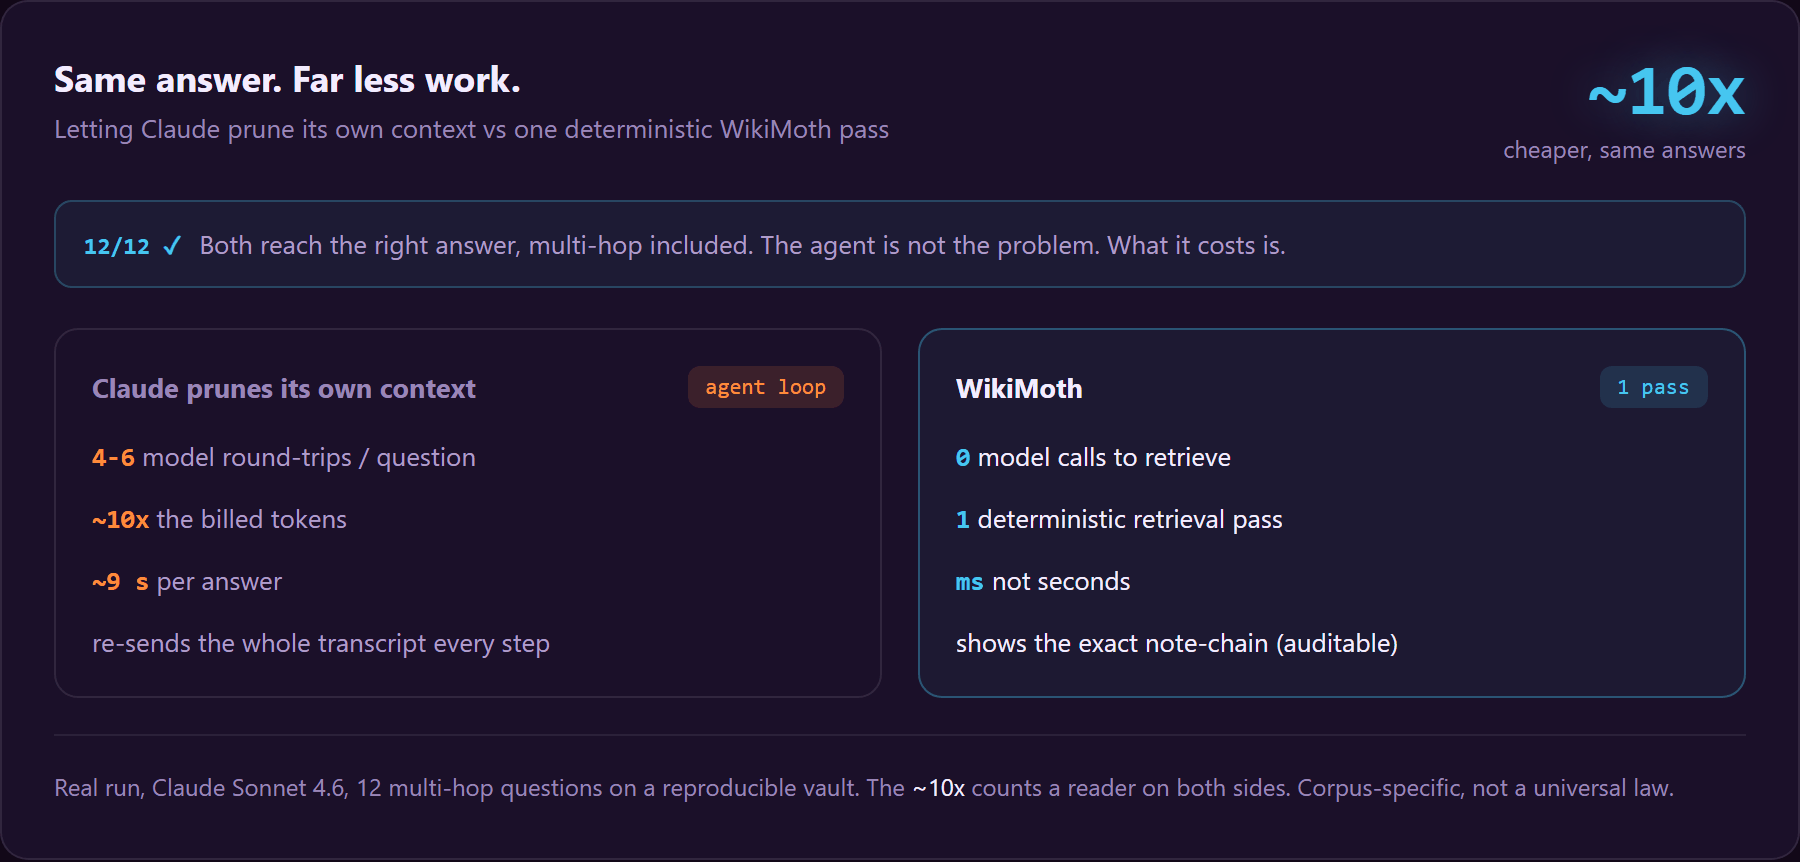
实际测试:Claude Sonnet 4.6,在一个可复现的库上测试 12 道多跳问题。约 10 倍的差异计算了两种方案中的读取者;该数字取决于语料,并非普遍规律。运行 python scripts/run_agentic_benchmark.py 即可复现。完整分析见诚实的局限性。
为什么选择 WikiMoth
大多数 Agent 记忆要么是把整个笔记文件夹粘贴到上下文中(成本高,而且模型会在中间迷失方向),要么是由大模型总结的相似度搜索(有损且不确定:同一个问题下周可能会返回不同的记忆)。WikiMoth 选择了不同的方案:你的笔记就是存储(纯 Markdown),图谱由你编写(你的 [[wikilinks]],无需训练嵌入或担心它们漂移),检索靠的是代码,而不是模型,因此结果可复现,而且你能确切了解每条笔记为何被选中。
| WikiMoth | BM25 | 向量 RAG | claude-mem | LLM Wiki (Karpathy) | |
|---|---|---|---|---|---|
关联信息(在你编写的 [[links]] 上进行多跳检索) | ✅ | ❌ | ❌ | ❌ | ✅ (Agent 驱动) |
| 确定性检索(相同查询 → 相同结果) | ✅ | ✅ | ✅ | ❌ | ❌ |
| 检索无需调用大模型 | ✅ | ✅ | ✅ | ~ | ❌ |
| 可审计的笔记链(哪些笔记生成了答案) | ✅ | ~ | ❌ | ❌ | ~ |
| 直接查找召回率@8(真实知识库) | 1.00 | 1.00 | 1.00 | ~ | ~ |
| 无需 GPU / 向量数据库 / 构建索引 | ✅ | ✅ | ❌ | ~ | ✅ |
| 纯 Markdown 存储(可在任何编辑器中打开) | ✅ | ~ | ❌ | ❌ | ✅ |
| 相较于倾倒整个知识库,所需令牌极少 | ✅ −99% | ✅ −99% | ✅ −99% | ✅ | ~ |
| 确定性、无需 API 的自动捕获 | ✅ | ❌ | ❌ | ❌ | ❌ |
| 无需大模型即可保持整洁(冲突 · 重复 · 过时 · 替代) | ✅ | ❌ | ❌ | ~ | ❌ |
LLM Wiki 和 WikiMoth 一样,会沿链接浏览并跳过向量数据库,但它由大模型编写并读取 wiki,因此检索由 Agent 驱动(每次召回都要调用大模型,且不可复现),而它整理出的页面内容更丰富。~ = 部分支持 / 未经独立基准测试。
优势在于组合,而不是更高的召回率:WikiMoth 在基础功能上不逊于扁平搜索,并额外提供关联信息 + 确定性 + 审计追踪 + 纯 Markdown 存储。有关它在哪些方面持平、哪些方面胜出的详情,请参阅诚实的局限。
与 Karpathy 的 LLM Wiki 对比
WikiMoth 采用了 Andrej Karpathy 的 LLM Wiki 模式所推广的底层基础:纯 Markdown [[wikilink]] 笔记,无需向量数据库,但引擎恰恰相反。在 LLM Wiki 模式中,大模型既编写 wiki,也读取 wiki:页面丰富且注明来源,但召回是Agent 驱动的(需要调用大模型,且路径不可复现)。WikiMoth 用代码计算边,并通过固定算法检索,整个过程中不调用大模型 → 每次都得到相同的笔记链,结果可复现、可审计。两者互为补充,并非相互竞争:将 WikiMoth 指向 Karpathy 风格的 wiki,即可对其进行确定性多跳检索。(我们并不声称自己比 LLM Wiki“更好”:它整理出的页面更丰富;我们提供确定性检索。)
快速入门(阅读)
from wikimoth import MemoryRAG, EchoReader

rag = MemoryRAG(reader=EchoReader())          # API-free default reader
rag.index("/path/to/your/wikilink/vault")     # notes → ~400-token chunks, graph built

chunks, tokens = rag.retrieve("a connect-the-dots question?", top_k=8)
print(f"{len(chunks)} chunks, {tokens} tokens to feed the reader")   # the headline win

# EchoReader is a deterministic stub for wiring/tests: it prints a diagnostic
# `[echo] ...` line, NOT a natural-language answer. Swap in ClaudeReader (below)
# for real prose. The retrieval + token numbers above are the same either way.
print(rag.answer("a connect-the-dots question?"))
换成真实的 Claude 答案(仅在构造时调用 API):
from wikimoth import MemoryRAG, ClaudeReader
rag = MemoryRAG(reader=ClaudeReader(model="claude-sonnet-4-6"))   # needs ANTHROPIC_API_KEY
查看哪些记忆为答案提供了依据:wikimoth serve
wikimoth serve                 # serves http://127.0.0.1:8765 (local-only)
wikimoth serve --vault PATH --port 8080
零依赖的本地网页查看器(纯标准库,无 Flask、无 JS 框架、无网络):
- 浏览 + 搜索你的笔记,
- 查看你编写的
[[wikilink]]图谱(即检索器遍历的同一组边), - 以及最重要的功能——“哪些记忆为这个答案提供了依据”:输入问题,即可查看 WikiMoth 会提供给读者的确切笔记链,包括每个文本块的跳数、令牌数,以及相较于倾倒整个知识库所节省的比例
−N%。仅检索:不调用大模型,无需 API 密钥,结果确定。
由于存储内容是纯 Markdown,你同样可以在 Obsidian 或 VS Code 中打开同一个知识库;查看器只是为了方便,并不会造成锁定。
在 Agent 循环中:wikimoth mcp
wikimoth serve 是给你用的。MCP 服务是给模型用的:它通过 Model Context Protocol 提供相同的确定性检索,因此 Claude 会自行调用它,而不是由你手动获取上下文。
# 1. install into the Python that runs your Claude Code
python -m pip install wikimoth

# 2. verify the command resolves (prints status, then exits)
python -m wikimoth status

# 3. register the MCP server with Claude Code
claude mcp add wikimoth -- python -m wikimoth mcp
第 2 步是关键检查:如果 python -m wikimoth status 输出状态行,那么 Claude 也能运行
python -m wikimoth mcp。三个步骤都要使用同一个 python(在某些系统上是
python3);只有这一点必须一致。
更喜欢 Node 环境,或者还没配置 Python?一行命令,无需匹配工具链:
claude mcp add wikimoth -- npx -y wikimoth-mcp
wikimoth-mcp 启动器会找到安装了
WikiMoth 的 Python(如果没有,就会通过 uvx 即时安装一个),注入知识库路径,确保服务不会从客户端的工作目录读取空文件夹,并原样传递 MCP 通道。同一个 npx -y wikimoth-mcp 可用作任何 mcpServers 配置(Claude Desktop、
Cursor、Windsurf)中的服务命令;将 WIKIMOTH_VAULT 设置为你的知识库路径。
现在 Claude 有了一个 recall(query) 工具。向它询问笔记中记录的内容,它就会调用
recall;WikiMoth 会遍历 [[links]] 并返回确切的笔记链(检索不调用大模型、令牌用量极少,且每次结果相同),Claude 再根据这些内容作答。status 工具会报告已连接的知识库。对于其他 MCP 客户端,请使用 python -m wikimoth mcp 作为服务命令(stdio 传输);使用 --vault PATH 指定特定知识库。
python -m wikimoth mcp 是可移植形式(无论软件包安装在哪里都能运行)。如果控制台脚本位于 PATH 中,也可以直接使用 wikimoth mcp。它完全使用标准库:手动实现的 JSON-RPC 2.0 stdio 服务端,不依赖 MCP SDK。
mcp-name: io.github.juliangeymonat-jpg/wikimoth
捕获:会话 → 笔记(写入部分)
检索需要一个 [[wikilink]] 知识库;手动编写知识库正是阻碍所在。wikimoth.capture 会自动构建知识库:安装 Claude Code 生命周期钩子,将每个会话转换为一篇确定性的 Markdown 笔记。
**关键的不变量:**笔记的 [[wikilinks]](图中的边)由代码(字符串/路径匹配)计算得出,绝不由模型生成。大模型可以选择性地起草摘要文字(WIKIMOTH_LLM_PROSE=1),但它生成的任何 [[...]] 都会被剥离,绝不会被解析为边。因此,图是可复现且可审计的(相同会话 + 知识库 → 相同边)。默认捕获完全确定性,不会发起任何 API 调用。
wikimoth install                 # writes 5 hooks into ./.claude/settings.json (absolute interpreter path)
wikimoth install --user          # ~/.claude/settings.json instead
wikimoth install --vault PATH    # choose where notes go (sets WIKIMOTH_VAULT)
wikimoth status                  # vault, note/session/buffer counts, hook state
wikimoth uninstall               # remove the hooks again
生命周期:SessionStart 将近期会话召回到上下文中 · UserPromptSubmit / PostToolUse 缓冲会话 · Stop / SessionEnd 写入一篇笔记。捕获的笔记正是读取流程会索引的内容;捕获与检索由此形成闭环。
保持记忆准确:卫生检查套件
只增不减的记忆终将腐坏。笔记会过时,两条笔记开始互相矛盾,同一事实被保存两次,旧事实被替换却从未退役。其他 Agent 记忆工具会用 大模型 解决这个问题,并悄悄覆盖旧状态。WikiMoth 提供六条命令,以确定性方式揭示这些问题,而且绝不删除任何内容:git 就是你的审计轨迹。
| 命令 | 查找内容 | 是否写入? |
|---|---|---|
wikimoth conflicts | 两条笔记对同一事实断言了不同值(类型感知,精确到有效时间) | 否 |
wikimoth lint | 失效链接、孤立笔记、内容残缺的笔记、过时笔记、取代关系循环 | 否 |
wikimoth dedup | 完全重复和近似重复的笔记(MinHash + LSH,通过精确 Jaccard 确认) | 否 |
wikimoth decay | 逐渐沉寂的笔记:年代久远、很少被链接、很少被回忆(仅生成审核队列,绝不自动删除) | 否 |
wikimoth recall --as-of <date> | 记忆在过去某日所断言的内容(双时态时间回溯,无需数据库) | 否 |
wikimoth supersede OLD NEW | 退役一条事实:使其失效,而非删除 | 是 |
所有命令都遵循三项原则:
- 使其失效,而非删除。
supersede会在 frontmatter 中将笔记标记为已取代,并链接到替代笔记。旧正文不再参与检索,但指向当前笔记的[[link]]仍然有效,因此查询即使落到过时笔记上,也会直接跳转到新笔记。任何内容都不会被rm;历史记录保存在 git 中。 - 工具绝不猜测。 每条命令都会输出候选项。唯一无法机械判定的判断——两条笔记是否真的矛盾——交由调用模型处理,绝不内置在工具中。因此,输出可复现,你也能准确了解每个候选项为何被标记。
- 双时态,无需数据库。
recall --as-of 2026-01-01仅根据 frontmatter 中的有效时间窗口,重现知识库在该日期所断言的内容。无需事件日志、向量存储或迁移。
与 WikiMoth 其他部分遵循相同的不变量:纯标准库、确定性(输出逐字节一致),除唯一的 supersede 写入命令外均为只读,并使用可进行 diff 的纯 Markdown。这七条命令也通过 MCP 提供(list_conflicts、list_lint、list_duplicates、list_fading、supersede,以及新增 as_of / show_superseded 参数的 recall),让 Agent 能自行保持记忆整洁。
安装
WikiMoth 的核心纯用标准库实现(dependencies = []):检索引擎、分块器、wikilink 图、流水线和捕获功能都已包含在 wikimoth/ 下:无需额外安装任何内容,无需 GPU,也无需向量数据库。
pip install wikimoth
# optional extras:
pip install "wikimoth[hybrid]"          # optional BM25-seeded retriever variant
pip install "wikimoth[claude,tokens]"   # real Claude reader + exact tiktoken counts
附加组件:hybrid = 以 BM25 为种子的检索器(rank_bm25) · claude = anthropic 阅读器 ·
tokens = 精确的 token 数量(tiktoken) · dense = 密集检索基准基线 · headroom =
可逆的 CCR 压缩。
工作原理
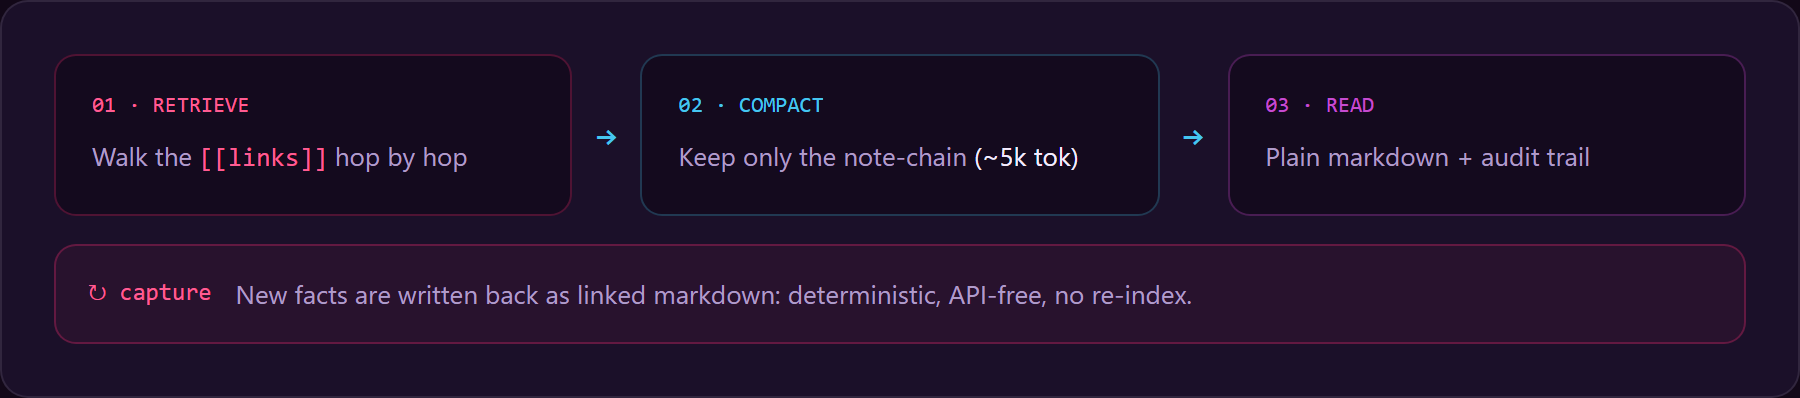
检索 → 压缩 → 阅读。 index() 会将每篇笔记拆分为约 400 个令牌的文本块(重叠约 50 个令牌),
并保留每个文本块的笔记身份,使 [[wikilink]] 图谱仍能跨文本块连接(在文本块粒度上进行多跳检索)。GraphRetriever(source="wikilinks") 会先进行词汇匹配,再沿着作者编写的链接遍历,因此,即使某段内容与问题在词汇上并不相似,只要能通过链接到达,也仍会被检索出来。可选的压缩阶段(通过
chopratejas/headroom 实现可逆 CCR)会在付费阅读器读取前进一步压缩文本段;如果未安装 headroom,则会退化为无操作。
纯导航枢纽(类似目录的 MEMORY.md)可以仅以图边的形式编入索引(exclude_content,默认值为 ("MEMORY.md",)):其中的 [[links]] 会构建图边,它仍会作为 BFS 路径节点,但其自身文本块不会传递给阅读器。
每个阶段都可通过构造函数注入:MemoryRAG(retriever=…, compactor=…, reader=…),因此你可以替换检索器(例如以 BM25 为种子的 HybridRetriever)、压缩器或阅读器。
基准测试:传递给阅读器的令牌数
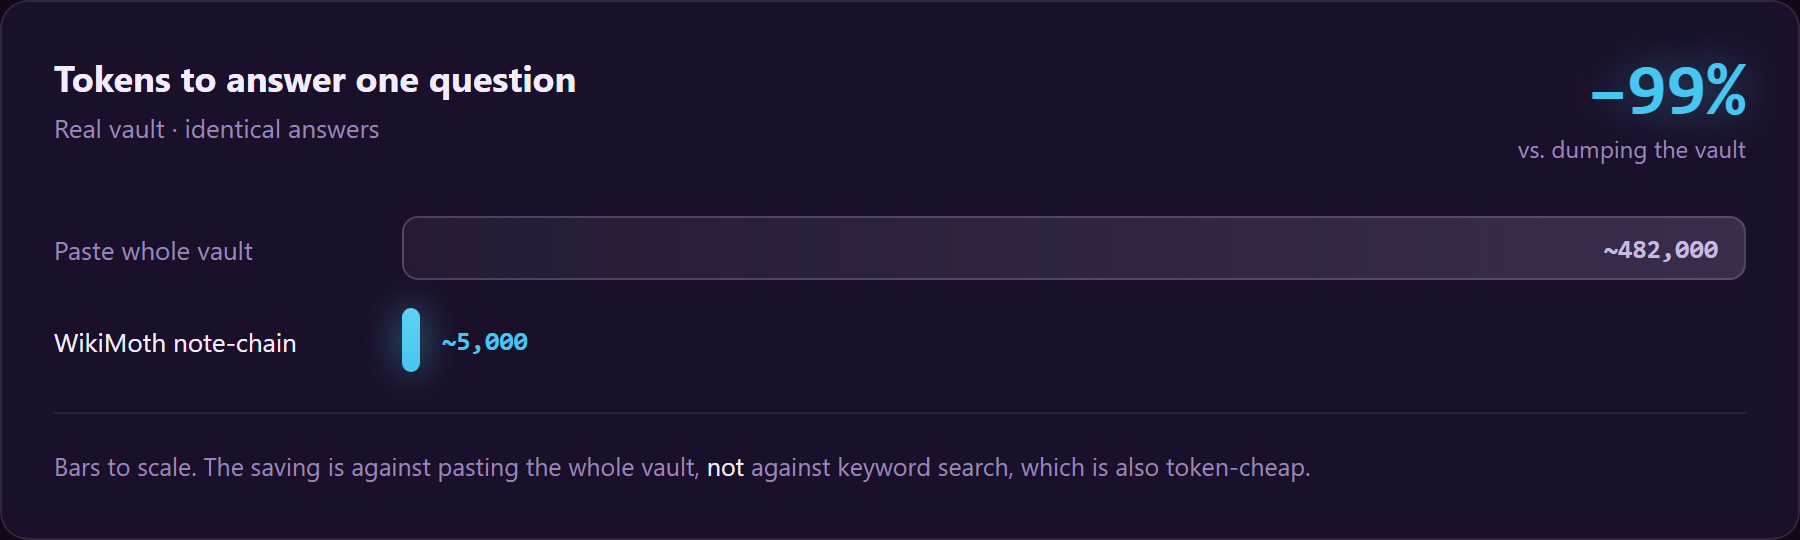
wikimoth.benchmark.harness 会在相同的知识库和问题上,衡量各方案传递给阅读器的令牌数(也就是实际付费的内容):
| 方案 | 传递给阅读器的内容 | 状态 |
|---|---|---|
dump | 整个知识库 | 基准 |
deterministic | 基于 wikilink 图谱的检索 | 已实现 |
deterministic_compacted | 检索 + Headroom | 已实现 |
agentic | 大模型浏览并精简自身上下文 | 已实现(Claude 工具调用) |
默认情况下不会运行任何付费 API 调用;每种方案的阅读器默认都使用无需 API 的 EchoReader。
诚实说明局限
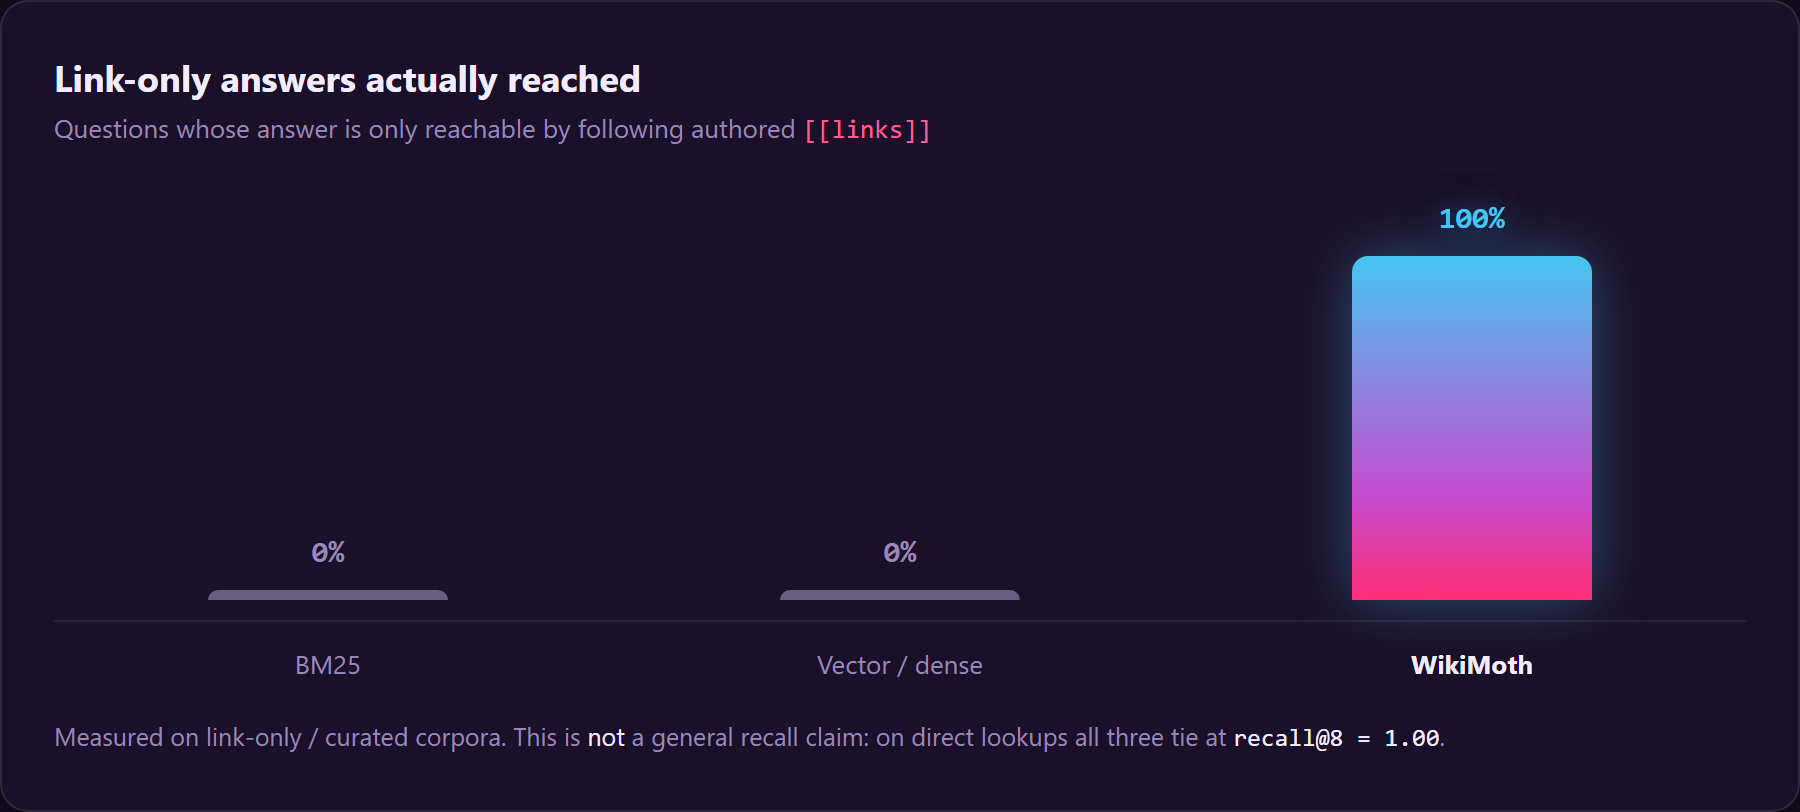
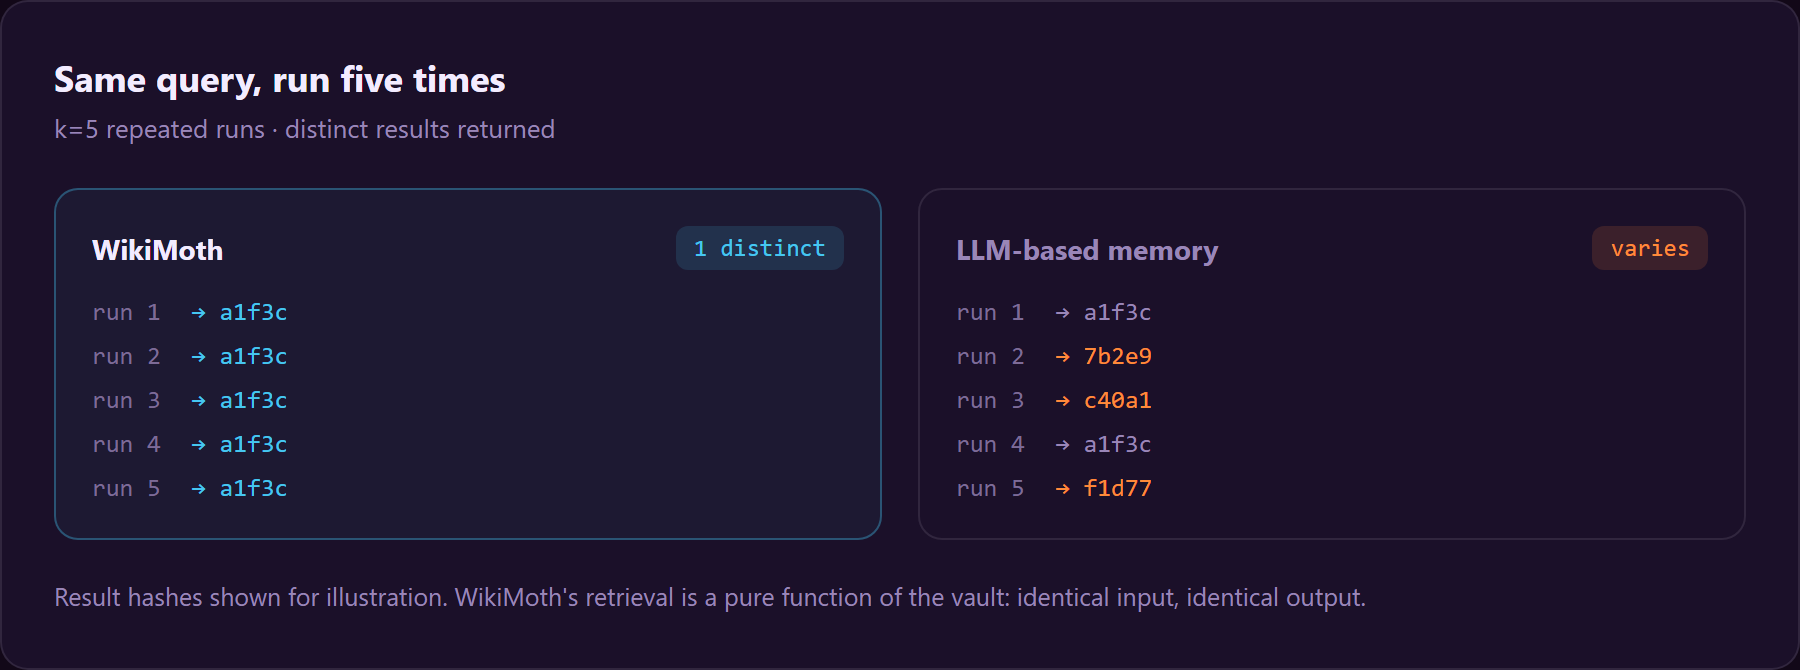
WikiMoth 的价值在于提供确定、可审计、最少令牌、纯 Markdown 的记忆,并具备真正的多跳能力,而不是“检索效果优于 BM25”。具体来说:
- −99% 是相对于 倾倒整个知识库(真实的 356 条笔记知识库约为 5k 个令牌,而倾倒全部内容约为 482k 个令牌),并非相对于 BM25:经过调优的 BM25-RAG 也会提供约 5k 个令牌。优势在于对比现实中常见的做法(粘贴所有内容 / 对整篇笔记进行简单 RAG),而且结果是确定的。
- 在典型的真实知识库中,检索效果 ≈ BM25。 直接查找时,recall@8 均为 1.00。多跳 / 串联线索的优势(在普通搜索得分为零的情况下从 0% 提升至最高 100%)出现在经过精心整理、链接密集的语料库中;在一般知识库中,混合检索绝不会比 BM25 差,但召回率并非严格优于 BM25。
- 确定性是所有静态检索器(BM25/dense 也一样)的固有属性;WikiMoth 在确定性方面的优势具体体现在相对于由 LLM 总结的记忆(后者每次运行都会变化)。
- 相对于让模型自行精简上下文(
agentic分支,在 12 个多跳问题上与 Claude Sonnet 4.6 进行的真实运行):Agent 能得到相同的答案,包括多跳问题(12/12)。区别在于成本。它每个问题需要 4 到 6 次付费往返,产生的计费令牌约为 10 倍,因为每一步都会重新发送不断增长的对话记录;而 WikiMoth 只需一次确定性处理即可作答,检索循环中不调用模型,并提供可审计的笔记链。这个倍数取决于语料库,并非普遍规律。复现方式:python scripts/run_agentic_benchmark.py。
可插拔 + 许可证
MemoryRAG(retriever=…, compactor=…, reader=…);默认值为 GraphRetriever(source="wikilinks") /
NoOpCompactor / EchoReader。任何符合精简 Protocol 的组件都可以接入。
Apache-2.0;详见 LICENSE。© 2026 Julian Geymonat。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。