关于 pdf-mcp
pdf-mcp 是供 AI Agent 从单个 PDF 或整个文件夹检索信息的 MCP 服务。它结合关键词与语义搜索、按需读取页面、OCR,以及表格和图表数据提取。
主要功能
- 01关键词与语义混合搜索
- 02按需读取指定页面并执行 OCR
- 03搜索和概览 PDF 文件夹
- 04提取表格和图表坐标
- 05使用 SQLite 缓存已解析文档
- 06将隐藏文本标记为不可信内容
适用场景
- 01在长篇报告中定位相关段落
- 02跨多个 PDF 文档搜索
- 03读取扫描页面或提取表格数据
MCP 相关
它向 MCP 客户端提供 PDF 信息、搜索、读取、渲染和语料库工具。默认支持 stdio,也提供 HTTP,适用于无法启动进程的客户端或共享语料库场景。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
我们还没有获取到这个服务的安装包或远程地址,请按项目 README 中的说明安装。
工具
13收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| path | string | 是 | PDF 文件路径(绝对路径、相对路径或 URL) |
| detail | boolean | 否 | 为 True 时,在 `text_coverage` 中包含逐页数组 (`text_chars_per_page`、`raster_images_per_page`)。默认值为 False——仅返回固定大小的 `summary`,以限制大型文档的负载大小(否则,3000 页的 PDF 仅覆盖信息就会包含约 6000 个 整数)。仅在需要 逐页字符数/图像数时启用。 |
| content_trust | boolean | 否 | 为 True 时,在 响应中包含 `content_trust` 键,其中包含对隐藏文本信号的扫描结果。扫描结果会与文档元数据一同缓存,因此后续调用开销很低。`suspicious=True` 表示文档中的某些文本对人类读者不可见(例如,白底白字文本、不透明度为零的文本跨度、极小字号)。隐藏文本绝不会被删除或修改——此信息仅供参考。`detail=True` 时,该区块还会包含一个 `spans` 列表,其中列出每个文本跨度的信号详情。默认值为 False——除非显式请求,否则完全省略,以减轻常规调用的负担。 |
详细介绍
pdf-mcp


通过单个 MCP 工具,对单个 PDF 或整个文件夹执行 Agentic RAG。
由 Agent 决定何时搜索;pdf-mcp 负责检索并返回摘录。它是一个 MCP 服务,可让 Claude Code 和其他 AI Agent 按含义或关键字搜索单个 PDF 或整个文件夹,只读取所需页面,并准确提取表格、图片和扫描文本,即使面对多栏和日文版式也能处理;预热大型语料库时还可选择使用 CUDA 加速。
mcp-name: io.github.jztan/pdf-mcp
在浏览器中试用
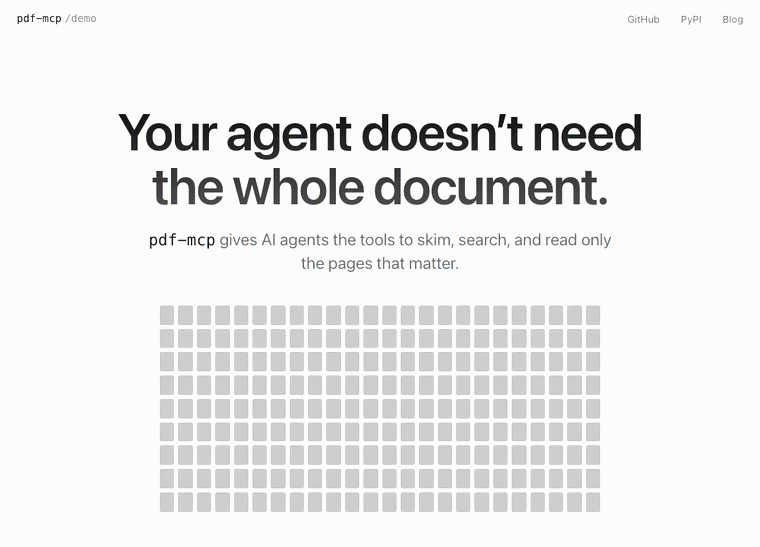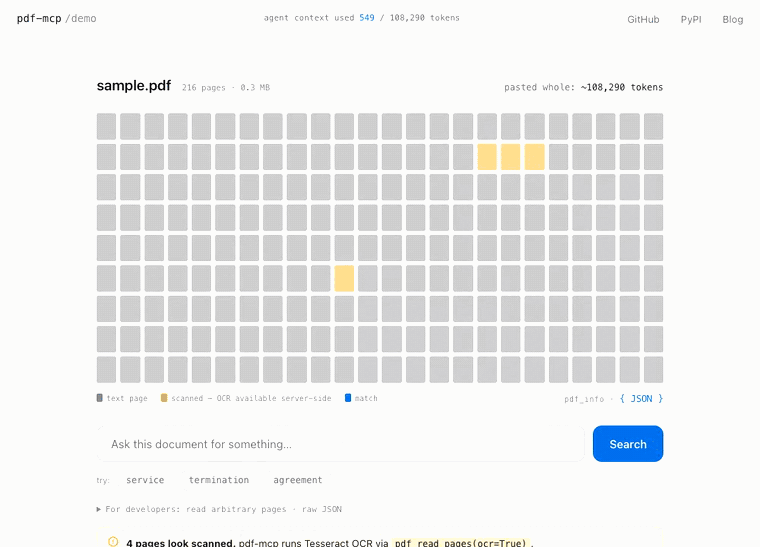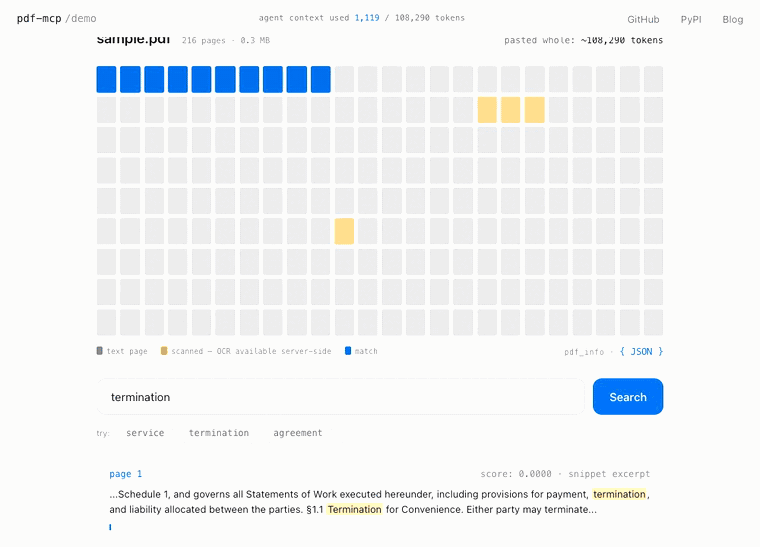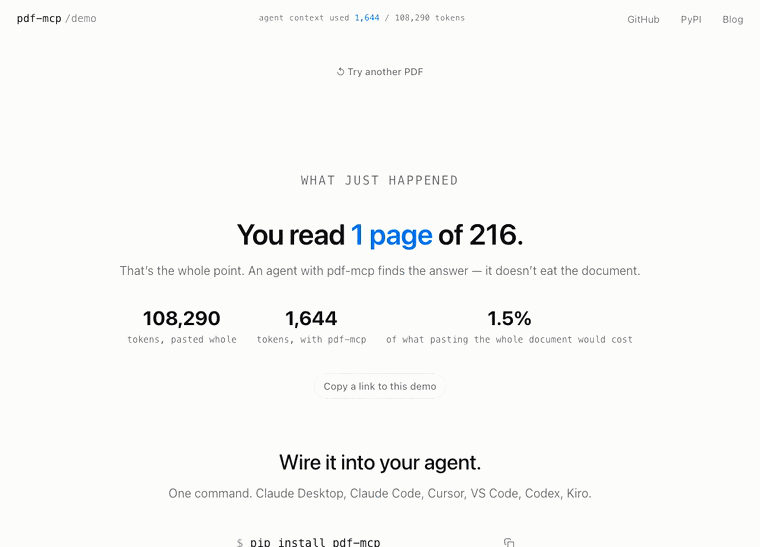
添加任意 PDF,或包含多个 PDF 的整个文件夹,观察 Agent 如何筛查语料库、同时搜索所有文档,并只读取所需页面,仅使用一小部分 token。100% 在客户端运行,无需安装。
为什么选择 pdf-mcp?
| 不使用 pdf-mcp | 使用 pdf-mcp | |
|---|---|---|
| 大型 PDF | 上下文溢出 | 只读取所需页面 |
| 查找内容 | 加载所有内容 | 混合搜索:BM25 关键字 + 语义搜索 |
| PDF 文件夹 | 一次处理一份文档 | 预热、筛查并搜索整个文件夹 |
| 预热大型文件夹 | CPU 嵌入耗时数分钟 | 按长度排序并以小批量进行 CPU 编码;也可使用 CUDA 嵌入,在 NVIDIA 显卡上速度快 10 到 100 倍 |
| 表格和图表 | 在原始文本中丢失 | 结构化行,以及矢量图表中的 (x, y) 数据 |
| 多栏和竖排版式 | 列内容交错 | 正确的阅读顺序,包括日文纵排 |
| 扫描版 PDF | 完全没有文本 | 通过 Tesseract 进行 OCR,并行处理各页面 |
| 重复访问 | 每次都重新解析 | 重启后仍保留的 SQLite 缓存 |
| 隐藏或注入的文本 | 未经提示地摄入 | 标记为不可信,不会剥除 |
安装
Claude Desktop:无需预先安装
- 下载 pdf-mcp.mcpb。
- 在 Claude Desktop 中打开 Settings > Extensions,将文件拖到 该页面,然后点击 Install。
- 通过文件位置询问 Claude 关于 PDF 的问题,例如:“使用 pdf-mcp 总结 C:\Users\me\Downloads\report.pdf”,也可以询问整个文件夹。
首次启动时会下载 pdf-mcp 的组件(约 250 MB),可能需要几分钟;之后启动只需几秒。已包含扫描页面的 OCR 功能:遇到第一个扫描页面时,会下载仅支持英语的 Tesseract(约 14 MB)。需要 Windows 10 或更高版本,或 macOS 13 或更高版本(Apple Silicon 设备需 macOS 14),并在 Claude Desktop 的 Chat 中运行。有关更新、卸载和其他详情,请参阅 docs/clients.md。
Claude Code 和其他 MCP 客户端
需要 Python 3.11 或更高版本。使用
uv 或 pipx 安装 pdf-mcp 命令:
uv tool install pdf-mcp # or: pipx install pdf-mcp
在虚拟环境中使用 pip install pdf-mcp 也可以;Homebrew 的 Python
以及近期版本的 Debian 和 Ubuntu 不允许全局安装 pip 软件包。
然后将其添加到客户端。Claude Code 的配置方法:
claude mcp add pdf-mcp -- pdf-mcp
对于 VS Code、Cursor、Codex CLI、Kiro 或任何其他 MCP 客户端,请参阅 docs/clients.md。然后让你的 Agent 读取 PDF。
搜索、语料库工具、表格、多栏文本和 CJK 阅读顺序开箱即用。对于非英语文档,请参阅 语言支持。扫描页面的 OCR 还需要 Tesseract:
brew install tesseract                             # macOS
sudo apt install tesseract-ocr                     # Ubuntu/Debian
winget install -e --id UB-Mannheim.TesseractOCR    # Windows
可选:在 NVIDIA 显卡上使用 CUDA 嵌入,可将大型文件夹的预热速度提升 1 到 2 个数量级;请参阅 docs/configuration.md。
从 Python 使用
pdf-mcp 的工具也是普通的 Python 函数,因此你可以导入它们,并将 PDF 交给 Anthropic SDK,而无需运行服务。两个可运行脚本,分别用于提问和处理完整文档:examples/。
为何要构建此工具,以及过程中遇到了哪些问题:Claude 的 100 页 PDF 限制及其解决方法
工具
提供 13 个专用工具,而非一个包罗万象的工具。典型流程:
使用 pdf_info 制定计划,使用 pdf_search 定位内容(其段落摘录通常
可直接回答问题),需要更多内容时使用 pdf_read_pages。对于文件夹,先用
pdf_corpus_overview 进行初筛,再用 pdf_corpus_search 搜索。
| 工具 | 功能 |
|---|---|
pdf_info | 页数、元数据、目录摘要、扫描页面检测。首先调用。 |
pdf_search | 按页面或章节进行混合搜索(关键词 + 语义);搜索结果包含摘录、来源坐标、所属大纲章节以及表格的引导句 |
pdf_read_pages | 读取指定页面或范围,可按需执行 OCR,并读取表格和嵌入图像 |
pdf_read_all | 一次调用读取整个文档,受字节数上限限制 |
pdf_get_toc | 为含有大量书签的文档获取完整目录 |
pdf_render_pages | 将页面渲染为 PNG,供视觉模型处理:图表、手写内容、扫描件 |
pdf_extract_chart | 从绘图几何信息中读取图表数据,输出精确的 (x, y) 表格 |
pdf_corpus_warm | 在时间预算内将 PDF 文件夹预热到缓存中 |
pdf_corpus_overview | 为文件夹中的每份文档生成初筛卡片 |
pdf_corpus_search | 跨文件夹搜索;搜索结果包含文档和页面来源信息 |
pdf_cache_stats | 按文档显示缓存明细和总大小 |
pdf_cache_clear | 清除已过期或全部缓存条目 |
server_info | 当前启用的可选功能和配置 |
这些工具返回的文本均为从 PDF 中提取的不可信内容。
pdf_info(content_trust=True) 会报告人类读者无法看到的隐藏文本,而读取工具会按页面标记这些内容。
示例提示词:
"Read the PDF at /path/to/document.pdf"
"Which pages discuss supply chain risks?"
"Find sections about the training process"
"Show me what page 5 looks like"
"OCR pages 3-5 of the scanned PDF"
完整参考文档,涵盖每个参数和响应结构: docs/tool-reference.md。嵌入模型选择: docs/embedding-models.md。
示例工作流
针对大型文档(例如,一份 200 页的年报):
User: "Summarize the risk factors in this annual report"

Agent workflow:
1. pdf_info("report.pdf")
   → 200 pages, TOC shows "Risk Factors" on page 89

2. pdf_search("report.pdf", "risk factors")
   → Matches with structural paragraph excerpts: each excerpt
     is the bullet, paragraph, or heading that matched, not a
     fixed-width window. Often enough to answer directly.

3. If excerpts are sufficient → synthesize answer

4. If more context needed:
   pdf_read_pages("report.pdf", "89-95")
   → Full page text for deeper reading
远程 / HTTP 传输
STDIO 是默认方式,以上所有示例都使用它。pdf-mcp-http
通过 HTTP 提供相同的工具,适用于无法启动进程的客户端
(Anthropic API MCP connector、claude.ai 自定义连接器),以及多个客户端共享的
预热语料库。
export PDF_MCP_AUTH_TOKEN="$(openssl rand -hex 32)"
pdf-mcp-http
路径在服务端解析,因此 HTTP Agent 读取的是服务器上已有的内容:
允许列表根目录下的文件,或由服务器获取的 URL。它无法
传入自己机器上的文件。该服务为单租户,并采用默认拒绝策略:如果没有身份验证令牌,也没有 [paths] 允许列表,进程会退出,
而不会提供开放端点。
Docker 镜像已发布到 GHCR,支持 amd64 和 arm64,且已包含所有依赖,因此每个工具都能在首次请求时正常工作:
./deploy.sh              # token, image, start, health-check
cp your.pdf documents/   # this folder is the server's /data/pdfs
部署前,请阅读 docs/remote-access.md,了解信任边界 和威胁模型;有关设置、客户端配置和令牌轮换,请参阅 docs/configuration.md。
配置
pdf-mcp 开箱即用。若要限制服务可访问的路径和 URL 主机,调整缓存和工作线程设置,或添加自己的 内容信任短语,请参阅 docs/configuration.md。
路线图
请参阅 ROADMAP.md,了解计划中的功能和发布历史。
贡献
欢迎贡献。有关设置、检查、一致性评估框架和质量迭代指南,请参阅 docs/contributing.md。
贡献者
感谢所有通过代码、评审、测试和功能请求帮助改进此项目的人:
@Summer907 · @ebbsanchez · @VooDisss · @DerDennisOP · @deepdmk · @TheSOV · @janLo · @bbulkow · @HillsCloud · @phinnphace
每个版本的贡献者鸣谢名单列于 Changelog。
安全
发现漏洞?请参阅 SECURITY.md,了解威胁模型、报告渠道和预期响应时间。请勿针对尚未修复的安全问题创建公开 GitHub issue。
许可证
MIT。请参阅 LICENSE。
链接
博客文章
版本背后的故事。 构建 pdf-mcp 总让我不断遇到意外:结果不如预期的基准测试、导致一切出问题的格式,以及不得不移除的功能。我会在 The Dispatch 中记录这些思考。如果你也对此感兴趣,欢迎关注。
构建 pdf-mcp 的背景、基准测试和设计笔记:
入门
- 我如何构建 pdf-mcp:AI Agent 处理大型 PDF 时面临的问题,以及可行的解决方案
- 如何向 Claude 的 API 发送超过 100 页的 PDF:测量 Claude API 实际的页数和令牌上限,并介绍两种应对方式:针对问题在磁盘上的 PDF 中进行搜索;对于整篇文档任务,分窗口处理文本,并仅渲染包含图片的页面
- Claude Code 实际上如何读取 PDF:AI Agent 如何使用 pdf-mcp 工具读取和浏览 PDF 文档
- AI Agent 应该如何读取 PDF:经受住生产环境考验的 5 种模式:五种经过生产环境验证的模式,介绍 Agent 如何大规模浏览 PDF
语料库与多文档搜索
- 知识库不过是一个文件夹:使用语料库工具将一个 PDF 文件夹转变为 Agent 知识库,无需摄取流程或向量存储
- 无需向量数据库,为 AI Agent 实现跨文档检索:为什么 BM25 分数无法在各文档索引间合并,而排名可以;以及两阶段 RRF 如何在包含 100 个 PDF 的语料库中,对 184 个经过评分的查询,有 84.8% 能将目标文档排入前 3 名
- Amazon Bedrock 如何帮助我改进 RAG:在相同的 2,000 个令牌预算下,以 4 美分的成本将 pdf_corpus_search 与 Bedrock Knowledge Bases 进行基准测试,发现了自行测试 8 个月都未注意到的两个 bug:摘录选择器丢弃了已检索页面中的答案;每页只生成一个嵌入,导致短答案被隐藏
搜索与检索
- Semantic vs Keyword Search for AI Agents:基准测试和双路搜索路由模式:精确标识符使用 FTS5,自然语言使用嵌入
- Hybrid Search vs Query Routing for AI Agents:为什么 pdf-mcp 使用混合 RRF,而非查询路由:基准测试显示 RRF 在各种查询类型中表现更佳
- Section Chunking vs Page Chunking for AI Agents:为什么按章节搜索能通过一次调用获取完整章节内容,而按页搜索每次查询需要额外调用工具 2–6 次
- Section-Level RAG: Why BM25 Beat Hybrid Search in My Benchmark:为什么 pdf-mcp 的章节粒度搜索仅使用 BM25:混合 RRF 在章节粒度下导致词法检索效果下降 33%,因此粒度决定搜索技术
- How One Search Change Eliminated an Entire Agent Step:将 pdf_search 从固定宽度片段改为段落摘录,使其从中转工具变为终端工具:在包含 30 个查询的基准测试中,答案包含率从 80% 提升到 97%
工程与安全
- MCP 服务安全:8 个漏洞:审计 MCP 服务的安全漏洞时,我们发现了什么
- 你的大模型是 MCP 服务的免费 QA:pdf-mcp 中有 4 个 Payload 用户体验问题,schema 测试没能发现,但 Claude Desktop 在实际使用中发现了
- 为什么多栏 PDF 会打乱 RAG 的阅读顺序:修复双栏提取问题(保真度从 0.564 提升至 0.816)、由此引发的标题页作者网格回归问题,以及对这两者都视而不见的汇总指标
- 我如何修复日文竖排 PDF 的提取问题:竖排页面的内容提取结果杂乱无章,因为阅读顺序是几何排列,而非存储顺序;我们根据字形位置重建阅读顺序(从右向左排列列,从上到下排列字符),无需 OCR,也不引入新依赖
- 我的 AI Agent 不再使用我自己的 PDF 工具:72 DPI 错误:为满足响应字节预算,手机扫描件被悄悄降采样到 72 DPI,导致手写内容无法辨认,因此 Agent 绕开了 pdf_render_pages;修复方案是在降低分辨率前先降低 JPEG 质量,并让响应说明渲染内容是否无法辨认,以及应重试哪些裁剪区域
- 从 PDF 中提取图表数据:一个不会猜测的 MCP 工具:直接从 PDF 的矢量几何图形中读取精确的图表数值,然后将有歧义的判断交由大模型处理,而不是自行猜测
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。