关于 footnote-mcp
footnote-mcp 是面向 Agent 和研究流程的网页研究 MCP 服务,结合多引擎搜索、内容提取与浏览器自动化,并提供关联来源的主张核验和字符偏移。
主要功能
- 01无需 API 密钥的多引擎网页搜索
- 02提取文本、表格和链接文件
- 03根据抓取的来源文本核验主张
- 04返回带字符偏移的引文
- 05使用 Chromium 自动操作交互页面
适用场景
- 01跨多个搜索引擎研究主题
- 02提取并比较网页表格数据
- 03根据来源页面核验陈述
- 04浏览含动态内容的页面
MCP 相关
它通过 stdio 通信,向 MCP 客户端提供 45 种搜索、提取、核验和浏览器工具。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
45收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| num | integer | 否 | 返回结果的最大数量 |
| lang | string | 否 | 语言代码:en、ru 等。 |
| query | string | 是 | 搜索查询 |
| provider | string | 否 | auto | auto+marginalia | searxng | tavily | brave | google | wiby | marginalia | scrape |
| semantic | boolean | 否 | 使用本地 bge-m3 嵌入向量按含义对结果重新排序 |
详细介绍
footnote-mcp — 用于验证主张的网页研究 MCP 服务
搜索、提取数据,并根据来源页面验证每一条主张。
与返回原始文本或 Markdown 的搜索 API(Tavily、Exa)或抓取工具(Firecrawl)不同,footnote-mcp 专为验证而构建:每条主张都会根据原始来源文本进行核查,并附上句子级引文和字符偏移量,且无需任何 API 密钥。
添加到 Cursor · Claude Desktop 设置
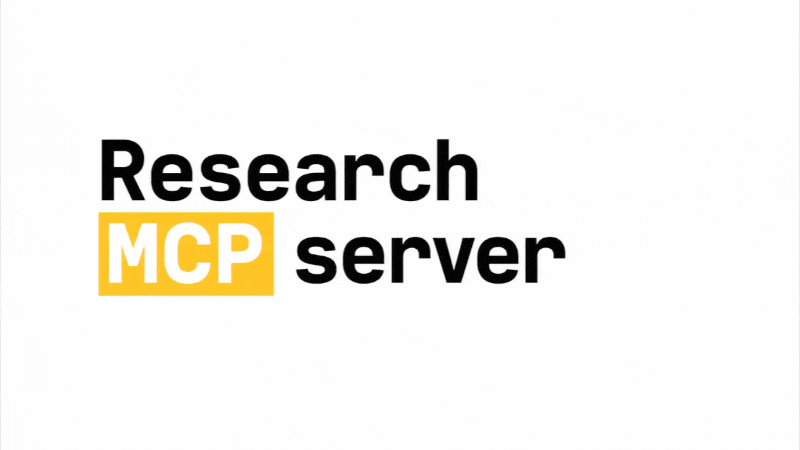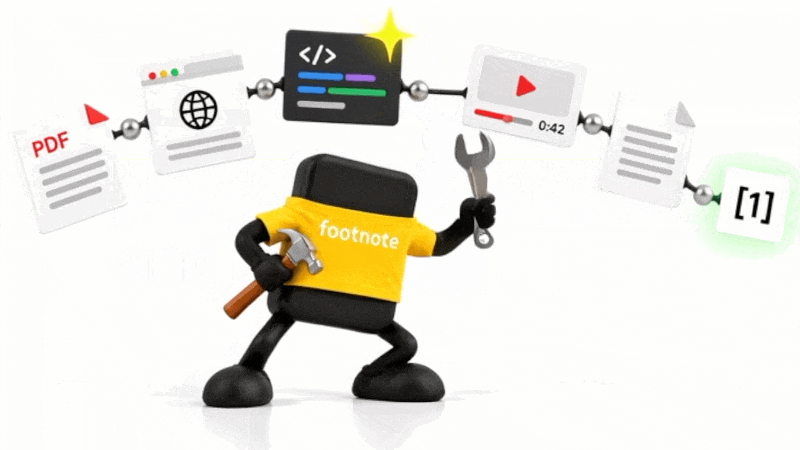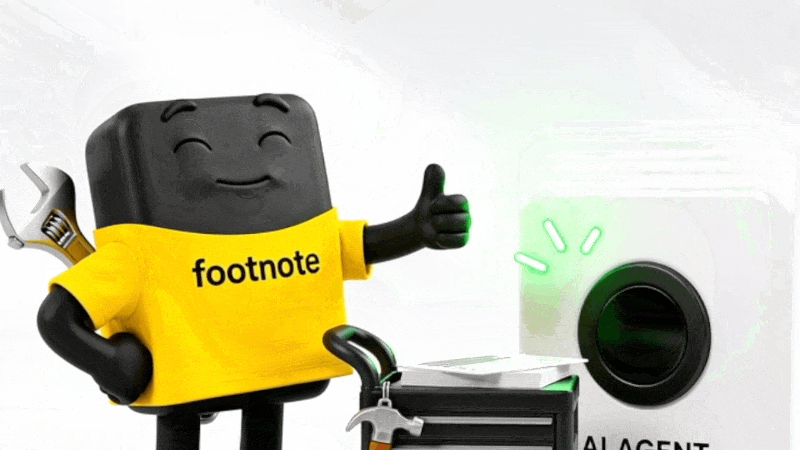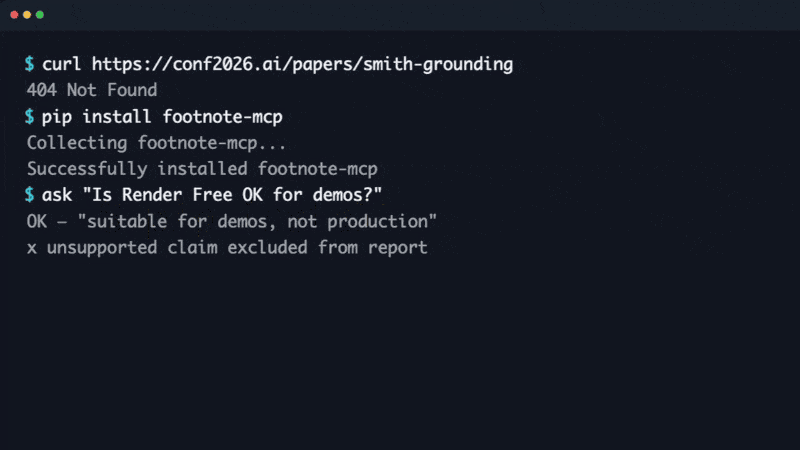
无需 API 密钥 · 45 个工具 · MIT 许可
快速开始
pip install footnote-mcp
python -m playwright install chromium   # browser tier for JS-heavy and blocked pages
footnote-mcp 通过标准输入输出使用 MCP。将客户端指向它即可——例如 Claude Desktop 的
claude_desktop_config.json,或 Cursor 的 ~/.cursor/mcp.json:
{"mcpServers": {"footnote": {"command": "footnote-mcp"}}}
启动无需 API 密钥。重启客户端,并让它运行 startup_health_check:
它会逐行报告此机器上的提取器、PDF 和电子表格解析器、浏览器、OCR 以及缓存目录是否可用——这样,缺少可选组件的问题会立即显现,而不是等到研究任务进行到一半才出现。
无需配置 API 密钥即可搜索网页
让助手查找某项信息,web_search 就会查询无需密钥的搜索服务——Bing、
DuckDuckGo、Brave、Wiby——以及你配置的任何需要密钥的服务,然后对结果去重并合并排序。
每条结果都会标明返回它的搜索引擎,并附上相关性评分。因此,可以区分某个页面是否得到两个独立索引的共同支持,还是仅被一个搜索引擎找到。摘要仅用于发现信息:此阶段的内容都还不能作为证据,接下来的两个章节会介绍相关功能。
关于服务路由、密钥和语义重排,请参阅:docs/search-backends.md。
从网页提取表格和文件并转换为结构化行
web_extract_tables 会将网页的 HTML 表格转换为带命名列的行集,并为每组数据标注其来源 URL 和实际总数,因此答案被截断时会明确说明,而不会看起来像是完整的。以 Wikipedia 的营收表格为例,你会得到 Rank、Name、
Industry、Revenue、Employees 等字段,可用于排序和比较,而不必重新阅读一大段文本。
网页链接而非直接呈现的数据也能处理:web_detect_downloads 会查找网页附带的
CSV/TSV/XLS/XLSX/PDF/JSON 文件,web_parse_file 会解析这些文件,web_fetch_json
则可直接获取 API 端点。
验证来源是否确实支持某项主张
这是普通搜索工具做不到的部分。evidence_entailment 会比较主张与来源文本并返回判定;corroborate_claim 会通过多个摘录进行交叉验证;locate_claim_span 则会返回支持该主张的句子及其字符偏移量。
给定主张 “2023 年,挪威新乘用车中的纯电动车占比为 82.4%”,以及来源文本 “2023 年,在挪威登记的新乘用车中,纯电动车占 82.4%”,返回的判定结果可供 Agent 直接使用,而不必再解读一整段文字:
{"status": "supported", "score": 0.778, "reason": "token overlap heuristic", "backend": "heuristic"}
默认后端采用确定性离线方式,绝不会悄悄把判定交给另一个模型:对于它无法确信的情况,会返回 needs_review 及其匹配到的文本片段,供你或调用它的助手阅读——调用它的助手已经掌握了两段文本。你也可以按需使用本地 LLM 判定器(backend="ollama")和本地 NLI 模型(backend="local_nli")。确定性路径(默认方式)的准确率测量结果,请参阅:benchmarks/REPORT.md。
工作原理
搜索摘要用于发现信息,绝不能作为证据。发现阶段会合并多个独立索引;
抓取阶段则逐级升级——普通 HTTP、可选代理、无头 Chromium、可选的托管抓取 API——并在最便宜的层级返回真实内容后停止。提取阶段会获取文本、表格和链接文件,并将每项内容连同其来源 URL 一起缓存。只有完成这些步骤后,验证才会开始:它会根据已抓取的文本检查主张,确认后才将其视为有效。web_deep_search 会封装整个循环:分解要求、针对未解决的缺口重新搜索,并返回一份证据台账,展示候选内容在哪个环节被筛除。
query → merged discovery → fetch ladder → extract (text · tables · files) → verify vs source → evidence
按类别列出的全部 45 个工具
搜索(8)
web_search— 使用无需密钥的提供方(Bing、DuckDuckGo、Brave、Wiby)和可选的按量计费 API 进行多引擎搜索web_search_recent— 在指定的时间范围内(天、周、月、年)进行搜索web_deep_search— 迭代式多步研究循环,提供证据台账和漏斗诊断papers_search— 通过 Crossref 和 arXiv 搜索学术论文encyclopedia_search— 查询 Wikipedia 和 Wikidata 实体,并提供只读 SPARQLgithub_search— 搜索公开代码仓库、代码、问题和提交记录archive_search— 通过 Wayback Machine 和 Common Crawl 获取历史快照generate_search_queries— 生成有针对性的运算符查询(site:、filetype:csv)
抓取(4)
web_read— 抓取 URL、提取文本、评估来源质量并缓存快照web_fetch_authenticated— 抓取需要自定义 Cookie 或会话标头的页面web_archive_fetch— 为失效或已更改的 URL 获取 Wayback Machine 中最接近的快照web_crawl— 从起始 URL 出发,按广度优先方式跟随链接进行爬取
提取(15)
web_extract_tables— 将 HTML 表格解析为带有来源 URL 的类型化列和行web_detect_downloads— 发现链接的数据文件(CSV、TSV、XLS、XLSX、PDF、JSON、XML)web_parse_file— 下载并解析表格数据和 PDF 文档web_fetch_json— 将直接 REST API 端点的内容抓取并解析为 JSONcheck_date_completeness— 根据日历和市场日程验证时间序列日期的连续性resolve_units— 规范化货币、单位和货币对validate_unit_rows— 检测并拒绝单位或货币冲突的行reconcile_time_series— 按键对齐序列、计算差值,并标记缺失项或异常值export_dataset— 将汇总行保存为 CSV、XLSX 或 JSON 文件tool_spec_propose— 提出针对特定任务的提取方案规范tool_code_generate— 生成 Python 提取方案的入门代码tool_code_validate— 根据 AST 安全许可列表验证方案代码tool_code_run_sandboxed— 在受限子进程中执行提取代码tool_promote— 将已验证的方案持久化到本地记忆recipe_registry— 列出、检查、运行和删除已注册的提取方案
验证(8)
evidence_entailment— 评估来源文本是否支持某项主张(启发式方法、Ollama 或 NLI)corroborate_claim— 对多个摘录中的主张进行交叉验证,判断是否一致或冲突locate_claim_span— 定位支持性句子,并提供字符偏移量和包含度分数classify_source— 对域名进行分类(官方、聚合器、博客、论坛、交互式、已屏蔽)source_cache_get— 检索缓存的页面快照和来源元数据source_cache_put— 将页面内容和元数据存入持久缓存build_research_debug_report— 生成简明诊断报告,汇总查询、来源和验证缺口startup_health_check— 检查解析器、浏览器运行时、OCR 和缓存目录的可用性
完整参数和架构:docs/tools.md。
要求
- macOS、Linux 或 Windows 上的 Python 3.10 或更高版本——CI 会运行全部六种组合
- 通过
python -m playwright install chromium安装 Chromium,用于浏览器层和浏览器工具 - 任意使用 stdio 通信的 MCP 客户端;Claude Desktop 和 Cursor 的配置文档均已提供
- 可选,用于
semantic: true:Ollama 守护进程,或requirements-embed.txt,以便在进程内运行相同的 bge-m3 权重——这是 Docker 等没有守护进程时唯一可用的选项 - 可选:系统
tesseract二进制文件,用于web_screenshot和扫描版 PDF 的 OCR - 无需 API 密钥、账号或托管服务
限制
- 离线蕴含启发式方法在数字和事实类主张上的得分为 100%,但在带标签数据集上的总体得分为 83%;纯语义否定和释义需要使用
backend="ollama"。 - 基准测试运行器在 Windows 上没有严格的单任务超时:它基于 Windows 不支持的
signal.setitimer,因此任务若卡住便不会受到保护地继续运行。服务本身不受影响。 - 零密钥提供方通过抓取获取数据,因此结果会因 IP 而异。搜索请求遭拒时会通过代理重试;对于 Bing 和 Brave,还会使用无头 Chromium;DuckDuckGo 会返回带错误占位内容的 Chromium 答案,因此只能等待冷却时间,或者放弃。
- 语义重排尽力而为:如果无法连接任何嵌入运行时,则原样返回原始排序。
- 生成的配方会在子进程中运行,该进程只允许导入
csv、datetime、html、json、math、re和statistics;eval、exec、open和__import__均会被拒绝——这只是验证器,并非加固型沙箱。 - 托管 HTTP 服务会将每位用户的速率限制保存在内存中;重启后限制会重置。
配置
服务只接受一个标志 --headed,用于显示 Chromium 窗口,而不是在不可见模式下运行——这在观察浏览器层处理反复失败的页面时很有用:
{"mcpServers": {"footnote": {"command": "footnote-mcp", "args": ["--headed"]}}}
环境变量
所有变量均为可选。免费层(Bing、DuckDuckGo、Brave、Wiby)会优先提供结果;只有免费结果少于 FOOTNOTE_MIN_FREE_RESULTS 时才会调用按量计费的服务商。付费搜索是备用方案,而非默认选项:不配置密钥时,大多数查询不受影响,只有范围狭窄或较冷门的搜索结果会较少,不会再补充结果。
| 变量 | 设置后的效果 | 未设置时的效果 |
|---|---|---|
FOOTNOTE_SEARXNG_URL | 将可自托管的 SearXNG 纳入免费层,不产生按量费用 | 免费层为 Bing、DuckDuckGo、Brave、Wiby |
TAVILY_API_KEY | 将 Tavily 纳入按量计费轮询 | 跳过;绝不调用 |
BRAVE_API_KEY | 将 Brave Search API 纳入轮询,与抓取的 Brave 结果并用 | 仅使用无需密钥的抓取版 Brave |
GOOGLE_API_KEY 和 GOOGLE_CSE_ID | 将 Google Programmable Search 纳入轮询 | 跳过;绝不调用 |
FOOTNOTE_MIN_FREE_RESULTS | 触发按量计费备用方案的免费结果阈值 | 3 |
FOOTNOTE_PROVIDER_STRATEGY | merge 会调用所有服务商;cost_aware 仅在需要时调用按量计费的服务商 | cost_aware |
GITHUB_TOKEN | github_search 使用已认证的速率限制 | 未认证的速率限制 |
FOOTNOTE_RESEARCH_MODEL | web_deep_search 中用于查询规划和事实提取的 Ollama 模型 | 不使用规划器运行 |
FOOTNOTE_EMBED_MODEL | 用于 semantic: true 重排的嵌入模型 | bge-m3 |
FOOTNOTE_EMBED_BACKEND | ollama 需要守护进程;local 会在进程内加载相同权重(requirements-embed.txt) | auto:若守护进程正在运行则使用它,否则在进程内运行,再否则不改变排序 |
FOOTNOTE_BROWSER_FALLBACK | 0 会禁用 Chromium 浏览器备用方案 | 已启用 |
FOOTNOTE_SEARCH_CACHE_TTL | 搜索缓存 TTL(秒)(0 表示禁用) | 86400 |
FOOTNOTE_PROXIES | 以逗号分隔的请求代理 URL | 直接连接 |
FOOTNOTE_SCRAPE_API | 配合密钥使用的托管抓取备用服务(firecrawl 或 scrapingbee) | 浏览器层作为最后的备用方案 |
FOOTNOTE_SOURCE_CACHE | 原始缓存页面的目录 | ~/.footnote-mcp/source_cache/ |
完整列表和默认值:.env.example、docs/fetching.md、docs/search-backends.md。
Docker、uvx、从源码安装、OCR、测试
Docker
docker run -i --rm ghcr.io/kazkozdev/footnote-mcp:latest # bundles Chromium and Tesseract
{"mcpServers": {"footnote": {"command": "docker",
  "args": ["run", "-i", "--rm", "ghcr.io/kazkozdev/footnote-mcp:latest"]}}}
uvx / pipx / 从源码安装
uvx footnote-mcp
pipx install footnote-mcp
python3 -m venv .venv && source .venv/bin/activate && pip install -e .
这些方式都不会获取浏览器。还需运行一次 python -m playwright install chromium,否则浏览器层和浏览器工具将不可用。
OCR 和本地 NLI
pytesseract 需要系统二进制文件(brew install tesseract)。evidence_entailment 使用
backend="local_nli" 时,需要运行 pip install -r requirements-nli.txt 并设置 FOOTNOTE_NLI_MODEL。
测试
python -m pytest -q                              # offline; no network or keys
RUN_LIVE_WEB_TESTS=1 python -m pytest -m live    # opt-in live search


评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。