关于 mcp-retriever
mcp-retriever 是提供网络搜索、网页提取、站点抓取和带引用研究的 MCP 服务。它支持配置多个提供方,并将提供方密钥保存在私有凭据文件中,而非客户端配置里。
主要功能
- 01融合多个搜索提供方的结果
- 02提取网页内容并抓取站点
- 03为符合条件的 404/410 页面使用 Wayback 快照
- 04设置用量上限和提供方冷却时间
- 05将提供方密钥存于客户端配置之外
适用场景
- 01合并多个提供方结果并排序
- 02提取网页内容或抓取站点
- 03检索无法访问页面的存档版本
- 04配置提供方并避免密钥进入客户端设置
MCP 相关
向 MCP 客户端提供搜索、网页读取、站点抓取和研究能力。设置向导可配置客户端条目,提供方密钥则单独保存。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
1收录的工具列表 · 更新于 2 周前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| limit | integer | 否 | 返回的最大行数(默认:200,最大:500) |
| offset | integer | 否 | 从第几行开始(从 1 起,默认:1) |
| result_id | string | 是 | Retriever 工具返回的不透明结果 ID |
| byte_offset | integer | 否 | 所选行内的 UTF-8 字节偏移量;原样传递 next_byte_offset(默认:0) |
详细介绍
mcp-retriever
一个 MCP 服务,提供网页搜索、页面提取和带引用的研究功能。 使用你自己的提供商,合并其结果,并避免将 API 密钥放入 客户端配置中。
- **联合搜索:**查询两到三个提供商,去重 URL,
并使用
web_search_fused合并排名。 - **深入阅读:**提取页面、抓取网站;启用存档回退后,可从 Wayback Machine 快照恢复 404/410 页面。
- **控制用量:**可选的提供商报告用量支出上限、冷却时间,以及大型结果的分页访问。
支持 Tavily、Brave、Exa、You.com、SearXNG、GitHub、Linkup、 Firecrawl 和 Context.dev。只配置你要使用的提供商。
Context.dev 提供网页搜索、通过 ai_search 获取研究答案、
使用 context_news 搜索新闻、抓取网页以及品牌工具。其亮点信息
可在搜索和阅读工具中查看。Exa 搜索新增 lite 类型,Firecrawl 搜索类别为 developer、gov、research 和 pdf。详情请参阅
配置,
这些信息已于 2026-10-19 验证。
快速开始
需要 Node.js 22+ 和一个提供商密钥,或你自己的 SearXNG 实例。
npx -y mcp-retriever setup
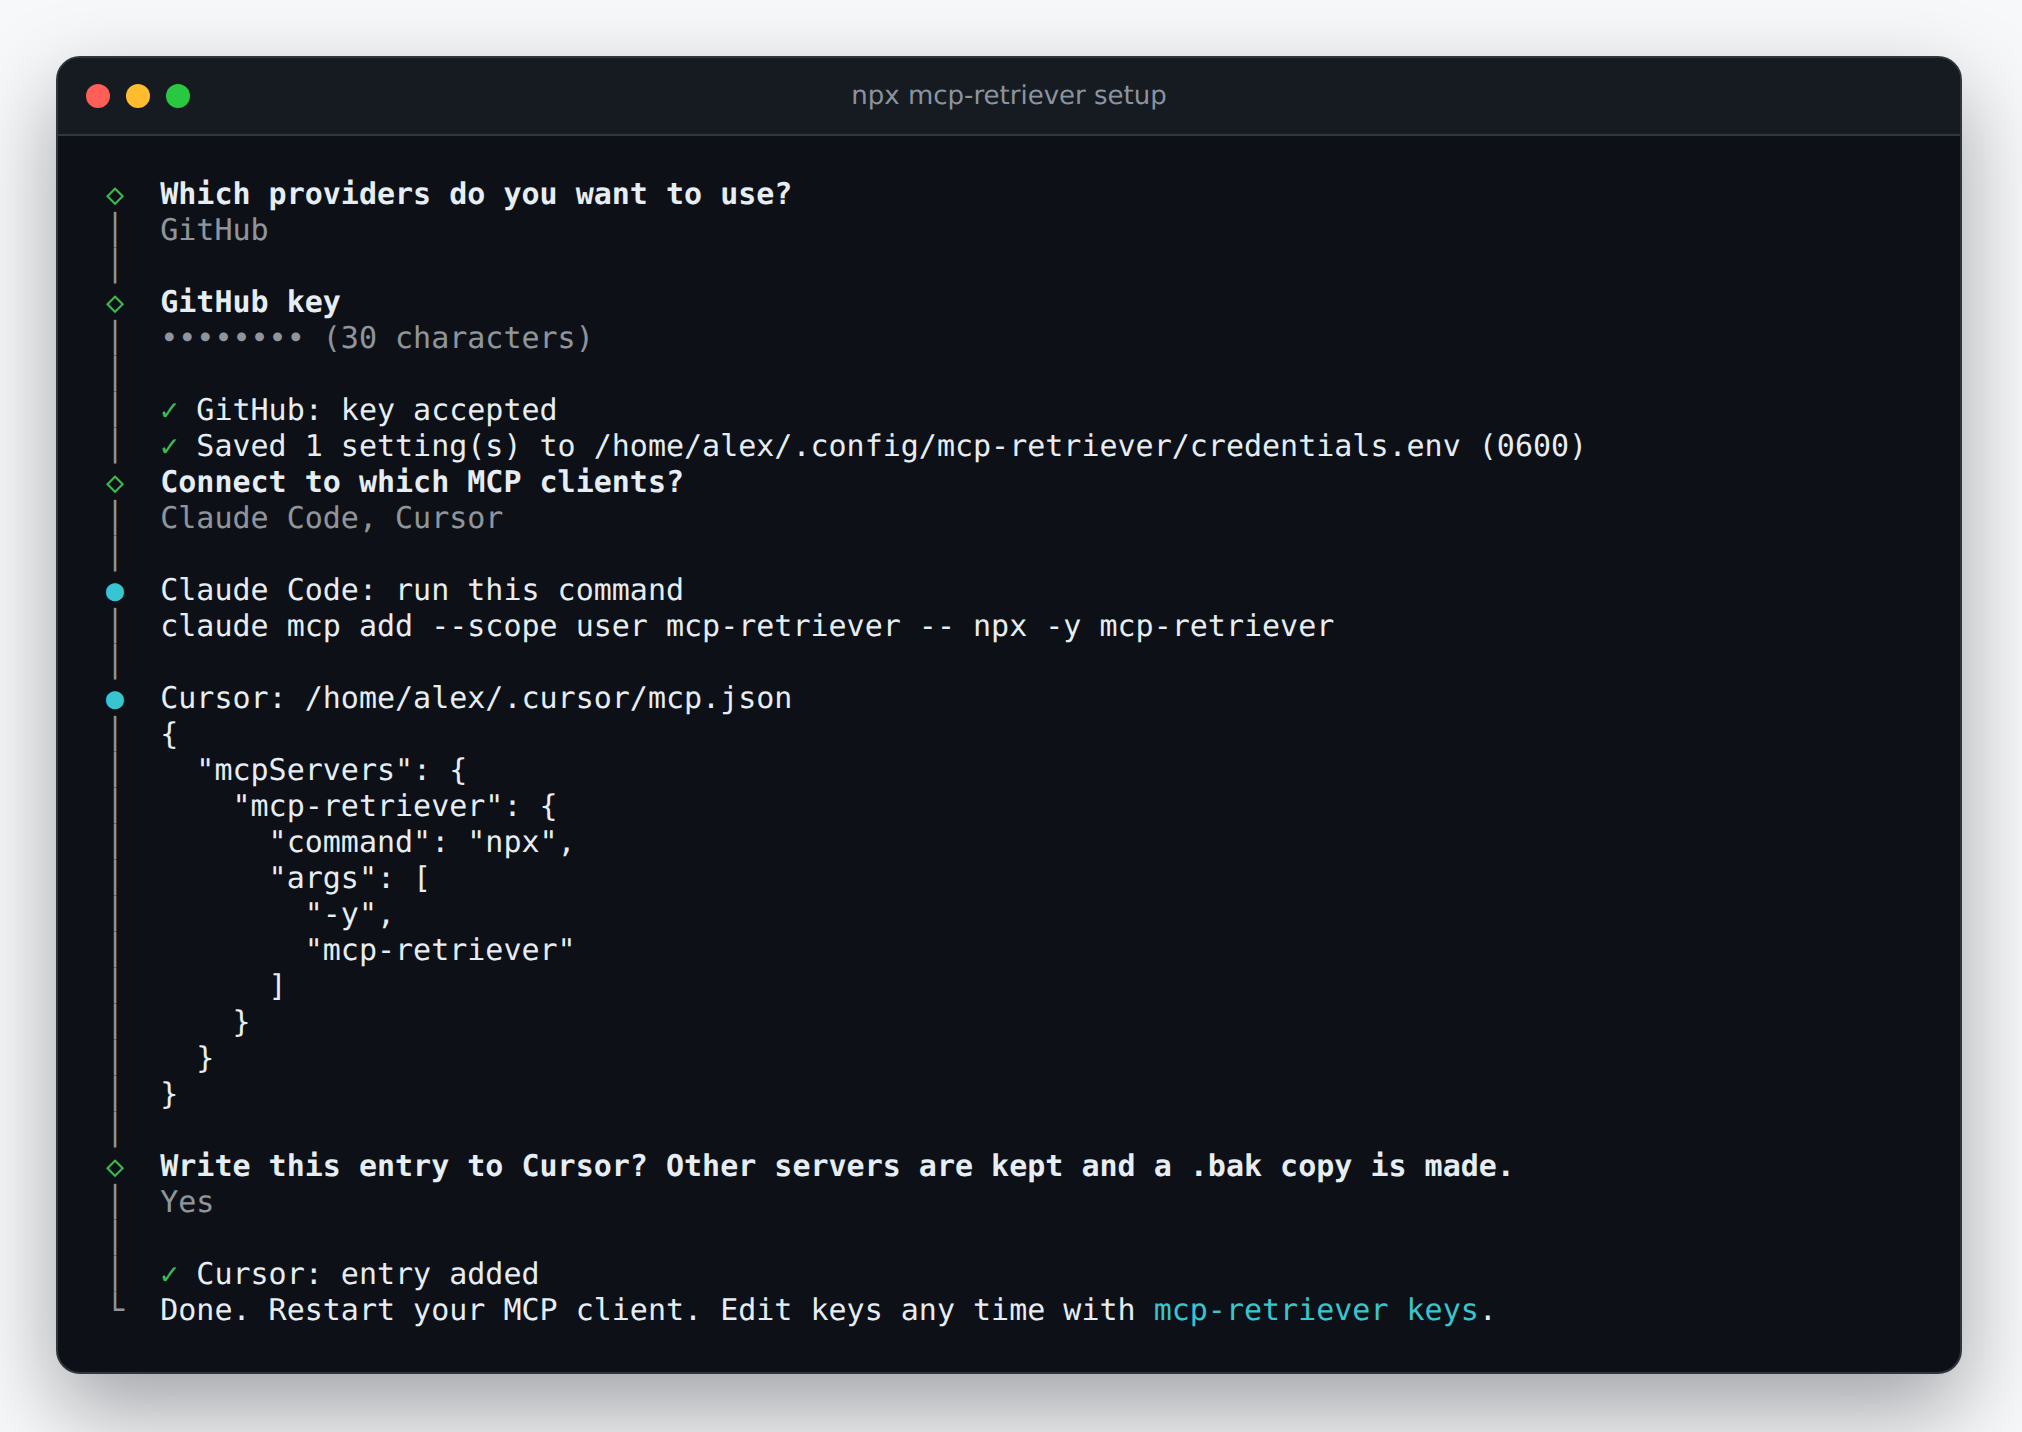
选择提供商,私下保存密钥,并连接 MCP 客户端。 向导会写入 Claude Desktop 和 Cursor 配置项,或显示 Claude Code 和 Codex 的命令/配置。检查计费密钥前 需要征得同意。
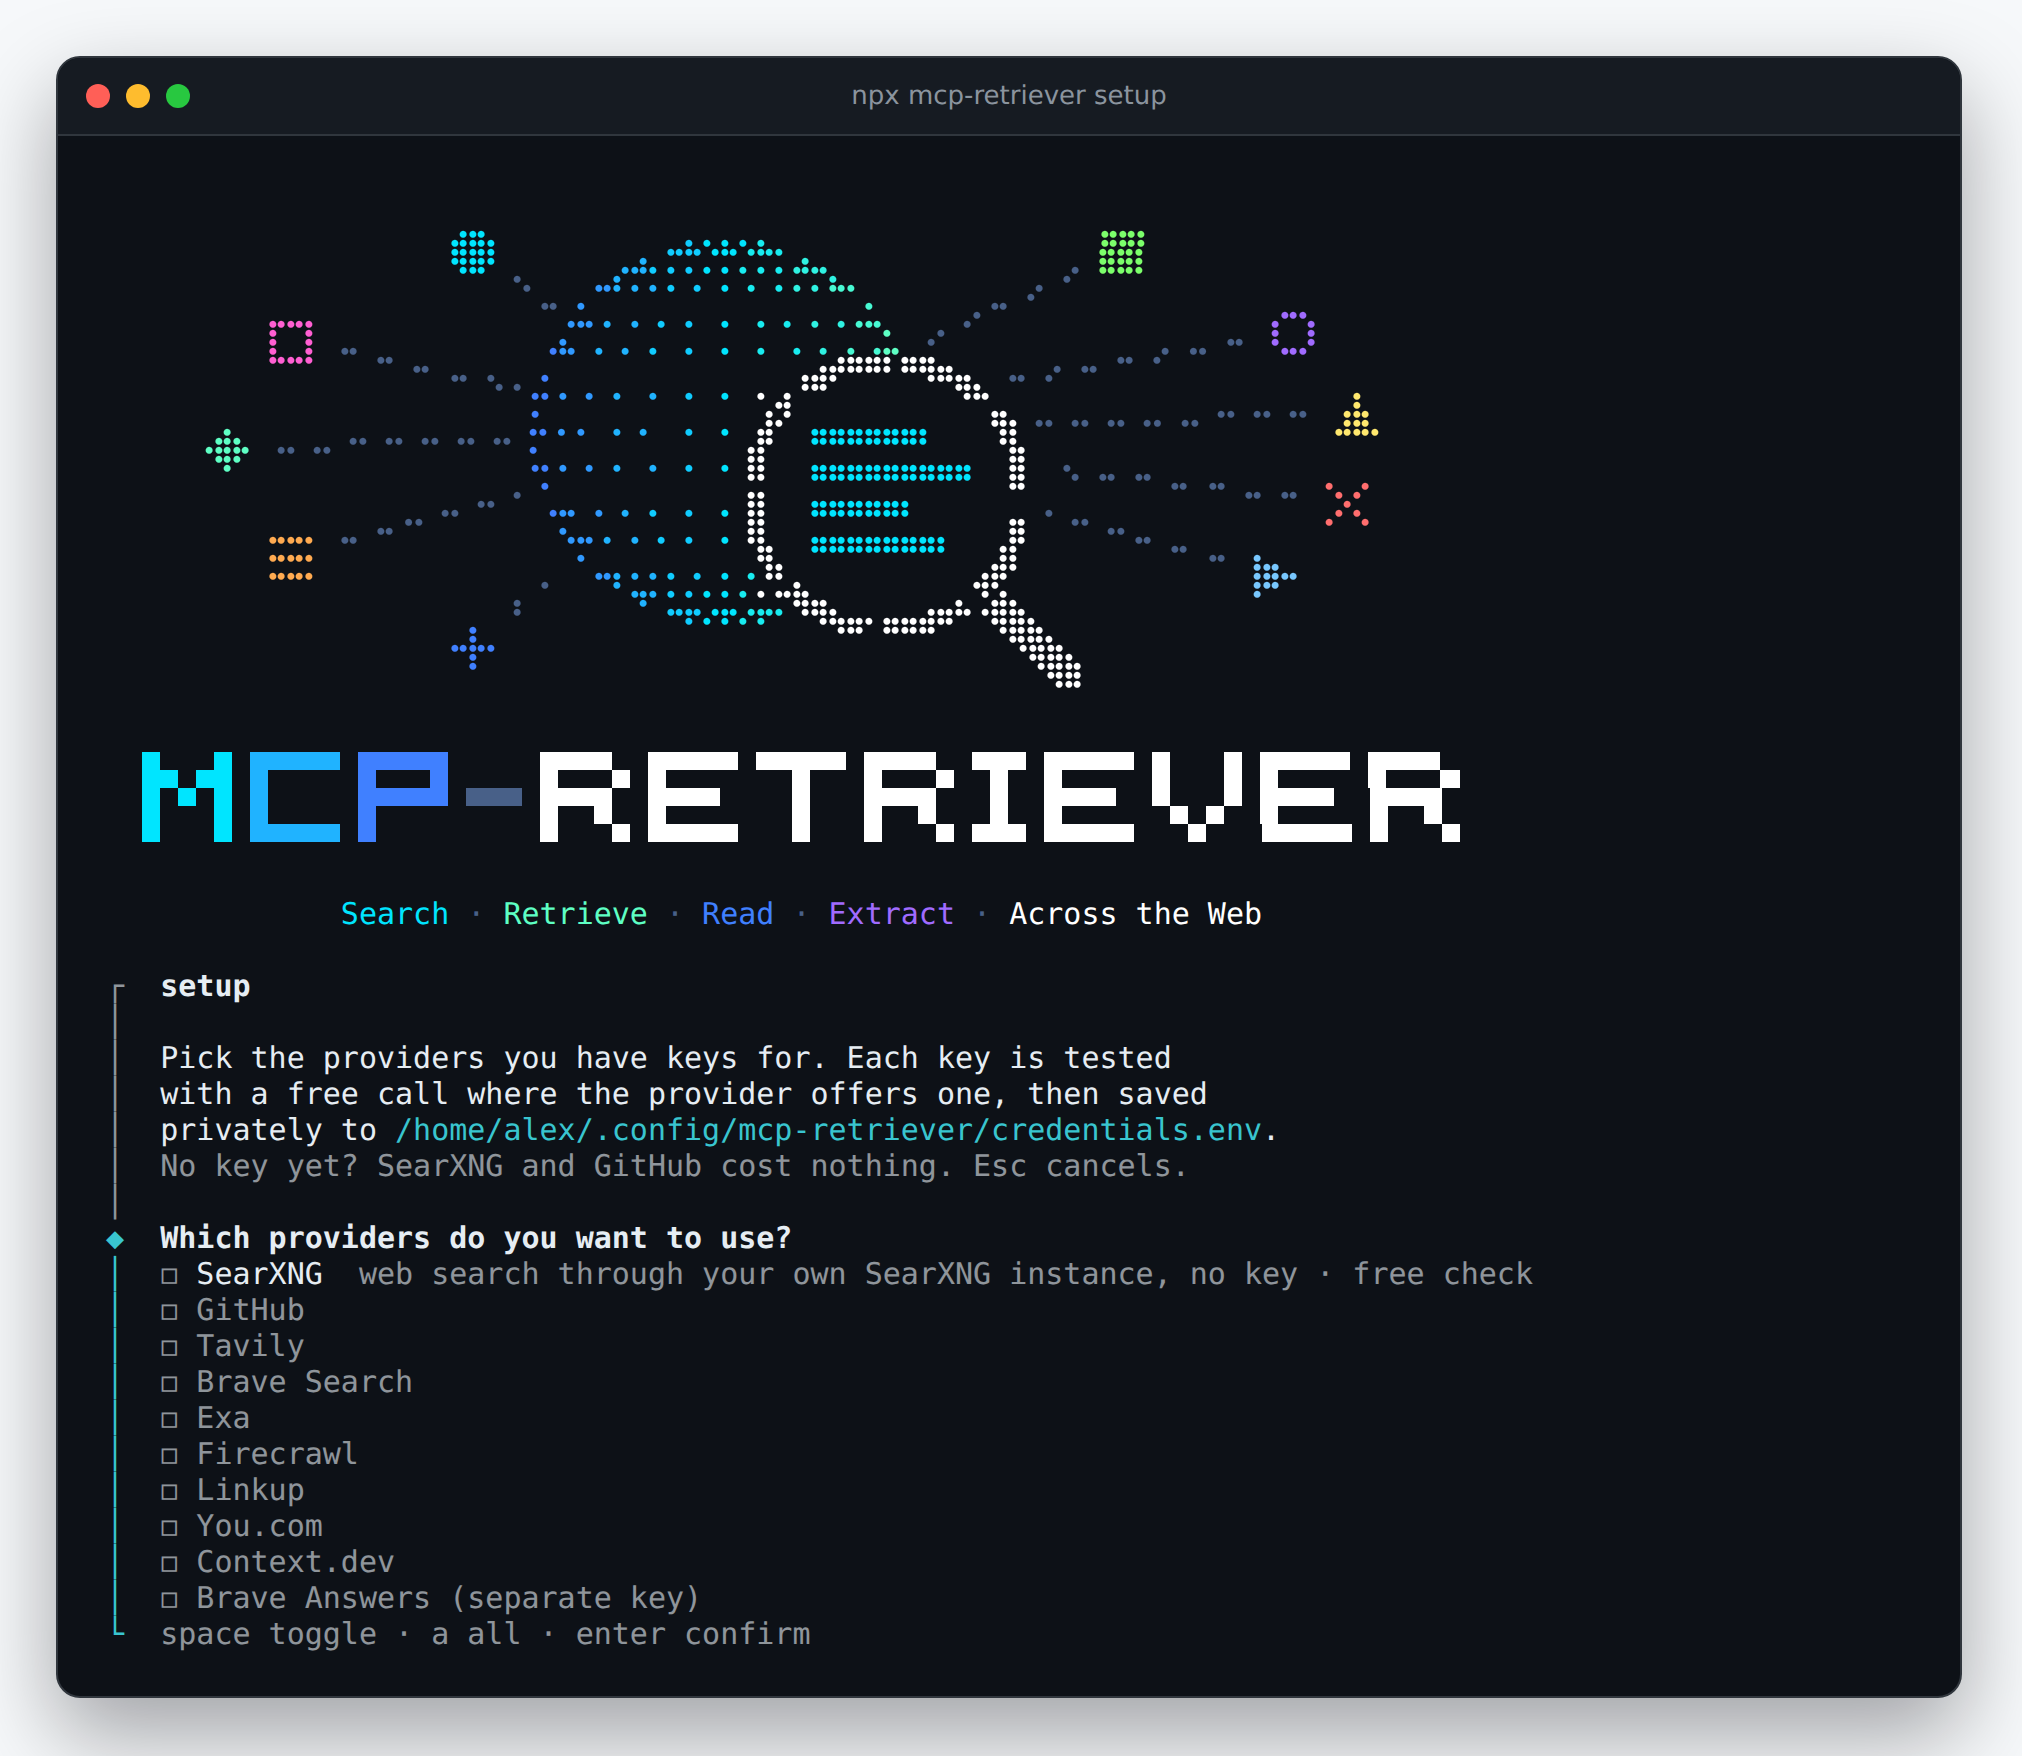
密钥存储在 ~/.config/mcp-retriever/credentials.env 中,而不是
客户端配置中。设置完成后,请重启客户端。
客户端连接和密钥管理
添加、测试或移除密钥:
npx mcp-retriever keys
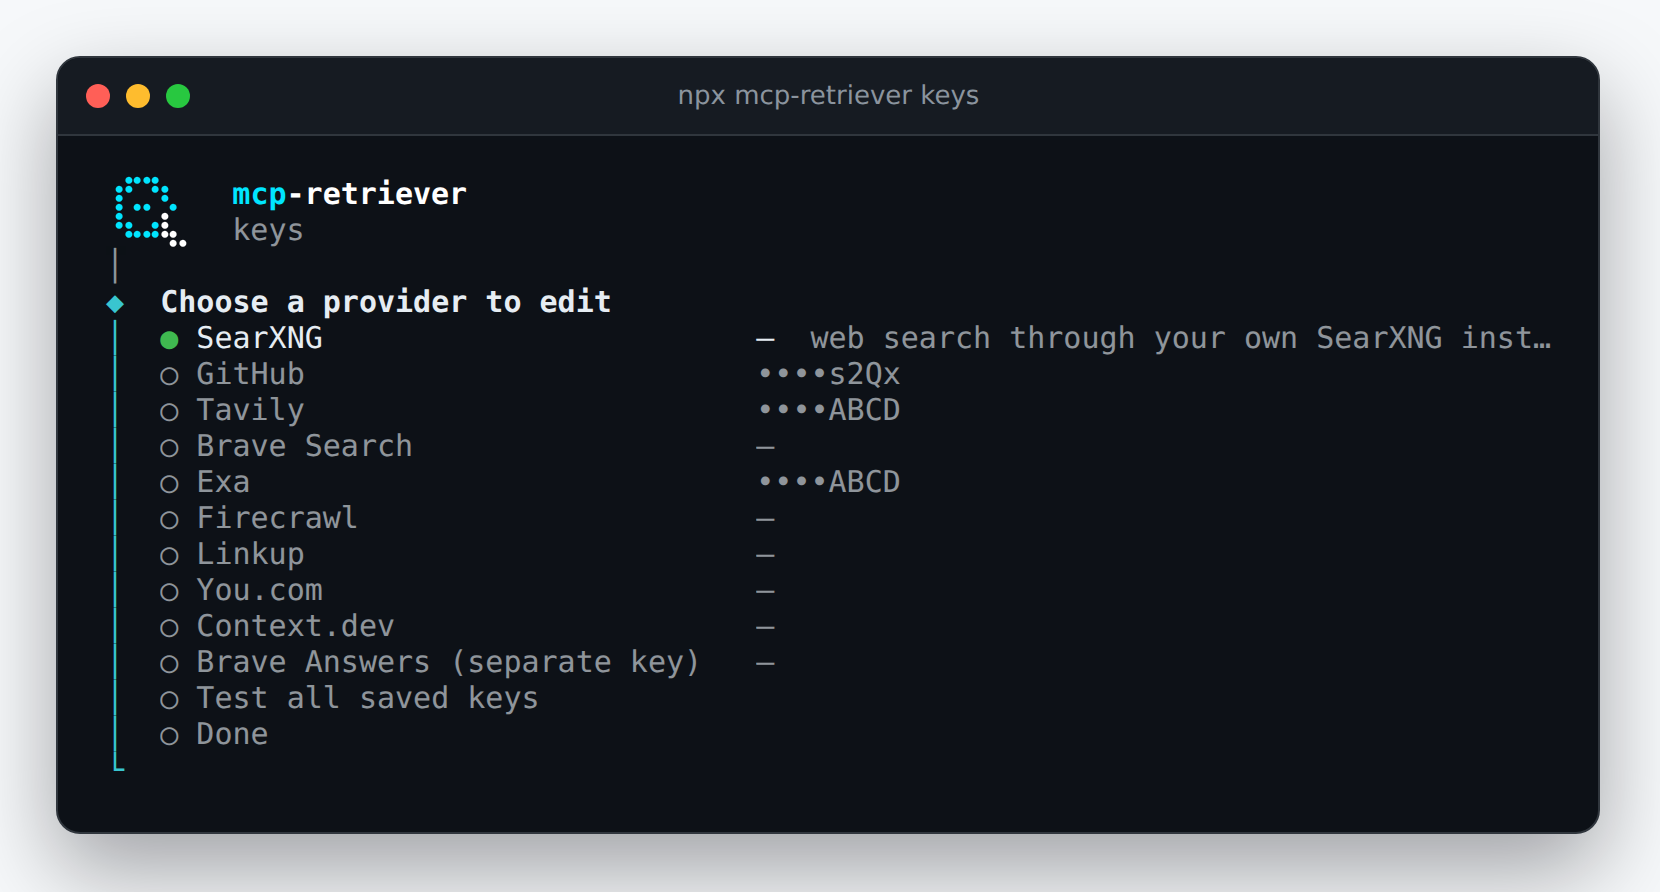
截图展示的是使用模拟凭据和模拟密钥检查响应的演示会话,并非对实际提供商的验证。
示例
使用两个已配置的搜索提供商调用 web_search_fused:
{
	"query": "reciprocal rank fusion hybrid search",
	"providers": ["brave", "exa"],
	"limit": 3
}
结果包含来源提供商和合并后的排名。如果某个提供商发生故障, 仍会返回可用结果,并附上各提供商的状态。
文档
每个服务实例共用一个信任边界。请勿将其结果存储用于彼此不信任的客户端。支出上限依据提供商报告的用量,而非估算成本。
许可证和来源
MIT。
该项目原名为 mcp-omnisearch,是 Scott Spence 的
mcp-omnisearch 的持续维护分支。升级此分支时,请将 OMNISEARCH_* 设置重命名为 RETRIEVER_*,
将 omnisearch:// 资源改为 retriever://,并将 _meta.omnisearch 改为
_meta.retriever。迁移到 ~/.cache/mcp-retriever/results 时,请保留旧的结果存储和支出记录;Docker/MCPO 客户端
也必须将 /omnisearch 改为 /retriever。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。