关于 context-doctor
context-doctor 是面向开发者和 API 使用者的本地工具集,用于测量并减少 AI Agent 会话中的冗余上下文。它分析 Token 成本,并提供上下文打包、钩子和可选的代理自动处理功能,无需 API 密钥,也不发送遥测数据。
主要功能
- 01测量 Token 用量和估算成本
- 02打包相关文档与代码片段
- 03回忆会话记录中的相关内容
- 04提示词与压缩钩子
- 05本地代理或 SDK 封装自动处理
适用场景
- 01检查 Agent 会话的 Token 开销
- 02按预算精简检索到的文档
- 03审查拉取请求中的记忆文件增长
- 04减少 API 请求中的过期工具输出
MCP 相关
它的 MCP 服务提供 `pack_context`、`recall` 等工具,用于筛选相关内容和检索会话记录片段。可通过客户端的服务配置或 Claude Desktop bundle 添加该服务。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
4收录的工具列表 · 更新于 今天
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| model | string | 否 | 用于计算上下文窗口的目标模型名称,例如 claude-sonnet-5 或 gpt-4o |
| sketch | object | 否 | 聊天应用中对话的粗略描述。为每个内容块提供一个大小提示:代码用行数,散文用词数,日志和工具输出用字符数(或 Token 数);这些内容每行大小差异最大。 |
| sketch.model | string | 否 | 此聊天使用的模型,例如 claude-sonnet-5、gpt-5 |
| sketch.turns | integer | 是 | 目前为止的用户与助手交流轮数 |
| sketch.blocks | array | 是 | 仅列出超过约 500 个 Token、重复出现或包含图像的内容块。无需列出普通对话轮次。 |
| conversation | string | 否 | 对话 JSON(OpenAI 或 Anthropic 格式,或裸消息数组)或原始提示词文本。在聊天应用中省略此项并传入 `sketch`。 |
详细介绍
context-doctor 🩺





查看 AI Agent 的 token 都花在哪里,并停止为毫无作用的 token 付费。
AI Agent 会在每条消息中重新发送整个上下文:旧的工具输出、粘贴的文件、冗长的指令。一个 500k-token 的会话每次都会为所有内容再次付费;喝杯咖啡回来后,提示词缓存过期,还得按全价付费。context-doctor 会在你自己的会话中以美元计量这些浪费,并在真正能省钱的时机将其消除:在内容进入上下文之前、驻留在上下文期间,以及每次请求时。它在你的机器上运行,无需 API 密钥,不发送遥测数据,适用于 Claude Code(终端、IDE、桌面应用)、Claude Desktop、ChatGPT、Codex、Cursor、Gemini CLI、GitHub Copilot、任何使用 Anthropic、OpenAI 或 Gemini API 的应用,以及 CI。采用 MIT 许可,支持 Node 20+、macOS、Linux 和 Windows。
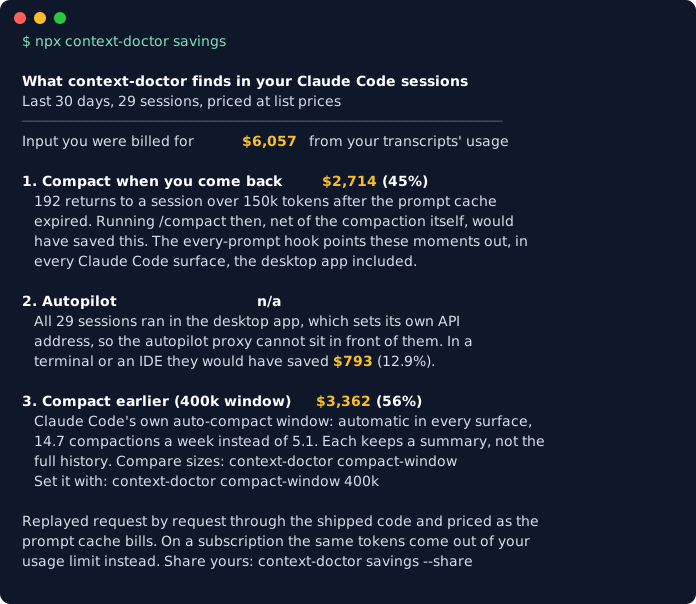
npx context-doctor savings # what your recent sessions cost, and what each fix would have saved
这是哪个 context-doctor? 有几个项目使用了这个名称。这里介绍的是 npm 上的
context-doctor,以及官方 MCP Registry 中的io.github.KushalP1/context-doctor(查看条目)。Registry 是一项服务,并非 GitHub 仓库中的列表:modelcontextprotocol/servers仓库只收录参考服务,其他服务请见 Registry。由 gAI Ventures 构建并维护。
快速开始
选择你的工作环境。每种方式都只需约一分钟,且完全可逆。
| 你使用的环境 | 操作 |
|---|---|
| Claude Code(终端、IDE、桌面应用) | 在 Claude Code 中:/plugin marketplace add KushalP1/context-doctor,然后运行 /plugin install context-doctor@context-doctor。你将获得每次提示词检查、压缩钩子、MCP 工具,以及 /context-doctor:savings、:checkup、:overhead、:pack、:autopilot、:compact-window |
| 一次性配置这台机器上的所有环境 | npm install -g context-doctor && context-doctor install 会为 Claude Code、Claude Desktop、Cursor、Codex、Gemini CLI、Google Antigravity 和 GitHub Copilot 配置 MCP 服务、技能和钩子(写入内容)。context-doctor doctor 可检查配置;context-doctor uninstall 可移除配置。然后,对于终端或 IDE 中的 Claude Code,运行 context-doctor autopilot on |
| Claude Desktop、Cursor 或任何 MCP 客户端 | 将服务添加到客户端的 MCP 配置中(或者在 Claude Desktop 中安装最新版本提供的一键安装包 .mcpb):{"mcpServers": {"context-doctor": {"command": "npx", "args": ["-y", "context-doctor", "mcp"]}}} |
| claude.ai、ChatGPT、手机应用 | 运行 npx context-doctor instructions --copy,然后将内容粘贴到应用的个人偏好设置中(它会告诉你具体位置)。ChatGPT 也可以通过 URL 连接 MCP 服务(了解方法) |
| 你自己的 LLM API 应用 | 运行 npx context-doctor proxy --autopilot,并将 ANTHROPIC_BASE_URL、OPENAI_BASE_URL(添加 /v1)或 GOOGLE_GEMINI_BASE_URL 指向 http://127.0.0.1:8787。无法使用代理?可以封装 SDK 客户端:withContextDoctor(new Anthropic())(库) |
| Python / RAG 流水线 | 运行 pip install "git+https://github.com/KushalP1/context-doctor#subdirectory=python"(即将发布到 PyPI),然后使用 pack_documents(retrieved_docs, question, budget=4000),将 LangChain 或 LlamaIndex 的结果精简为相关片段。Python README |
| GitHub 拉取请求 | 使用 uses: KushalP1/[email protected],它会评论 PR 对 CLAUDE.md、AGENTS.md 和规则文件大小的影响,并可在超出预算时使检查失败(配置方法) |
功能
基于你自己的历史记录,以美元计量(分析)
savings:你最近的 Claude Code 会话花费了多少,以及下方各项修复本可为你省下多少;逐个请求重放,并与实际账单对照。overhead:每个请求在收到你的消息前都会重新读取哪些内容(系统提示词、工具、MCP 服务、CLAUDE.md、规则、记忆),并按月计算每个文件的费用。tasks、reads、subagents、compactions:每次提交的费用;哪些文件在一个又一个会话中被读取;每个子 Agent 是否比在父 Agent 中执行相同步骤更省钱;会话在压缩后是否表现更差。cache-misses:在提示词缓存本应仍处于热状态时,却重新写入缓存的请求;按模型和上下文大小计价,并在转录记录中显示原因时一并注明。limits:你的方案的 5 小时和每周额度窗口(Claude Pro/Max,由状态行记录)以及 Codex 的额度窗口、消耗速度和各自耗尽时间;每种类型的 100 万个令牌占额度的百分比,以及基于你自己的读数拟合的结果和误差。cache-plan <request.json>:Anthropic API 请求应在哪处携带cache_control,以及调用 N 次可节省多少费用。session、watch、analyze、report、dashboard:任何会话、对话文件或 Agent 轨迹的令牌明细和上下文浪费分析。
避免上下文中的浪费(打包与开销)
pack(以及pack_contextMCP 工具):从大型文档、PDF、日志或代码库中,只提取问题所需的内容,并控制在令牌预算内,而不是使用全部内容。recall(以及recallMCP 工具):从本次会话的转录记录中找出问题所需的少量行,包括被压缩总结掉的轮次,以及被自动驾驶清除的工具输出;附带时间和位置,并屏蔽机密信息。overhead split:将臃肿的 CLAUDE.md 或记忆文件拆分为精简文件和参考文件,Agent 需要时再打开;逐字保留,不遗漏任何内容。ci和 GitHub Action:像检查其他费用一样,检查记忆文件的增长。
自动消除浪费
- 模型切换警告(
PreModelSwitch,Claude Code 2.1.251+)会在切换发生前显示/model切换的费用:将整个上下文重新写入新模型的缓存。 - 子 Agent 费用提示(Agent 工具上的
PreToolUse)会在子 Agent 启动前显示其费用,按你自己的该类型中位数计算(作者的数据:通用型 $3.99、Explore $1.43,30 天内运行 422 次);若在 Opus 或 Fable 上运行,还会显示 Sonnet 价格;多个启动聚集时则显示总费用。它绝不会阻止启动。 - 压缩钩子(
PreCompact)会告诉每次 Claude Code 压缩哪些内容不能丢失(已更改的文件、未完成的任务、你的指令、失败的测试),让压缩既能节省令牌,又不会丢失上下文。 - 每次提示词钩子(Claude Code、Codex、Gemini CLI;Cursor 在每次工具调用后)会告诉模型真实的上下文大小和最大浪费,并在缓存过期后你返回大型会话时建议使用
/compact。 compact-window:设置 Claude Code 自带的自动压缩窗口,先基于你的历史记录进行测量。桌面应用中也可使用。- Autopilot:本地代理(或 SDK 包装器),仅在提示词缓存冷却时清除过时的工具输出,确保请求费用不会增加。
可节省的费用
在作者机器上的每个 Claude Code 会话中进行实测,而非建模估算(主要使用 Opus 5 和 Fable 5,采用 1M 窗口);按照提示词缓存的计费方式和 API 标价计算(缓存读取按各模型的读取费率计费,为输入价格的 2.5-10%;写入费用为输入价格的 1.25 倍,适用于 5 分钟缓存,1 小时缓存则为 2 倍)。于 2026-10-13 重新测量,每个请求均按其对应模型和当前价格计算(Opus 5.5 每 100 万个输入令牌收费 $4,读取费用为 $0.20)。context-doctor savings 可对你的数据执行相同测量。
1. 返回时压缩上下文(适用于 Claude Code 的所有界面,包括桌面应用)。133 天内,在提示词缓存过期后,479 次返回到超过 150k 个 token 的会话(1 小时缓存闲置 65 分钟后过期;Claude Code 2.1.295 经常写入的 5 分钟缓存则闲置 10 分钟后过期);返回时的上下文中位数为 522k 个 token。
如果在首次回复后运行 /compact,净节省金额 | $2,993(每月约 $675) |
| 能省下费用的返回次数 | 479 次中的 342 次 |
| 单次最差情况 | −$1.79(会话在几条消息后就结束) |
每次返回只计算到下次返回前的消息,并将压缩请求计入费用。未计入:模型压缩后可能重新读取的文件,以及摘要遗漏的内容。因此,这是一条附有数据的建议,而不是替你自动执行的操作。
2. 自动驾驶(在终端或 IDE 中运行的 Claude Code、API 应用)。133 天内的 67 个会话,使用已发布的自动驾驶代码并依据真实时间戳重放:
| 不使用自动驾驶 | 使用自动驾驶 | 节省 | |
|---|---|---|---|
| 按 API 目录价格计算的输入费用 | $11,347 | $9,905 | $1,442(12.7%,每月约 $325) |
| 费用增加的会话数 | 67 次中 0 次 |
67 个会话中有 30 个能省钱,最高可省 34.9%:长时间闲置的会话最能省钱。这些会话在桌面应用中运行,自动驾驶无法访问,因此对作者来说,这些数据反映的是同一批会话在终端中的节省金额;context-doctor savings 会为你区分这两种情况。工作原理 →
3. 提前压缩上下文 (自动运行,适用于 Claude Code 的所有界面,包括桌面应用)。第 1 条中的做法只是建议;在作者的机器上,33 次中只执行了 1 次。Claude Code 有一项原生设置,无需任何人手动执行:在 ~/.claude/settings.json 中设置 autoCompactWindow,即可让它按指定窗口大小进行压缩。context-doctor compact-window 会按请求重放每个会话,测试多个窗口大小,并按缓存的计费方式计算费用(每次模拟压缩都会计入自身请求费用,以及按输出费率计价的 20k-token 摘要);在你选定窗口前,不会更改任何设置:
| 窗口 | 过去 30 天的输入费用 | 节省 | 每周压缩次数 |
|---|---|---|---|
| 当前设置(约 970k) | $3,648 | 4.7 | |
| 600k | $2,242 | $1,405(39%) | 6.5 |
| 400k | $1,814 | $1,833(50%) | 14.2 |
| 300k | $1,664 | $1,983(54%) | 25.2 |
| 200k | $1,501 | $2,146(59%) | 48.1 |
41 个会话。这样做确实有代价:每次压缩都会用摘要替换会话历史,因此窗口越小,细节损失越多,省下的钱也越多。这就是为什么命令会先显示表格,只有在你指定窗口大小后才会设置(context-doctor compact-window 400k;off 可撤销设置,并会保留 settings.json 的备份)。
另有测量结果:
- **打包:**关于此代码库的 10 个问题中,有 9 个只用其 0.6% 的 token 就能回答。了解详情 →
- **准确计算 Claude 的 token:**当前 Claude 模型处理普通文本时,每个 token 对应 2.75 个字符(代码为 2.4 个),而不是大多数工具假设的 4 个:与通常的“4 个字符对应 1 个 token”规则相比,Claude 计算出的 token 数多约 40%(普通文本约多 45%,代码约多 33%)。
context-doctor accuracy会根据你自己的会话重新检查比例。原因 →
使用 Claude 订阅时,你无需按目录价格付费;相同的 token 会从你的使用额度中扣除。Anthropic 没有公布缓存 token 在额度中的计费权重,因此请将这些金额视为影响程度,而非实际账单。
适用范围
| 工作位置 | 每个请求自动执行 | 额外提供的功能 |
|---|---|---|
| 终端、VS Code 或 JetBrains 中的 Claude Code | Autopilot 清除过时的工具输出(仅限冷缓存,绝不会增加成本)。每次提示词都会运行 Hook:显示实际上下文大小、最大的浪费,以及当你在缓存过期后返回较大的会话时提供 /compact 建议。每次压缩都会运行 Compaction hook。可设置 compact-window | 可通过 npm 安装或作为 插件 安装。状态栏上下文计量器、/context-doctor:savings、session、watch、report、仪表板、MCP 工具 |
| 桌面应用 Code 标签页中的 Claude Code | Hooks,同上;缓存过期后恢复会话时,/compact 建议也会显示给你和模型。可设置 compact-window:Claude Code 会自行更早进行压缩。不是 autopilot:应用会设置自己的 API 地址,并忽略设置中的地址 | 同上 |
| Cursor(agent) | 原生的 after-tool-call hook(~/.cursor/hooks.json):在内容较多的聊天中,agent 每当上下文增长 40% 就会收到相同的清理建议和最大的浪费。(Cursor 的 prompt hook 只能允许或阻止提示词,因此这是建议传达给模型的时机) | MCP 工具、编辑器状态栏扩展、cursor 分析器。使用你自己的 OpenAI 密钥时,也可通过带令牌的隧道启用 autopilot(方法) |
| Codex(ChatGPT 应用的 Codex 标签页、IDE 扩展、CLI) | 每次提示词都会运行 Hook,并使用 API 自带的 token 计数 | MCP 工具、技能,session 会读取 Codex rollout。使用 API 密钥时,也可启用 autopilot(autopilot on 会在 ~/.codex/config.toml 中设置 openai_base_url;Codex 不再读取 OPENAI_BASE_URL) |
| Gemini CLI | 每次提示词都会运行 Hook(BeforeAgent),并使用 API 自带的 token 计数。使用 API 密钥时,也可启用 autopilot:GOOGLE_GEMINI_BASE_URL=http://127.0.0.1:8787(Google 登录流量会走其他路径) | MCP 工具,session 和 watch 会读取其聊天记录,overhead 会计算 GEMINI.md 的大小 |
| GitHub Copilot(Copilot CLI、Copilot 应用、VS Code agent 会话) | 会话启动 Hook(~/.copilot/hooks/context-doctor.json)会向每个新会话或恢复的会话提供常驻规则。不检查大小:Copilot 只会向无法添加上下文的 Hook 传递转录内容 | MCP 工具(~/.copilot/mcp-config.json,VS Code 的 Copilot 会话也会读取该文件) |
| 你在 Anthropic、OpenAI 或 Gemini API 上的自有应用 | 对 /v1/messages、/v1/chat/completions、/v1/responses 和 Gemini 的 generateContent 启用 autopilot(ANTHROPIC_BASE_URL / OPENAI_BASE_URL / GOOGLE_GEMINI_BASE_URL),或使用优化代理(处理缓存流量时成本可能更高);无法使用代理(无服务器、边缘环境)?withContextDoctor(client) 会在 SDK 客户端内运行 autopilot | /stats 中的精确用量和缓存命中率、提示词缓存放置建议(代理) |
| Claude Desktop 聊天 | 下方的六条常驻规则会发送到每次聊天中(尚未确认经典版 Chat 是否会将它们展示给模型,原因);模型会在约 30 轮对话后,以及遇到任何成本问题时,调用一次低成本的 profile_context;使用 pack_context,而不是完整读取大型本地文件;聊天变长后会提供交接选项,因为无法截断聊天历史,但可以开启新聊天 | 一键安装 .mcpb、context_checkup、handoff 和 ask_file 提示词、用于在下一次聊天中附加内容的 handoff://latest(交接) |
| claude.ai、ChatGPT、手机应用 | 你的账户常驻偏好设置,粘贴一次即可(快速入门) | 使用 analyze 或 session 分析导出的聊天记录。ChatGPT 开发者模式:通过 URL 使用 MCP 工具,将上传内容交给 pack_context(方法) |
| CI | analyze --fail-over-budget 会在提示词超出预算时令构建失败;GitHub Action 会限制记忆文件的增长 | .contextdoctorrc 预算和预设(CI) |
| 这项功能不声称适用于以下场景,因为你的机器上没有进程会发送这些请求:Claude Desktop 聊天、claude.ai、ChatGPT、Cursor 自带订阅模型,或使用 ChatGPT 登录的 Codex 中的内容精简。这些场景只会获得上述规则和测量数据,而不会自动执行。 |
MCP 服务会将这些常驻规则原样交给每个启用了它的聊天(Cursor 和 Claude Code 会将它们放在模型面前;对于 Claude Desktop 的经典 Chat,这一点未经验证):
- 当有人询问 token、成本、速度或限制时,以及大约进行 30 轮对话或粘贴 3 次以上大段内容后:在回答前调用 profile_context;在聊天应用中传入一个
sketch。根据其最重要的发现采取行动。不要自行估算 token 数量。- 当聊天内容变得很长时,主动提出一次交接(save_handoff):只有开启新聊天才能截断其历史记录。
- 将任何超过约 2k token 的粘贴内容或工具结果总结为所需要点。
- 按名称引用前文;绝不重新引用它,也不要内联 base64。
- 对于你不会编辑的大型文件,带上问题调用 pack_context;不要通读整个文件。
- 如果 optimize_context 返回了已精简轮次的摘要,请写出其不超过 150 token 的总结。
规则 1-4 恰好在第 512 个字符处结束,这是 ChatGPT 指南要求必须独立呈现的部分。
命令
| 命令 | 功能说明 |
|---|---|
context-doctor install / uninstall | 配置(或移除)它找到的所有内容:为 Claude Desktop、Claude Code、Cursor、Codex、Gemini CLI、Google Antigravity 和 GitHub Copilot 配置 MCP 服务;配置 Agent Skill(Claude Code、Codex、Antigravity);配置每条提示词钩子(Claude Code、Codex、Gemini CLI 的 BeforeAgent、Cursor 的 postToolUse、postToolUseFailure 和 sessionStart);配置 Claude Code 的 PreCompact、SessionStart、PreToolUse(子 Agent 价格)以及 2.1.251+ 版本中的 PreModelSwitch 钩子;配置 Copilot 的 sessionStart(常驻规则)。--statusline 会添加状态栏行(详情) |
context-doctor doctor | 对整个安装进行自检——输出一份可直接复制的 ✓/✗ 诊断结果和修复方法,包括 autopilot 能触及的界面,以及端口上运行的任何其他程序 |
context-doctor savings [--days n] [--share [--copy]] | 查看最近的 Claude Code 会话费用,以及在冷启动恢复时执行 /compact、使用 autopilot 和提前触发自动压缩窗口可节省的费用;使用随附代码,根据你的实际计费使用量重放计算。--share 仅输出总计(不含项目名称或路径),方便发布。在终端中直接运行 context-doctor 会显示相同内容 |
context-doctor autopilot on|off|pause|resume|status | 每个在终端或 IDE 中启动的 Claude Code 新会话都会经过本地代理。只有提示词缓存处于冷状态时,代理才会清除过期工具输出:实测输入费用降低 12.7%,没有任何会话变差(详情) |
context-doctor proxy --autopilot | 为你自己的 Anthropic、OpenAI 和 Gemini API 应用提供本地代理:只有提示词缓存处于冷状态时,才会清除过期工具输出,因此费用绝不会增加。普通的 proxy 会运行优化策略(去重、裁剪、移除 base64),处理缓存流量时可能增加费用。使用 --token 获取公共 URL;使用 /stats 查看累计节省额(详情) |
context-doctor compact-window [status|off|<size>] | 将最近 30 天的数据按 200k 到 800k 的自动压缩窗口重放:查看输入费用、节省额以及每种设置多触发的压缩次数。400k(或 250000、0.4m)会设置 Claude Code 的 autoCompactWindow,并先创建备份;off 会移除该设置。适用于所有 Claude Code 界面,包括桌面应用 |
context-doctor instructions [--copy] | 约 190 个 token 的常驻规则(GPT 上约 130 个),用于 claude.ai / ChatGPT 偏好设置,适用于没有运行 MCP 服务的网页和手机 |
context-doctor handoff [list|show <id>|latest] [--copy] | 列出从聊天应用保存的交接内容(通过 handoff 提示词或 save_handoff 保存)、打印其中一条,或复制内容以用作新聊天的第一条消息(交接) |
context-doctor mcp [--http] | 以子命令形式运行 MCP 服务,供通过 npx -y context-doctor mcp 启动服务的客户端和注册表使用 |
context-doctor-mcp | MCP 服务本身——默认使用 stdio(安装程序配置的方式);--http [--port 8808] [--host H] [--allowed-hosts names] [--allowed-origins list] [--store-handoffs] 会在 /mcp 提供可流式传输的 HTTP,供基于 URL 的客户端使用,例如 ChatGPT 开发者模式连接器(仅限其已知的主机名:通过隧道访问时,将隧道名称传给 --allowed-hosts) |
context-doctor session [file] | 分析 Claude Code 会话:实时上下文、发现项、实测 token 数和提示词缓存成本、每个工具耗费的时间、输出与推理所占费用比例、按费用计算的重复相同(轮询)工具调用,以及子 Agent 的费用(它们自己的窗口,计入你的账单;不会出现在父会话的分析结果中)。也可读取 Codex rollouts、Gemini CLI 聊天记录和 ChatGPT 数据导出文件(conversations.json);使用 --list 浏览 |
context-doctor watch [file] | 实时监视不断增长的会话转录或 Agent 跟踪记录(Claude Code / Codex JSONL,或普通的 OpenAI/Anthropic 对话 JSON 文件):每次变更都会显示 token/费用行,并实时呈现发现项 |
context-doctor cursor [--list] | 分析 Cursor 本地历史记录中的聊天(支持两种存储格式) |
context-doctor analyze <file> | 分析对话:token 明细、发现项、费用和延迟估算。--exact 会添加精确计数;--fail-over-budget 在超出预算时以状态码 1 退出,供 CI 使用 |
context-doctor optimize <file> | 应用安全修复;对于大型内联文件写入,添加 --strategy trim-tool-calls;对于经同意的有损压缩,添加 --strategy prune-history(各策略的功能) |
context-doctor diff <before> <after> | 比较两个分析结果:按类别查看变化、哪些发现项已解决或新增,以及节省的费用和延迟 |
context-doctor overhead [--days n] [--mcp] | 查看每条请求在你的消息之前重新读取的内容:实测首次请求大小(Claude Code、Codex 和 Gemini CLI 会话)、各记忆文件(CLAUDE.md 及其导入文件、规则、自动记忆、AGENTS.md、Cursor 规则、GEMINI.md)的月度费用,以及每个服务的 MCP 调用情况;--mcp 会统计每个已配置服务的工具定义大小,并标记未使用的服务 |
context-doctor overhead prune [--days n] [--write] [--undo] | 按项目列出其会话在 n 天内从未使用的 MCP 服务和技能;--write 会在该项目的 .claude/settings.local.json 中关闭这些服务(保留备份,并记录每个条目);--undo 会准确恢复这些条目。绝不会修改应用的连接器、插件或 context-doctor 本身 |
context-doctor overhead split <file> [--min-tokens n] [--write] | 将记忆文件中的大型或代码密集型章节逐字移至 <name>.reference.md,并留下指针;保留索引。默认仅生成计划;使用 --write 才会写入,并会先备份 |
context-doctor pack <files|dirs|-> -q "…" | 从大型文档、日志或代码中,只选出问题所需的片段,按相关性排序,并控制在 --max-tokens 内(默认为 4000)。不指定查询时会生成大纲;使用 --ids a#2,b#5 从大纲中选取片段。--semantic 还会使用本地 Ollama 模型按含义排序。离线运行,无需密钥 |
context-doctor recall "<query>" [--session <id|path>] | 搜索此会话在磁盘上的转录记录(Claude Code 或 Codex;包括压缩前的轮次和已从上下文中清除的工具输出),并打印最相关的摘录及其时间和位置,同时屏蔽机密信息。除非通过 --session 指定,否则绝不会搜索其他项目的会话。也提供 recall MCP 工具 |
context-doctor tasks [--days n] | 按提交和项目查看费用:根据会话记录的使用量计算每个会话的费用,并与其产生的提交关联 |
context-doctor reads [--days n] [--limit n] | 查看每个会话读入的文件:读取次数、token 数、费用,以及 CLAUDE.md 摘要或 pack 是否值得使用 |
context-doctor subagents [--days n] | 查看哪些子 Agent 的投入物有所值:对比每个子 Agent 的费用与在父会话中执行相同步骤的费用 |
context-doctor compactions [--days n] | 查看会话在压缩后是否表现变差:对比每次压缩前后的重新读取、工具错误和你的更正情况 |
context-doctor cache-misses [--days n] | 查看在提示词缓存有效期内重写缓存的请求(期间没有压缩,之前的上下文超过 20k,其中超过 60% 被重新写入):按模型和上下文大小,依据高于缓存读取速率的价格计算;在原因可见时显示原因,并列出缓存未命中更少的模型版本;按 Claude Code 版本统计,并标记升级后的变化(1 小时缓存占比、首次请求大小、模型未命中率);使用 --json 按模型和版本输出 |
context-doctor limits [--days n] | 以各自单位查看套餐限制:各窗口的使用百分比、消耗速率和耗尽时间(Claude 的 5 小时和每周窗口取自状态栏读数,Codex 的窗口取自其 rollouts),以及每 1M 个输入、缓存读取、缓存写入和输出 token 占限制的百分比;根据你的读数拟合并显示拟合误差;数据不足时会明确说明,不会引用不可靠数值 |
context-doctor cache-plan <request.json> [--calls n] [--out file] [--explicit] | 指出 Anthropic API 请求应在哪些位置携带 cache_control(默认对动态末尾部分使用顶层自动缓存,除非指定 --explicit),并计算 n 次调用的节省额;--out 会将应用后的结果写入文件 |
context-doctor accuracy | 查看账单中有多少内容可在转录记录中看到(固定的 harness 基线、每轮注入的内容),并进行 tokenizer 检查:根据 API 自己的计数,列出各模型的实际字符/token 比率,并与估算器使用的比率对照 |
context-doctor report | 查看整台机器的影响报告(代理的节省额会跨重启保留):精确的代理节省额、钩子活动、冷启动恢复时 /compact 建议后实际执行压缩的频率,以及近期会话中可挽回的浪费 |
context-doctor dashboard | 在 127.0.0.1 上打开本地节省情况仪表板:每日节省的 token 数、按已用上下文与可挽回上下文分类的会话数、预算状态 |
context-doctor ci [--base <ref>] [--max-tokens n] [--max-increase n] [--markdown] | 对比 HEAD 与基础提交中的记忆文件(CLAUDE.md、AGENTS.md、GEMINI.md、规则及其导入文件);超出预算时以状态码 1 退出。GitHub Action 运行的内容(详情) |
context-doctor init [preset] | 根据预设(chat、agent、batch)写入 .contextdoctorrc——一条命令即可采用预算,之后还可调整 |
context-doctor experiment --task "…" | 从同一个提交开始,在全新会话和从 --existing 会话分叉出的会话中各运行一次任务,使用相同的模型和工具;对比账单、缓存构成、耗时,以及 --check 是否通过。这里唯一会产生费用的命令,因此会限制每组实验的支出,并拒绝在工作树有未提交更改时运行(详情) |
context-doctor ab [--lever …] [--yes] | 检验某项手段是否会影响质量:运行 8 个小型编码任务,每个任务都在一个精简仓库中执行,并由隐藏检查评分;通过 Messages API 对比启用和未启用常驻规则、autopilot 清理、pack_context 或 PreCompact 指令时的结果,显示通过次数、token 数和费用。费用计入 ANTHROPIC_API_KEY:先打印估算值,未指定 --yes 时不会发送请求,达到 --budget 后停止(详情) |
context-doctor statusline | Claude Code 状态栏:显示实时上下文与窗口、缓存占比、费用,以及(Claude Code 2.1.251+)缓存保持热状态的剩余时间和缓存转冷后下一轮的费用。由 install --statusline 配置;绝不会覆盖你已有的 statusLine(详情) |
context-doctor hook | 每条提示词钩子(Claude Code、Codex、Gemini CLI、Cursor)和 Claude Code 的压缩钩子,由 install 注册;hook copilot 是 GitHub Copilot 的会话启动钩子;你无需自行运行这些钩子。可通过 CONTEXT_DOCTOR_WARN_TOKENS 调整警告阈值(默认为 80000) |
context-doctor --version | 打印已安装的版本。--help 会列出所有标志 |
| **隐私:**所有操作都在你的计算机上运行。核心功能无需 API 密钥,不会向任何地方发送数据,也不会收集遥测信息;代理会原样转发你应用自己的凭据,不会持有自己的凭据。 |
新增内容
- 即将推出(在 main 分支上,尚未发布):缓存计时、缓存未命中原因说明和 Antigravity:在 Claude Code 2.1.251+ 中,状态栏会显示提示词缓存何时会失效,以及缓存失效后下一轮会花费多少。
cache-misses会用 Claude Code 自己的说法说明每次未命中的原因(工具发生变化、系统提示词发生变化、空闲时间超过有效期)并给出修复方法,还会捕获缓存到期后才被唤醒的循环。install也会接入 Google Antigravity(MCP 服务和技能),而overhead --mcp会标出工具列表不断变化、导致缓存失效的 MCP 服务。 - 0.38:以各自单位显示你的限额、升级后的回归问题、回忆,以及子 Agent 的费用:
context-doctor limits会显示各方案窗口的使用百分比、消耗速度和耗尽时间(Claude Pro/Max 通过状态栏获取,Codex 根据其 rollouts 获取),并根据你的读数估算 1M 个 token 会占用限额的百分比,同时给出误差;savings也会以你的限额为单位显示。cache-misses会标出 Claude Code 升级后的显著变化;recall会搜索会话自身的记录(包括压缩过的轮次);钩子会在子 Agent 启动前估算其费用(绝不阻止启动);overhead prune会按项目停用未使用的 MCP 服务和技能,并且可撤销。OpenAI 缓存最多可保持 24 小时的热状态。独立 QA 审查发现的问题已在发布前修复。 - 0.37:桌面聊天应用:交接、文件上传、精简结果和安全审查:聊天应用的历史记录无法编辑,因此
handoff提示词(Claude Desktop 的 + 菜单)会让模型撰写一份 ≤400-token 的简报,并通过save_handoff保存(屏蔽机密信息,通过handoff://latest附加到下一次聊天中,并报告每轮节省的 token 数:一段 52k-token 的聊天记录可缩减至约 600)。ask_file通过pack_context根据大型文件作答;通过--http使用时,也支持 ChatGPT 上传文件。ChatGPT 会收到精简结果。独立 QA 审查发现的 11 个问题均已通过测试修复;通过隧道连接时,--http现在需要--allowed-hosts <tunnel host>(交接)。
查看各版本的完整内容:docs/whats-new.md。
文档
install的作用:它会写入哪些文件、之后每个会话中会运行什么,以及何时需要 MCP- Autopilot:它如何清除过时的工具输出,以及为何绝不会增加费用
- 代理:Autopilot 和 API 应用的优化模式、
/stats、缓存建议,以及供 Cursor 使用的公共 URL - 聊天应用:Claude Desktop、ChatGPT、claude.ai 和手机应用;哪些操作会自动执行,哪些只会提示;MCP 工具、提示词和资源
- 交接:用一份不超过 400 个 token 的简报,在新的聊天中继续长对话
- 性能分析:会话、提示词缓存的成本效益、子 Agent、
tasks、reads、compactions、cache-misses、limits、report - 打包与开销:
pack、recall、overhead、overhead split和overhead prune - 检测器与修复:性能分析器会发现什么,以及各项优化策略会如何改变内容
- 库:
profileConversation、optimizeConversation、packContext、withContextDoctor - 预算与 CI:GitHub Action 和
.contextdoctorrc - 编辑器与状态栏:VS Code / Cursor 扩展和 Claude Code 的状态栏
- Token 数量:为何数量是“~”、Claude 的比例如何测量,以及精确数量
- 性能:context-doctor 本身的开销(其六个 MCP 工具定义最多约为 2,344 个 token)
- 实验和 A/B 测试套件:更小的上下文是否有帮助,以及某项调整是否会影响质量?基于真实任务进行测量
- 更新内容、路线图、Python 包
参与贡献
欢迎提交 Issue 和 PR——请参阅 CONTRIBUTING.md,了解确保此工具可信赖的规则、如何运行检查,以及如何发布。后续计划见 ROADMAP.md:研究事项,以及等待所有者账号处理的步骤(PyPI、编辑器扩展市场、签名的 Desktop 安装包、Glama 列表)。
许可证
MIT © gAI Ventures
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。