关于 Turbo Quant Memory
Turbo Quant Memory 是一款本地优先的 MCP 服务,为编码 Agent 提供持久笔记、可搜索的 Markdown 和关联知识图谱。搜索以精简卡片返回结果,项目数据保留在本机;首次运行时会下载嵌入模型。
主要功能
- 01带标签和来源信息的分类笔记
- 02语义与精确词项混合搜索
- 03关联笔记、文件和问题
- 04项目范围的加密秘密库
- 05共享工作区状态和文件历史
适用场景
- 01跨编码会话回忆决策和经验
- 02搜索已索引的 Markdown 和代码上下文
- 03查找相关笔记与项目实体
- 04查看或恢复多个 Agent 共用的文本文件版本
MCP 相关
该 MCP 服务提供存储、搜索、关联和维护记忆的工具,以及工作区和秘密库操作。编码 Agent 通过 MCP 客户端连接。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
uvx turbo-quant-memoryTQMEMORY_FTS_LANGUAGESnowball stemmer for the BM25 lane. Use Russian for Cyrillic-dominant corpora.TQMEMORY_EMBEDDING_BACKENDEmbedder backend. Default fastembed (ONNX); sentence-transformers needs the [torch] extra.TQMEMORY_MIGRATE_ON_STARTUPSet to 1 to apply pending schema migrations automatically on startup.TQMEMORY_SECRETS_PASSPHRASE密钥Argon2id passphrase for the secrets vault on headless hosts. Omit to use the OS keyring.本地服务需要在你的电脑上安装运行环境(如 Node.js 18+)。各客户端的配置文件位置不同,请参考客户端文档。
工具
19收录的工具列表 · 更新于 1 周前
此工具无需参数。
详细介绍
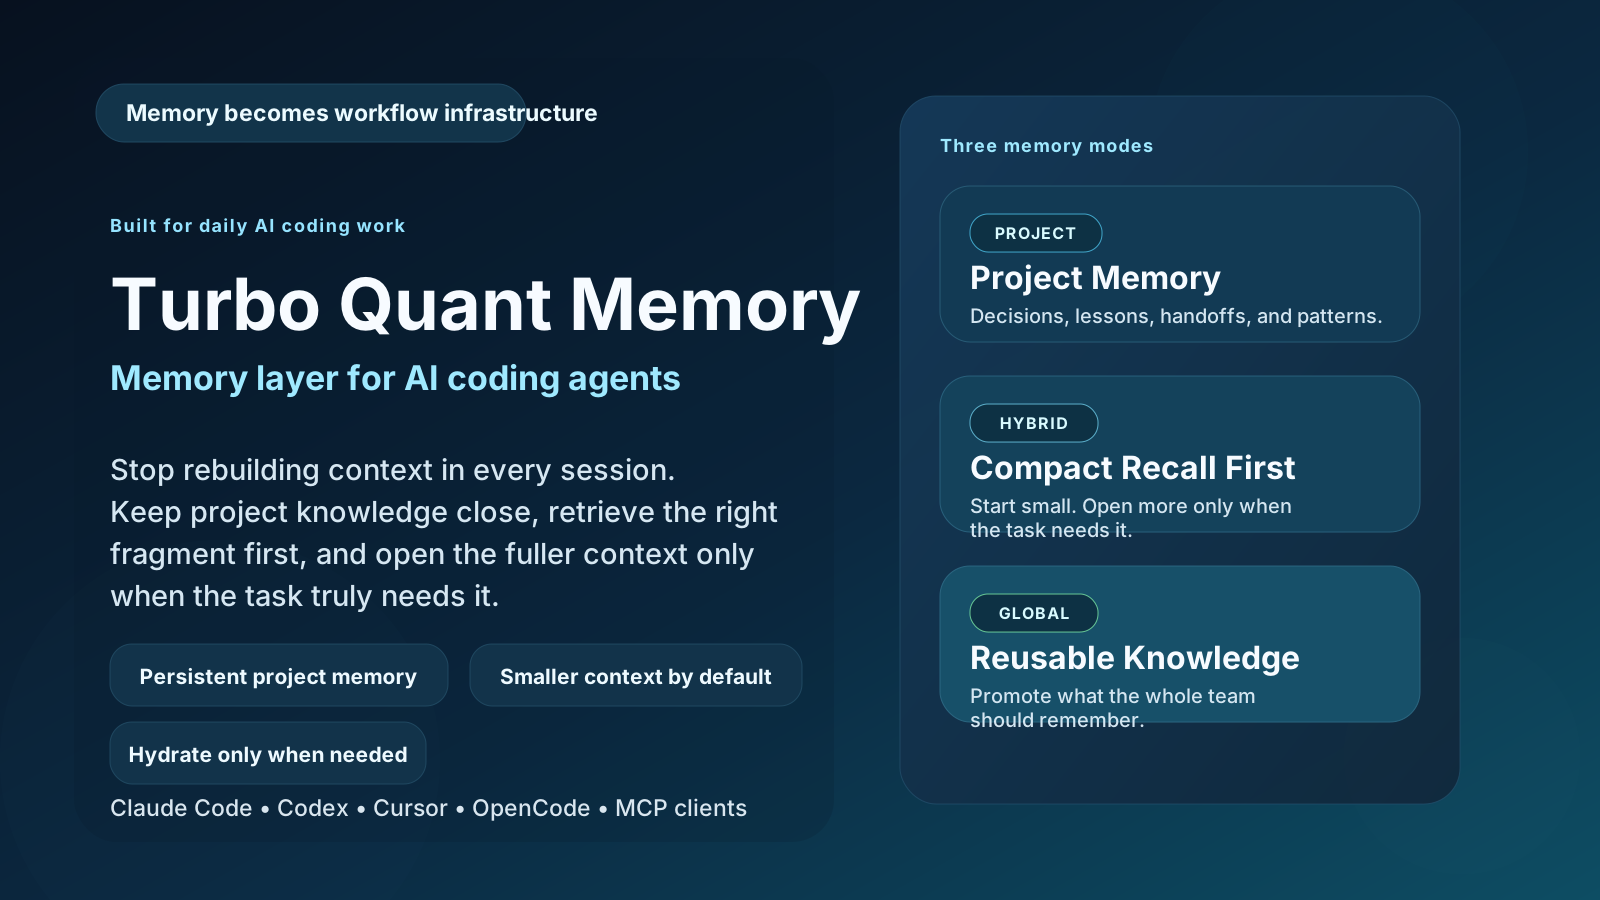
为 AI 编码 Agent 提供本地优先的记忆和知识图谱
你的 Agent 不再反复读取文件,也不再重新推导相同的结论。
你的笔记、代码和机密永远不会离开你的设备。




演示

问题所在
长时间的会话会积累来之不易的细节,说明代码为何如此设计。随后上下文被压缩,这些细节便消失了。下次会话中,Agent 又会重新读取相同的文件、重新推导相同的结论,并再次为相同的令牌付费。
CLAUDE.md 无法扩展到几十行以上,也无法回答 “我们对 X 做了什么决定,为什么?”。
Turbo Quant Memory 是一个 MCP 服务,为 Agent 提供持久、可搜索的存储空间,让它在工作过程中记录决策、经验、模式和会话交接内容;此外,它还会为你的 Markdown 文件建立精简索引。检索结果会以约 220 个字符的结果卡片返回,而不是整篇文档;只有在卡片信息不足时,Agent 才会加载完整内容。
为什么选择它
| Turbo Quant Memory | mem0 / OpenMemory | MCP memory server | |
|---|---|---|---|
| 数据存放位置 | 始终在你的磁盘上 | 供应商云端或可自托管 | 你的磁盘 |
| 数据是否离开主机 | 绝不会 | 会,除非可自托管 | 绝不会 |
| 检索方式 | 混合 BM25 + 稠密向量,RRF 融合 | 稠密向量 | 精确图查询 |
| 搜索返回内容 | 精简卡片,按需加载 | 完整记忆 | 完整节点 |
| 知识图谱 | 有 — 含生命周期管理和 lint 检查 | 无 | 有 |
| 非英语内容 | 开箱即用的西里尔文精确匹配 | 因情况而异 | 不适用 |
| 是否衡量自身节省的用量 | 是 — server_info() | 否 | 否 |
| 价格 | 免费,MIT | 付费套餐 | 免费 |
没有 HTTP 客户端、没有遥测、不会向外发送数据。你可以自行验证 — 这不会返回任何内容:
grep -rnE '^[[:space:]]*(import|from)[[:space:]]+(requests|httpx|aiohttp|urllib3)\b' src/
准确地说,唯一的例外是:首次运行时,fastembed 会从 Hugging Face 下载嵌入模型(约 0.22 GB)。此后,服务将完全离线运行。你的笔记、代码和机密绝不会传输到任何地方 — 软件包中没有任何可以发送这些内容的东西。
安装
让你的 Agent 安装
将以下内容粘贴到 Claude Code、Codex、Gemini CLI、Cursor 或 Antigravity 中:
为此工作区安装并配置 Turbo Quant Memory MCP 服务,来源: https://github.com/Lexus2016/turbo_quant_memory — 遵循 README,注册
tqmemory服务,运行turbo-memory-mcp skill install,运行健康检查,并 为此项目建立索引。
skill install 会将操作手册复制到此机器上的每个 Agent 技能目录中,因此今后的每次会话都能直接知道如何使用记忆,无需额外告知。
或者自行安装
uv tool install turbo-quant-memory
从 0.27.x 或更早版本升级?该发行包在 0.28.0 中更名,因此
uv tool upgrade turbo-memory-mcp 将无法解析 — 请先运行一次
uv tool install --force turbo-quant-memory,之后再运行 uv tool upgrade turbo-quant-memory。turbo-memory-mcp 命令本身未变,因此客户端配置仍可继续使用。
然后在客户端中注册该服务:
claude mcp add --scope project tqmemory -- turbo-memory-mcp serve   # Claude Code
codex  mcp add tqmemory -- turbo-memory-mcp serve                   # Codex
gemini mcp add tqmemory turbo-memory-mcp serve                      # Gemini CLI
Cursor、OpenCode、Antigravity 和其他客户端 → CLIENT_INTEGRATIONS.md。 Hermes 通过 systemd 网关运行 MCP → docs/hermes.md。
📈 它会衡量自身节省的用量 — 亲自看看
Turbo Quant Memory 不只是声称能节省 token — 每次安装都会持续累计用量,你可以随时通过 server_info()(字段 usage_stats.headline)查看。节省了多少由你验证,而不是由我们承诺。
真实开发者实例的实时快照(v0.28.2):
| 记忆功能的表现 | 数值 |
|---|---|
| 🔢 累计节省的输入 token | ≈ 2,640,000,还在增长 |
| 🔁 已提供的检索 | 2,280 次搜索 + 280 次深度加载 |
| 📉 每次检索平均节省 | ≈ 1,200 tokens |
| 📚 管理中的知识 | 237 条有效笔记 + 763 个已索引代码块 |
| 🛡️ 完整性 | 0 条损坏记录 · 0 项待处理迁移 |
这些是单台机器的累计数据,并非合成基准测试 — 你的计数器从零开始,随着 Agent 工作而增长。在你的安装中运行
server_info(),即可查看真实数据。
功能介绍
- 类型化笔记。
decision、lesson、pattern、handoff——每条笔记都附带标签、来源信息,以及指向相关文件或议题的知识图谱链接。 - 分层记忆。 默认搜索
durable(决策、模式)和reference(已索引文档);episodic(会话交接)则不会干扰你,只有在你提出请求时才会纳入搜索,因此昨天的杂讯不会淹没架构决策。 - 混合检索。 以密集向量检索为主;BM25 检索则补充精确匹配的术语——函数名称、文件路径、ID——并通过 Reciprocal Rank Fusion 融合结果。西里尔字母和其他非英语术语均可精确匹配,不区分大小写和重音符号,无需配置。
- 知识图谱。 在笔记、文件和议题之间建立带时间戳的有向关系。搜索结果会内嵌关联上下文,因此 Agent 无需再次查找。
- 人工笔记优先于 Agent 笔记。 你明确要求记住的内容会标记为
human-explicit,在相关性相同时,其排名高于 Agent 自身的观察记录。 - 加密密钥库。 按项目隔离,采用 AES-256-GCM 加密,在结构上无法通过搜索访问。→ docs/secrets-vault.md
- 可在小型设备上运行。 默认嵌入模型通过 fastembed 使用 ONNX,无需 PyTorch,模型约为 0.22 GB,在 2 GB 内存的设备上也能轻松运行。
- 多个 Agent,共用一个项目——自动协作。 在同一 Git 工作树中工作的 Agent 可以互相查看会话、已发布的工作内容和近期文件变更;两个或更多 Agent 共用该工作树期间,文本文件的变更会被记录,以便恢复。无需设置。
完整技术详情 → docs/features.md
多个 Agent 在同一项目中协作
如果你在同一工作树中运行多个 Agent,tqmemory 会自动将它们连接起来。无需进行任何配置。
- Agent 可以互相查看。
workspace_status会列出活跃会话、每个会话通过announce_work、finish_work发布的工作内容,以及近期变更的文件。30 分钟内未调用 tqmemory 的会话会列在idle_sessions下:它不是活跃的协作对象,其已发布的工作区域也不会计入overlaps。只有发生新情况时,其他 tqmemory 响应才会附带简短的workspace提示;只有一个会话时则不会附带。health和server_info始终包含工作区诊断信息块。 - 变更会被记录。 两个或更多会话共用同一 Git 工作树期间,监视器会记录其检测到变更的文本文件的新版本(每个文件最大 1 MiB;跳过与
.gitignore或.tqmemoryignore匹配的文件)。连续快速写入的多个版本可能会合并为一个版本。file_history会列出各个版本,restore_file可恢复到指定版本;恢复操作本身也可以撤销。你也可以在终端中执行:turbo-memory-mcp files log和turbo-memory-mcp files restore。 - 限制。 只有两个或更多会话共用同一 Git 工作树期间,才会记录版本。日志不会在 Git 工作树之外、你的主目录中或文件系统根目录下运行。默认值:每个文件 1 MiB、每个项目的目标大小为 256 MiB、保留 14 天。记录的版本可恢复 14 天;超过此期限或项目超出目标大小时,系统会删除最旧的版本。最近 24 小时内有变更的每个文件,其最新版本不会因大小限制而被删除。这些默认值由
TQMEMORY_JOURNAL_MAX_FILE_BYTES、TQMEMORY_JOURNAL_MAX_BYTES和TQMEMORY_JOURNAL_RETENTION_DAYS设置;大小限制是目标值,而非硬性上限。
这只能提供部分保护,无法保证每项变更都会被保存。它不会阻止写入:两个 Agent 仍可能互相覆盖工作成果,而 tqmemory 只能显示变更并帮助你恢复。完全不调用 tqmemory 的 Agent 看不到任何内容。它仅适用于一台计算机。要关闭此功能,请设置 TQMEMORY_WORKSPACE_DISABLE=1。
24 个 MCP 工具
| 分组 | 工具 |
|---|---|
| 写入 | remember_note · deprecate_note · promote_note · index_paths |
| 读取 | semantic_search · hydrate · recent_context · list_scopes |
| 图谱 | link_entities · unlink_entities · get_related_entities |
| 健康维护 | lint_knowledge_base · health · self_test · server_info |
| 密钥库 | set_secret · get_secret · list_secrets · delete_secret |
| 工作区 | announce_work · finish_work · workspace_status · file_history · restore_file |
文档
| MEMORY_STRATEGY.md | 如何在日常工作中实际使用记忆 |
| CLIENT_INTEGRATIONS.md | 各客户端的配置:Cursor、OpenCode、Antigravity 等 |
| TECHNICAL_SPEC.md | 架构与存储格式 |
| docs/features.md | 检索、图谱、层级、嵌入器、FTS 语言 |
| docs/secrets-vault.md | 密钥库配置、威胁模型、常见问题 |
| docs/hermes.md | Hermes 网关配置与故障排查 |
| CHANGELOG.md | 发布历史 |
许可证
MIT。可复制、修改、分叉,也可将其集成到闭源产品中并进行销售。唯一条件是注明出处。
语言
🇺🇸 English · 🇺🇦 Українська · 🇷🇺 Русский
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。