关于 Llm Usage & Cost Tracker
llm-usage-mcp 是本地优先的 LLM 调用成本追踪器,适合使用多个模型提供方的开发者。它将调用记录到本地 SQLite,并通过 MCP 工具和 CLI 提供支出查询、价格比较与提供方推荐。
主要功能
- 01将调用与成本记录到本地 SQLite
- 02支持 Anthropic、OpenAI、DeepSeek 和 Qwen
- 03查询支出并按维度汇总
- 04比较模型价格并按预算推荐
- 05提供本地调用捕获代理
适用场景
- 01汇总不同提供方的 LLM 调用支出
- 02按项目、模型或时间段分析成本
- 03估算工作负载在不同模型上的价格
- 04通过本地代理捕获 API 调用用量
MCP 相关
它提供 stdio MCP 服务,开放七种工具,用于查询支出、比较提供方、获取价格、推荐模型、列出提供方及手动记录用量。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
本地服务需要在你的电脑上运行后才能读取工具,维护者暂未提供工具列表。
详细介绍
llm-usage-mcp
大模型用量与成本追踪器——你的本地优先支出监控工具


English | 中文
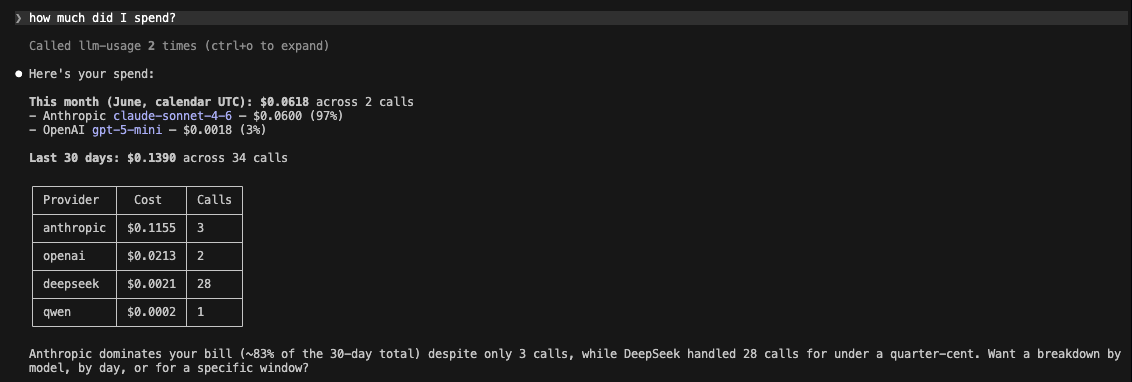
别再把大模型 API 账单当成一部只有月底才敢捂着眼睛看的恐怖片。了解你调用大模型实际花了多少钱——涵盖所有服务商,集中在一处,数据留在自己的机器上。向你的编码 Agent(MCP)提问,或输入命令(CLI)。
它是成本计量器,而不是路由器:它会告诉你花了多少钱,以及哪个服务商适合某项工作负载——但绝不会改动你的调用。它也可以与路由器或模型排行榜工具配合使用。
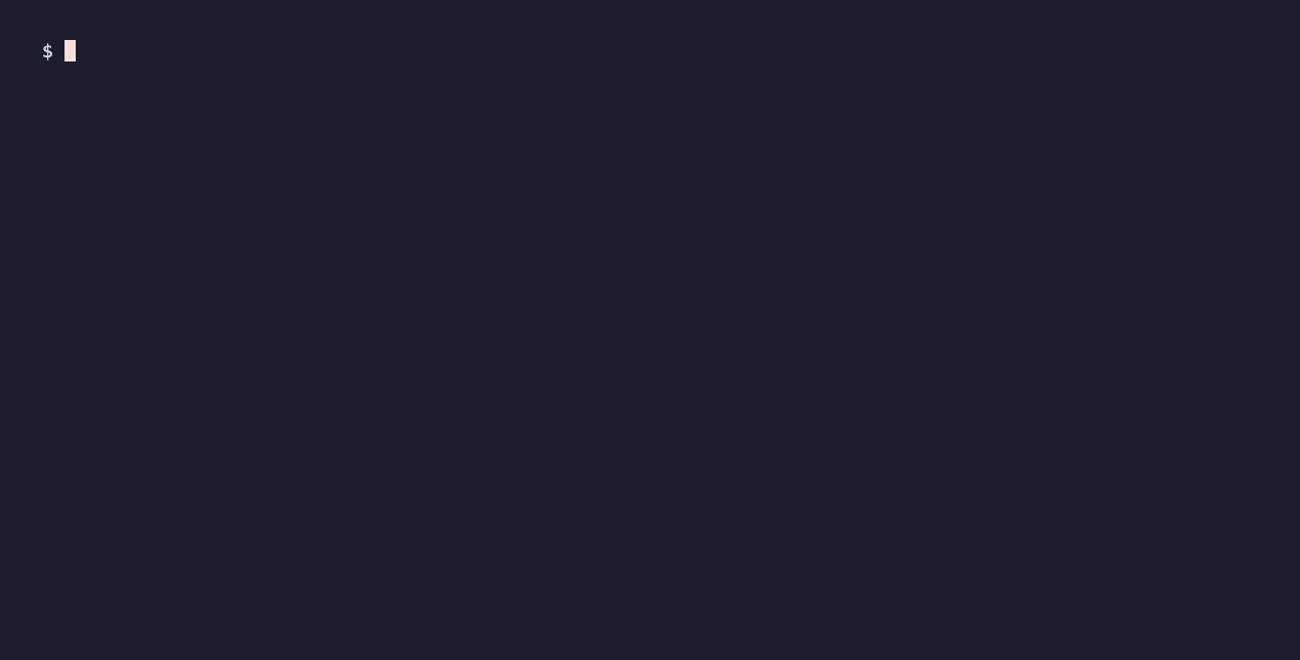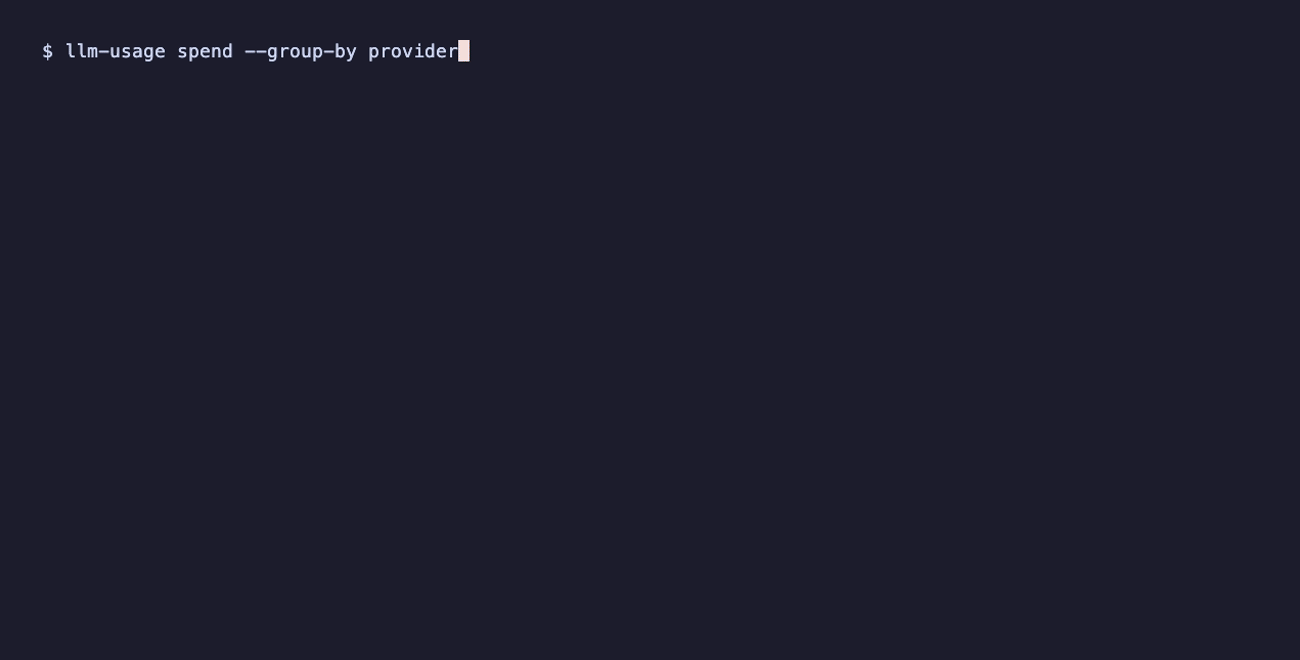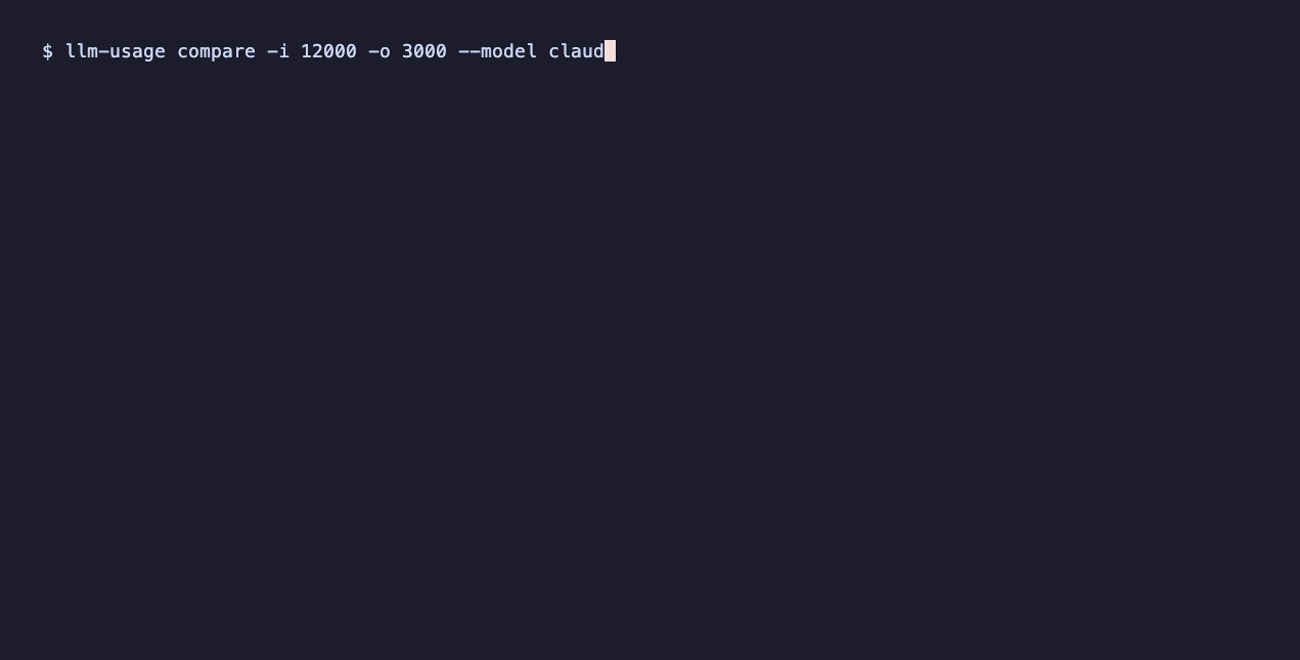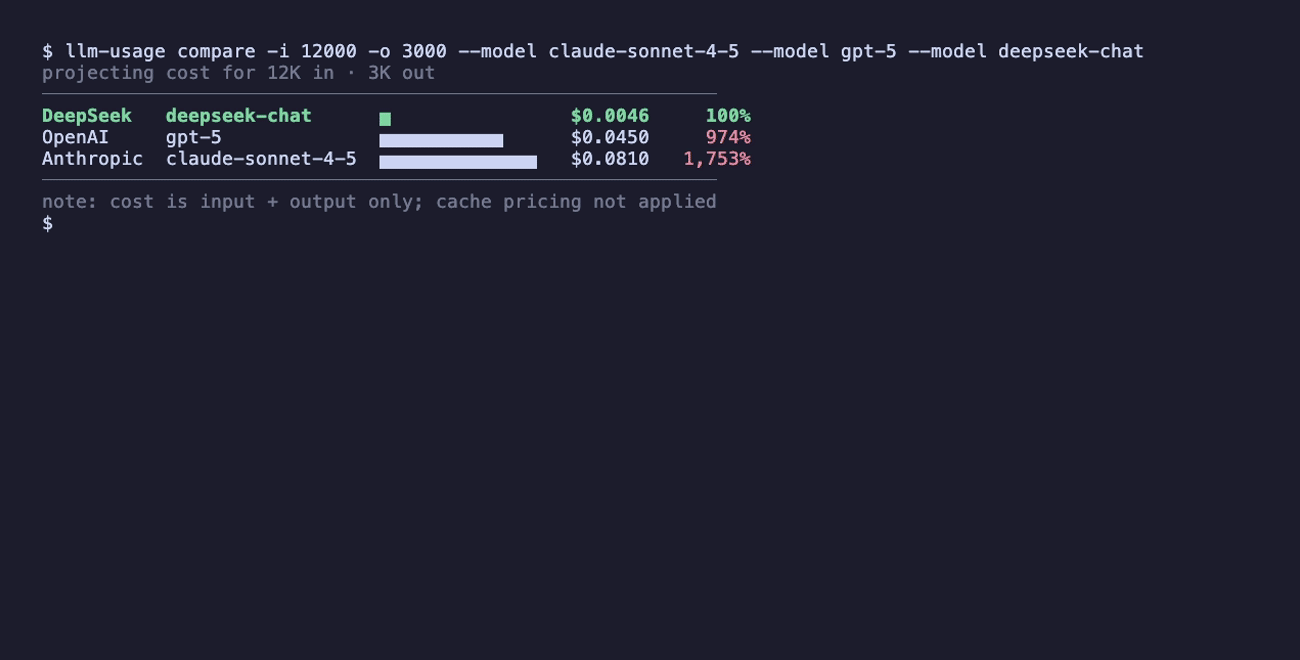
也可以直接在终端中使用——查看本周按服务商分类的支出,并在选定模型前比较不同服务商的成本:
为什么你会需要它
你会通过几个服务商调用大模型——Claude、GPT,还有 Qwen 和 DeepSeek 等中国模型。每家都会在自己的控制面板中计费,使用自己的货币,也有各自对“缓存 token”费用的计算规则。因此,最简单的问题——我花了多少钱,钱都花在哪儿了?——却要登录四个网站、查询人民币兑美元汇率,还得在深夜费力弄清楚“缓存上下文 token 折扣”到底是什么意思。大多数人只好听天由命,等着月底账单揭晓。
llm-usage-mcp 会将你的每次调用记录到一个本地存储中,根据服务商在调用发生时准确计算成本,并通过两种方式告诉你结果:
- 向你的编码 Agent 提问。 它是一个 MCP 服务,因此 Claude Code、Cursor 或任何 MCP 客户端都能用通俗语言回答*“我这周在 Claude 上花了多少钱?”或“对于一次输入 10k、输出 2k 的调用,哪个服务商最便宜?”*
- 或者输入命令。 它也是一个 CLI——
llm-usage spend、llm-usage compare、llm-usage recommend——适合不想通过 Agent 来回操作时使用。
而且它不会打扰你:
- 本地优先。 没有 SaaS 服务、无需注册、不收集遥测数据。所有数据只存放在
~/.llm-usage/usage.db这个 SQLite 文件中。隐私是它的特性,而不是一个设置选项。 - 支持多家服务商,也支持中国模型。 Anthropic、OpenAI、DeepSeek、Qwen——全部支持流式和非流式调用。DeepSeek 和 Qwen 使用与 Anthropic、OpenAI 相同的记录流程,并非事后勉强补上的功能。更多服务商(Gemini、Bedrock、Moonshot 等)即将支持。
快速开始
从 git clone 到记录你的第一次调用,只需两分钟。本节介绍记录调用——让调用被记录下来。读取数据将在下一节介绍。
1. 安装
使用 uv(或 pipx)从 PyPI 安装——这会将三个控制台脚本放到你的 PATH 中:
uv tool install llm-usage-mcp # or: pipx install llm-usage-mcp
想动手开发?也可以改为克隆项目并从源代码同步:
git clone https://github.com/zhaoyue722/llm-usage-mcp.git
cd llm-usage-mcp
uv sync
无论使用哪种方式,你都会获得三个控制台脚本:
llm-usage— 多命令 CLI。请参阅下文的通过命令行(CLI)。llm-usage-mcp— stdio MCP 服务。llm-usage-proxy— 向后兼容的别名;与llm-usage proxy完全相同。
下方的快速入门使用
uv run …(从源代码运行的工作流)。如果你从 PyPI 安装,脚本已在你的PATH中——去掉uv run前缀,并使用claude mcp add llm-usage -- llm-usage-mcp注册 MCP 服务。
2. 至少设置一个 API 密钥
你只需要为实际使用的提供商设置密钥;代理会始终启动,而针对缺少密钥的提供商的各路由请求会返回 503 configuration_error。
export ANTHROPIC_API_KEY=sk-ant-...
# and/or:
export OPENAI_API_KEY=sk-...
export DEEPSEEK_API_KEY=sk-...
export DASHSCOPE_API_KEY=sk-...   # Qwen
完整的环境变量参考:docs/configuration.md(或者将 .env.example 复制为 .env 并填写)。
3. 运行采集代理
uv run llm-usage-proxy
它仅绑定到 回环地址(127.0.0.1:5525)——无法从网络访问。代理会在服务端保存你的 API 密钥;客户端无需获取密钥。
4. 将编码 Agent 指向代理
代理为每个提供商提供一个路由。在客户端设置相应的 *_BASE_URL 环境变量:
| 提供商 | 客户端环境变量 | 值 |
|---|---|---|
| Anthropic | ANTHROPIC_BASE_URL | http://127.0.0.1:5525 |
| OpenAI | OPENAI_BASE_URL | http://127.0.0.1:5525/openai/v1 |
| DeepSeek | DEEPSEEK_BASE_URL(或任何 OpenAI-SDK 基础 URL 覆盖项) | http://127.0.0.1:5525/deepseek/v1 |
| Qwen | DashScope OpenAI 兼容基础 URL | http://127.0.0.1:5525/qwen/v1 |
示例——启动 Claude Code,并通过代理路由调用:
ANTHROPIC_BASE_URL=http://127.0.0.1:5525 claude
5. 确认已开始采集
通过你的 Agent(或任何指向代理的客户端)发起调用,然后检查记录是否已写入:
uv run llm-usage spend
每次调用都会连同 token、费用、延迟和用于幂等性的 request_id 一起写入 ~/.llm-usage/usage.db,并显示在该概览中。整个流程就是这样:一端采集,另一端获取答案。
查询你的支出
开始采集调用后,你可以通过两种方式查看数据。数据相同,数字也相同——选择适合当下情境的方式即可。
询问你的编码 Agent(MCP)
使用 Claude Code 注册 MCP 服务:
claude mcp add llm-usage -- uv --directory $(pwd) run llm-usage-mcp
然后在该会话中直接用自然语言提问:
我今天在 Anthropic 上花了多少钱?对于输入 10k token、输出 2k token 的调用,哪个提供商最便宜?
Claude 会选择合适的工具并返回数据。通过 stdio 暴露七种工具;完整的参数和返回值结构请参阅 docs/spec.md。
| 工具 | 用途 |
|---|---|
query_spend | 在指定时间范围内统计总额和各分组汇总(按提供商/模型/项目/标签/日期分组)。 |
usage_summary | 提供 today/week/month/year 的概览——总额、排名靠前的提供商和模型,以及最大的一次调用。 |
compare_providers | 根据假设的工作负载(输入/输出 token 数),按费用对所有有定价的模型进行排名。 |
recommend_provider | 选择符合指定预算的最便宜的有定价模型。 |
get_pricing | 查看随项目提供的定价快照。 |
list_providers | 列出提供商及其模型,以及是否兼容 OpenAI 的标记。 |
record_usage | 手动写入方式——在未使用采集代理时记录调用。 |
query_spend 和 usage_summary 默认设置 include_failed=false,以免部分流式响应记录影响总额;可通过该参数选择启用。
从命令行(CLI)
通过 CLI 查询相同的问题——在一个 llm-usage 控制台下提供 8 个子命令,适合打字比询问 Agent 更快的情况。
以下示例假设
llm-usage已加入你的PATH——可以运行source .venv/bin/activate或uv tool install .。否则,请在每条命令前加上uv run(例如,uv run llm-usage spend)。
$ llm-usage
 Local-first LLM spend capture + query, exposed over MCP.

 Commands
   proxy      Run the local LLM capture proxy on 127.0.0.1.
   compare    Project the cost of a hypothetical workload across every priced model.
   models     Browse the local pricing catalog.
   recommend  Recommend the cheapest priced model for a workload + budget.
   spend      Show recorded spend over a calendar period.
   status     Snapshot of the local install: DB, proxy, providers, pricing.
   providers  List configured providers with key state, wire-format, model count.
   about      Show version, author, license, and the project homepage.
| 命令 | 回答的问题 |
|---|---|
compare | 给定一项工作负载,哪个最便宜? |
models | 它们的实际收费是多少(每百万个 Token)? |
recommend | 我还剩 $0.04——用哪个模型才不会让我破产? |
spend | 我刚才花了多少钱? |
status | 一切真的都在正常运行吗? |
providers | 本地配置了什么? |
about | 这是什么?在哪里报告 Bug? |
proxy | 运行捕获代理(与 llm-usage-proxy 相同)。 |
所有命令都遵循以下约定:
--json会输出与对应 MCP 工具返回结果相同的 Pydantic 结构。可直接通过管道传给jq。--color {auto,always,never}会遵循NO_COLOR和 TTY 检测。配色采用柔和、低对比度的深色主题,深夜 11 点使用也不伤眼。- 筛选标志(
--provider、--model)对提供商名称不区分大小写,对模型名称区分大小写;作为白名单使用时可重复指定。 --version/-V会打印版本并退出。--install-completion {bash|zsh|fish|powershell}会安装 Tab 补全脚本——重启一次 Shell 后,每个标志都可以通过<Tab>补全。
compare
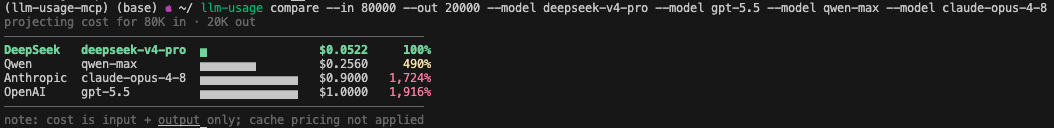
按指定的 n 个输入 Token / m 个输出 Token 调用的预估成本,对所有有定价的模型进行排名。最便宜的排在前面,并显示相较于最便宜模型的百分比。默认视图会合并同时具有相同模型系列根名称和相同价格的行,因此 gpt-5-mini 和 gpt-5-mini-2025-08-07 会合并为一行,并标记为 ×2。传入 --all 可查看目录中的所有行。
# How does an 8k-in / 2k-out call price out today?
$ llm-usage compare --in 8000 --out 2000

# Just OpenAI's models:
$ llm-usage compare --in 8000 --out 2000 --model gpt-5-mini --model gpt-5-nano

# Same projection, JSON for a script:
$ llm-usage compare --in 8000 --out 2000 --json | jq '.ranked[0]'
models
目录浏览器。与 compare 类似,但回答的是“这个模型怎么收费?”,而不是“我的工作负载要花多少钱?”。默认按提供商的字母顺序排列每百万个 Token 的费率;使用 --sort input 或 --sort output 可切换排序方式,查找任一方向上最便宜的模型。缓存费率默认隐藏(使用 --cache 显示),因为大多数模型都没有缓存费率,空列只会浪费宽度。
# Full catalog, deduped.
$ llm-usage models

# OpenAI's nano models only, with cache rates:
$ llm-usage models --provider openai --match nano --cache

# Cheapest input rate first — quick "what's the floor right now?":
$ llm-usage models --sort input
recommend
选出一个模型。按 --provider、--model 和 --budget 筛选,然后返回最便宜的匹配项及两个备选项。推理说明会解释其假设和选择结果,方便你核实,而不是盲目信任。
# Cheapest priced model, full stop.
$ llm-usage recommend

# Anything Anthropic that fits under one cent for a 1k/1k call:
$ llm-usage recommend --provider anthropic --budget 0.01

# Of these three specific candidates, which wins?
$ llm-usage recommend --model gpt-5-mini --model claude-sonnet-4-6 --model qwen-max
v1 仅按成本排名。--task 为可选参数,会显示在推理文本中;它不会影响选择(此工具不是大模型,无法理解自由文本)。
spend
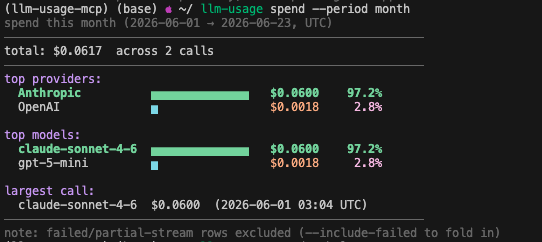
读取 SQLite。默认视图显示 usage_summary 概览——总金额、排名前三的提供商、排名前三的模型,以及金额最大的单次调用。传入 --group-by 可切换到汇总模式。
# Headline for this week.
$ llm-usage spend

# This month grouped by model, JSON for a dashboard:
$ llm-usage spend --period month --group-by model --json | jq

# Spend on a specific project tag, day-by-day:
$ llm-usage spend --group-by day --project my-side-thing
时间段边界按 UTC 日历计算:today = 自 UTC 时间 00:00 起,week = 自星期一开始,month = 自每月 1 日开始,year = 自 1 月 1 日开始。默认排除失败和部分流式传输的行;使用 --include-failed 可将其纳入。
status
一个屏幕显示四个部分:数据库、捕获代理、提供商、定价。这是用于确认“一切是否真的在正常运行”的命令。此命令为只读——在全新安装后、尚未启动代理或 MCP 服务时运行,会显示 database not initialized,而不会悄悄创建文件。
$ llm-usage status

# Skip the network probe (offline, CI, slow link):
$ llm-usage status --no-net

# Machine-readable for a healthcheck script:
$ llm-usage status --json
providers
按提供商查看配置。内容比 status 中的 Providers 区块更丰富:增加了传输格式标志(openai-compat: yes/no),并提供可选的 --models 展开项,列出每个提供商下所有有定价的模型。
$ llm-usage providers
$ llm-usage providers --models   # expand each provider with its model list
about
首页面板:版本、作者、许可证和项目主页。它是面向用户的 --version 补充信息——字段读取自已安装的软件包元数据,因此与 PyPI 上显示的信息一致。
$ llm-usage about

# Machine-readable, for a script or an issue template:
$ llm-usage about --json
支持的提供商
| 提供商 | 身份验证 | 非流式 | 流式 | 缓存定价 |
|---|---|---|---|---|
| Anthropic | x-api-key | 是 | 是 | cache_creation + cache_read |
| OpenAI | Bearer | 是 | 是 | 嵌套的 prompt_tokens_details.cached_tokens |
| DeepSeek | Bearer | 是 | 是 | prompt_cache_hit_tokens / _miss_tokens |
| Qwen(DashScope) | Bearer | 是 | 是 | 通常在 OpenAI 兼容端点中省略 |
更多支持即将推出。 Google Gemini、AWS Bedrock、Moonshot(Kimi)、Zhipu GLM、MiniMax 等已列入 docs/post_v1_providers.md 的规划。
定价来源。 定价数据是 LiteLLM 定价 JSON 的精简快照,随 GitHub Action 每周刷新(refresh-pricing.yml)。对于 LiteLLM 尚未收录的模型,则通过 pricing_overrides.json 在本地补充。
配置
所有配置都通过环境变量(或仓库根目录下的 .env 文件)设置。默认值经过合理设置——启动代理无需配置任何内容。完整参考见:docs/configuration.md。你最可能需要修改以下三个配置:
| 变量 | 默认值 | 用途 |
|---|---|---|
LLM_USAGE_DB_URL | sqlite:///$HOME/.llm-usage/usage.db | 本地数据库的位置。 |
LLM_USAGE_PROXY_PORT | 5525 | 捕获代理端口(仅限环回地址)。 |
LLM_USAGE_<PROVIDER>_BASE_URL | 各提供商的官方端点 | 将提供商指向反向代理 / 网关——在网络受限地区很实用。 |
Docker
项目中包含一个精简的 Dockerfile,仅用于自动化 MCP 注册表验证(例如 Glama),以确认打包后的服务能够启动并响应 MCP 内省。仍建议在本地通过 uvx llm-usage-mcp 运行服务——这是一个本地优先的工具,而不是托管服务。
许可证
MIT。
评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。