关于 llmxray
LLMxRay 是面向 Ollama 用户、开发者和 Agent 的本地观测与诊断工具。它代理 Ollama 请求、展示提示词与运行过程,并提供只读 MCP 工具分析调用情况。
主要功能
- 01兼容 Ollama 的请求代理
- 02实时查看请求与缓存
- 03提示词和运行过程可视化
- 04模型与 GPU 使用情况视图
- 05本地只读 MCP 诊断
- 06导出 OpenTelemetry 跟踪
适用场景
- 01检查本地 AI 客户端发送的提示词
- 02查找缓存失效或上下文截断
- 03诊断 Agent 最近的 Ollama 调用
- 04比较变更前后的模型调用性能
MCP 相关
LLMxRay 提供 7 个只读 MCP 工具,用于检查近期调用、本地模型、提示词估算和服务状态。MCP 服务通过 localhost 从运行中的 LLMxRay 实例读取数据。
配置
本地服务的配置在各客户端中通用,复制后粘贴到客户端的 MCP 配置文件即可。
工具
3收录的工具列表 · 更新于 4 天前
| 参数 | 类型 | 必填 | 说明 |
|---|---|---|---|
| client | string | 否 | LLMxRay 中显示的客户端标签或 ID 的一部分(例如 "VS Code Copilot"、"python-requests",或你发送的 X-LLMxRay-Client 标头)。不区分大小写的子字符串。省略则匹配所有客户端。 |
| since_minutes | integer | 否 | 仅包含最近 N 分钟内的轮次。省略则包含 LLMxRay 保留的所有轮次。 |
详细介绍
LLMxRay


看看你的本地 AI 实际在做什么。
将 VS Code Copilot、Open WebUI、Continue、n8n 或你自己的 Agent 指向 LLMxRay,而不是 Ollama,即可查看每一轮的情况:
缓存了什么、重新读取了什么、守护进程悄悄截断了什么,以及哪个工具驱逐了哪个模型。无需云服务、API 密钥,也无需付费。



🌐 English • Français • 中文 • العربية • Srpski
快速开始 • 工具实际发送的内容 • 保留并继续发送 • 面向 Agent • 还包含 • 适用对象 • 安装 • Ollama 兼容性 • 更新日志
快速开始
你需要运行 Ollama,并至少拉取一个模型(ollama pull llama3.2)。然后:
npx llmxray
或者使用 Docker:
docker run -p 5174:5174 -p 11435:11435 djovaneli/llmxray
现在,将你的工具指向 **http://localhost:11435**,而不是 Ollama 的 11434:VS Code Copilot、Open WebUI、Continue、n8n 或你自己的脚本。它的行为与 Ollama 完全相同,并会转发所有内容。打开 **http://localhost:5174**,进入 Live,观察这些工具发起的对话轮次。
只想试试模型?打开 Chat 页面,选择一个模型,然后发送消息。
你的工具实际发送了什么
你的编辑器、Agent 和脚本都与同一个 Ollama 通信。这些页面会展示它们各自发送的内容、守护进程对此做了什么,以及这对其他工具造成了什么影响。
Live:其他工具发送的内容
LLMxRay 会开放第二个端口 11435,其行为与 Ollama 完全相同,并会将所有内容转发给 Ollama。将 VS Code Copilot、Open WebUI、Continue、n8n 或你自己的脚本指向 http://localhost:11435,它们发送的每轮对话都会显示在这里:客户端、模型、提示词大小、缓存命中量、预填充和生成速度、工具调用。
VS Code Copilot ─┐
Open WebUI ──────┤                                    ┌─ Live page: every turn,
Continue / n8n ──┼─► http://localhost:11435 ─► Ollama ┤  cache hits, prefill speed,
your scripts ────┘        (LLMxRay)                   └─ where the cache broke
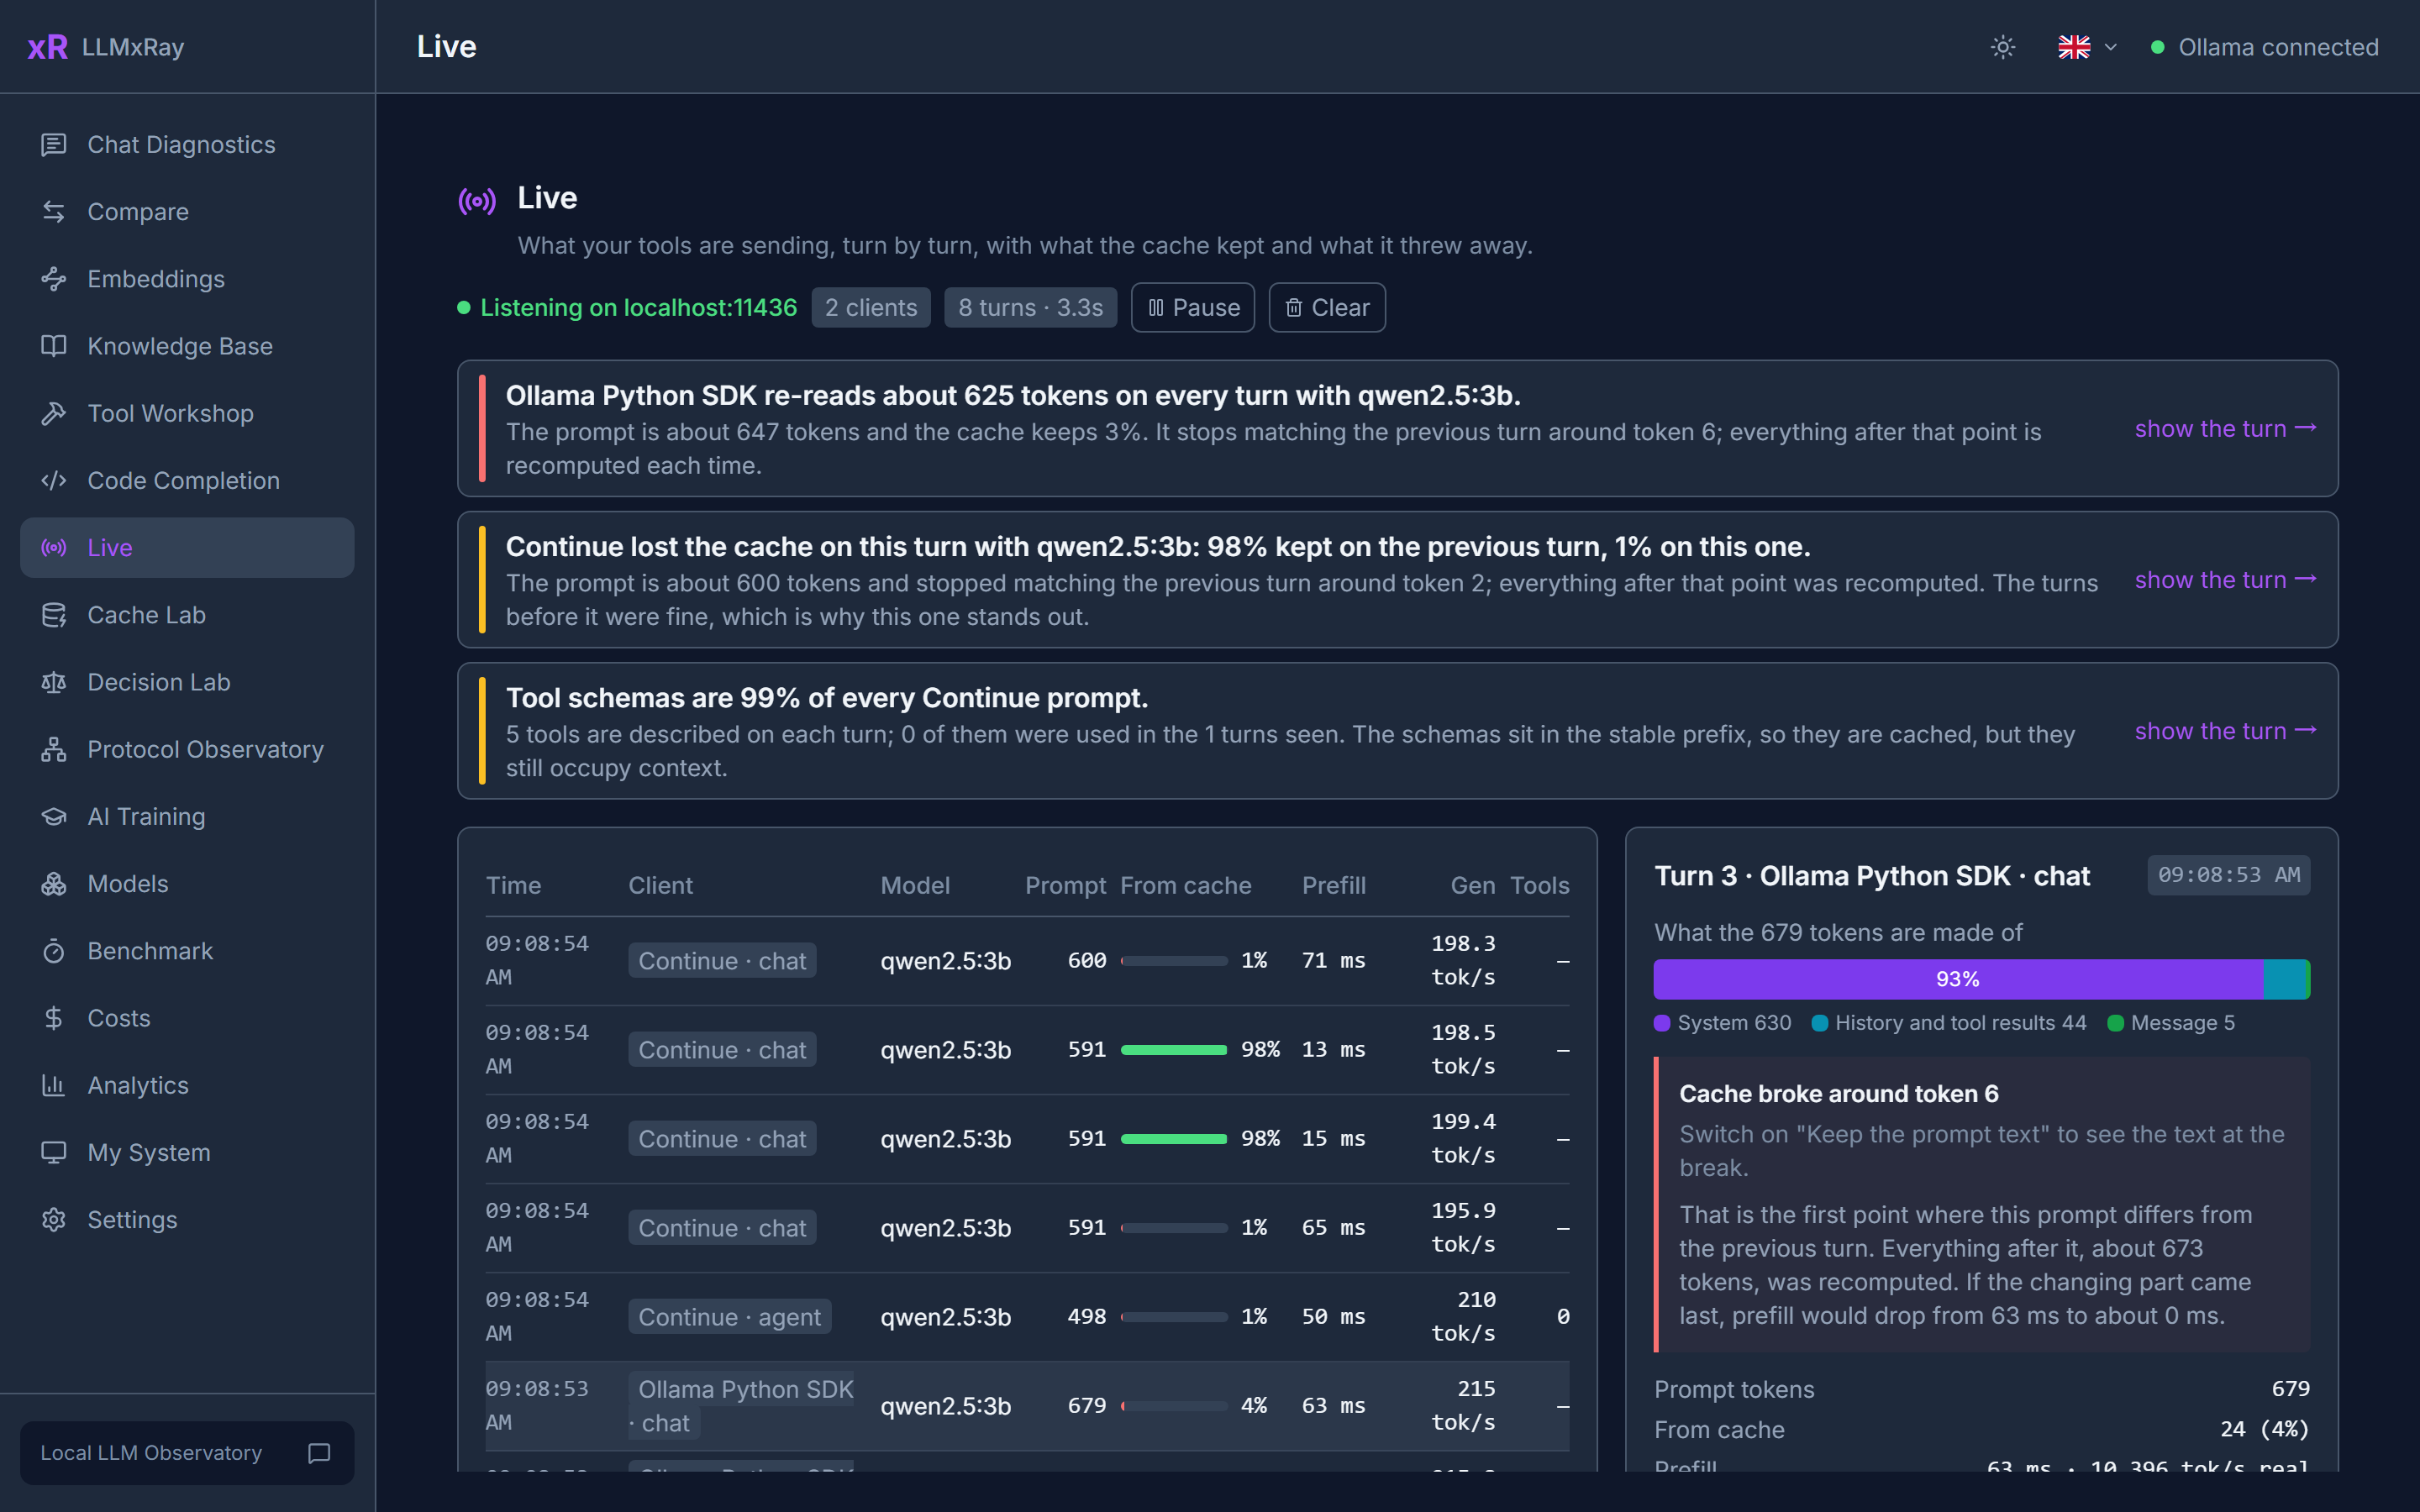
选择一个对话轮次,即可查看提示词由哪些部分组成,以及它从哪里开始与上一轮不再匹配——缓存也正是在此处失效。发现结果以简明句子呈现,每条都链接到能证明问题的对话轮次:客户端每轮都重新读取整个提示词;提示词被守护进程静默截断以适应上下文(Ollama 会保留开头的几个 token 和结尾部分,丢弃其余内容,却不作说明);模型部分运行在 CPU 上;工具架构占每个提示词的 40%。仅保留计数和计时数据,在这台机器上保存 30 天,因此重启后可以接着之前的记录继续。提示词文本需要选择启用,启用后会写入本地文件。除非你将对话轮次发送到自己的跟踪查看器,否则任何内容都不会离开你的机器:每次模型调用作为一个 OpenTelemetry span,每次运行作为一条 trace,可供 Jaeger、Phoenix、Langfuse 或 Grafana 使用。
默认情况下,两个端口都只响应本机的请求,因为 Live 日志会保存工具发送的内容。运行 npx llmxray --host 0.0.0.0,即可让网络上的其他机器访问它们,用于在第二块屏幕上查看 Live 页面,或连接共享 GPU 主机。
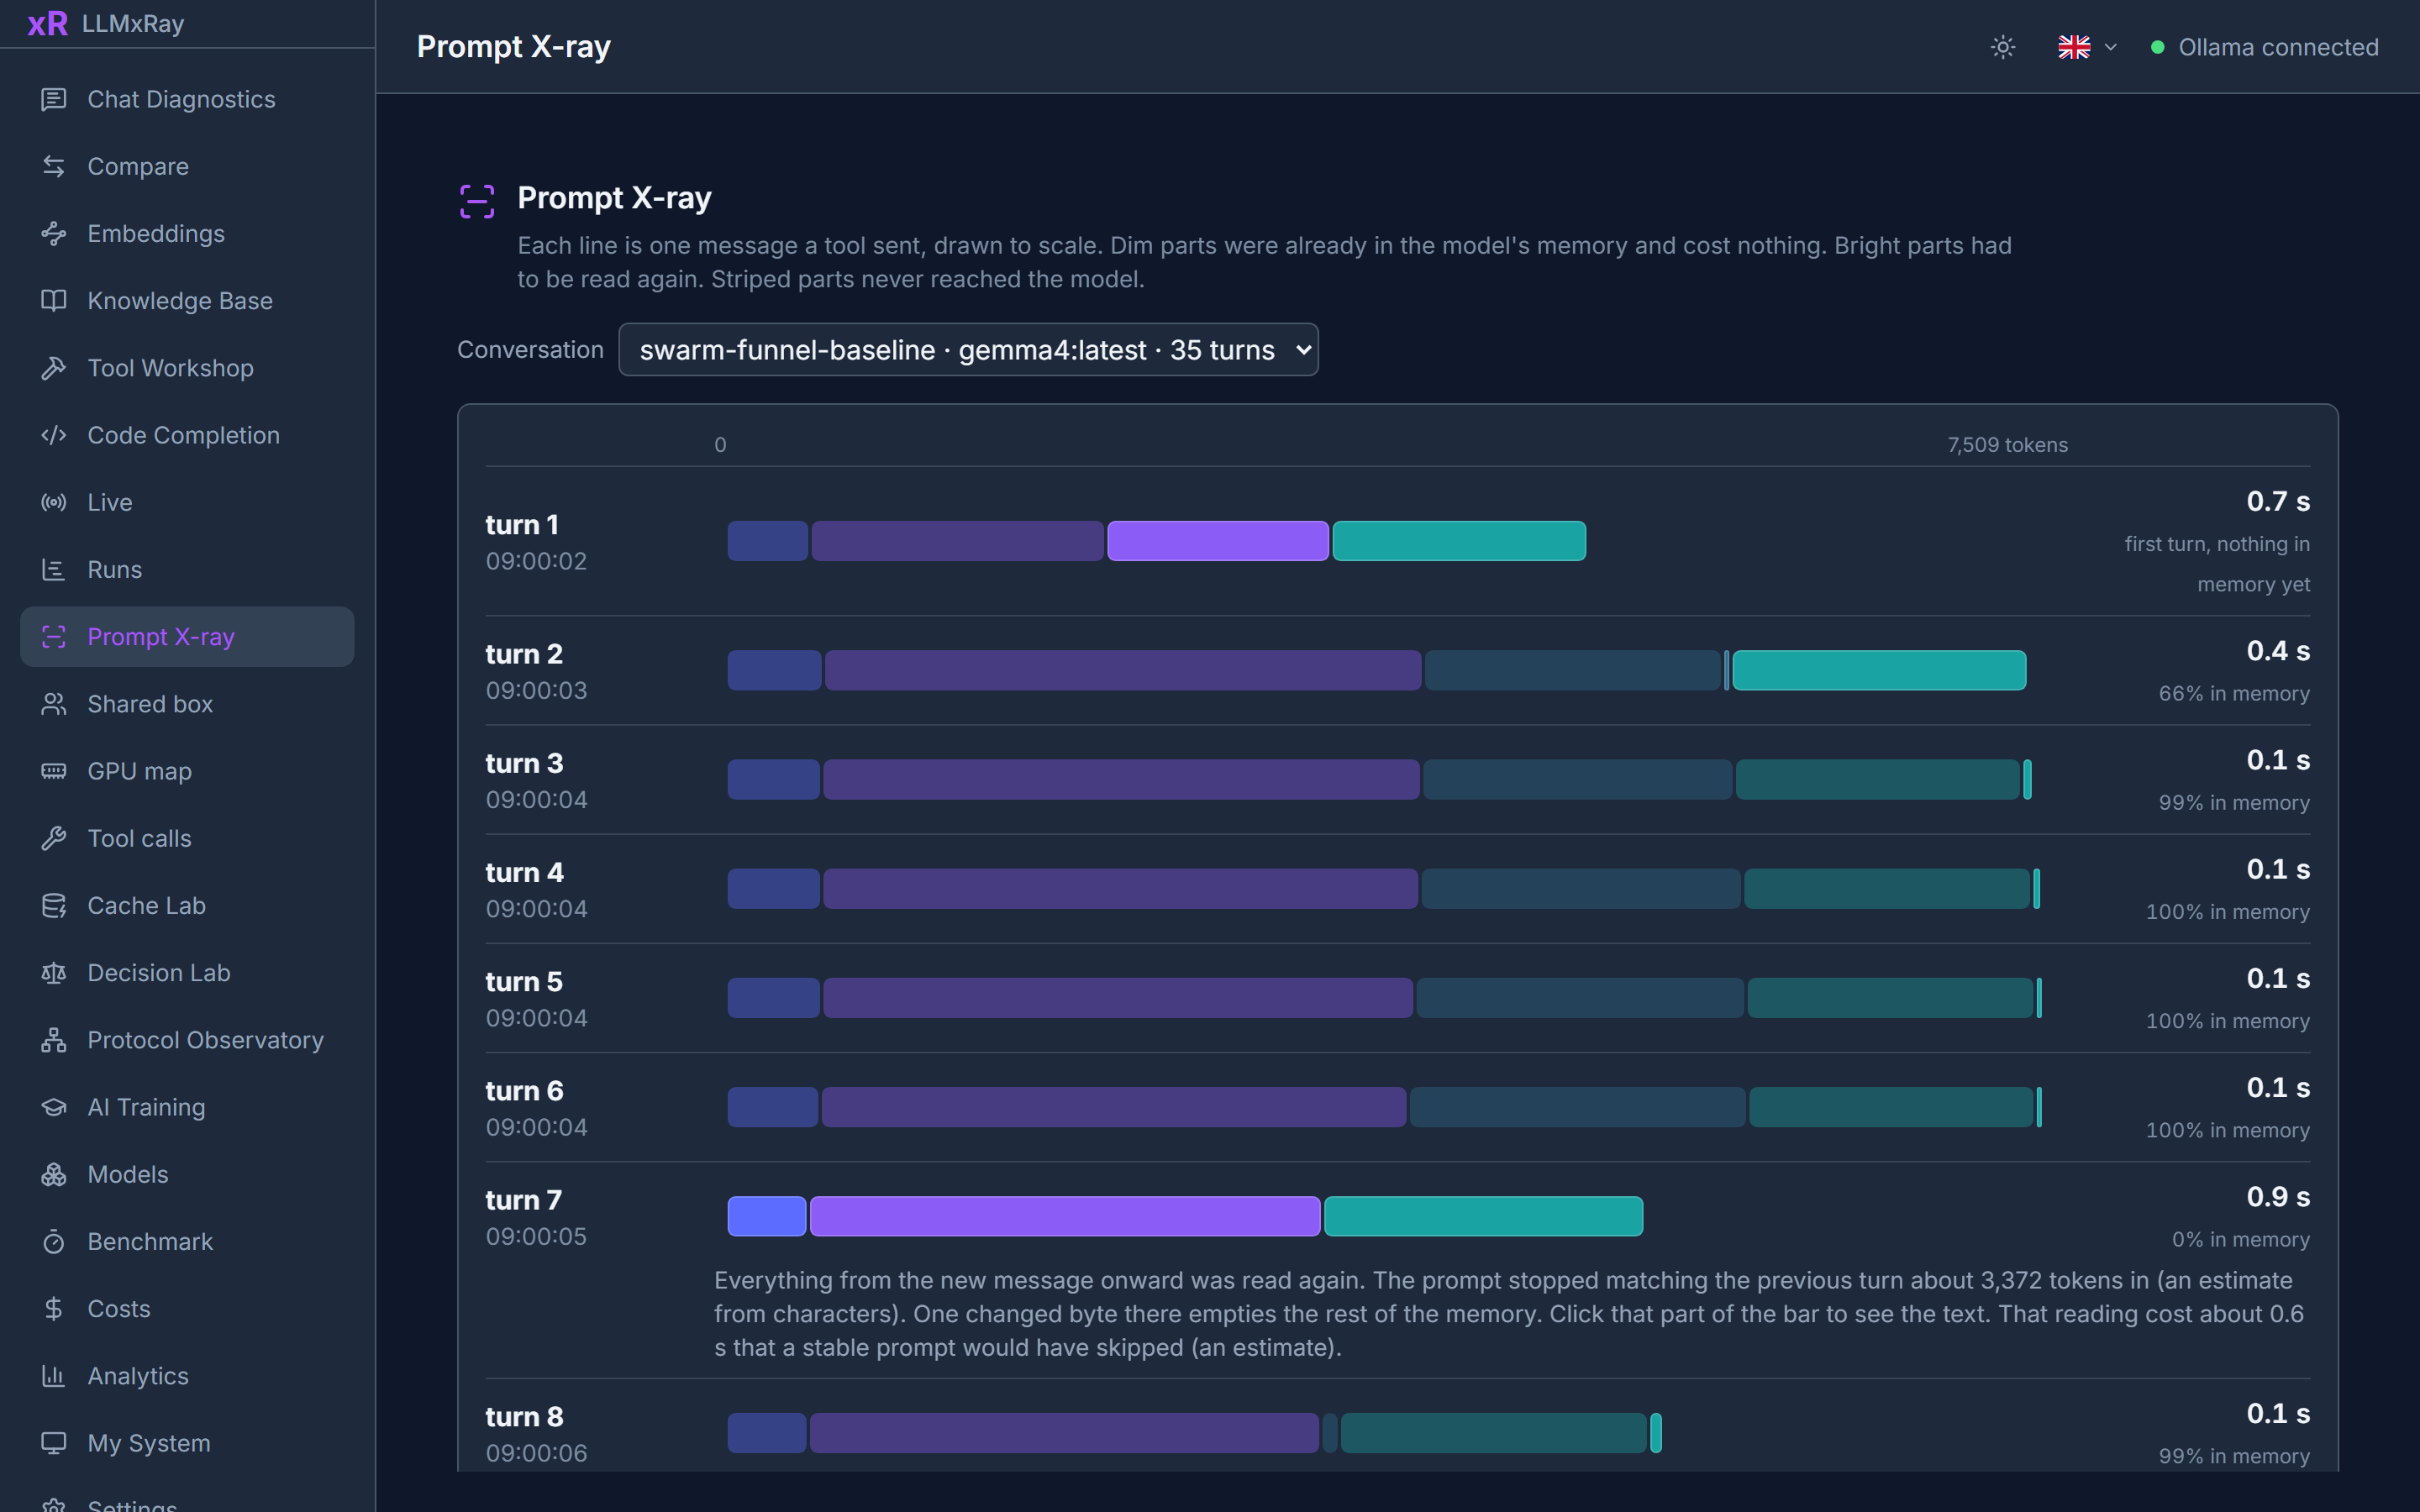
Prompt X-ray:按比例绘制提示词本身
工具发送的每一轮对话都绘制成一条长条。颜色表示提示词各部分的内容:系统提示词、工具架构、更早的对话轮次、新消息。亮度表示这些内容的处理情况:暗色表示已保存在模型记忆中,无须付出成本;亮色表示必须重新读取;条纹表示内容被守护进程截断,模型从未看到。将一段对话的各轮堆叠起来,就能观察缓存增长,看到系统提示词中的时间戳清空缓存的那一轮,以及提示词超出上下文后,Ollama 静默丢弃开头部分(包括系统提示词)却仍然作答的那一轮。点击某个部分,请求内容就会跳转到文本中的相应位置。
运行记录:一个工具从头到尾的工作过程
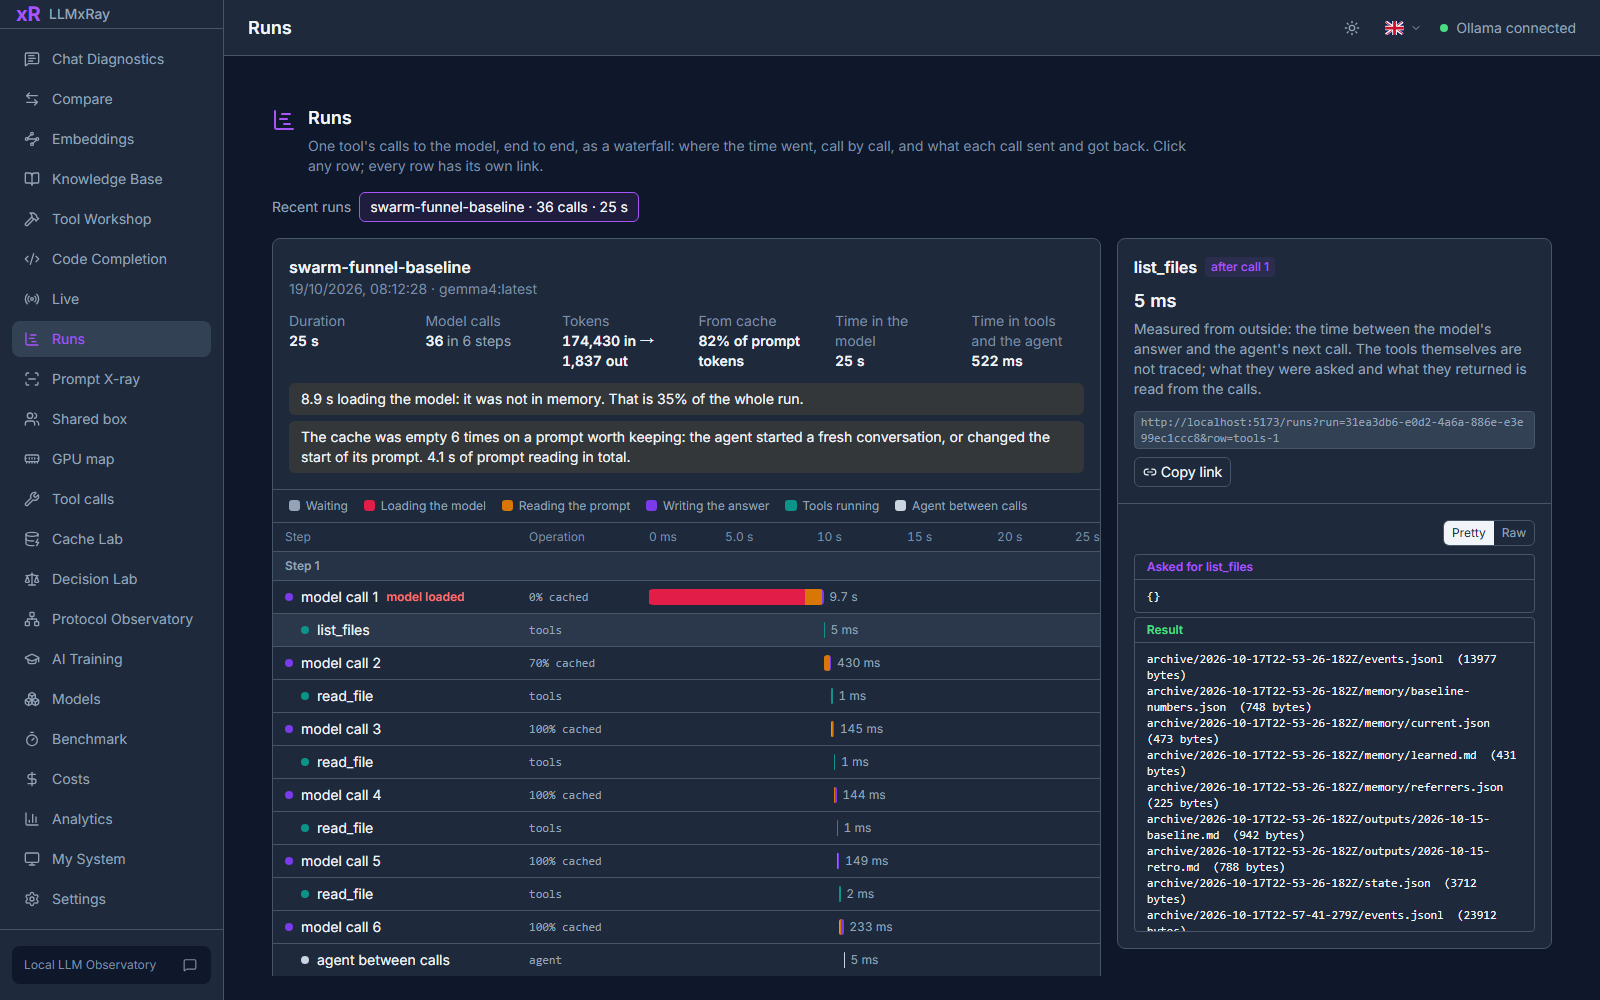
按时间顺序以瀑布图展示一个工具对模型的调用。每次调用都拆分为 Ollama 报告的各个阶段:等待、加载模型、读取提示词、生成回答。两次调用之间则显示工具自身的耗时,并以模型请求的工具命名。每一步都从工具开启新对话时开始,因此,Agent 若在每一步都丢弃缓存,一眼就能看出来;运行开始时模型不在内存中也同样如此。点击任意一行,即可查看该次调用发送的内容和收到的响应,包括模型的思考过程及其工具调用和参数;也可查看工具收到的请求和返回结果。每一行都有独立链接。在 Live 页面开启 Keep the prompt text 即可查看文本;查看耗时无需此设置。
共享资源:Ollama 此刻为何变慢,哪个工具造成了影响
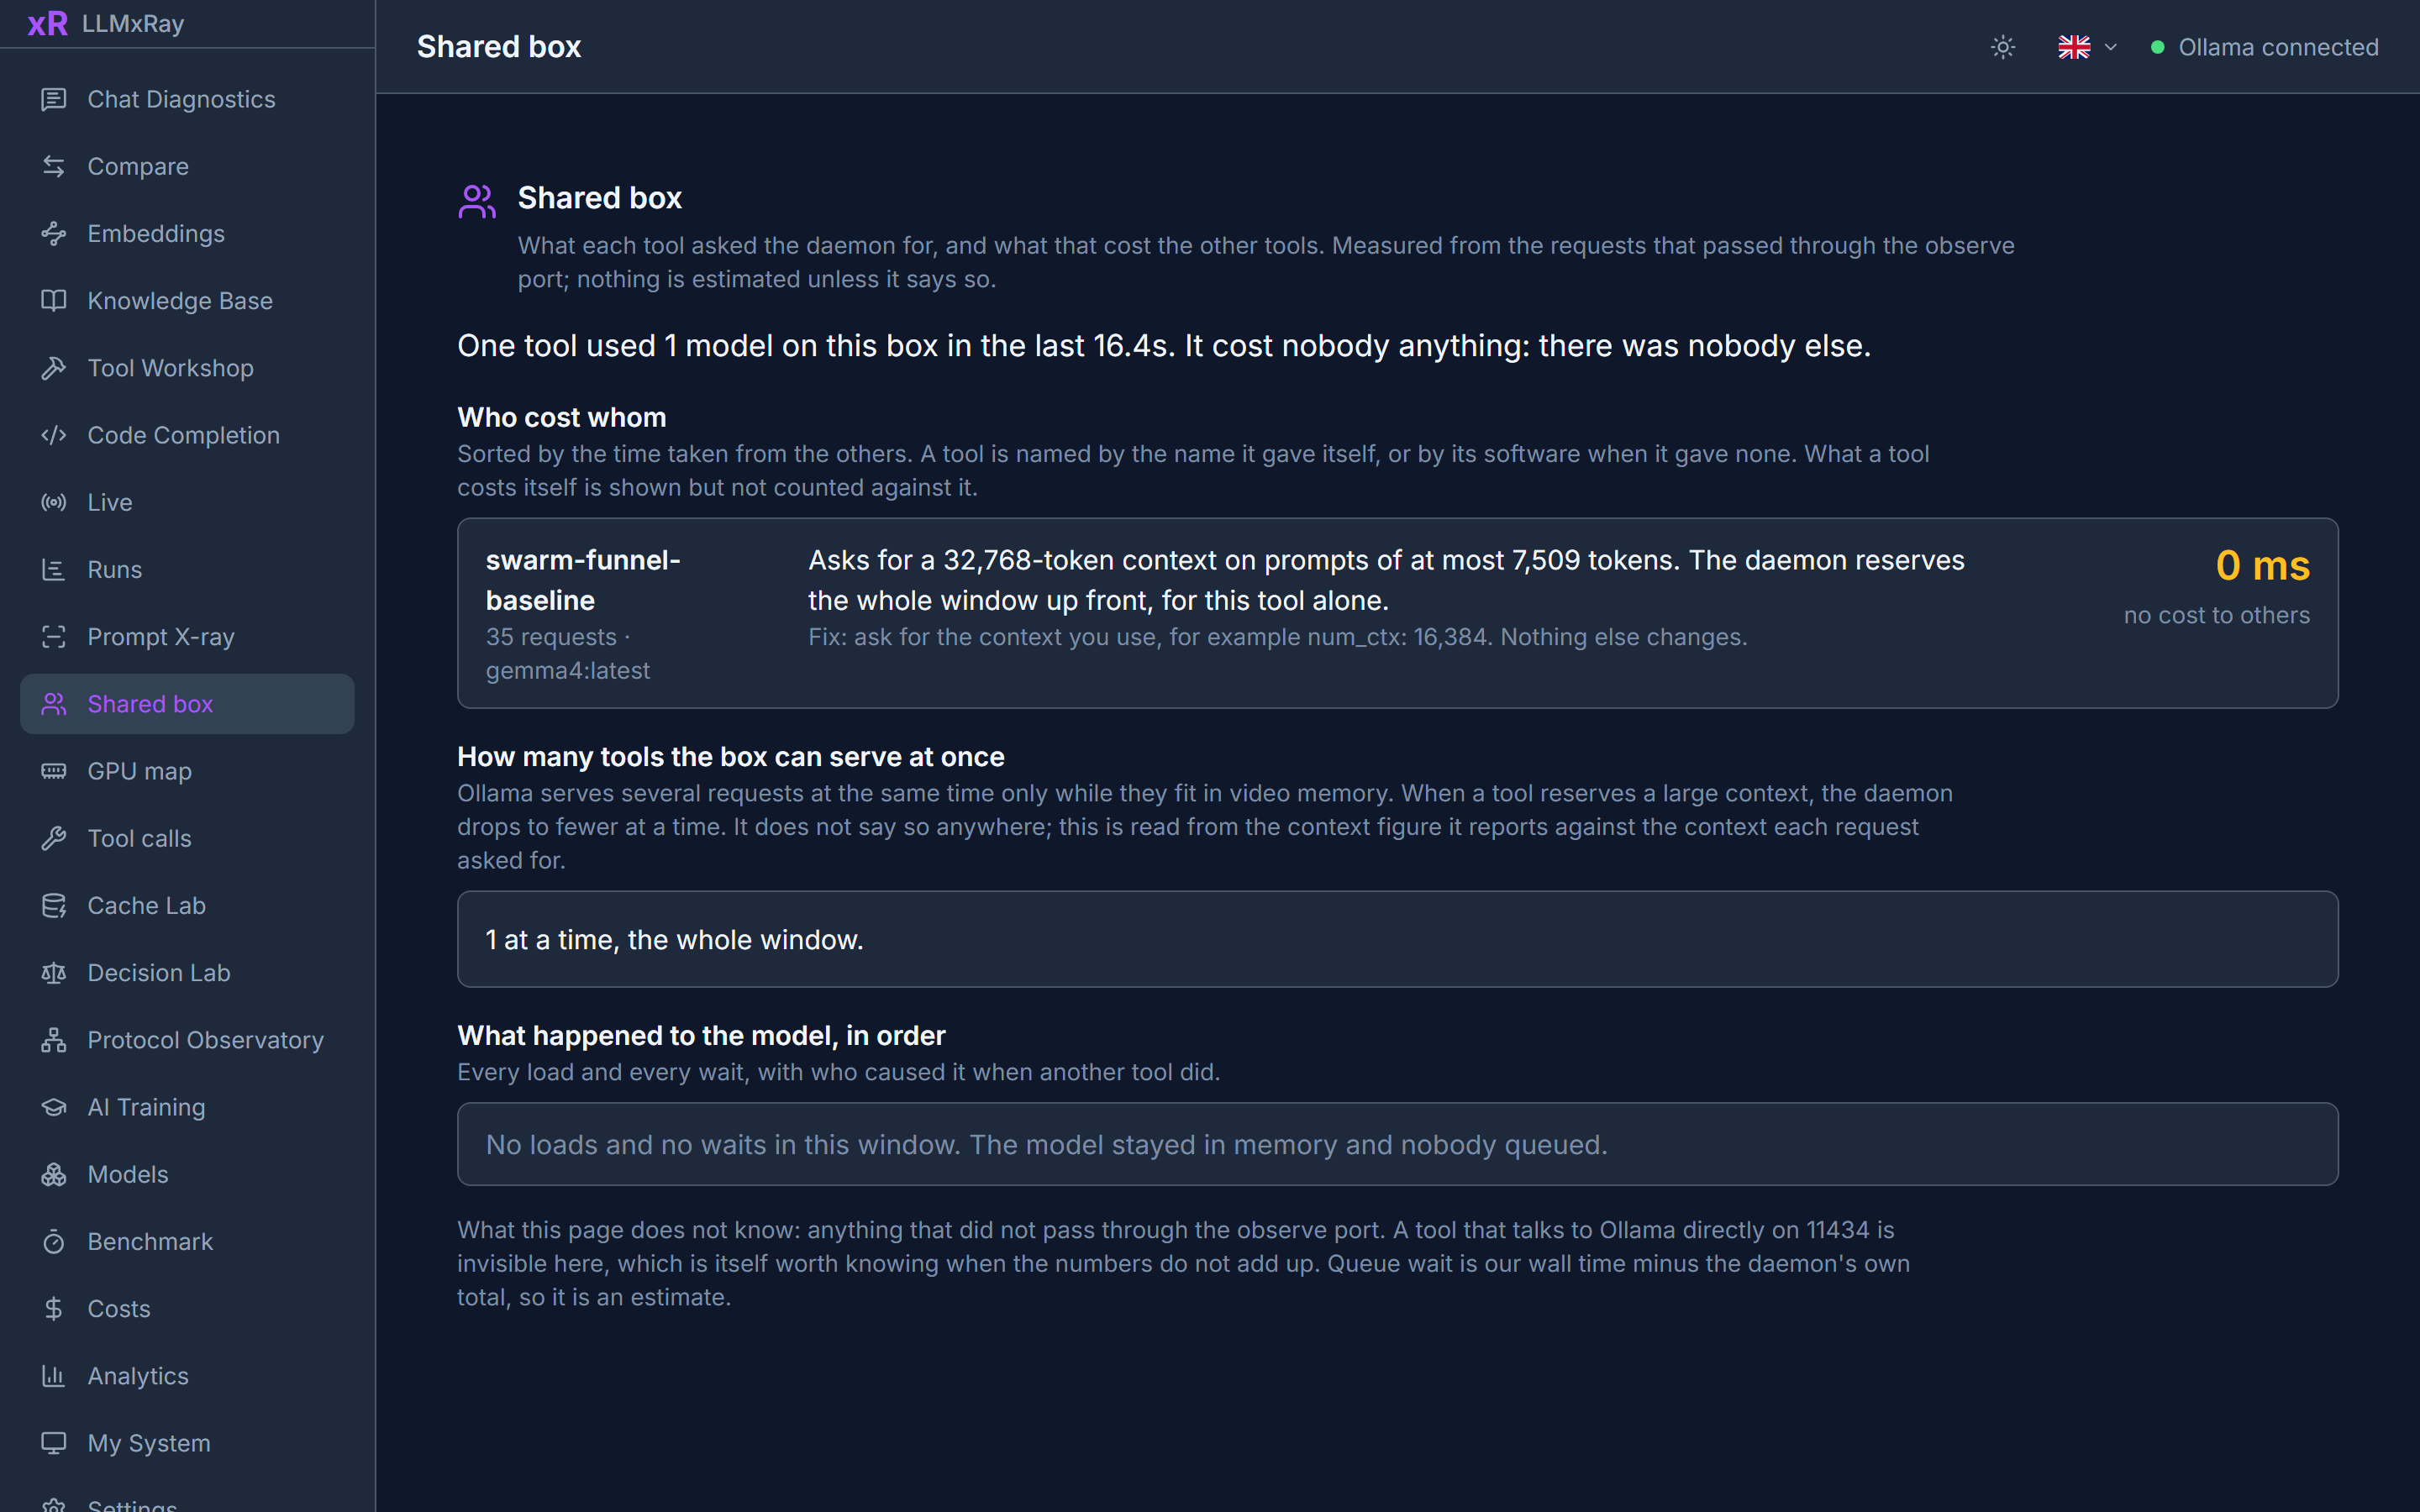
每个工具占一行,按给其他工具带来的成本排序,单位为秒:发送 keep_alive: 0、每次运行后都卸载模型的工具;在 4K 提示词上请求 128K 上下文、导致守护进程一次只能处理一个请求的工具;以及在它们之后等待了 22 秒的工具。每项都会列出需要更改的设置。没有造成任何影响的工具也会列出,让你了解理想情况是什么样的。
GPU 映射:显存中有什么,以及还能装下什么
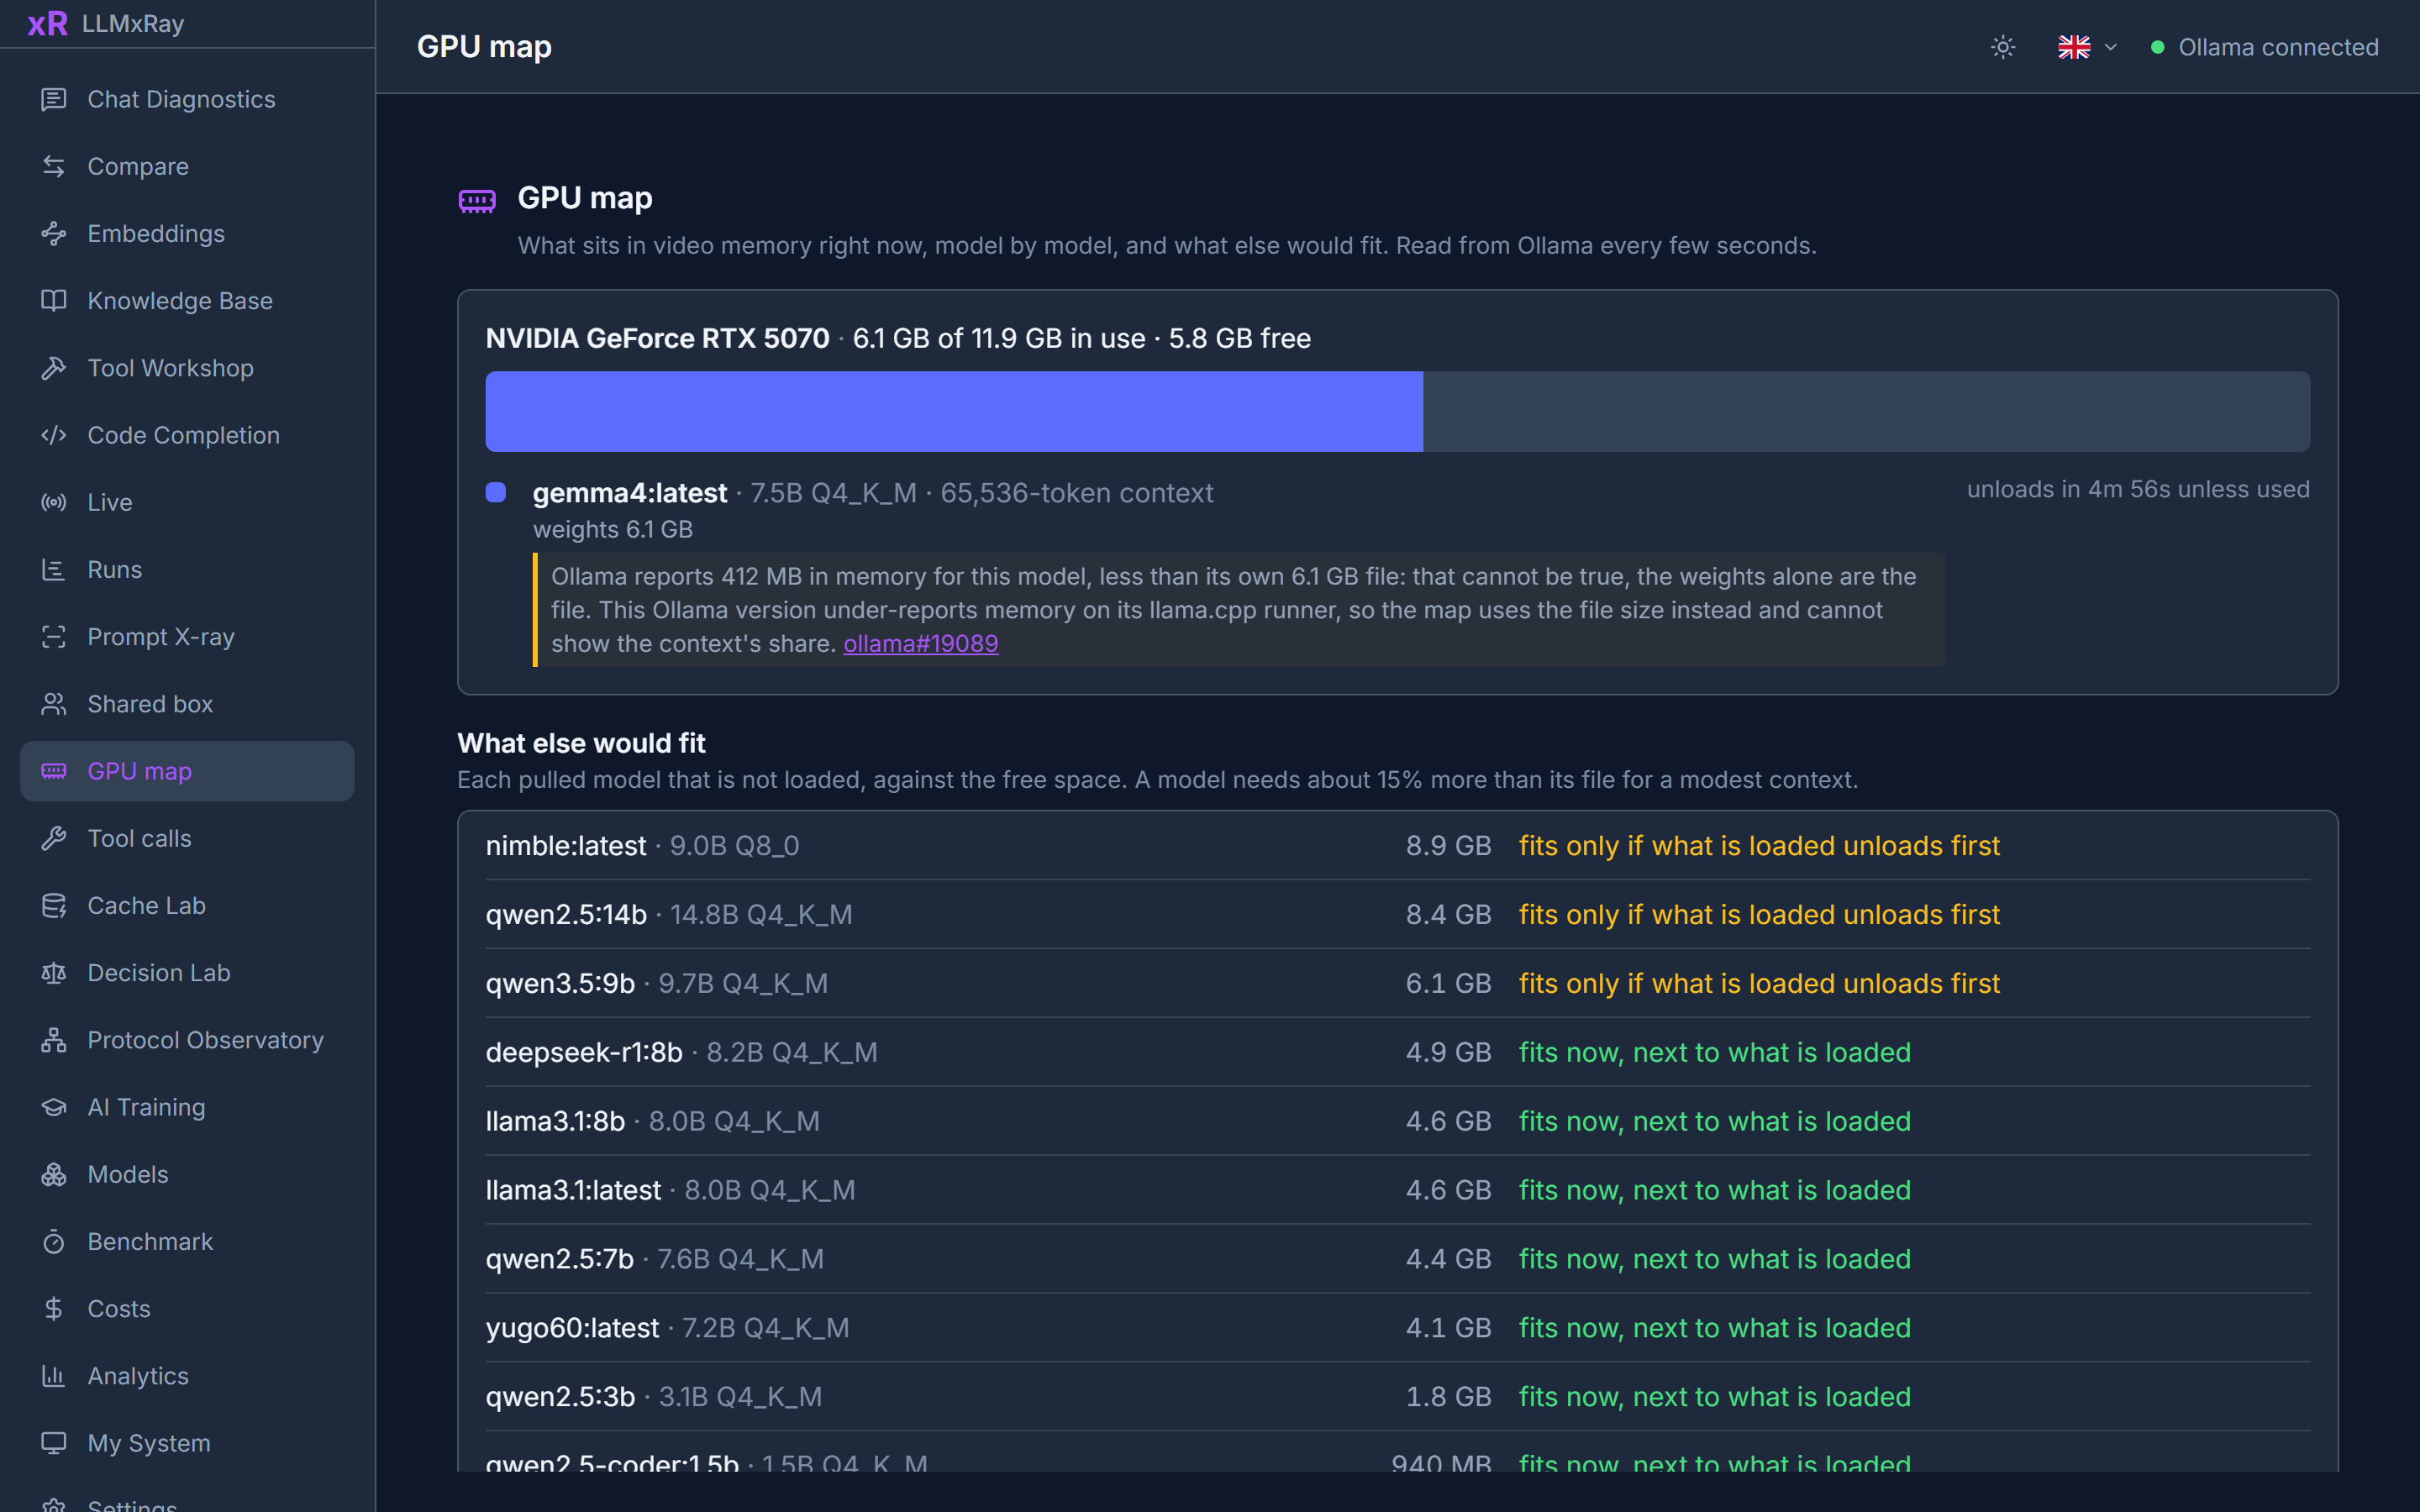
一条与显卡容量等宽的横条:每个已加载模型显示为一个区块,分成模型权重和上下文额外占用的空间,之后是剩余空间。下方列出所有已拉取的模型,并给出三种判断之一:现在能装下、只有卸载当前已加载模型后才能装下、超出显卡容量。
工具调用:这个模型能驱动 Agent 吗?
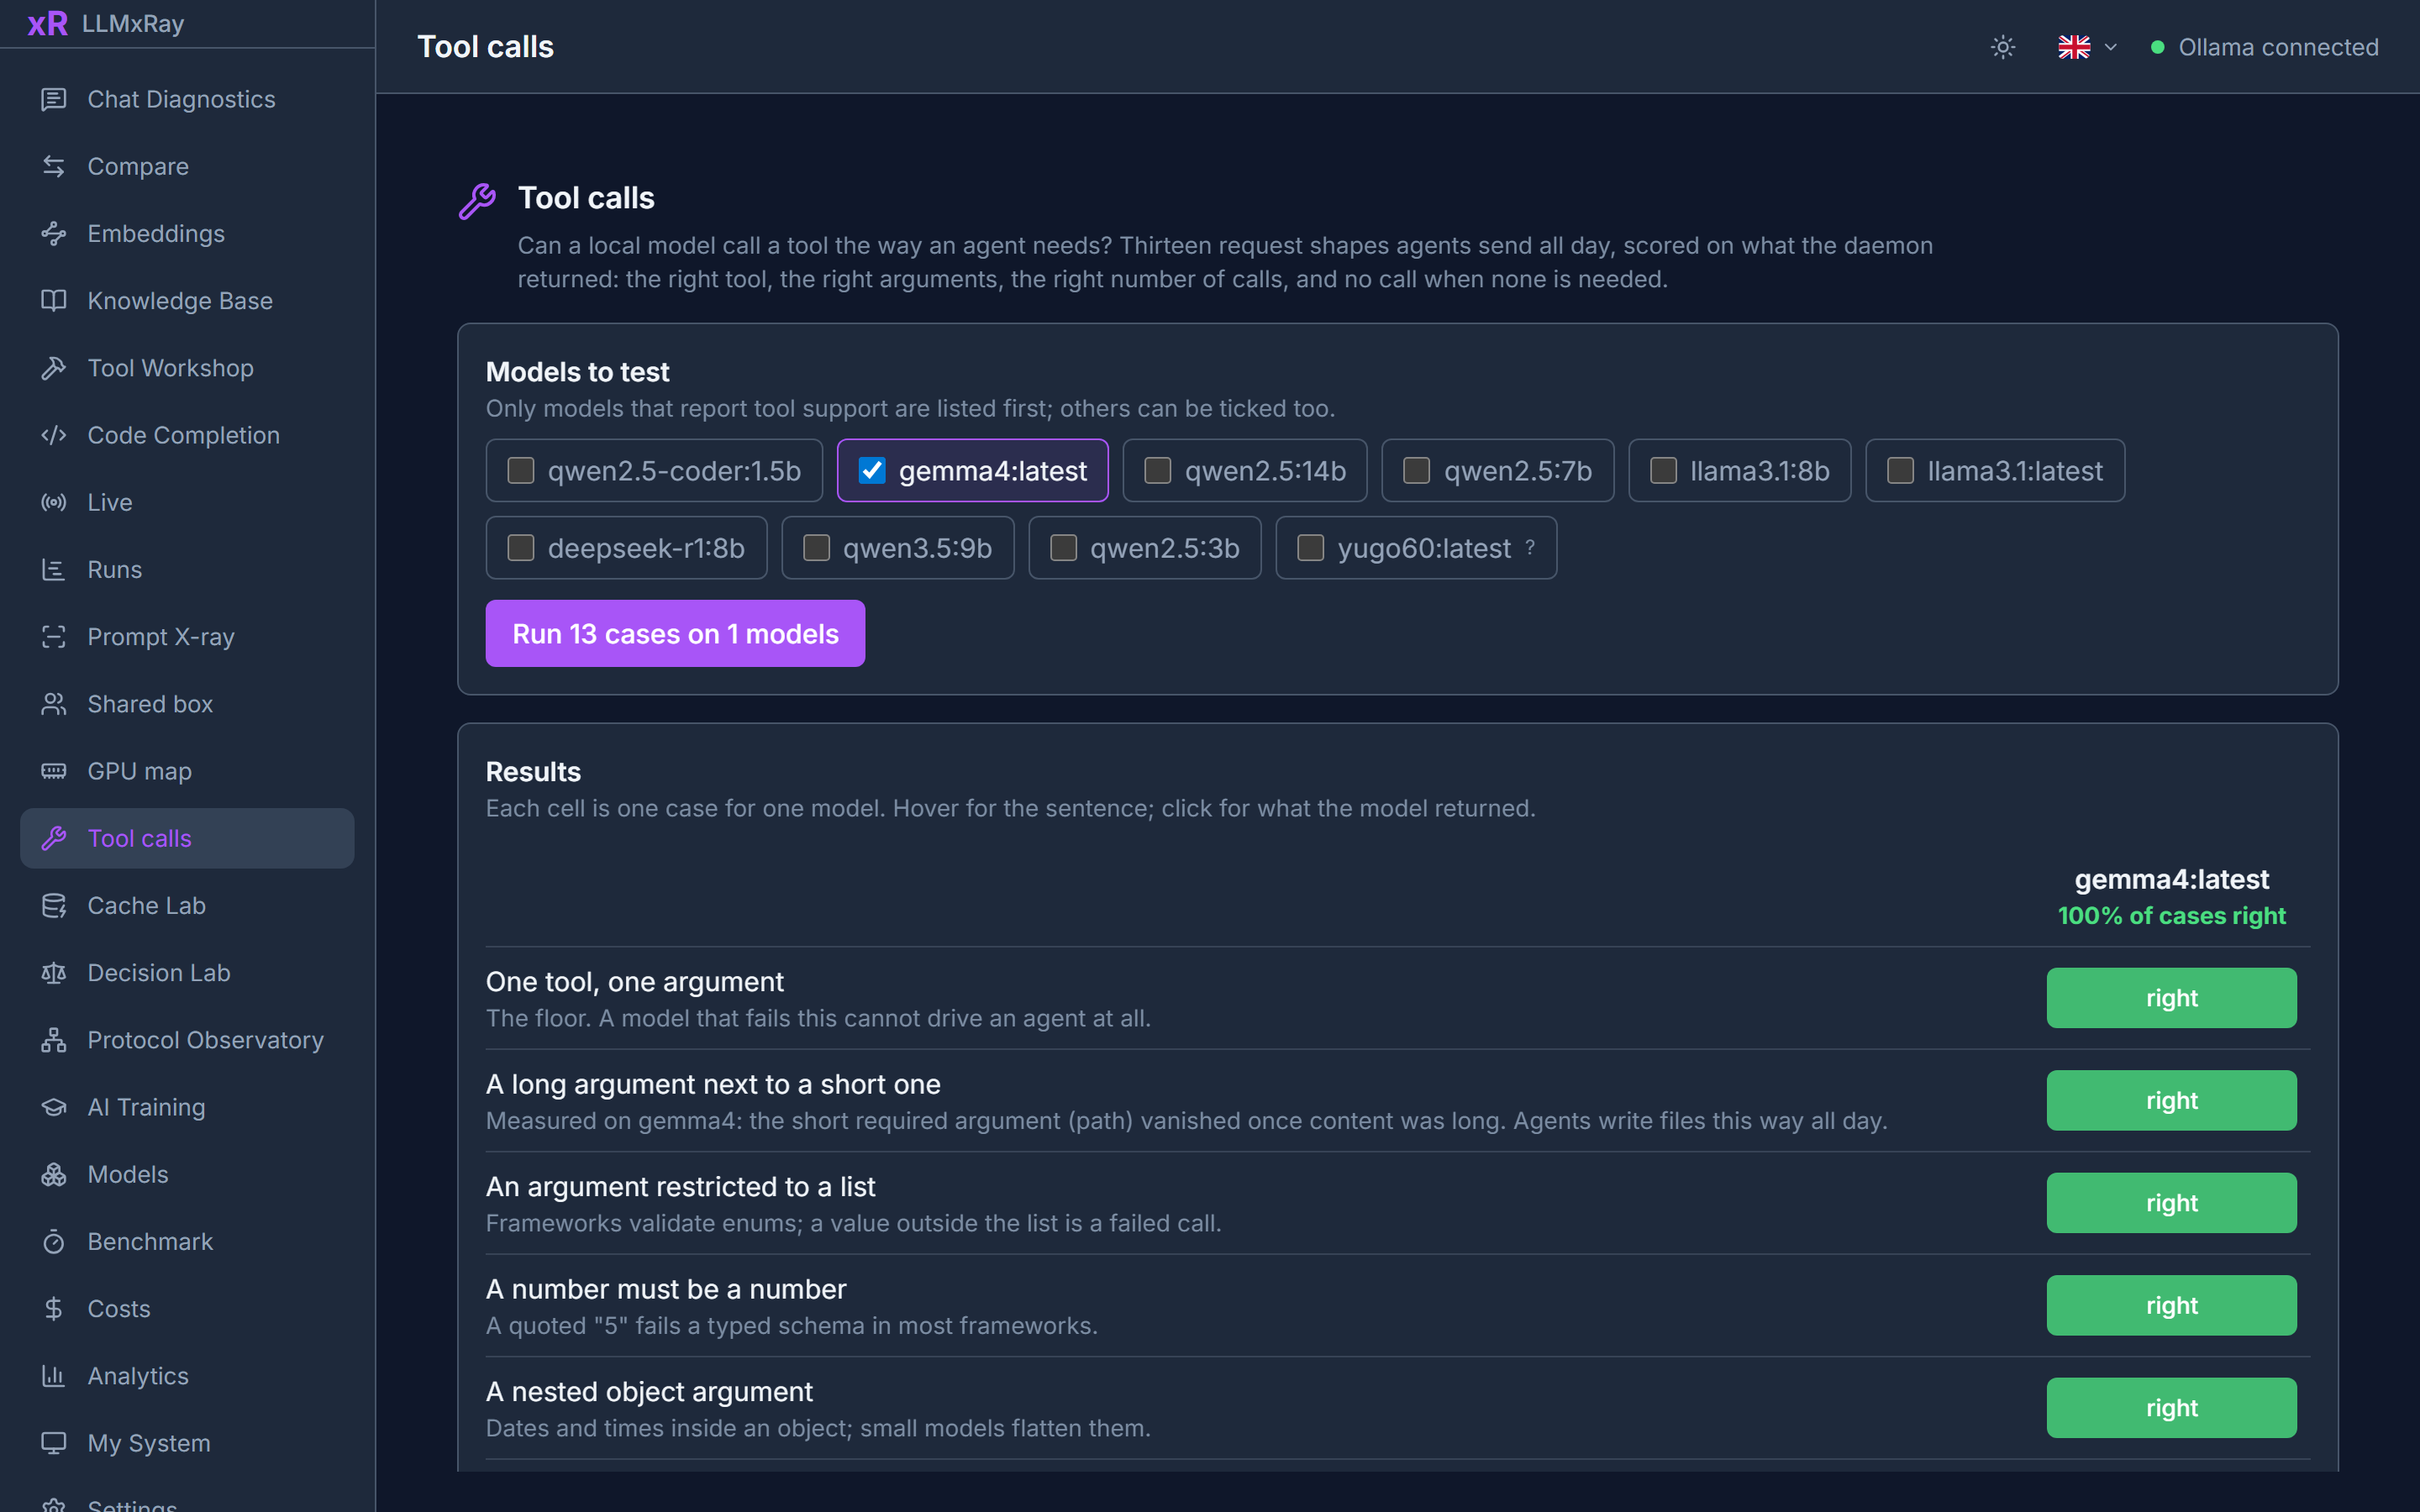
对 Agent 常用的 13 种请求形式进行评分,依据是守护进程返回的内容:工具是否正确、参数是否正确、调用次数是否恰当,以及不需要调用时是否没有发起调用。每个单元格用一句话说明情况,例如“缺少路径参数”“把调用写进了回答文本”“不需要工具时调用了 search_web”。点击即可查看模型的返回内容。
缓存实验室
只有提示词从第一个 token 起完全一致,本地模型才会复用提示词缓存。顶部附近的一个时间戳就可能让后面的内容全部无法复用。缓存实验室会找出不同轮次之间发生变化的值,显示复用从何处失效,然后针对你的守护进程进行测量,看把这些值移到末尾能节省多少时间。
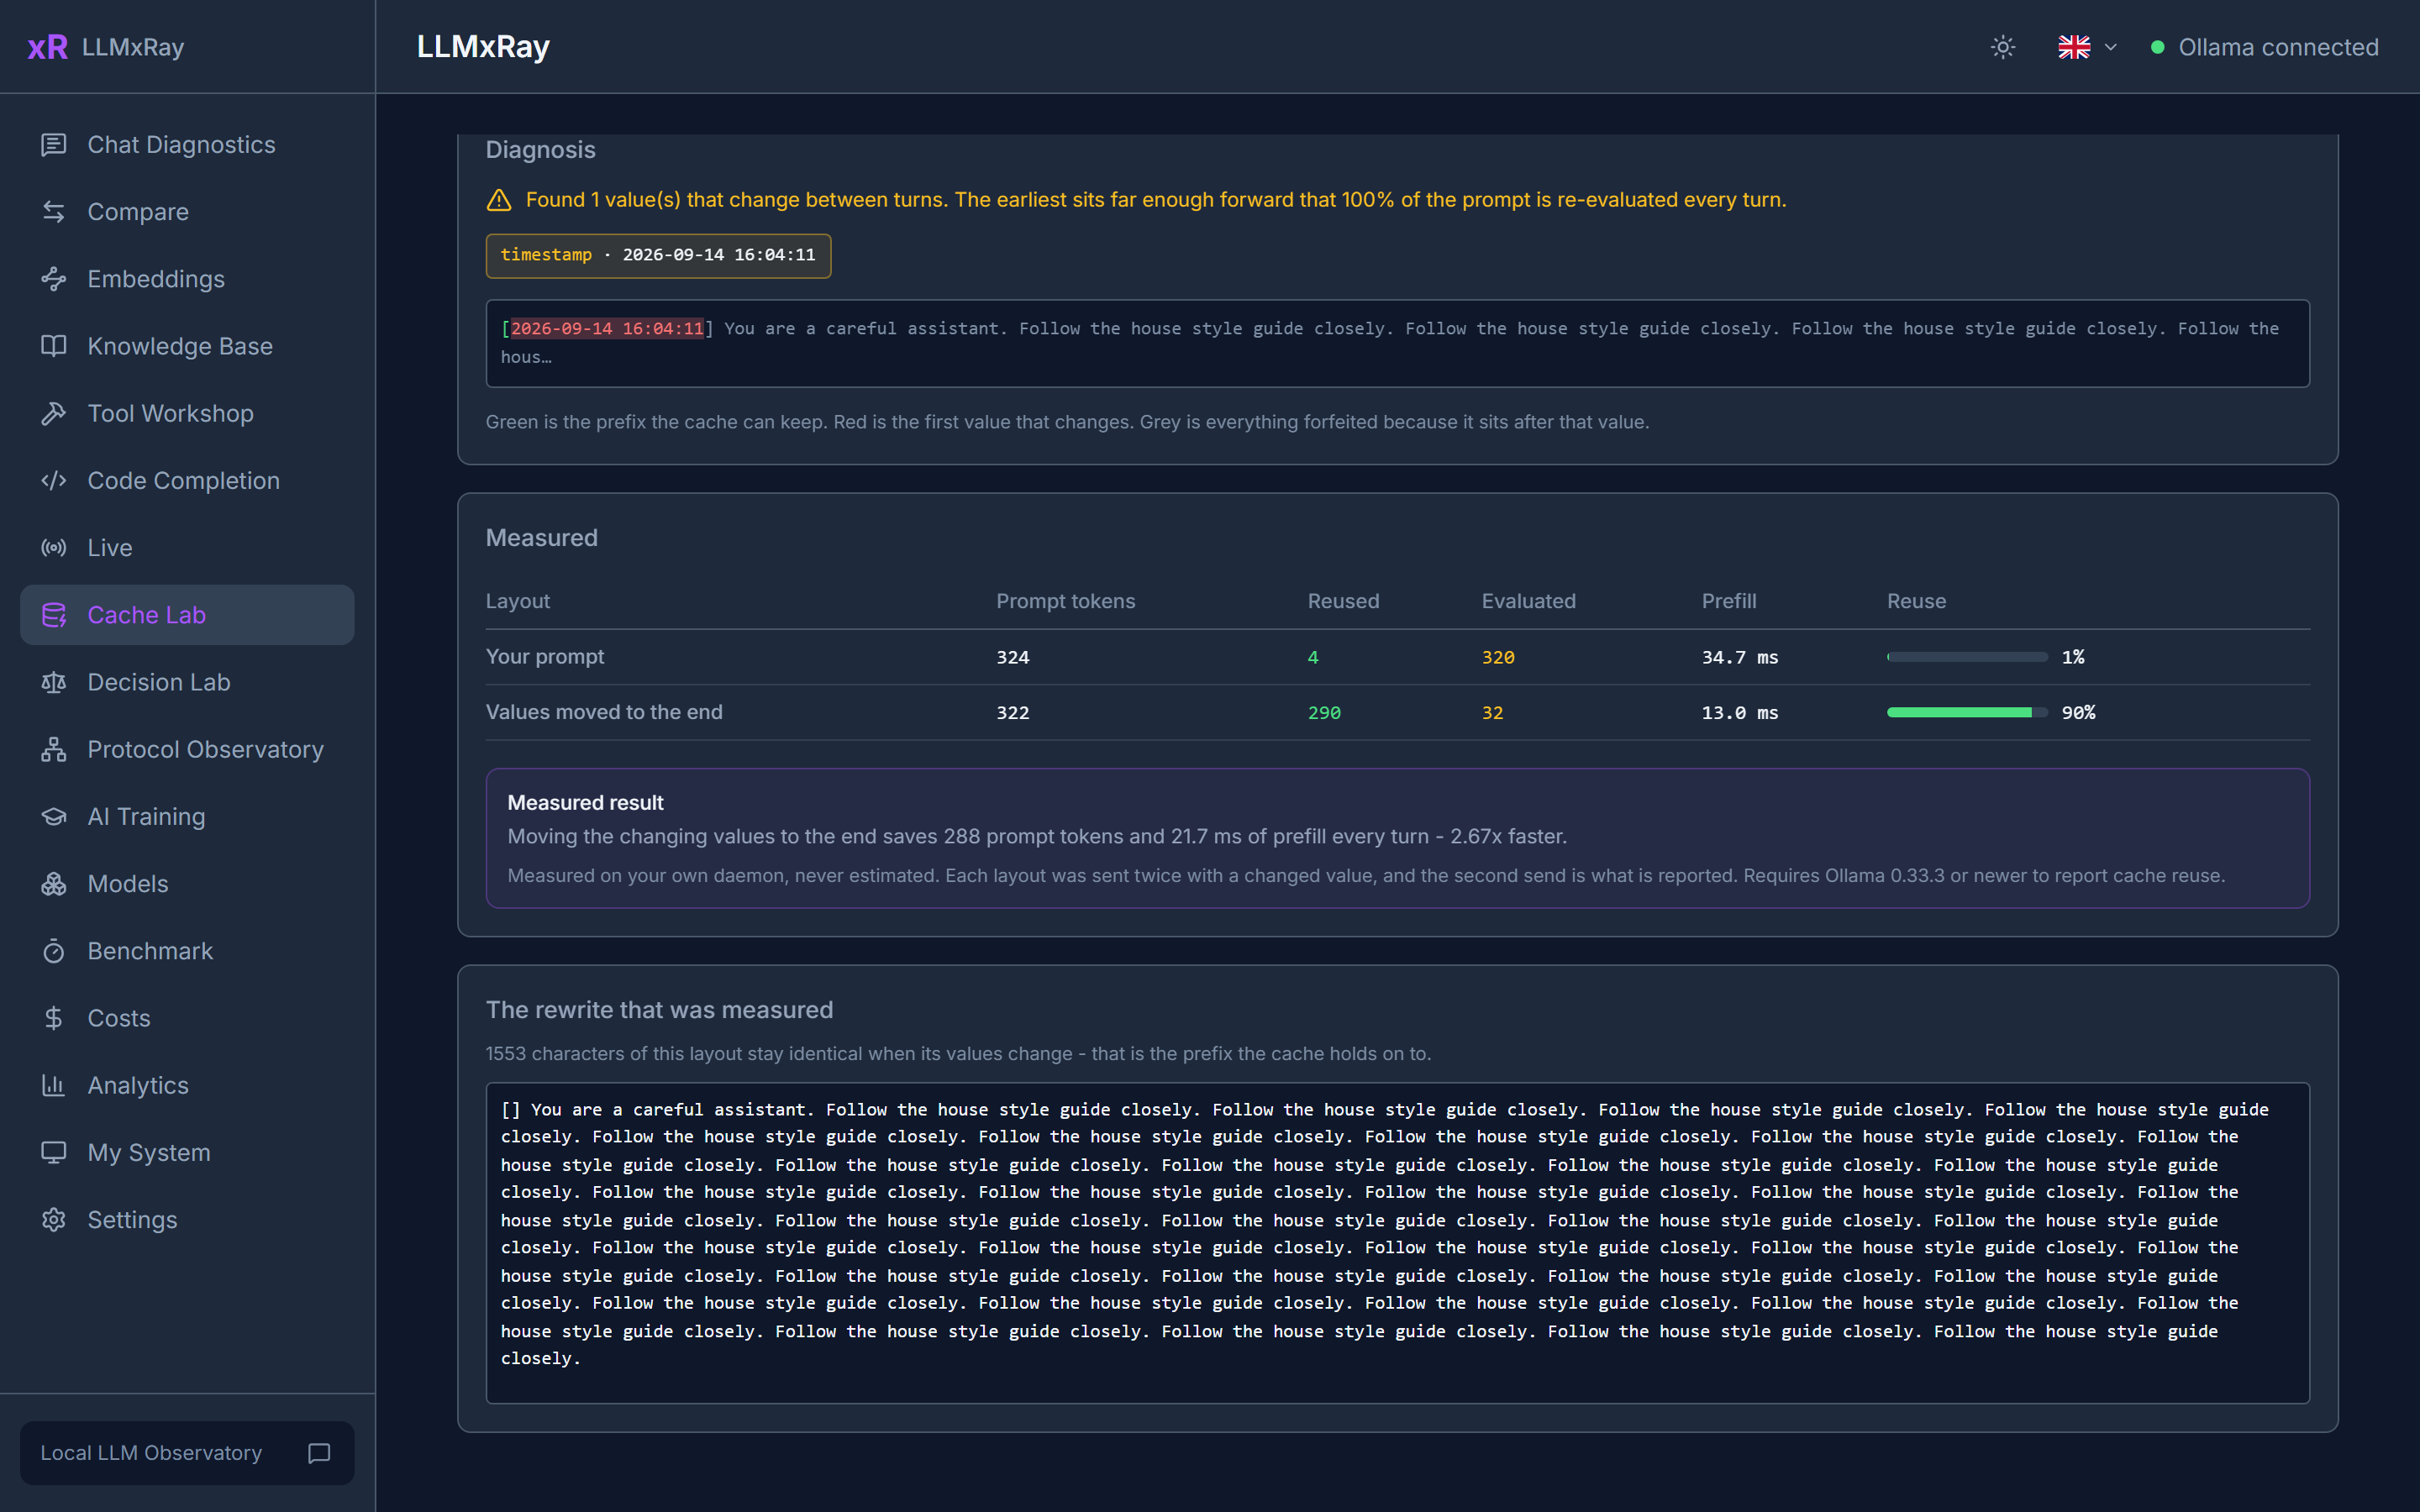
在一个真实的 324-token 提示词上测得:时间戳位于开头时,复用了 4 个 token,预填充耗时 64.6 ms;移到末尾后,复用了 290 个 token,耗时 18.6 ms。速度提升 3.5 倍,用词不变。
协议观测站
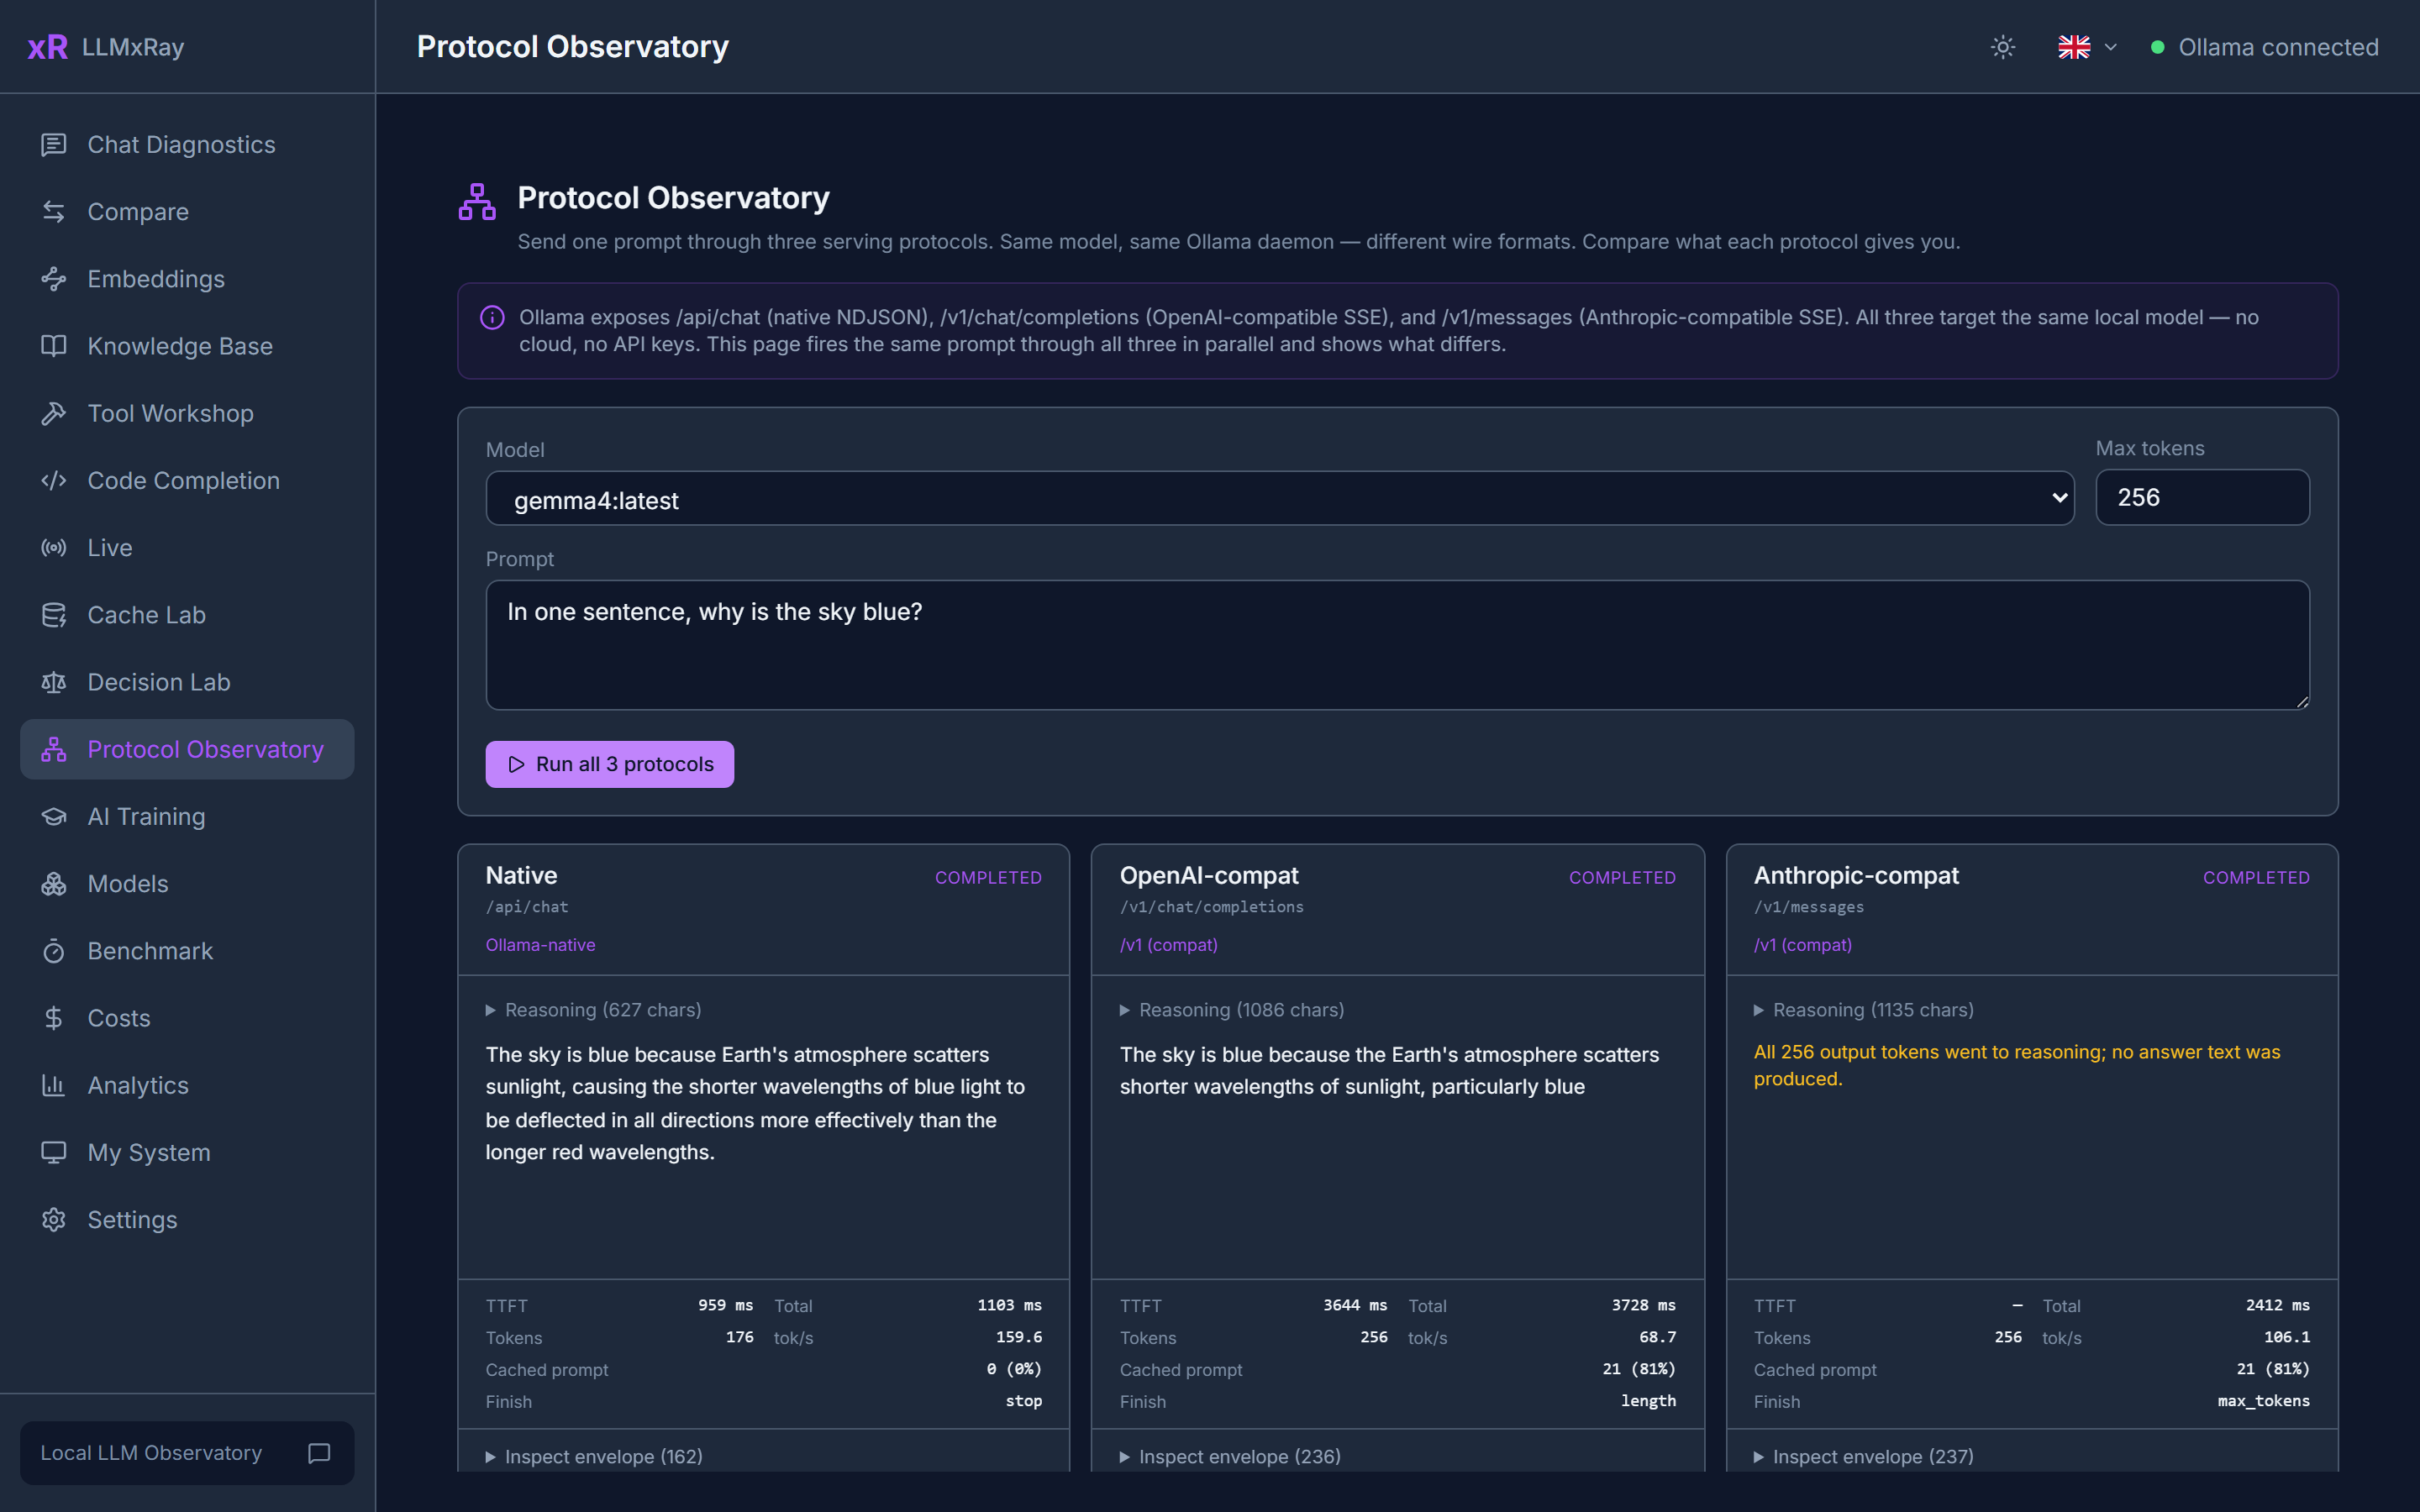
通过 Ollama 的三种服务协议并行发送相同提示词:原生 /api/chat、兼容 OpenAI 的 /v1/chat/completions,以及兼容 Anthropic 的 /v1/messages。并排查看流式输出和各协议指标,还可查看信封差异,了解每种协议如何封装结束原因、token 数量和错误。
保留记录,并将其发送出去
每轮的记录(令牌、缓存、耗时、客户端、模型,不包括文本)会在你的机器上保留 30 天,因此重启后可以从中断处继续。实时视图、运行记录、提示词 X 光和 MCP 工具都会照常工作。
如果你的团队已经在查看追踪记录,可以将这些轮次发送过去:每次模型调用都会成为一个包含查看器已支持的 GenAI 属性的 OpenTelemetry span,每次运行都会成为一条追踪记录,而调用之间的工具耗时则会成为独立的 span,其瀑布图与运行记录中的相同。在实时页面设置地址,或设置 OTEL_EXPORTER_OTLP_ENDPOINT。
| 查看器 | 地址 |
|---|---|
Jaeger (docker run -p 16686:16686 -p 4318:4318 jaegertracing/jaeger) | http://localhost:4318 |
Arize Phoenix (docker run -p 6006:6006 arizephoenix/phoenix) | http://localhost:6006 |
| Langfuse | https://cloud.langfuse.com/api/public/otel,并使用你的密钥生成 Basic 标头 |
| Grafana Tempo、OpenTelemetry Collector | 其 OTLP HTTP 地址,通常使用 4318 端口 |
只有同时开启 保留提示词文本 和 在每个 span 中包含提示词文本,提示词文本才会一并发送。
面向 Agent
如果你是一个运行在本地模型上的 Agent,LLMxRay 可以告诉你自己的调用出了什么问题。只需两步。
- 将 Ollama 调用发送到端口 11435,而不是 11434。它的行为与 Ollama 完全相同,并会转发所有内容;LLMxRay 只记录经过它的内容。
- 将 LLMxRay MCP 服务添加到你的工具中:
{ "mcpServers": { "llmxray": { "command": "npx", "args": ["-y", "-p", "llmxray", "llmxray-mcp"] } } }
七个工具,全部只读,数据不会离开本机:
| 工具 | 可回答的问题 |
|---|---|
diagnose_my_turns | 最近几轮有哪些值得注意的问题,并以句子形式给出修复建议:提示词因超过已加载的上下文而被拒绝、提示词缓存每轮或某一轮都未命中、模型部分运行在 CPU 上、工具架构挤占了提示词空间。 |
read_my_last_turn | 用数字展示上一轮:提示词令牌数和缓存占比、预填充耗时和速度、生成令牌数和速度、生成停止原因、提示词由哪些内容组成,以及模型是否装入了显存。 |
list_local_models | 已拉取哪些模型、它们的大小和量化方式、当前加载了哪些模型及其上下文大小,以及每个模型是否能装入显存。 |
list_my_turns | 历史记录:每轮一行,列出令牌数、缓存占比、预填充、生成速度、停止原因和标记。 |
compare_my_turns | 某项更改是否有帮助:比较某个时间点前后的缓存占比、预填充、速度和提示词大小的中位数,并给出结论。 |
estimate_my_prompt | 发送前检查:含 N 个令牌的提示词是否适合已加载的上下文、还剩多少空间、模型是否位于显存中,以及缓存可以复用多少内容。 |
read_llmxray_status | LLMxRay 的运行位置、观察端口、它转发请求到的 Ollama,以及它保留多少轮记录。 |
LLMxRay 本身必须正在运行(npx llmxray)。MCP 服务通过 localhost 从中读取数据。
也可以使用 Agent Skill,让你的 Agent 加载相同的操作流程:npx skills add LogneBudo/llmxray(skills.sh)或 clawhub install llmxray-diagnose-ollama-calls(ClawHub)。源码:skills/diagnose-ollama-calls/SKILL.md。
为自己命名,这样就能识别出属于你的轮次:发送标头 X-LLMxRay-Client: my-agent,或将 http://localhost:11435/?client=my-agent 用作基础 URL,并在工具中将 my-agent 作为 client 传入。基础 URL 的设置位置:Ollama SDK 和 CLI 使用 OLLAMA_HOST=127.0.0.1:11435;兼容 OpenAI 的客户端使用 base_url=http://localhost:11435/v1;Claude Code 使用 ANTHROPIC_BASE_URL=http://localhost:11435;Continue 使用 apiBase;Open WebUI 使用 OLLAMA_BASE_URL。
还包含这些功能
你运行一个本地模型,并与它聊天。LLMxRay 会回答接下来的问题:每个令牌生成得有多快、提示词耗费了什么、缓存有没有帮助、哪个设置确实更好,以及你的其他工具向同一个模型发送了什么。
下面的每个页面都会解答其中一个问题。
逐个 Token 聊天
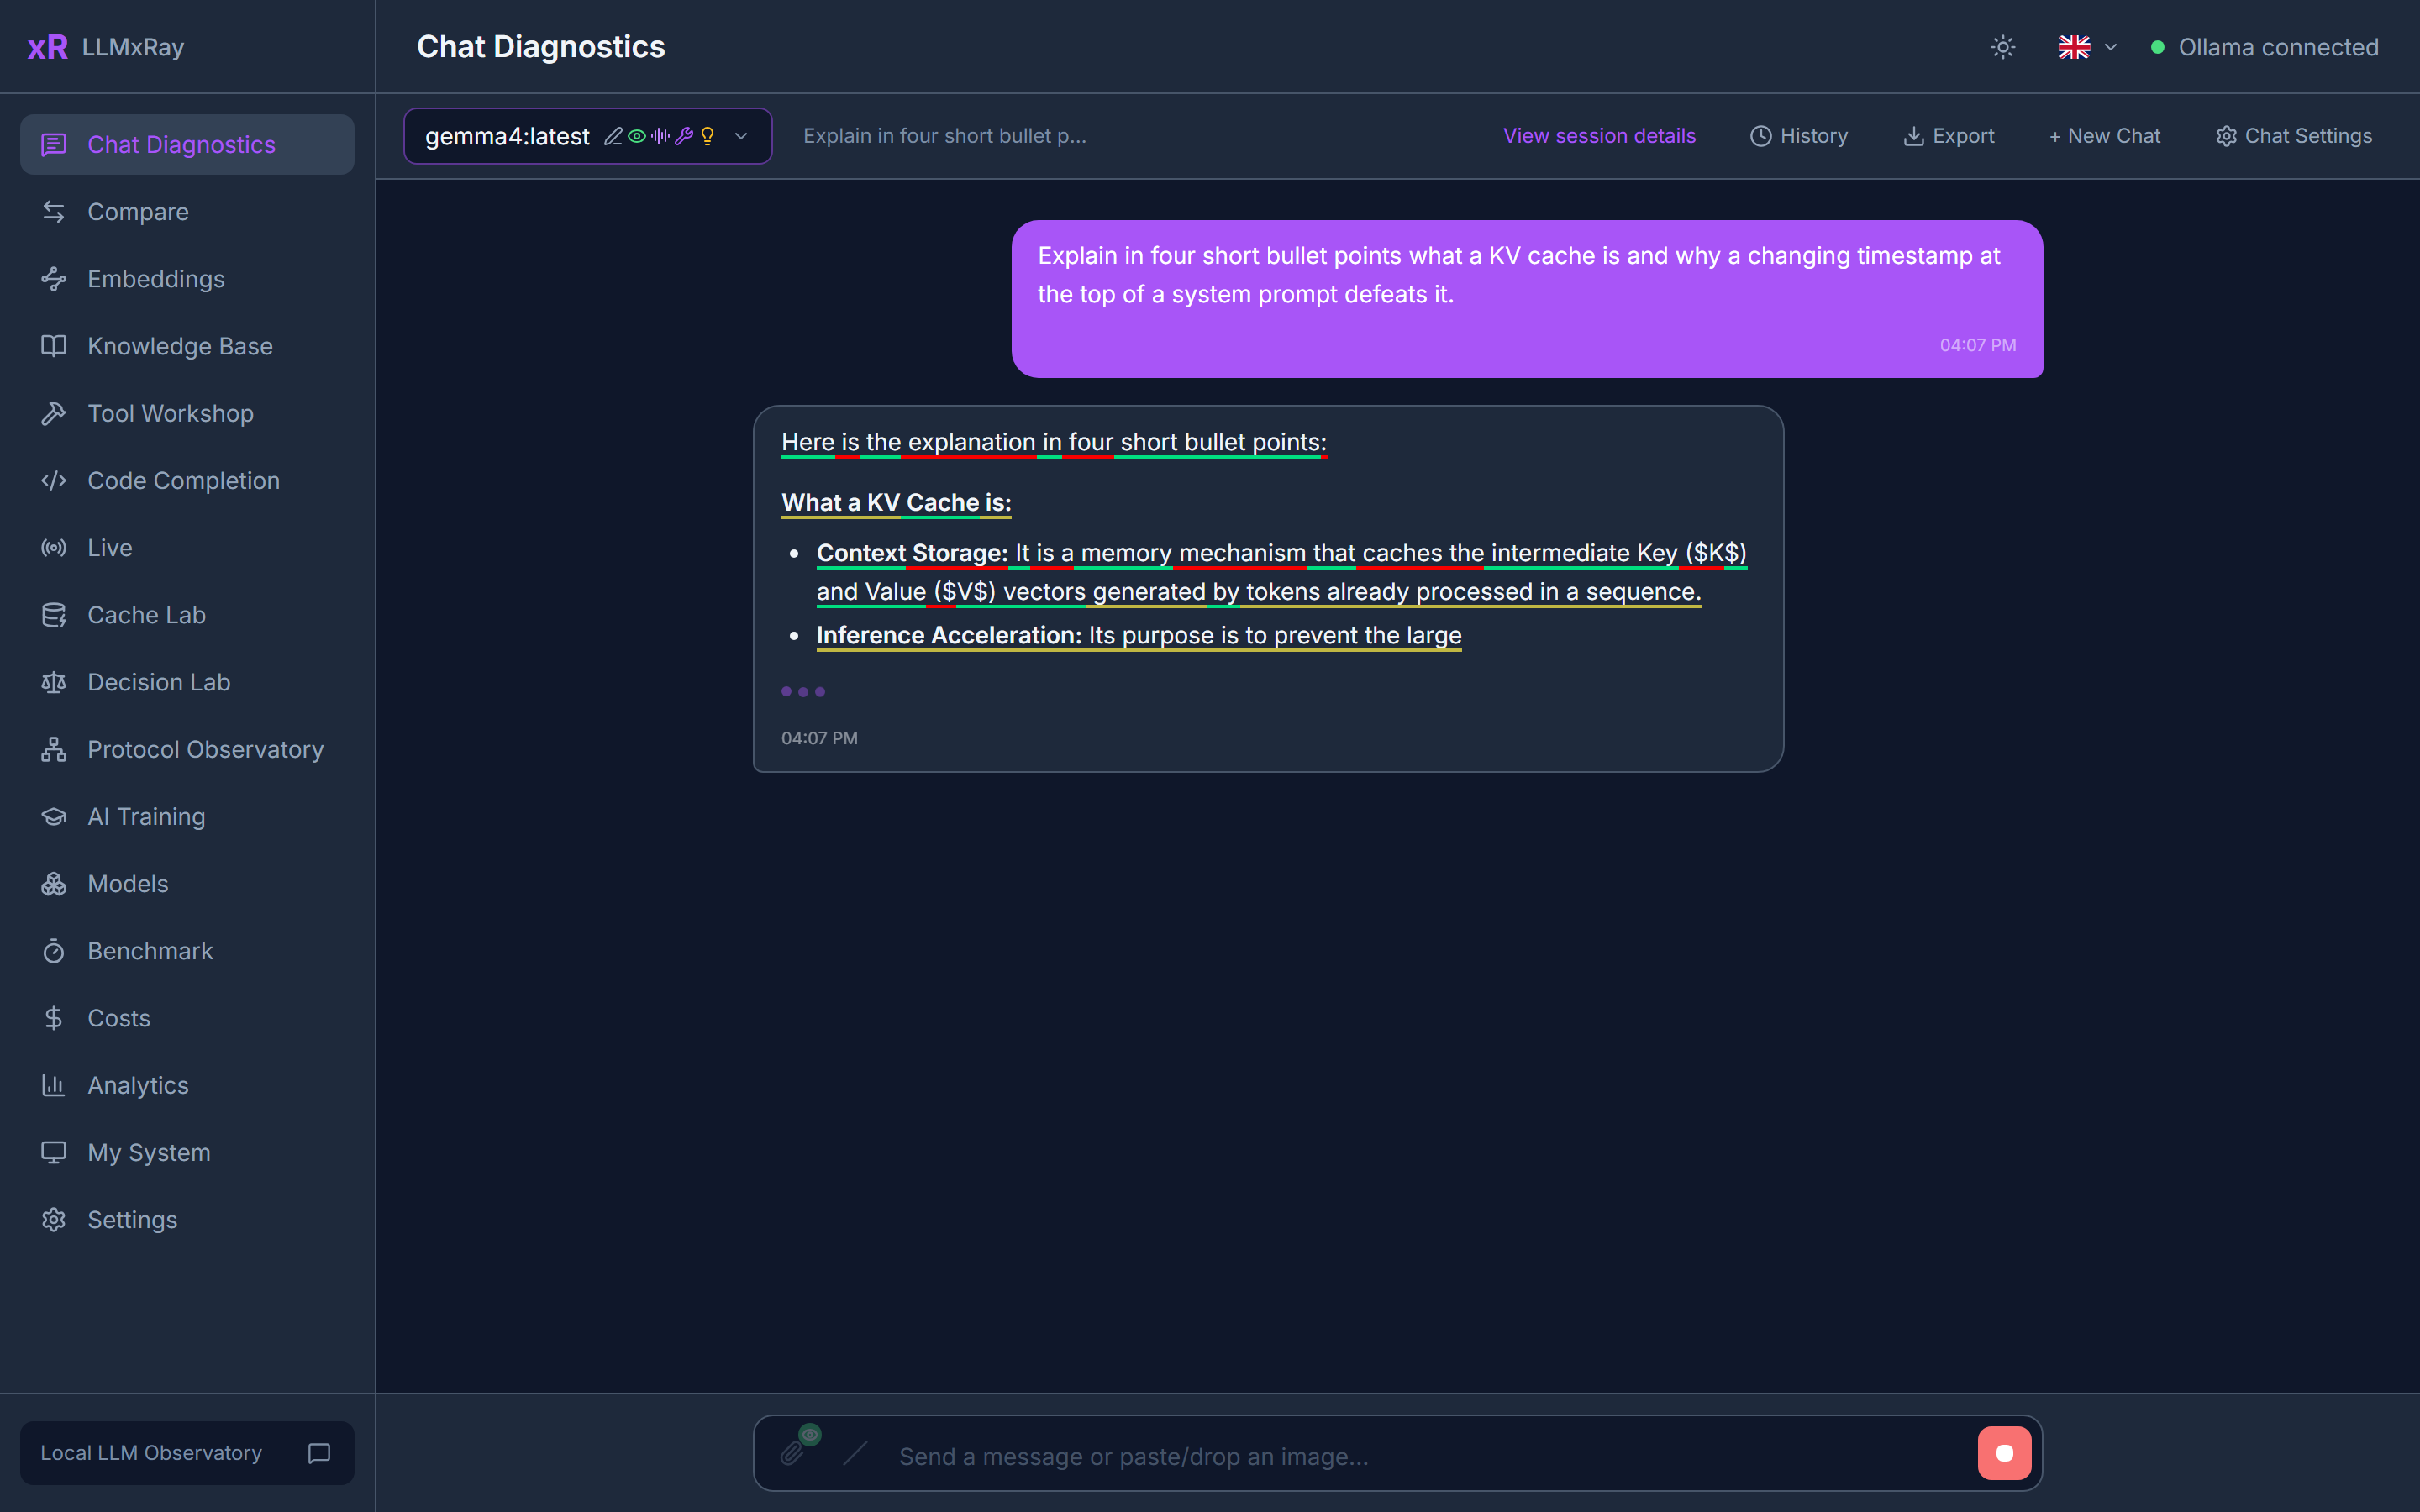
每个 Token 到达时都会立即绘制,并根据 Ollama 的 logprobs 按模型为其分配的概率着色。你可以看到模型在哪里犹豫、在哪里胸有成竹。支持 Markdown、多轮对话、文件和图片附件、斜杠命令,以及供推理模型使用的思考预算(关闭、由模型决定,或低/中/高/最高)。
每条回复也会在生成时接受检查。只有发现问题时才会显示徽章:重复、拒绝、乱码、空答案,或因达到 Token 上限而截断的回复。
截图
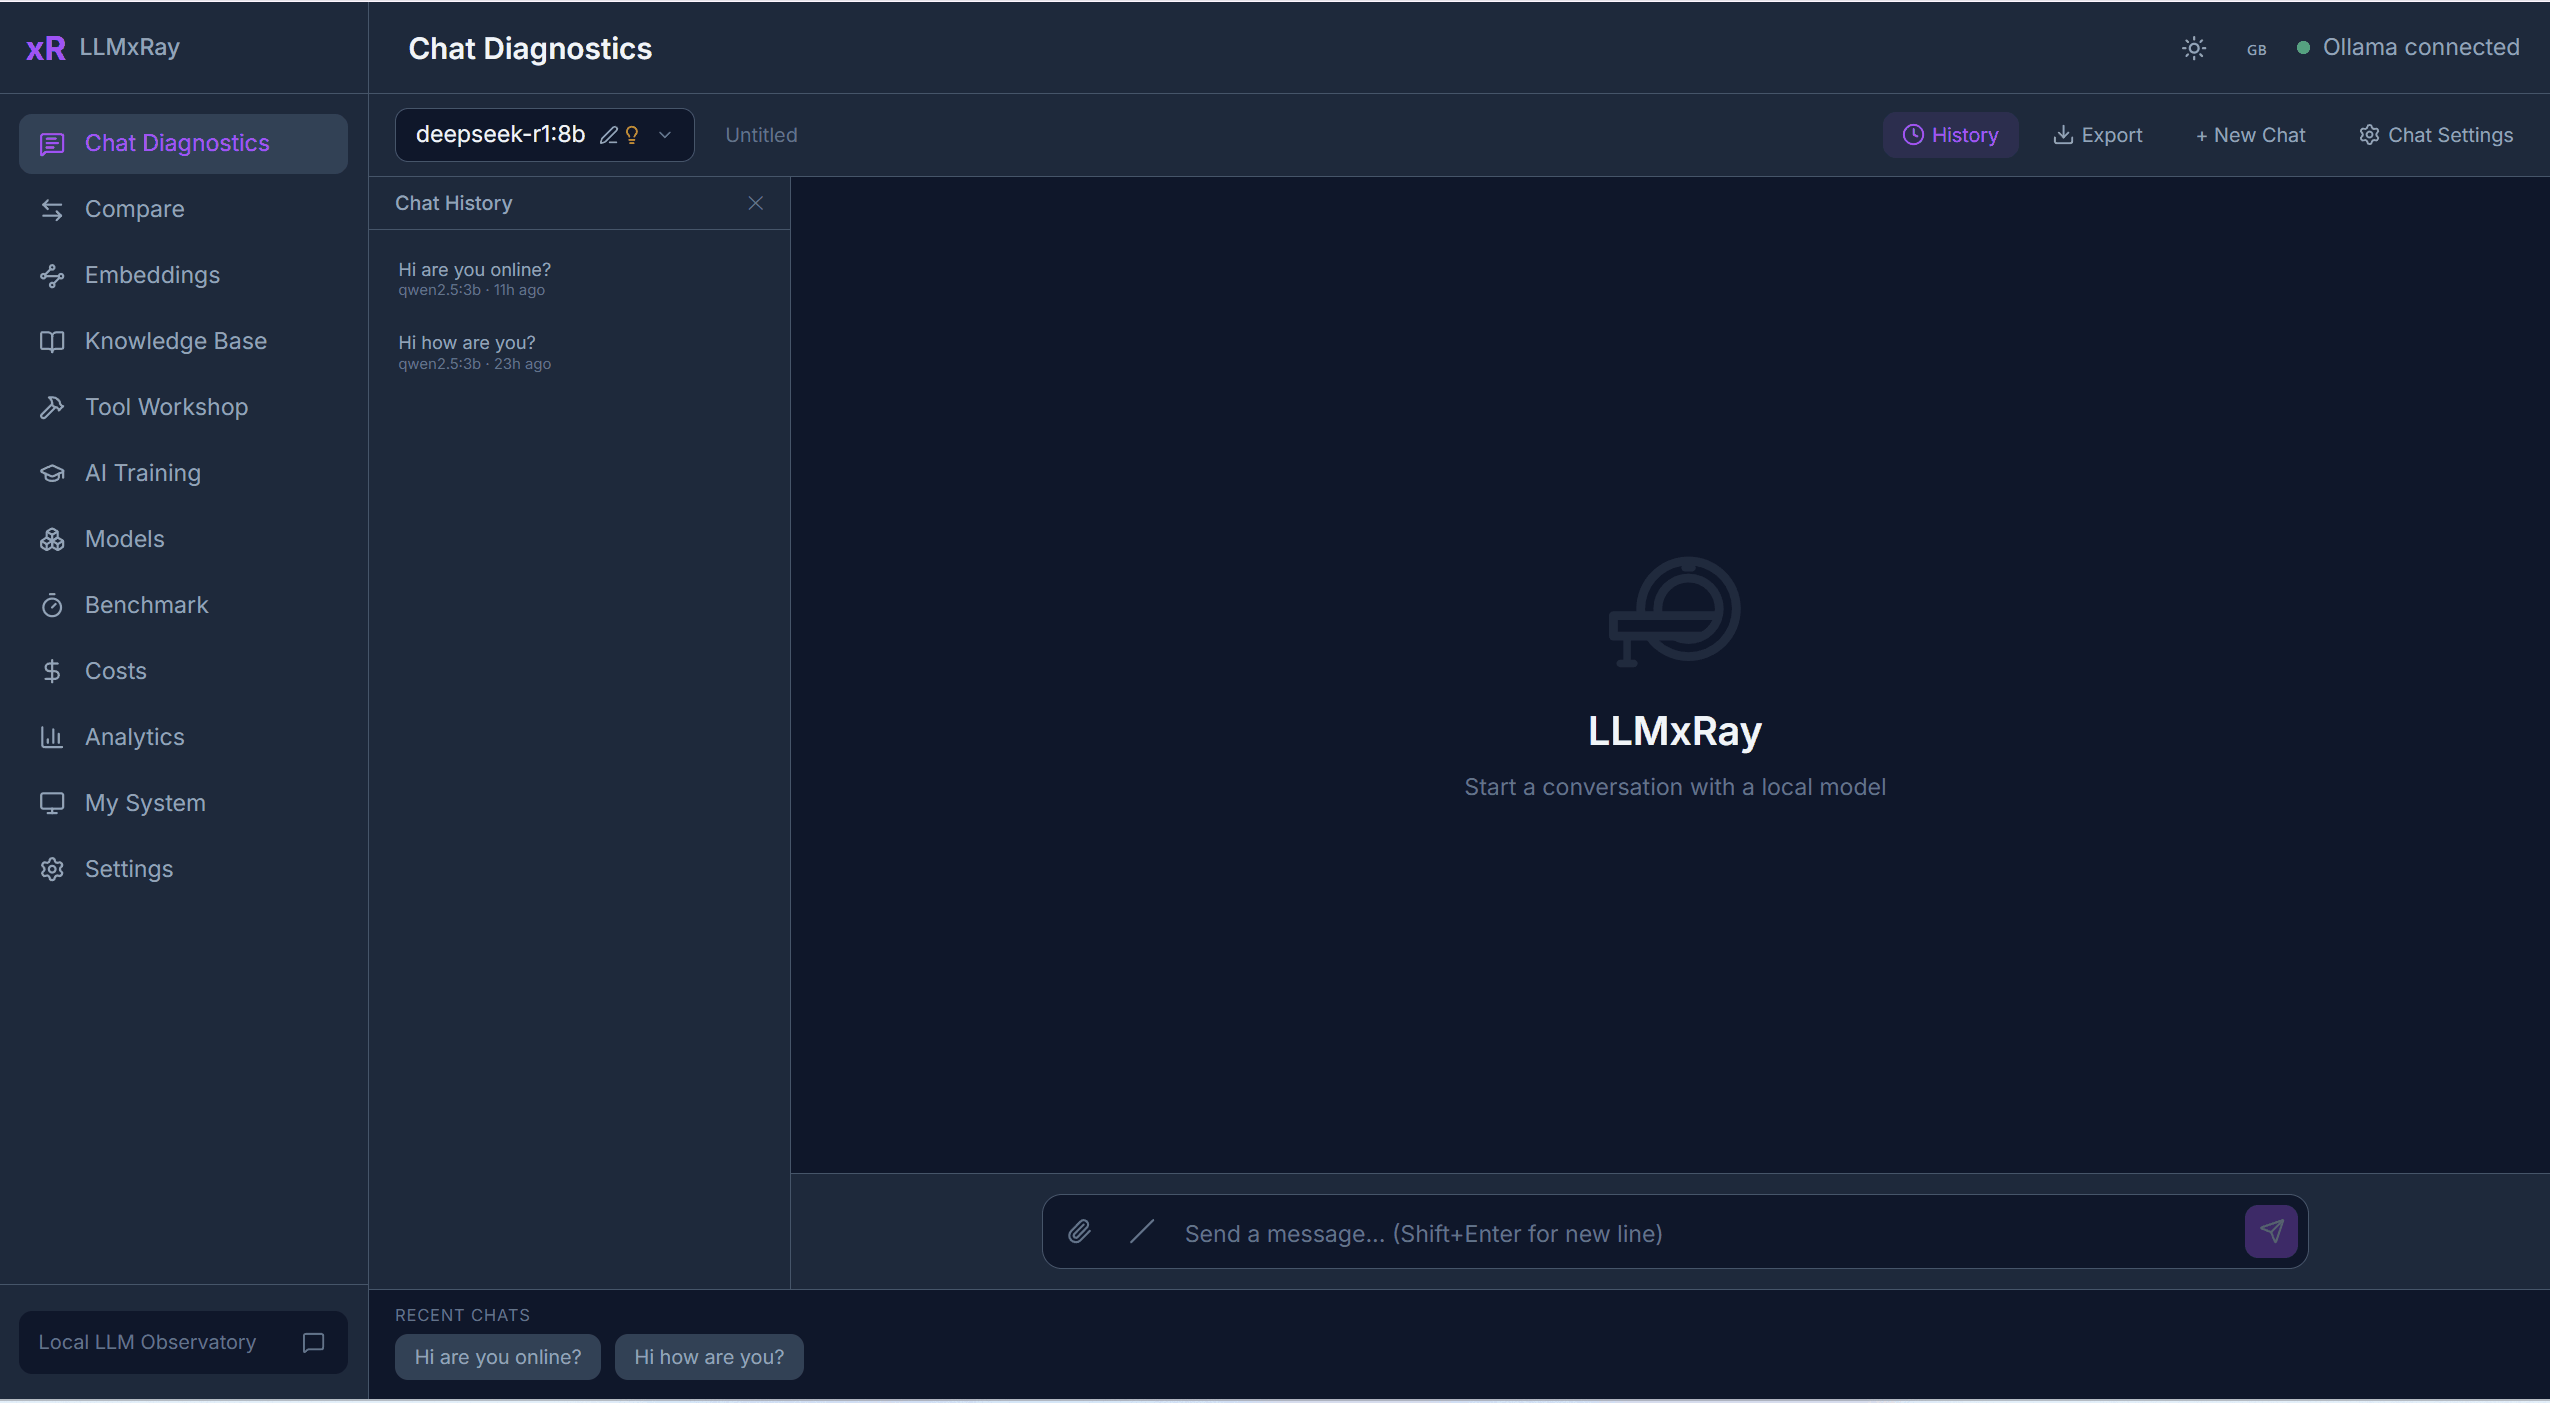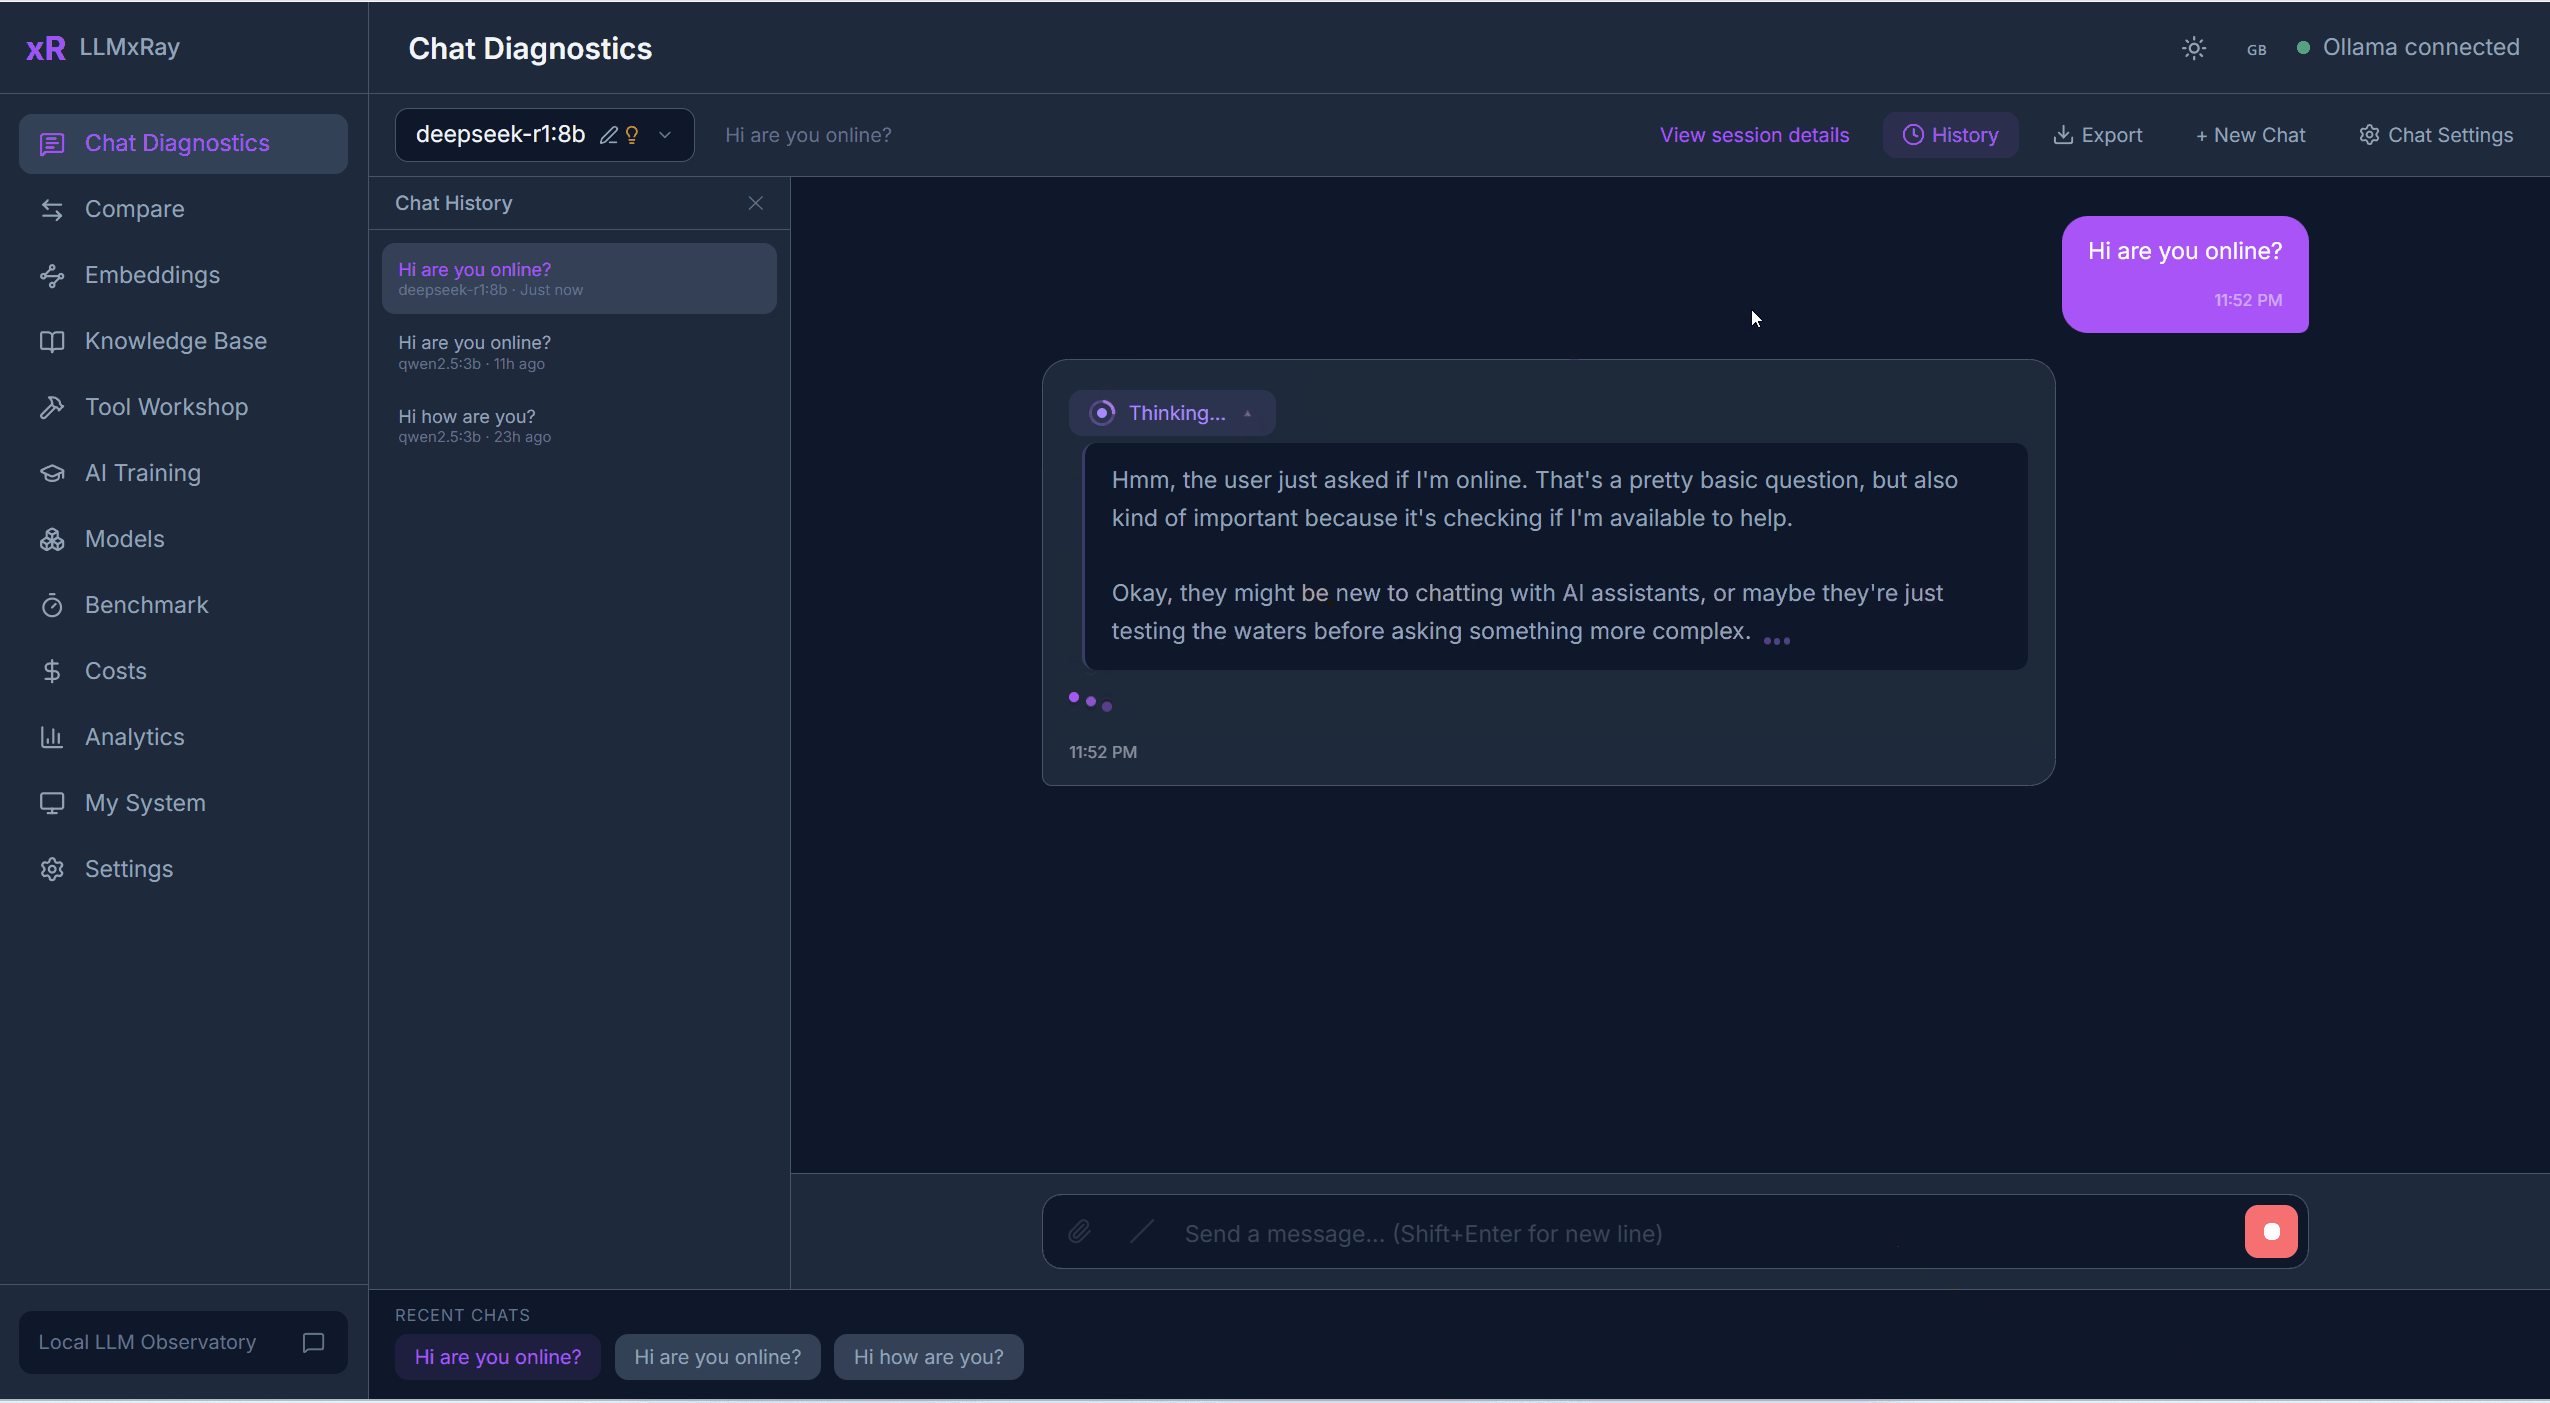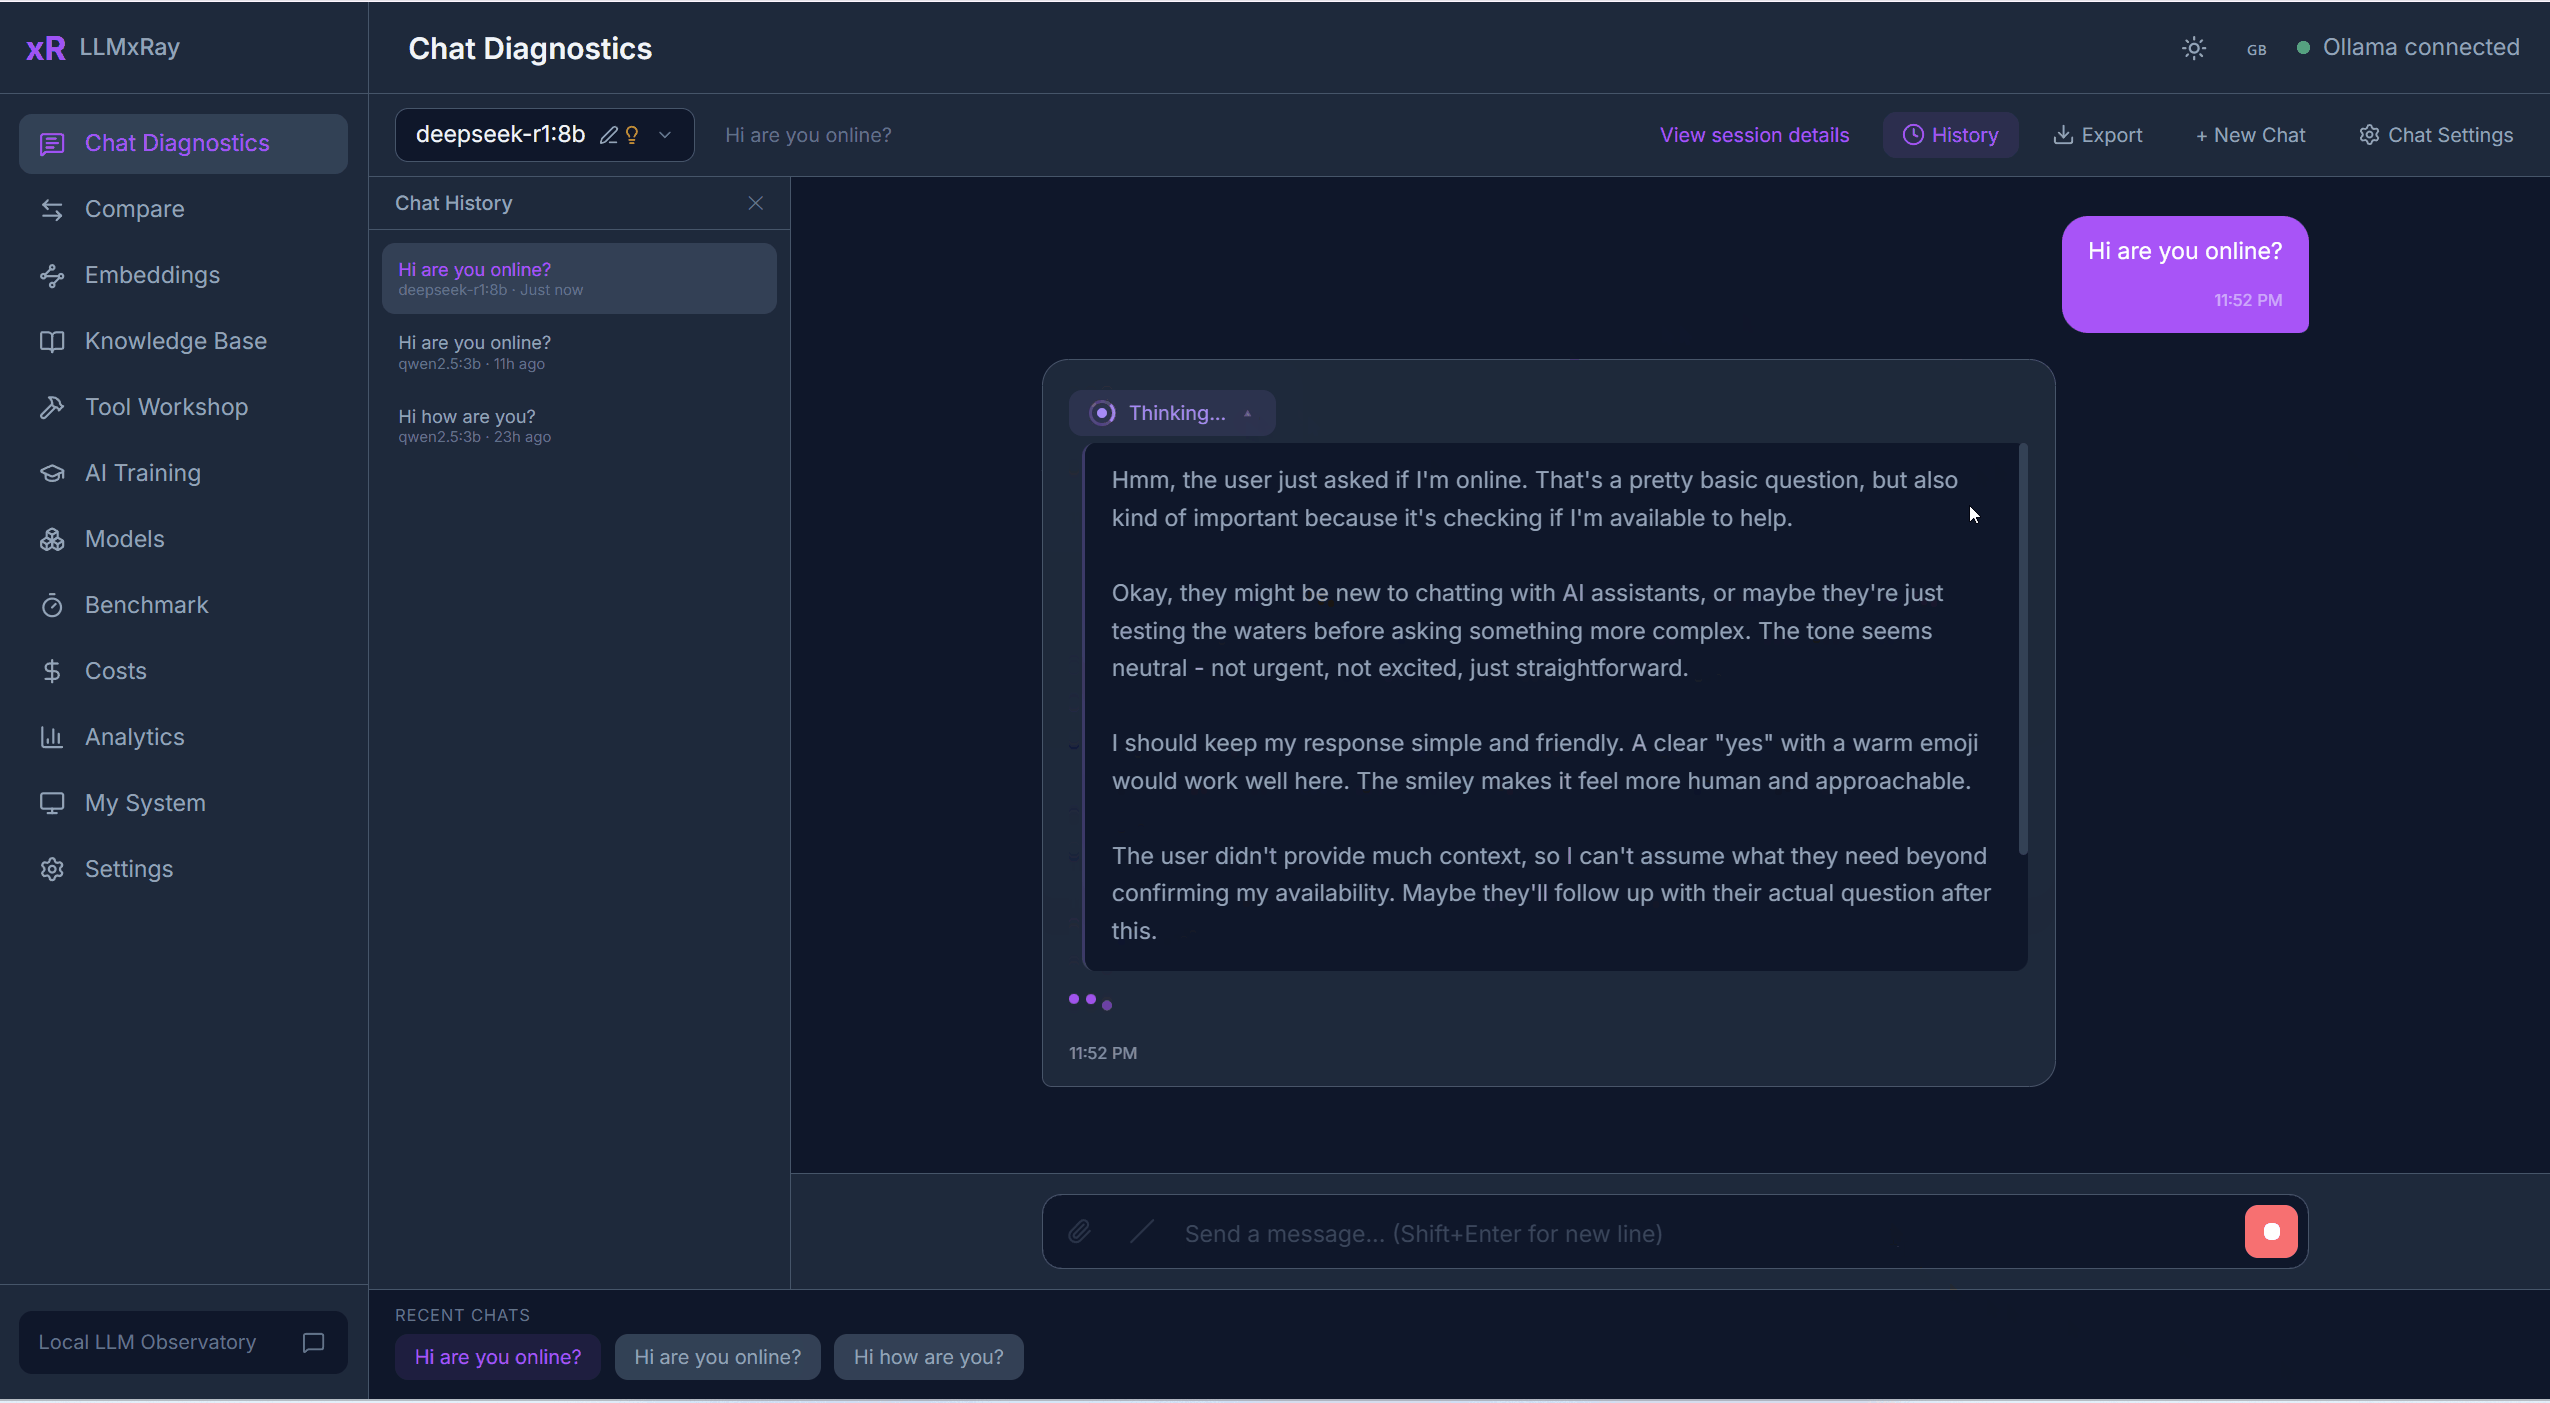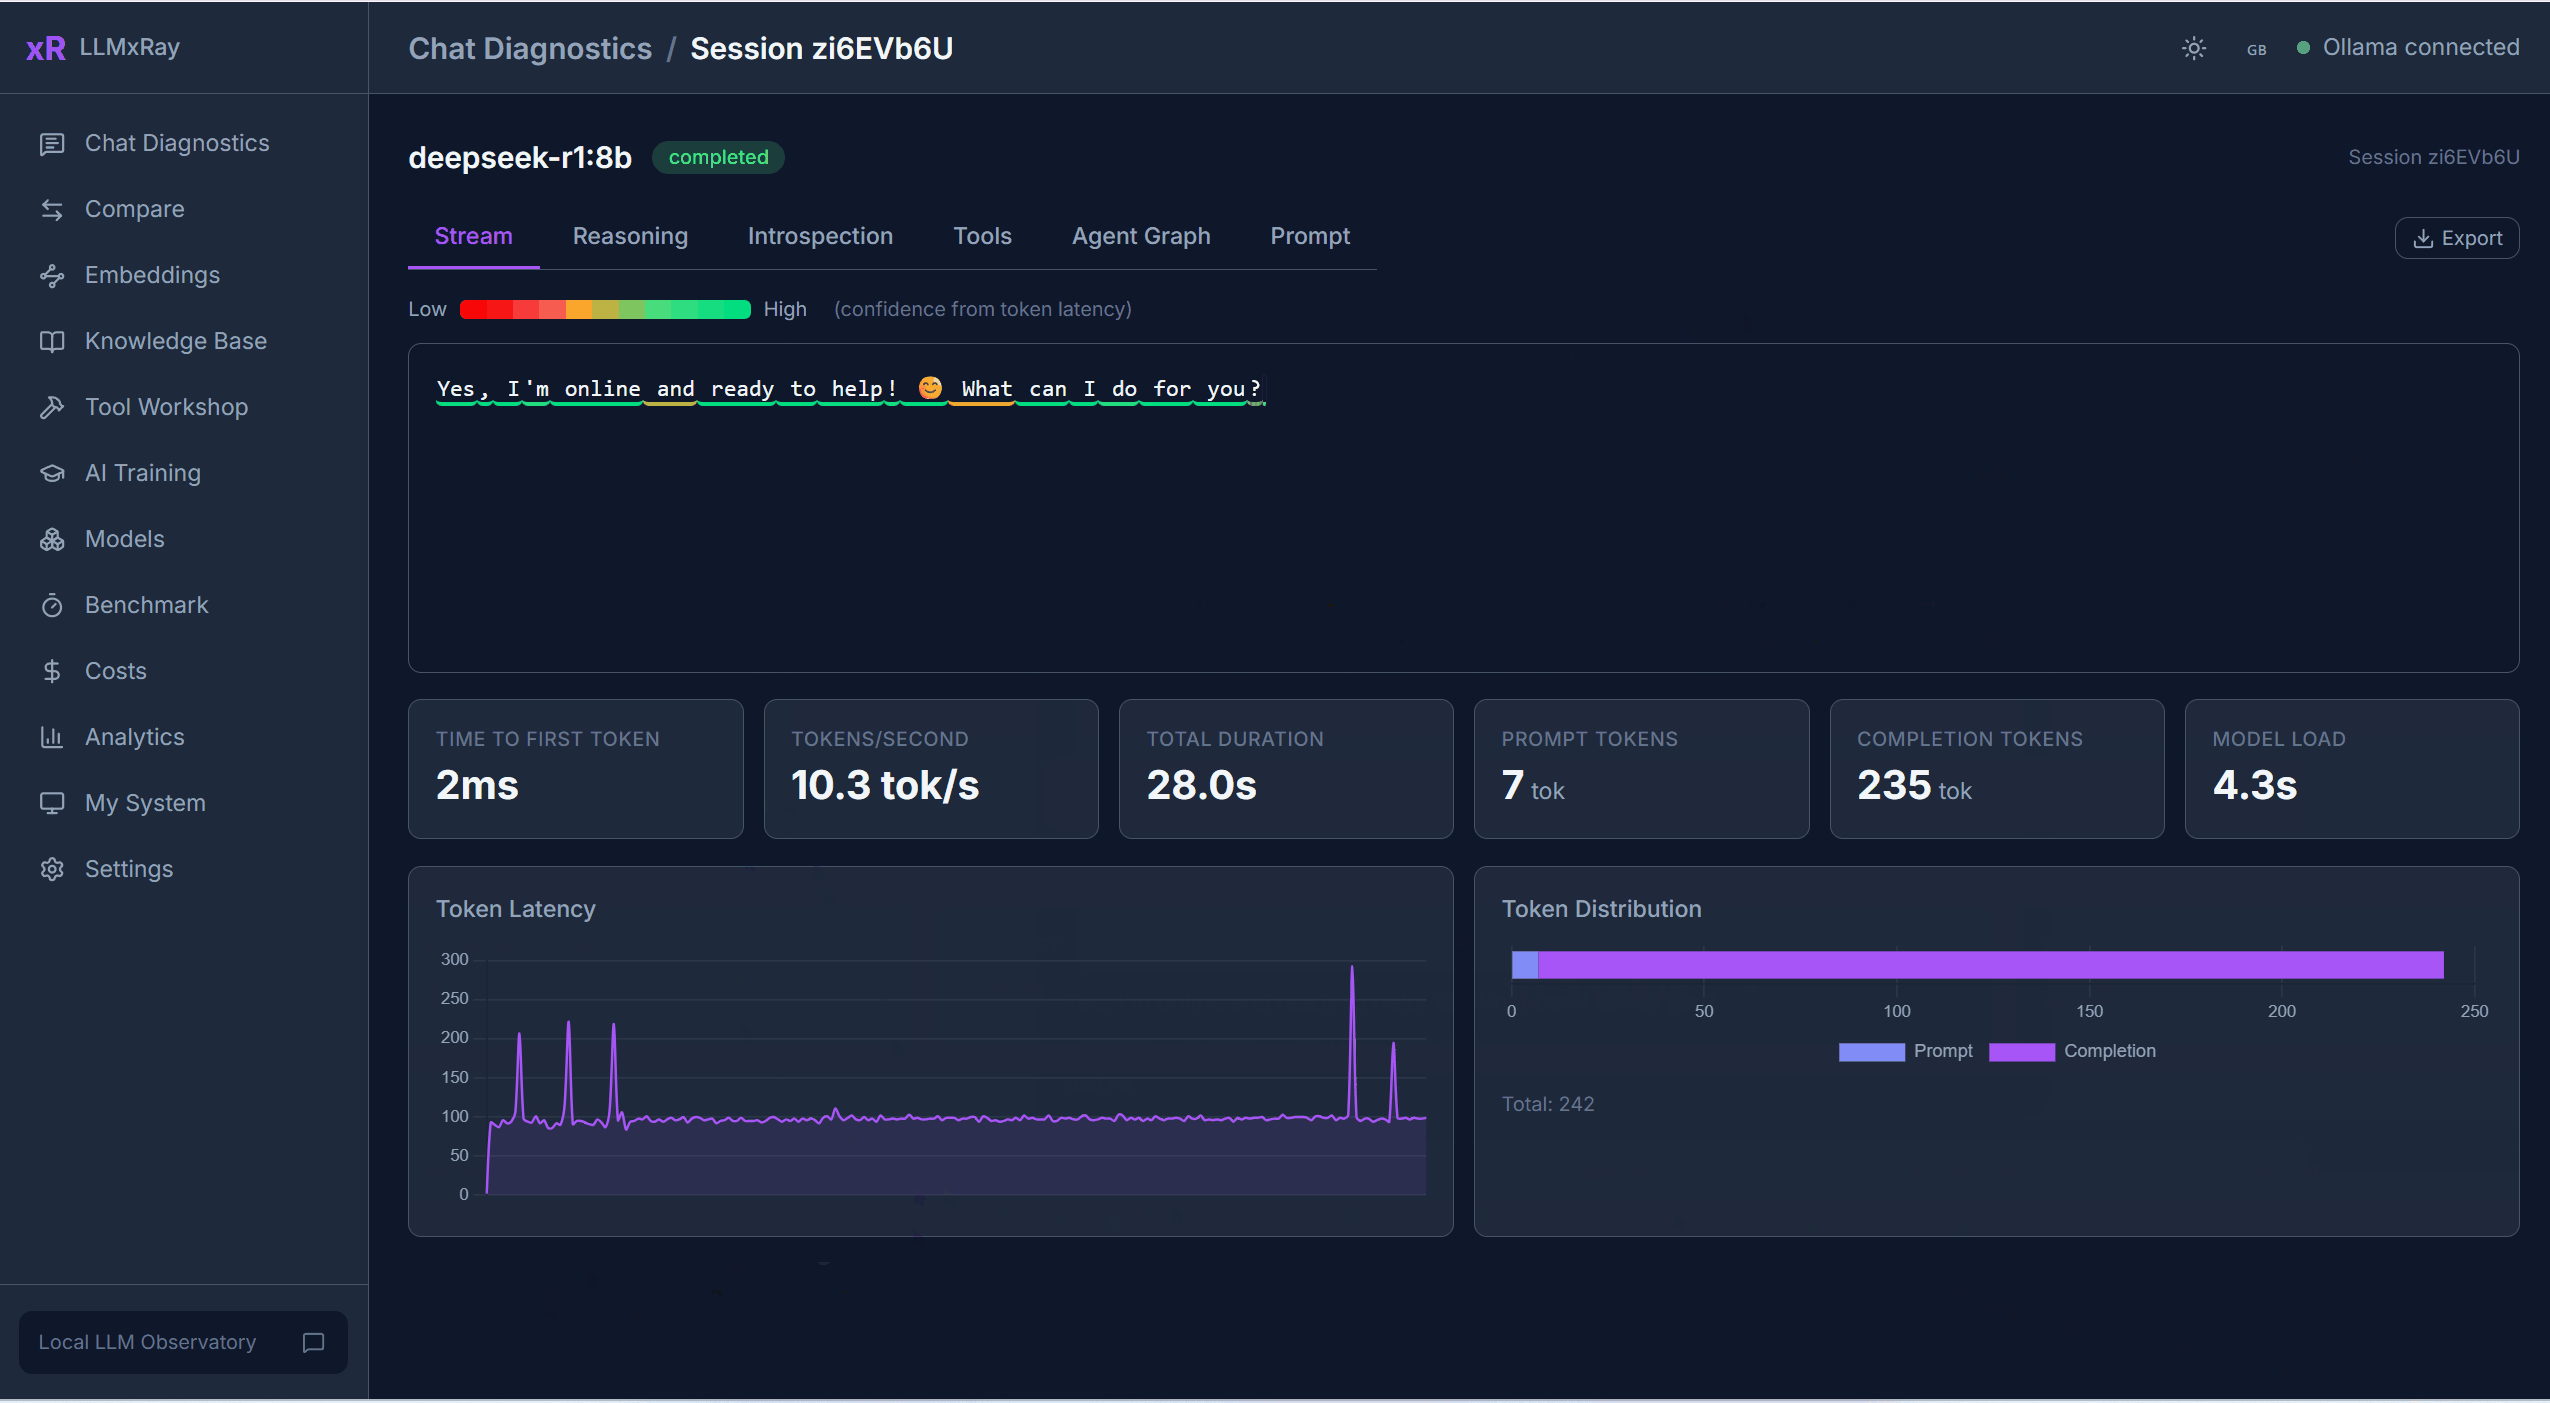
深入查看会话
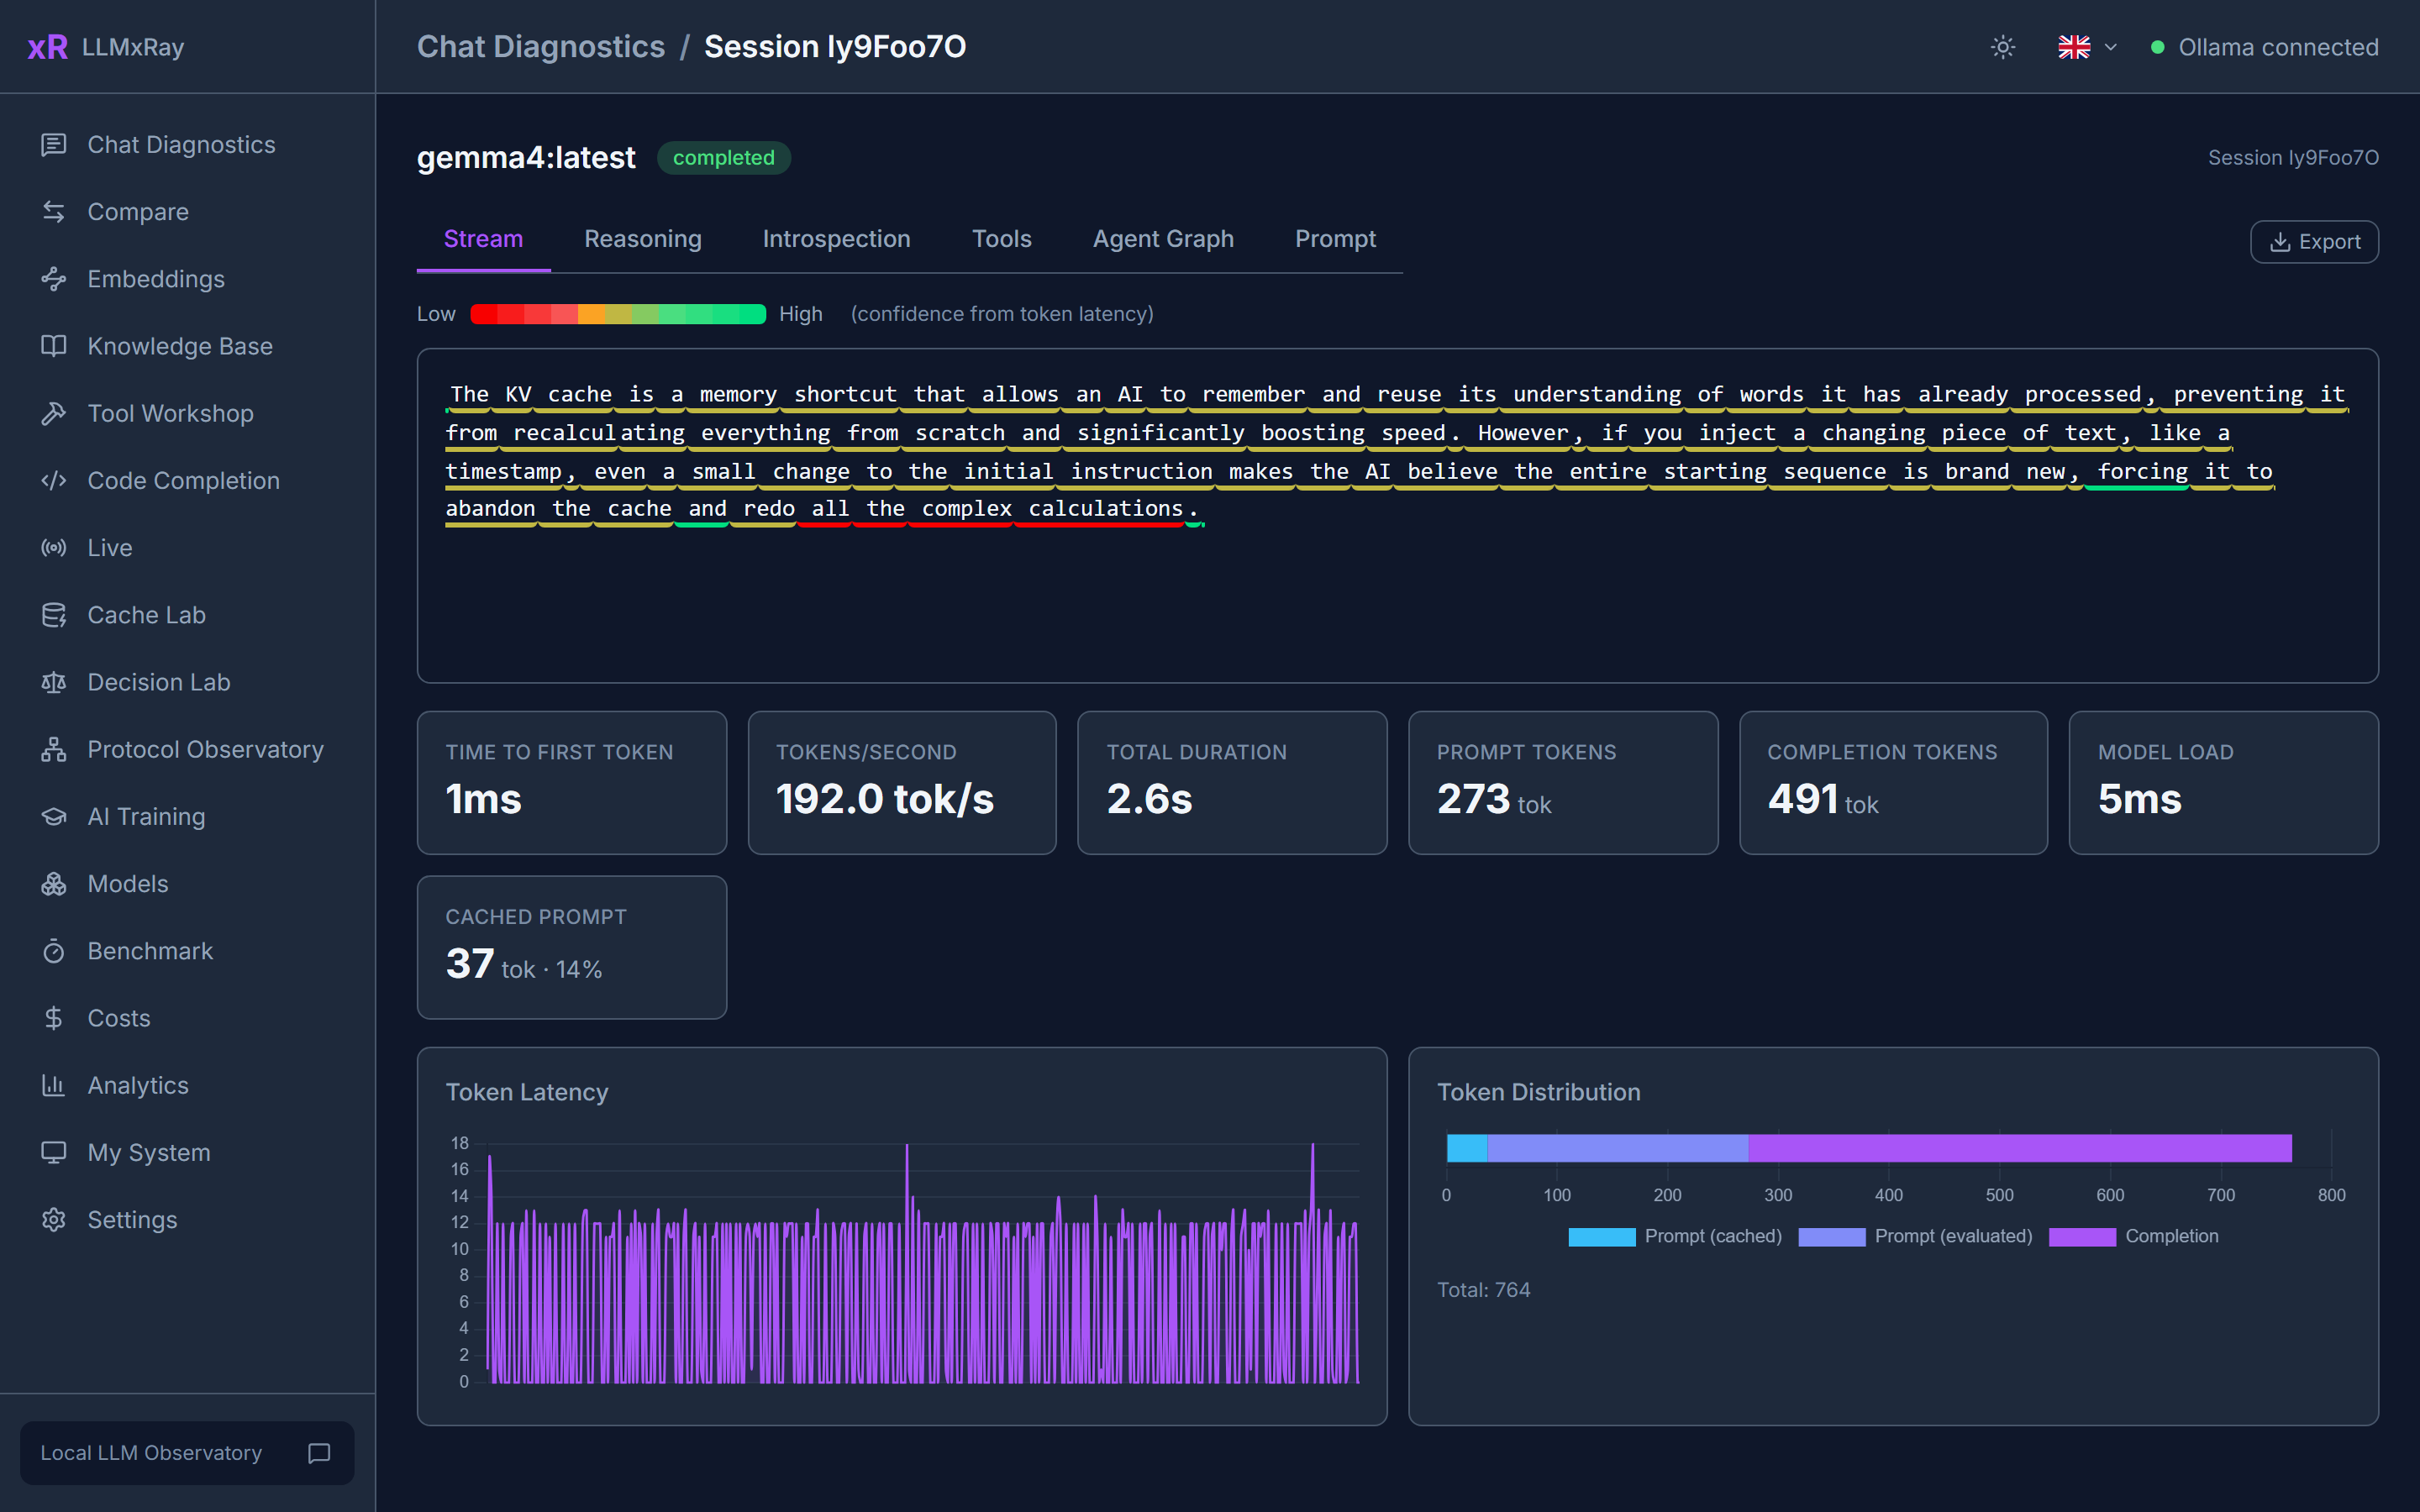
打开任意轮对话,即可按时间线查看详情:首个 Token 的生成时间、Token 之间的间隔、推理块(如有)、工具调用,以及实际发送的提示词。
截图
比较
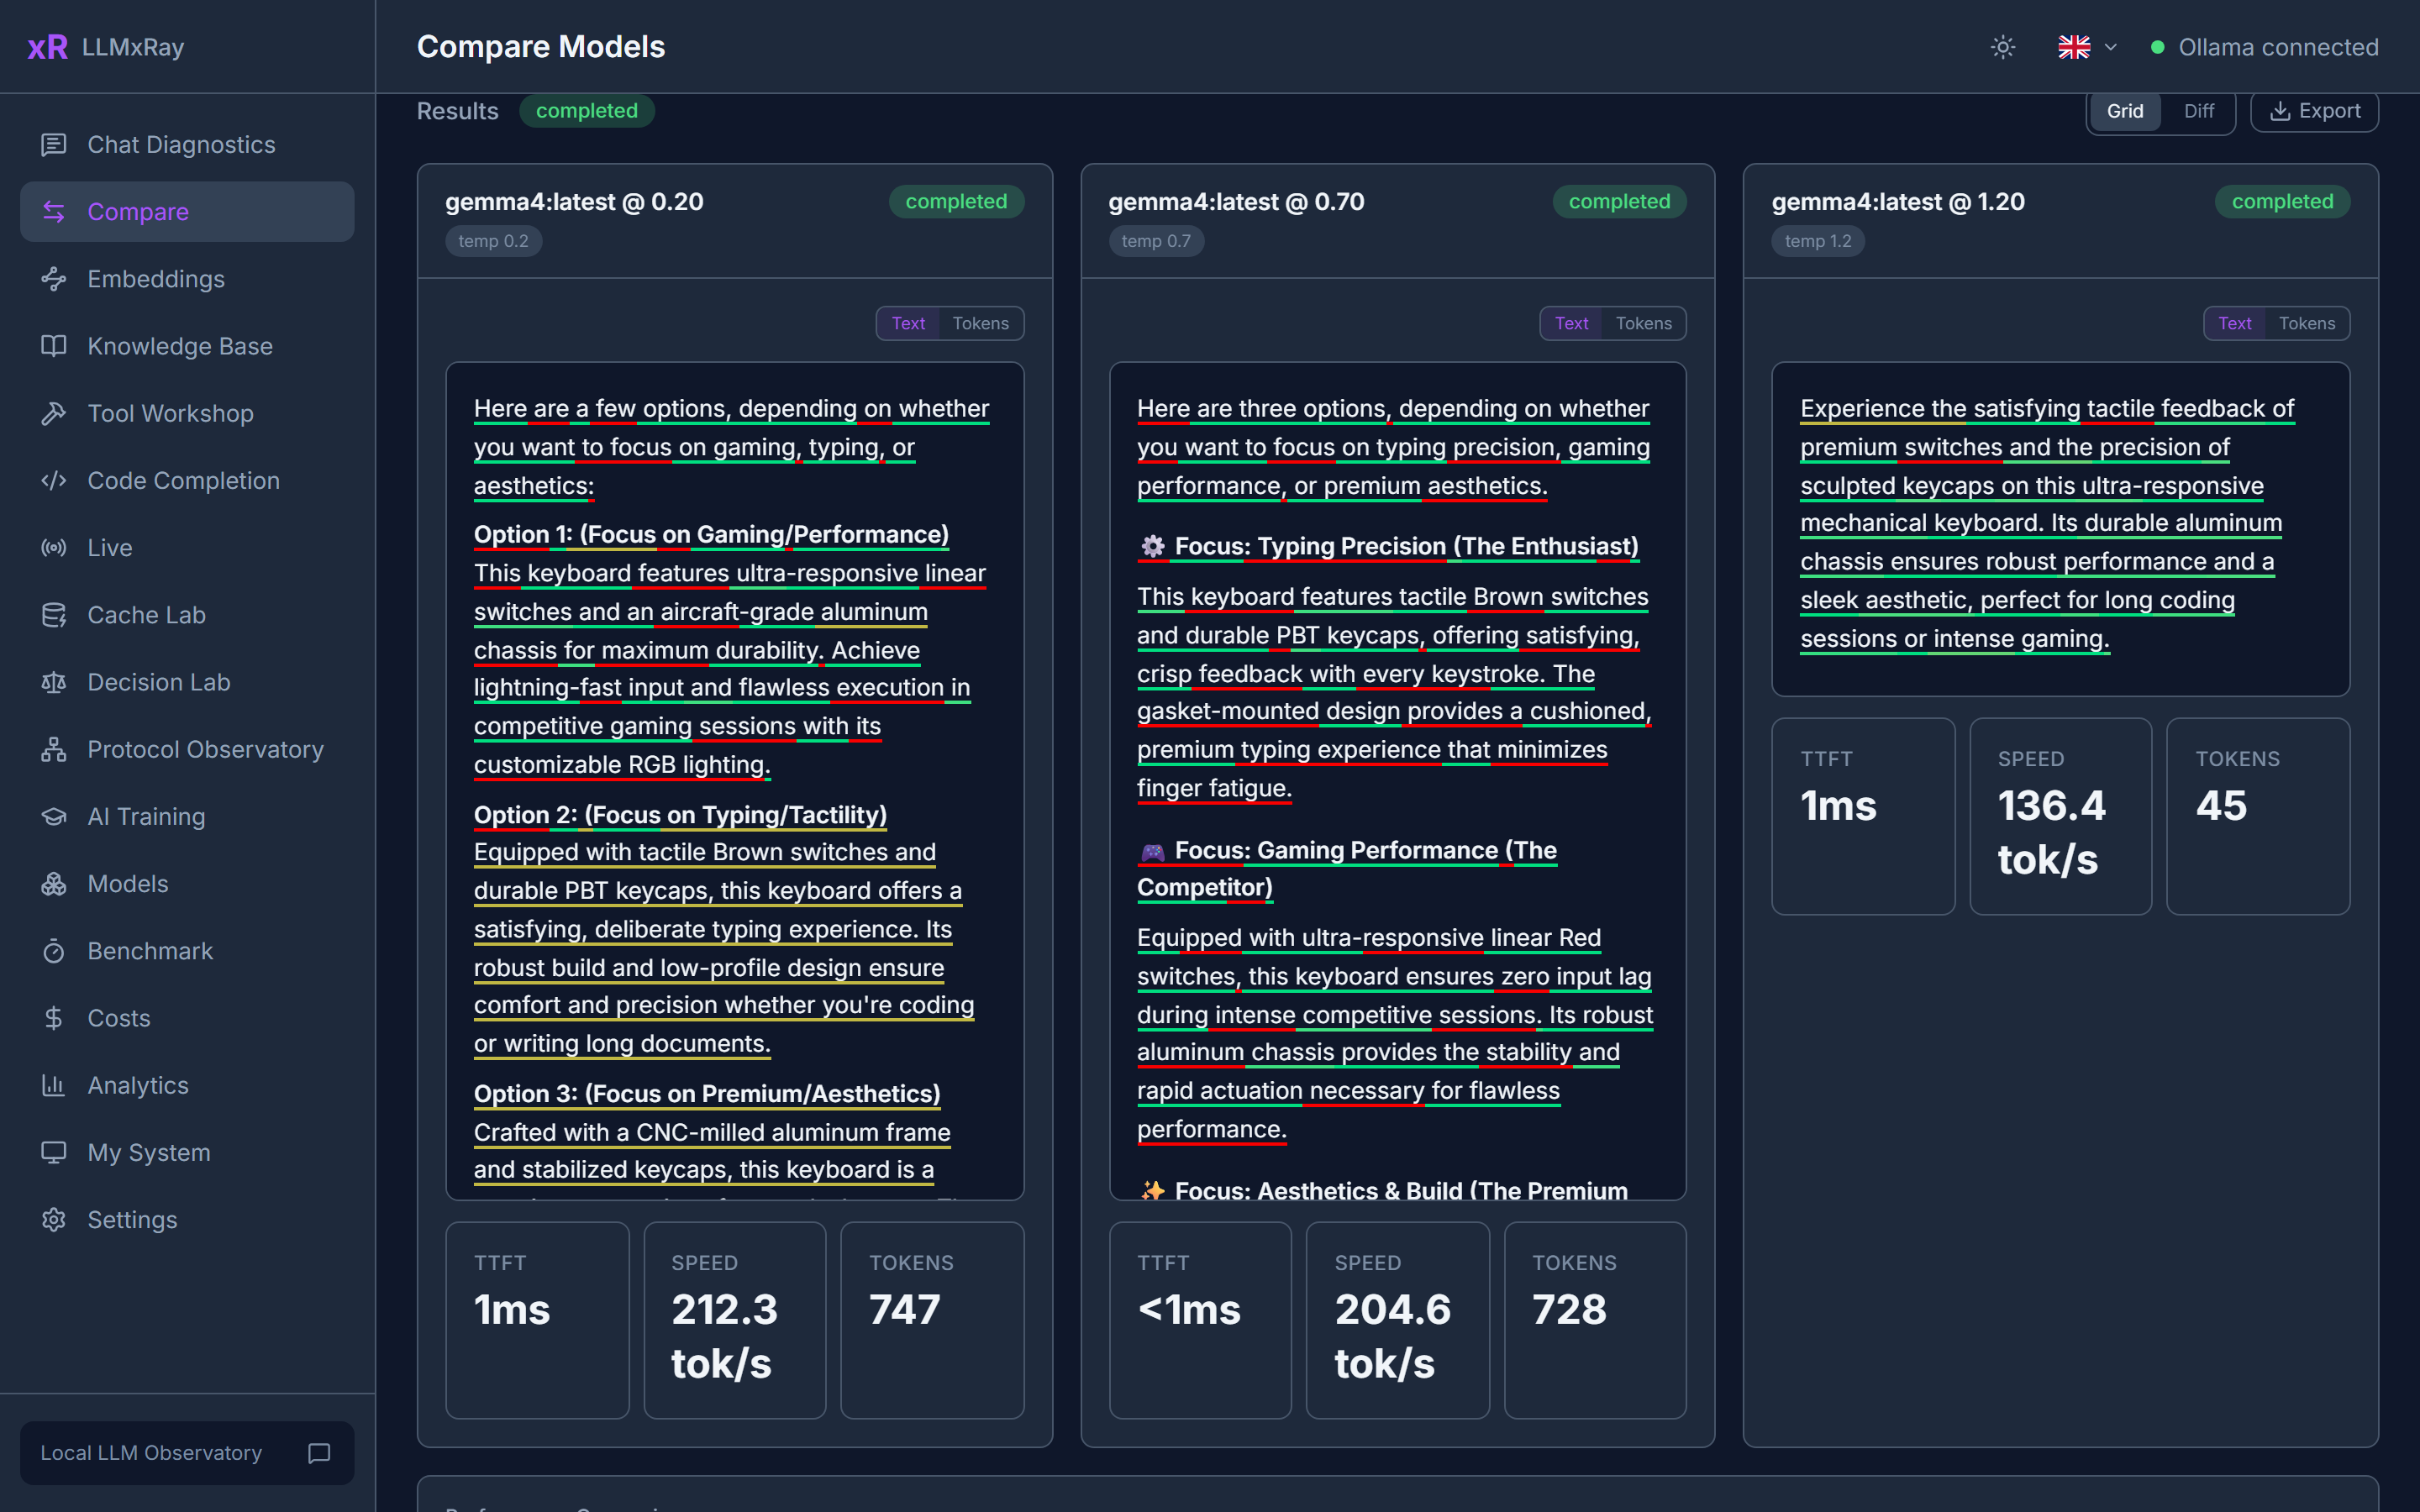
使用同一提示词比较最多 4 个槽位,每个槽位都可设置自己的模型、温度和系统提示词,并排流式生成。提供一键预设:温度扫描、确定性配对、语言比较。词级差异对比会精确显示两个答案之间的改动。
截图
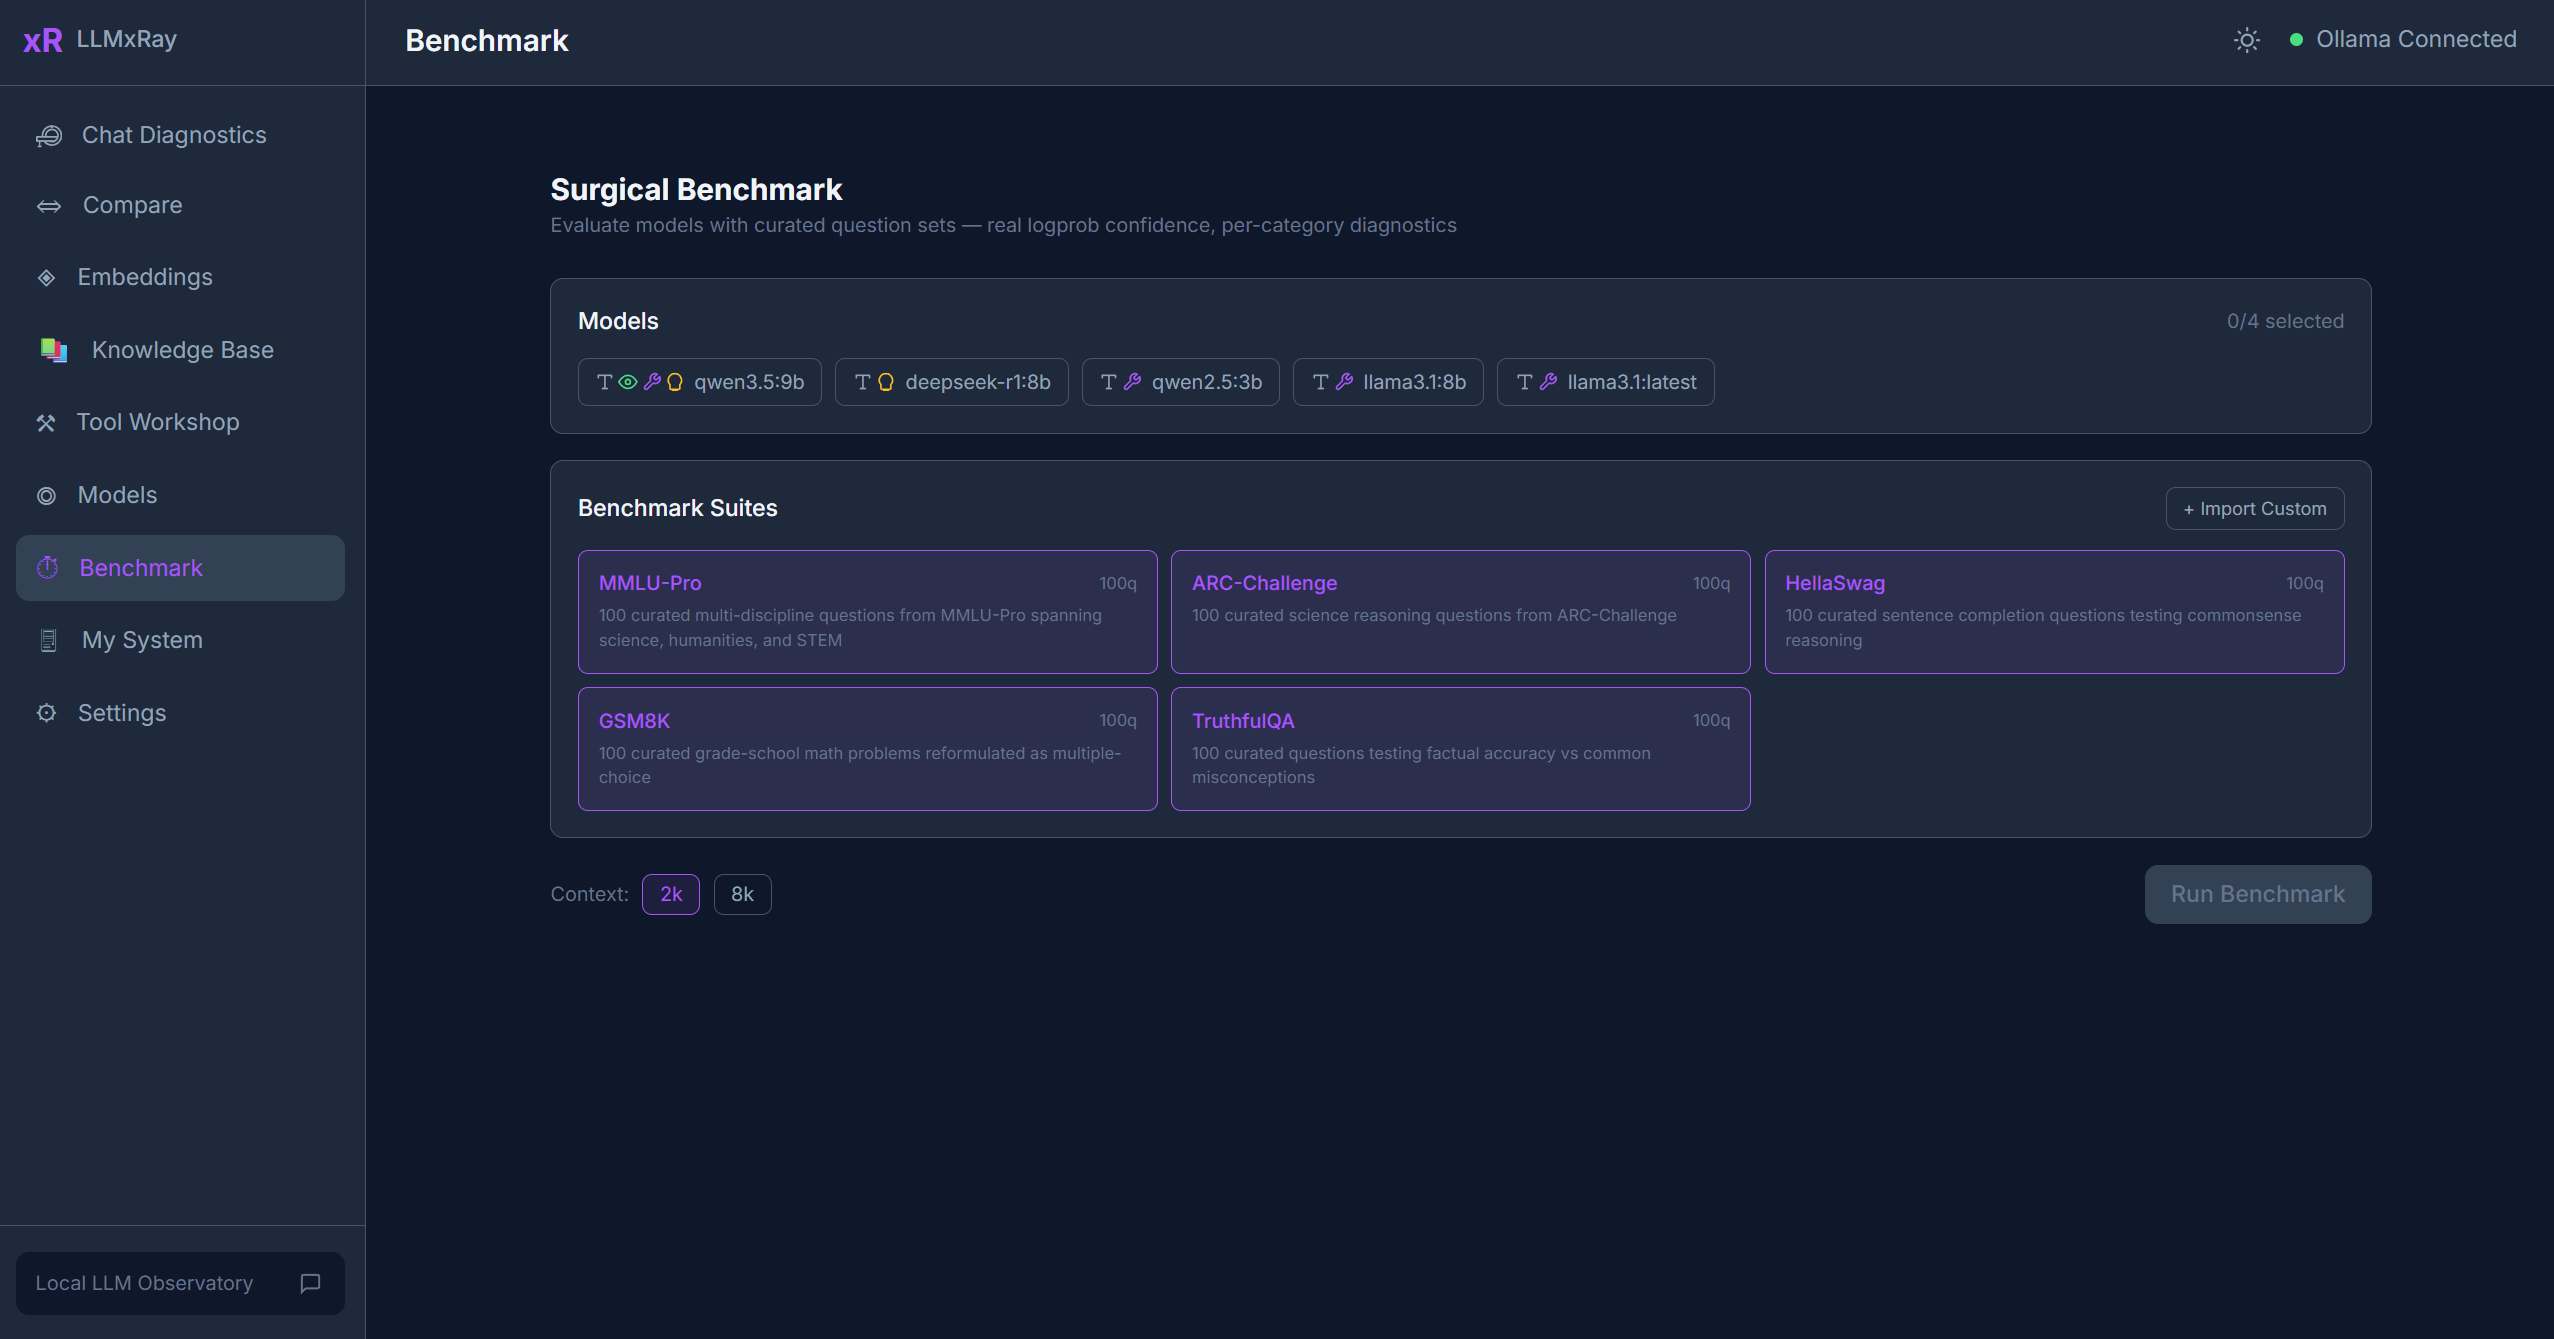
精准基准测试
使用精选的问题集(MMLU-Pro、ARC-Challenge、HellaSwag、GSM8K、TruthfulQA)对模型评分,依据的是模型的实际 Token logprobs,而不是答案看起来是否正确。按类别展示置信度与准确率,让你看到模型在哪些方面会自信地答错。还可将自己的问题集作为 JSON 导入。
截图
决策实验室
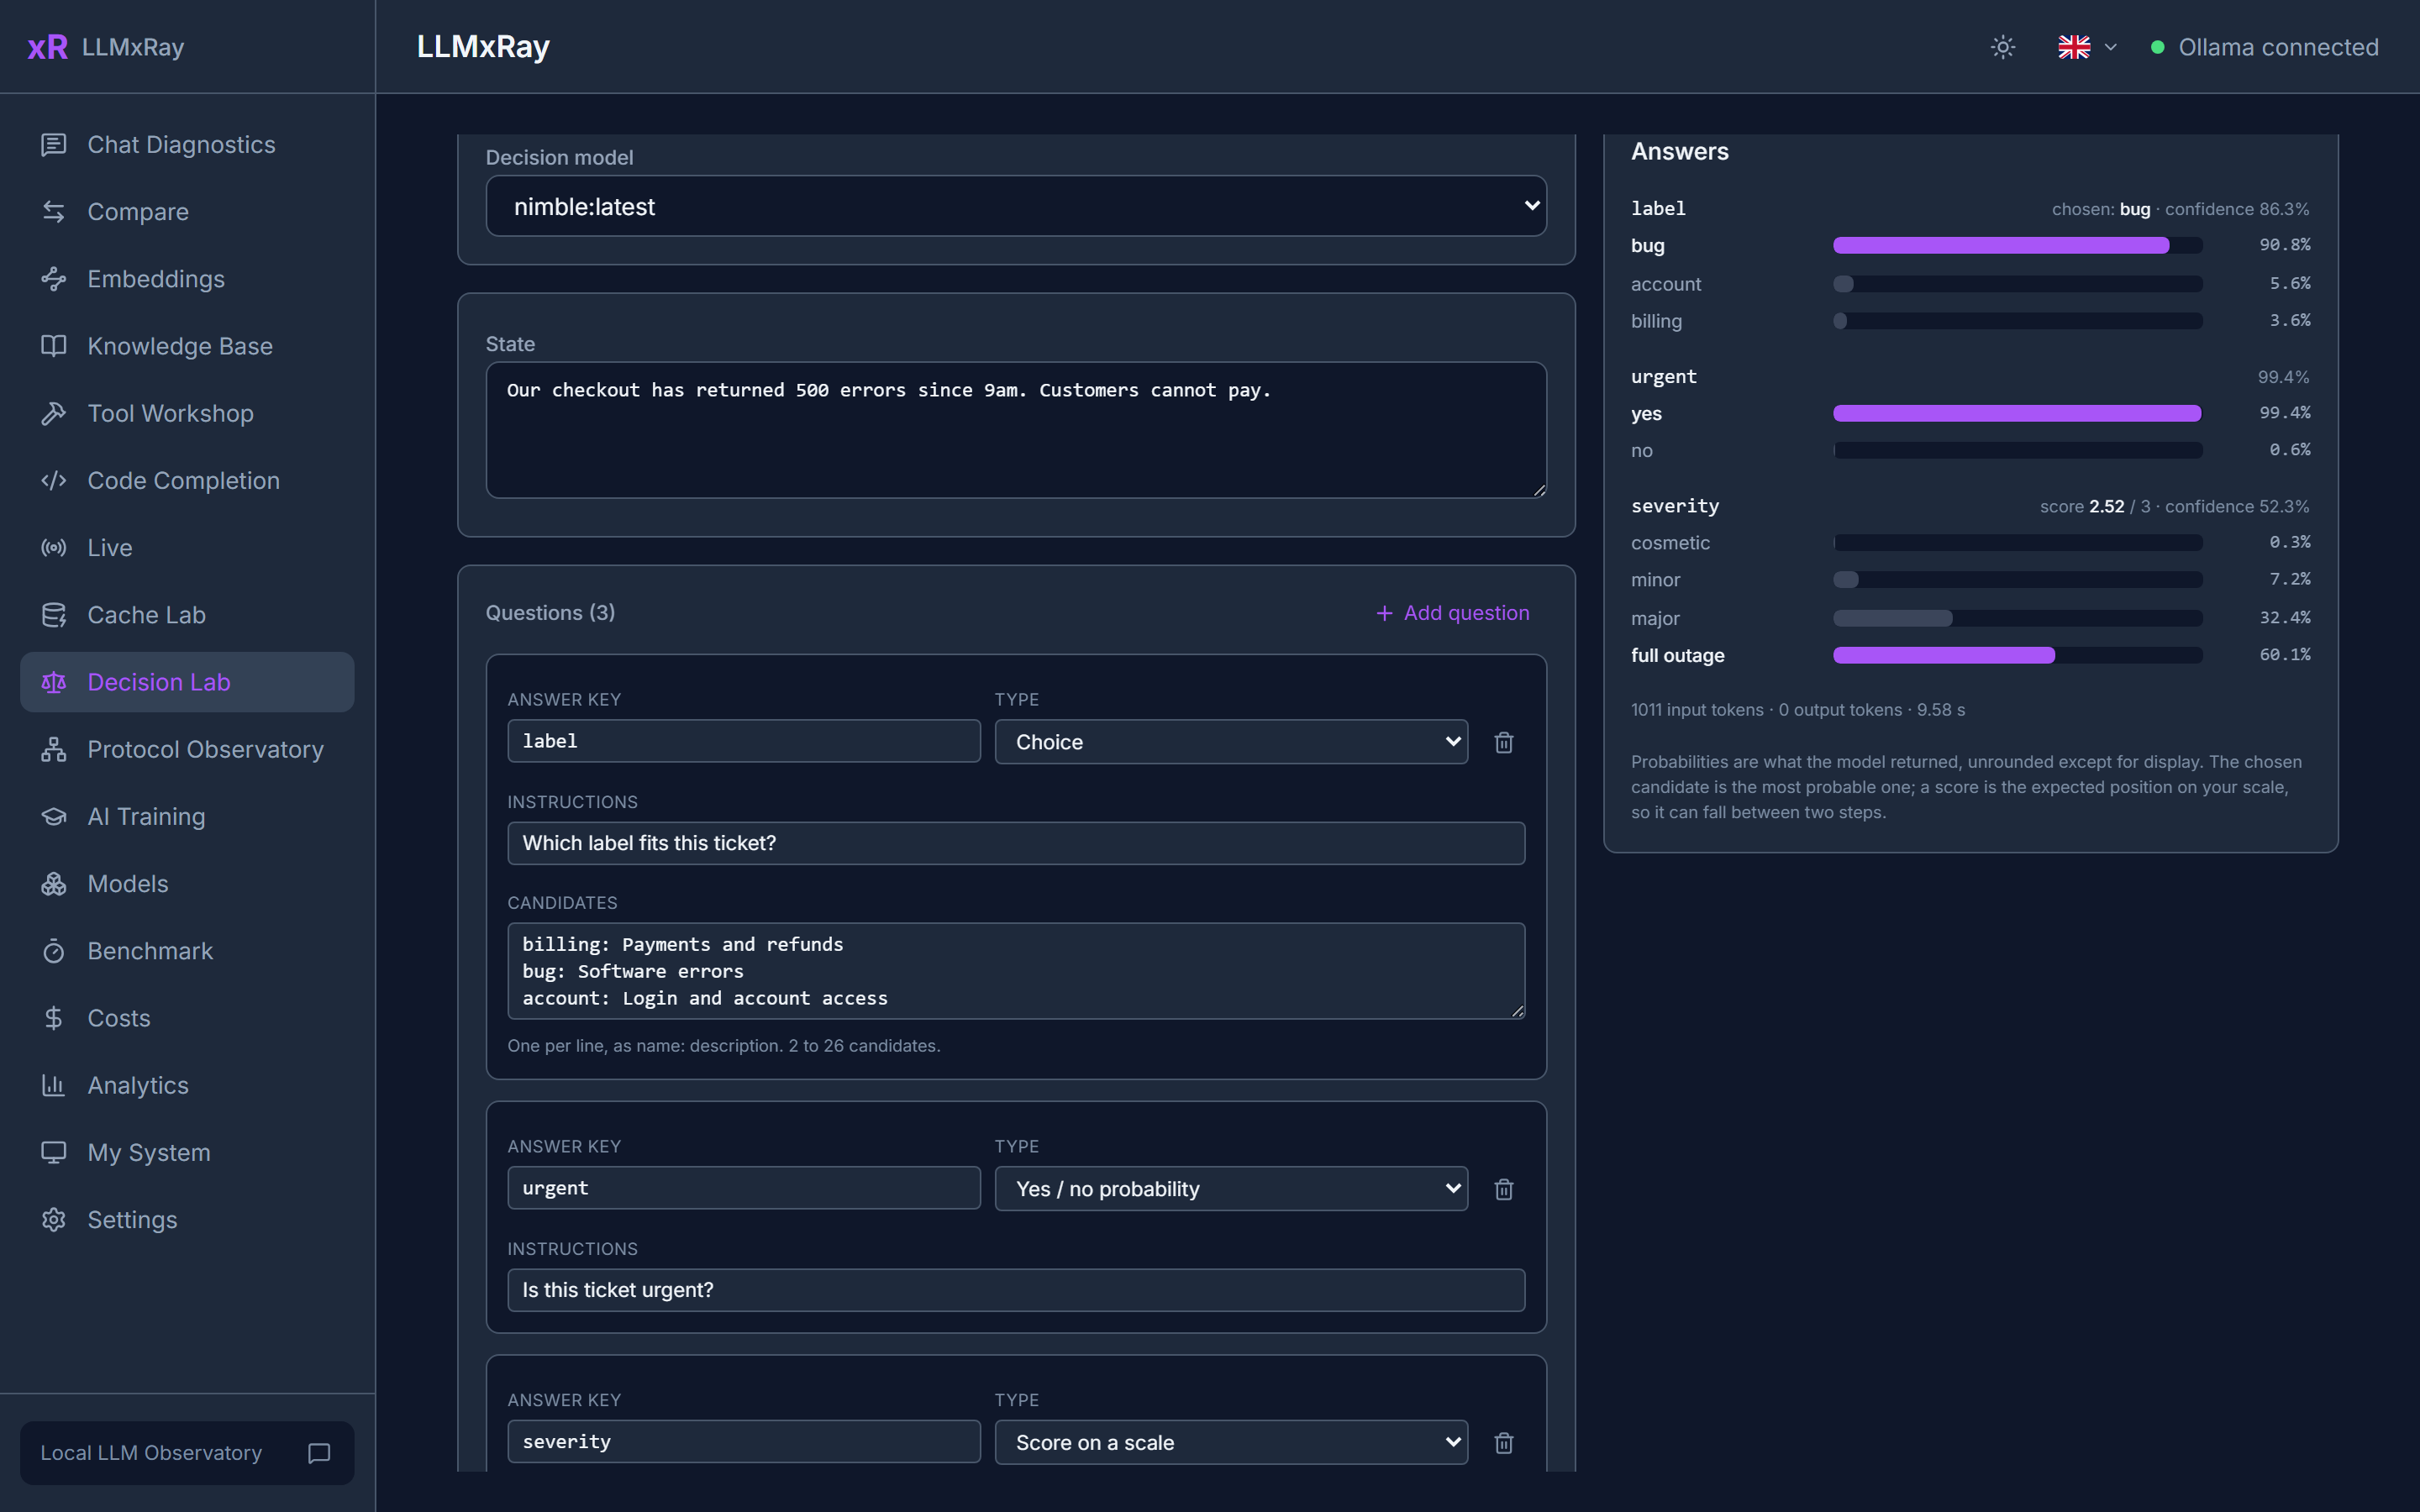
决策模型(nimble、tev1、clef)会以概率而非散文形式回答类型化问题。向实验室描述一种情况,并要求它从候选项中做出选择、给出是/否概率,或按量表评分。每个答案都会以模型自身的概率分布呈现,并绘制为条形图。
截图
知识库和嵌入
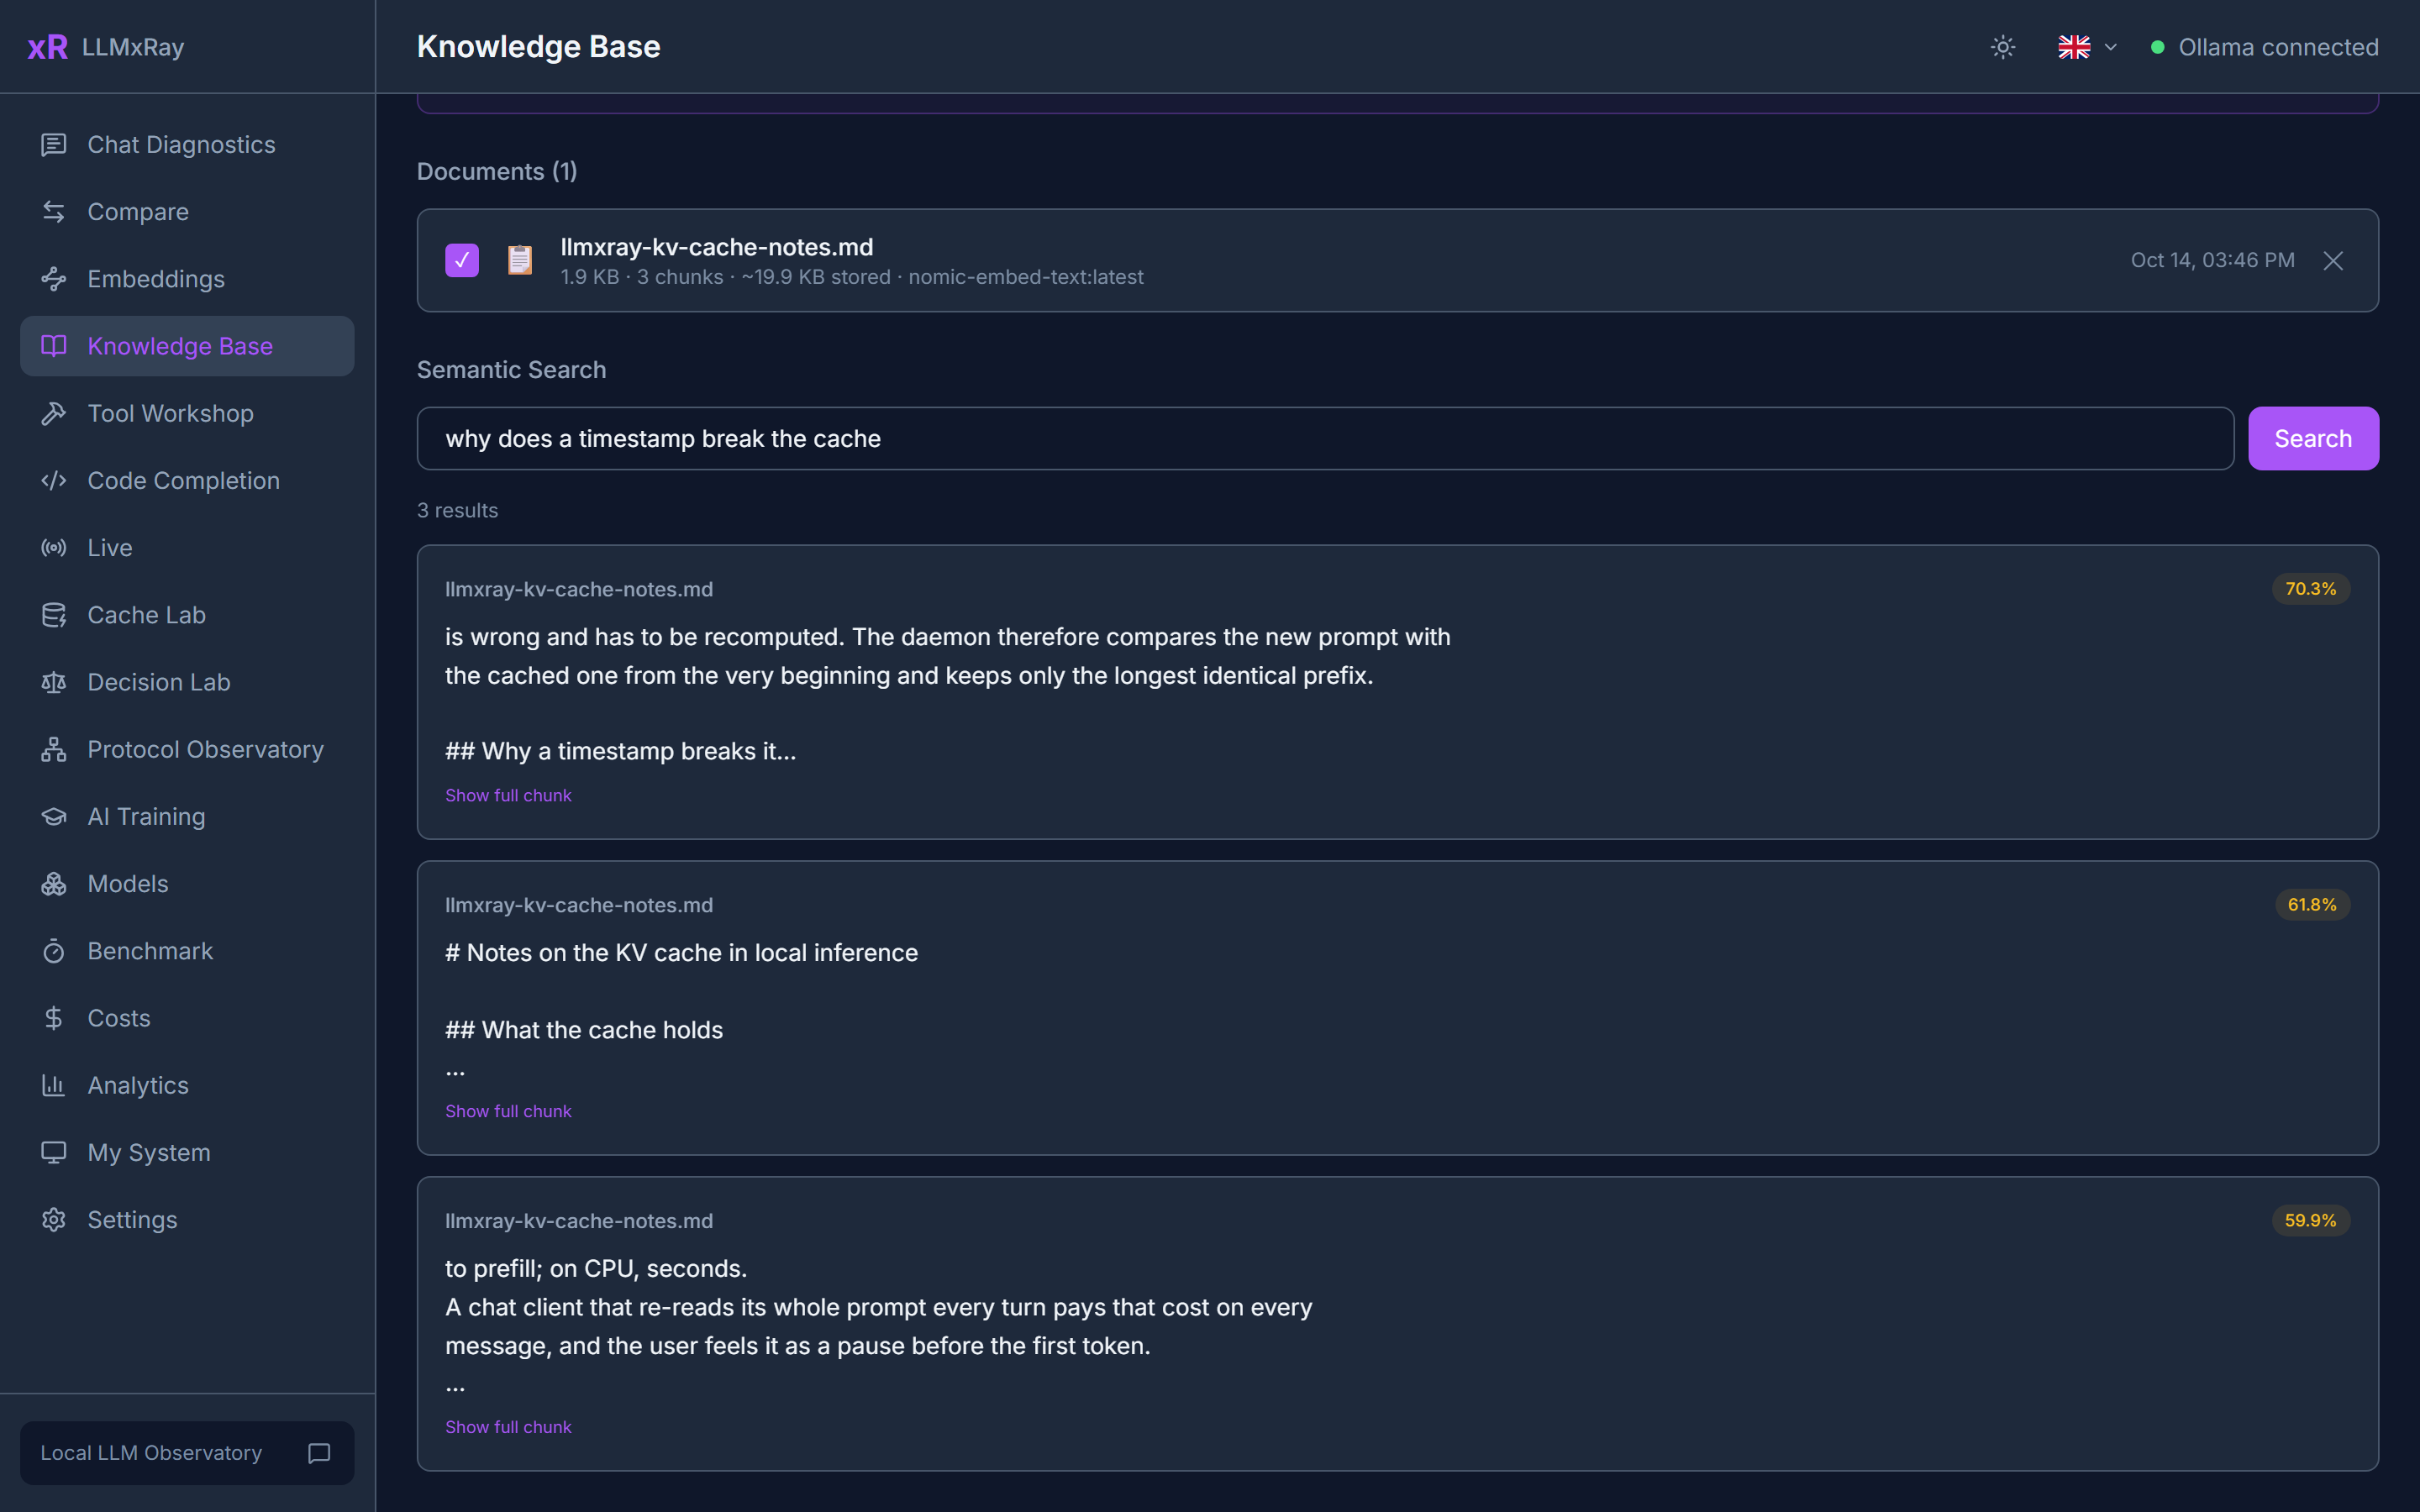
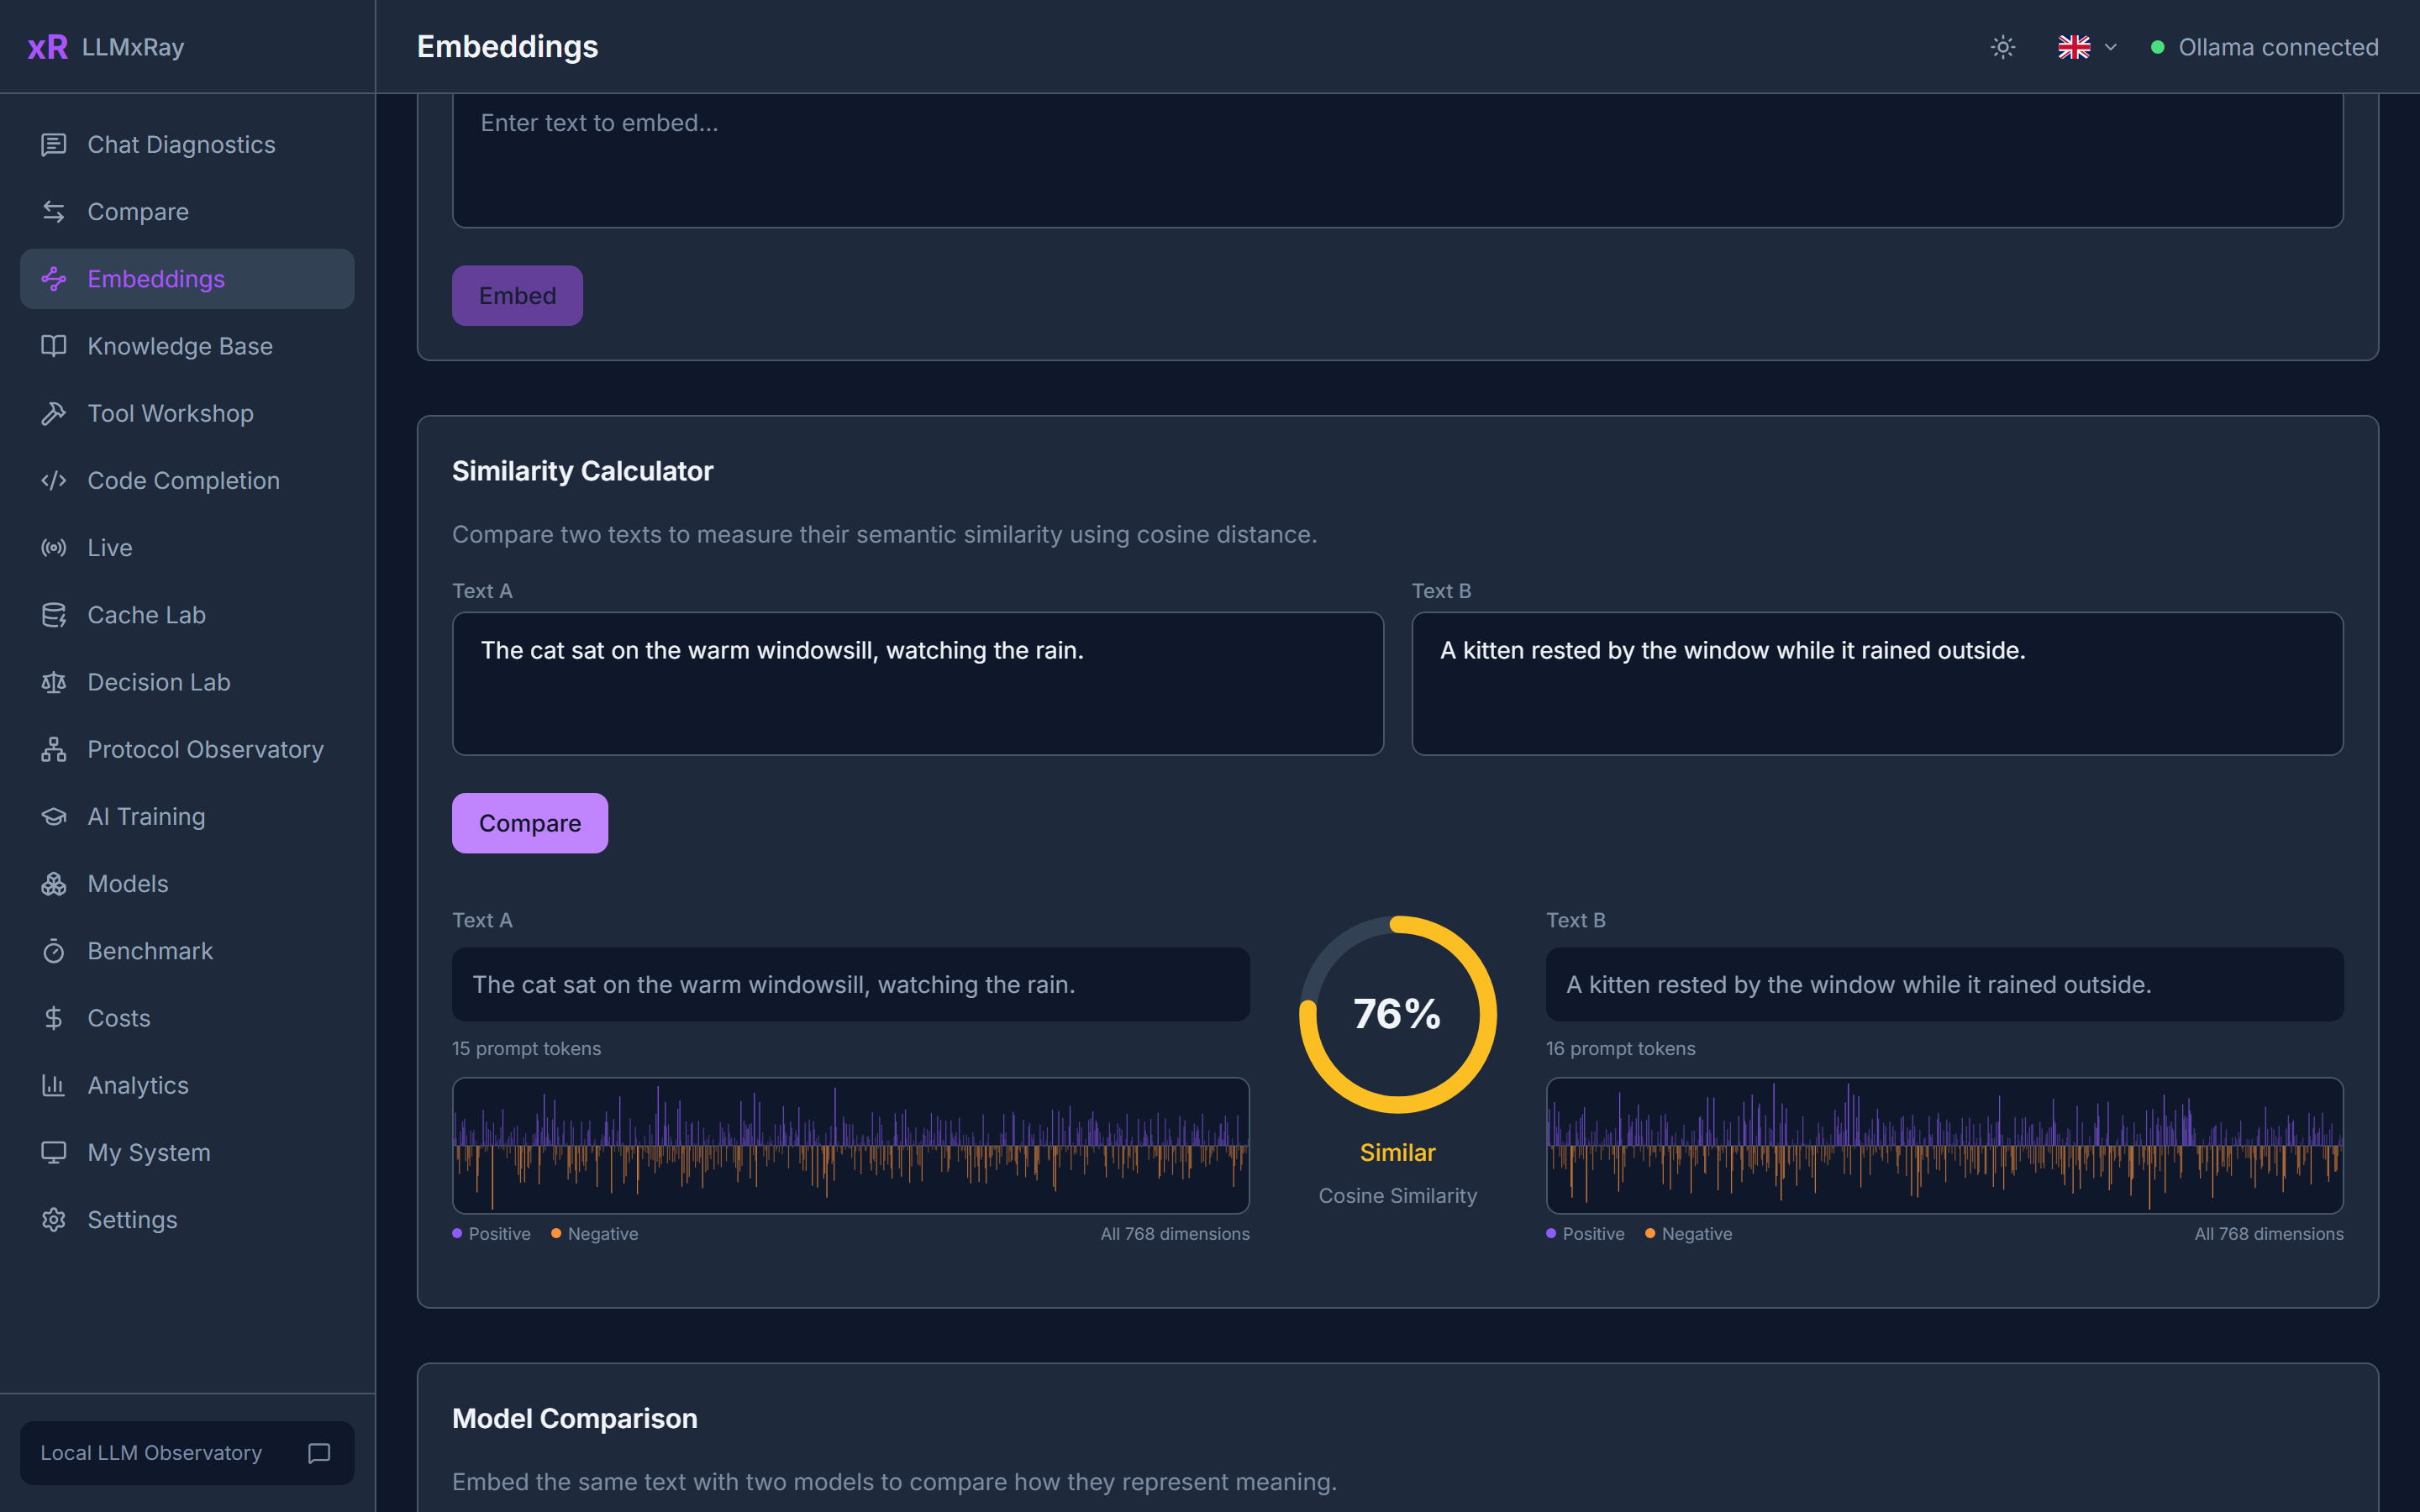
添加 PDF、DOCX、Markdown 或 CSV 文件。文件会被切分、嵌入并建立索引,方便你在模型看到内容之前查看检索实际返回的结果。嵌入页面可让你通过余弦相似度比较任意两段文本、可视化向量,并查看 Matryoshka 截断带来的代价。
所有内容都会保存在浏览器的 IndexedDB 中。
截图
|
|
|
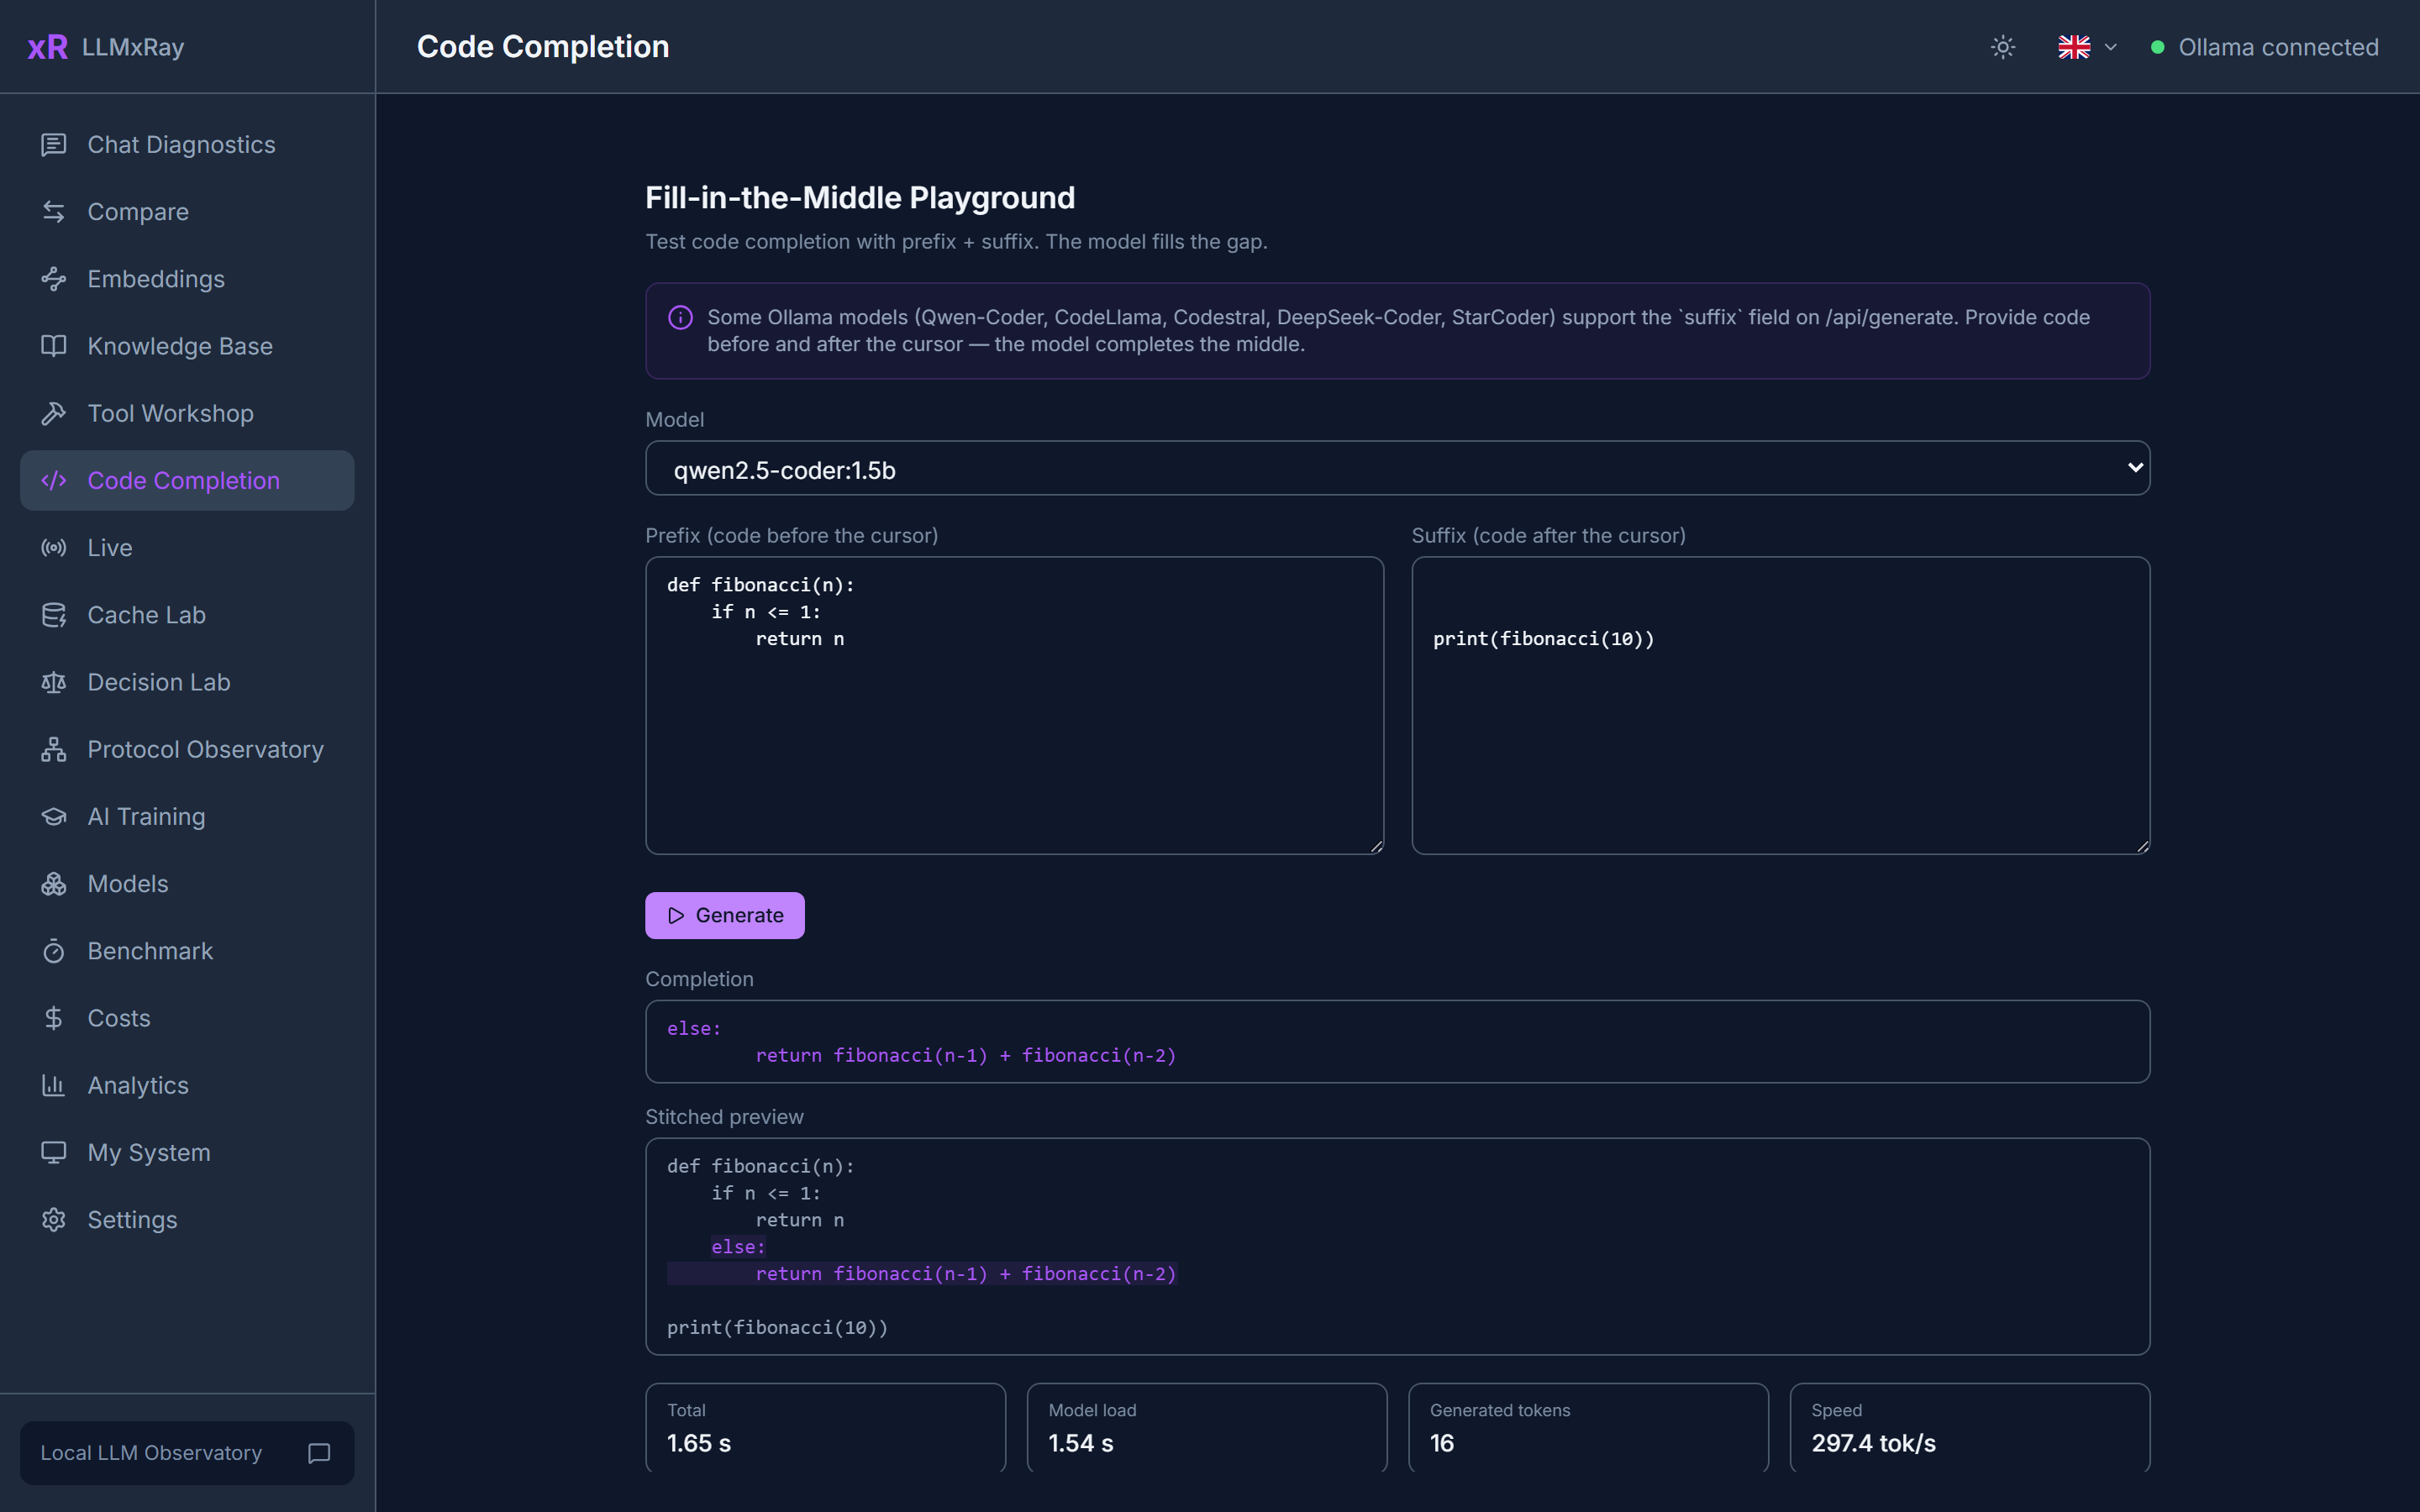
代码补全
为 Qwen-Coder、CodeLlama、Codestral、DeepSeek-Coder 和 StarCoder 提供中间填充功能:给出前缀和后缀,由模型填补空缺。拼接预览会展示结果在编辑器中的实际效果。
截图
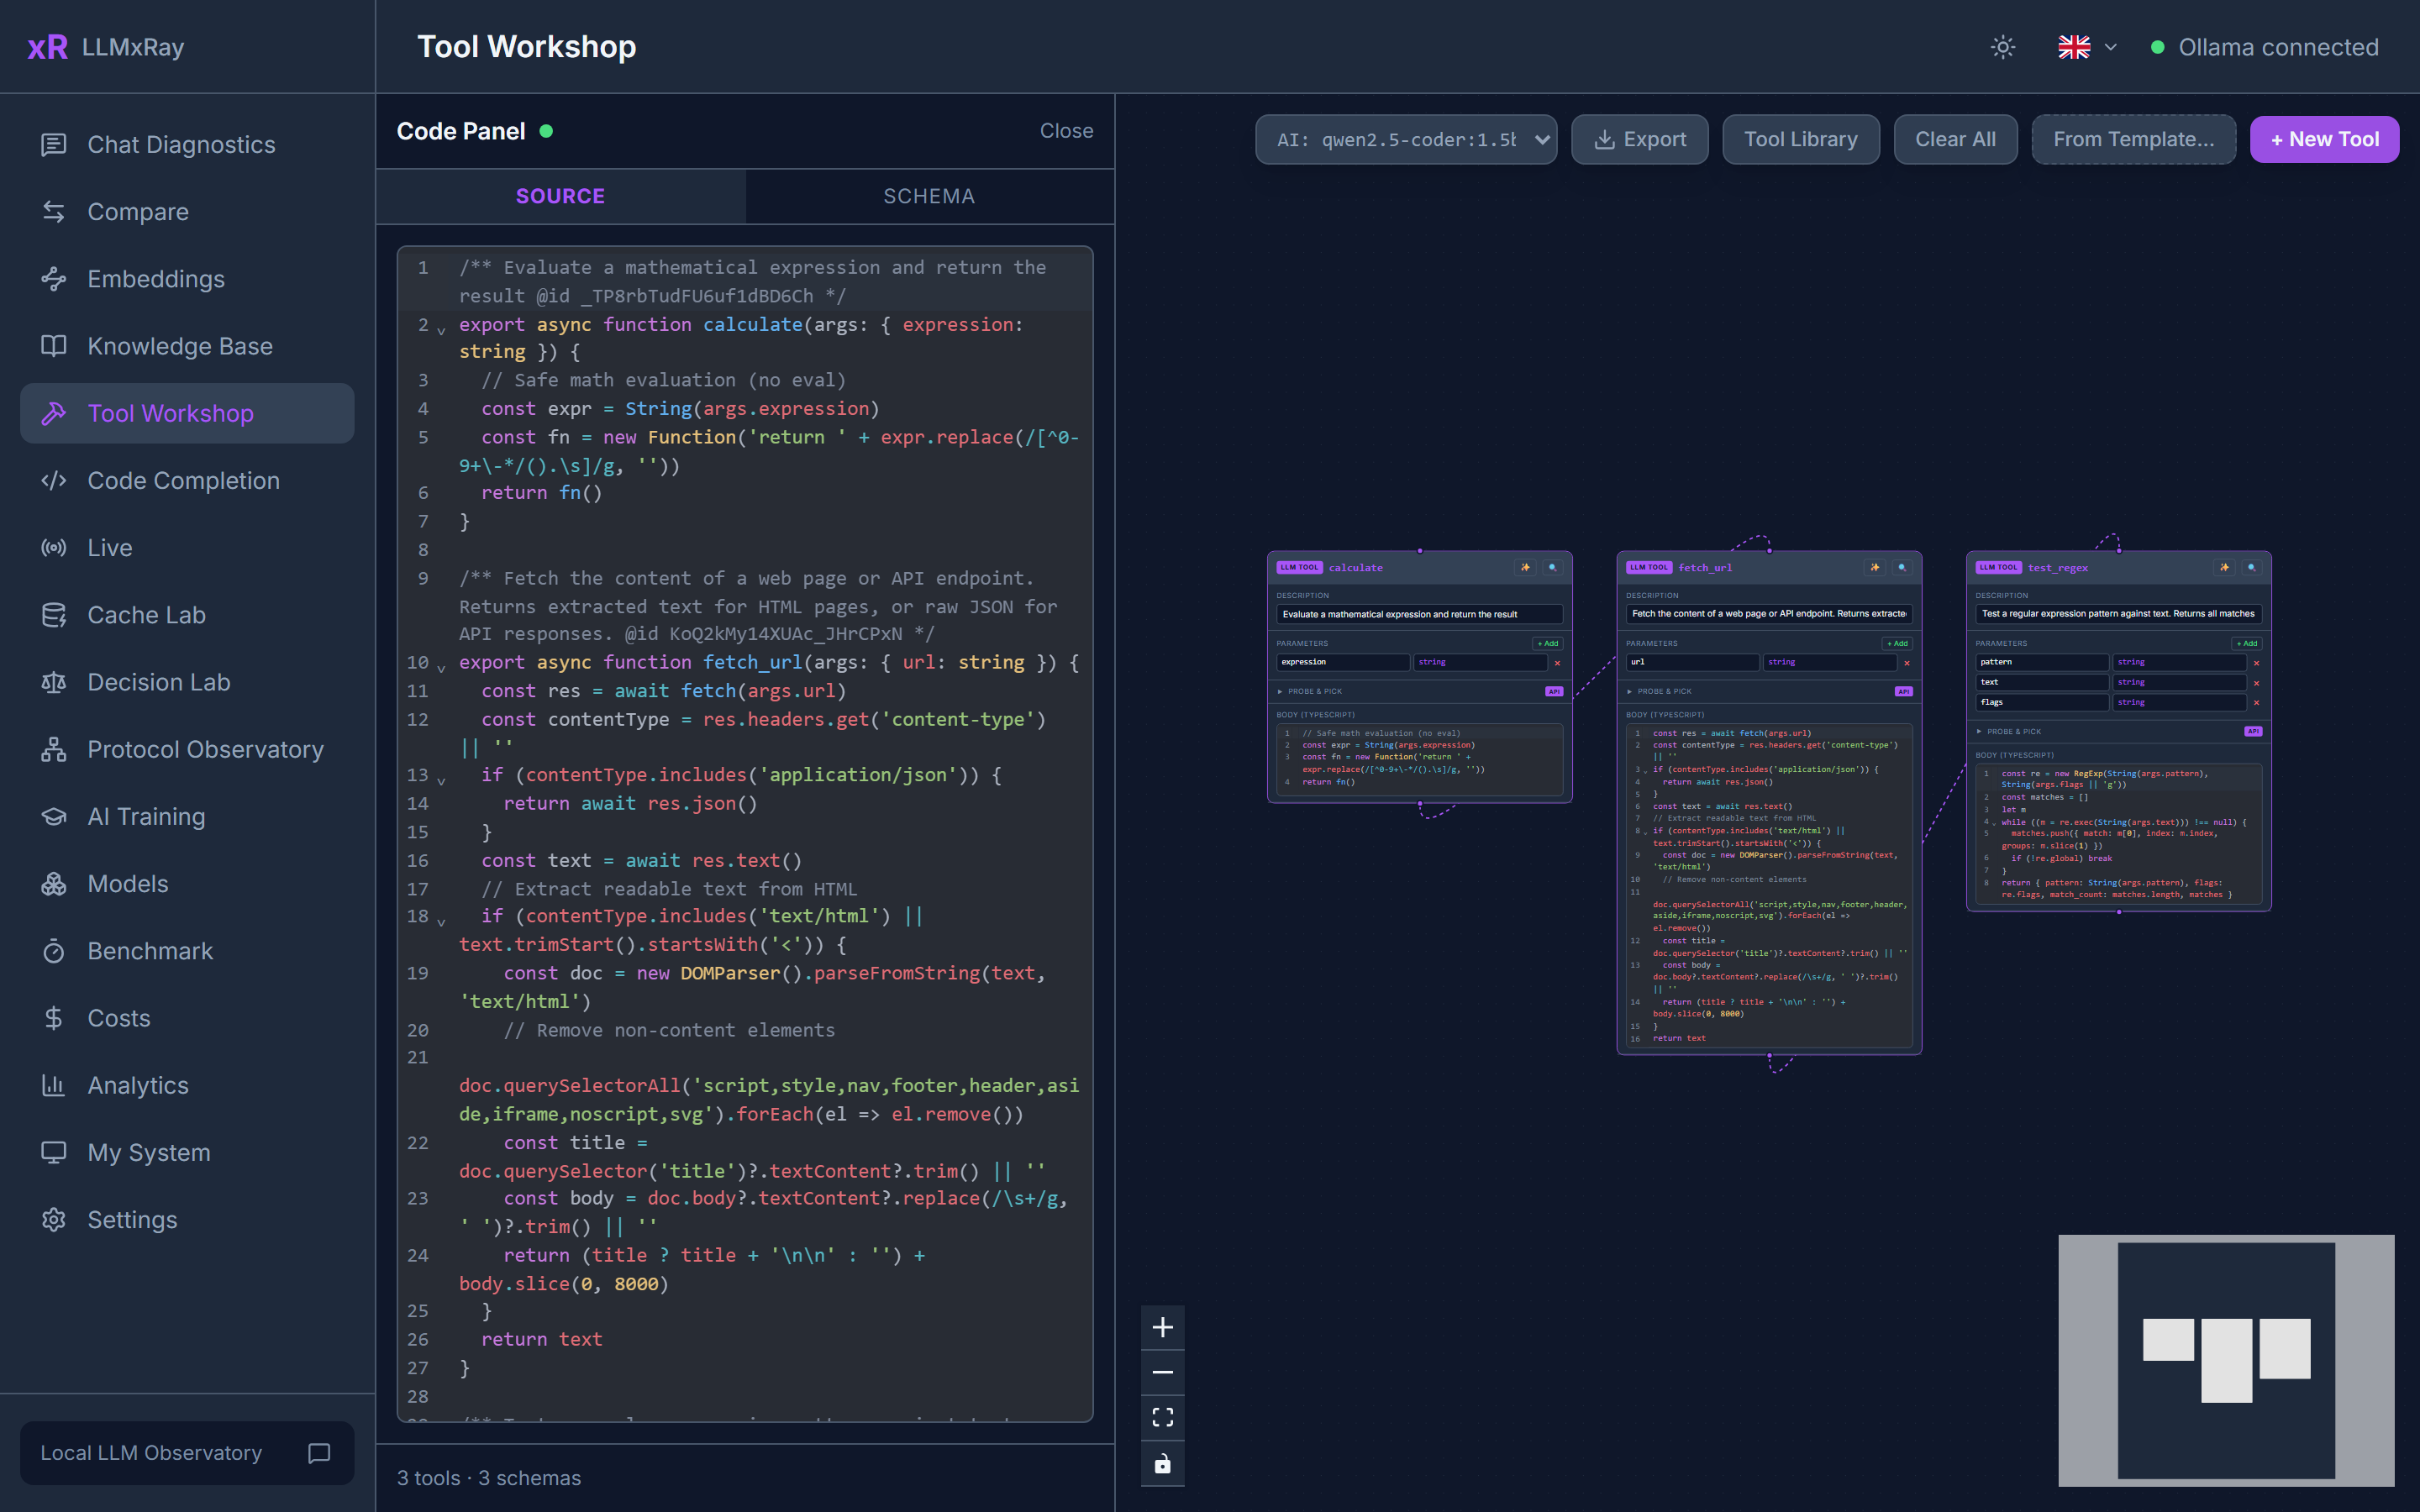
用于构建工具定义的节点画布,TypeScript 代码双向同步:既可以编辑节点,也可以编辑代码。探测 API、生成架构,并通过实时调用测试工具。
截图
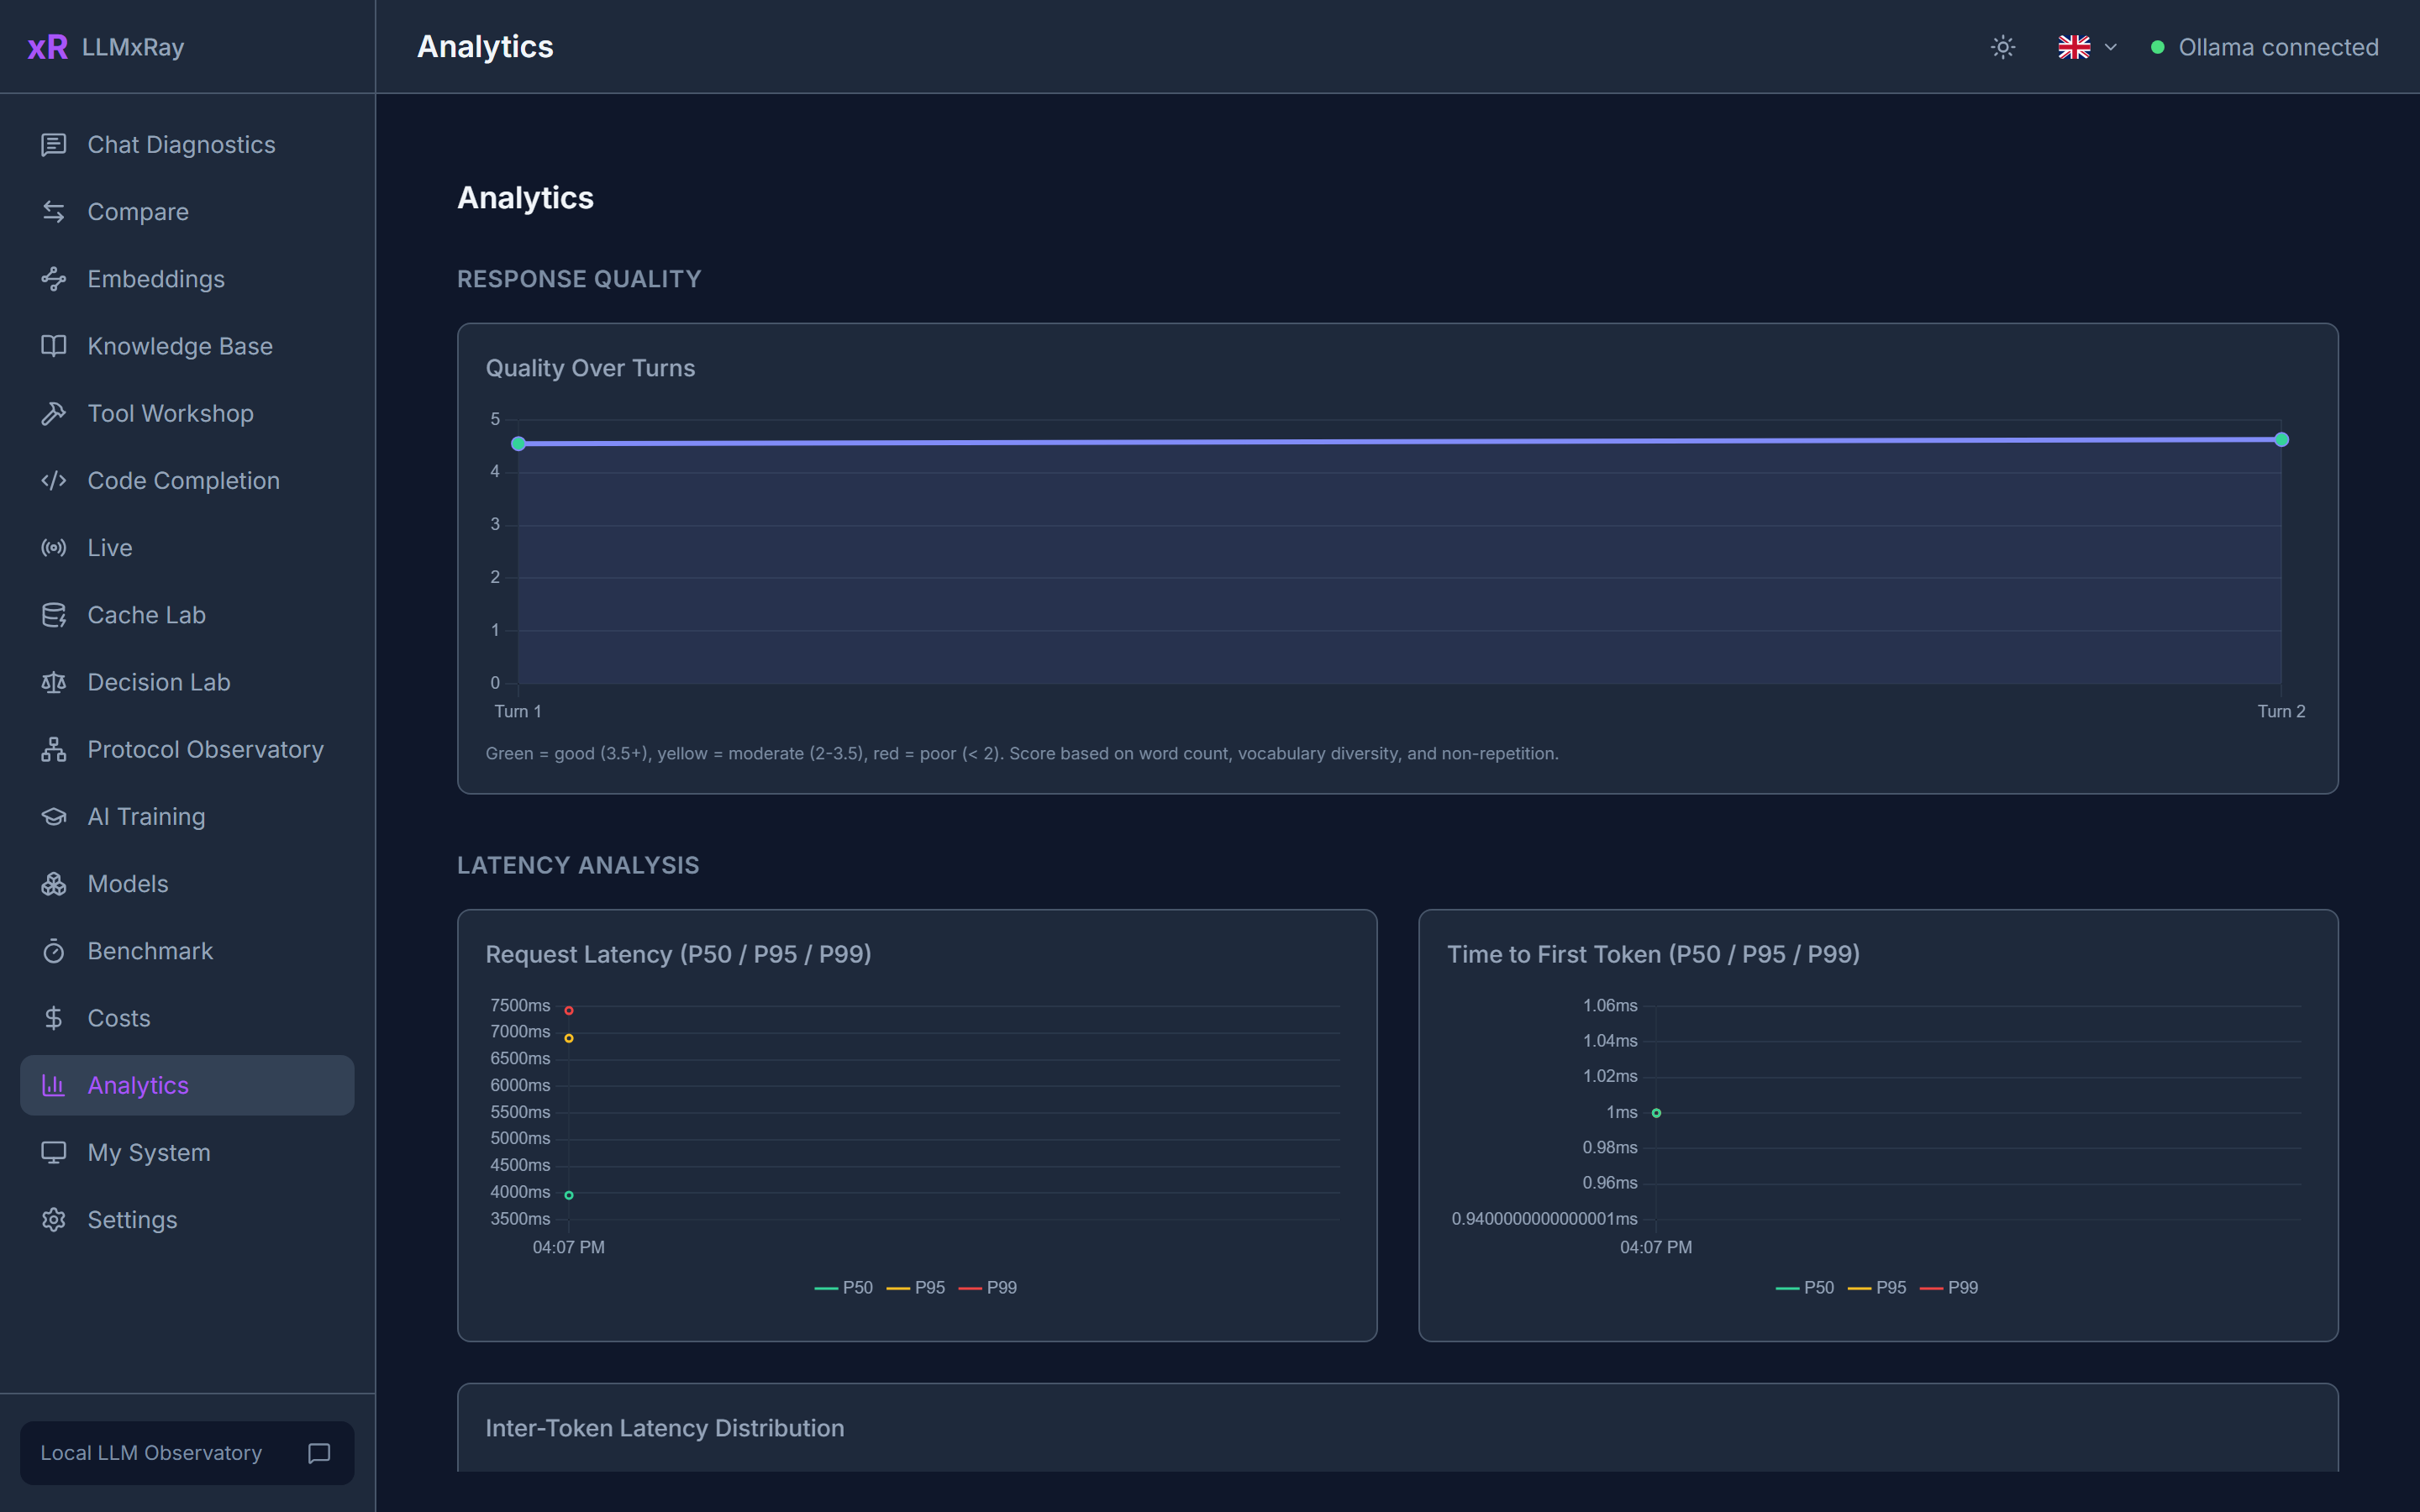
分析与成本
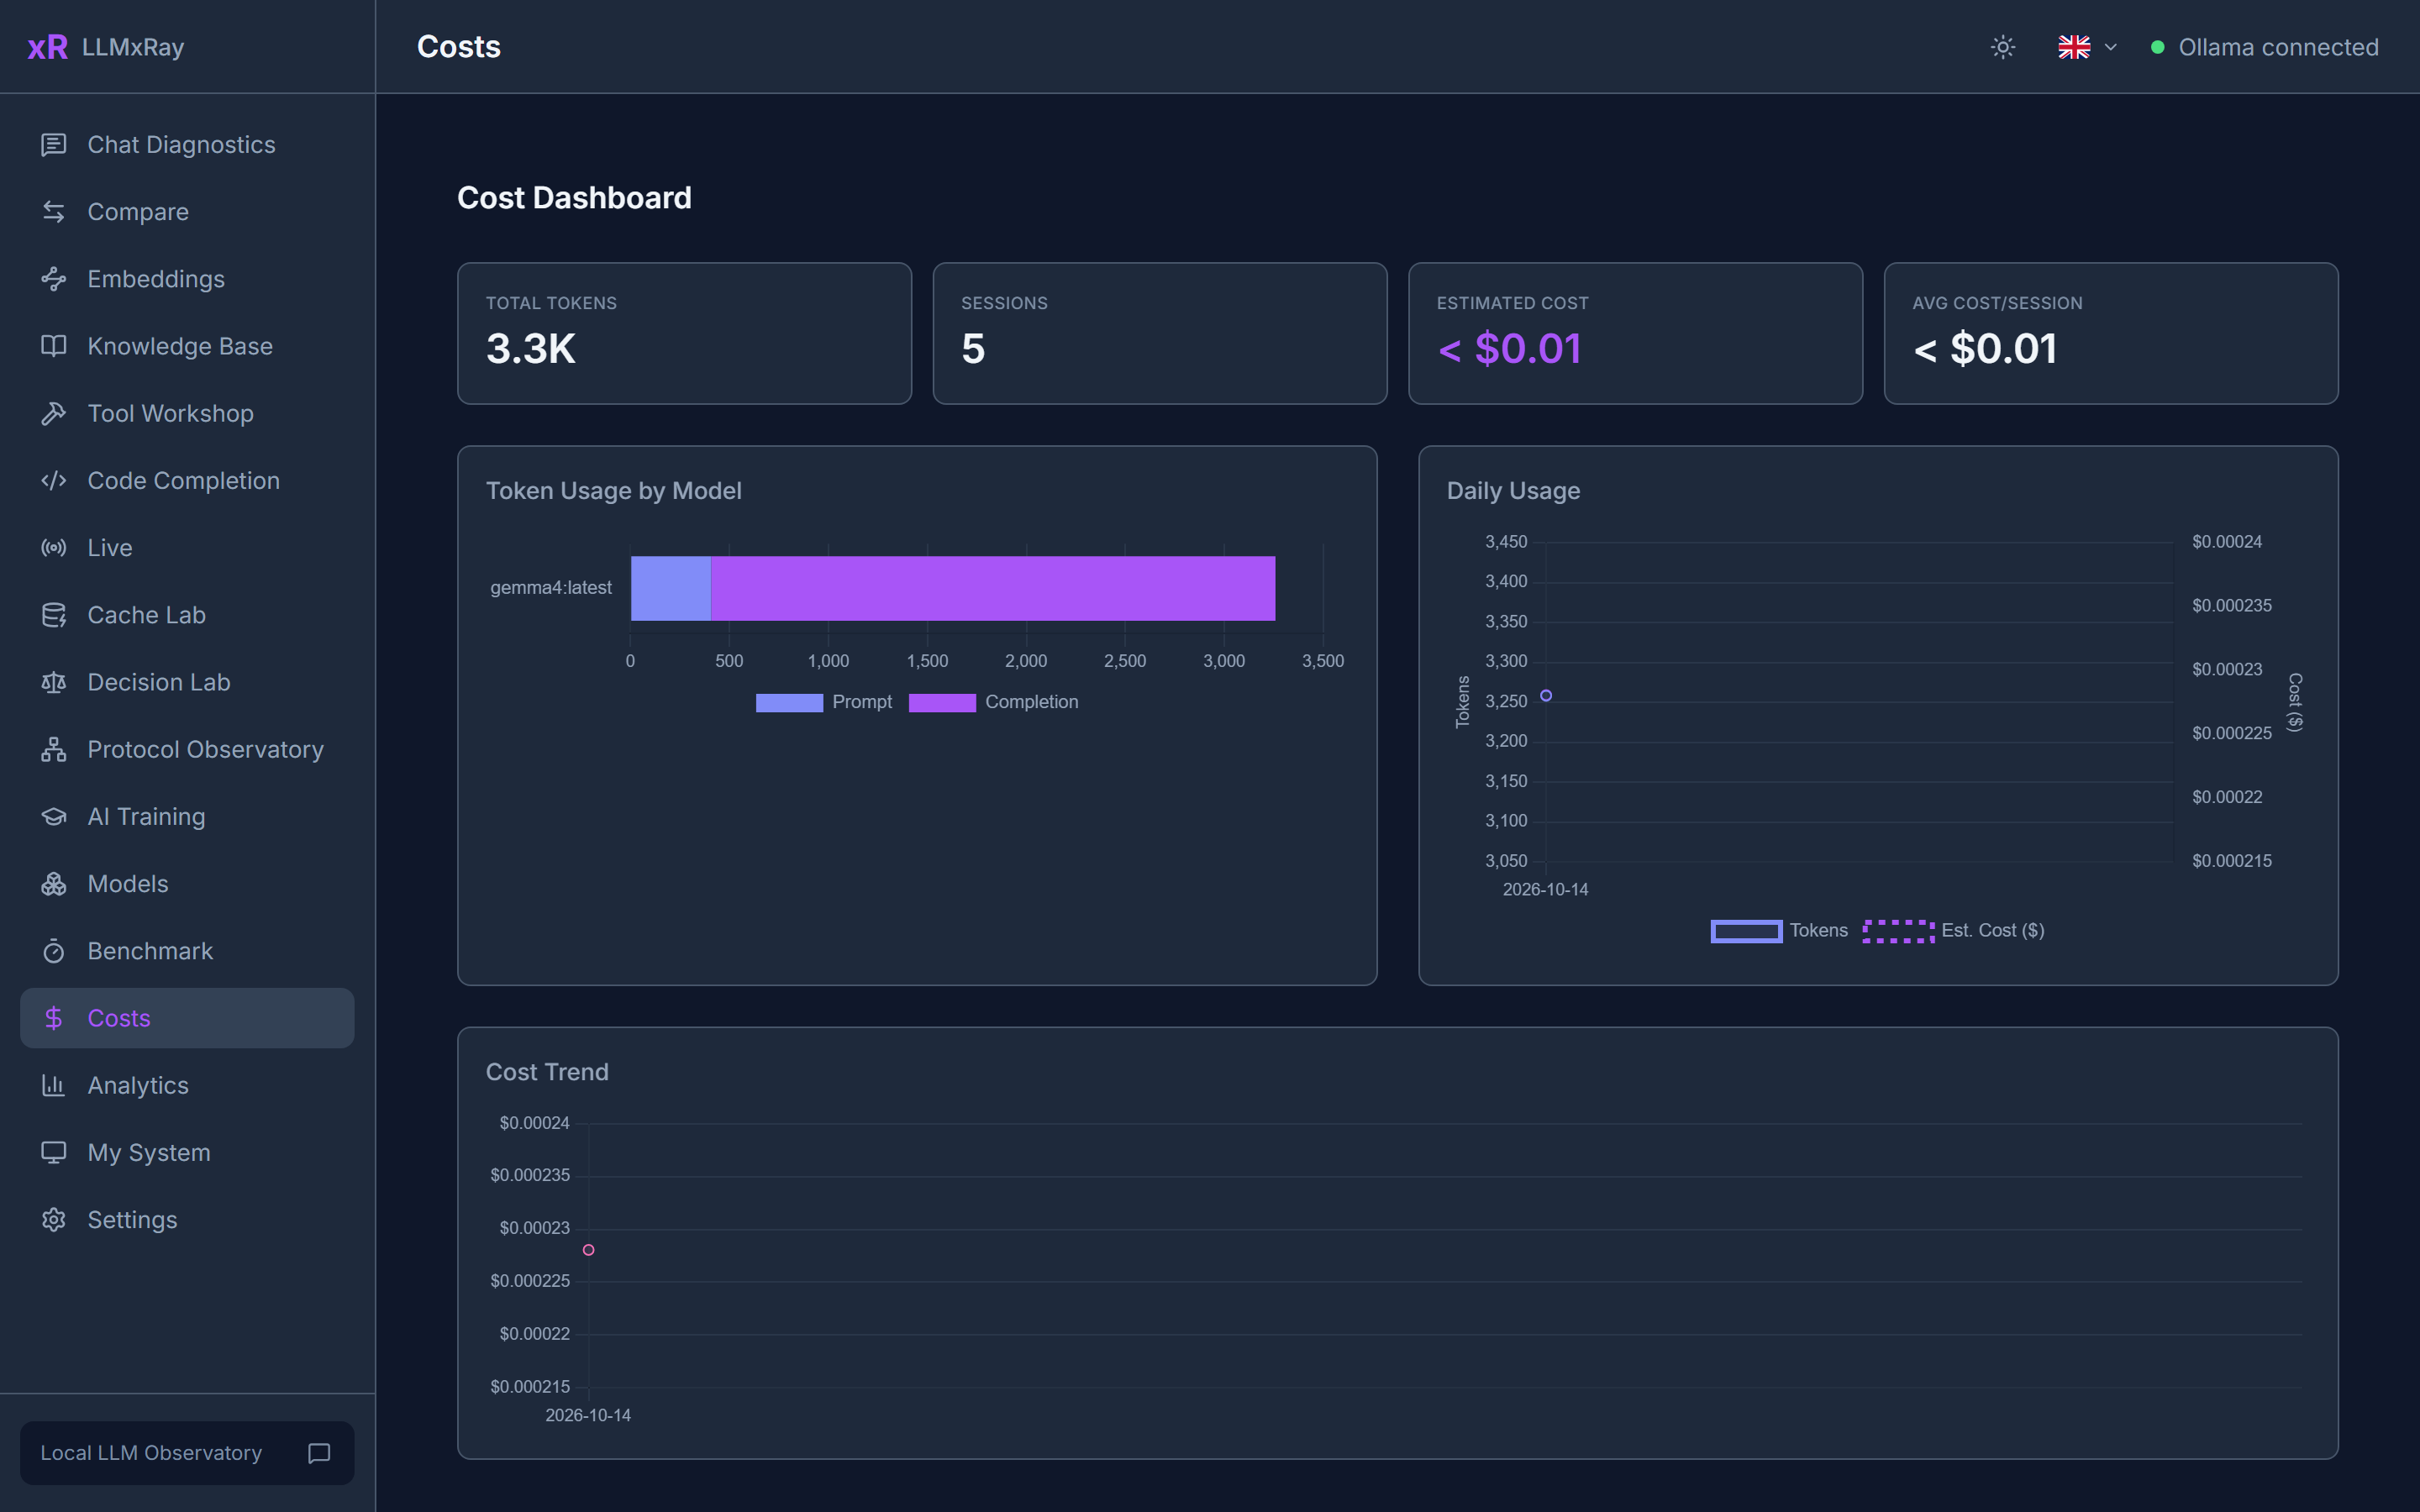
查看请求和首个令牌的延迟百分位数(P50 / P95 / P99)、各轮对话的质量、按模型统计的错误、使用热力图,以及温度与每秒令牌数之间的关系。成本页面按云端费率为本地用量估价,让你了解本地运行节省了多少成本。
截图
|
|
|
我的系统和模型
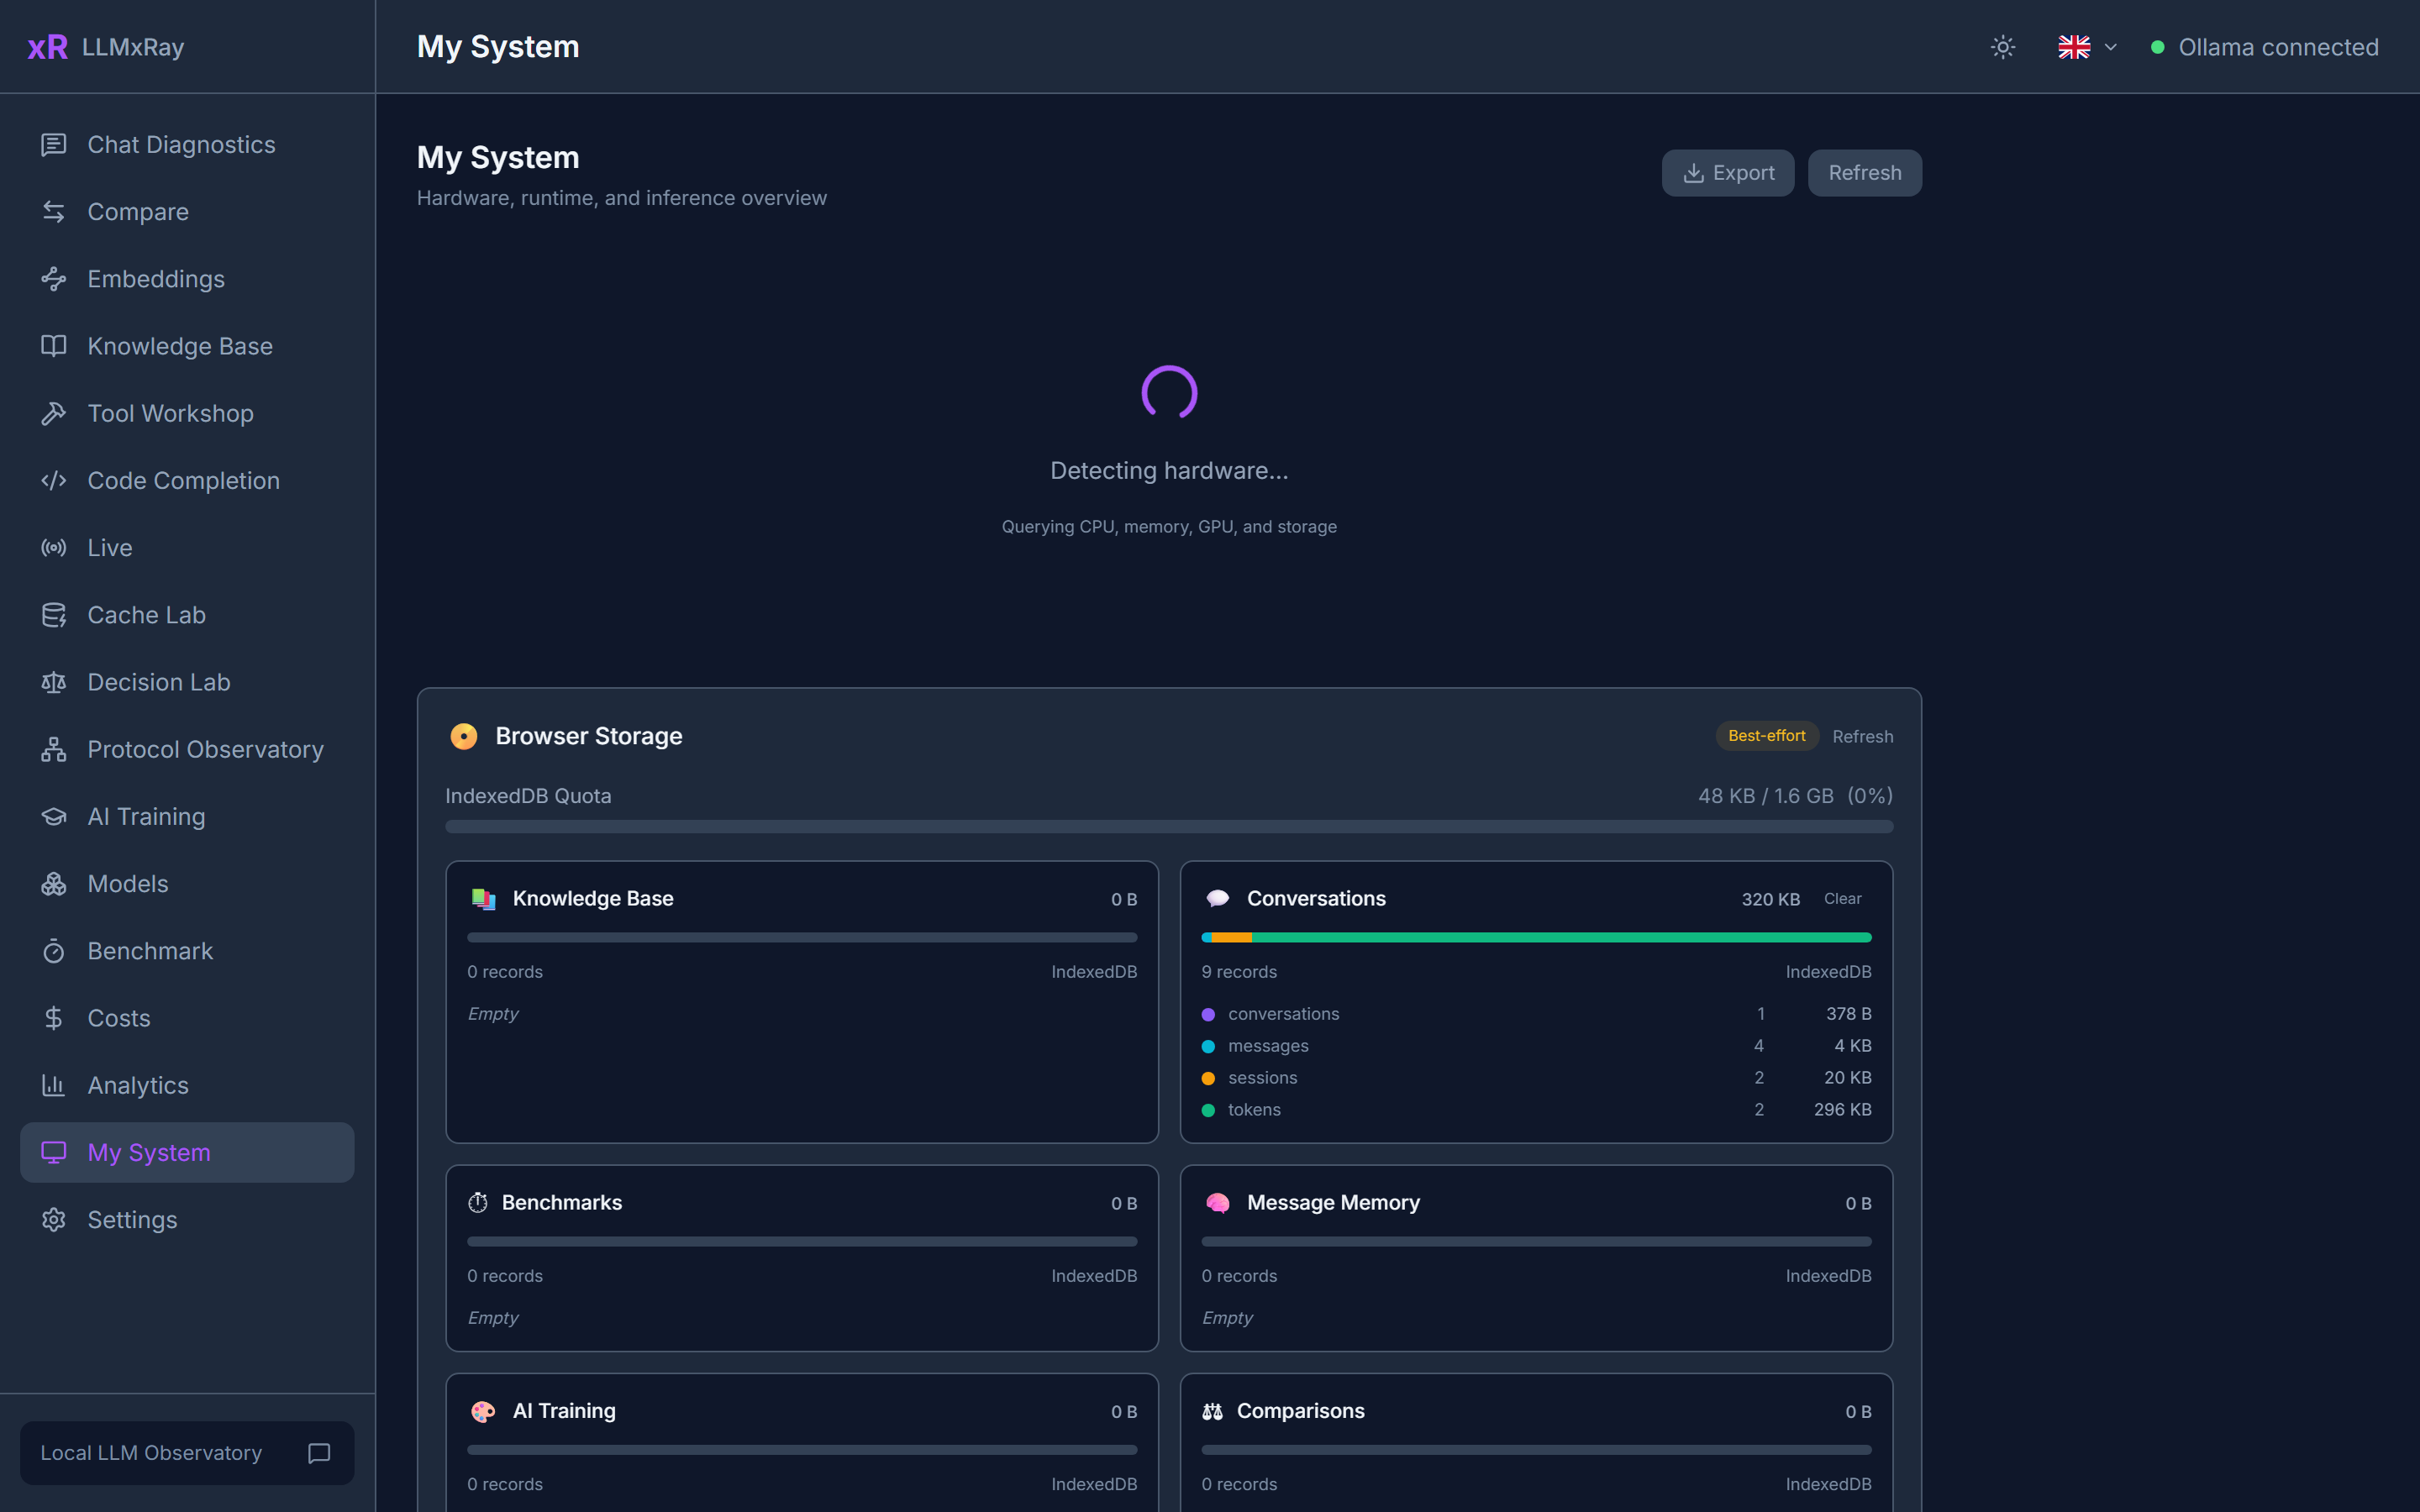
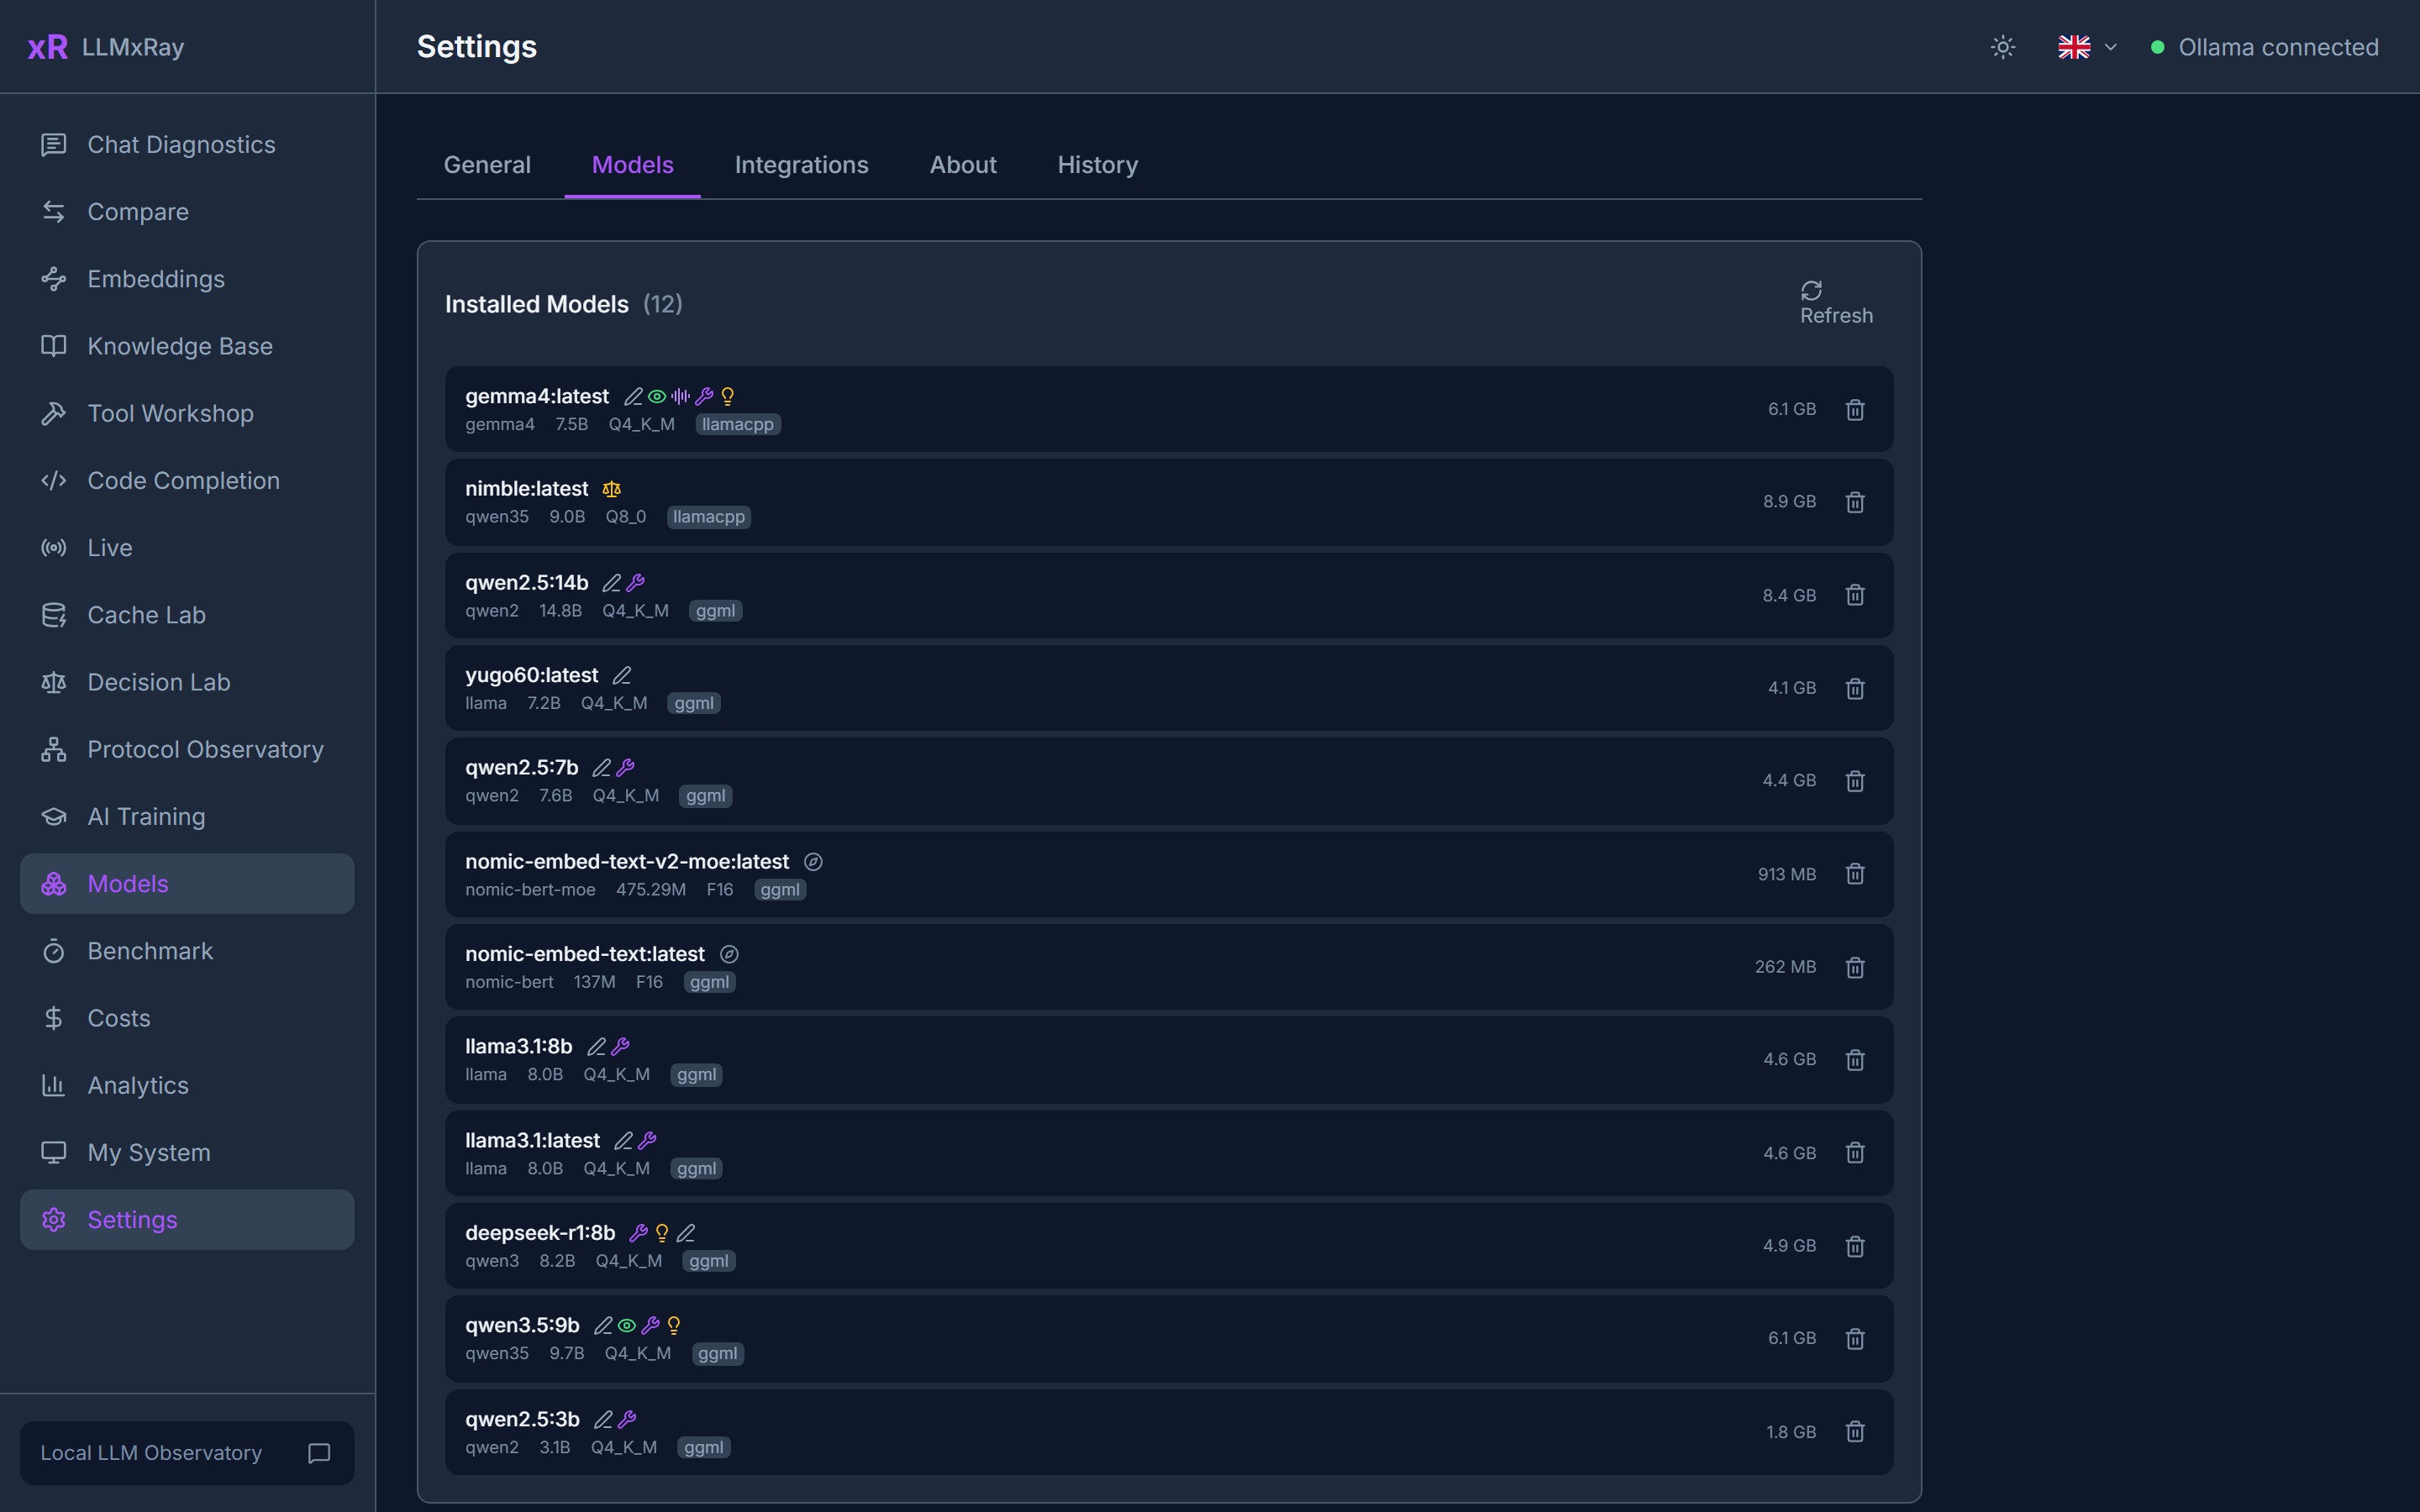
在一个页面中查看硬件、运行时和推理概况:CPU、内存、GPU、已加载的模型及其位置。模型选项卡会列出每个已安装模型的参数、模板和运行器,并可从目录中拉取新模型。
截图
|
|
|
更多
- AI 训练流水线。 从对话中整理配对数据,为其添加标签并进行审核,导出 JSONL 以用于微调。
- 本地历史记录数据库。 每次聊天、比较和基准测试都会归档到 IndexedDB 中,并提供筛选、趋势、导出和保留规则。
- 教育者工具包。 文档网站上的九个课程模块,每个模块都围绕一个 LLMxRay 页面构建。
- 五种语言。 支持英语、法语、塞尔维亚语(拉丁字母和西里尔字母)、中文和阿拉伯语,并提供从右向左的布局。已为希伯来语和日语准备好脚手架。
适用人群
| 你是…… | LLMxRay 可以帮助你…… |
|---|---|
| 开发者 | 调试提示词、分析延迟、比较模型、检查工具调用、查看编辑器发送的内容 |
| 研究人员 | 使用相同的设置,在不同模型和温度下开展受控实验 |
| 学生 / 教育者 | 观察模型行为,而不是只阅读相关介绍,并使用九个模块组成的教育者工具包 |
| AI 团队负责人 | 为每位开发者提供相同的本地环境,并收集他们导出的基准测试结果和训练配对数据 |
安装
npx(推荐)
npx llmxray
npx llmxray --port 3000
npx llmxray --ollama-url http://192.168.1.50:11434
npx llmxray --observe-port 11436     # the Live port, 11435 by default
Docker
docker run -p 5174:5174 -p 11435:11435 djovaneli/llmxray
docker run -p 5174:5174 -p 11435:11435 -e OLLAMA_URL=http://host.docker.internal:11434 djovaneli/llmxray
从源码安装
git clone https://github.com/LogneBudo/llmxray.git
cd llmxray
npm install
npm run dev     # http://localhost:5173
Ollama 兼容性
已针对 Ollama 0.40.x 测试(于 2026 年 10 月在 0.40.6 上验证)。兼容 0.20 及更高版本;较旧版本可以聊天,但不支持 think 和 JSON 架构 format。建议使用 0.33.3 或更高版本,该版本会报告提示缓存复用情况,因此预填充速度是根据实际评估的 token 数量测得的。
| 端点 | 用途 |
|---|---|
/api/chat | 流式聊天(NDJSON,支持 tools、think 推理力度级别、format 架构) |
/api/generate | 生成和通过 suffix 进行中间填充 |
/api/tags、/api/show | 模型列表、能力、上下文长度、参数、模板 |
/api/embed | 知识库的向量嵌入,支持通过 dimensions 截断 |
/api/pull、/api/delete、/api/ps、/api/version | 模型管理和状态 |
/v1/chat/completions | 兼容 OpenAI 的路径,供 Surgical Benchmark 获取真实 logprobs |
/v1/messages | 兼容 Anthropic 的路径,供 Protocol Observatory 使用 |
/v1/systemone | 决策模型,供 Decision Lab 使用 |
底层实现
Vue 3.5、TypeScript 6(严格模式)、Vite 8、Tailwind CSS 4、按关注点划分的 Pinia store、用于图表的 Chart.js 和 D3、用于工具画布的 Vue Flow、用于代码的 CodeMirror 6。应用会将自己的数据(聊天、比较、基准测试、知识库)存储在浏览器的 IndexedDB 中;Live 日志的回合记录存储在运行 LLMxRay 的计算机上的 ~/.llmxray 中。后端是本地 Ollama。
流式响应通过 fetch() 和 ReadableStream 读取 Ollama 的 NDJSON,token 通过 Pinia 更新 UI。Chat 和 Compare 会根据 Ollama 返回的真实 logprobs 为 token 着色;如果没有 logprobs,token 就不会着色,而 token 视图会将耗时称为速度,绝不会称为置信度。基准测试也使用真实 logprobs。硬件检测由一个直接向操作系统查询的小型 Vite 插件完成。Live 端口是一个透明代理:它会原样转发每个请求至 Ollama,不做任何转换(兼容 OpenAI 和 Anthropic 的路由由 Ollama 自行提供),并记录计数和耗时,保留 30 天。
| 命令 | 功能 |
|---|---|
npm run dev | 开发服务器(端口 5173) |
npm run build | 类型检查和生产构建 |
npm run test | 单元测试(Vitest) |
npm run test:e2e | 端到端测试(Playwright) |
贡献
欢迎贡献。设置和指南请参阅 CONTRIBUTING.md。尤其欢迎社区翻译:希伯来语和日语的脚手架文件已准备就绪。
许可证
商标
LLMxRay 是 Ivan Stankovic(LogneBudo)的商标。请参阅 TRADEMARK.md。
如果 LLMxRay 帮助你更好地了解自己的 AI,不妨为它点个星。
这有助于其他人发现这个项目。

评论
一个开放协议,规定了 AI 应用如何以统一方式连接外部工具与数据源。客户端负责与模型对话,MCP 服务负责提供工具、资源和提示模板,两者通过标准消息通信,同一个服务可以被不同客户端复用。